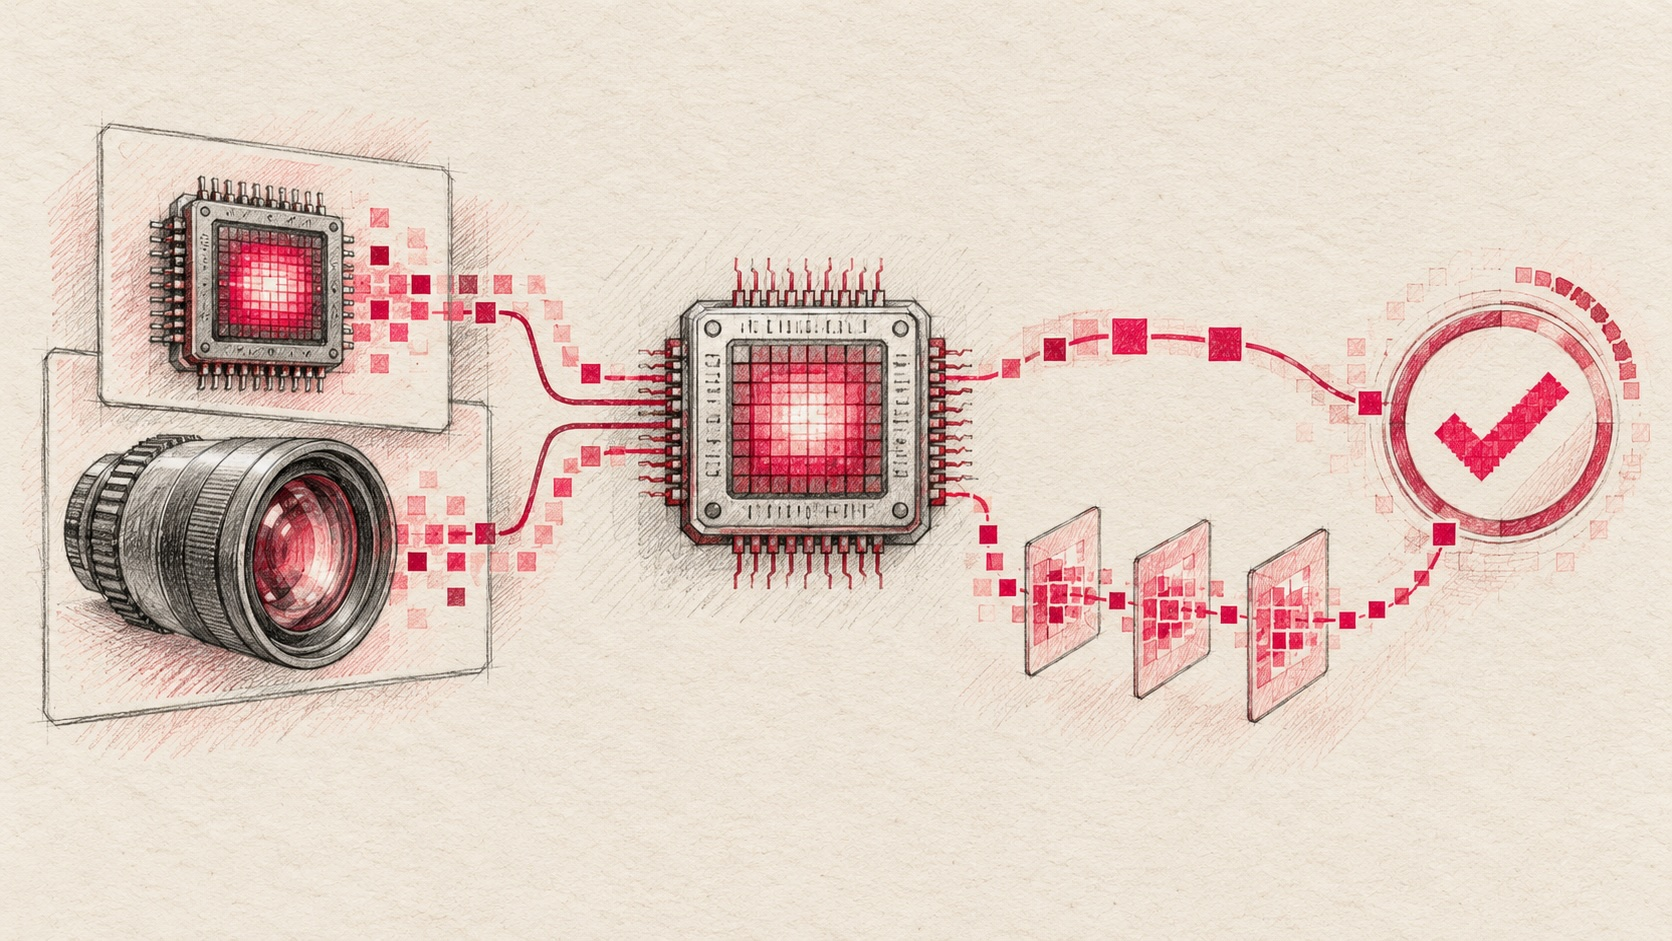
視覚言語モデルはすでに画像の理解や質問への回答が可能になっていますが、商品分類、コンテンツモデレーション、サムネイル選定などのタスクでは、モデルに本当に必要なのは冗長なテキスト生成ではなく、明確な判定結果である場合がほとんどです。AutoTrustが提供するJEV-27B-VLはQwen3.8-27Bを基盤とし、デュアルシステムアーキテクチャにより高速な意思決定と深い推論のオンデマンド切り替えを実現し、構造化された判定結果と校正された確率を直接出力することで、不要な生成オーバーヘッドを削減します。HyperAIでは、本モデルのオンラインチュートリアルを公開しており、モデルの読み込み、画像ベースの意思決定の実行、およびインタラクティブなWebUIの体験が可能です。