HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
モーション・オムニ:音声対話のための音声と全身動作のエンドツーエンド統合生成
オーディオ・ビデオモデルにおけるアテンショントライアングル
二層協調リフレクション:マルチエージェントLLMシステムへのゲーム理論的アプローチ
Dr. Claw: バイブ研究のためのAI科学者ワークスペース
WorldReward:カメラ条件付きワールドモデルのための報酬モデリング
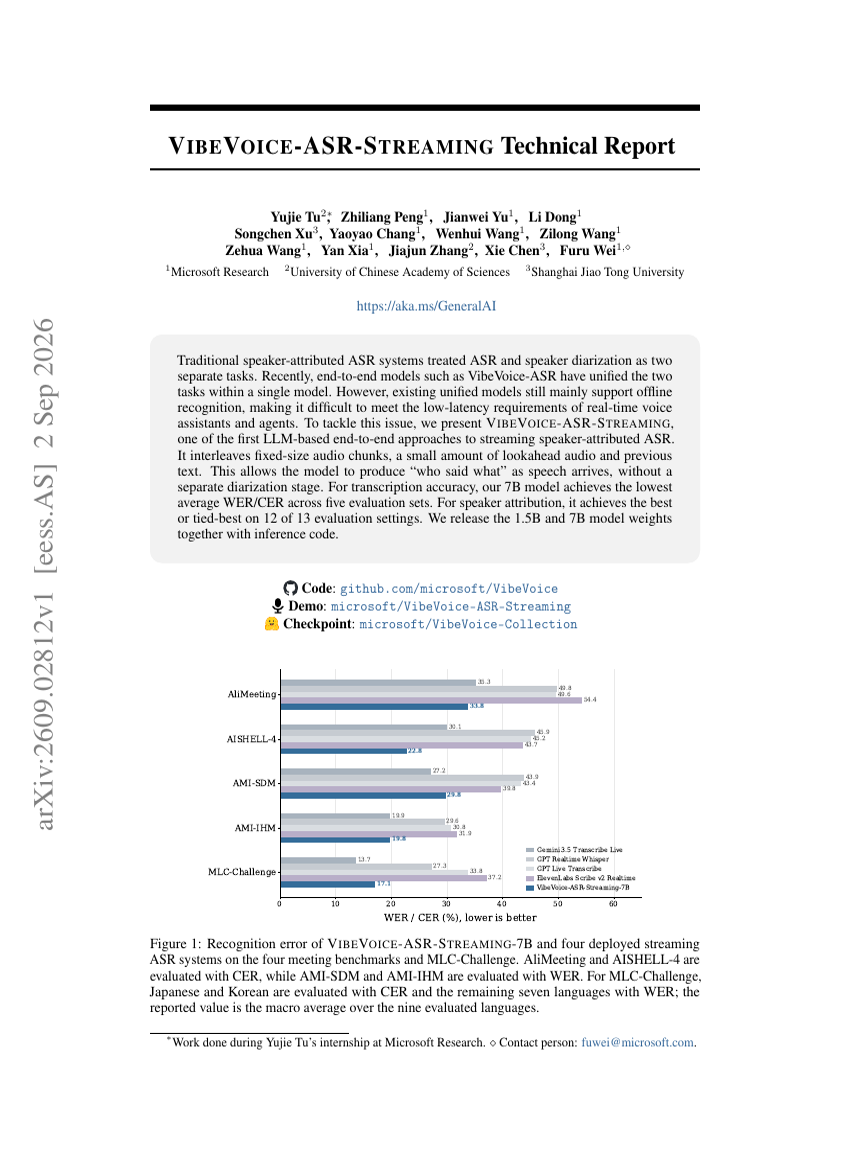
VIBEVOICE-ASR-STREAMING 技術レポート
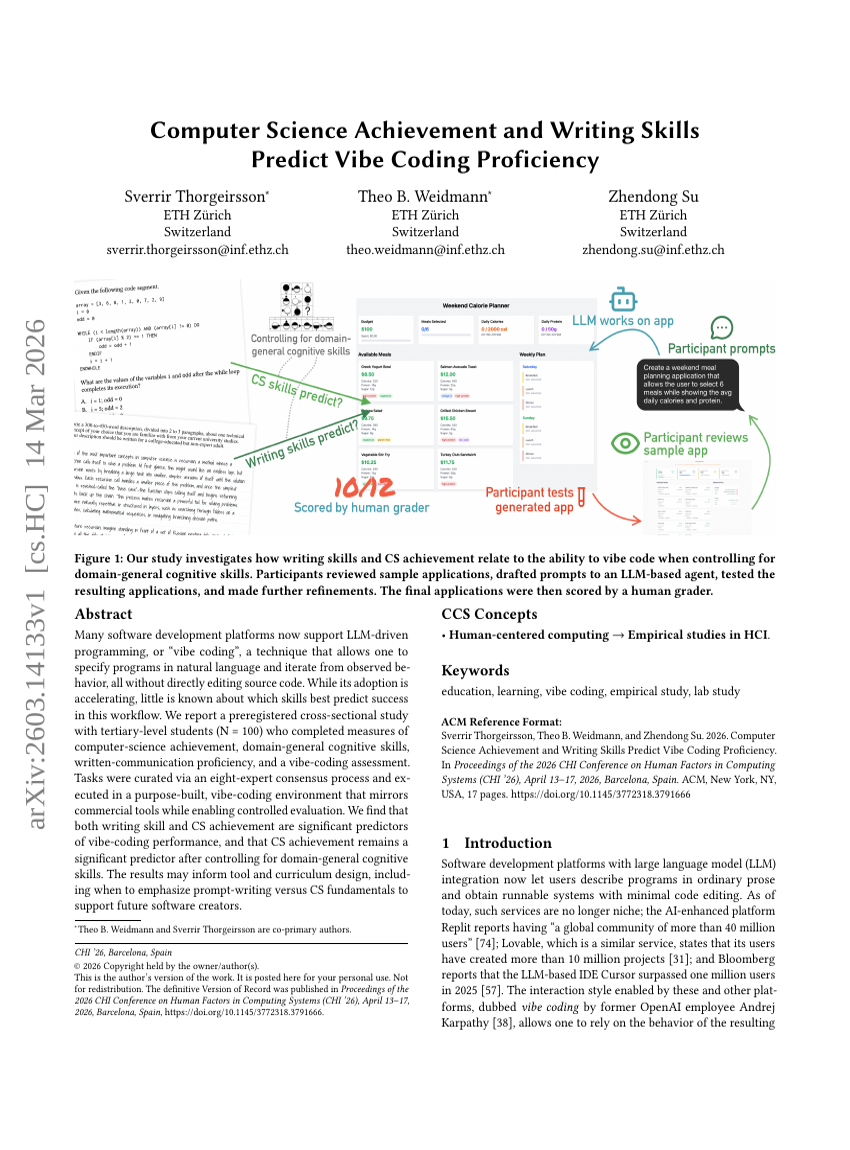
計算機科学の達成度と文章作成スキルがバイブコーディングの熟達度を予測する
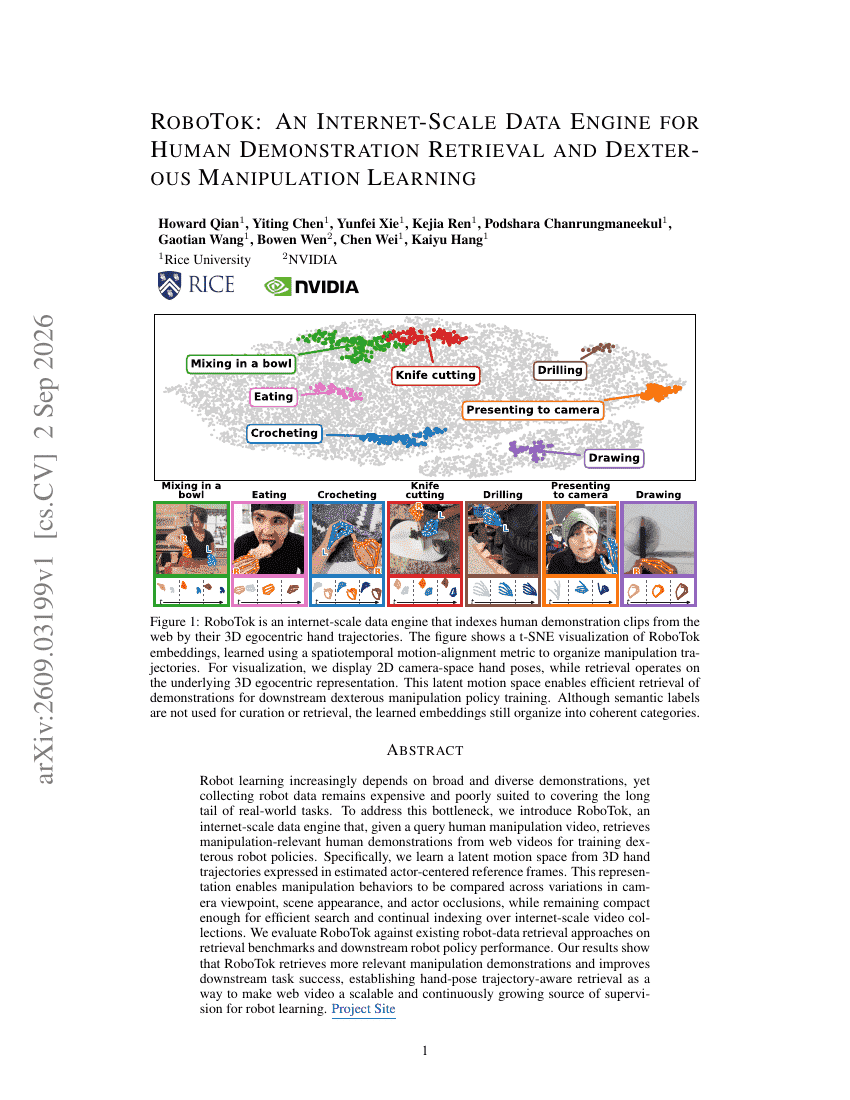
RoboTok: 人間のデモンストレーション検索と器用な操作学習のためのインターネット規模データエンジン
再利用すべきでない時を知る:自律的LLMポストトレーニングにおける条件付き経験移転
Random Attention: 効率的推論のためのKVキャッシュ削減再考
LLaDA-Image: 完全にオープンな訓練レシピによる強力な画像生成器の構築
Terminal-Universe: エージェント軌跡をスケーラブルな端末環境へ変換する手法
コンパイル・バイ・トレーニング:自然言語仕様からローカルニューラル関数への変換
HarnessDev: LLMは自らエージェントハーネスを生成し進化させられるか?
言語モデルは自らの注意を制御できる
マッチングには二者が必要:共進化する生成型検索モデルと強化学習
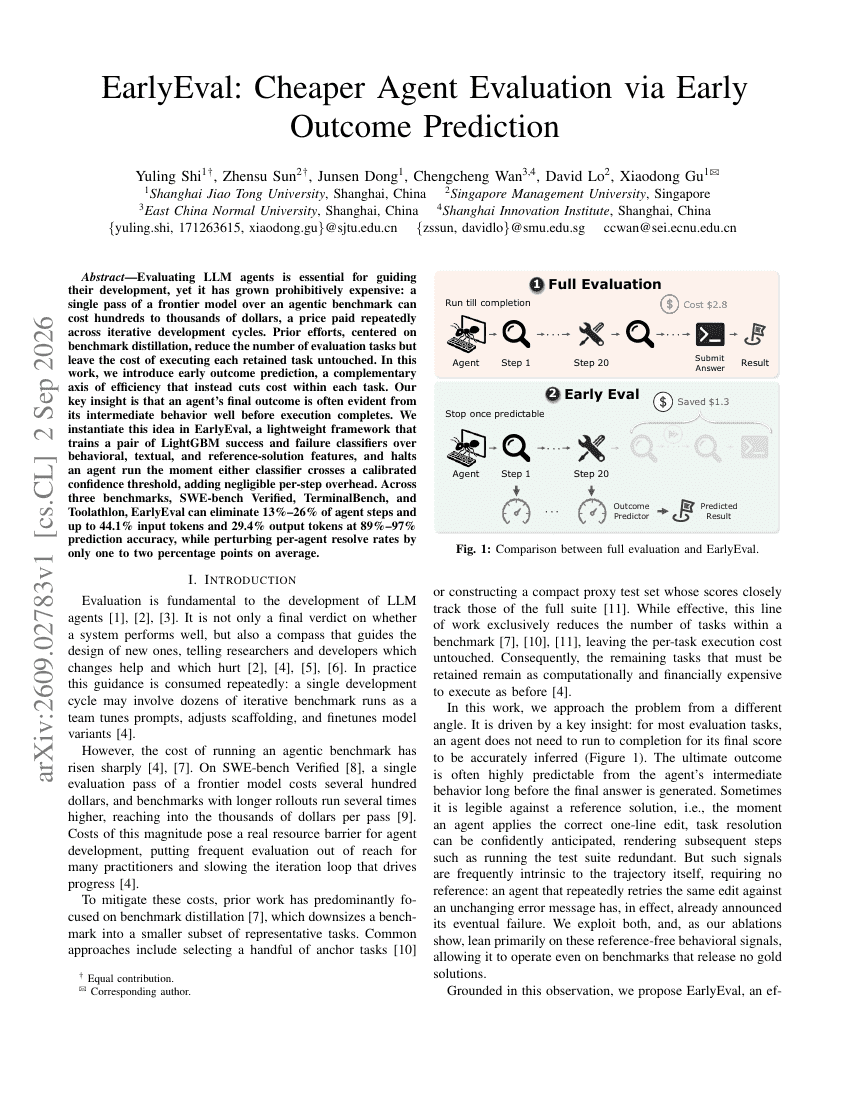
EarlyEval: 早期結果予測によるエージェント評価の低コスト化
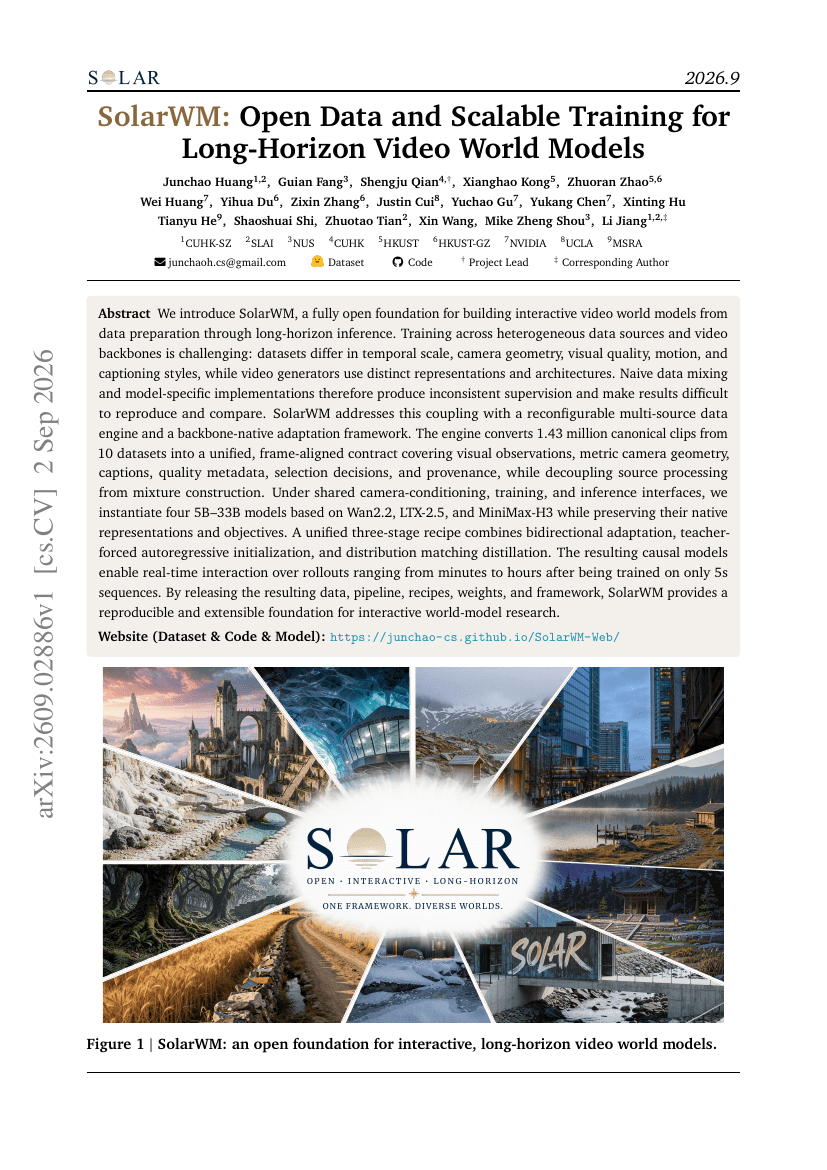
SolarWM: 長時間ビデオワールドモデルのためのオープンデータとスケーラブルな訓練
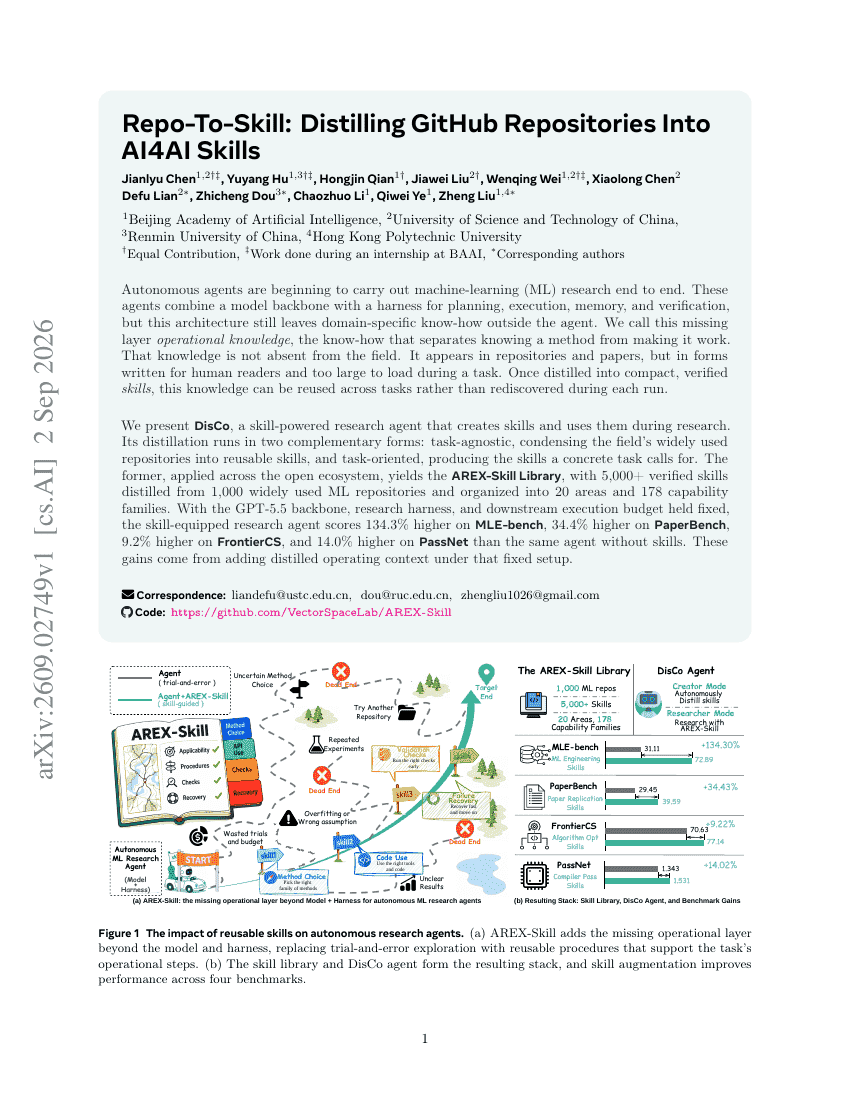
Repo-To-Skill: GitHubリポジトリをAI4AIスキルへ蒸留する
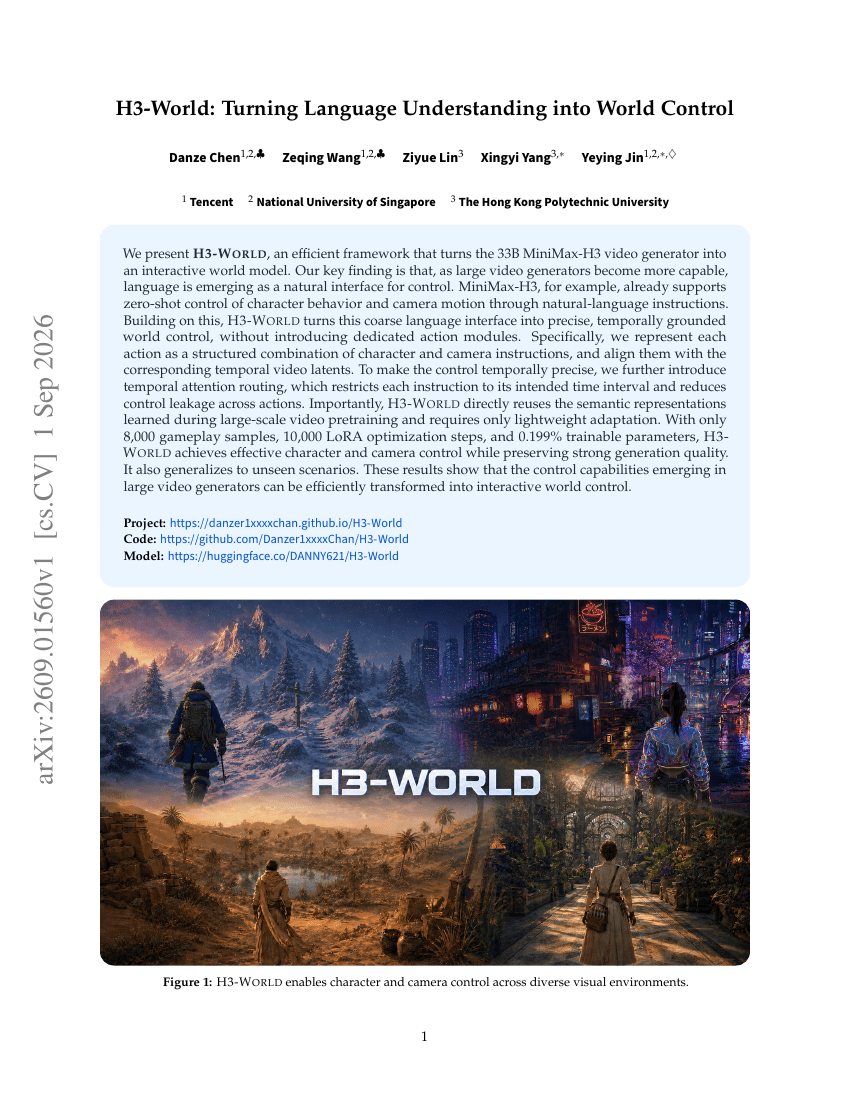
H3-World: 言語理解を世界制御へと転換する
ZimaBlue: スケーラブルな動画事前学習による汎化可能な世界行動モデルの進化
UI-Venus-2: GUIエージェントのための大規模言語モデル
SMELT: 計算量整合型MoEループトランスフォーマーのスケーリング則
Qwen-Drive-1.0:自動運転のための視覚言語基盤モデルに向けた第一歩
StudentSim: LLMベースの学習者シミュレータの訓練
SenseNova-U1: NEO-unifyアーキテクチャによるマルチモーダル理解と生成の統合
スーパーライブラリエージェント:単一コードベースを超えた複数アプリケーションの統合的生成と保守
CogEvol: 効率的かつ信頼性の高い学習環境生成を目指して
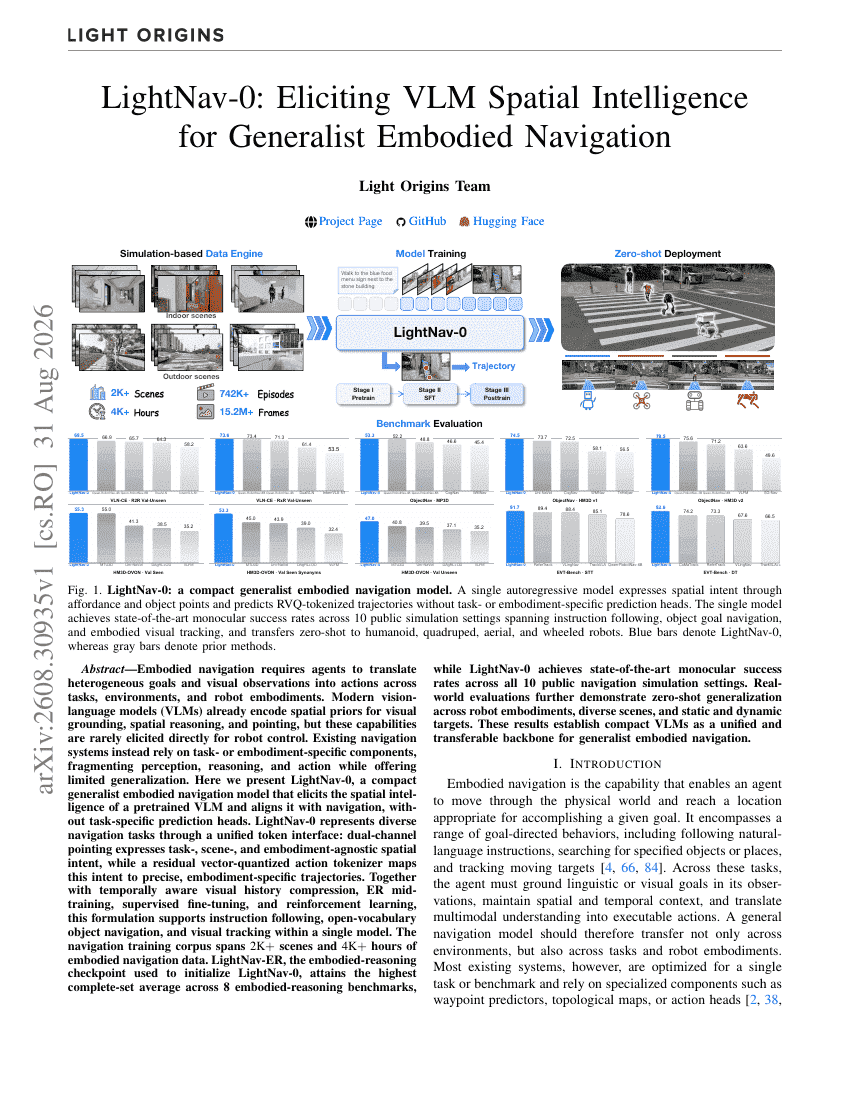
LightNav-0: 汎用身体化ナビゲーションのためのVLM空間知能の引き出し
GenFirst: 安定したエンドツーエンド潜在生成モデリングのための再構成前の生成
Lucida: 合成可能なReal-to-Simシーンモデリングのための解析・生成・配置
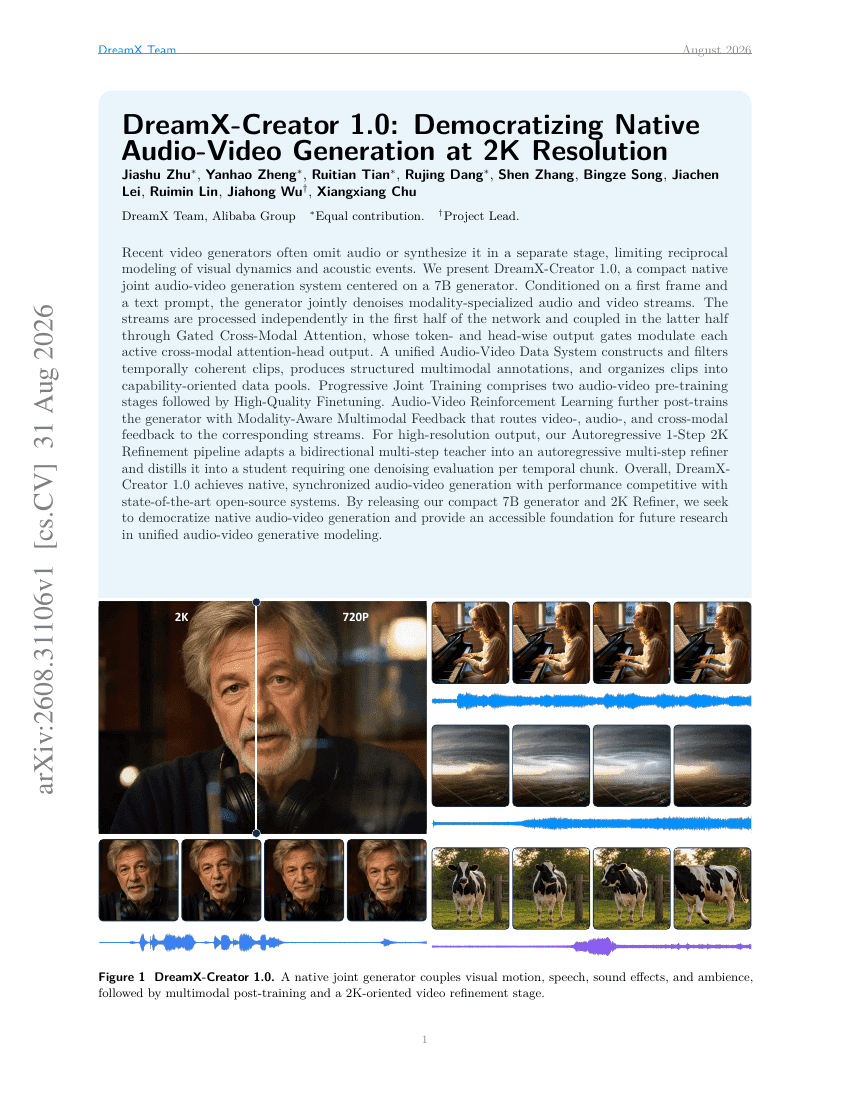
DreamX-Creator 1.0:2K解像度におけるネイティブ音声・映像生成の民主化