HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
3,171 論文
実世界の音響シーンに向けた効率的なストリーミング音声・視覚ターゲット話者抽出
DTCA: 拡散言語モデルにおける強化学習のためのデノイジング時のトークン単位クレジット割当て
CodeCap-Bench: コードは優れたビデオキャプションになり得るか
Rollback: 方策改善のための世界モデルにおける経験の巻き戻し
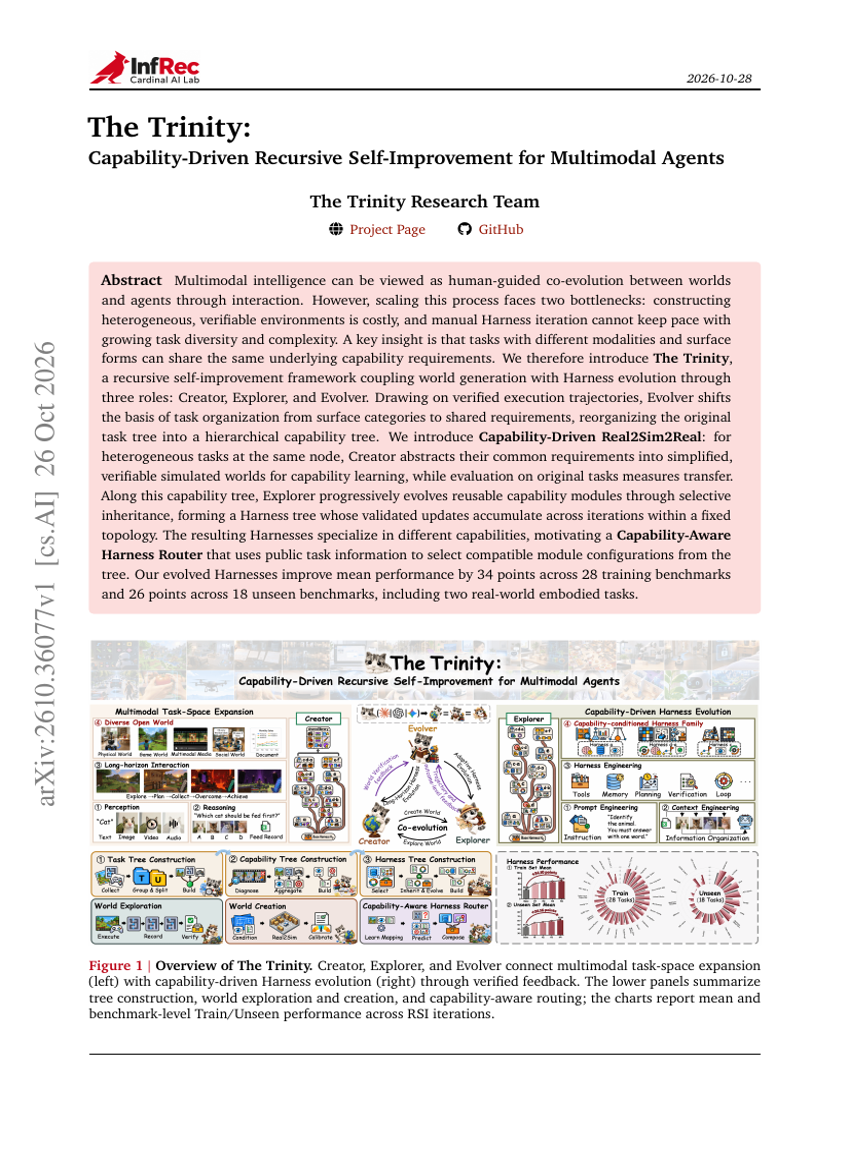
The Trinity: マルチモーダルエージェントのための能力駆動型再帰的自己改善
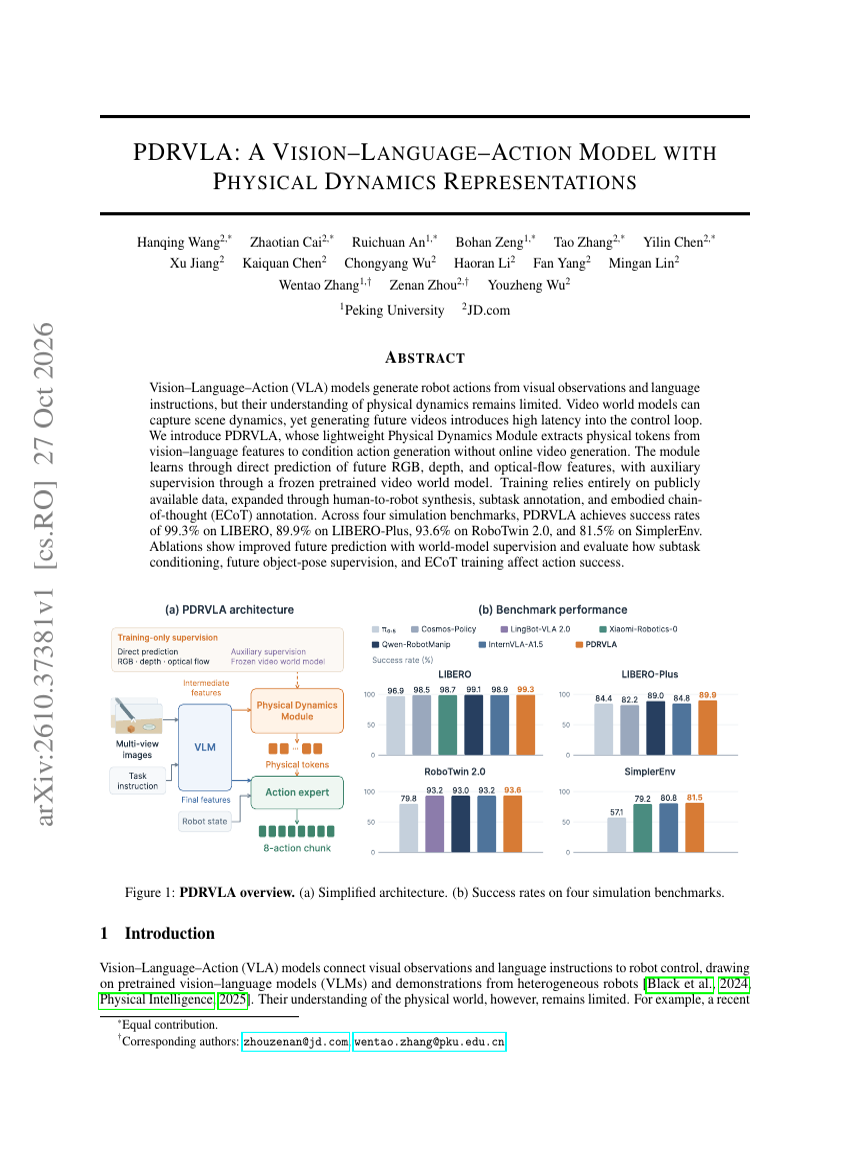
PDRVLA: 物理ダイナミクス表現を備えた視覚–言語–行動モデル
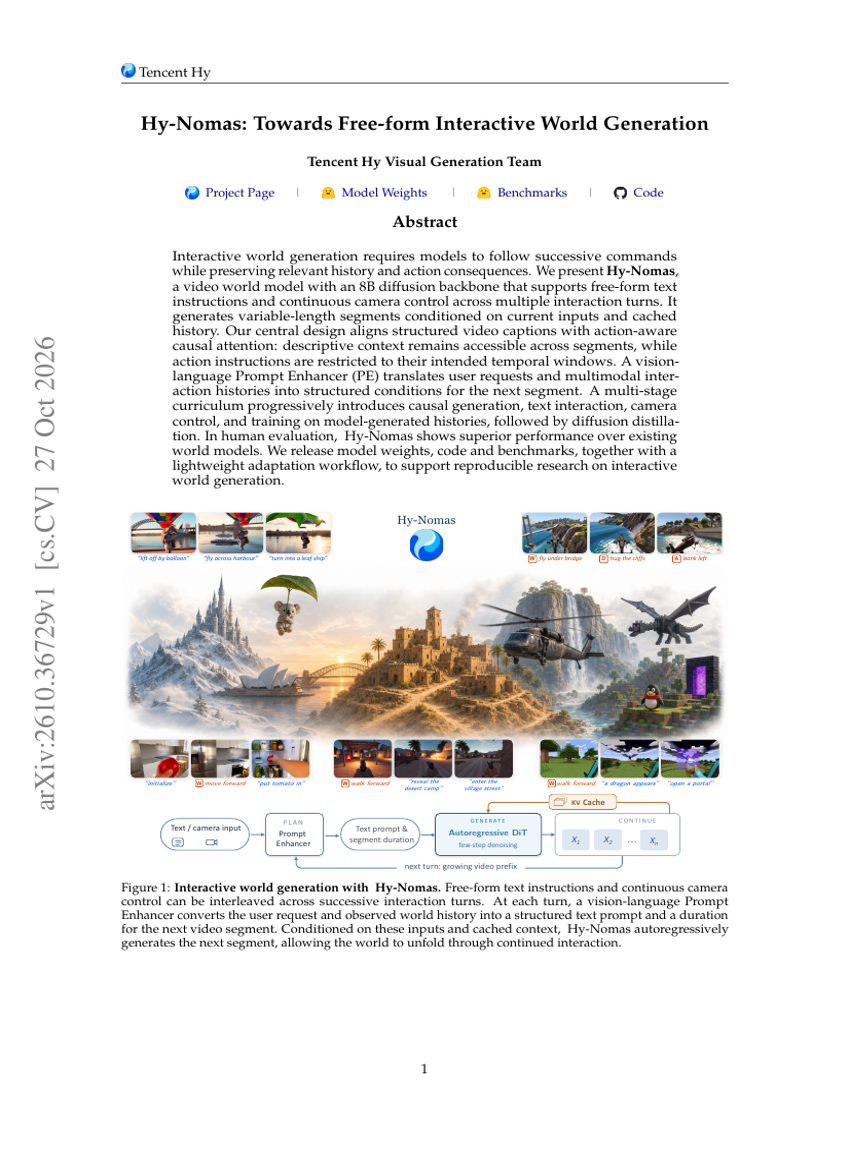
Hy-Nomas: 自由形式インタラクティブ世界生成に向けて
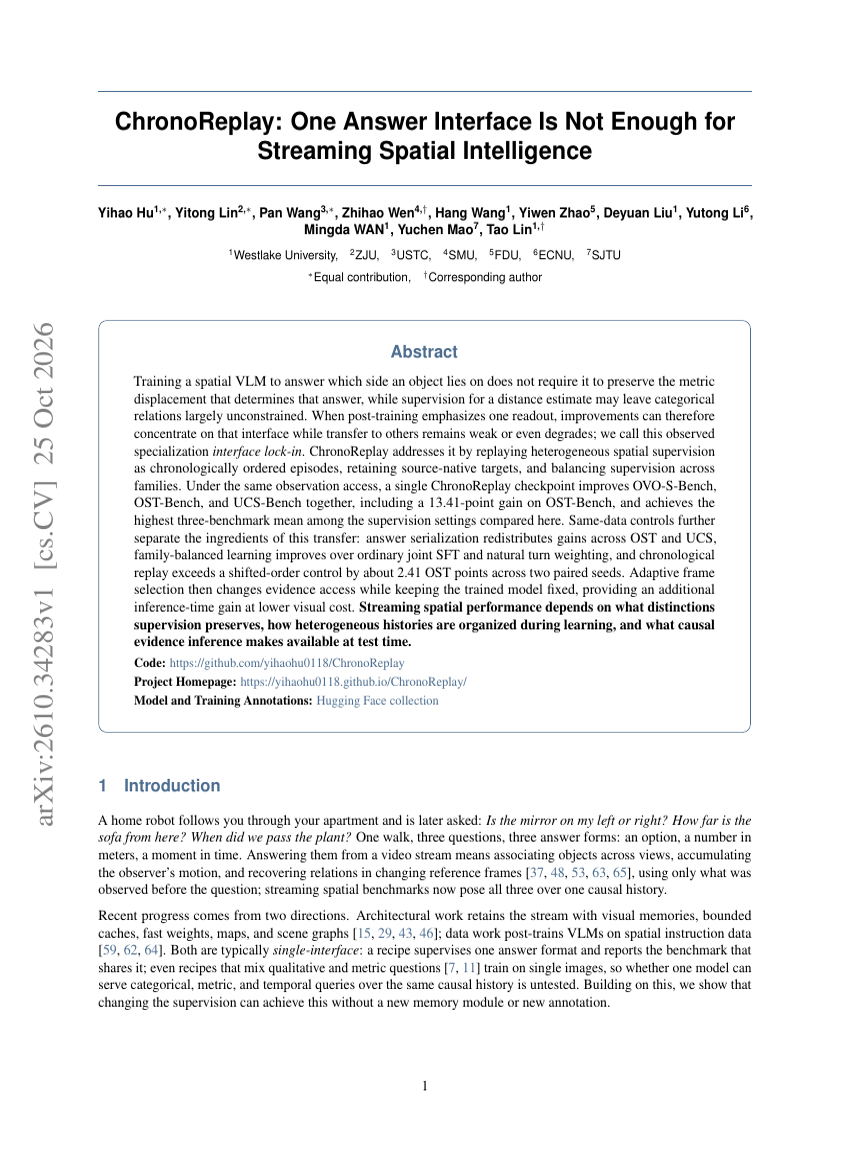
ChronoReplay: ストリーミング空間知能には単一の回答インターフェースでは不十分
自己進化エージェントは継続学習者か?
ワークエージェント:システム・能力・最適化
InteractiveWorld: より良いインタラクティブMLLMアシスタントを構築するための検証可能な人間中心環境
トレースによる試練:AIエージェントハーネスの信頼性と失敗原因帰属のベンチマーク
DynaFlow: 自由形式マルチエージェントオーケストレーションの学習
StreamVibe
Trajectory2Gym: ツール使用エージェントのための決定接地型・構成的インタラクション合成
Omni-Woodpecker: Omni LLMのための証拠-事前知識再均衡化による幻覚補正
RSIHub: エージェント進化手法のためのコンポーザブルなフレームワーク
RynnUnify: 統一的な具現化ブレインを目指して
HiSTEVE 1.0: オープンワールドゲームのためのヒューマンインターフェース型VLAエージェントの活用
USERARENA: 長期視野のショッピングエージェントのための対話型ユーザーシミュレーションのベンチマーク
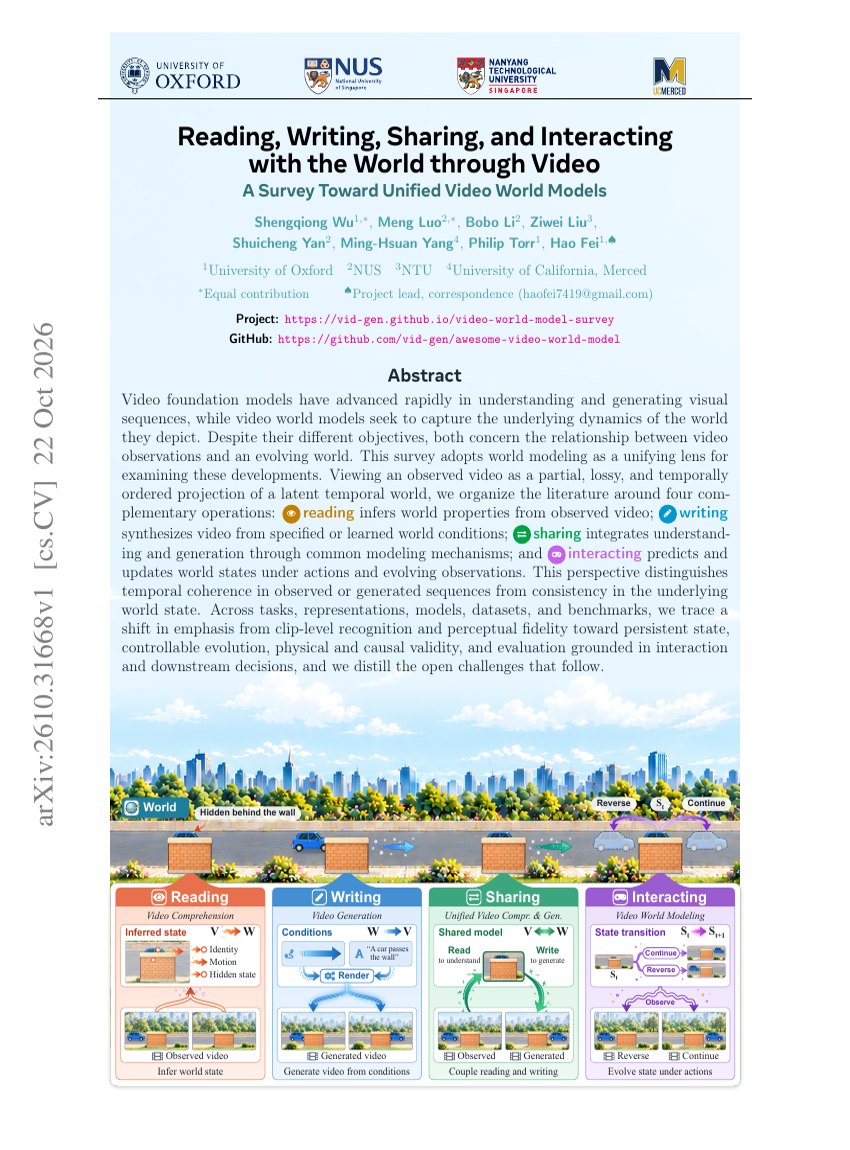
ビデオを通じた世界の読み取り・書き出し・共有・相互作用:統一的なビデオ世界モデルに向けたサーベイ
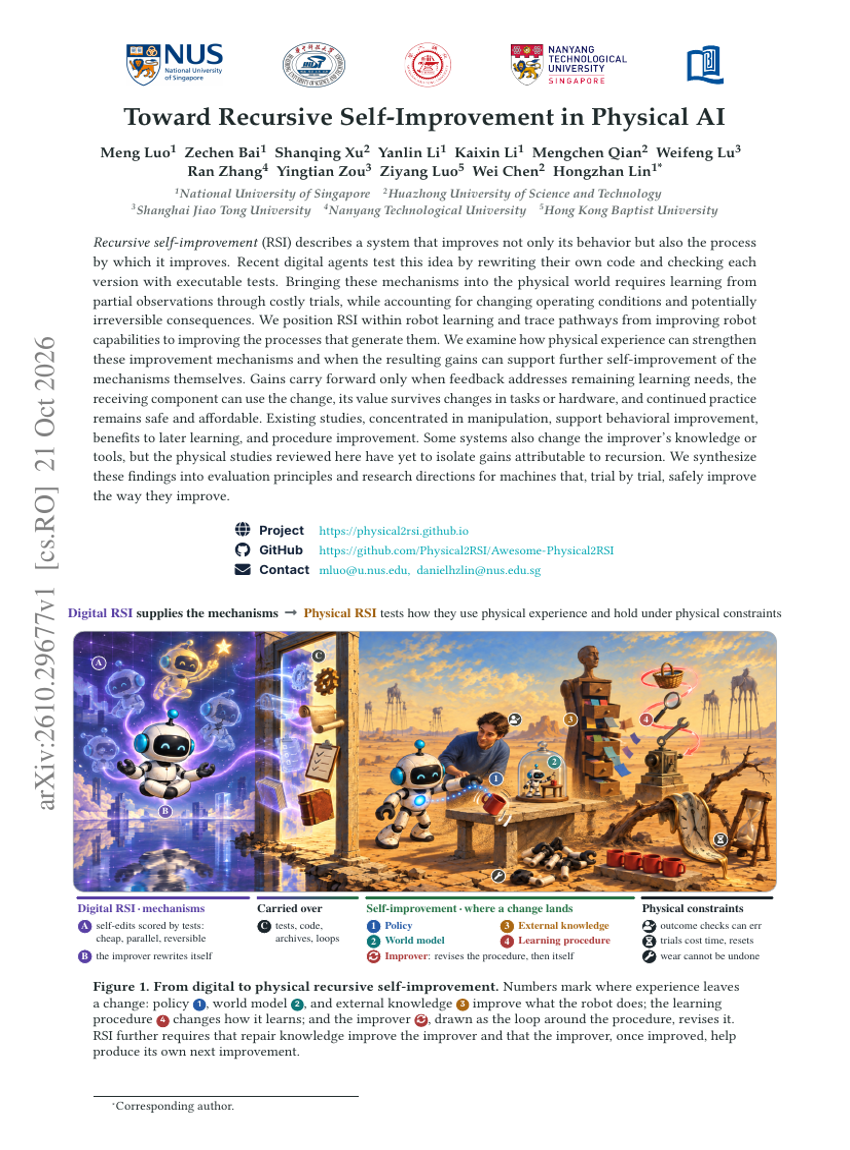
物理AIにおける再帰的自己改善に向けて
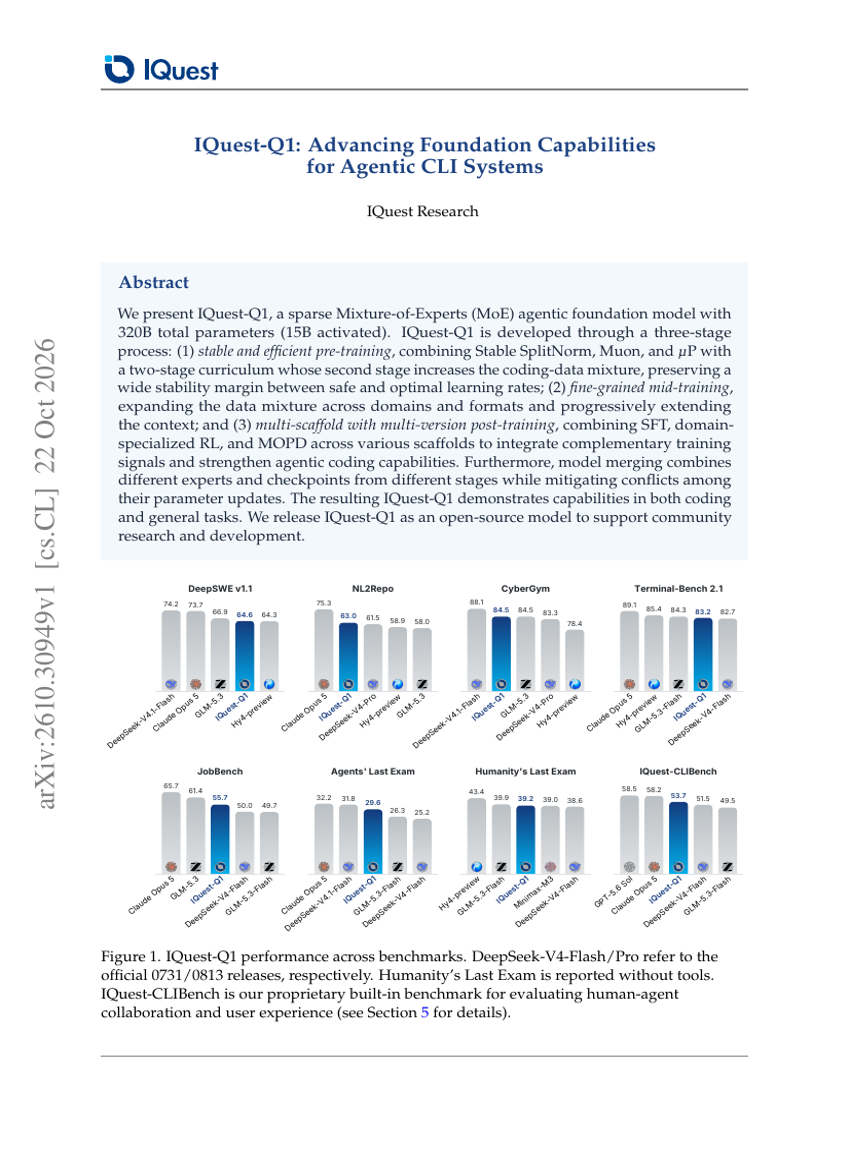
IQuest-Q1: エージェンティックCLIシステムのための基盤能力の向上
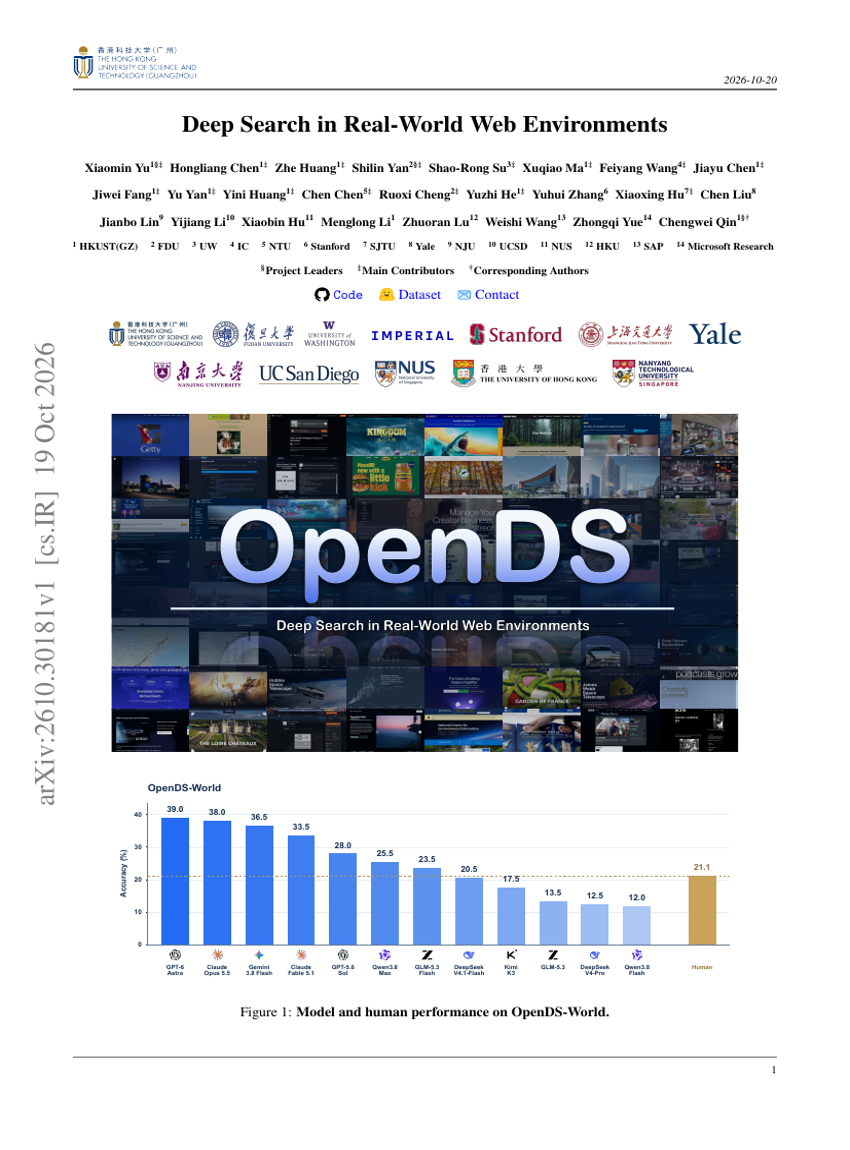
実世界Web環境における深層検索
MLLM潜在表現を有効化する:シネマティック映像生成のための因子認識型予測学習
Compositional Edit-Prior Distillationによる画像の再利用可能なレイヤーへの編集
WeVisOne-VL: 物体からピクセルまでの統一的な視覚認識
長期地平のワークエージェントのための検証可能環境のスケーリング
汎化可能なエージェント型強化学習のためのHarness Scaling
科学のための機械学習の自動化:最先端エージェントは実世界の科学の山々を越えられるか?
実環境におけるエージェント世界モデル:コンピュータ操作エージェント環境の合成
将来を見据える:自己回帰型動画生成における未来の発展のモデル化