HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
UniMoMo: 3次元分子の統一生成モデルによるde novoバインダー設計
対照的な信念更新による報酬追求の測定
LLM-as-a-Coach: 検証不可能なタスクのための経験学習
Apple-π: 物理法則の基盤化に基づく動画生成モデル評価ベンチマーク
HOMIE: マルチモーダル知的拡張による人間-物体中心ビデオパーソナライゼーション
SWE-Pruner Pro: コーダーLLMは刈り込むべき箇所を既に知っている
DeepSearch-World: 検証可能環境における深層探索エージェントのための自己蒸留
EvolvingWorld: 対話型文学世界におけるロールプレイエージェントと世界モデルの共進化のためのオープンスキーマフレームワーク
TimeLens2: マルチモーダルLLMによる汎用動画時間的グラウンディング
事前学習から事後学習に至る推論の理解
AIにおける再帰的自己改善:限定的自己洗練から自律的研究ループへ
ループ・ザ・ルーピーズ!
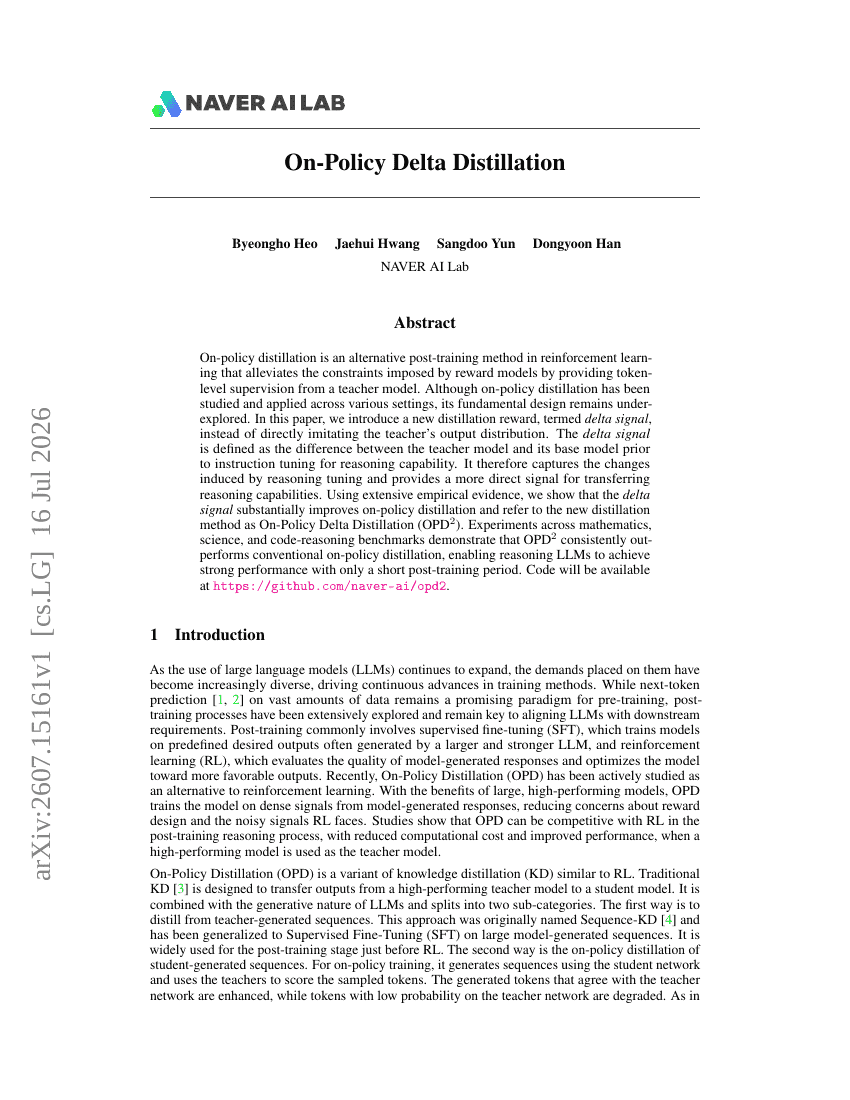
オンポリシー・デルタ蒸留
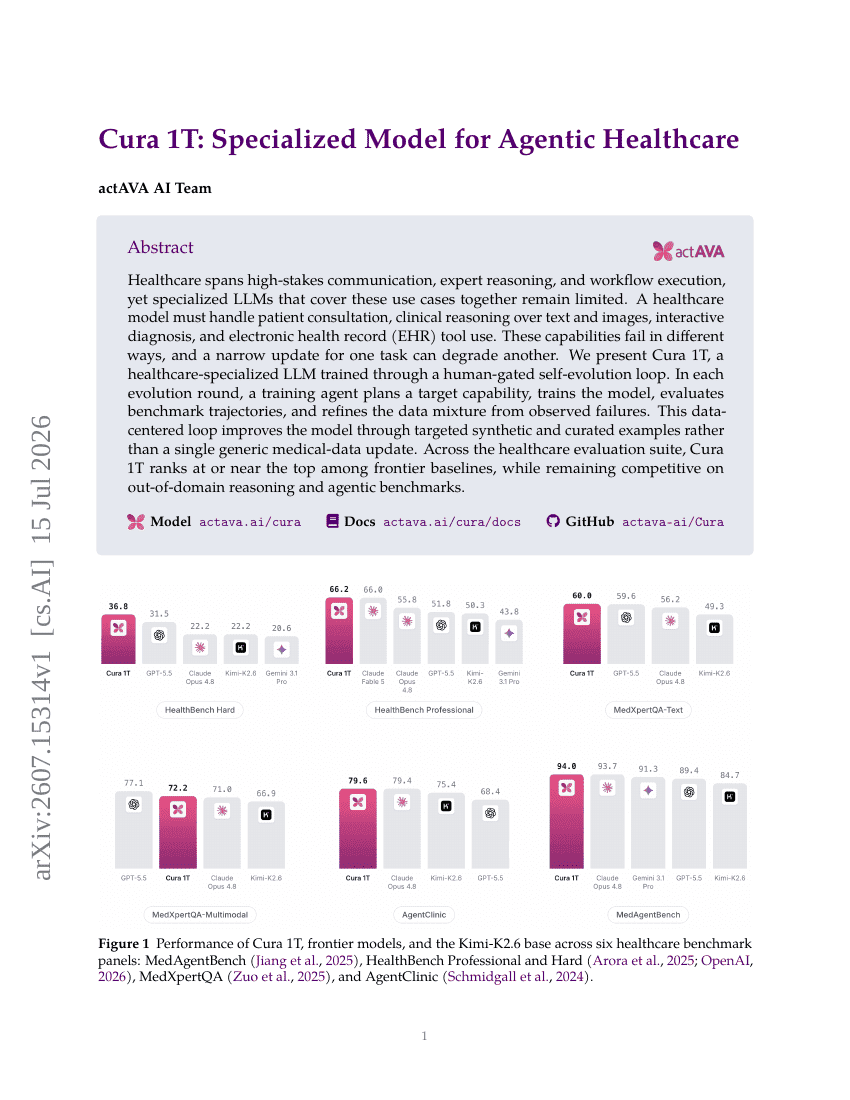
Cura 1T: ヒューマンゲート自己進化ループにより訓練された医療特化型大規模言語モデル
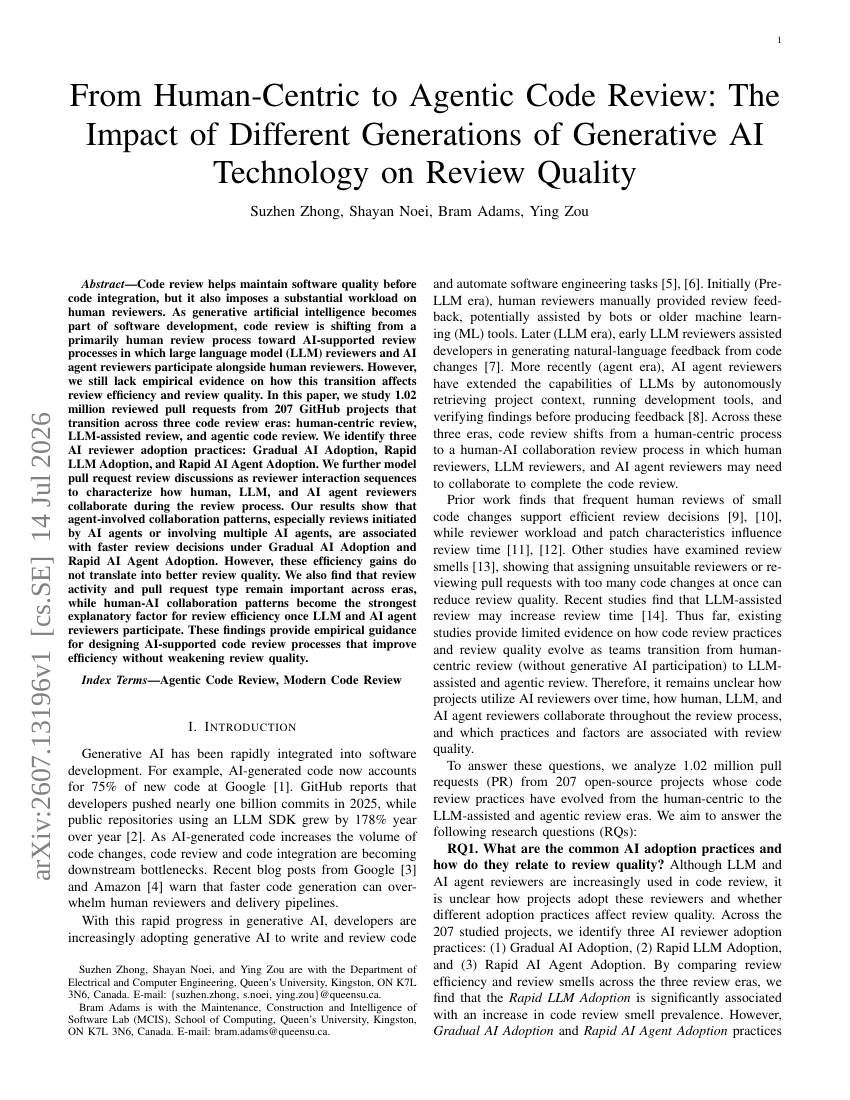
人間中心からエージェント型コードレビューへ:異なる世代の生成AI技術がレビュー品質に与える影響
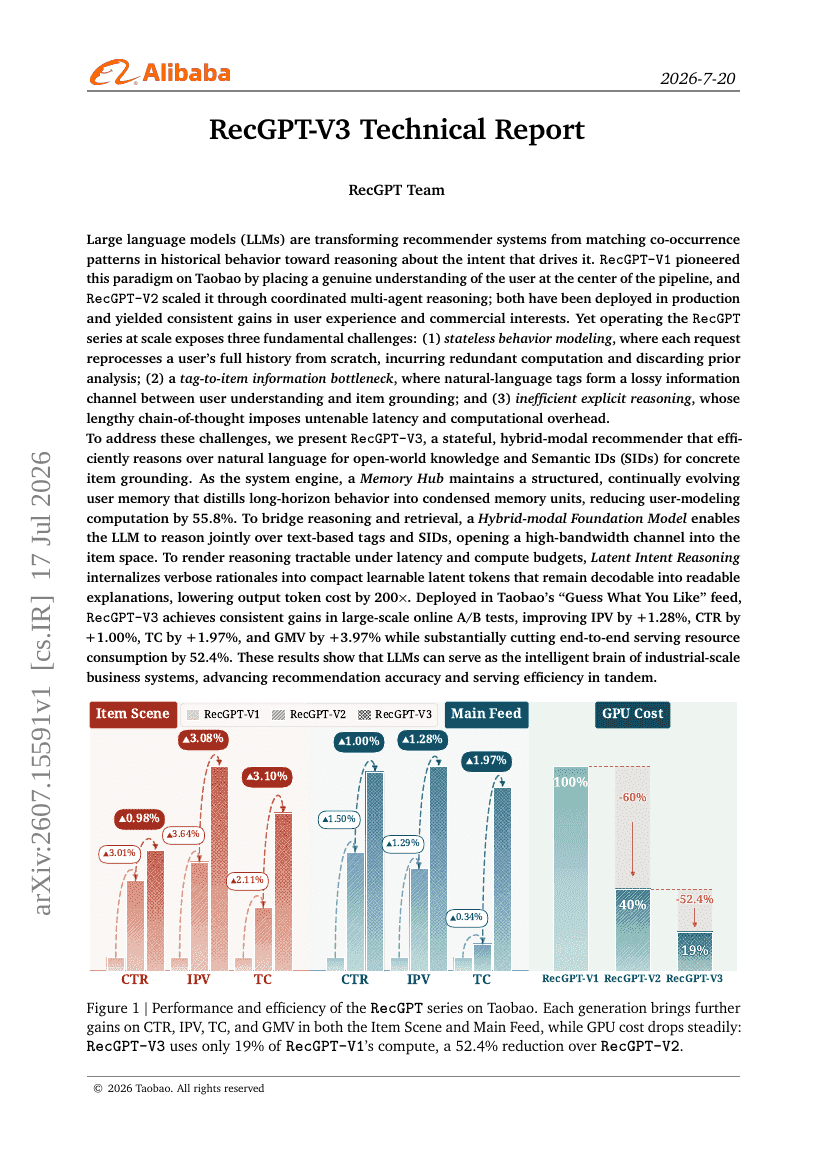
RecGPT-V3 技術レポート
xHC: 拡張ハイパーコネクション
予測的、整合的、かつスケーラブルなロボット学習に向けて
確率的世界モデルのための特徴空間におけるフローマッチング
MiMo-V2.5シリーズのフルパイプライン推論最適化:ハイブリッドSWA効率を限界まで追求
TRACE: 長期エージェントのための信用推定によるターンレベル報酬割り当て
KeyFrame-Compass: キーフレーム条件付き動画生成の包括的評価に向けて
BadWAM: 世界-行動モデルが正しく夢見るが誤って行動するとき
SearchOS-V1 : ロバストなオープンドメイン情報探索エージェント協調に向けて
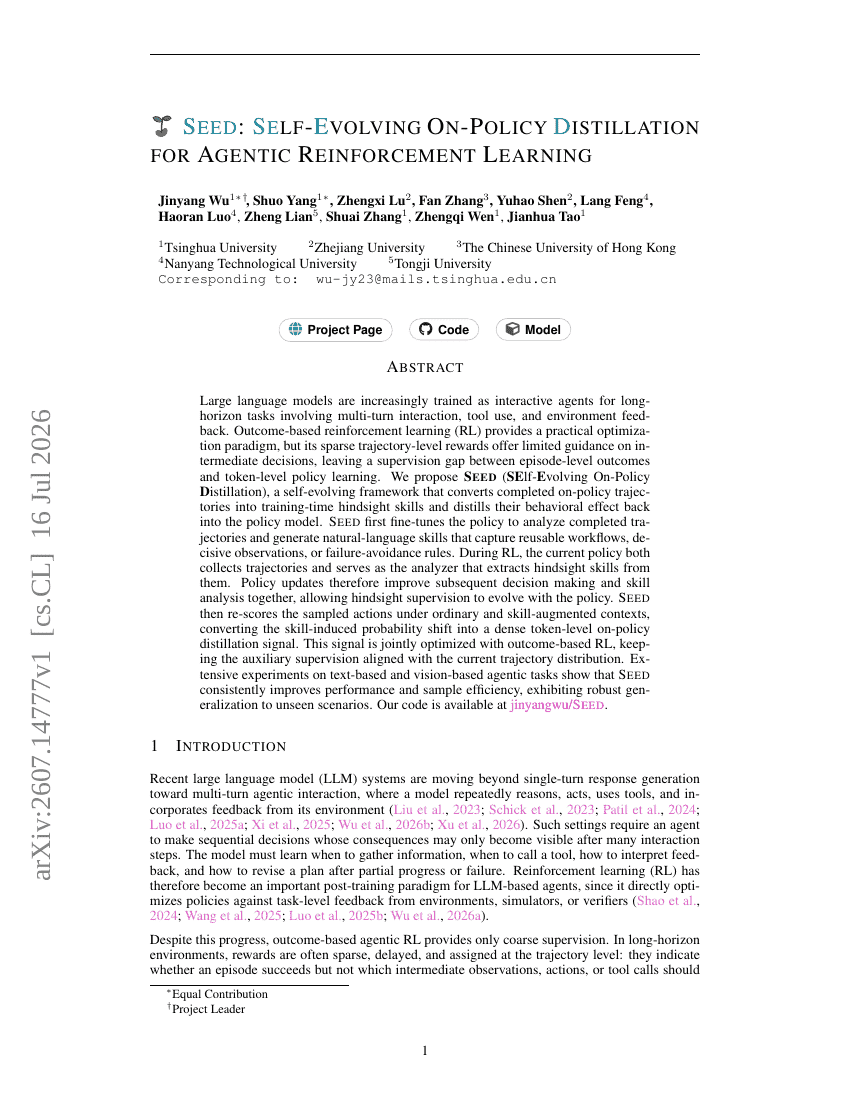
SEED: エージェント型強化学習のための自己進化的オンポリシー蒸留
VideoChat3: 効率的かつ汎用的な動画理解のための完全オープンな動画MLLM
LongStraw: 固定GPU予算下で200万トークンを超える長文脈強化学習
リモートセンシングにおける深層学習:レビュー
深層ニューラルネットワークに基づく音声強調への回帰アプローチ
音声認識における音響モデリングのためのディープニューラルネットワーク
RoboTTT: ロボットポリシーのためのコンテキストスケーリング
SWE-agent: エージェント・コンピュータインタフェースが自動化ソフトウェアエンジニアリングを可能にする