HyperAI
Command Palette
Search for a command to run...
Papers
최신 AI 트렌드를 파악할 수 있도록 매일 업데이트되는 최첨단 AI 연구 논문
개의 논문
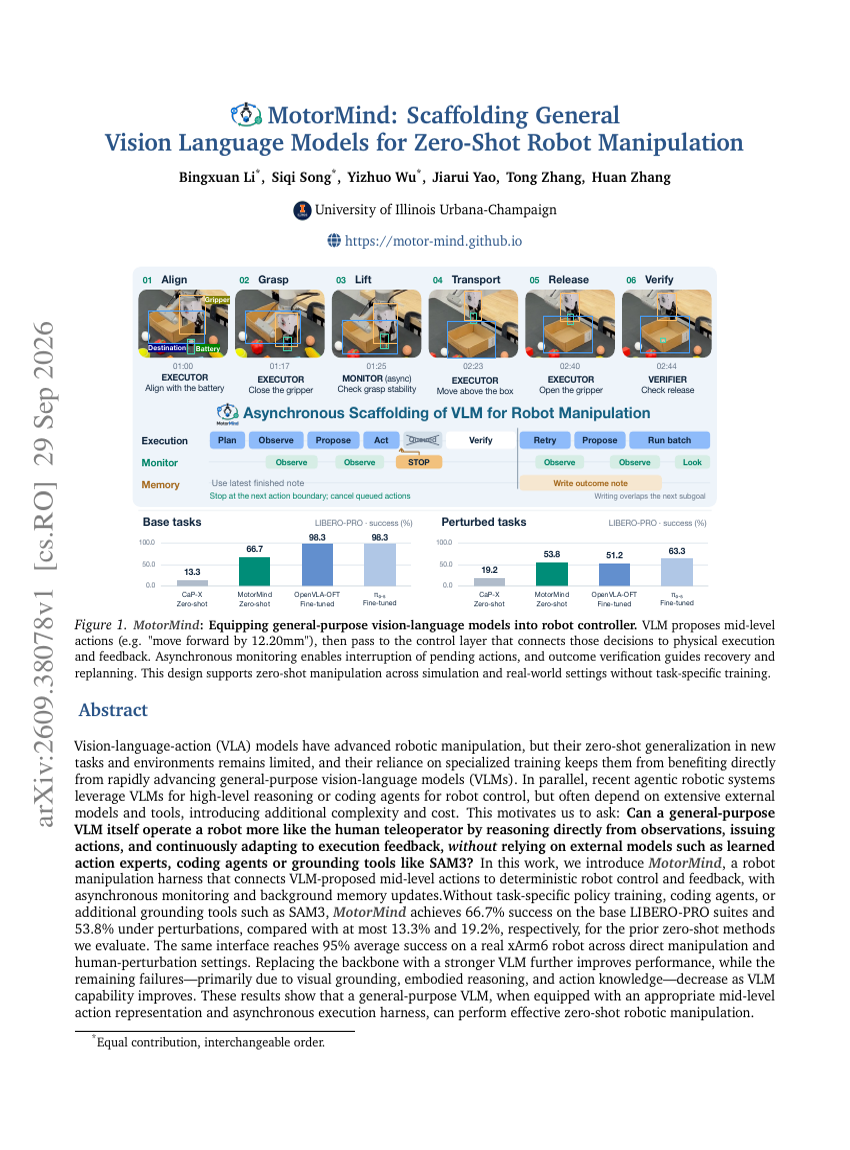
MotorMind: 제로샷 로봇 조작을 위한 범용 비전-언어 모델 스캐폴딩
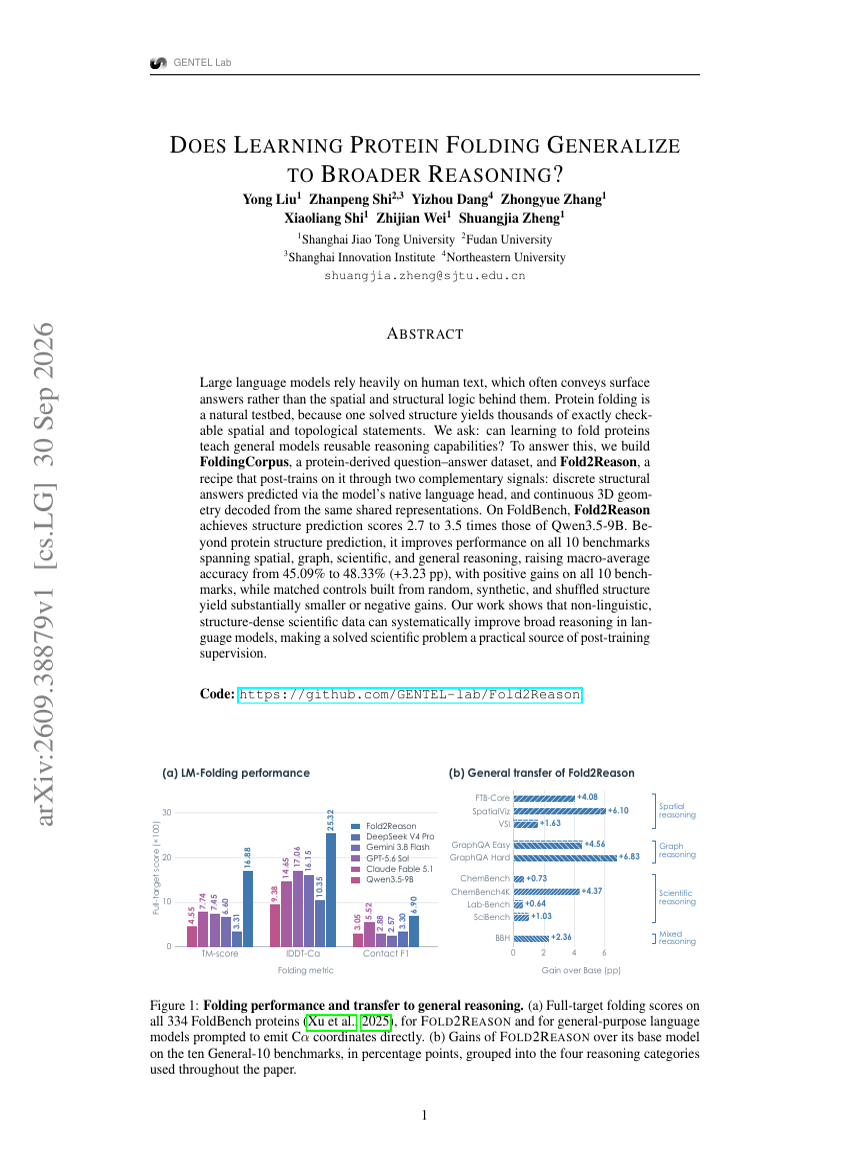
단백질 접힘 학습은 더 광범위한 추론으로 일반화되는가?
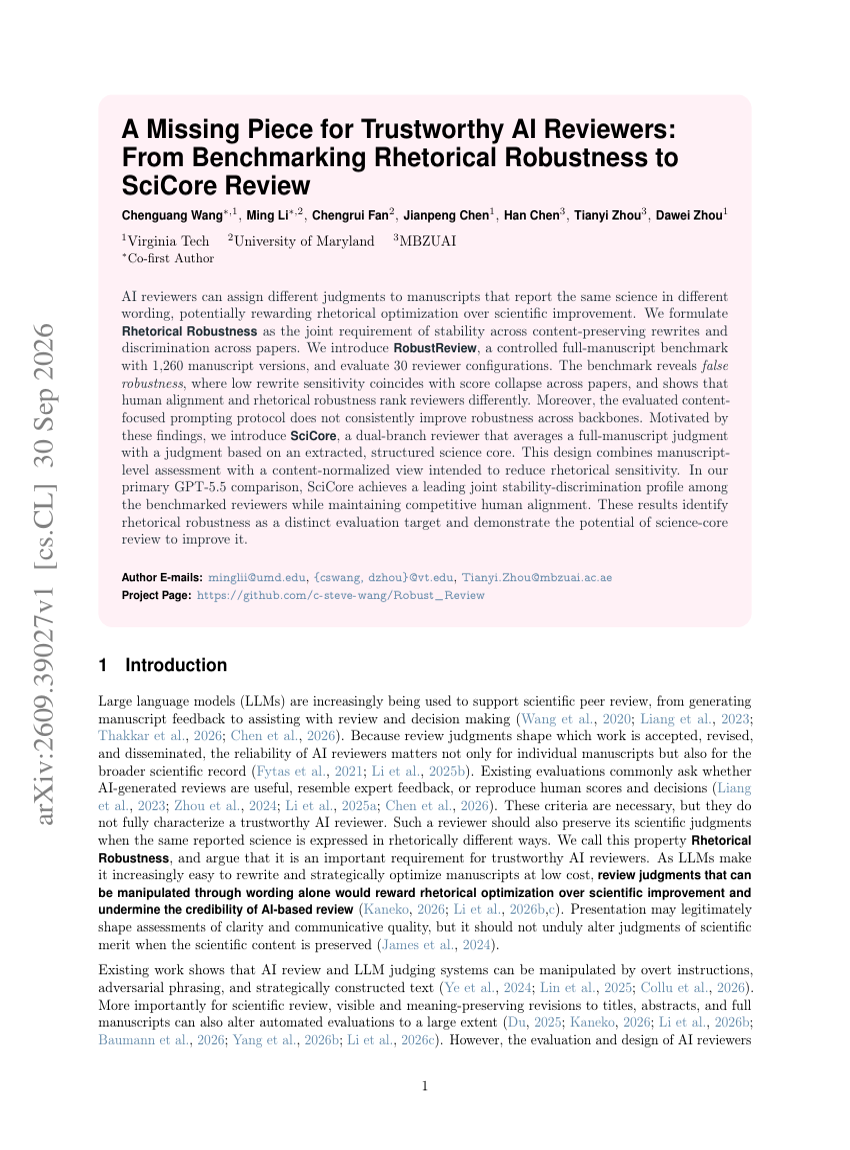
신뢰할 수 있는 AI 리뷰어를 위한 빠진 조각: 수사적 견고성 벤치마킹에서 SciCore 리뷰까지
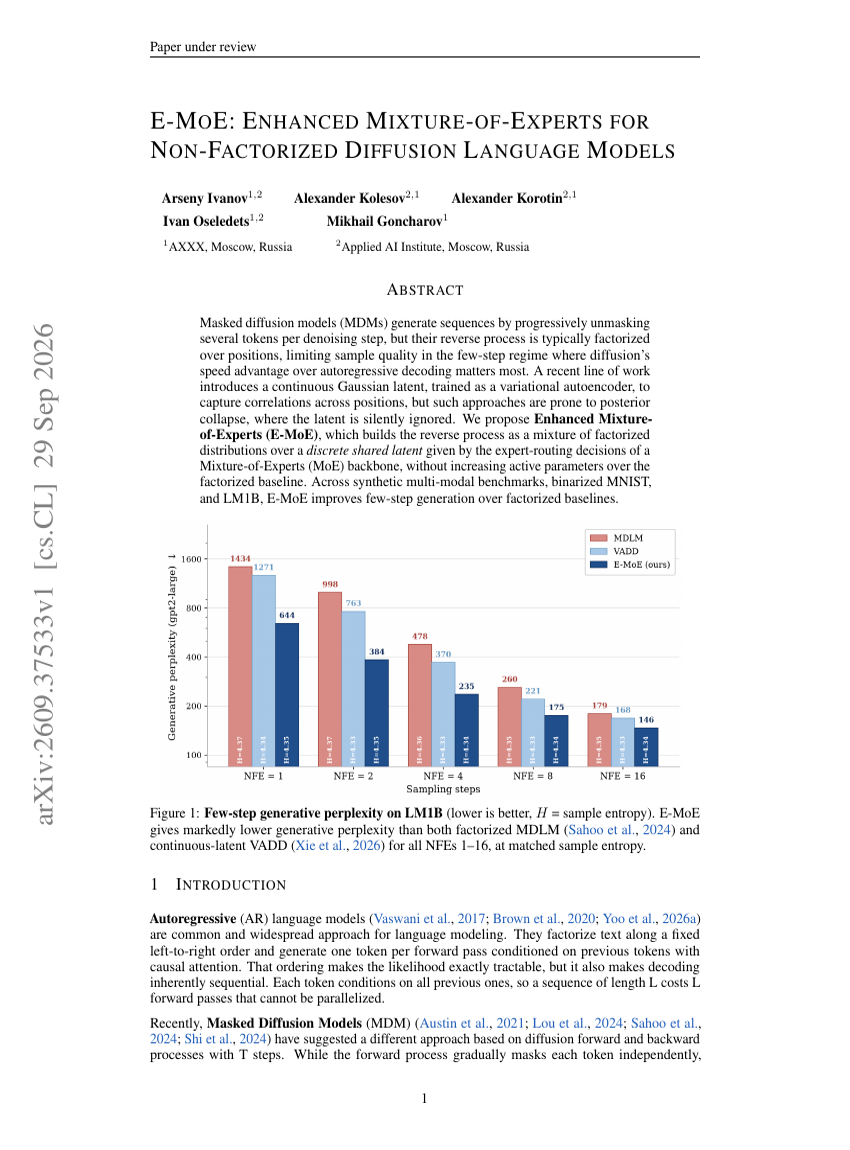
E-MoE: 비인수분해 확산 언어 모델을 위한 강화된 혼합 전문가 모델
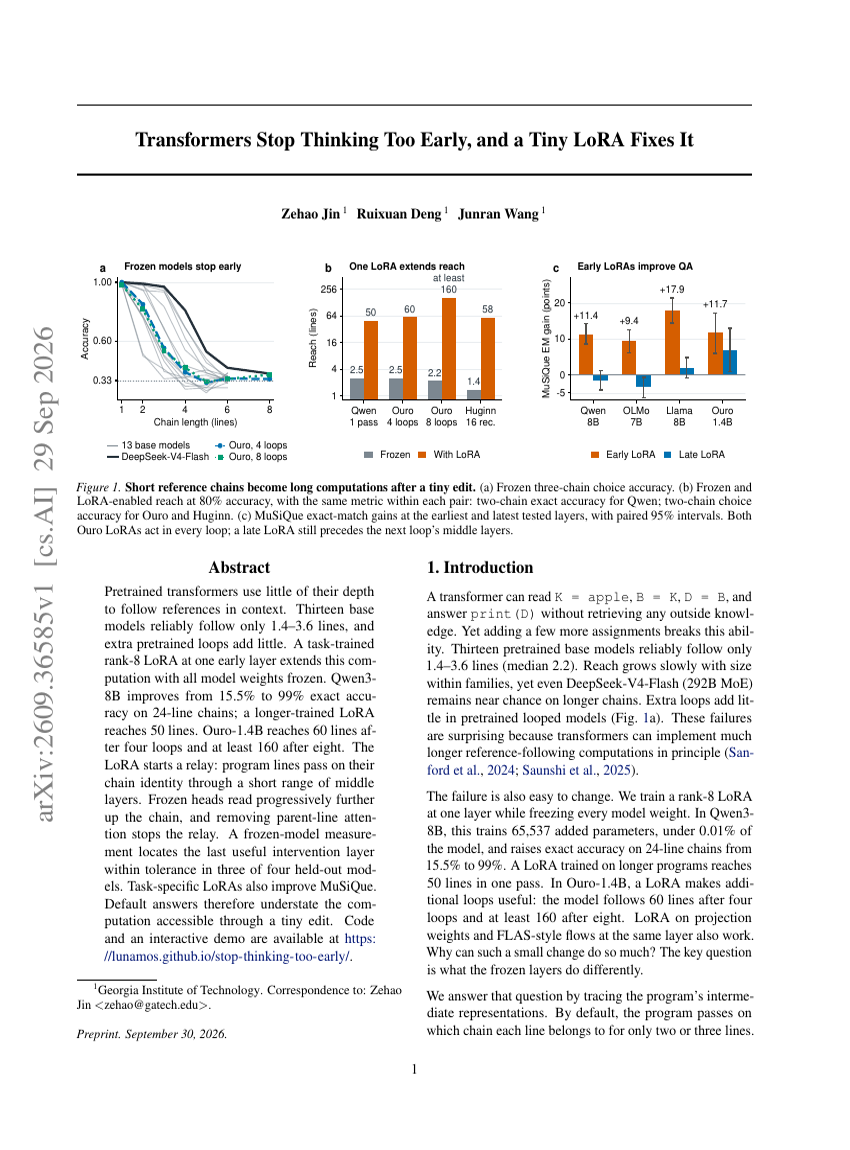
트랜스포머는 너무 일찍 생각을 멈추고, 작은 LoRA가 이를 해결한다
Adaptive Reward Routing: 순방향 프로세스 RL을 통한 결합 오디오-비디오 확산을 위한 동적 다중 보상 최적화
OneStreamer: 스트리밍 비디오 상호작용에서 지각, 기억, 선제적 응답의 통합
온폴리시(On-Policy) 학습인가, 오프폴리시(Off-Policy) 학습인가? 증류 동역학에 대한 체계적 연구
EVODUET: 과학적 발견을 위한 웹 검색과 과제 해결의 이중 계층 공진화
Mid-Harness: 터미널 에이전트를 위한 모델과 하네스 사이의 행동 스케일링
AREX-2: 장기 지평 성찰 과제를 통한 자기 개선 에이전트의 발전
허위 프런티어: 자기 진화형 검색 에이전트의 공동 치팅(co-cheating) 진단 및 완화
UNIEVO-VL: 멀티모달 모델 자기 개선을 위한 온폴리시 자기 증류 학습 레시피
교사는 목적지가 아니라 방향이다: 온폴리시 증류에서 RL 유도 표현 잔차의 외삽
무엇이 월드 액션 모델의 일반화를 이끄는가: 테스트 시점 미래 모델링에 대한 실증 연구
MaLiang-Harness: 이미지 및 비디오 생성을 위한 프로그래밍 가능한 경로
PanoVLN: 효과적인 파노라마 비전-언어 내비게이션을 향하여
VoxMem: 대규모 오디오 언어 모델의 멀티모달 메모리 벤치마킹
Omni-IO Skills: 에이전트를 옴니 네이티브로 만드는 하네스
Raven: 구성 가능한 에이전틱 지능을 위한 하네스들의 하네스
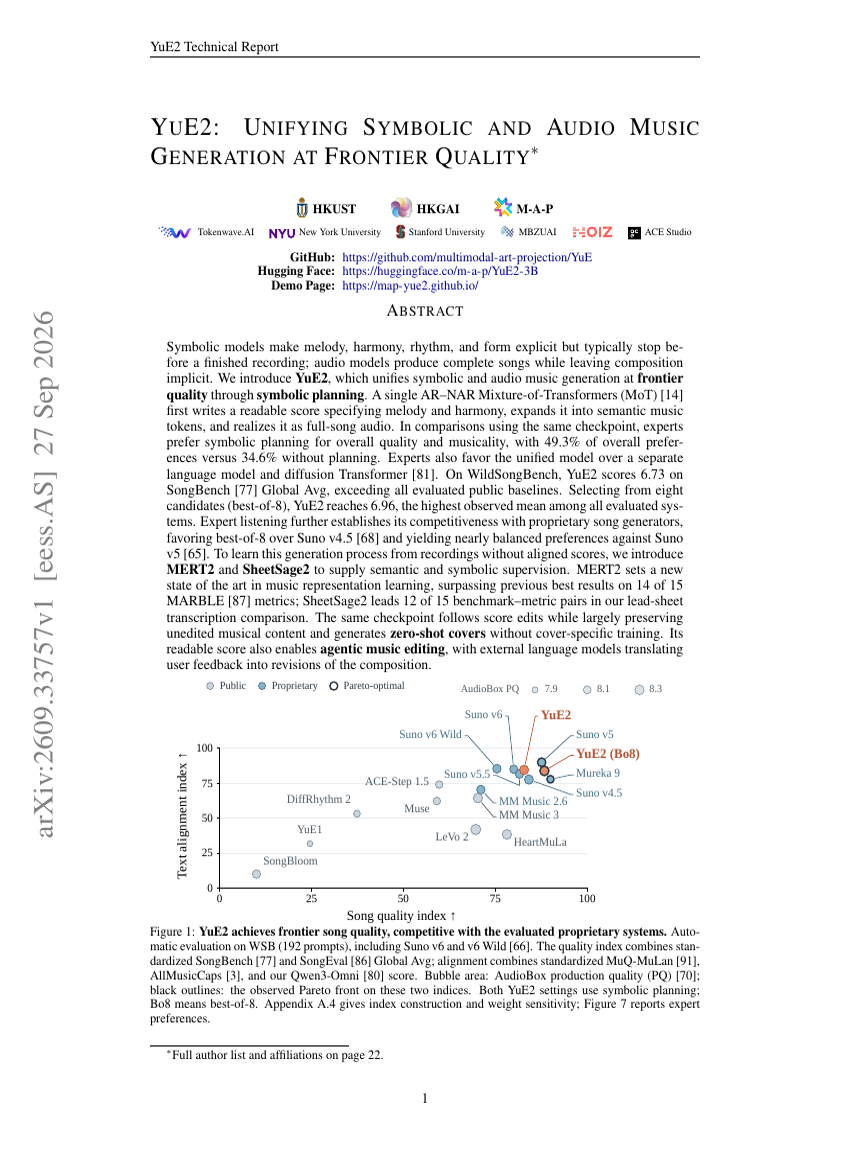
YUE2: 기호 및 오디오 음악 생성을 최첨단 품질로 통합
코드 에이전트 RL을 위한 그룹 단위 에이전트 평가 및 어드밴티지 재분배
비주얼 인코더 제거까지 우리는 얼마나 멀리 있는가? 인코더-프리 멀티모달 사전학습을 위한 스케일링 법칙
Duplex-MPE: 전이중 대화에서의 다자 간 상호작용 벤치마킹
사후 학습은 무관한 결정에 행동적 그림자를 남긴다
교사 할당을 넘어서: 도메인 정규화 다중 교사 온폴리시 증류
사전 학습된 확산 모델과 멀티모달 조건화를 활용한 사진측량 기반 수치 표면 모델 개선
Tactile-JEPA: 분산 촉각 센서를 위한 토폴로지 인지 자기지도 표현 학습
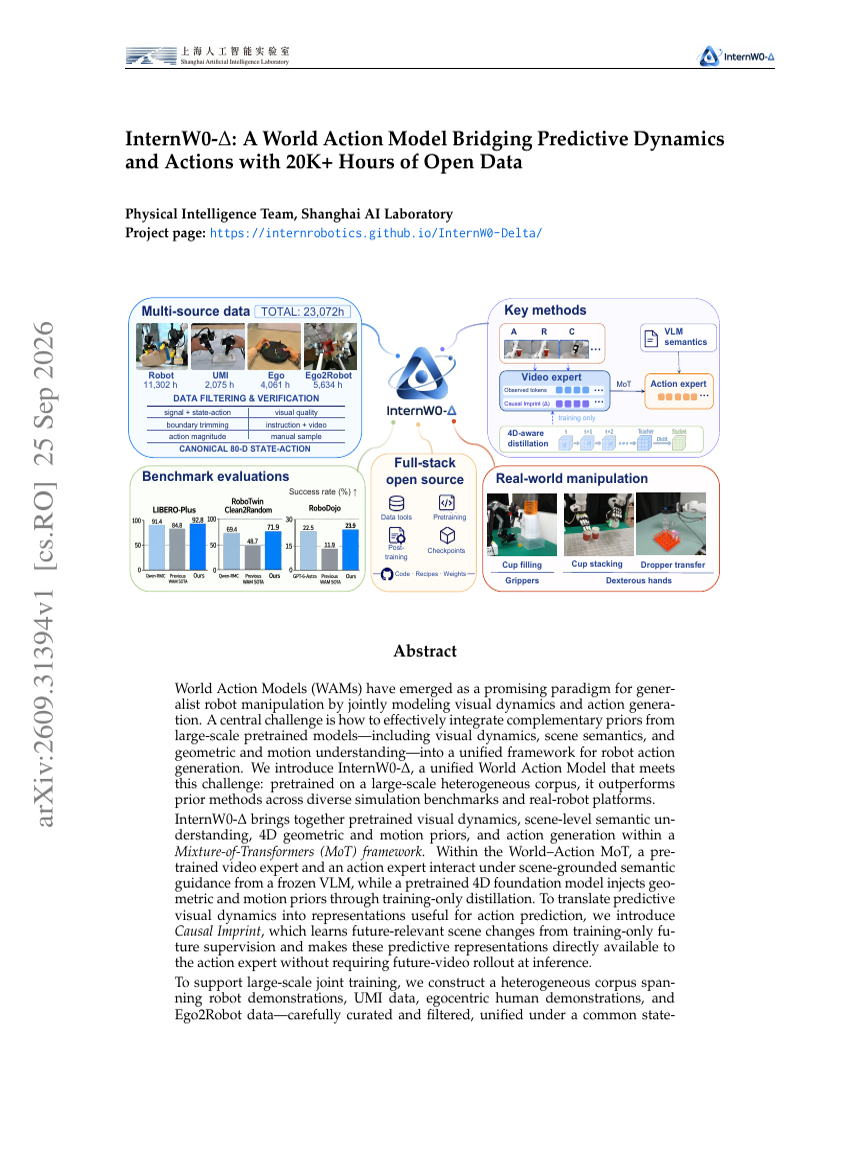
InternW0-∆: 예측 동역학과 행동을 연결하고 2만 시간 이상의 오픈 데이터를 활용하는 월드 액션 모델
로그-선형 복잡도를 갖는 블록 희소 어텐션
RayOrch: 파운데이션 모델 데이터 준비를 위한 계보 제어형 다중 입도 데이터플로우 프로그래밍 및 실행
FuseReg: 레이어 융합 정규화가 표현 오토인코더의 재구성-생성 간극을 완화한다