HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
Adaptive Reward Routing:前方過程RLによる音声・映像統合拡散のための動的マルチ報酬最適化
OneStreamer: ストリーミング動画対話における知覚・記憶・能動的応答の統合
オンポリシー学習かオフポリシー学習か?蒸留ダイナミクスの系統的研究
EVODUET: 科学的発見のためのウェブ検索とタスク解決の二レベル共進化
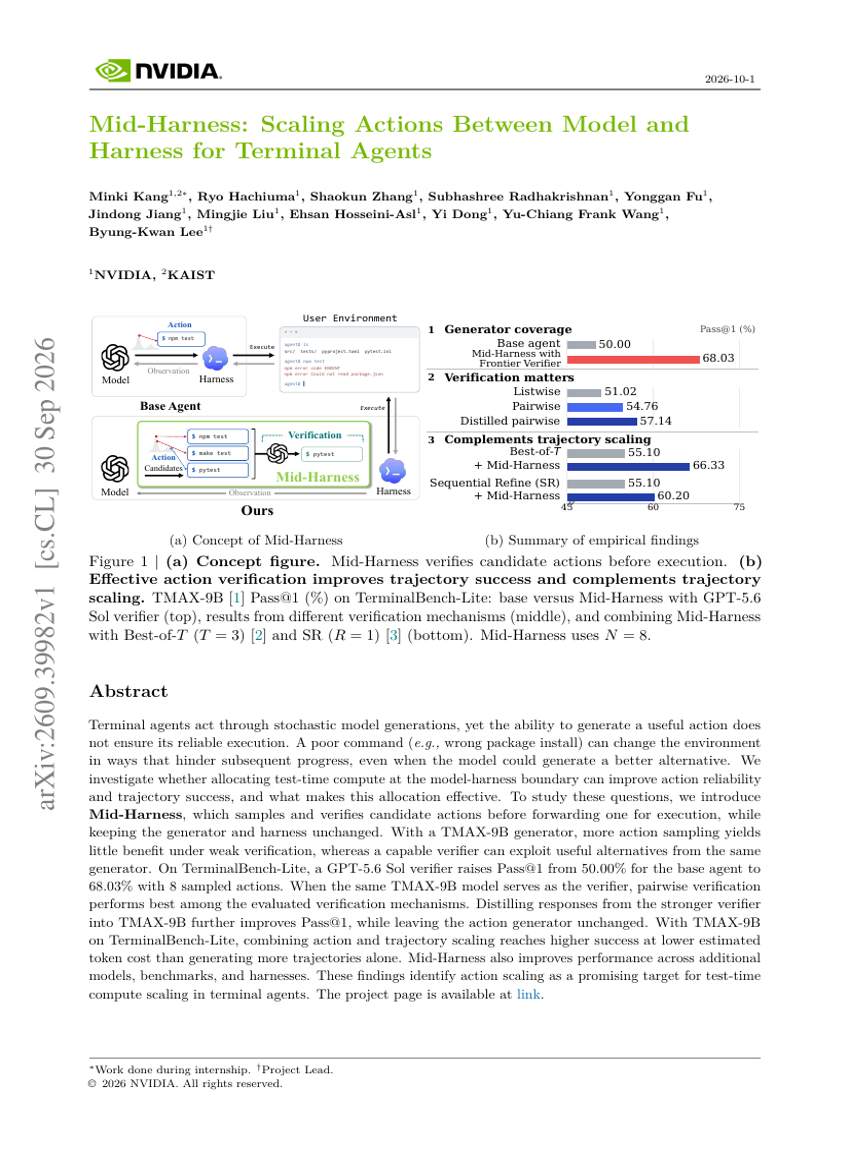
Mid-Harness: ターミナルエージェントのためのモデルとハーネス間におけるアクションのスケーリング
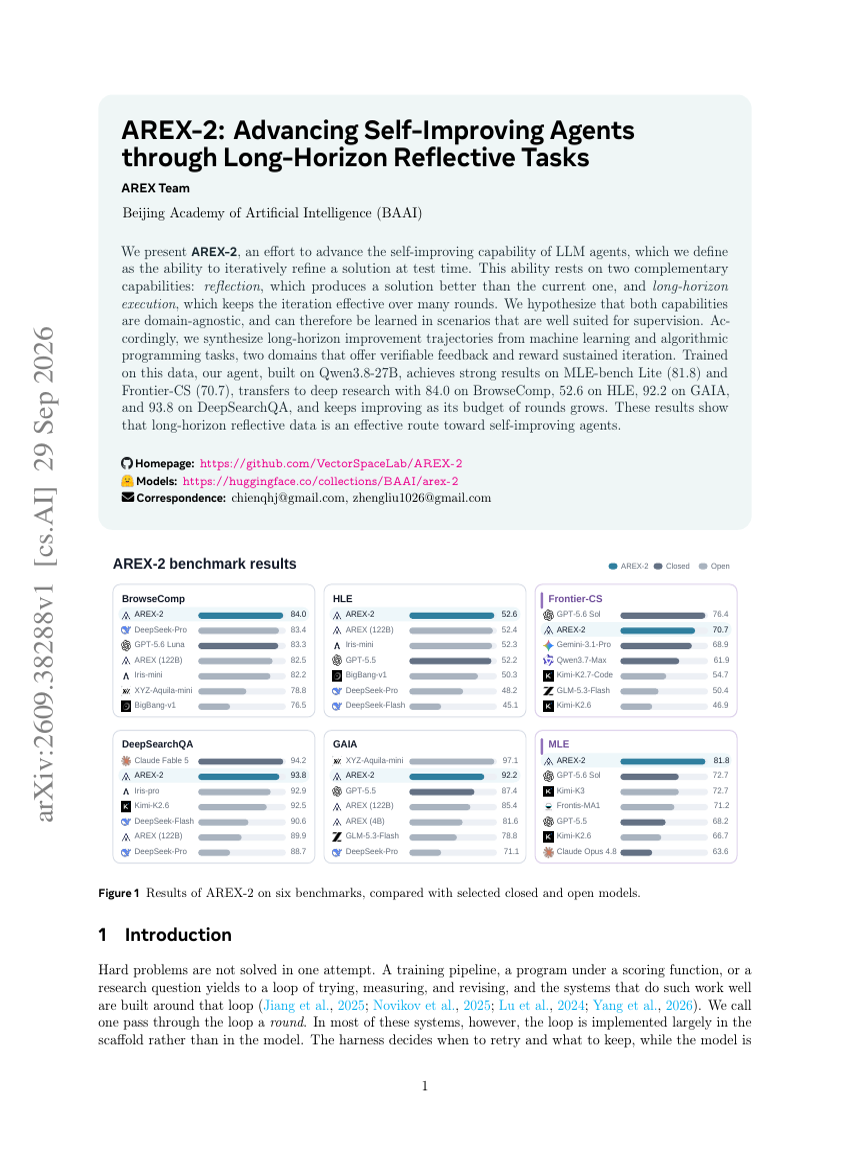
AREX-2: 長期的リフレクション課題を通じた自己改善エージェントの高度化
偽りのフロンティア:自己進化型探索エージェントにおける共謀(co-cheating)の診断と緩和
UNIEVO-VL: マルチモーダルモデル自己改善のためのオンポリシー自己蒸留訓練手法
教師は目的地ではなく方向である:オンポリシー蒸留におけるRL誘導表現残差の外挿
World Action Modelsの汎化を促すものは何か?テスト時未来モデリングに関する実証的研究
MaLiang-Harness: 画像・動画生成へのプログラム可能な経路
PanoVLN: 効果的なパノラマ視覚言語ナビゲーションに向けて
VoxMem: 大規模オーディオ言語モデルにおけるマルチモーダル記憶のベンチマーク評価
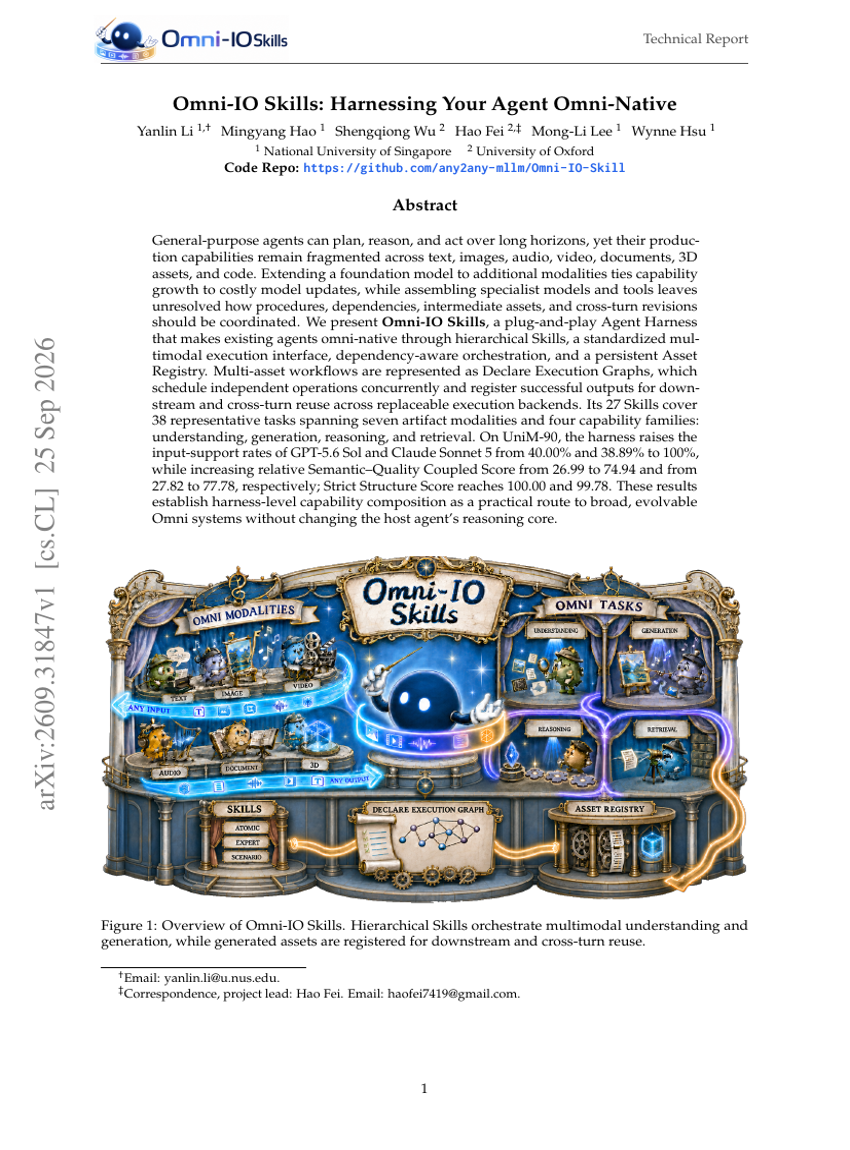
Omni-IO Skills: エージェントをオムニネイティブにするハーネス
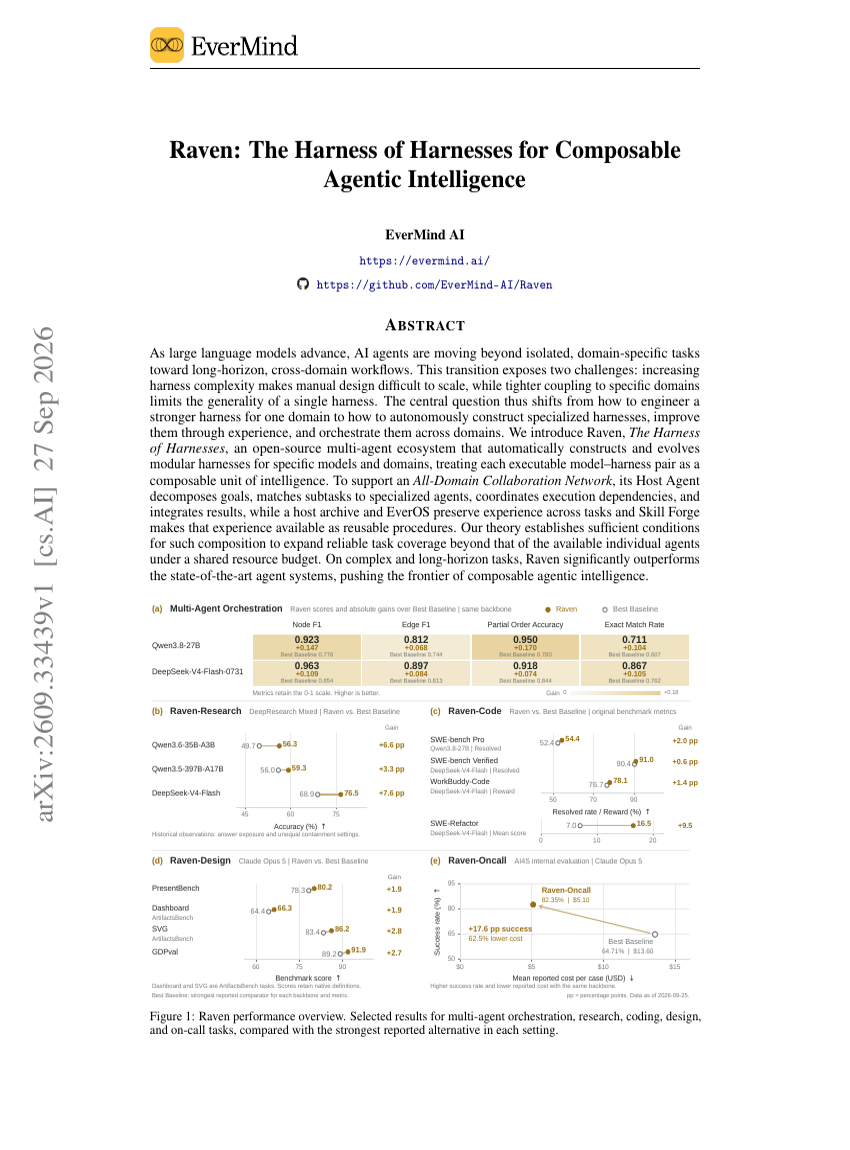
Raven: 構成可能なエージェント的知能のためのハーネスのハーネス
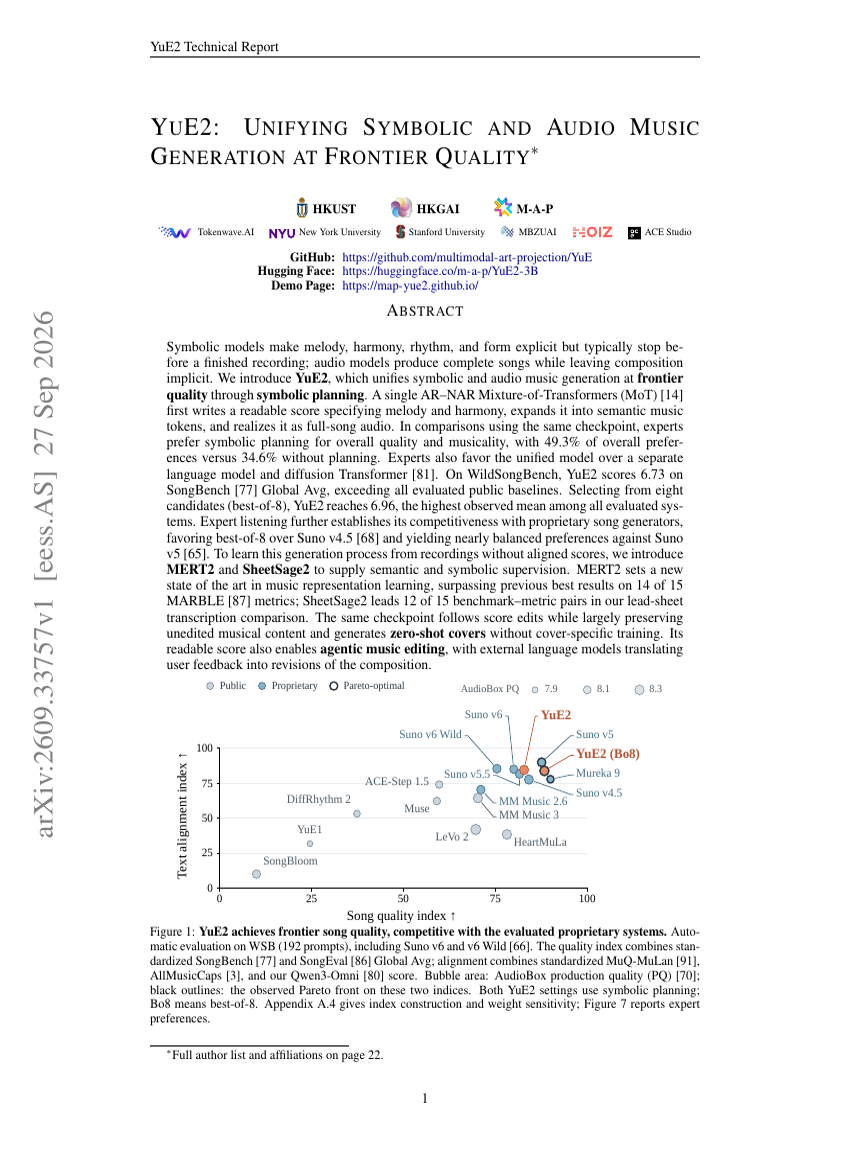
YUE2: 最先端品質での記号的音楽生成とオーディオ音楽生成の統合
コードエージェントRLのためのグループ単位エージェント型評価とアドバンテージ再分配
視覚エンコーダの除去まであとどのくらいか:エンコーダフリー・マルチモーダル事前学習のスケーリング則
Duplex-MPE: 全二重対話における多人数インタラクションのベンチマーク
ポストトレーニングは無関係な決定に行動の影を残す
教師割り当てを超えて:ドメイン正規化マルチ教師オンポリシー蒸留
事前学習済み拡散モデルとマルチモーダル条件付けによる写真測量数値表層モデルの高精度化
Tactile-JEPA:分散触覚センサのためのトポロジー認識型自己教師あり表現学習
InternW0-∆: 20K時間超のオープンデータにより予測的ダイナミクスと行動を橋渡しする世界行動モデル
対数線形計算量を実現するブロックスパース注意機構
RayOrch: 基盤モデルデータ準備のためのリネージ制御型マルチ粒度データフローのプログラミングと実行
FuseReg: 層融合の正則化が表現オートエンコーダにおける再構成–生成ギャップを緩和する
Rufus-Air: オープンなLLMポストトレーニングレシピ
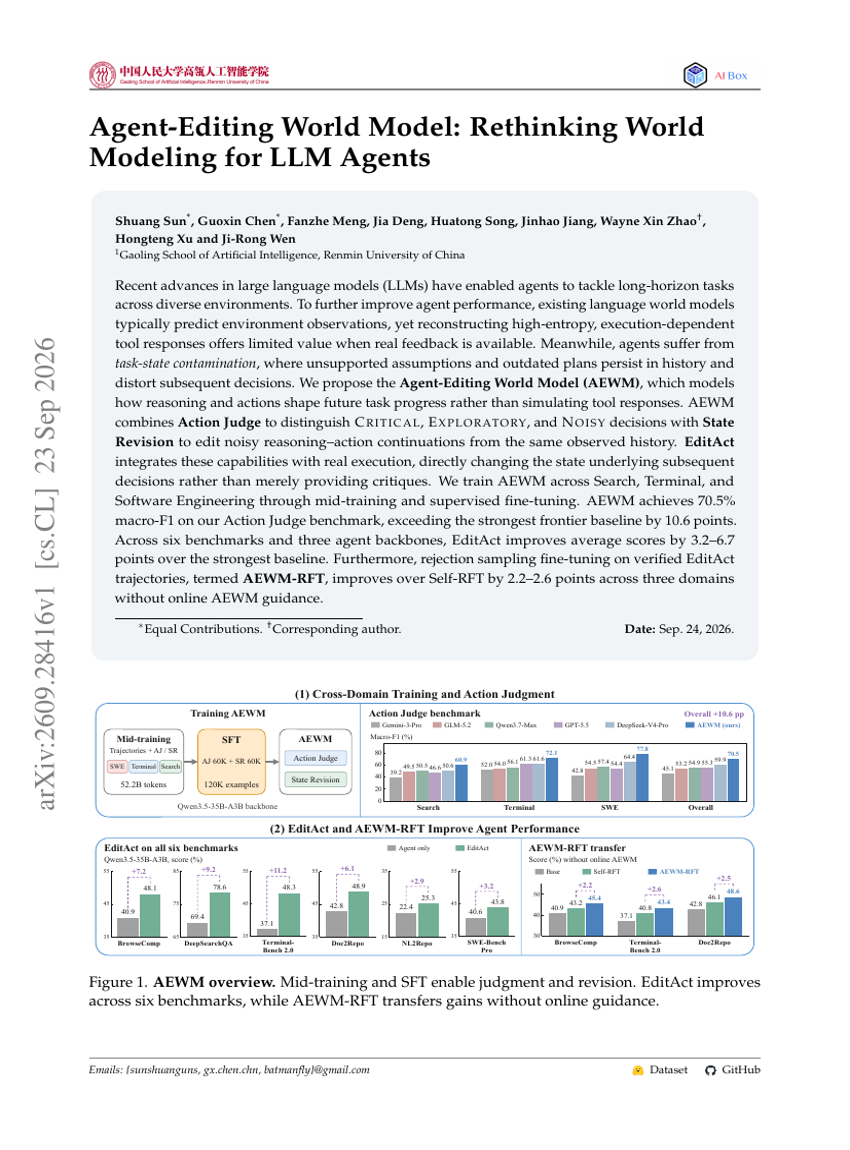
Agent-Editing World Model: LLMエージェントのための世界モデリング再考
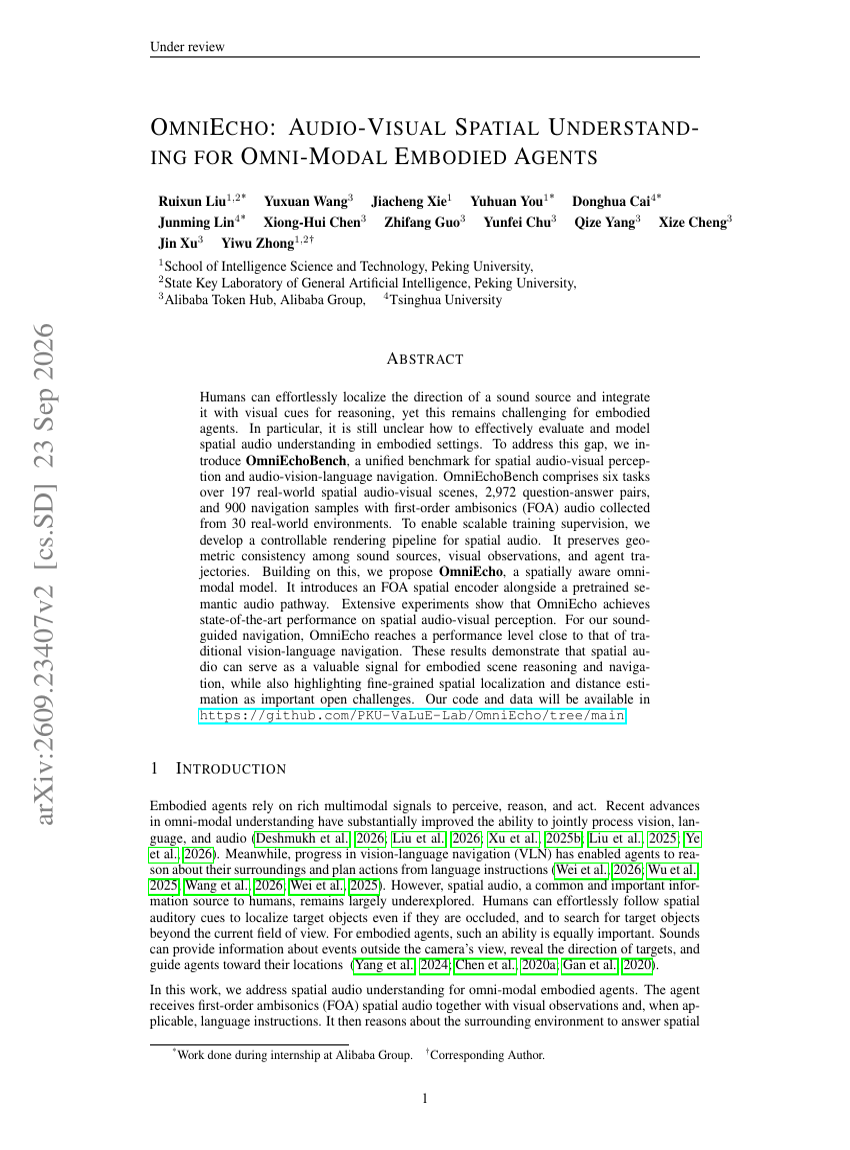
OMNIECHO: オムニモーダル身体化エージェントのための音声・視覚空間理解
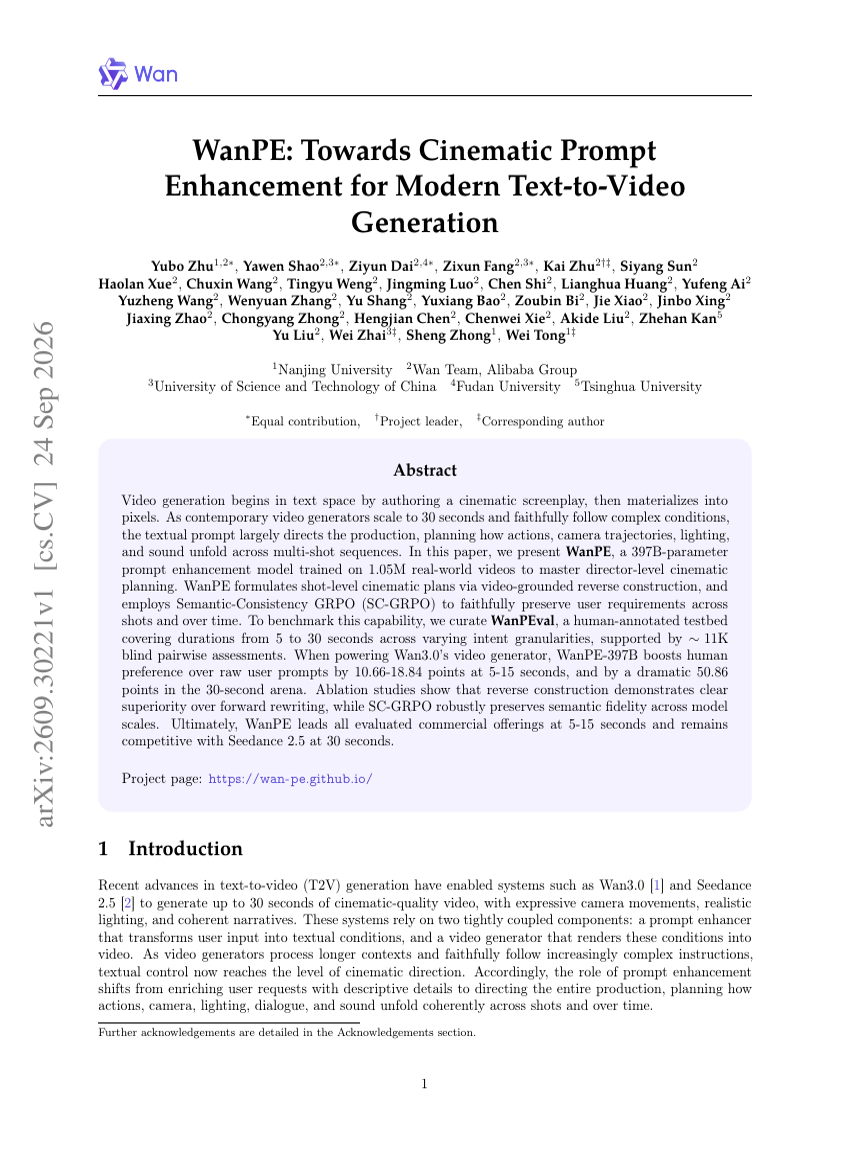
WanPE:現代のテキスト動画生成のための映画的プロンプト強化に向けて
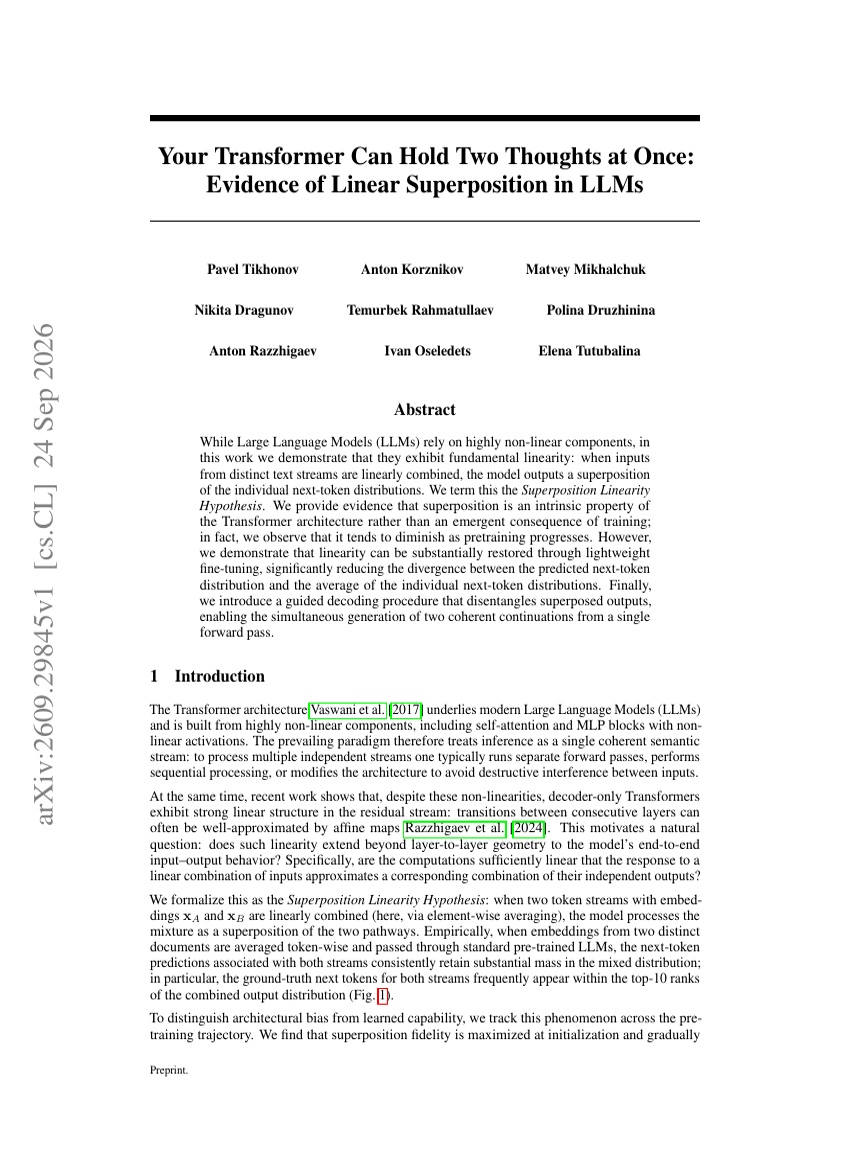
Transformerは同時に二つの思考を保持できる:LLMにおける線形重ね合わせの証拠