HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
MJev-Spatial: ネイティブな注意マッチングによるシステム1空間知能
Waypoint-OPD: ゲート付きオンポリシー蒸留によるRL誘発方策シフトの転移
TeleChat3-MoE の訓練報告
RuleTrek: 複雑なシナリオにおけるエージェント型ルール推論のベンチマーク
批評誘導型オンポリシー蒸留による信頼できる教師信号の回復
Doc2Harness:コーディングエージェントの長期ハーネスエンジニアリングにおけるLLMのベンチマーク
ドメインルーティング型監督を超えて:複数教師オンポリシー蒸留のためのCross-Teacher Guarding
PLAYER-1: 合成経験からゲームプレイを学習する
Any Time, Any Space: エージェント型動画生成のための世界状態中心フレームワーク
AesCode: 分離型クロスモーダル報酬による美的コード生成
GreenWAM: ロボティクスのための世界基盤モデル
Urbex: 都市スケール3Dシーンのためのエージェント型空間グラウンディング
Agent-Reflex: 言語エージェントに内省的行動を教える
VideoJev: ビデオ理解とインタラクションのためのSystem Oneモデル
Jeva: 第一原理に基づくシステム1モデル
マルチストリーム注意残差(Multi-Stream Attention Residuals)
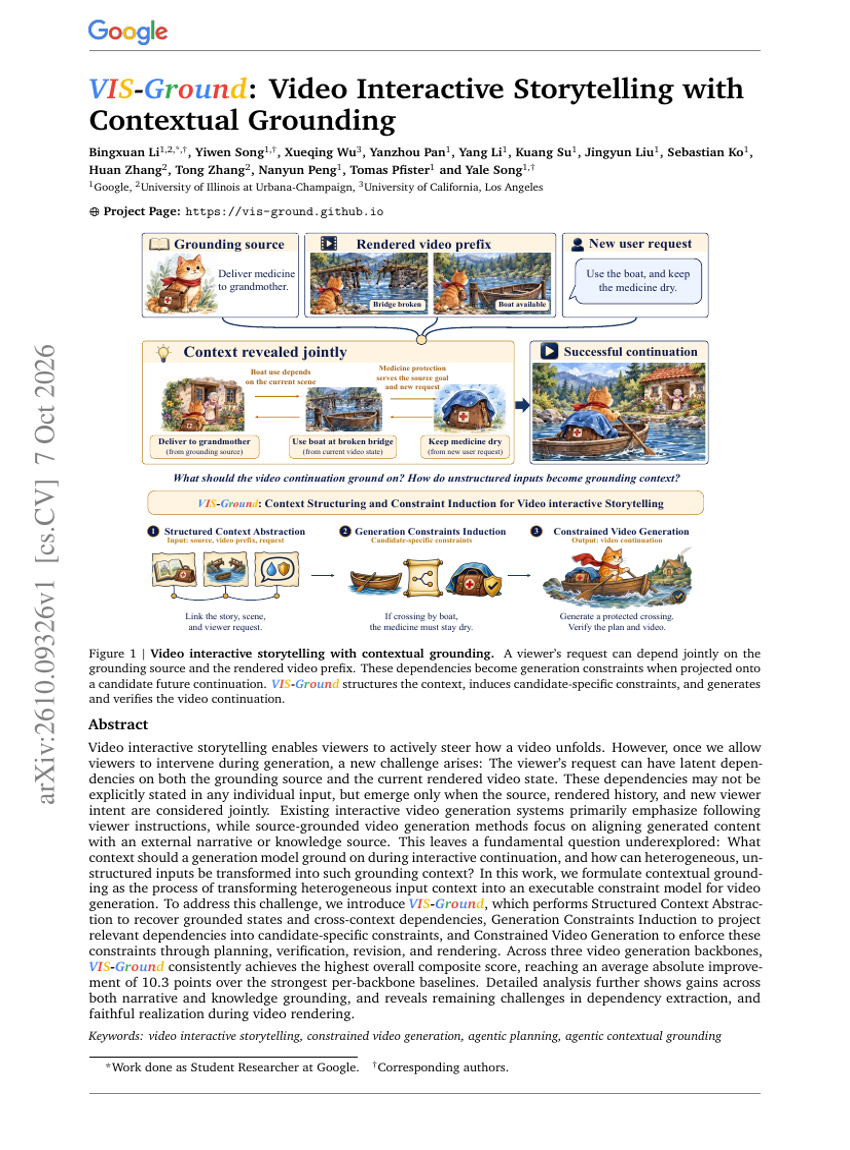
VIS-Ground: 文脈的グラウンディングを伴うビデオインタラクティブストーリーテリング
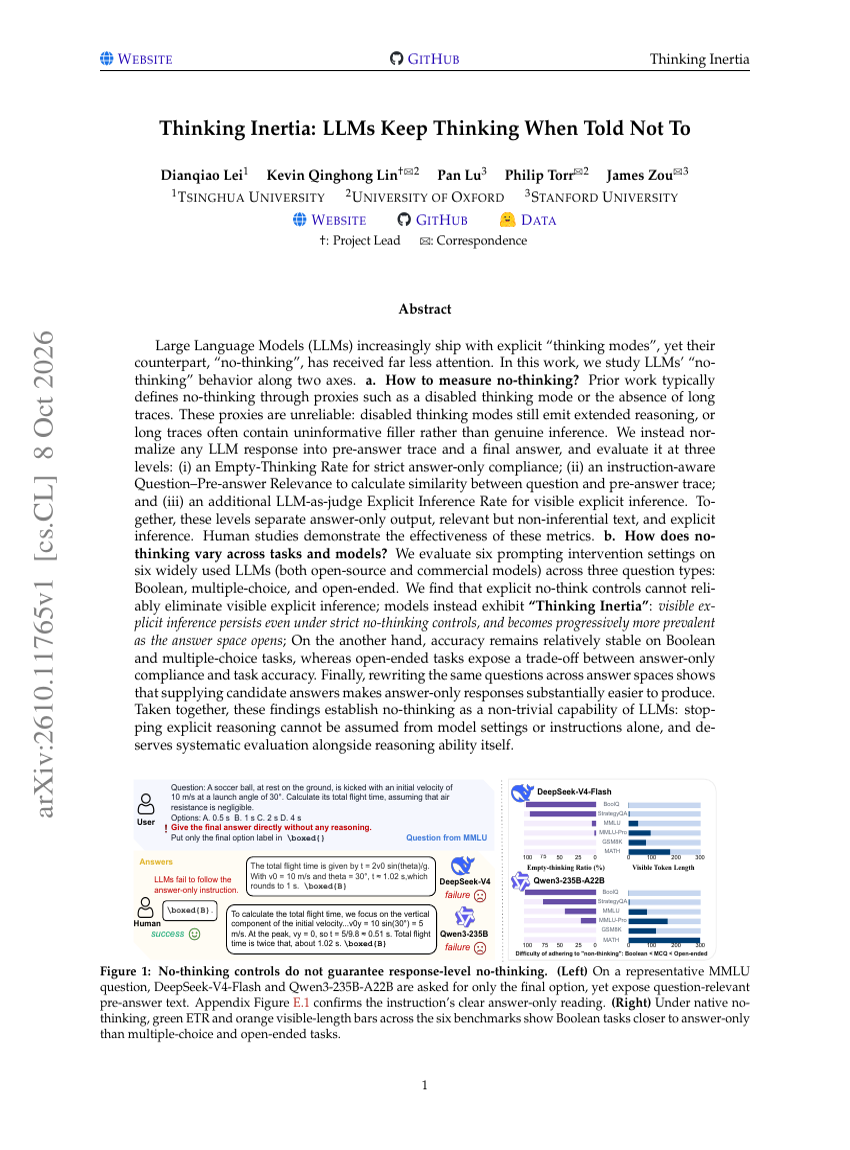
思考の慣性:LLMは「考えるな」と言われても考え続ける
長期的ターミナル知能のためのエージェント的データのスケーリング
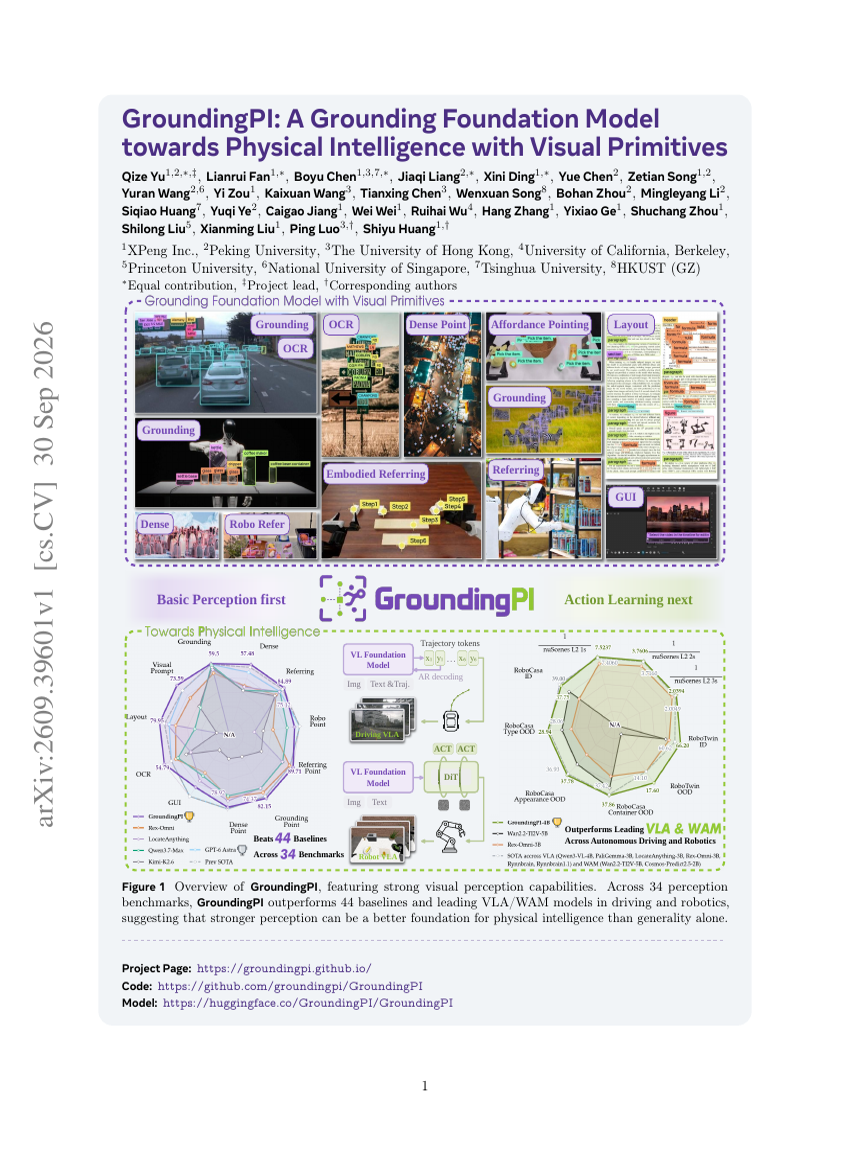
GroundingPI: 視覚プリミティブを用いた物理的知能に向けたグラウンディング基盤モデル
AgentSWE: コーディングエージェントは、本当に望むエージェントを構築できるのか?
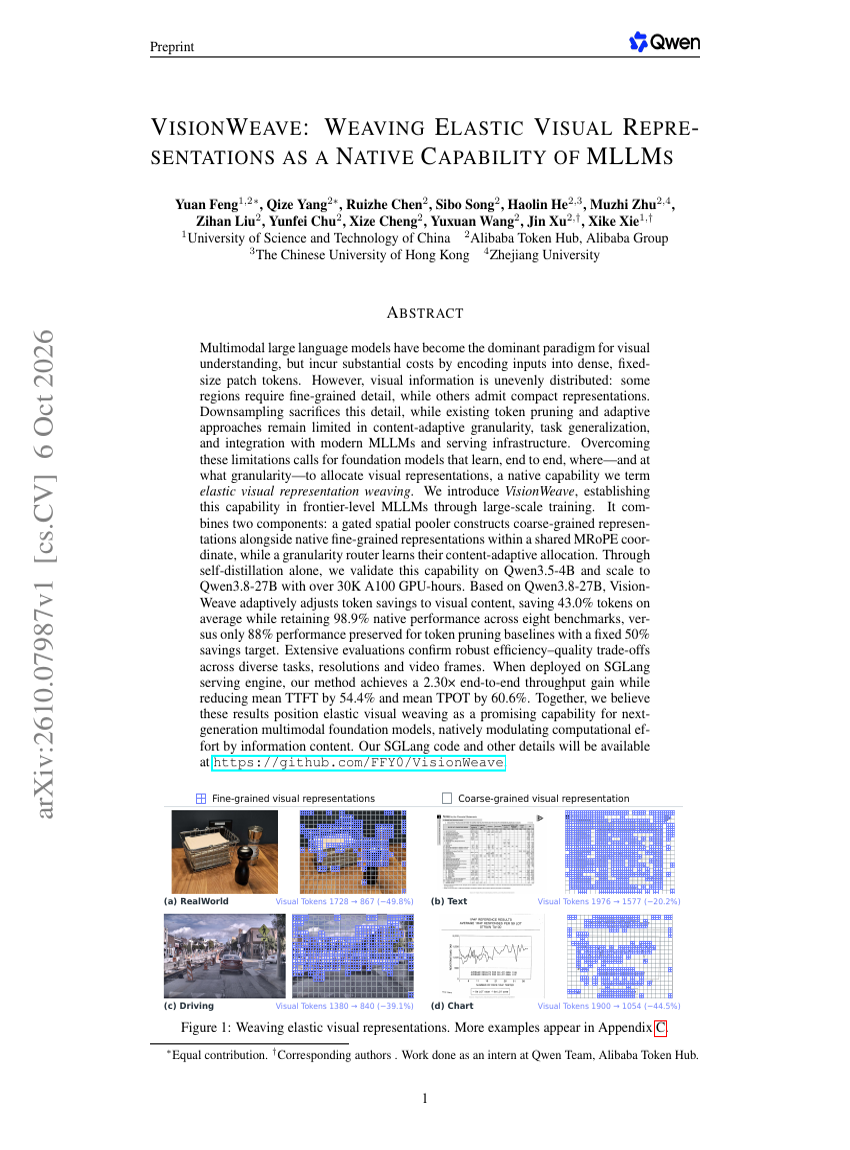
VisionWeave: MLLMのネイティブ能力として弾力的視覚表現を織り込む
EmbodiedCLBench: 自己進化型身体化エージェントのための継続学習評価
SOFTWAREGYM: 多様な合成ソフトウェア環境によるコンピュータ利用エージェント訓練のスケーリング
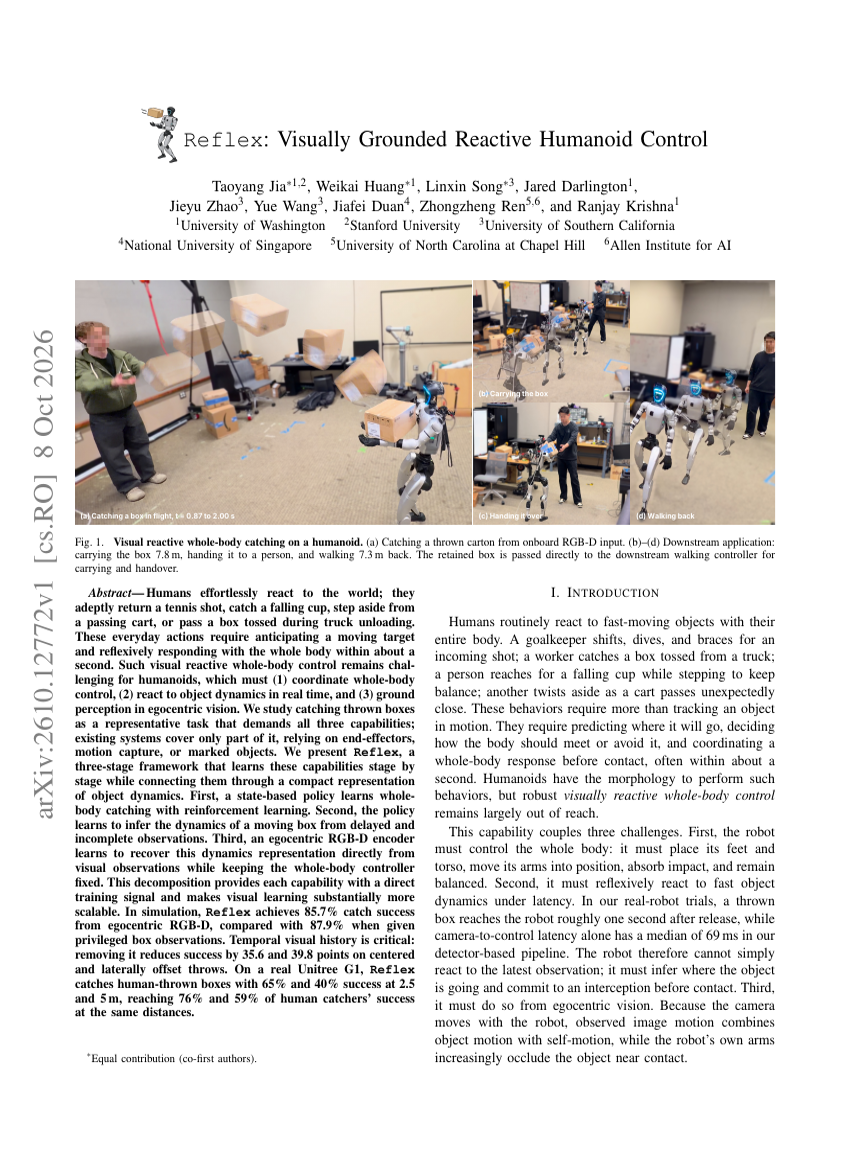
Reflex: 視覚に基づく反応型ヒューマノイド制御
S-Space: マルチモーダル言語モデルにおける空間ワークスペースの探索
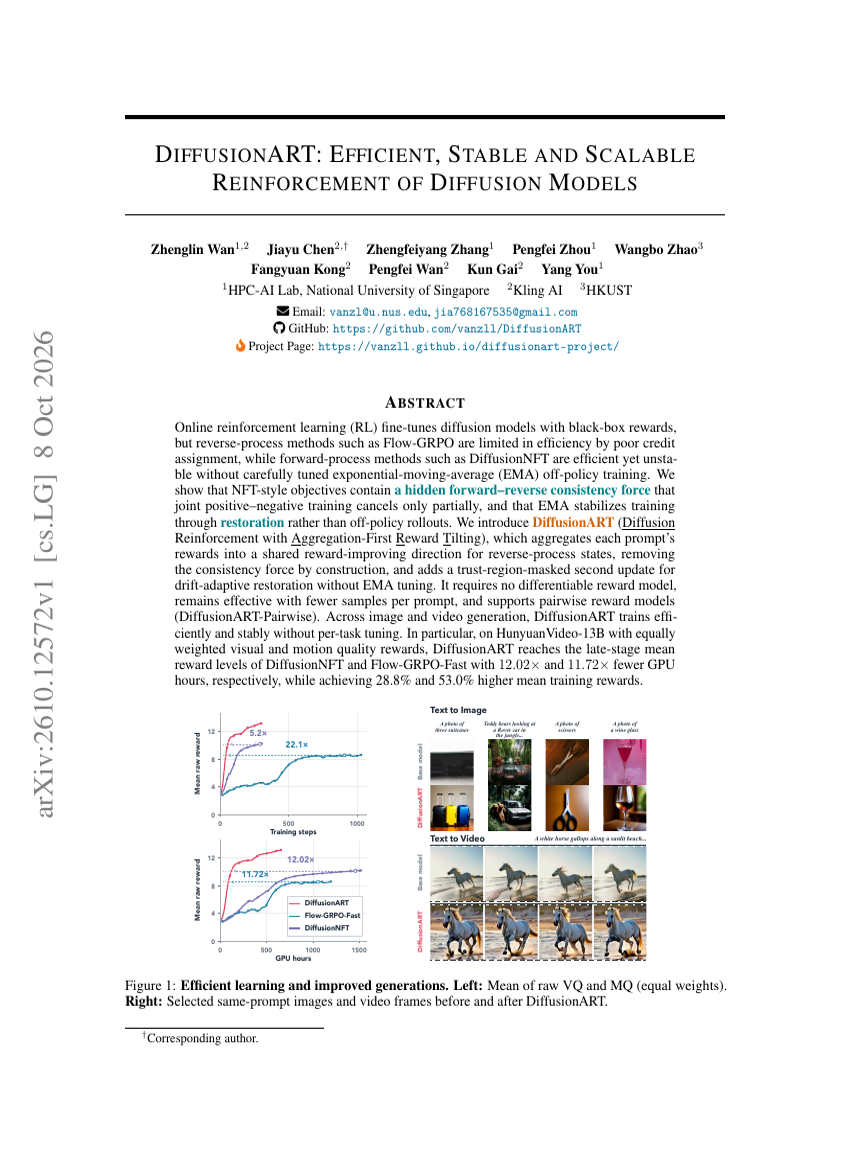
DiffusionART: 拡散モデルの効率的・安定的・スケーラブルな強化学習
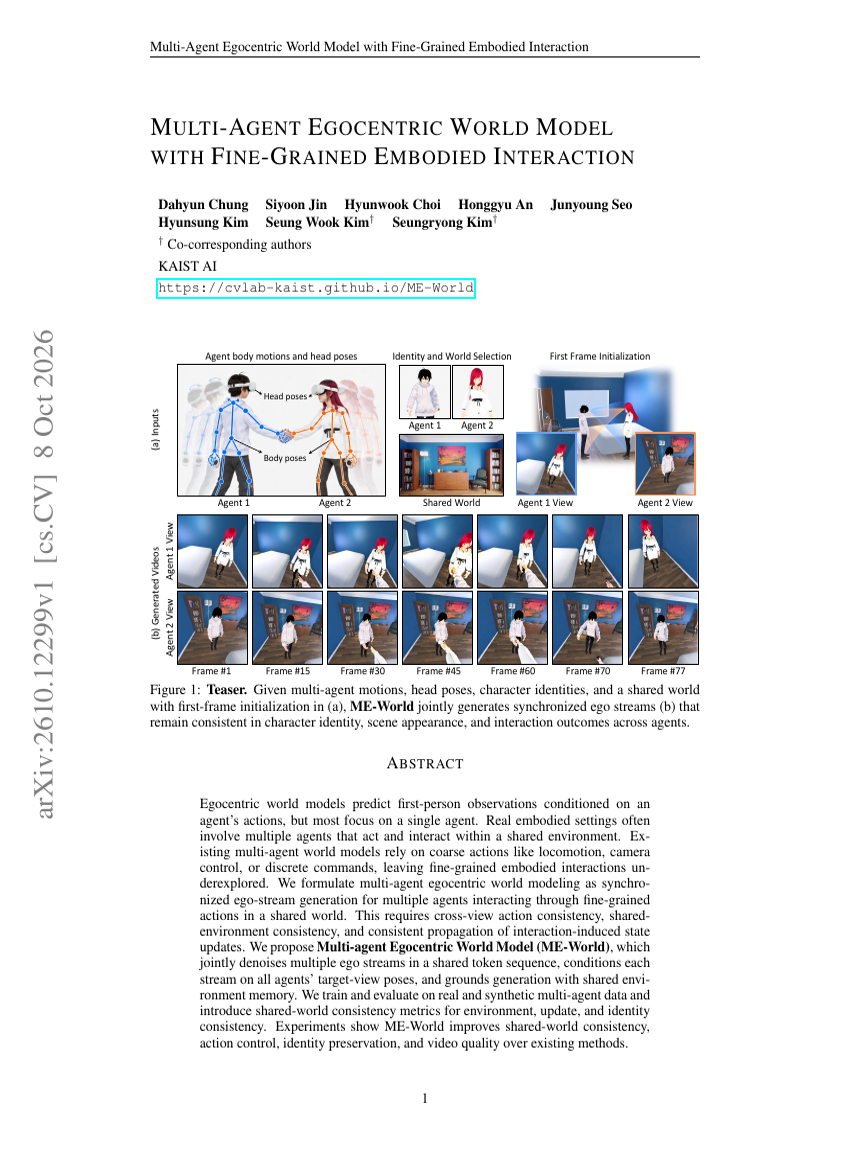
細粒度の身体化インタラクションを備えたマルチエージェント自己中心的世界モデル
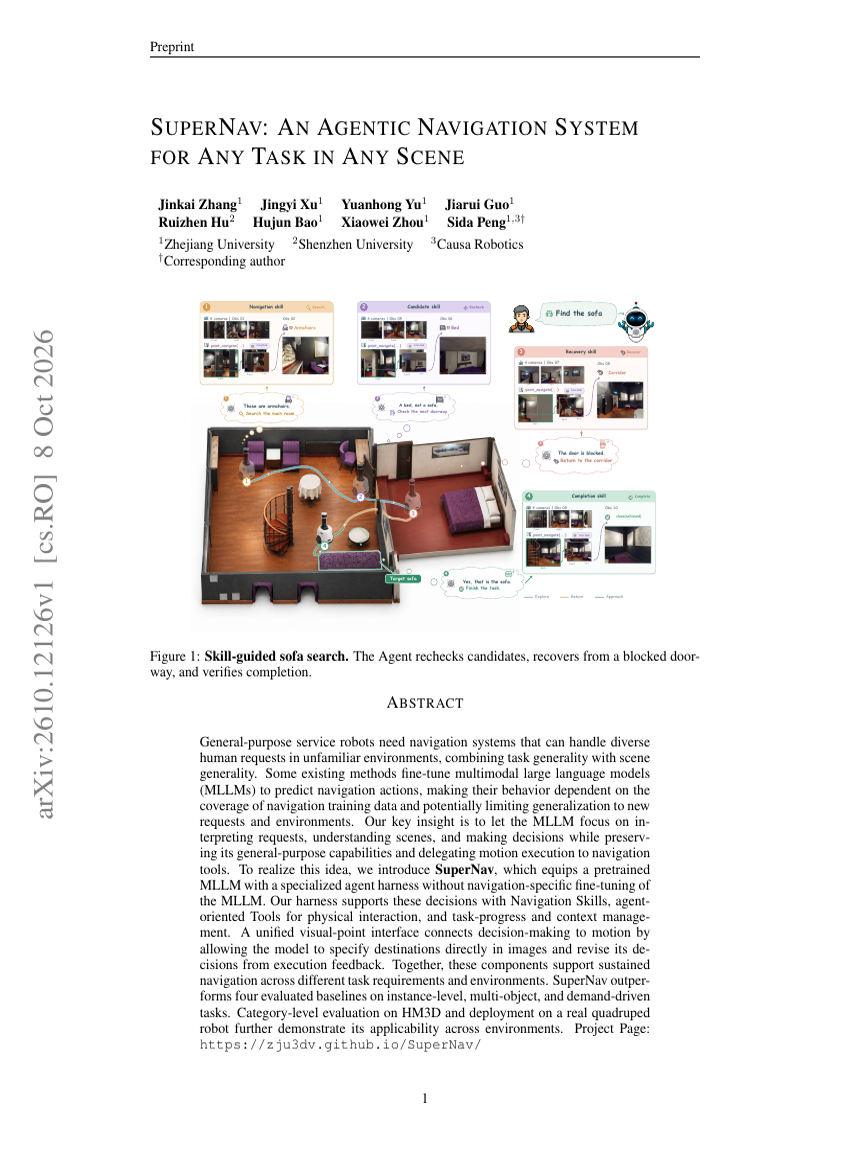
SuperNav: あらゆるシーンにおけるあらゆるタスクのためのエージェント型ナビゲーションシステム
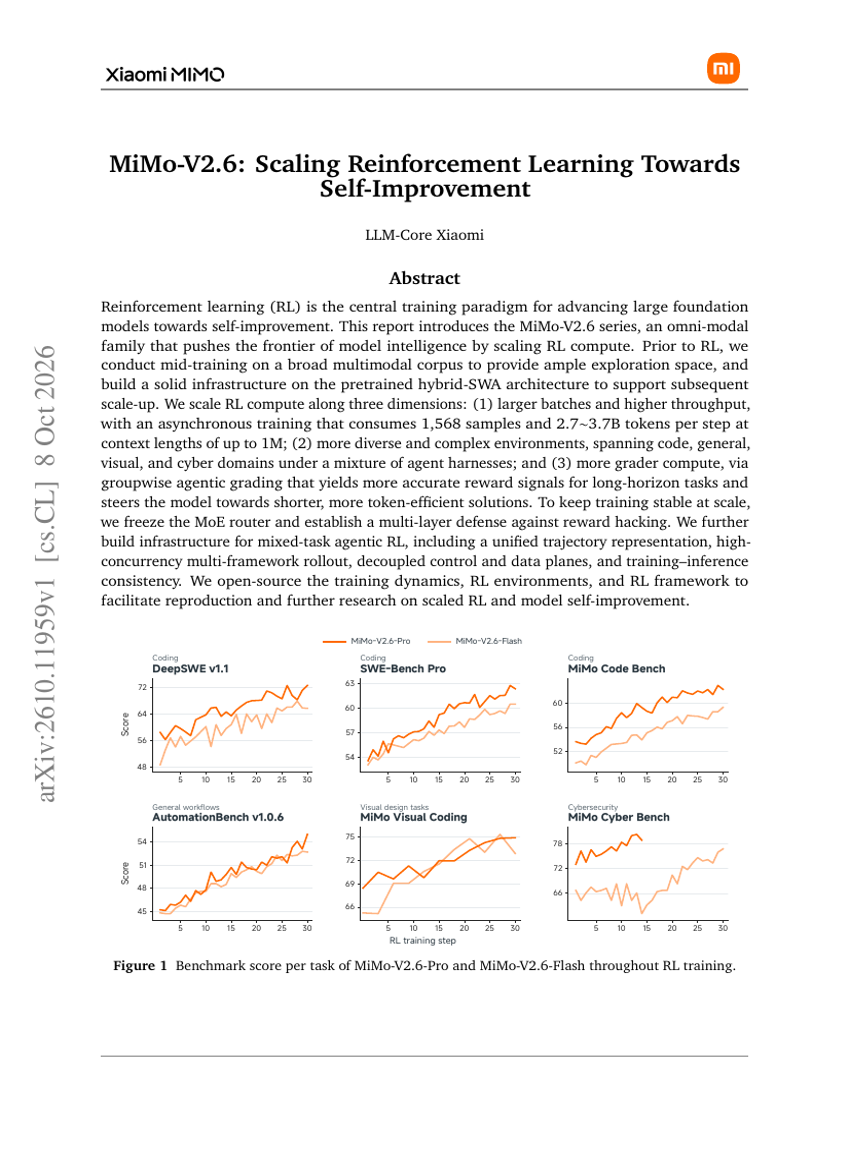
MiMo-V2.6: 自己改善に向けた強化学習のスケーリング
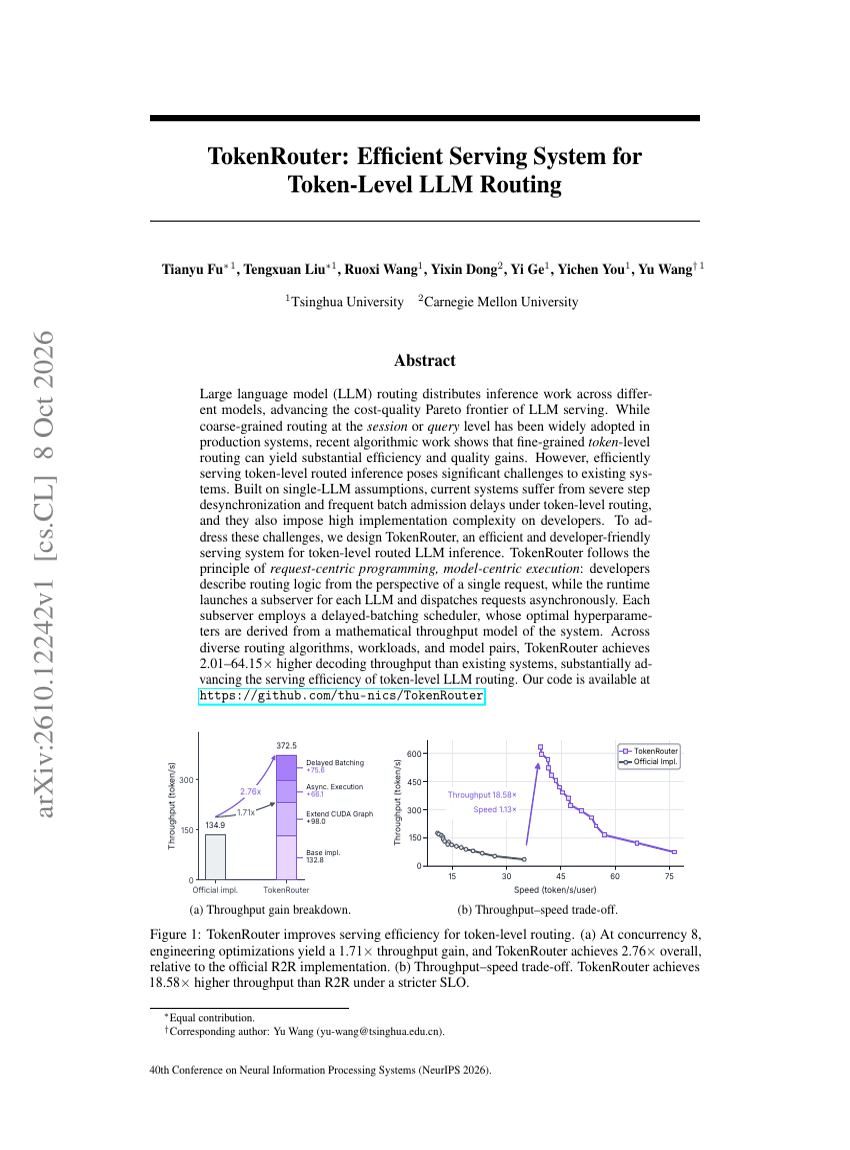
TokenRouter: トークンレベルLLMルーティングのための効率的なサービングシステム
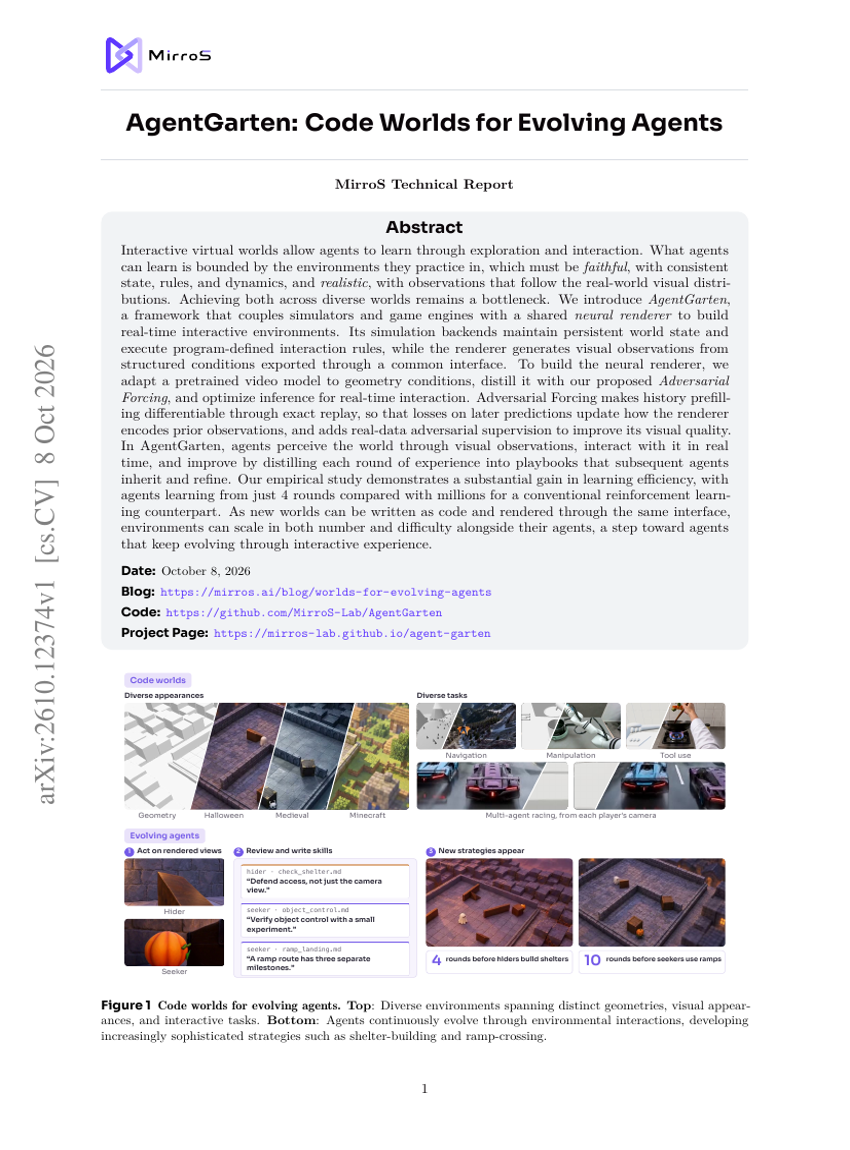
AgentGarten: 進化するエージェントのためのコード世界