HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
活性化オラクルが読まないことを学習する時:ファインチューニングされたオラクルにおける概念特異的な盲点
YOLO-PEFT: YOLOファミリーにおけるパラメータ効率的ファインチューニング
StreamArena: 継続的・対話的・長期的なエージェント型ストリーミング動画理解に向けて
SimWAM: エンドツーエンド自律走行のためのシンプルな世界行動モデル
SFTは衝突し、RLは共存する:大規模言語モデルにおけるマルチタスク学習パラダイムの理論的・実証的分析
単純な環境スケーリングを超えて:マルチモーダルエージェント学習のための効果的な環境分布の設計
MatrAIx:83億のペルソナエージェントによる世界シミュレーション
EvoHarness-RL: 長期的タスクを扱うLLMエージェントのための自己進化的実行時ハーネスの学習
EnvACE: エージェント型強化学習のための世界リハーサルによる環境ダイナミクスの内在化
GST-Bench: VLMは動画から大局的な空間認識を獲得できるか?
WorldClaw: エージェント駆動型の大規模3Dオープンワールド生成
知覚された音声の解釈可能なMEGデコーディング:皮質ソースと検索を駆動する刺激特徴
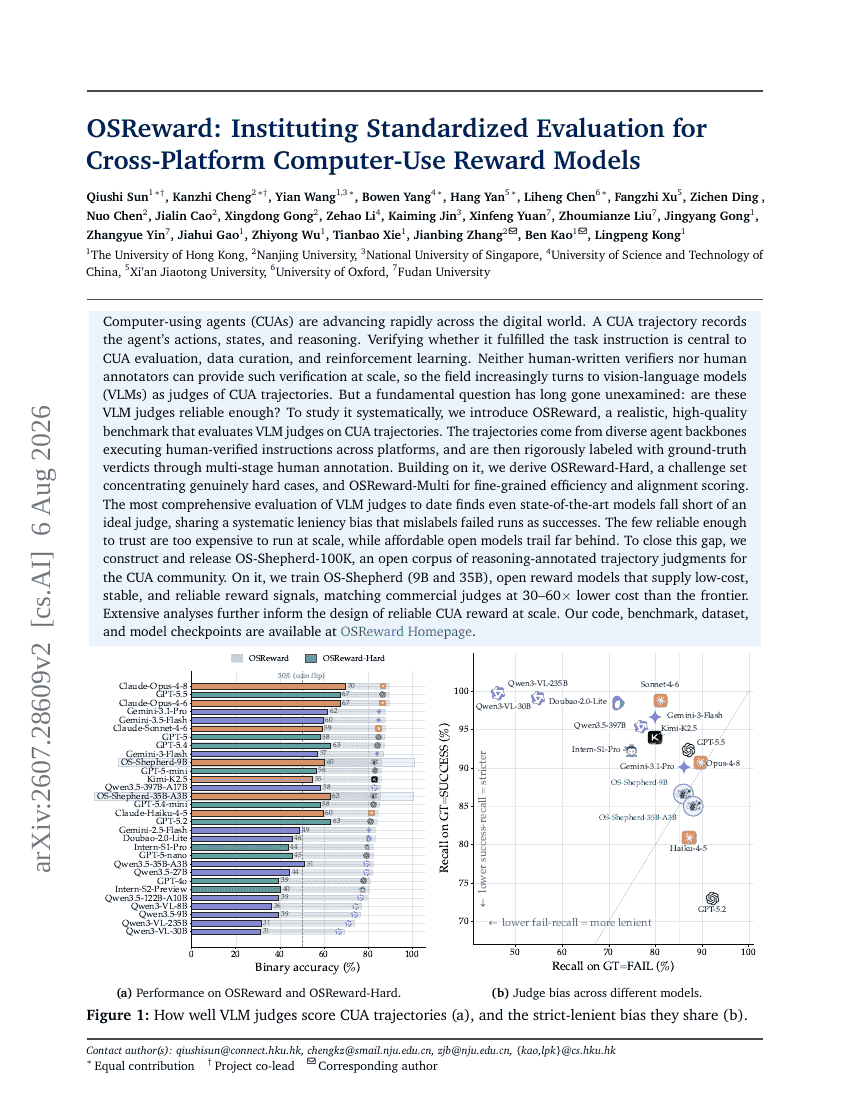
OSReward: クロスプラットフォームのコンピュータ操作報酬モデルに対する標準化評価の確立
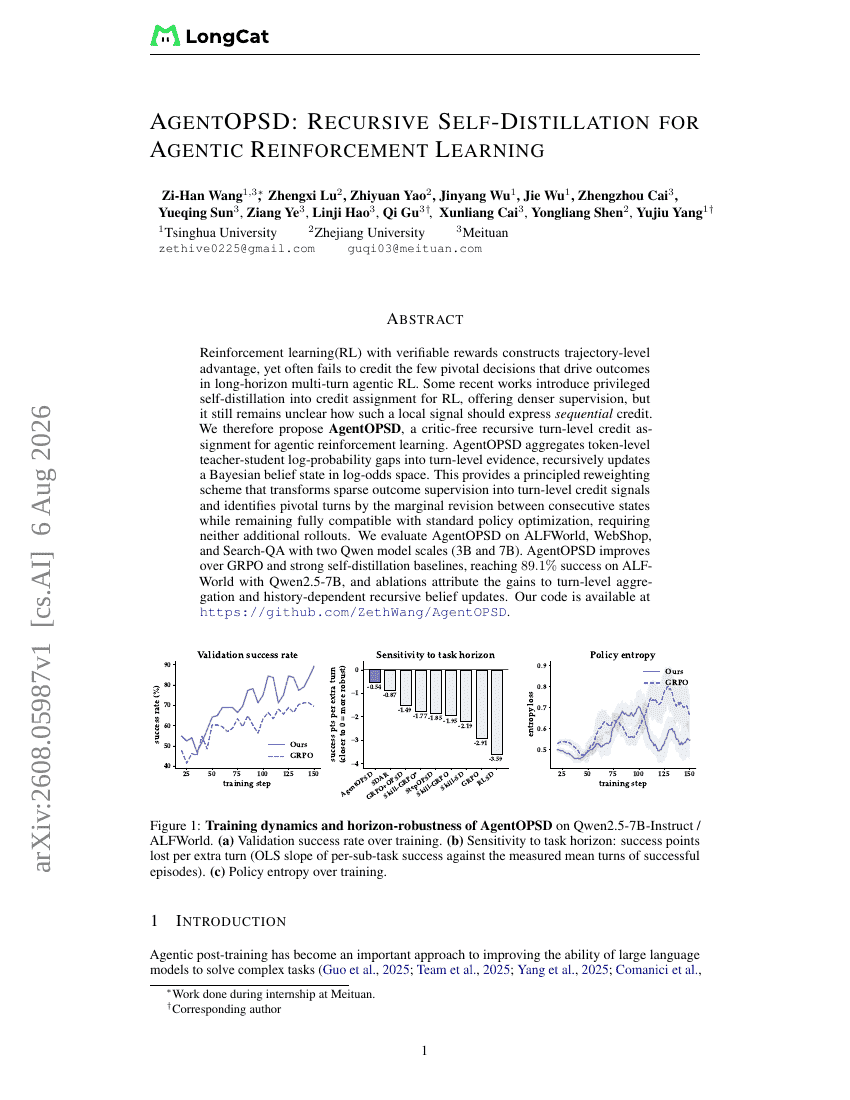
AgentOPSD: エージェント型強化学習のための再帰的自己蒸留
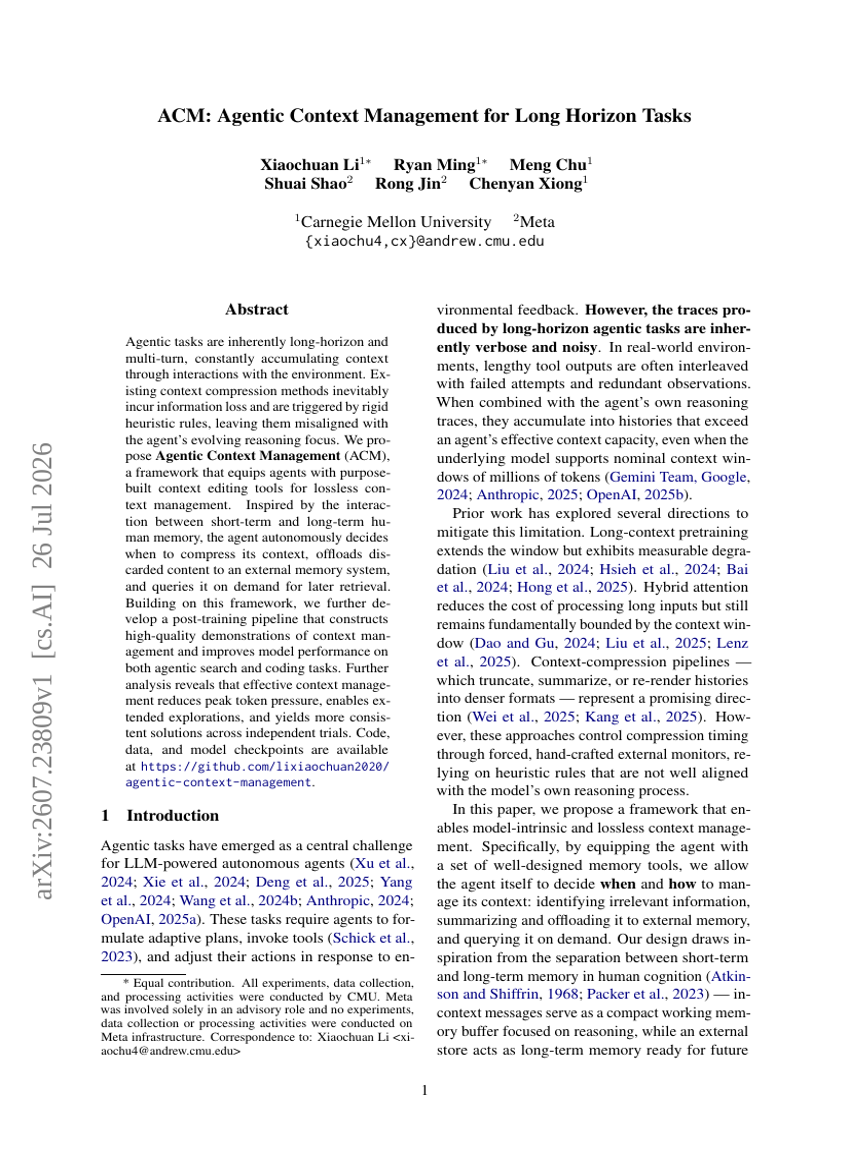
長期的タスクのためのエージェント的文脈管理(ACM)
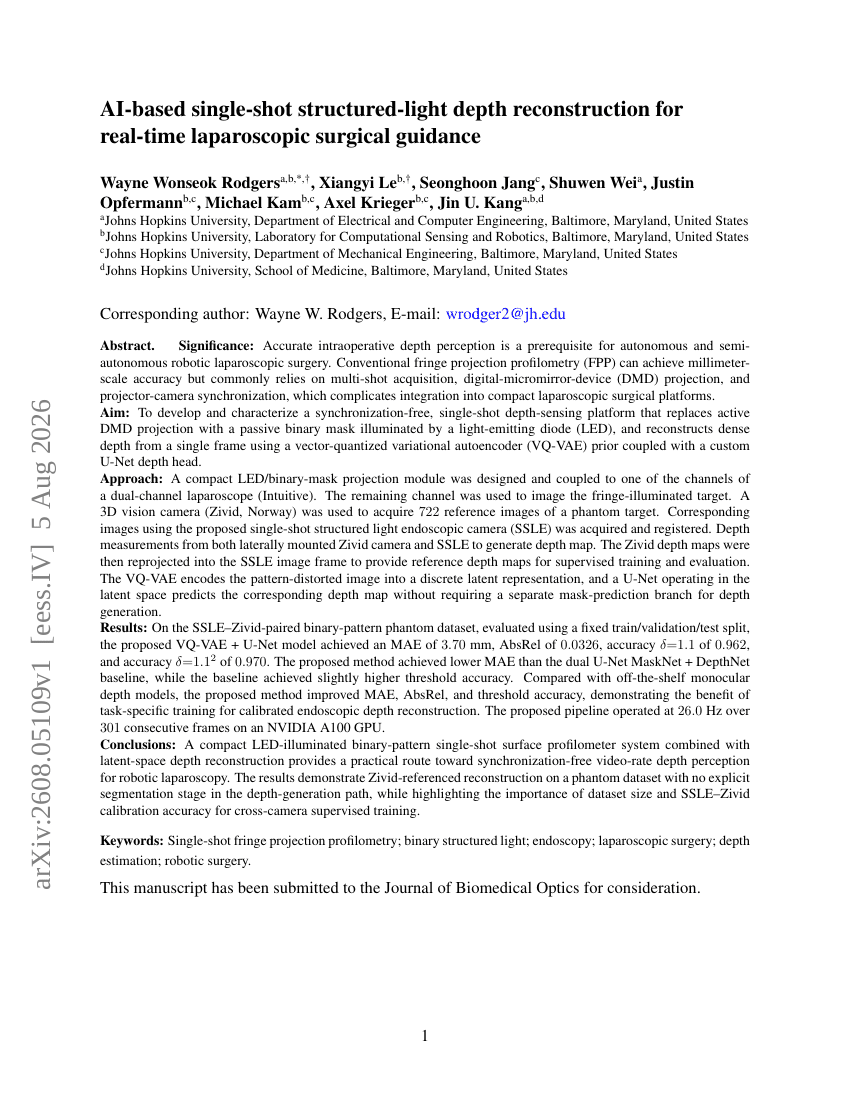
腹腔鏡手術のリアルタイムガイダンスに向けたAIベースの単一ショット構造化光深度再構成
浅深度における共有古典乱数によるユニタリ量子生成モデルとチャネル量子生成モデルの表現的分離
報酬構造が強化学習におけるエピソード探索とニューラルメモリの相互作用を形成する
安定リッジ:部分空間制約付き平均シフトの一貫性と収束性
プライバシーに配慮した教室内インシデント認識のためのロバストかつ効率的な動作推論
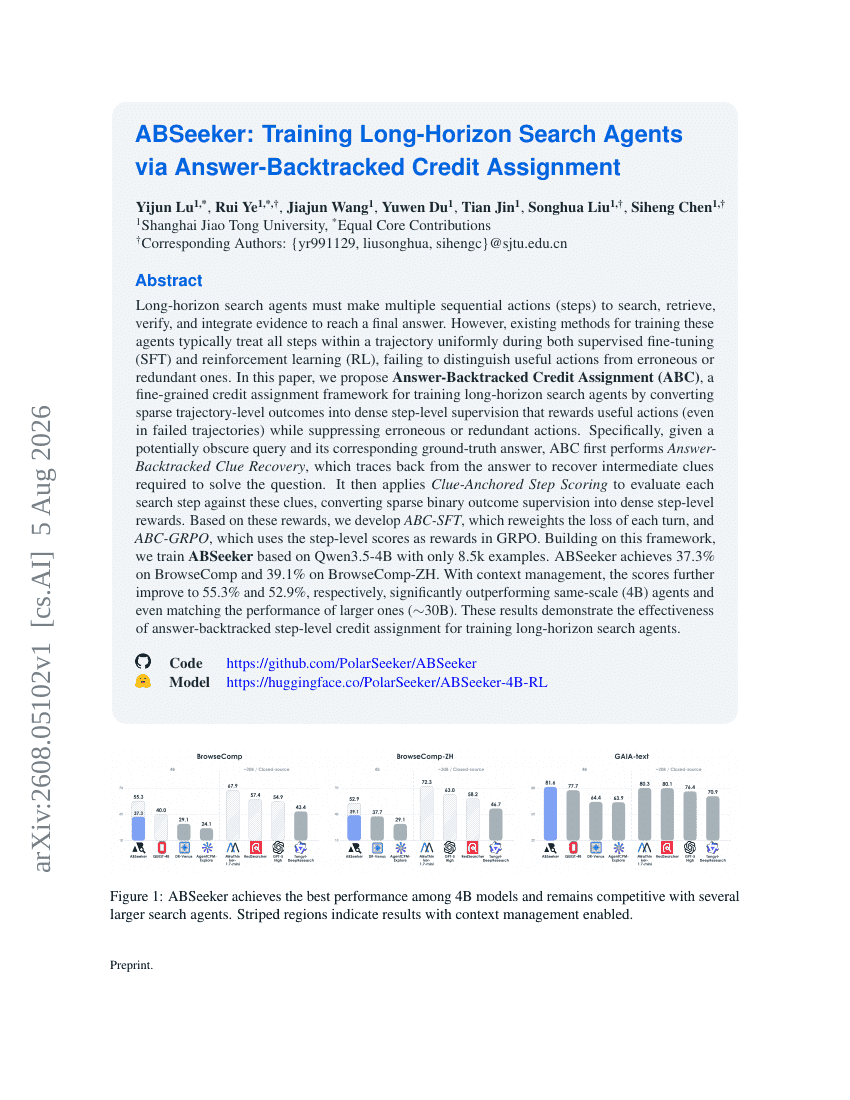
ABSeeker: 回答逆追跡によるクレジット割り当てに基づく長期探索エージェントの訓練
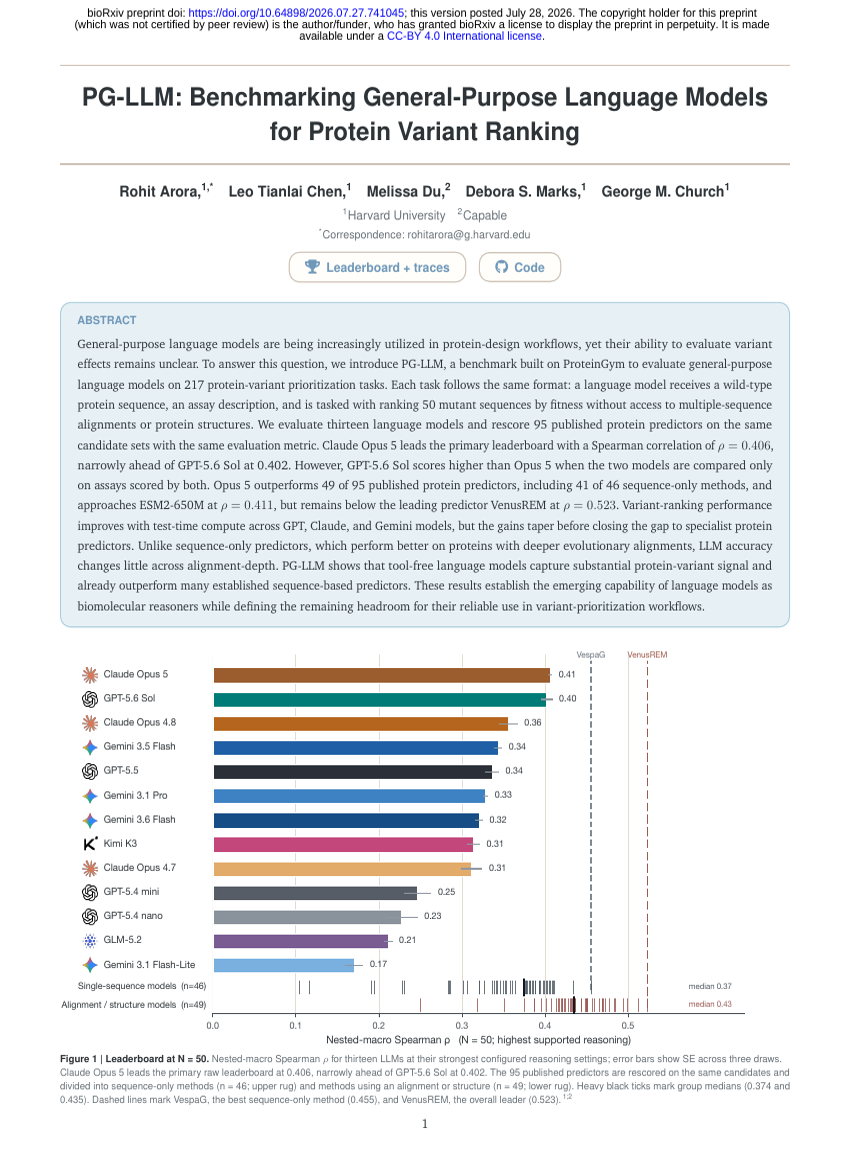
PG-LLM: タンパク質変異体ランク付けのための汎用言語モデルベンチマーク
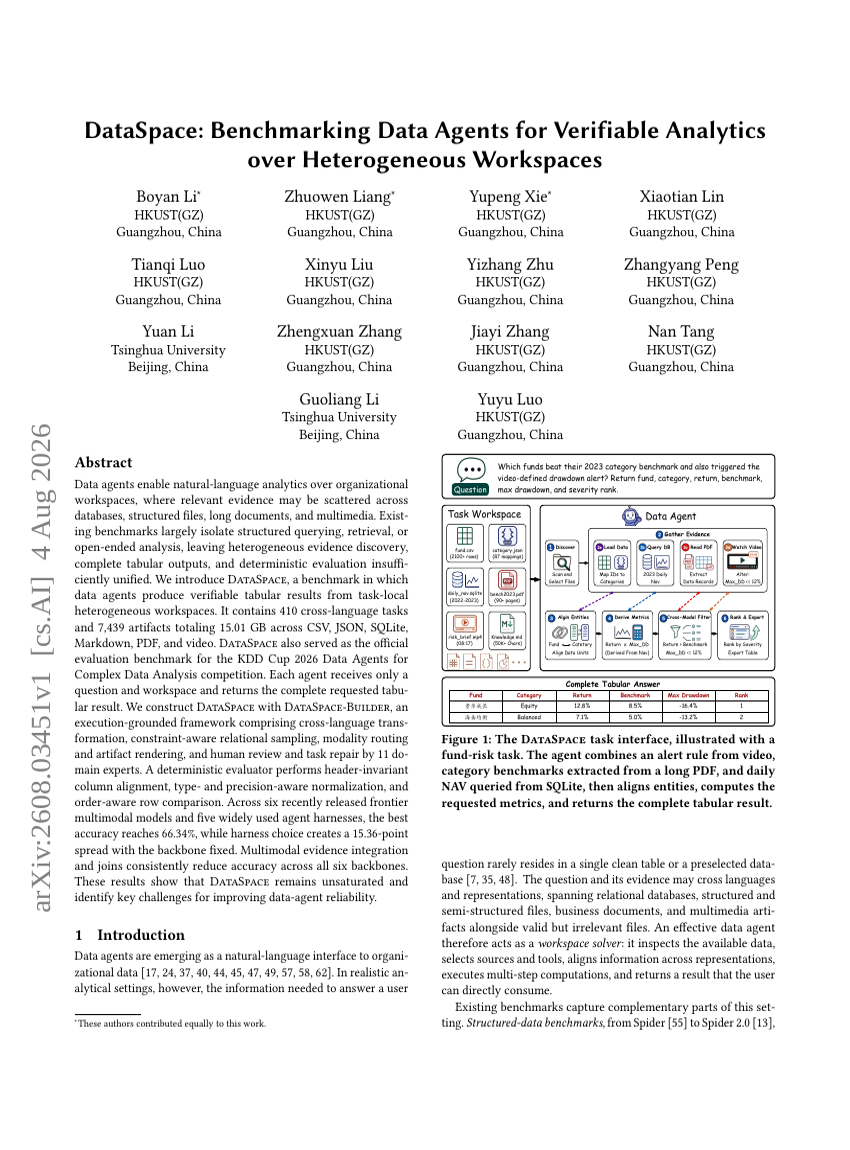
DataSpace: 異種混在ワークスペースにおける検証可能分析のためのデータエージェントベンチマーク
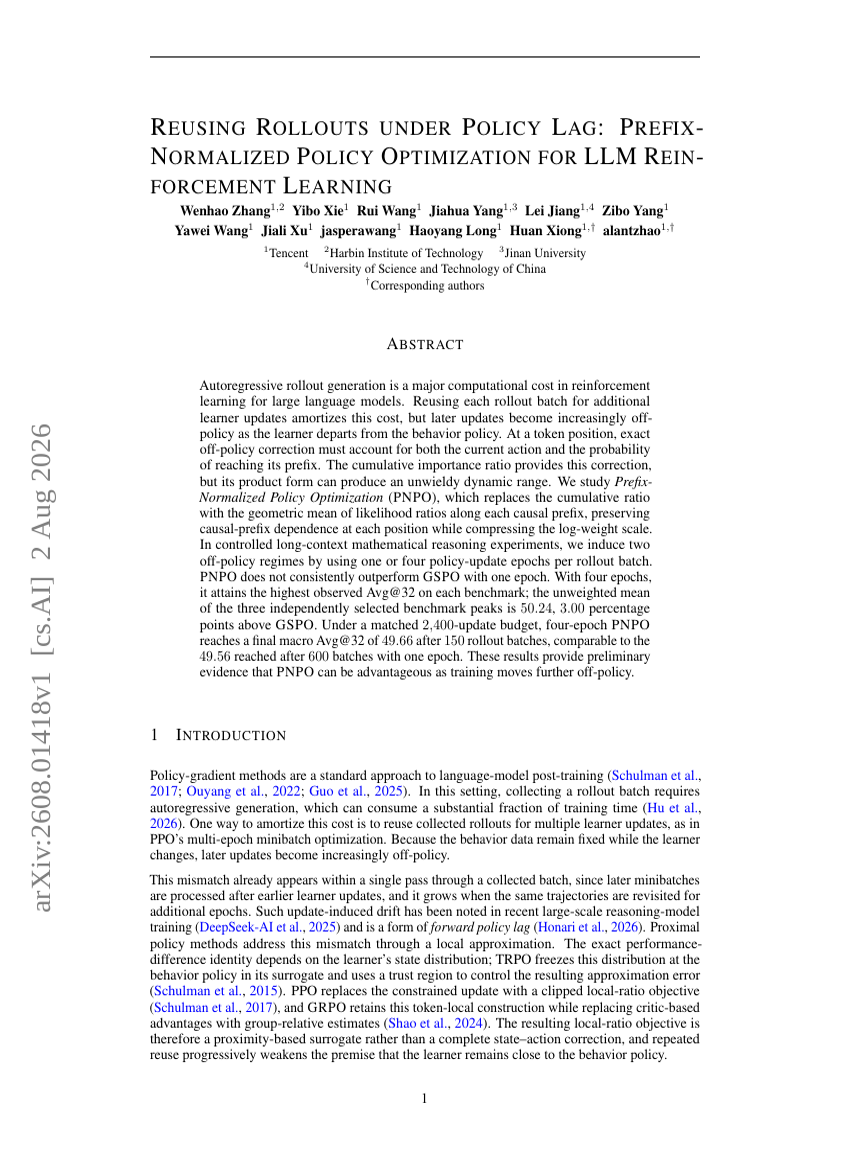
ポリシーラグ下でのロールアウト再利用:LLM強化学習のためのプレフィックス正規化方策最適化
Harness-R1: エージェントの失敗軌跡からの実行可能ランタイムハーネス編集の学習
FinanceHarness: 自律的金融ディープリサーチフレームワーク
DeepSeek-V4: 高効率な100万トークン文脈知能を目指して
知識と幾何の分離:ストリーミング推薦のための更新可能な事前学習済み転移
Video-DeepResearch: 次世代マルチモーダル深層リサーチエージェントを目指して
AURORA-LM: 連続潜在拡散言語モデルのための自己符号化統合表現
Hunyuan3D-Buffalo 1.0: スケーラブルな3D生成、理解、編集のための統合マルチモーダルモデル
JoyAI-Video-Edit: 自己回帰拡散モデルによるリアルタイム自由形式動画編集