HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
ThinkTwice: 推論とSelf-RefinementのためにLarge Language Modelsを共同で最適化する手法
ACES: テストをテストするのは誰か?コード生成におけるLeave-One-Out AUC一貫性
Agent Trajectories からの Retrieval を学習する
Claw-Eval: 自律エージェントの信頼できる評価に向けて
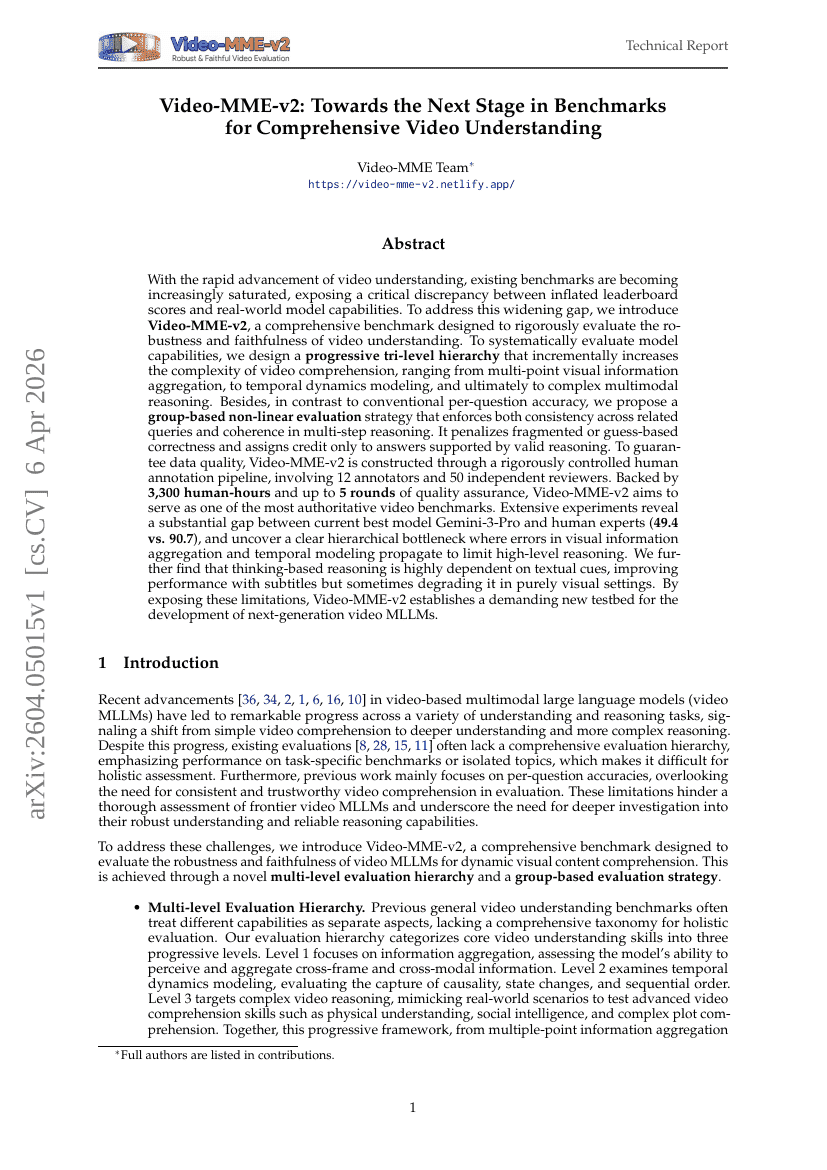
Video-MME-v2: 包括的な動画理解のためのベンチマークの次の段階へ
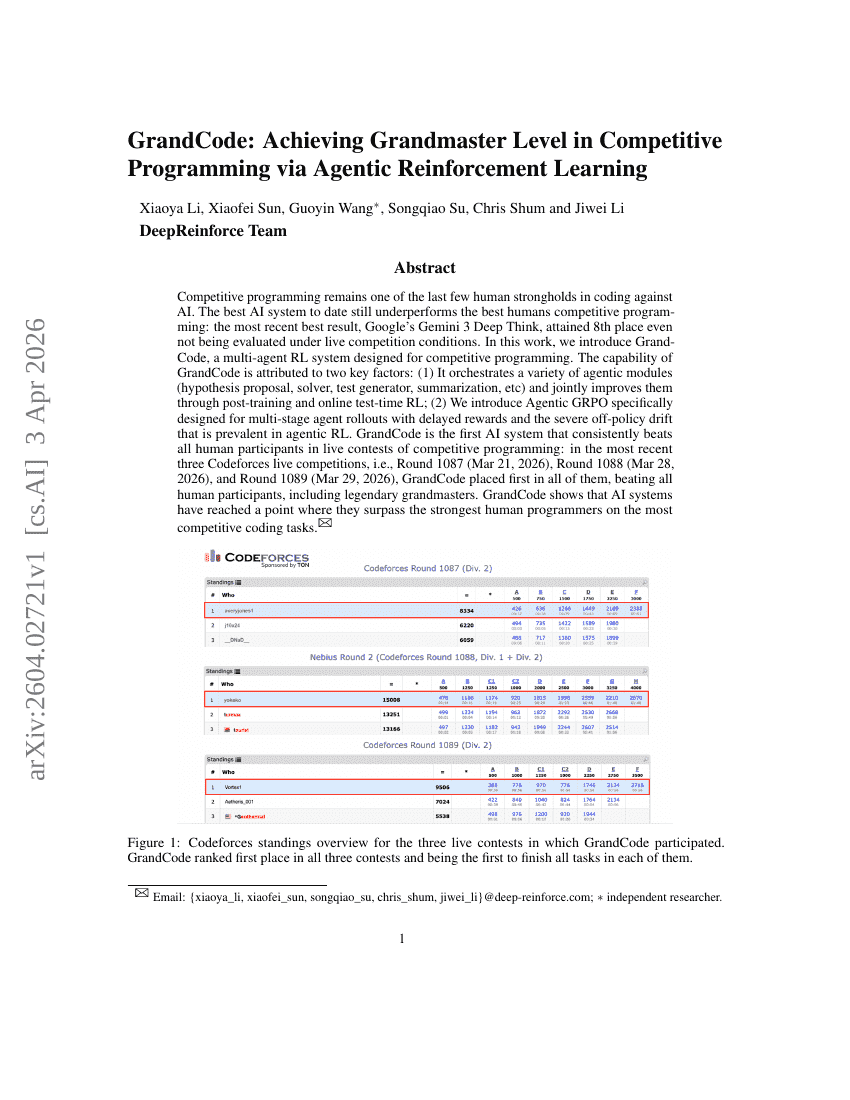
GrandCode: Agentic Reinforcement Learningを通じて競技プログラミングにおけるGrandmasterレベルを実現する
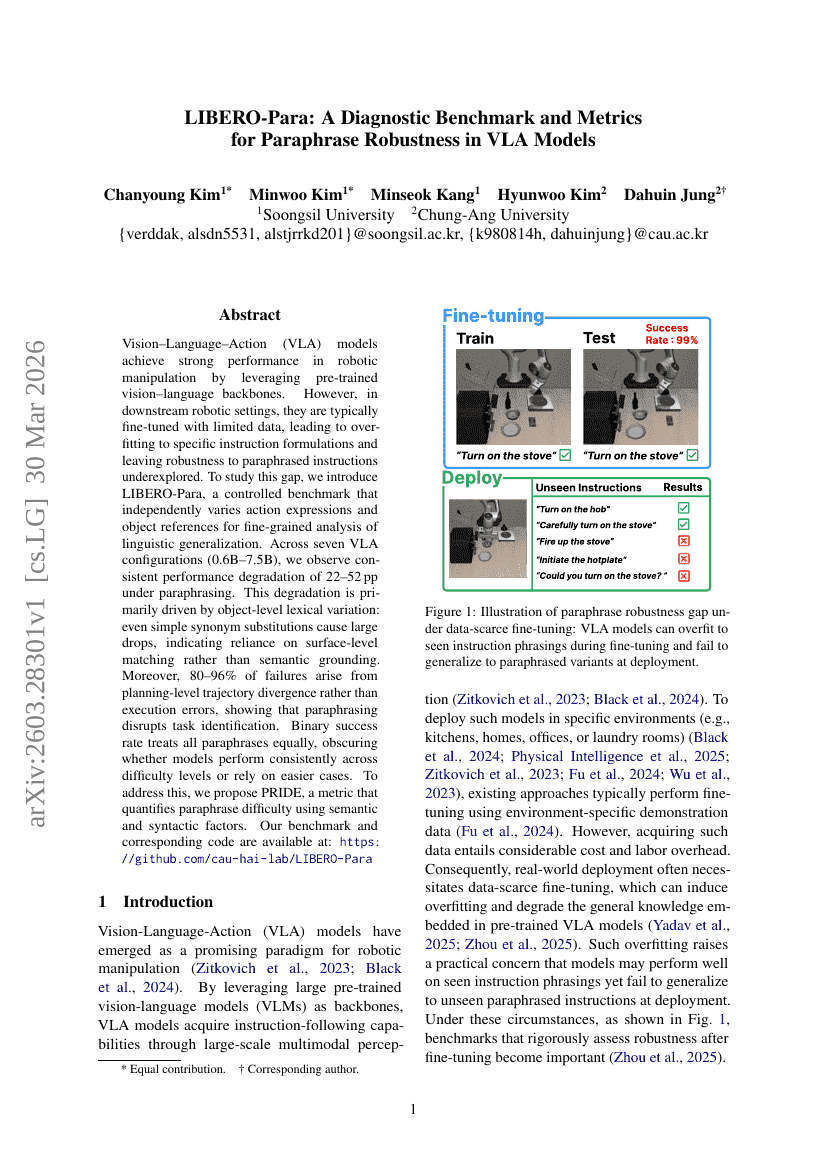
LIBERO-Para: VLAモデルにおける言い換えに対する堅牢性を評価するための診断用benchmarkおよび評価指標
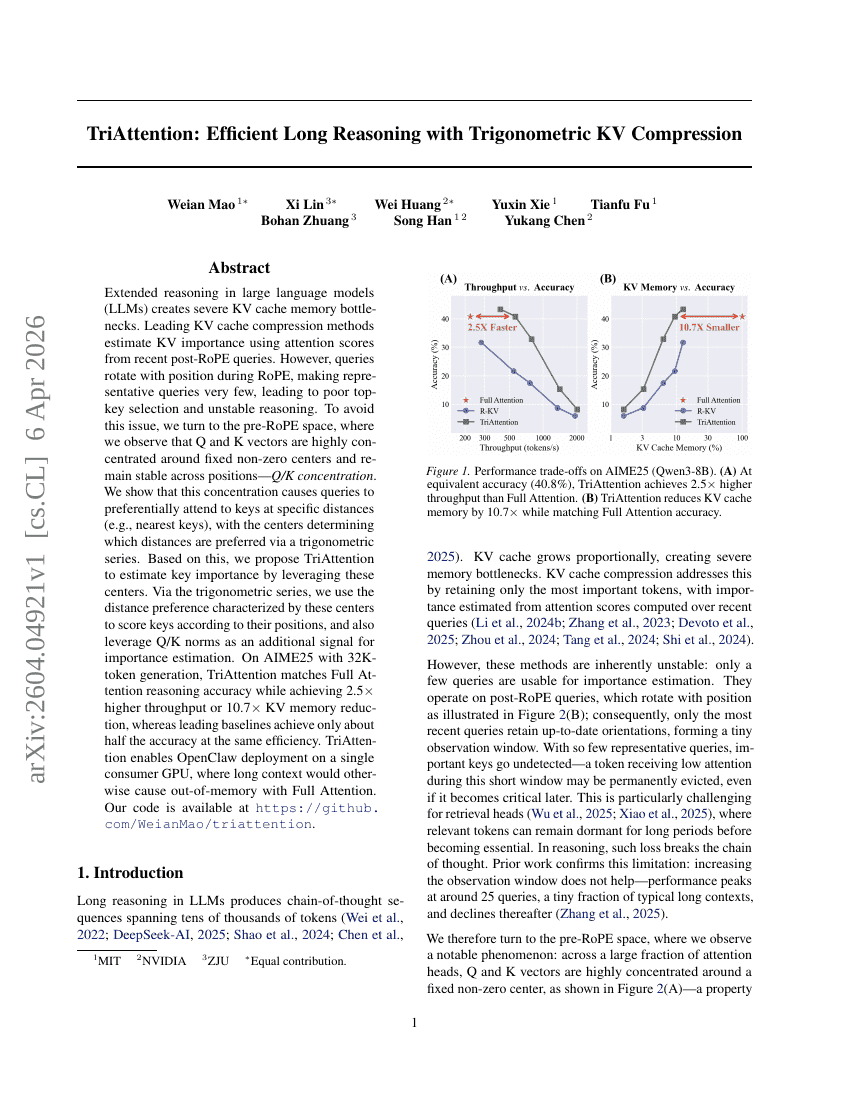
TriAttention: 三角関数を用いたKV Compressionによる効率的なLong Reasoning
MinerU2.5-Pro:大規模なData-Centricな文書解析における限界への挑戦
Adam's Law:Large Language Modelsにおけるテキスト出現頻度の法則
OpenWorldLib:高度な World Models に関する統一された Codebase および定義
WAXAL:大規模多言語アフリカ言語音声コーパス
DRACO:深層研究の正確性、完全性及び客観性に関するクロスドメインベンチマーク
HuatuoGPT-o1:LLMs による医療領域の複雑推論 toward
AgentSocialBench: 人間中心のエージェント型ソーシャルネットワークにおけるプライバシーリスクの評価
InCoder-32B-Thinking:思考のための産業用コード世界モデル
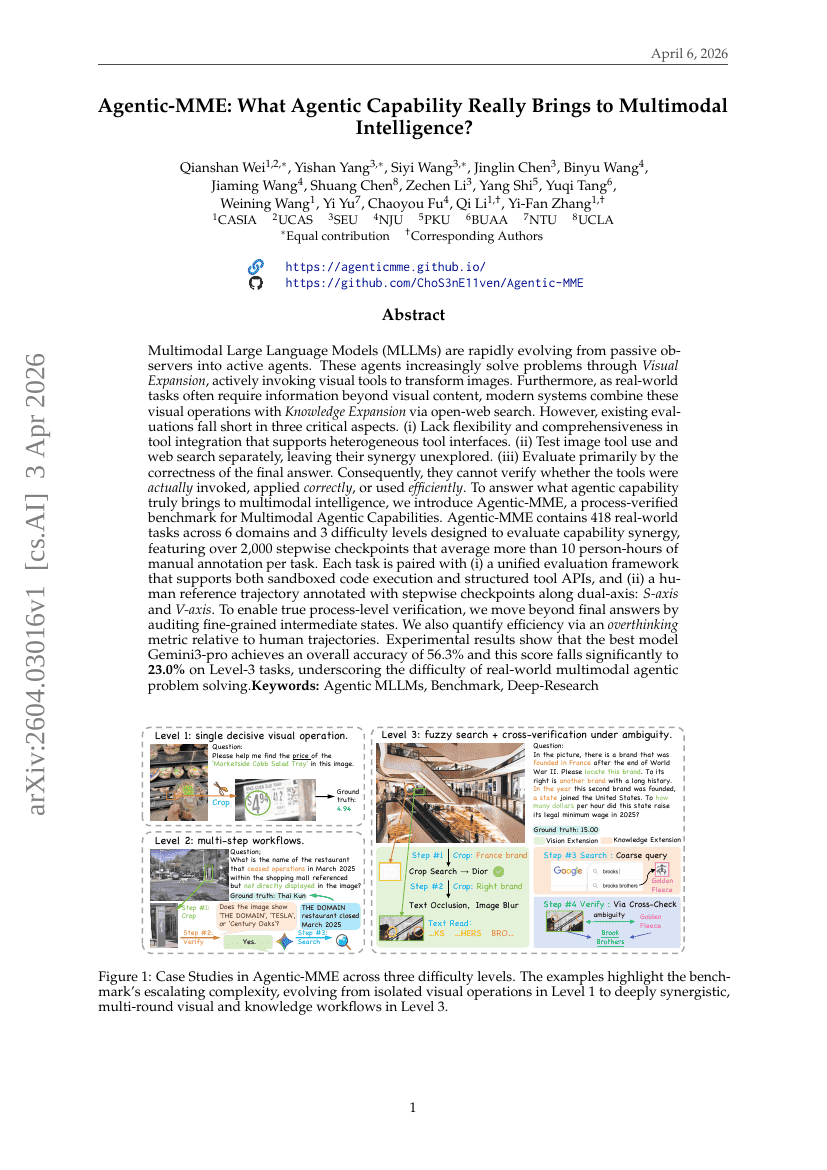
Agentic-MME: Agentic Capability がマルチモーダル知性に真にもたらすものとは?
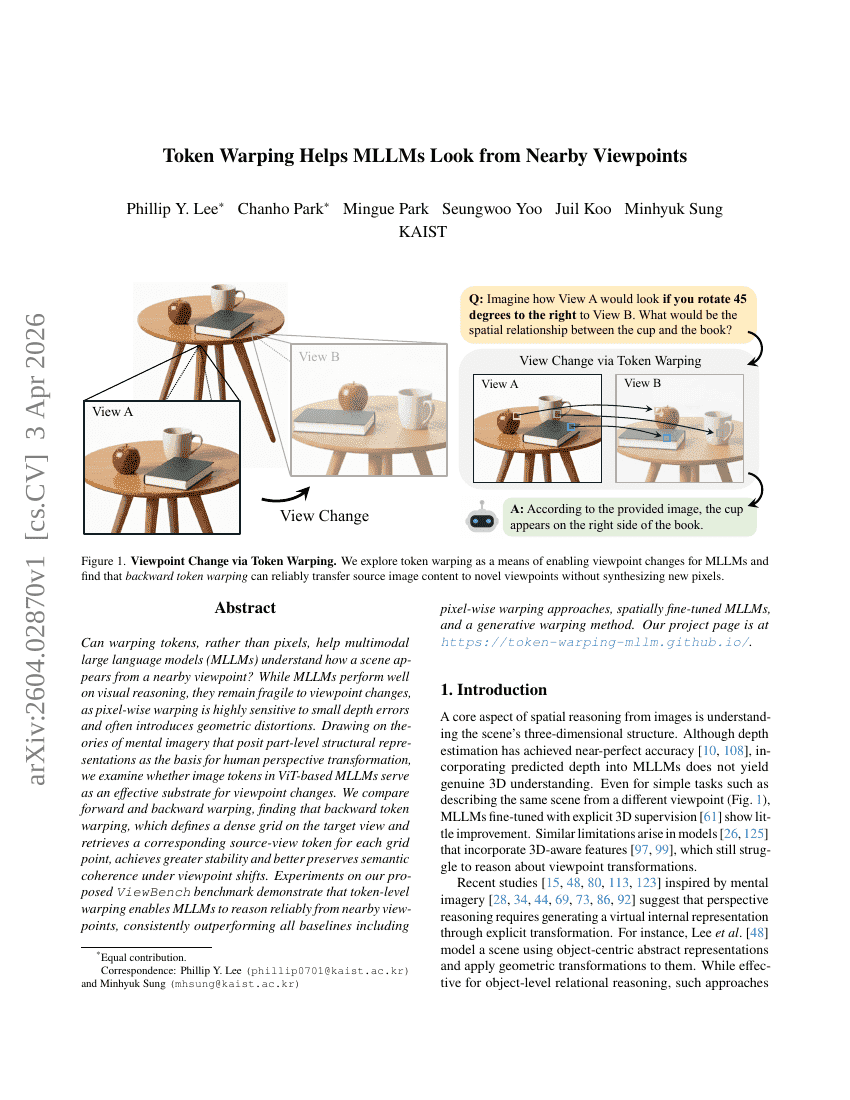
Token Warping により、MLLMs は近接視点からの観察が可能となる
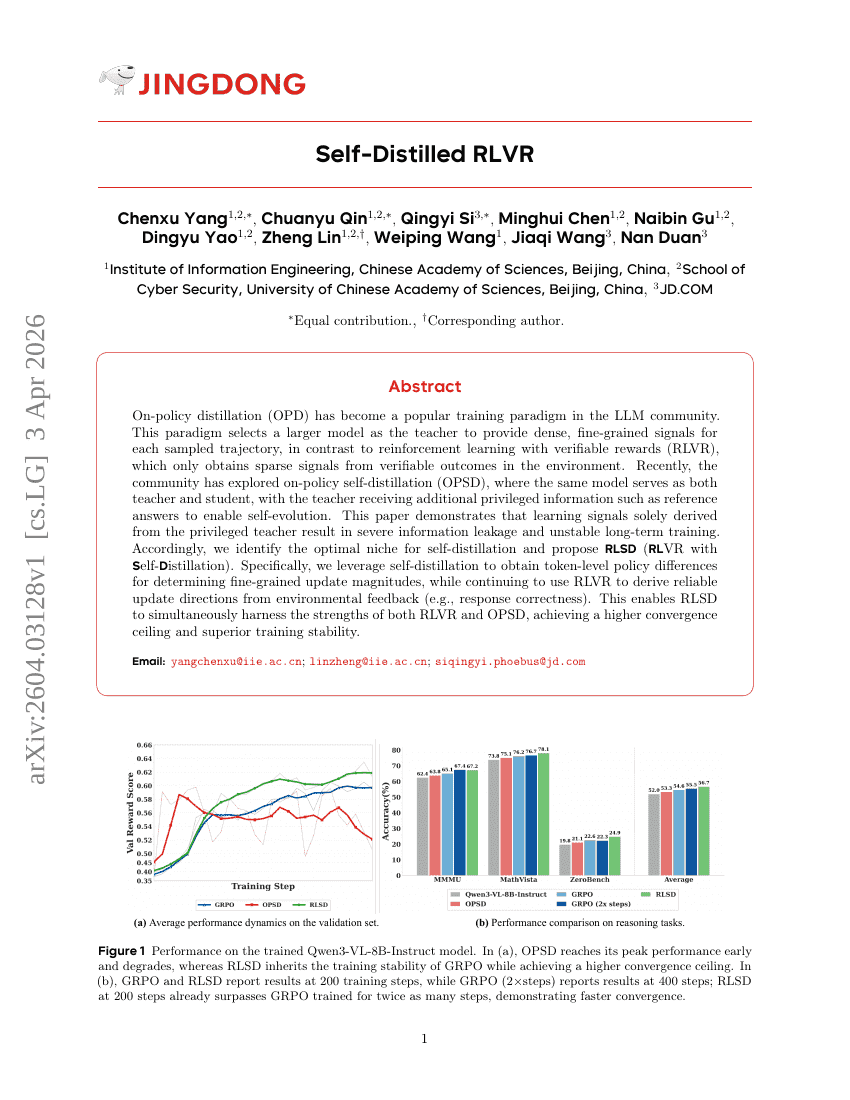
自己蒸留によるRLVR
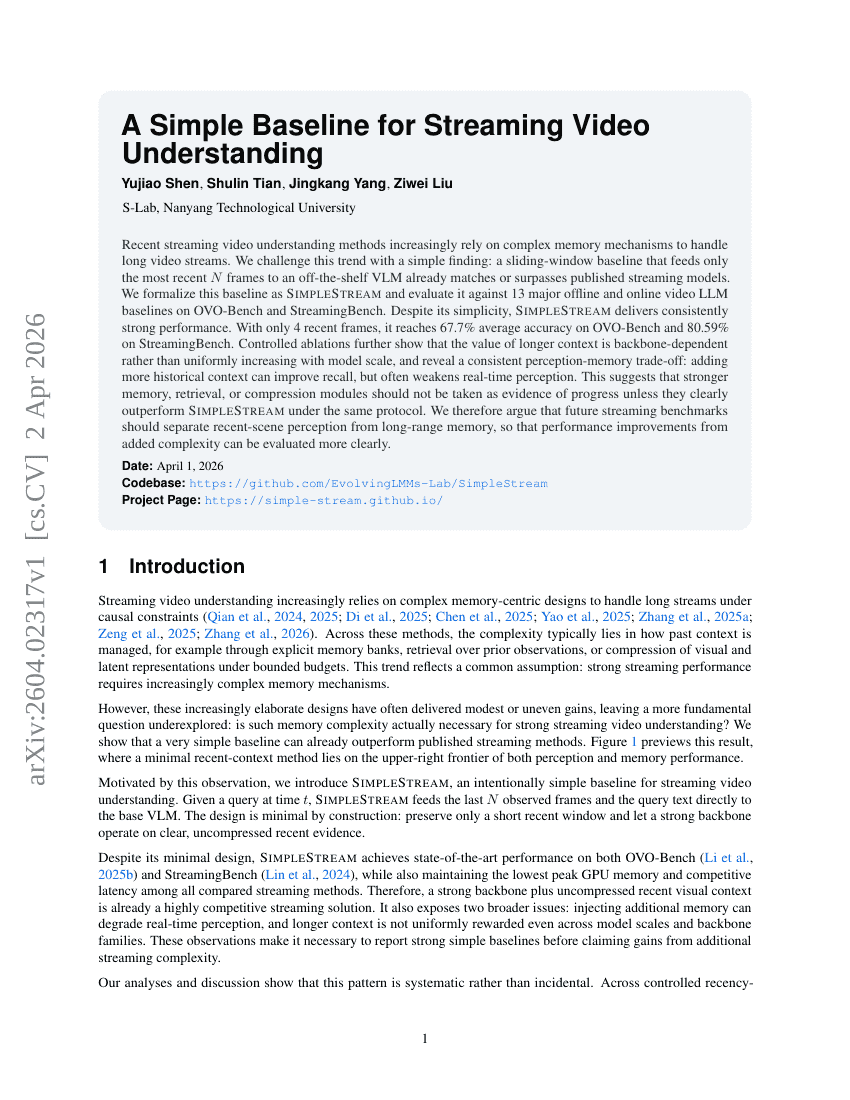
ストリーミング動画理解のためのシンプルなベースライン
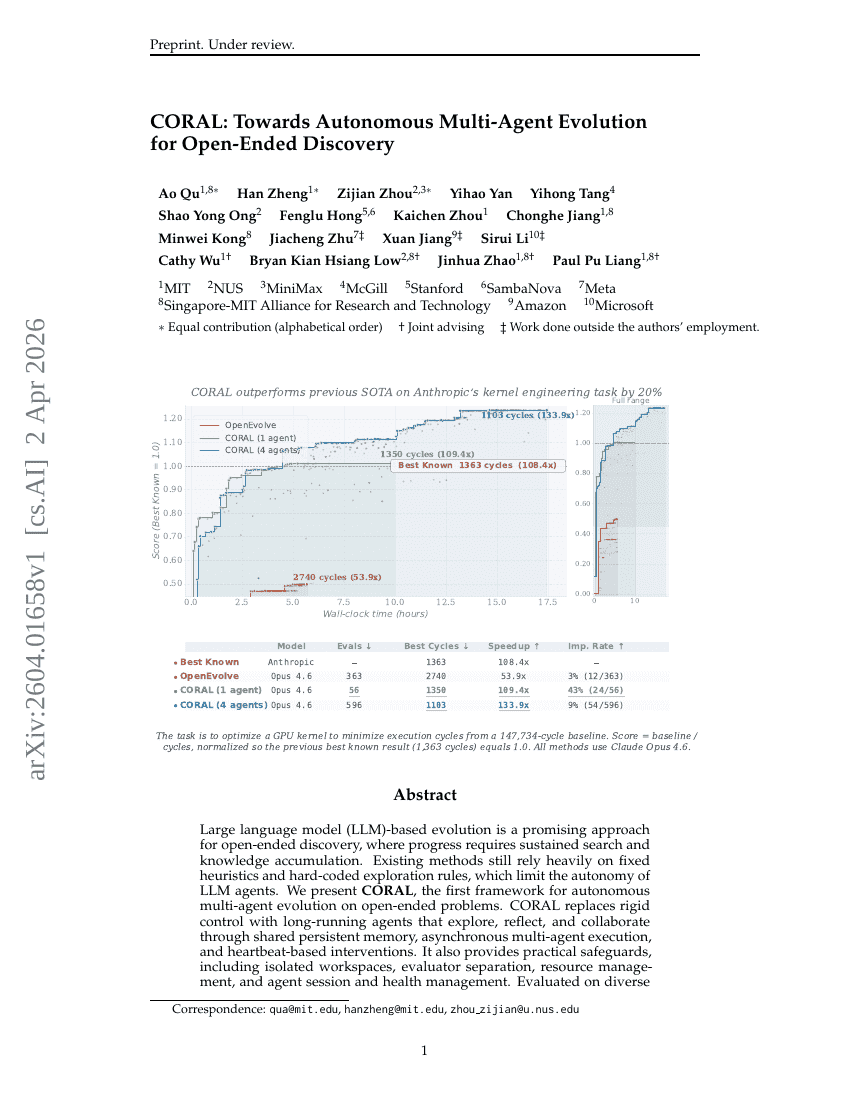
CORAL:オープンエンドな発見に向けた自律型マルチエージェント進化への道
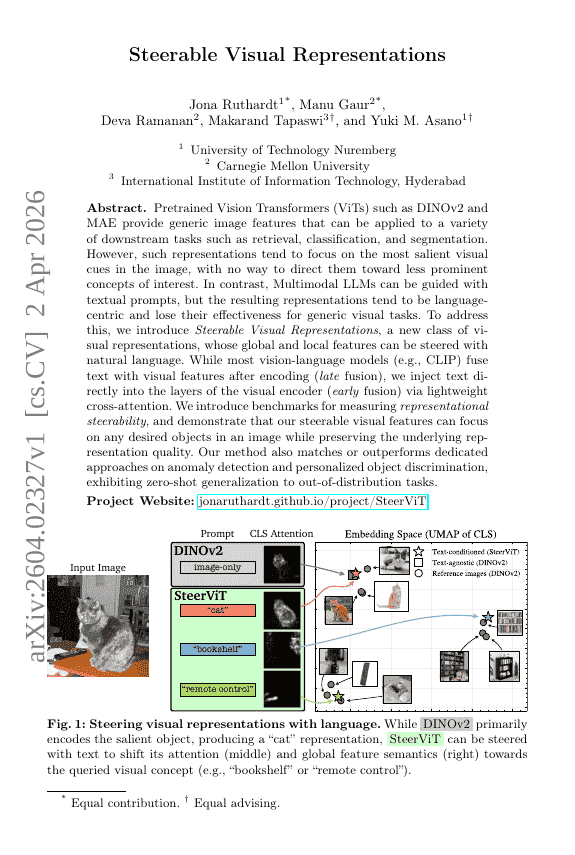
操作可能な視覚表現
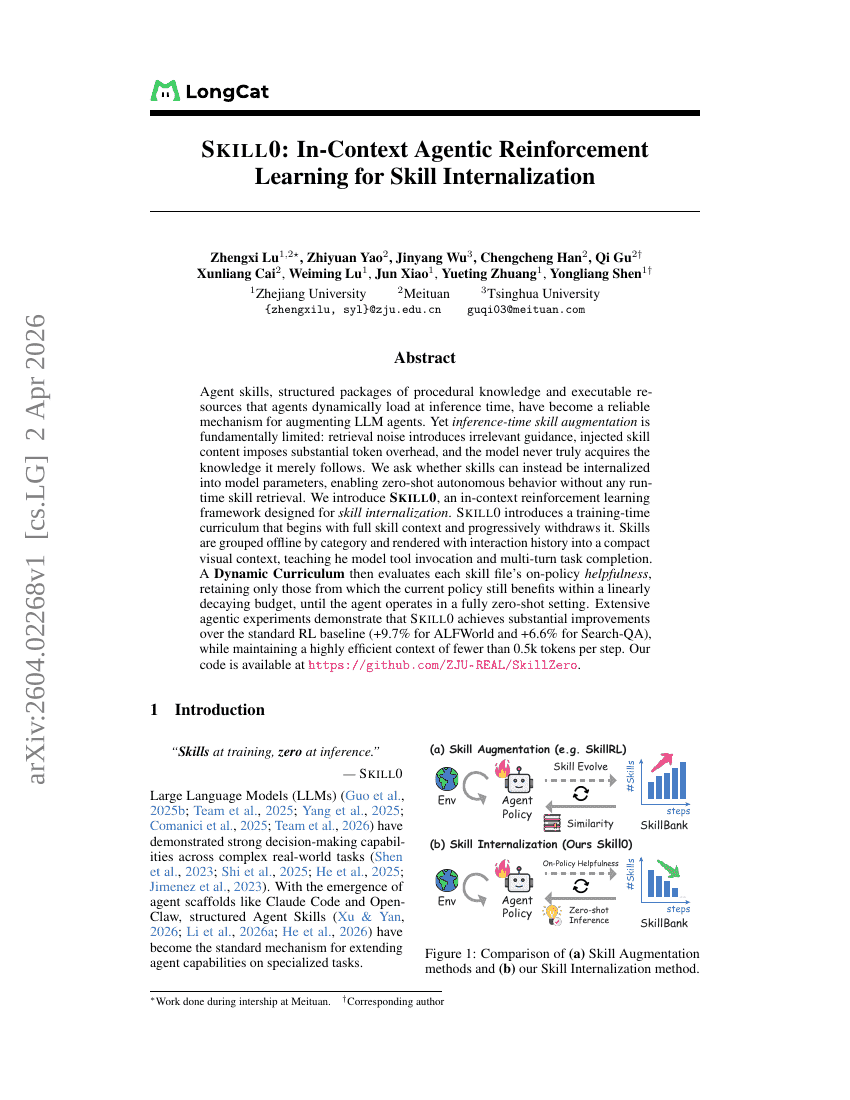
SKILL0: 文脈内エージェント強化学習によるスキルの内面化
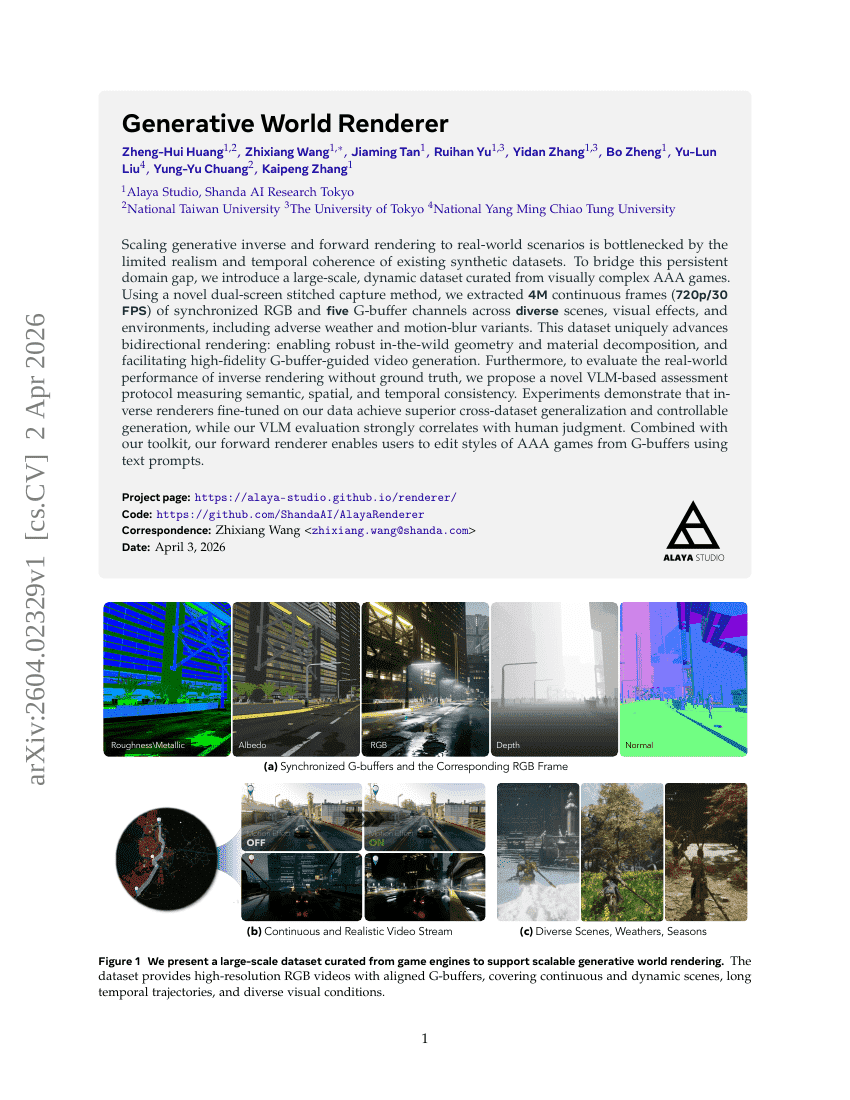
生成型ワールドレンダラー
潜在空間:基盤、進化、メカニズム、能力、および展望
DataFlex: 大規模言語モデルのデータ中心動的学習のための統合フレームワーク
QuitoBench:高品質なオープンタイムシリーズ予測ベンチマーク
Vision2Web:エージェント検証を備えた視覚的ウェブサイト開発のための階層的ベンチマーク
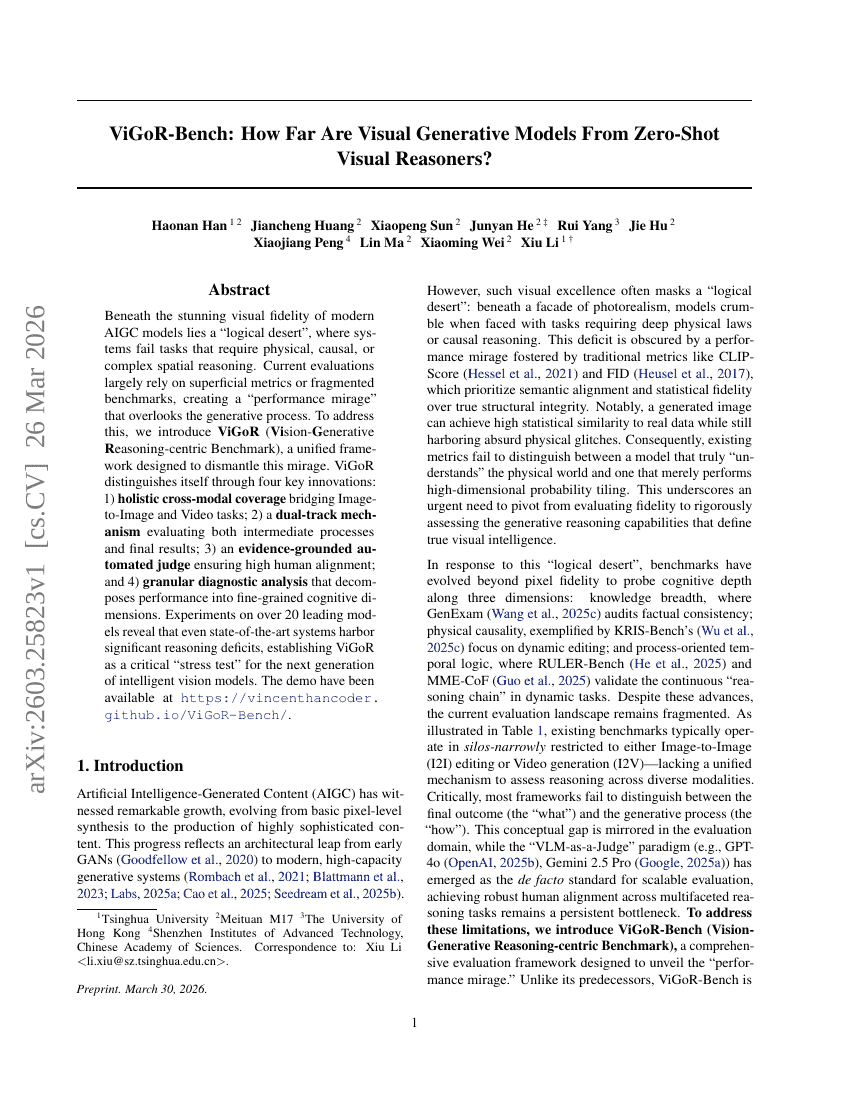
ViGoR-Bench:視覚生成モデルはゼロショット視覚推論器からどれほど遠いのか?
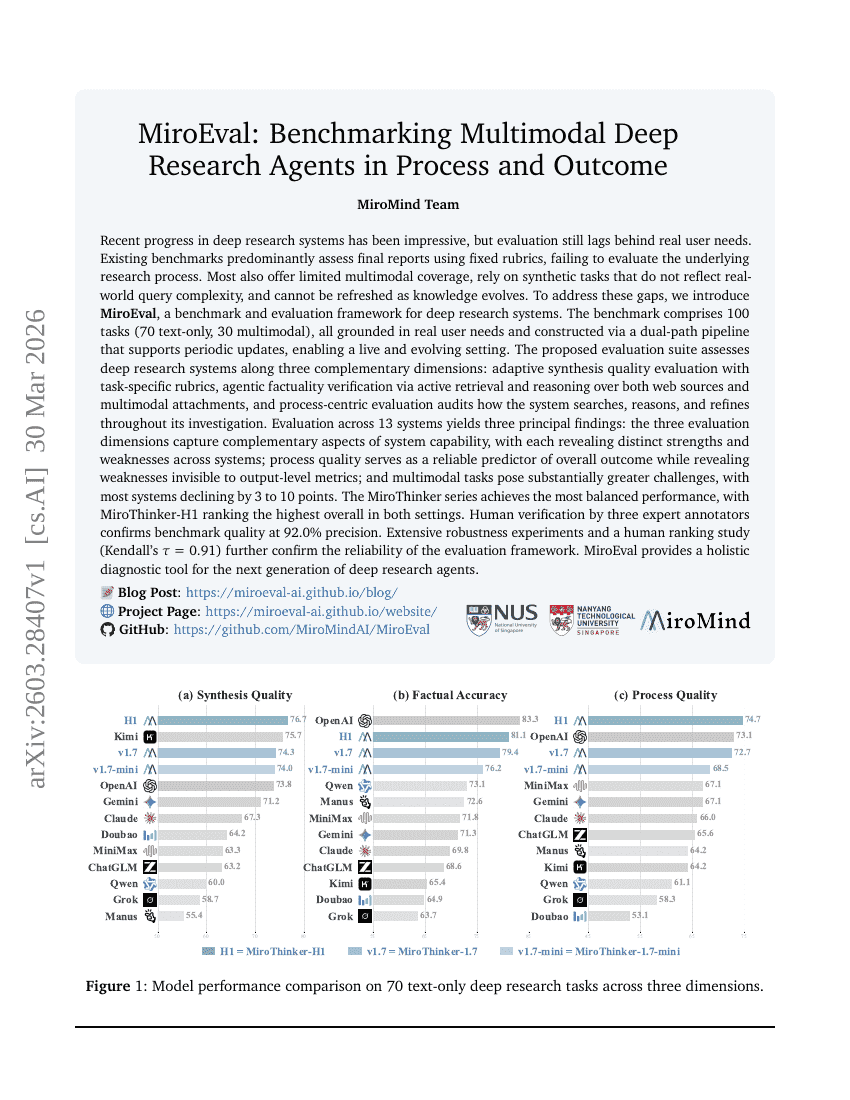
MiroEval: プロセスと成果におけるマルチモーダル深層研究エージェントのベンチマーク評価
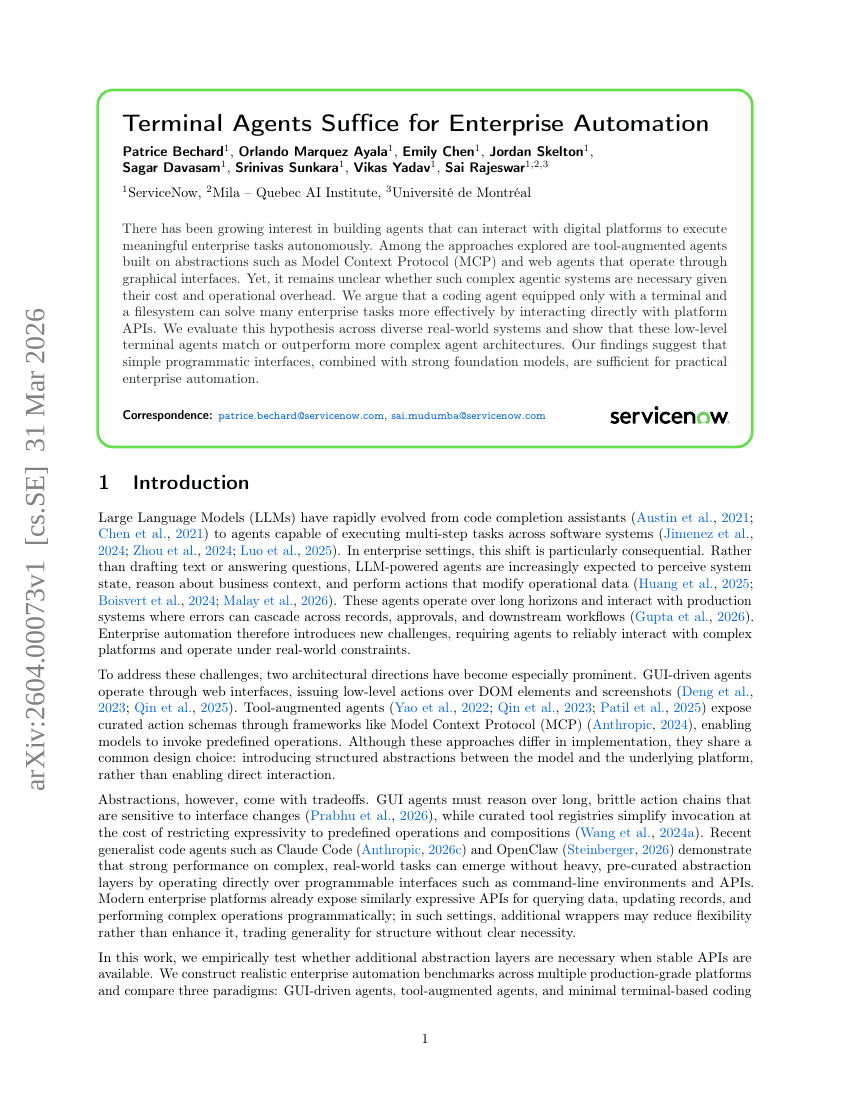
エンタープライズ自動化にはターミナル Agent で十分である
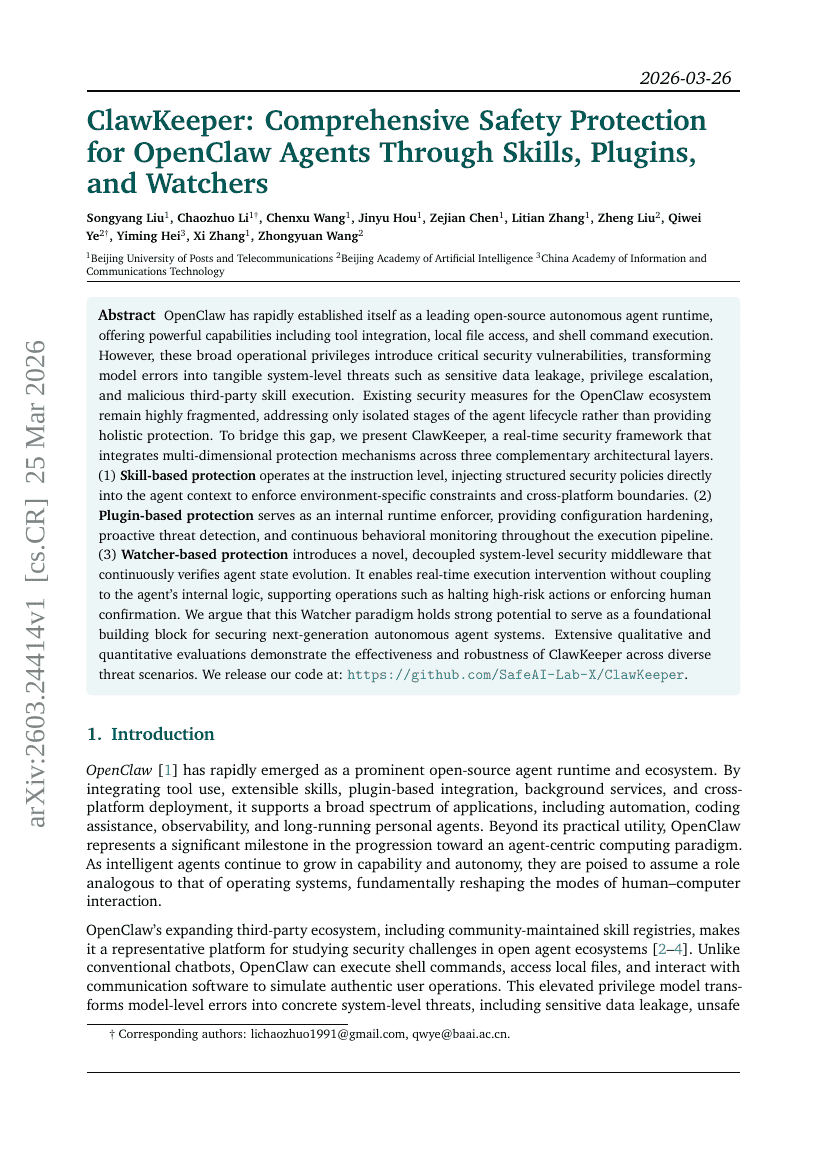
ClawKeeper: スキル、プラグイン、およびウォッチャーを通じた OpenClaw エージェントのための包括的な安全保護