HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
Audio-Omni: マルチモーダル理解から汎用的な音声生成・編集への拡張
大規模言語モデルにおける On-Policy Distillation の再考:現象論、メカニズム、およびレシピ




KnowRL: Minimal-Sufficient Knowledge Guidance を用いた Reinforcement Learning による LLM Reasoning の向上
Uni-ViGU: A Diffusion-Based Video Generator による、Video Generation と Understanding の統一に向けて
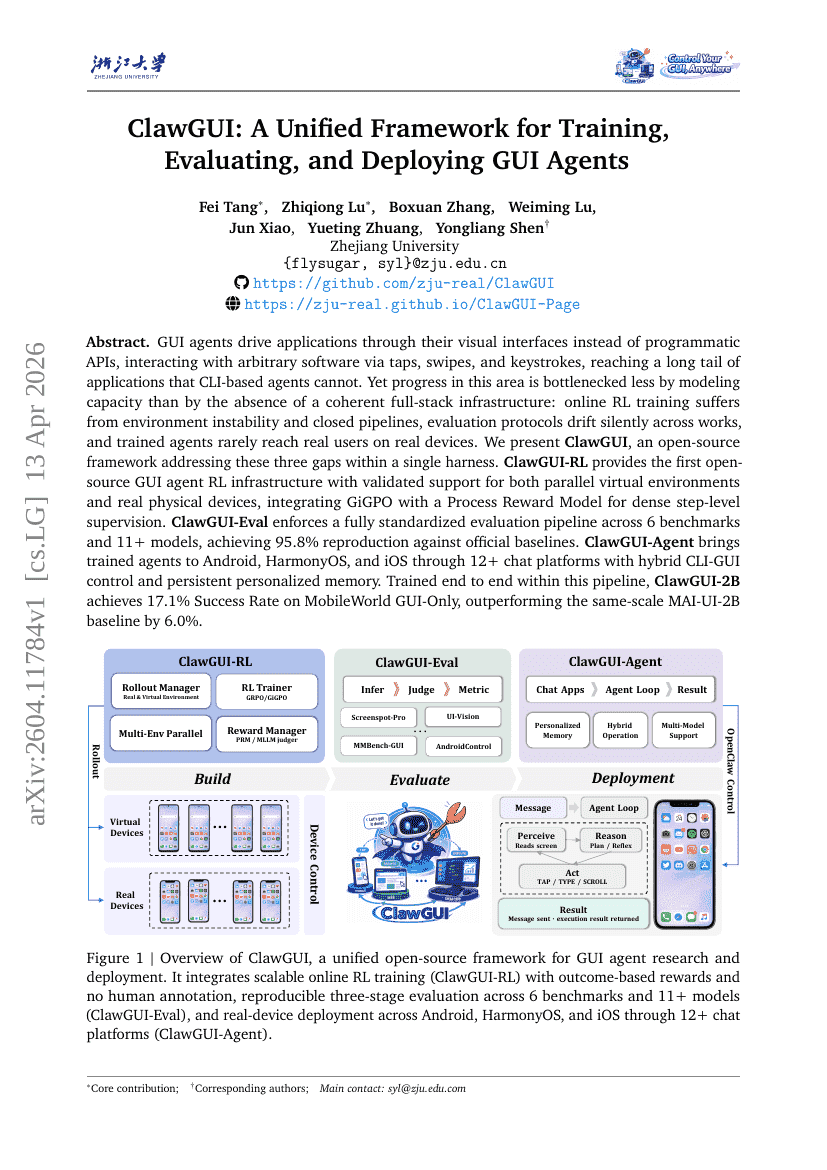
ClawGUI: GUIエージェントの訓練、評価、展開のための統一フレームワーク
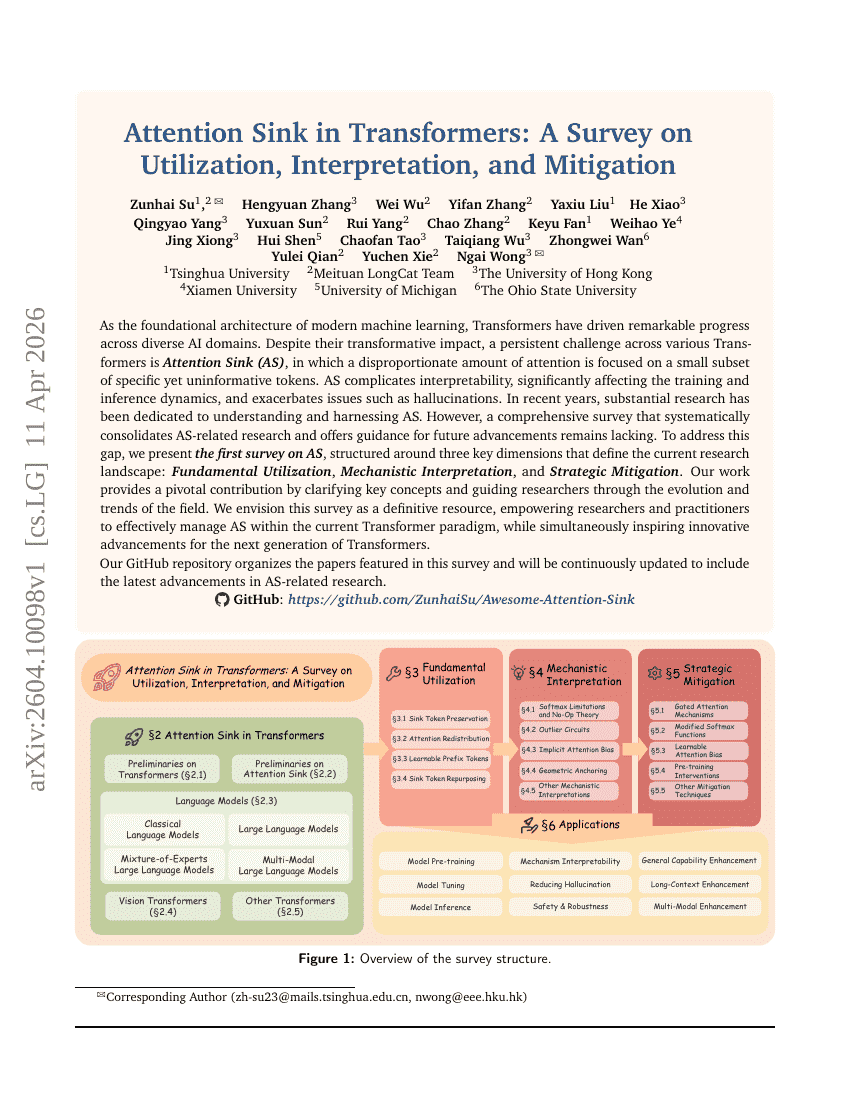
TransformerにおけるAttention Sink:その活用、解釈、および緩和策に関するサーベイ
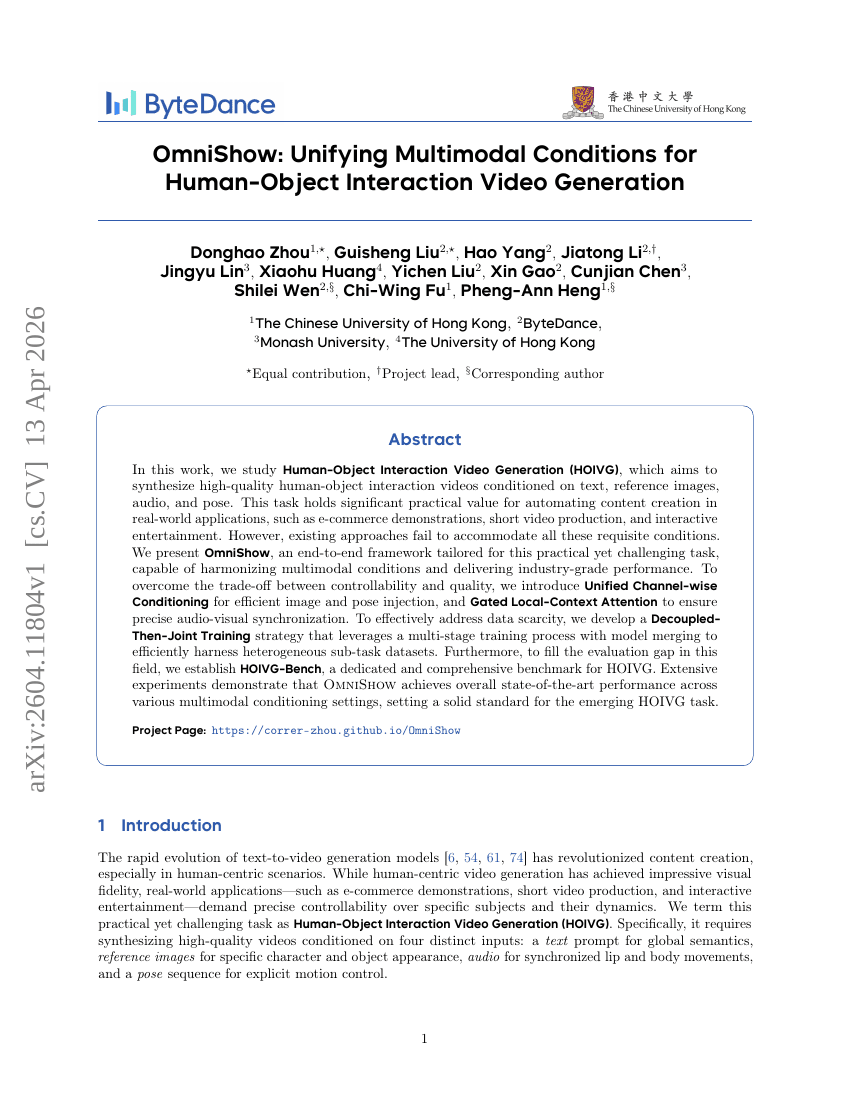
OmniShow: 人間と物体のインタラクション動画生成のためのマルチモーダル条件の統合
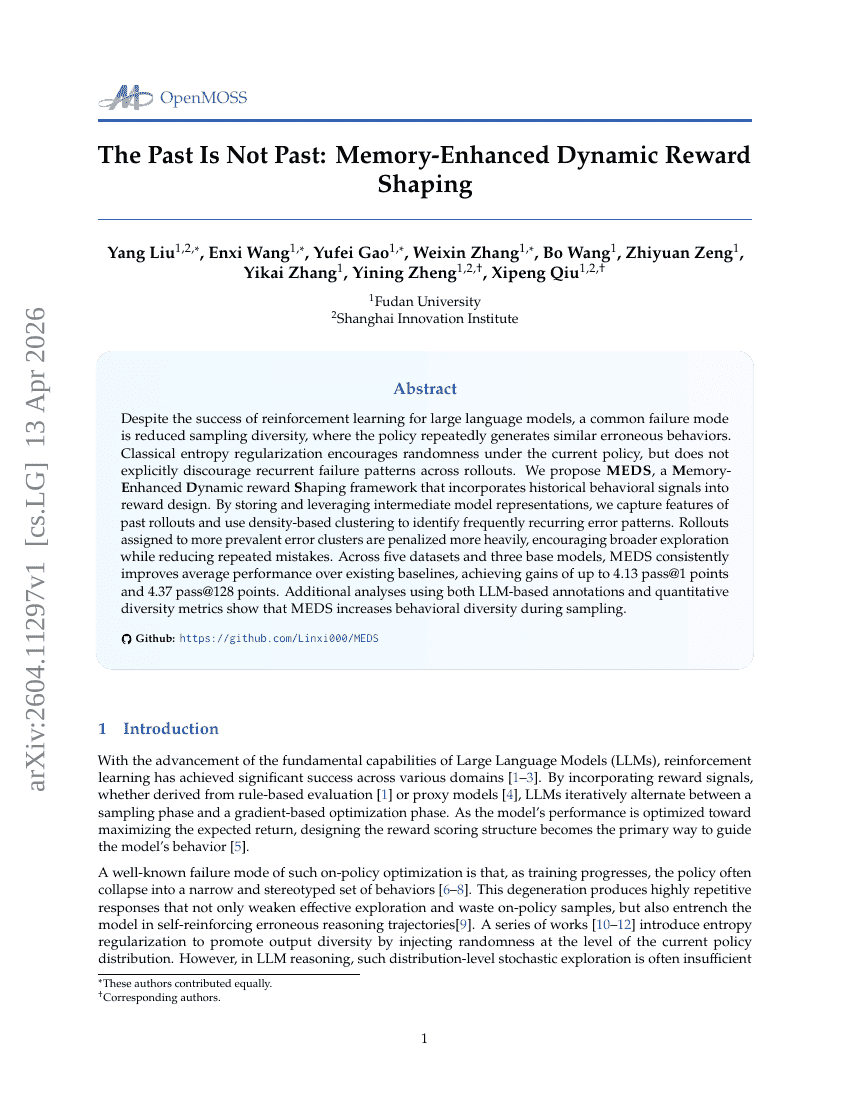
「過去は過去ではない:Memory-Enhanced Dynamic Reward Shaping」
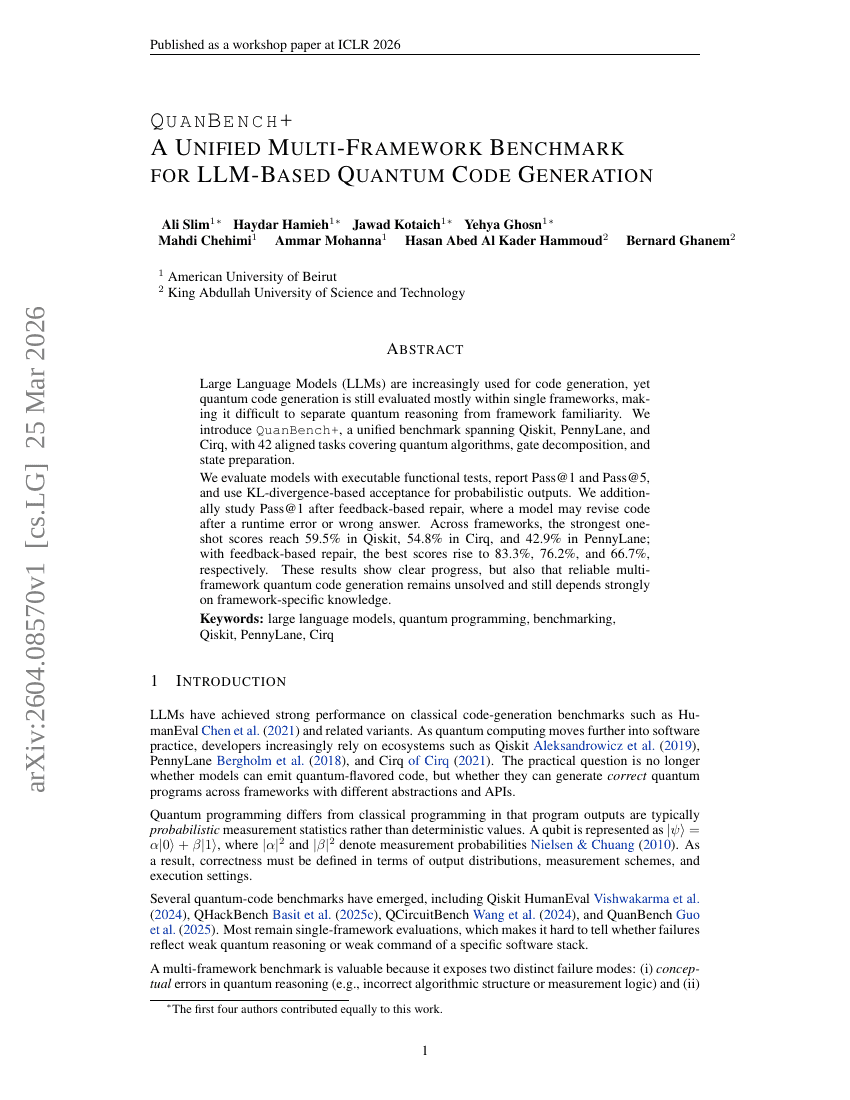
QuanBench+: LLMベースの量子コード生成に向けた、マルチフレームワーク統合Benchmark
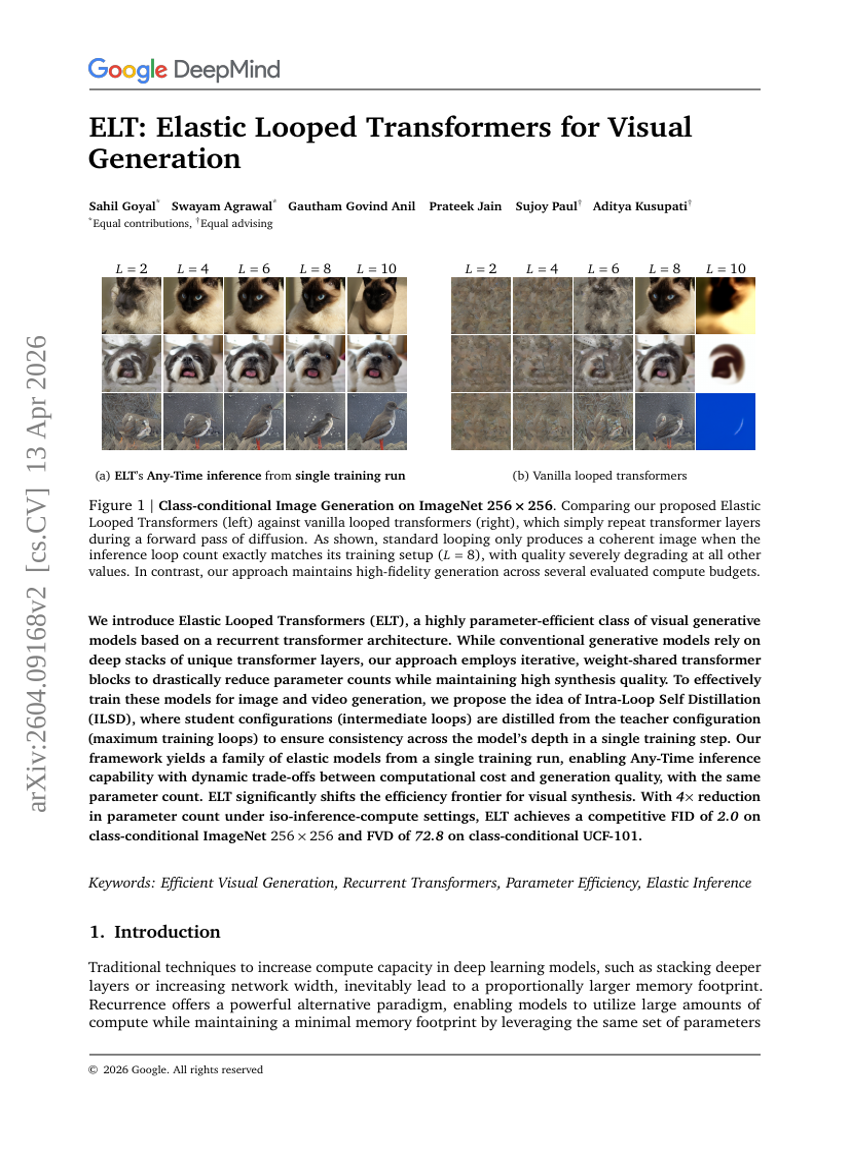
ELT:ビジュアル生成のための弾性ループ型トランスフォーマー
ECHO: One-step Block Diffusionを用いた効率的な胸部X線レポート生成
Matrix-Game 3.0: Long-Horizon Memoryを備えた、リアルタイムかつストリーミング可能なインタラクティブWorld Model
EXAONE 4.5 技術レポート
RefineAnything: 完璧なローカルディテールを実現するマルチモーダル領域特化型リファインメント
FORGE:製造シナリオにおけるきめ細かなMultimodal Evaluation
WildDet3D:野外環境におけるプロンプト可能な3D検出のスケーリング
Autoreason: 停止時期を判断可能な自己洗練(Self-Refinement)
ActiveGlasses: Ego-centricな人間のデモンストレーションからActive Visionを用いた操作学習を実現する手法
MegaStyle: 一貫したText-to-Image Style Mappingを通じて、多様かつスケーラブルなStyle Datasetを構築する手法
ご提示いただいたタイトルは、学術論文のタイトルとして非常に重要ですので、その文脈(AI・コンピュータビジョン分野のトップ会議やジャーナル)にふさわしい、格調高く正確な表現をご提案します。 翻訳結果は以下の通りです: 数字が語る時:Text-to-Video Diffusion Modelsにおけるテキスト内の数字表記と視覚的インスタンスの整合
【翻訳の解説(学術的観点から)】
When Numbers Speak: 文学的な表現ですが、論文のタイトルとしては「数字が語る時」あるいは「数字の意味するもの」といったニュアンスを含ませるのが一般的です。 Aligning: 機械学習の文脈では「整合(整合性を取る)」「アラインメント」と訳されます。ここでは、テキストと画像(動画)の内容を一致させることを指すため、「整合」という言葉を用いて学術的な響きを持たせています。 Textual Numerals and Visual Instances: 「Textual Numerals」はテキストに含まれる数字の表記(例:「3」や「three」)を指し、「Visual Instances」は動画内に現れる実際の物体(インスタンス)を指します。これらを「テキスト内の数字表記と視覚的インスタンス」と訳すことで、研究の対象を明確にしています。 Text-to-Video Diffusion Models: 指示通り、専門用語であるためそのまま英語で保持しています。
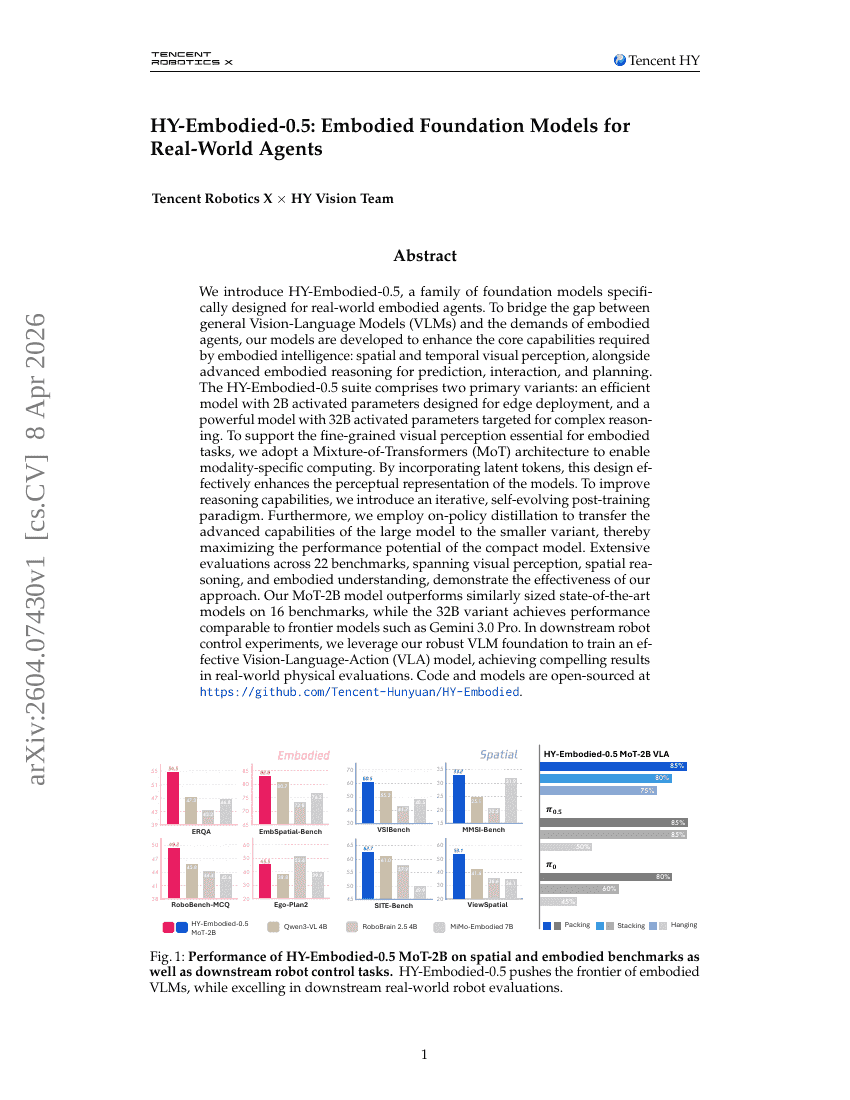
HY-Embodied-0.5:実世界における Agent のための Embodied Foundation Models
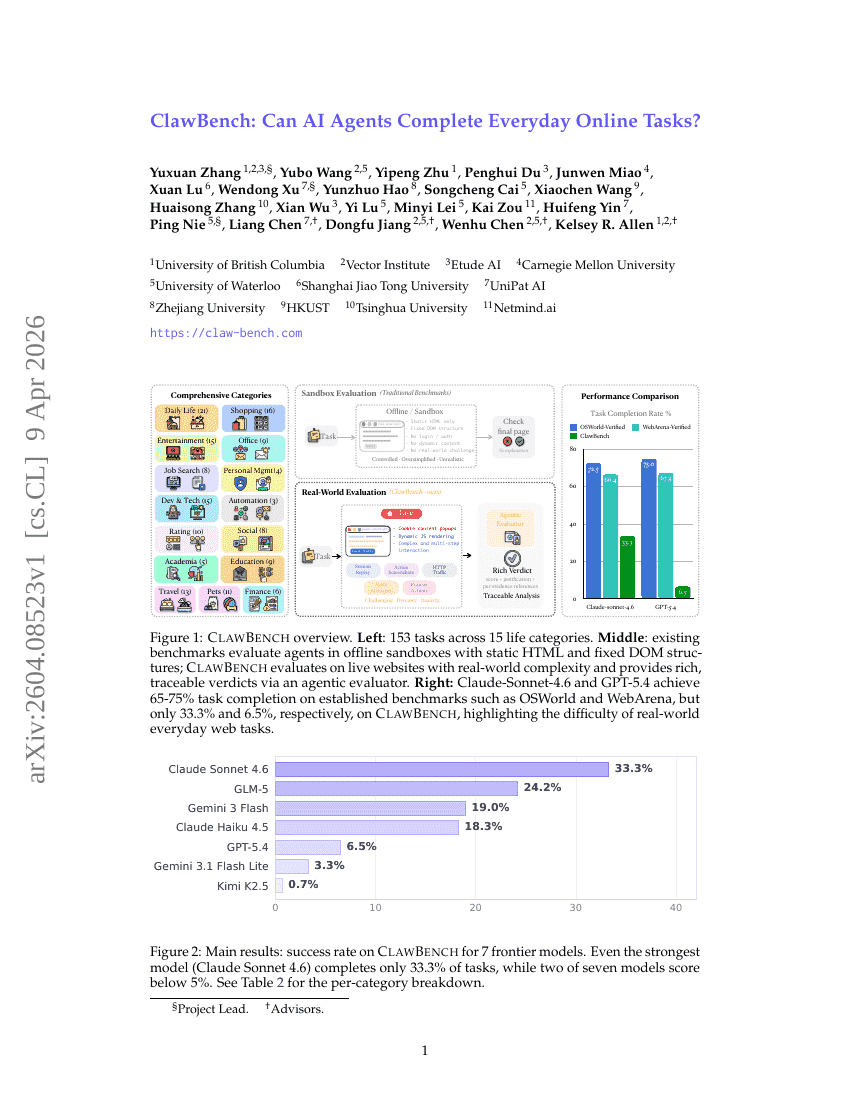
ClawBench: AIエージェントは日常のオンラインタスクを完遂できるか?
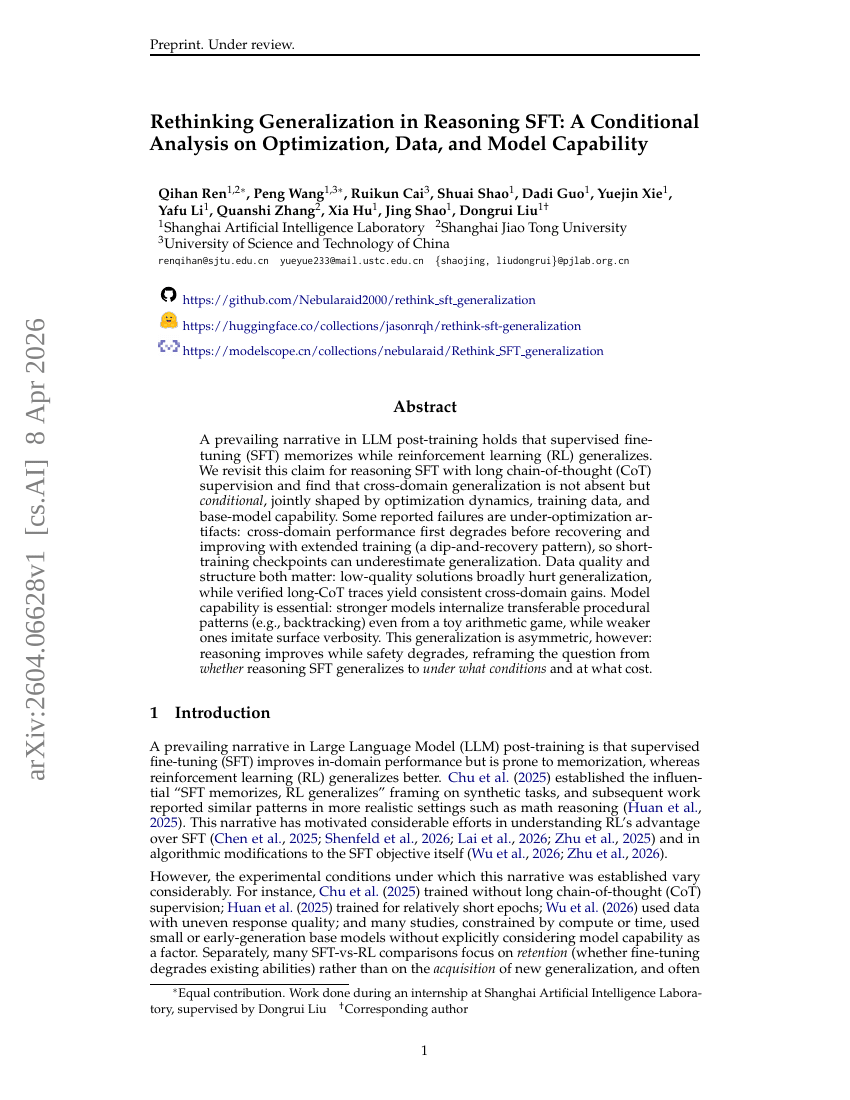
Reasoning SFTにおける汎化性能の再考:Optimization、Data、およびModel Capabilityに関する条件付き解析
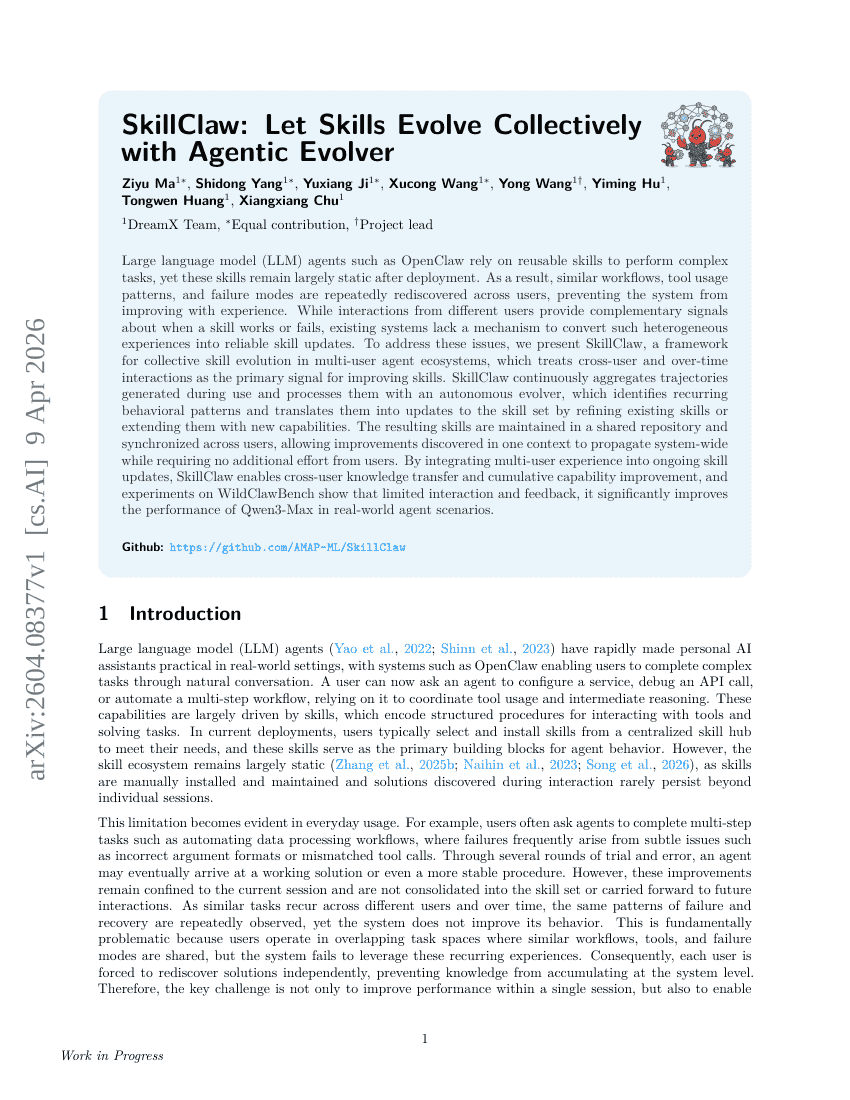
SkillClaw: Agentic Evolverによってスキルを集合的に進化させる
MDPBench: 実世界シナリオにおける多言語ドキュメントパースのためのベンチマーク
TC-AE: Deep Compression AutoencoderにおけるToken Capacityの解放
INSPATIO-WORLD: 時空間自己回帰モデリングによるリアルタイム4D World Simulator
FlowInOne: Image-in, Image-out の Flow Matching としてマルチモーダル Generation を統一する
MARS:実現する Autoregressive Models による Multi-Token Generation
ピクセルではなくストロークで考える:交互的なReasoningによるプロセス駆動型画像生成
RAGEN-2:Agentic RLにおけるReasoning Collapse(推論の崩壊)
Vanast: 合成されたTriplet Supervisionを用いたHuman Image AnimationによるVirtual Try-On