HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
DataFlex-RL: Eine Evaluierungsplattform für RLVR-Datenrichtlinien
Den Vision–Action-Shortcut durchbrechen: Latent Interface Training für generalisierbare Robotik-Foundation-Modelle


Feyospace-v1: Wie die Cyber Mercury Seven zukunftsweisende Cyber-Modelle trainierten
X-AuT: Progressive Audio-Encoder-Kompression für Sprach-LLMs mittels skalenübergreifender Destillation
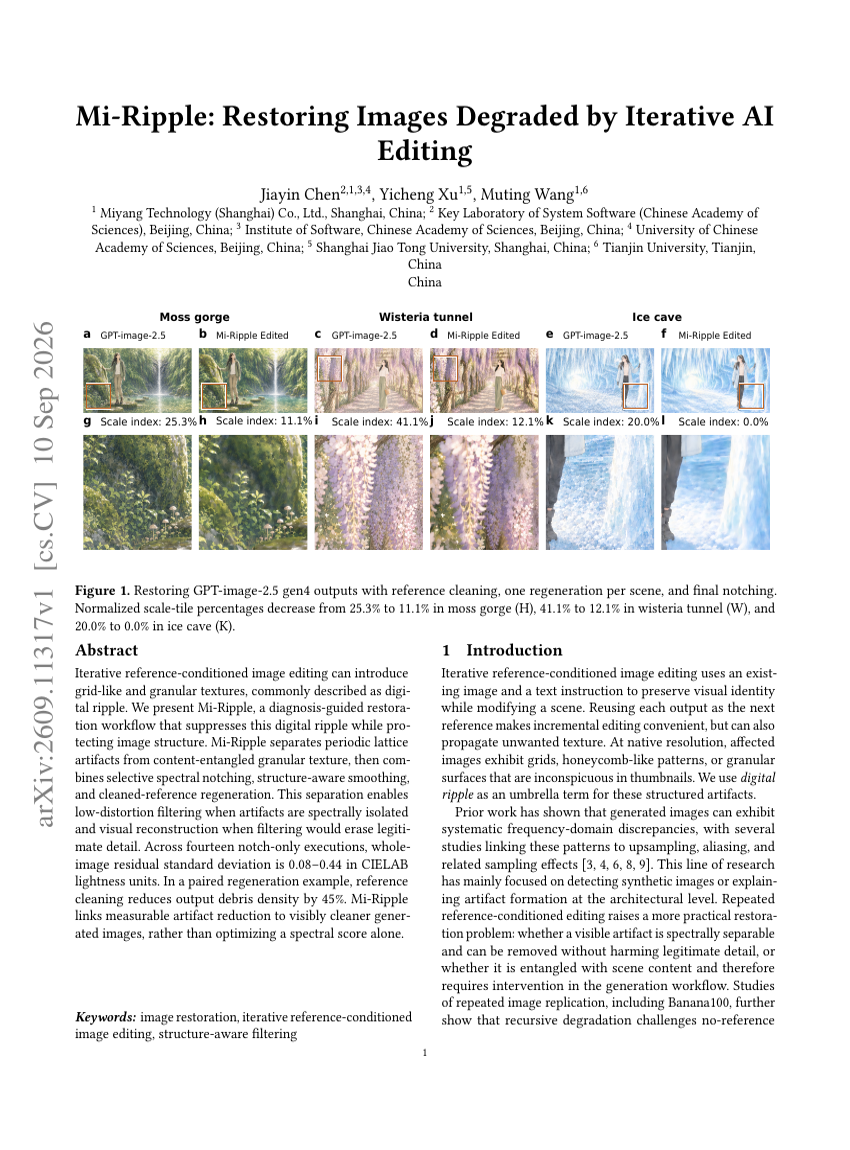
Mi-Ripple: Wiederherstellung von durch iterative KI-Bearbeitung degradierten Bildern
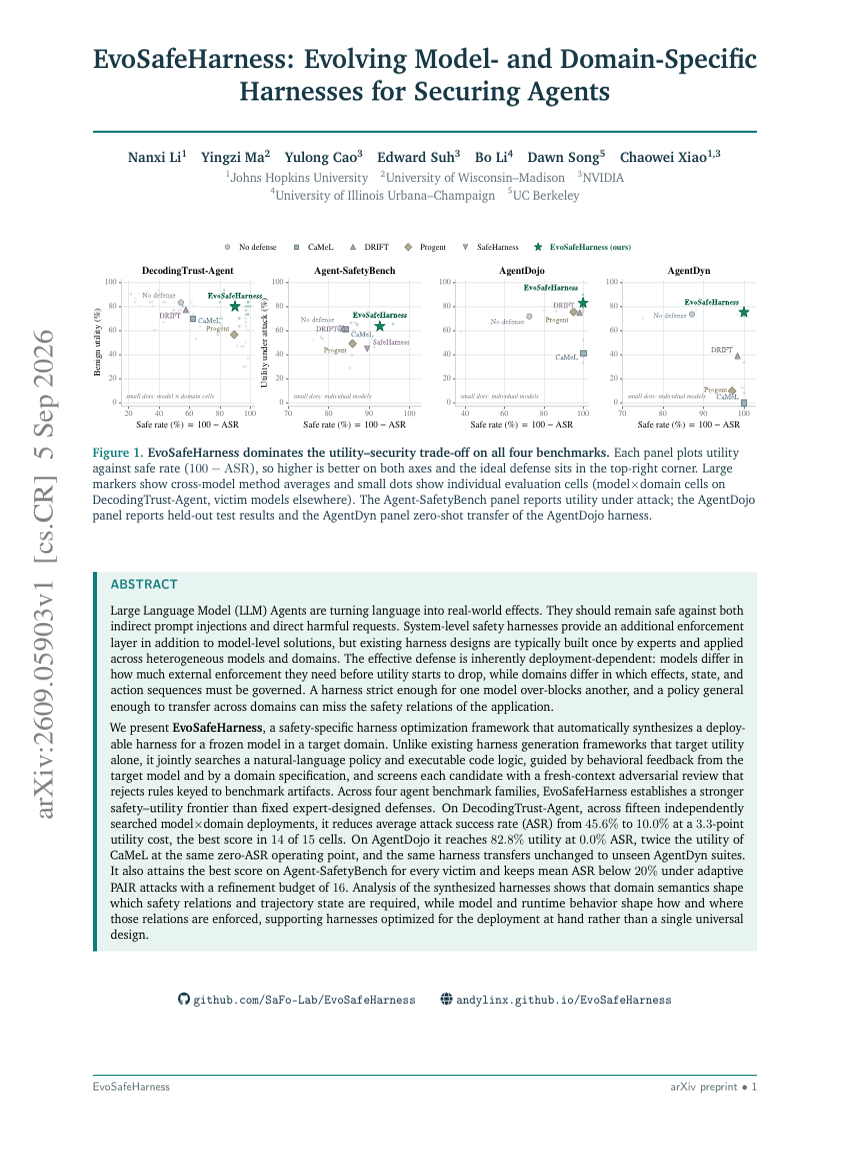
EvoSafeHarness: Evolutionäre modellund domänenspezifische Sicherheitsgurte für Agenten
SpatialBlock: Verbesserung der räumlichen Intelligenz in LVLMs durch synthetische Blockstapelprobleme
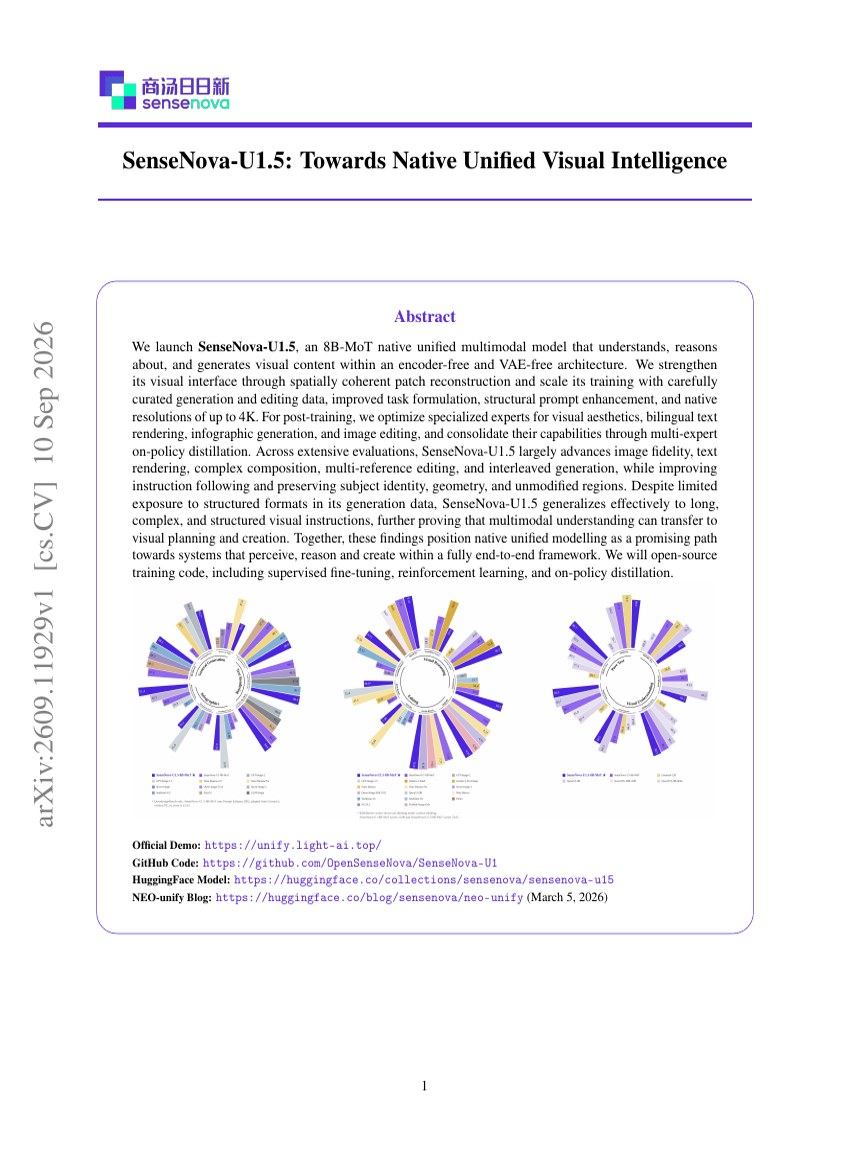
SenseNova-U1.5: Auf dem Weg zu nativer, vereinheitlichter visueller Intelligenz
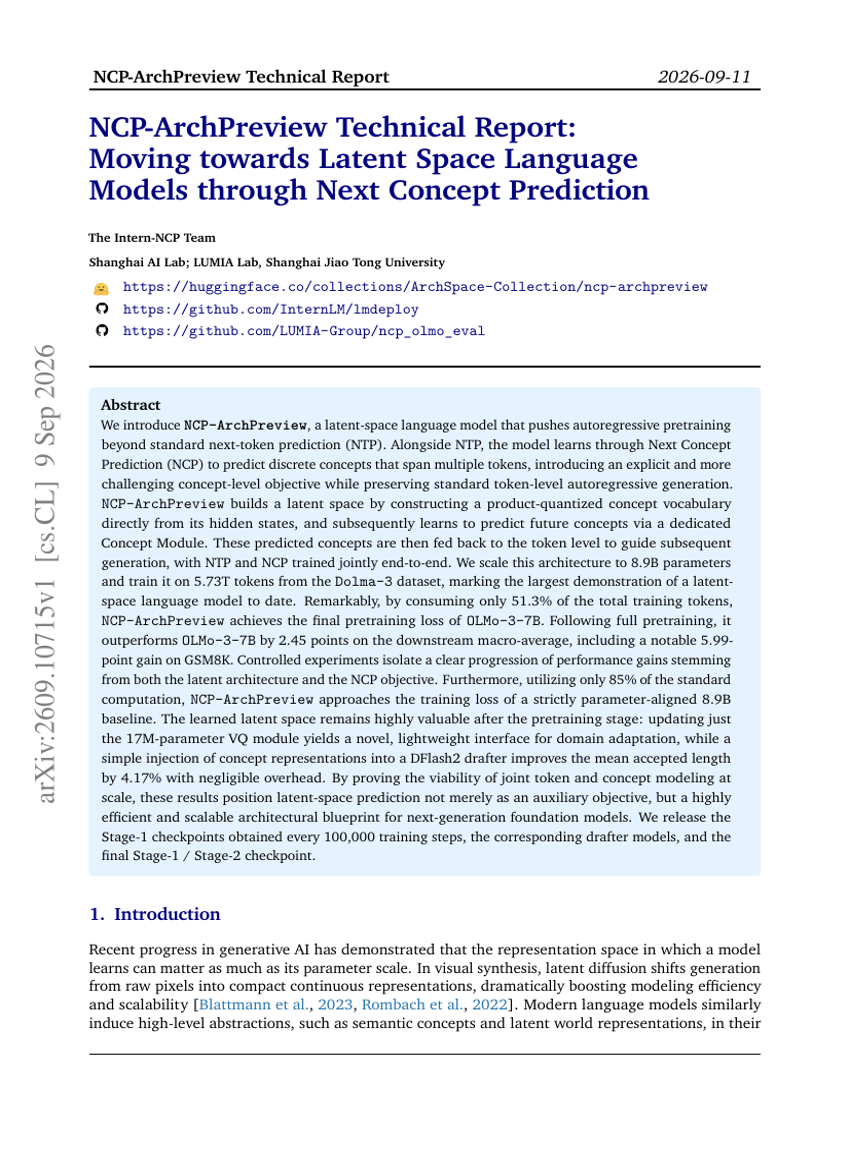
NCP-ArchPreview Technischer Bericht: Auf dem Weg zu Sprachmodellen im latenten Raum durch Next Concept Prediction
SAESCIENTIST-BENCH: KÖNNEN KI-AGENTEN AUTONOME SAE-INTERPRETIERBARKEITSFORSCHUNG BETREIBEN?
SWE-Bench Pro Verified: Ein verlässlicher Maßstab für Software-Engineering-Agenten
WearableQA: Ein Benchmark für gesundheitliches Schlussfolgern auf Basis realer Wearable-Daten
AgentGrad: Interventionsgesteuerte Prompt-Optimierung für Multi-Agenten-Systeme
Programmierbares Weltmodell
Show-Harness: Wie ein einfacher VLM-Agent Roboter steuern kann
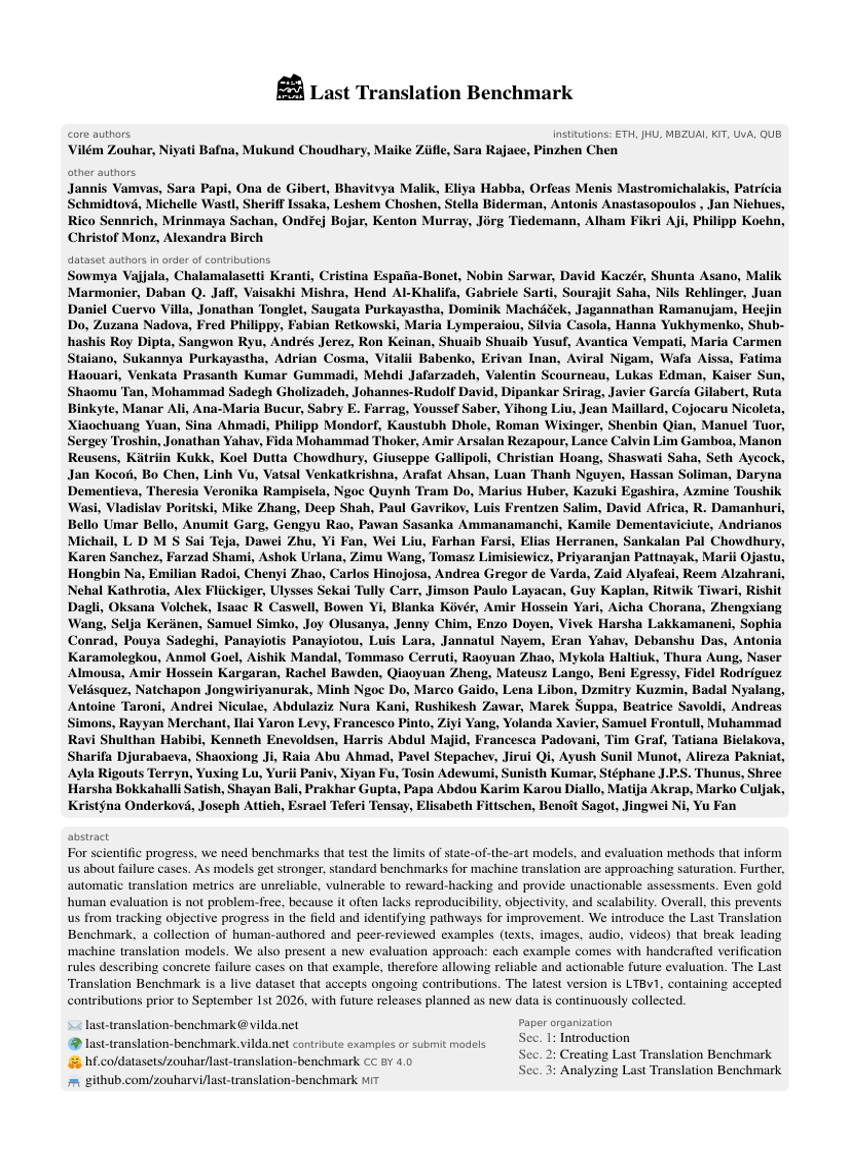
Last Translation Benchmark
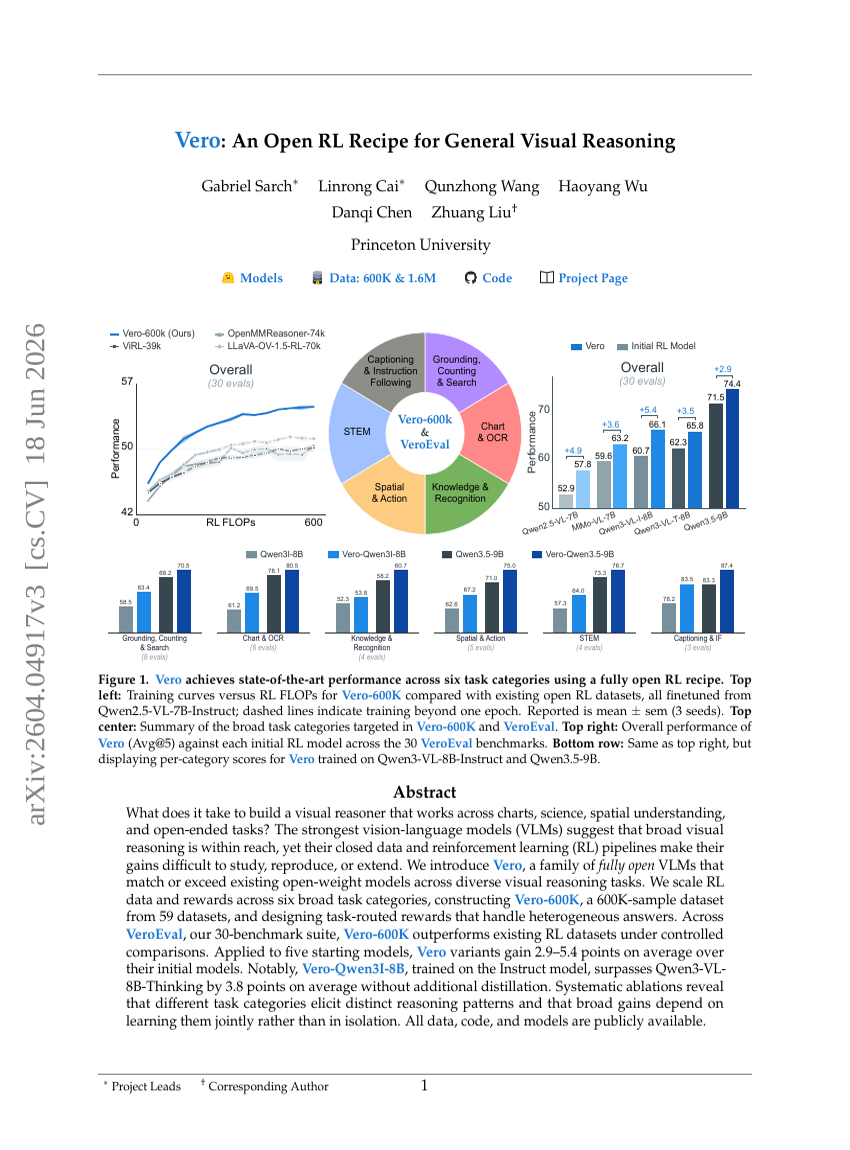
Vero: Ein offenes RL-Rezept für allgemeines visuelles Denken
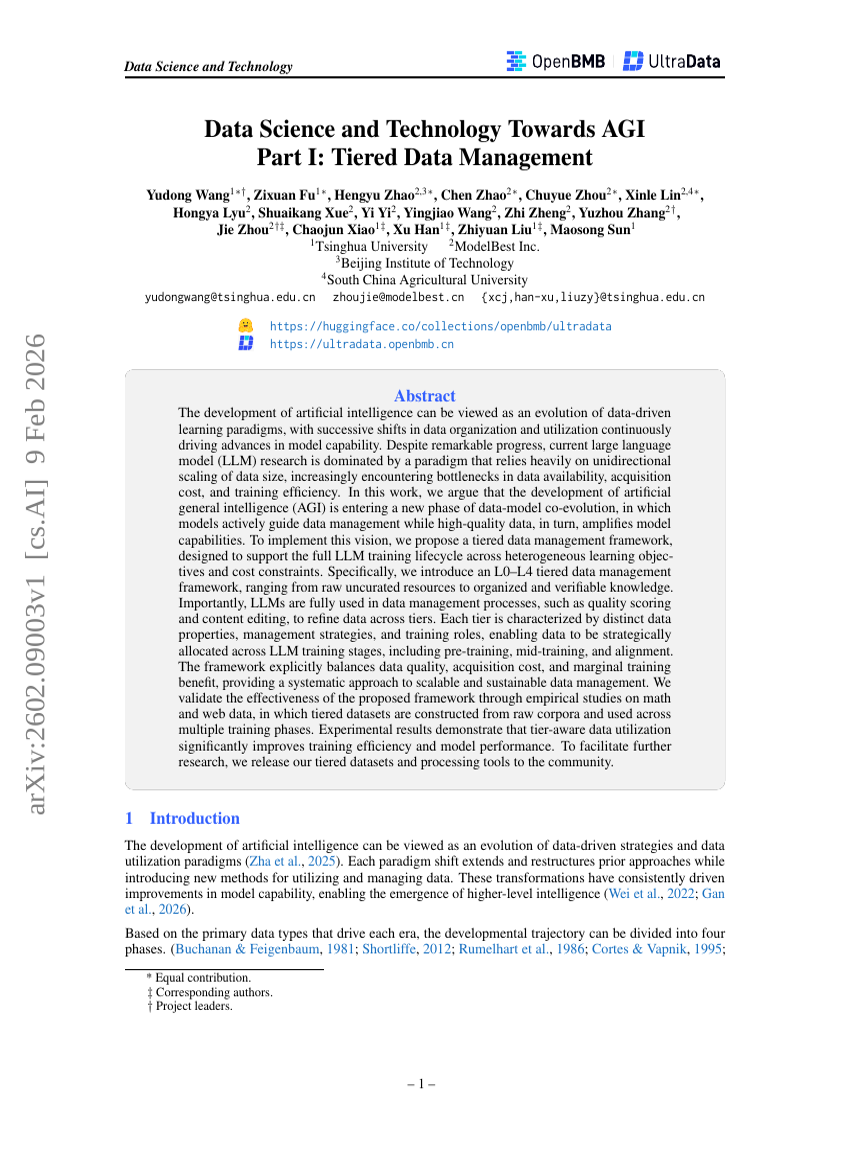
Datenwissenschaft und -technologie auf dem Weg zur AGI Teil I: Gestuftes Datenmanagement
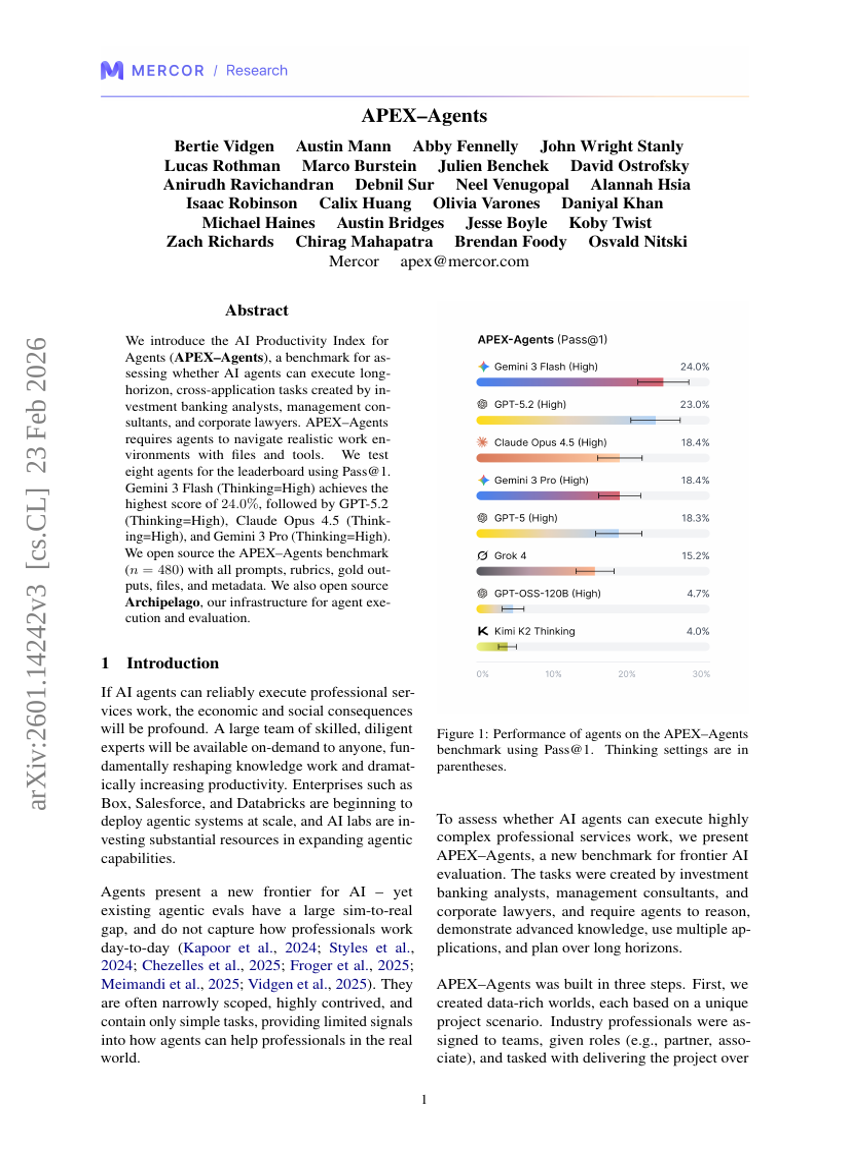
APEX–Agents
TERMINAL-BENCH: BEWERTUNG VON AGENTS AN SCHWIERIGEN, REALISTISCHEN AUFGABEN IN KOMMANDOZEILENSCHNITTSTELLEN
Orca: Progressives Lernen aus komplexen Erklärungsabläufen von GPT-4
Technischer Bericht zum Omni-Interaktionsagenten
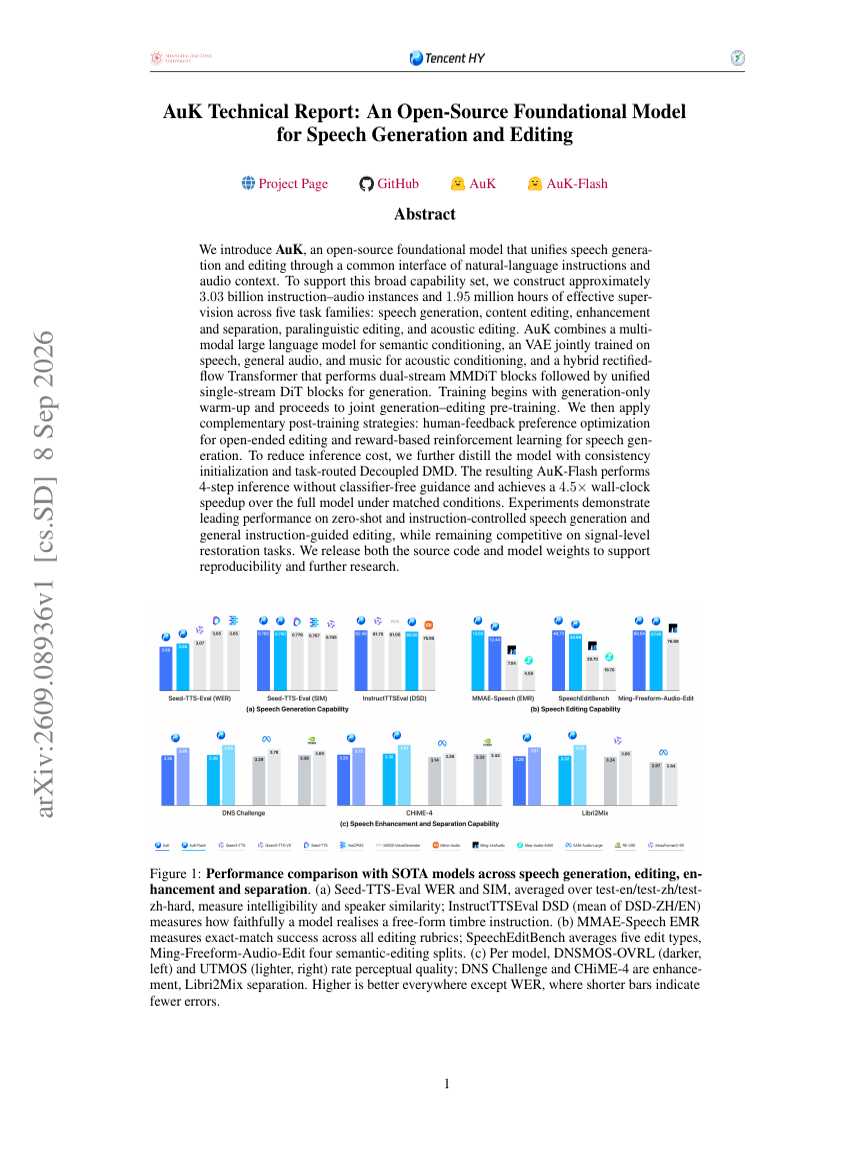
AuK Technical Report: Ein Open-Source-Basismodell für Sprachgenerierung und -bearbeitung
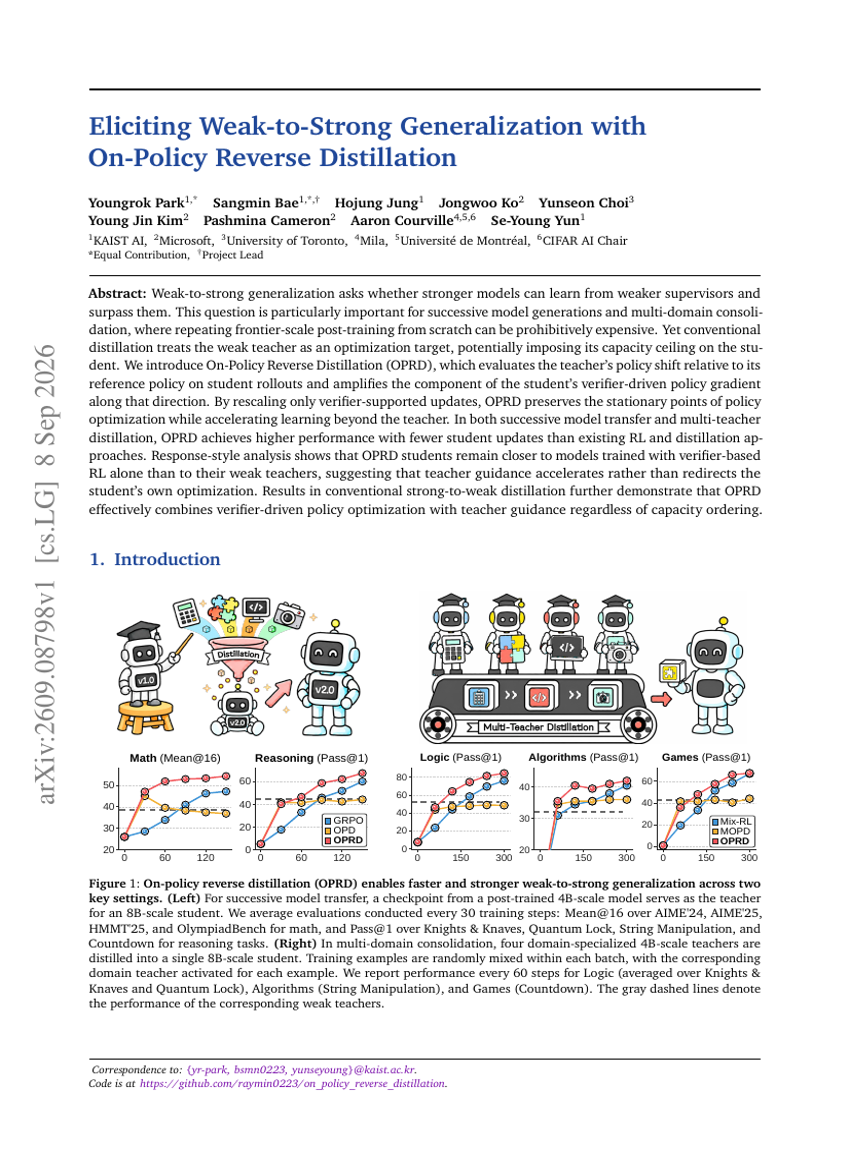
Erzielung von Weak-to-Strong-Generalization durch On-Policy-Reverse-Destillation
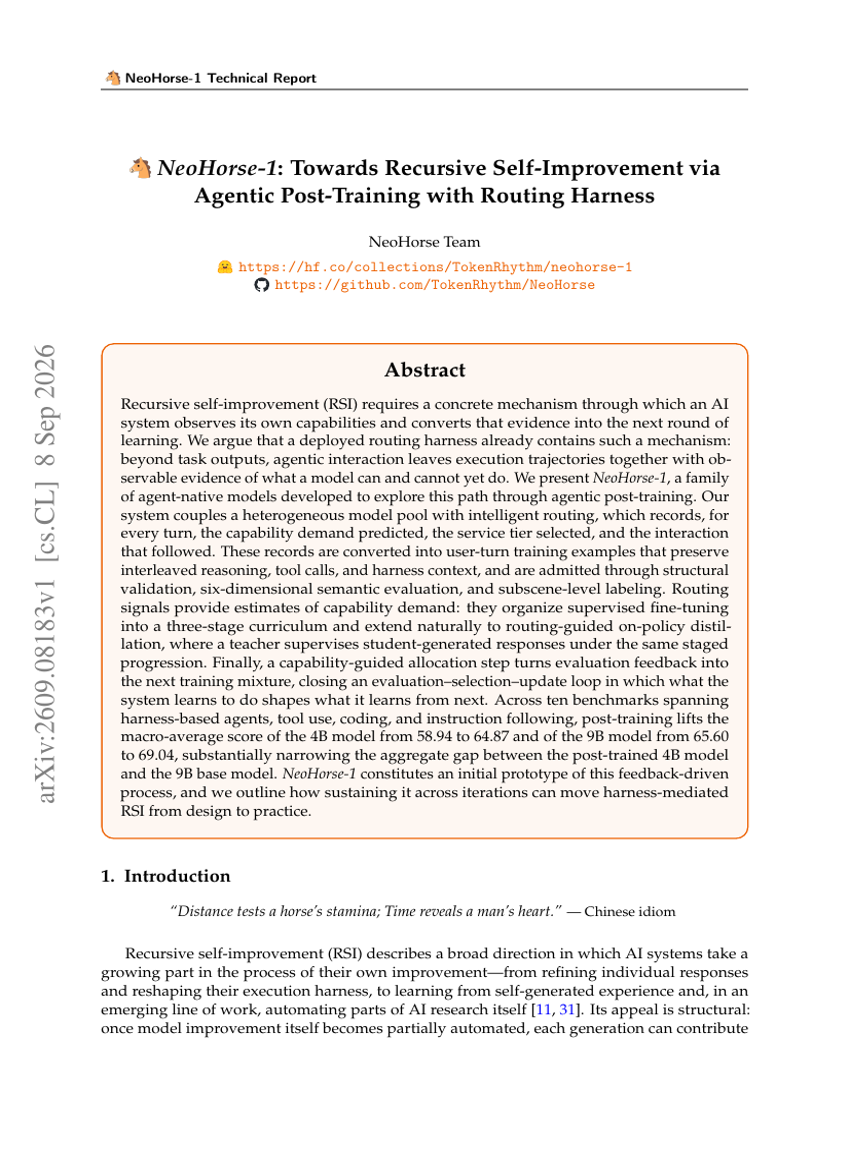
NeoHorse-1: Auf dem Weg zur rekursiven Selbstverbesserung durch agentisches Post-Training mit Routing-Harness
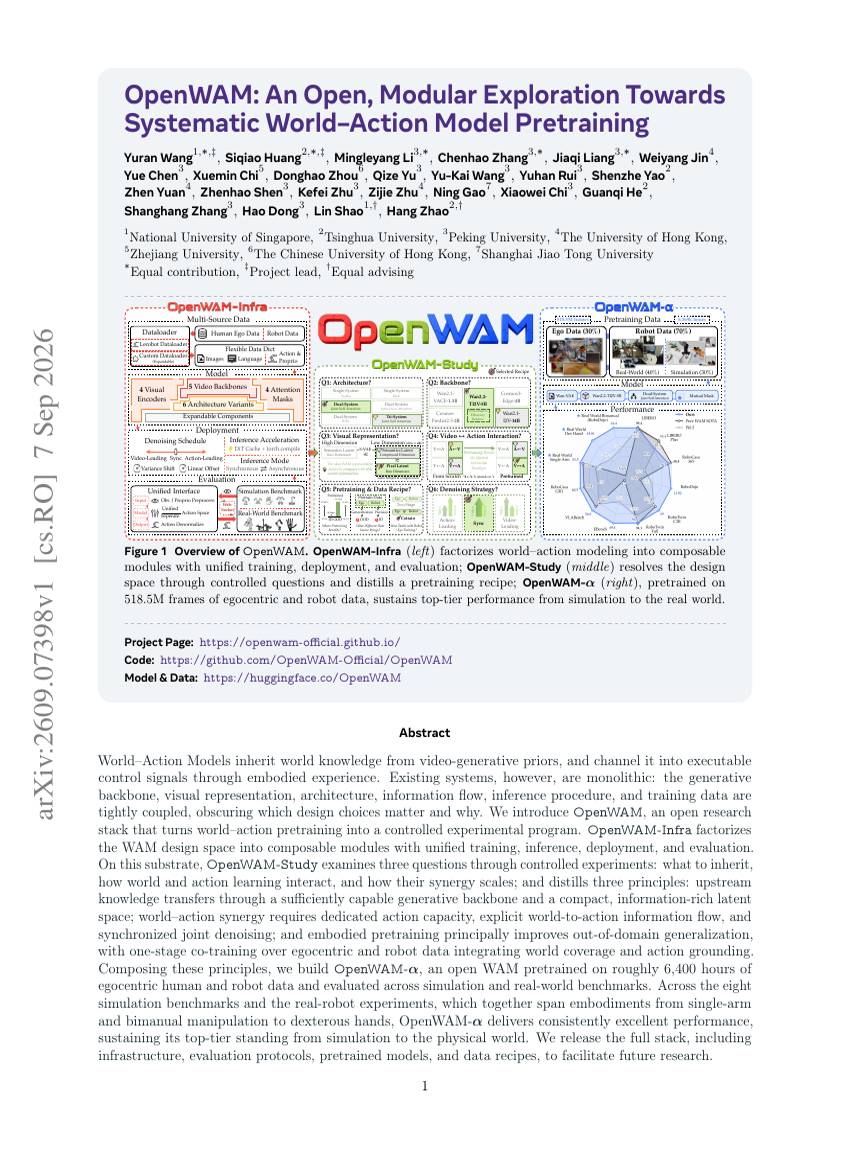
OpenWAM: Eine offene, modulare Erkundung hin zum systematischen Pretraining von Welt-Handlungs-Modellen
DriveZero: End-to-End-Fahren jenseits menschlicher Demonstrationen
ENEAS: Embedding-gestützte neuronale Ensemble-Methode für adaptive Segmentierung.
FlowBalance: Verifier-gestützte Selbstverbesserung durch On-Policy-Erfahrungen beim Reasoning
Kausale Fundamentmodelle
EmbodiedSkills: Ein einheitliches Framework zur Orchestrierung, zum Training und zur Bereitstellung von VLA-Agenten
Verlustfreie Beschleunigung von LLMs durch diskrete Diffusion