HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
Rufus-Air: Ein offenes Post-Training-Rezept für LLMs
Agent-Editing World Model: Weltmodellierung für LLM-Agenten neu gedacht
OMNIECHO: Audio-visuelles räumliches Verständnis für omni-modale verkörperte Agenten
WanPE: Auf dem Weg zu filmischer Prompt-Verbesserung für die moderne Text-zu-Video-Generierung
Ihr Transformer kann zwei Gedanken gleichzeitig halten: Evidenz für lineare Superposition in LLMs
Training von Objektpermanenz in Weltmodellen
Just-in-Time Memory: Lernen, ein aufgabenadaptives Gedächtnis für LLM-Agenten zu kuratieren
RewardVerse: Rubrikgeleitete Policy-Optimierung für die Video-Reward-Modellierung
SPEAKERMEM-R1: Sprecherzentriertes Dual-Track-Gedächtnis für Mehrparteiendialoge
Die Vergangenheit rahmt die Zukunft: Gedächtnis für autoregressive Videogenerierung – Ein Überblick
Spatial-Interactor: Erlernen räumlichen Denkens durch Interaktion mit der beobachtbaren physischen Welt
HappyWorld-Bench
Schaltkreis-Hypernetzwerke für quantenverstärkte Diffusions-Sprachmodelle
Bellman Policy Optimization
All-in-One-Szenentexterkennung für mehrere Sprachen mit skriptbewusstem Mixture-of-Experts
GAE: Lernen eines geometrie-nativen latenten Raums für 3D-konsistente Weltgenerierung
RULER: Instanzbezogene Rubrik-Belohnungen für die SVG-Generierung
Der geschmackvolle Agent: Messung und Verbesserung von Geschmack bei Aufgaben mit langem Horizont
OmniEdu: Offene Foundation-Modelle für Lernen und Lehren
Document Retrieval-Aware Chunking (D-RAC): Universelle retrieval-bewusste Aufnahme von Unternehmensdokumenten durch PDF-Normalisierung und multimodale Markdown-Konvertierung
GameHorizon Suite: Multi-Horizon-Daten und -Evaluierung im Gameplay
Übertragung der Intelligenz von VLMs auf die Robotersteuerung
WorldCrafter: Konsistentes Video-Weltmodell mit implizitem 3D-bewusstem Gedächtnis
RRSI: Regularisierte rekursive Selbstverbesserung von Agenten-Harnesses
OMNIVCHAT: Synthese, Benchmarking und Training für nativen audiovisuellen Dialog
RECREATIONWORLD: Skalierbare und verifizierbare Umgebungen für hybride Computer-Use-Agenten
EvoOntology: Eine selbstevolvierende Ontologieschicht für Datenagenten
CodeMidas: Skalierung agentischer Coding-RL-Umgebungen aus dem Code selbst
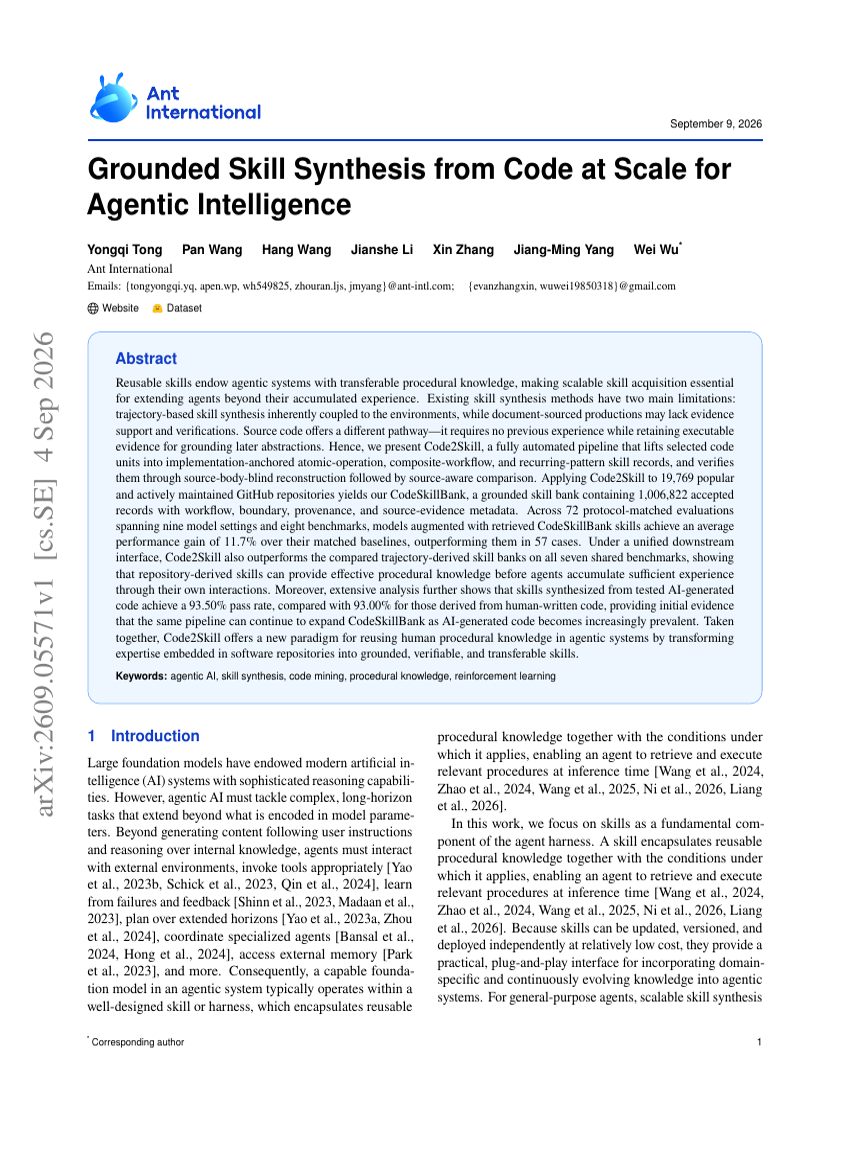
Fundierte Skill-Synthese aus Code im großen Maßstab für agentische Intelligenz
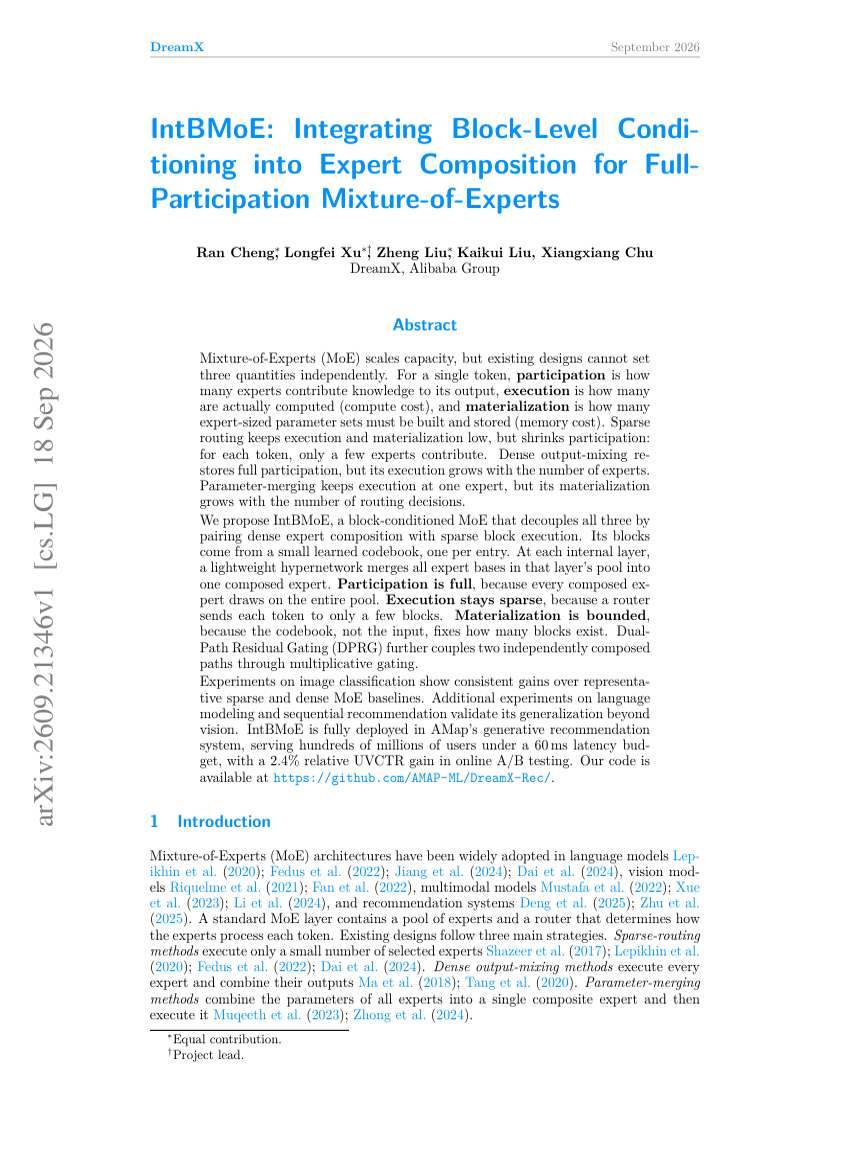
IntBMoE: Integration blockbasierter Konditionierung in die Expertenkomposition für Mixture-of-Experts mit vollständiger Partizipation
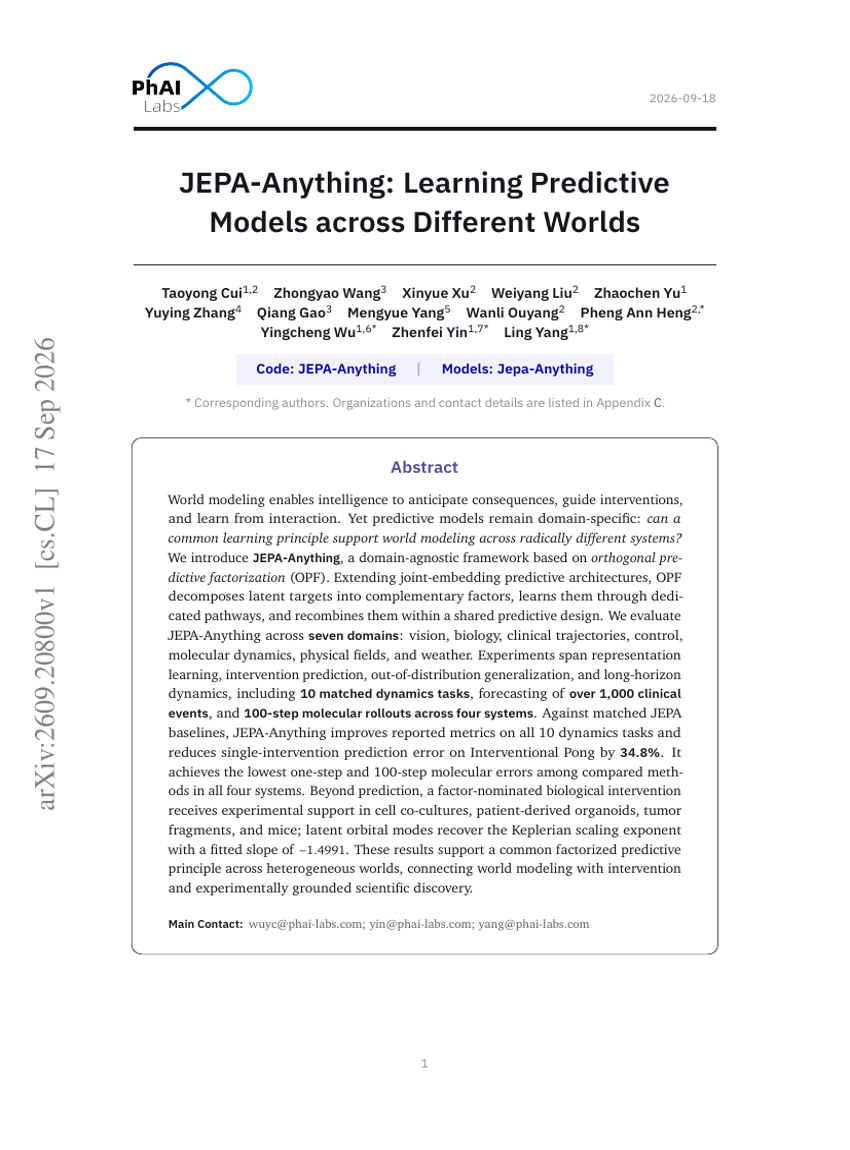
JEPA-Anything: Lernen prädiktiver Modelle über verschiedene Welten hinweg
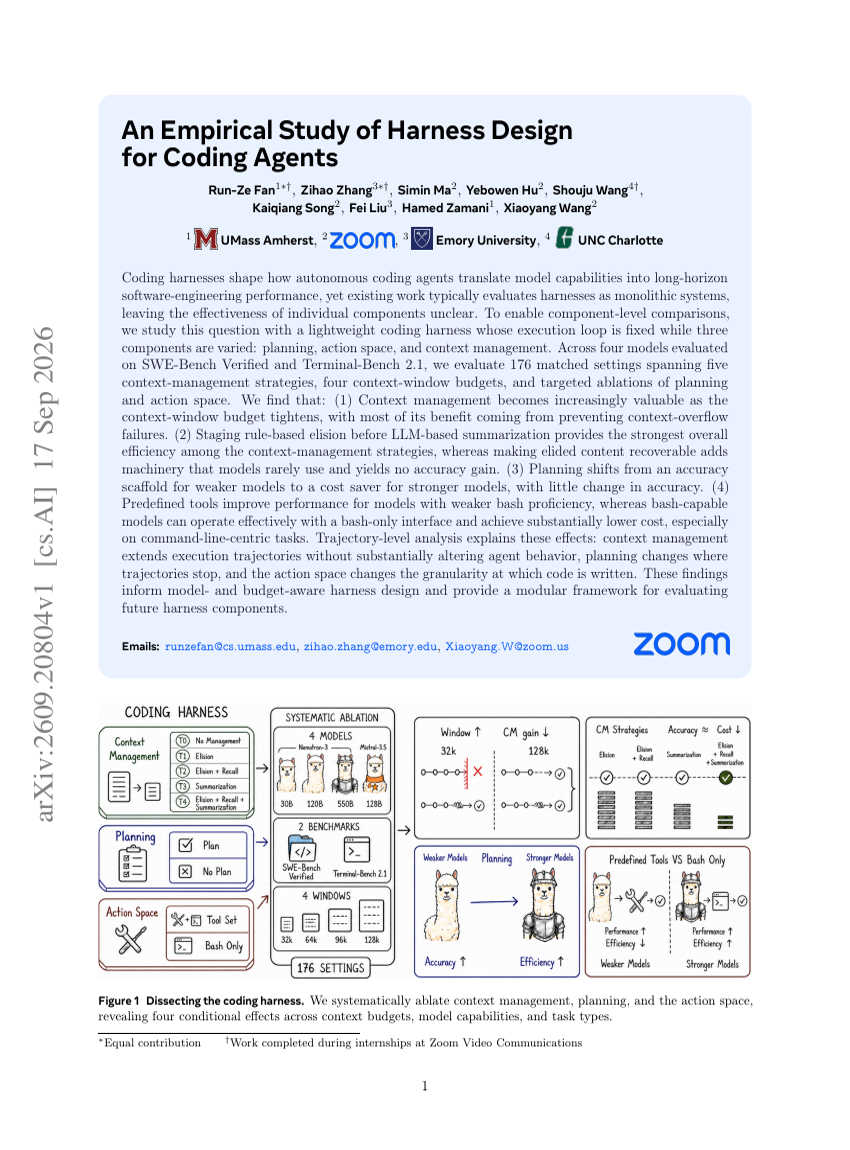
Eine empirische Studie zum Harness-Design für Coding-Agenten