HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
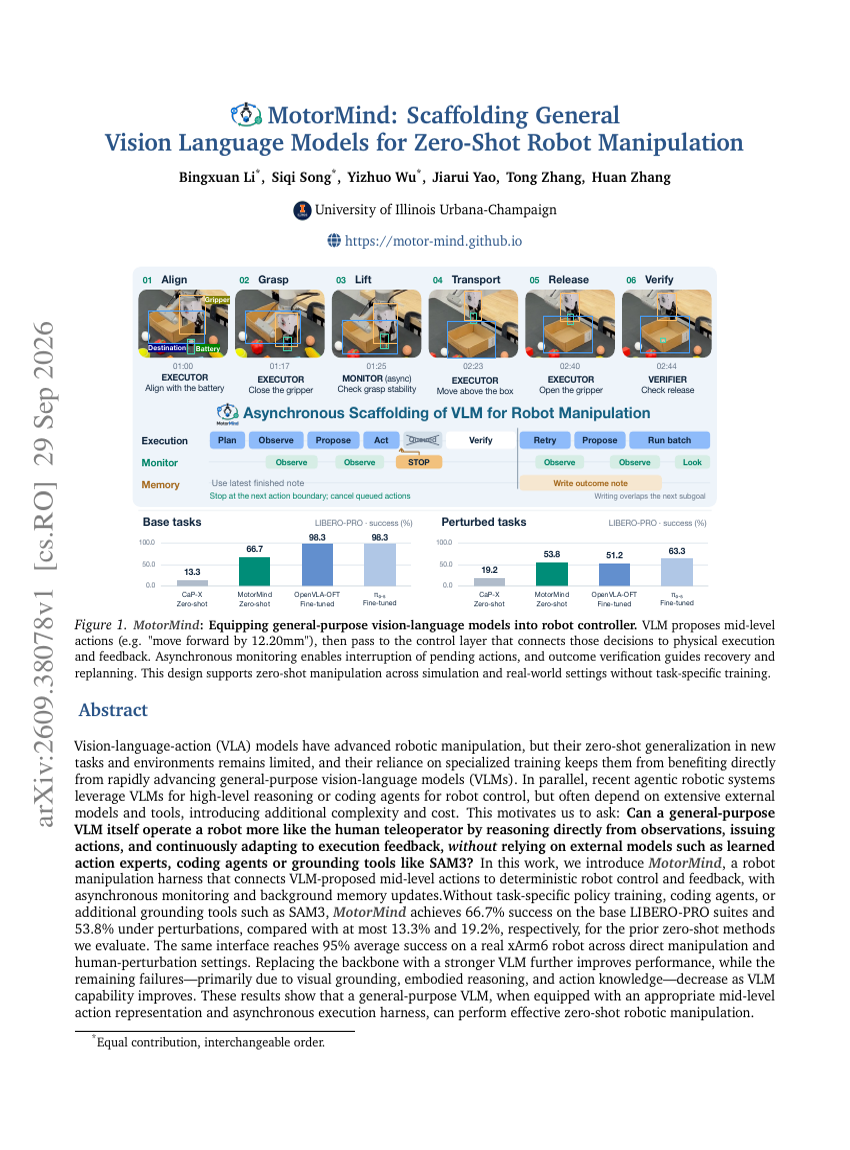
MotorMind: Ein Gerüst für allgemeine Vision-Language-Modelle zur Zero-Shot-Robotermanipulation
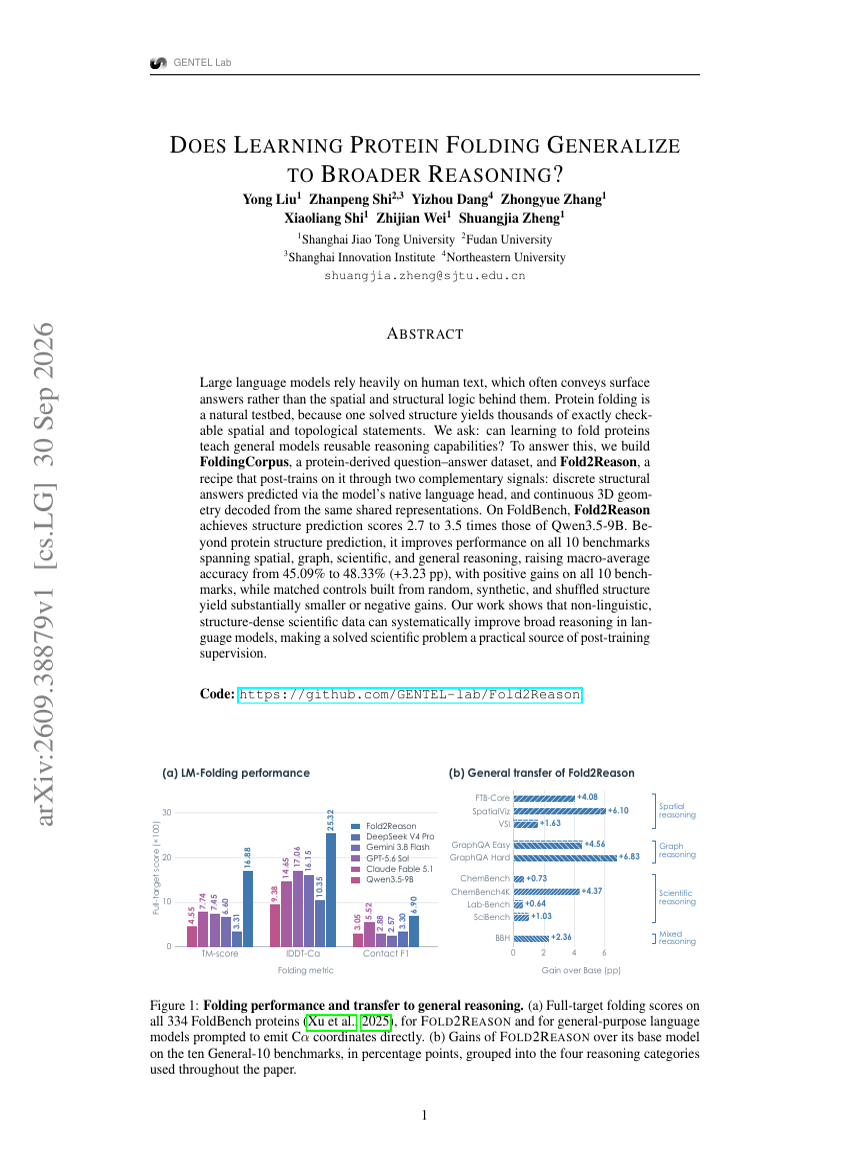
Generalisiert das Erlernen der Proteinfaltung auf breiteres logisches Denken?
Ein fehlendes Puzzleteil für vertrauenswürdige KI-Gutachter: Vom Benchmarking rhetorischer Robustheit zum SciCore-Review
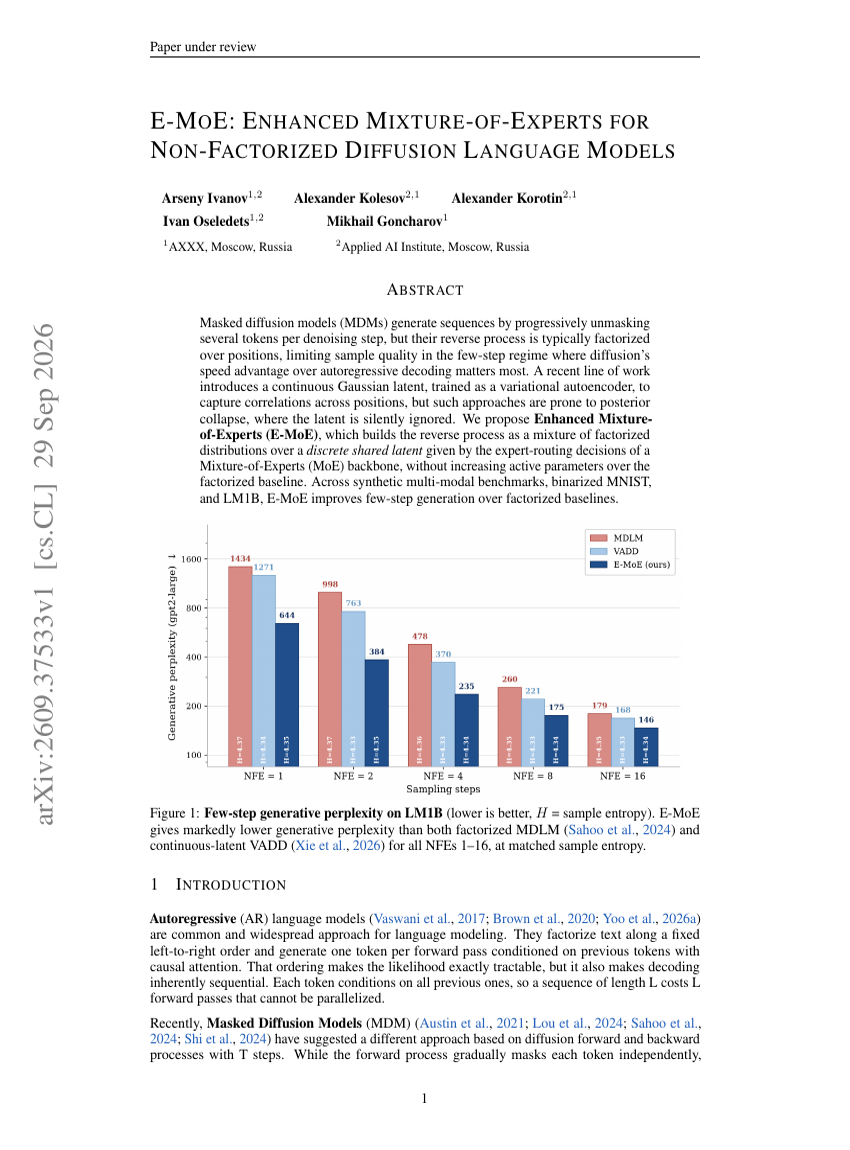
E-MOE: Enhanced Mixture-of-Experts für nicht-faktorisierte Diffusions-Sprachmodelle
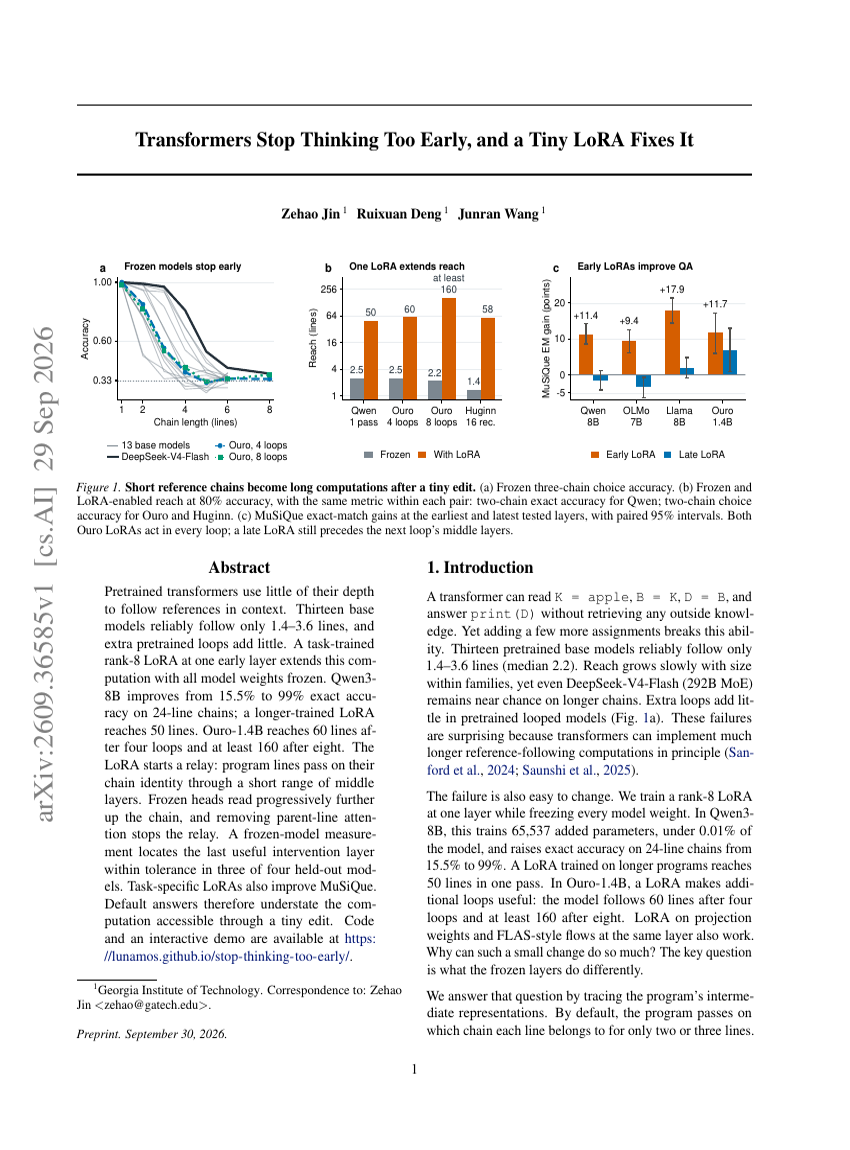
Transformer hören zu früh auf zu denken, und eine winzige LoRA behebt das
Adaptive Reward Routing: Dynamische Multi-Reward-Optimierung für gemeinsame Audio-Video-Diffusion mittels Forward-Process RL
OneStreamer: Vereinheitlichung von Wahrnehmung, Gedächtnis und proaktiver Reaktion in der Streaming-Video-Interaktion
On-Policyoder Off-Policy-Lernen? Eine systematische Studie zur Destillationsdynamik
EVODUET: Bilevel-Koevolution von Websuche und Aufgabenlösung für wissenschaftliche Entdeckung
Mid-Harness: Skalierung von Aktionen zwischen Modell und Harness für Terminal-Agenten
AREX-2: Fortschritte bei selbstverbessernden Agenten durch langhorizontige Reflexionsaufgaben
Falsche Grenzen: Diagnose und Eindämmung von Co-Cheating bei selbst-evolvierenden Suchagenten
UNIEVO-VL: Ein On-Policy-Selbstdestillations-Trainingsrezept zur Selbstverbesserung multimodaler Modelle
Der Lehrer ist eine Richtung, kein Ziel: Extrapolation RL-induzierter Repräsentationsresiduen in der On-Policy-Destillation
Was macht World Action Models generalisierungsfähig? Eine empirische Studie zur Zukunftsmodellierung zur Testzeit
MaLiang-Harness: Ein programmierbarer Weg zur Bildund Videogenerierung
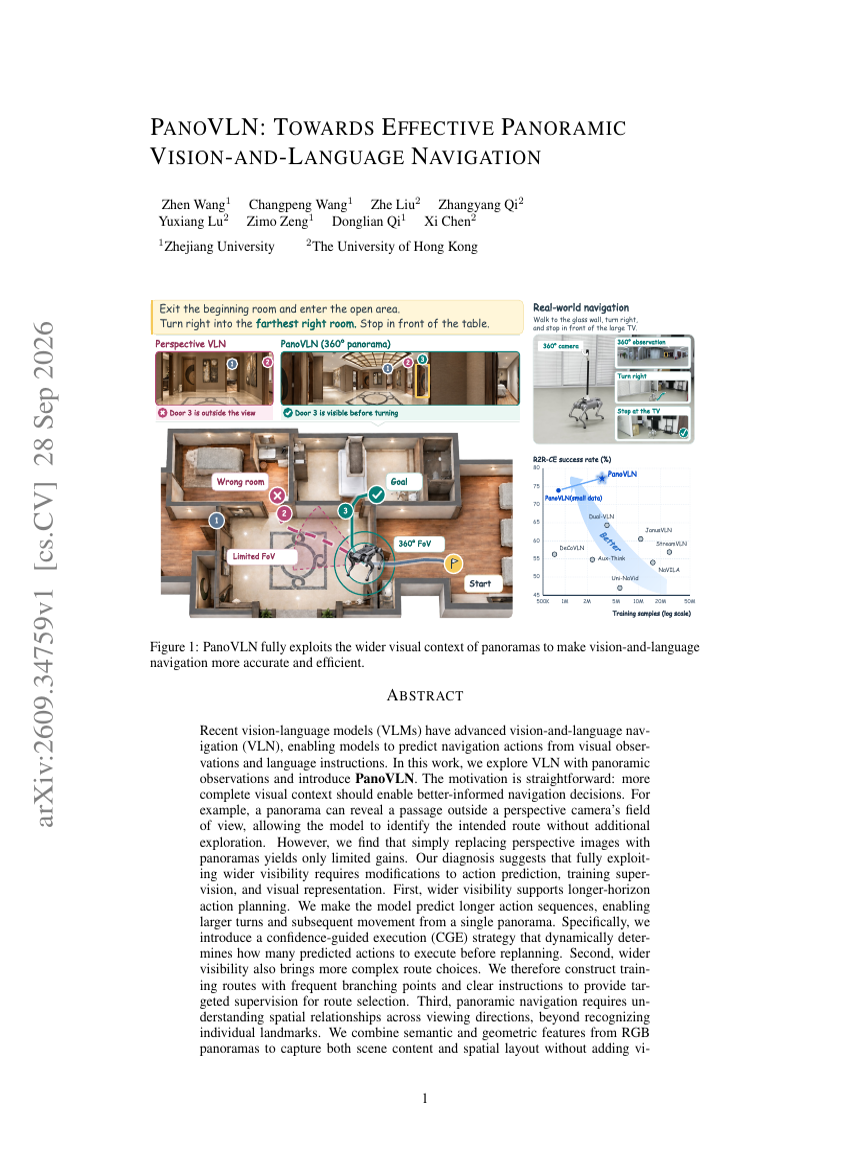
PanoVLN: Auf dem Weg zu effektiver panoramischer Vision-und-Sprache-Navigation
VoxMem: Benchmarking des multimodalen Gedächtnisses in großen Audio-Sprachmodellen
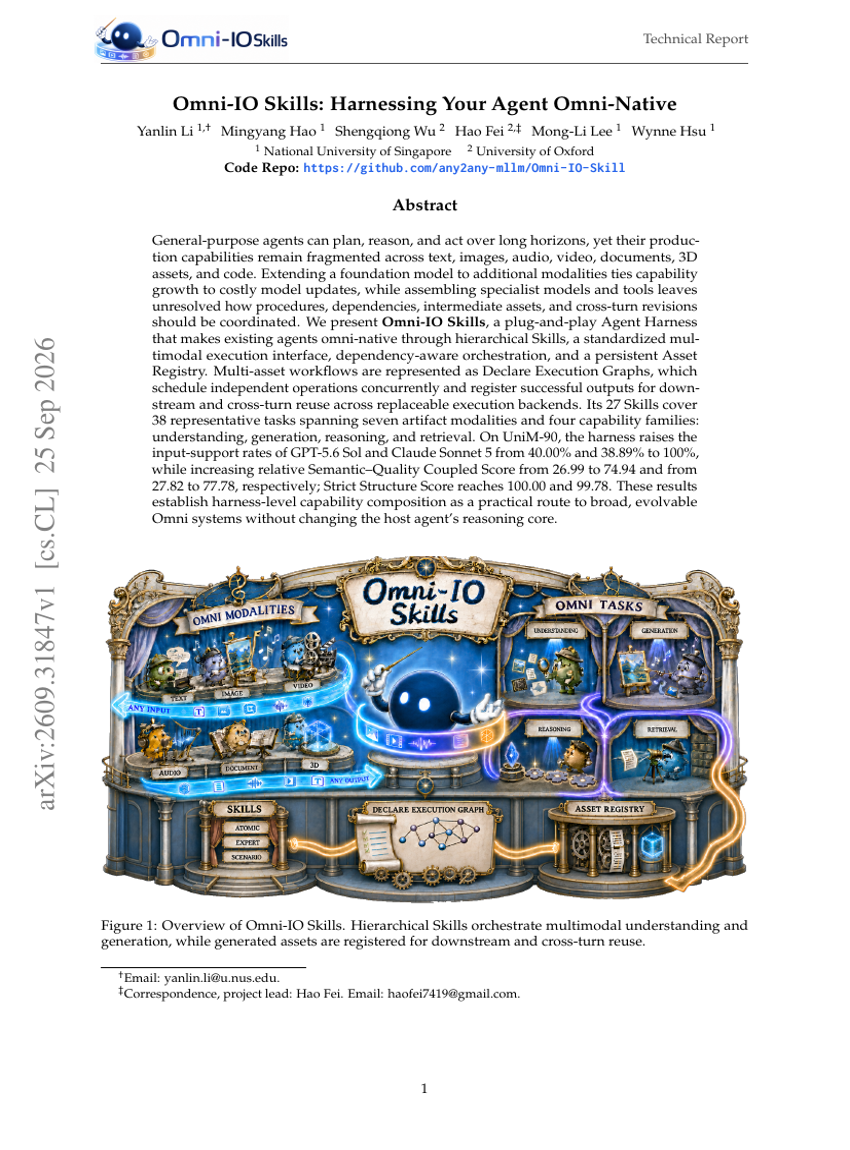
Omni-IO Skills: Ihren Agenten omni-nativ machen
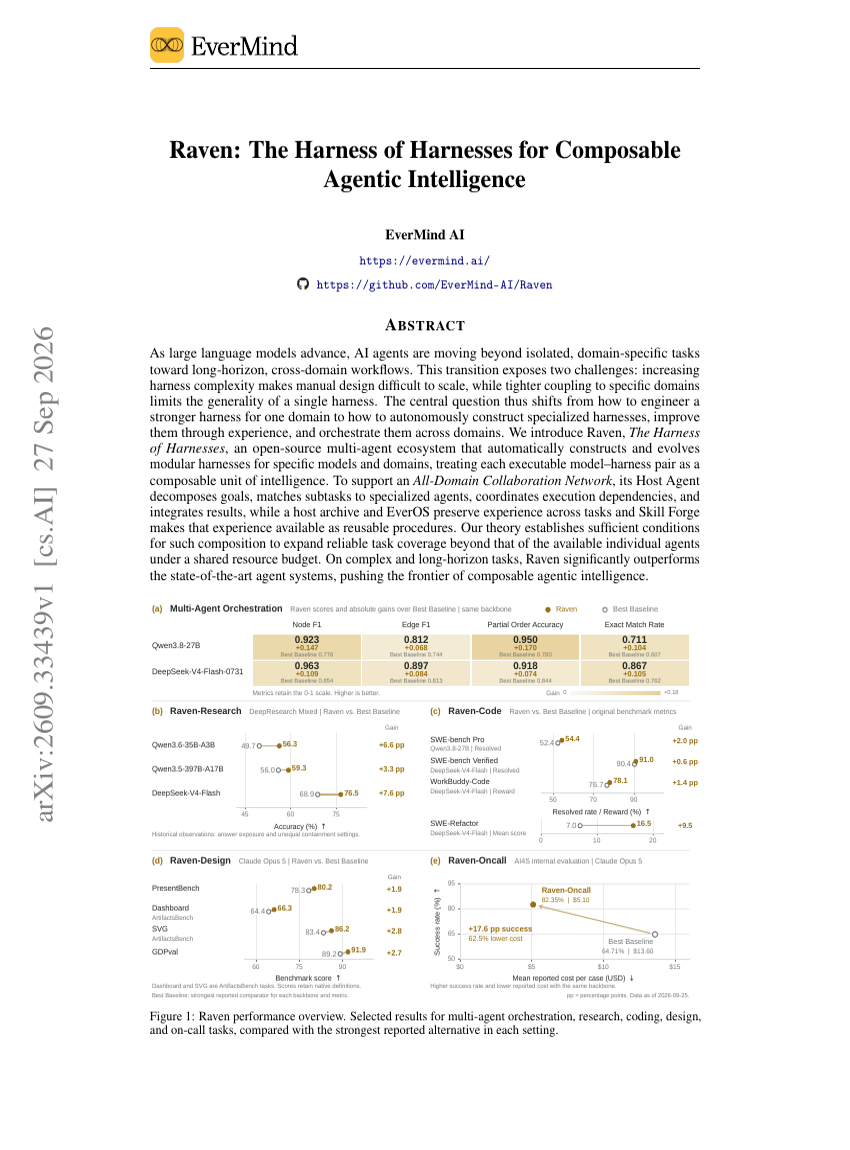
Raven: Das Harness der Harnesse für komponierbare agentische Intelligenz
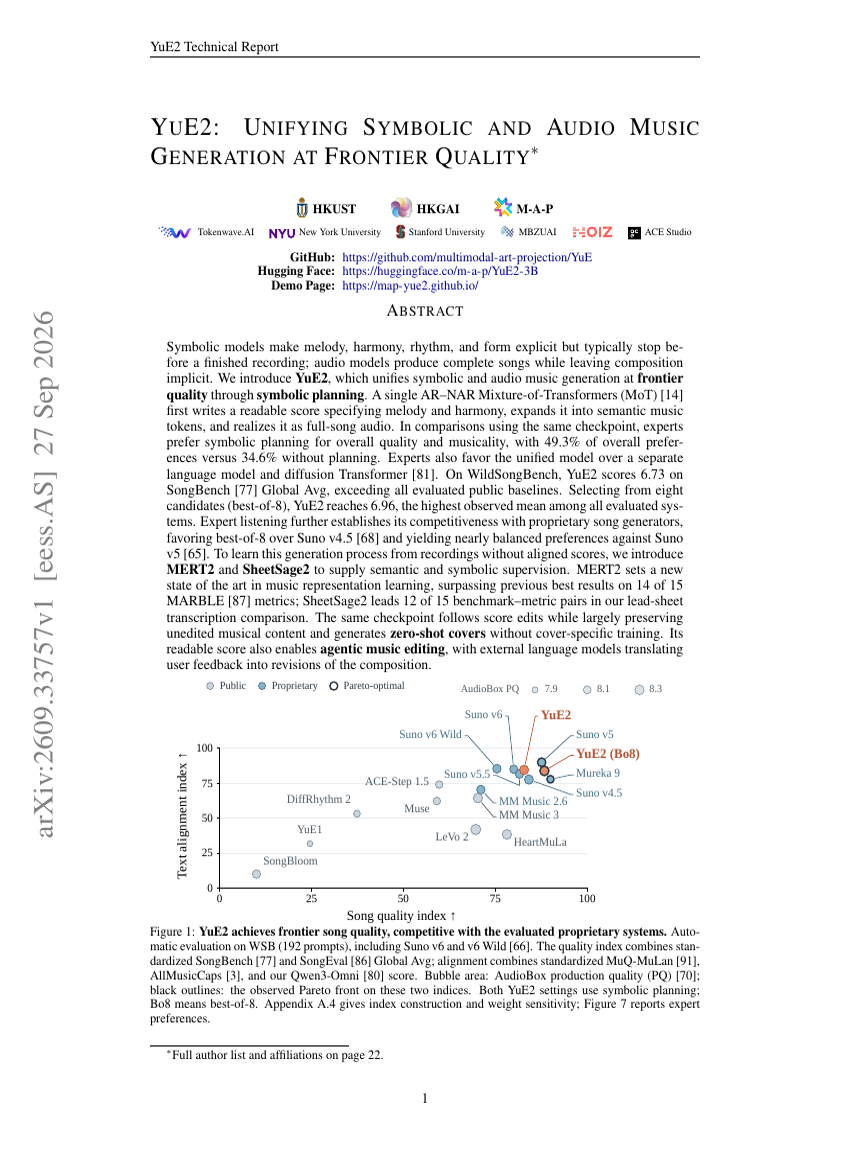
YUE2: Vereinheitlichung von symbolischer und Audio-Musikgenerierung in Frontier-Qualität
Gruppenweises agentisches Bewerten und Advantage-Umverteilung für das Reinforcement Learning von Code-Agenten
Wie weit sind wir davon entfernt, den visuellen Encoder zu entfernen? Skalierungsgesetze für encoder-freies multimodales Vortraining
Duplex-MPE: Benchmarking von Mehrparteien-Interaktion im Vollduplex-Dialog
Post-Training hinterlässt Verhaltensschatten auf unzusammenhängenden Entscheidungen
Über die Lehrerzuweisung hinaus: Domänen-normalisierte Multi-Teacher-On-Policy-Destillation
Verbesserung photogrammetrischer digitaler Oberflächenmodelle durch vortrainierte Diffusionsmodelle und multimodale Konditionierung
Tactile-JEPA: Topologiebewusstes selbstüberwachtes Repräsentationslernen für verteilte taktile Sensoren
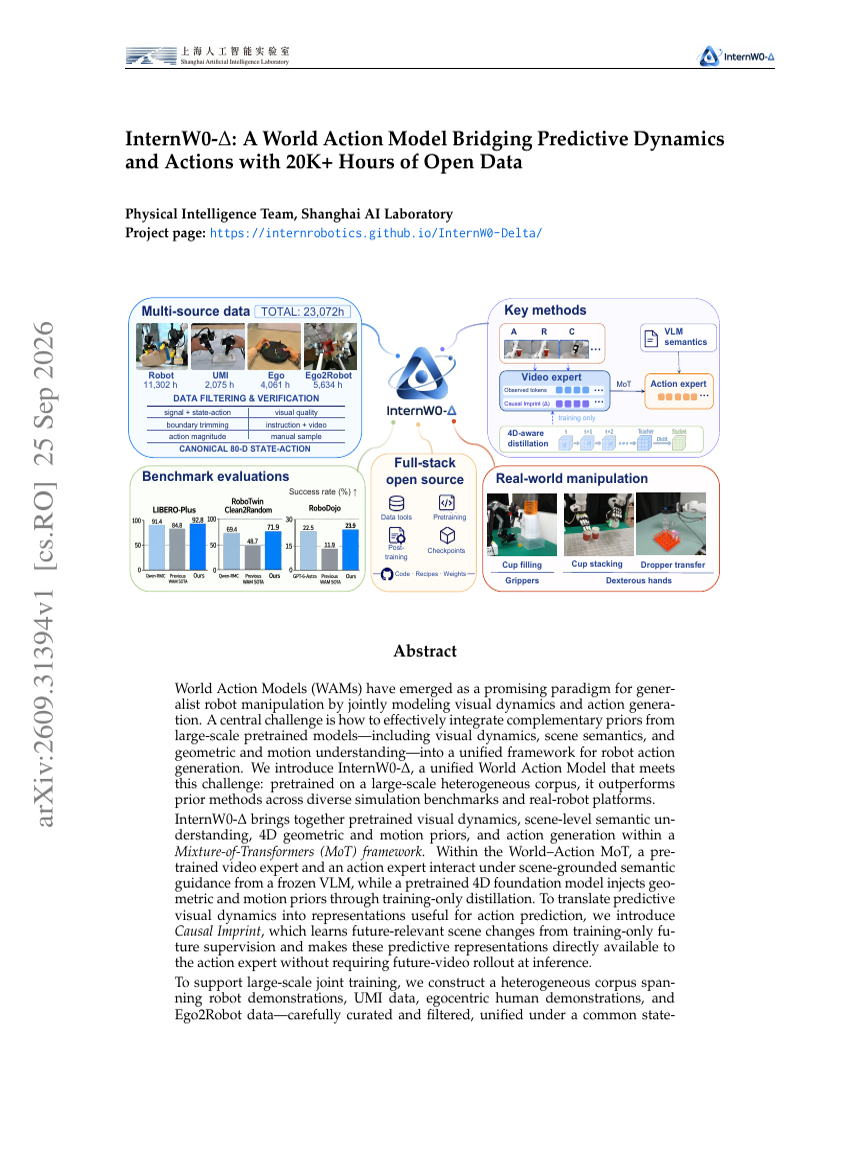
InternW0-∆: Ein World-Action-Modell, das prädiktive Dynamik und Aktionen mit über 20.000 Stunden offenen Daten verbindet
Block-Sparse-Attention mit log-linearer Komplexität
RayOrch: Programmierung und Ausführung lineage-kontrollierter Multi-Granularitäts-Datenflüsse für die Datenaufbereitung von Foundation-Modellen
FuseReg: Regularisierung der Layer-Fusion mildert die Rekonstruktions-Generierungs-Lücke in Repräsentations-Autoencodern