HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
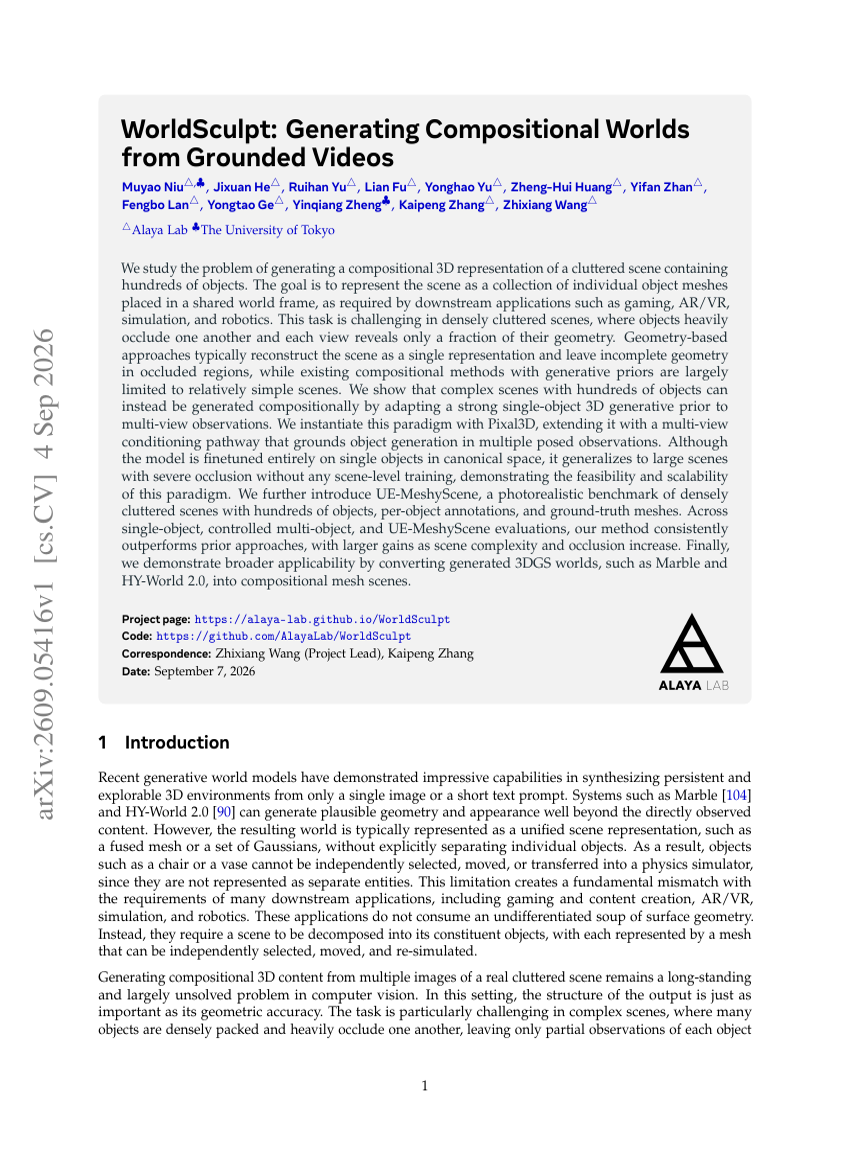
WorldSculpt: Erzeugung kompositionaler Welten aus verankerten Videos
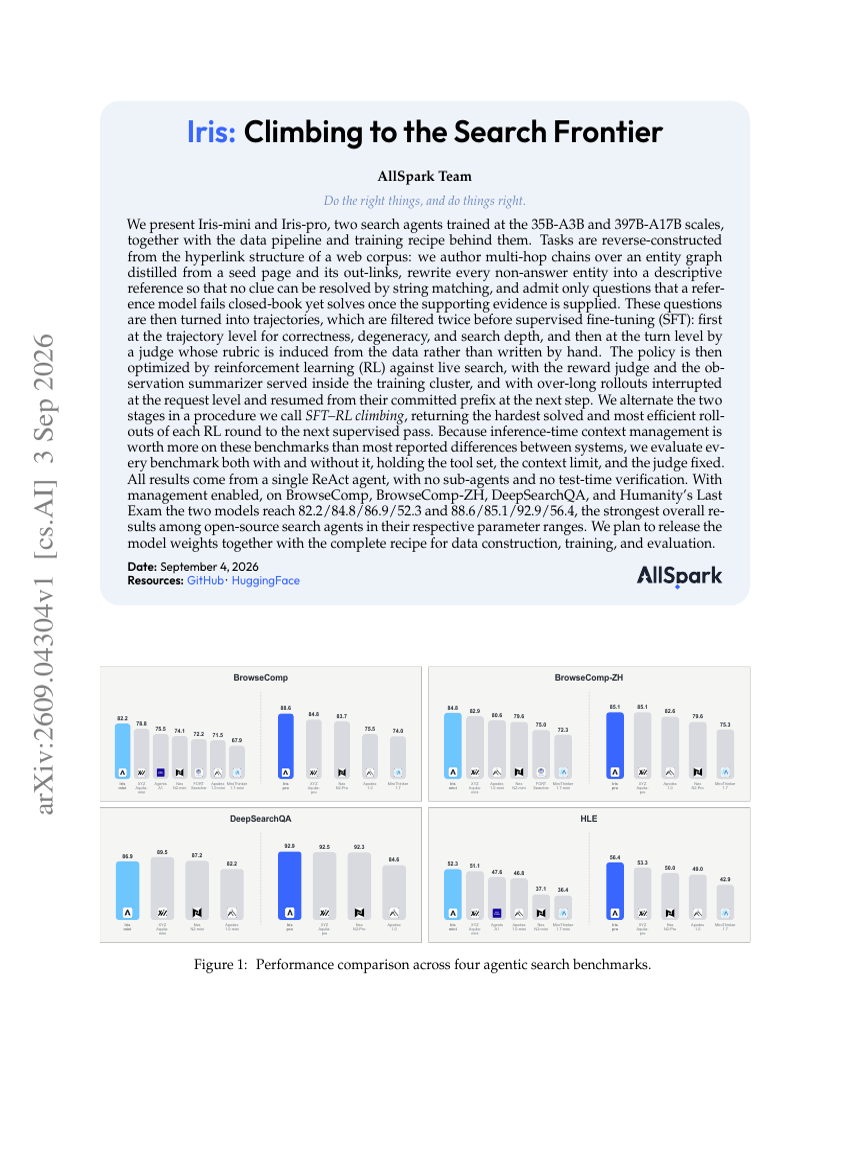
Iris: Aufstieg zur Suchgrenze
MOTION-OMNI: END-TO-END GEMEINSAME SPRACHUND GANZKÖRPERBEWEGUNG FÜR GESPROCHENE DIALOGE
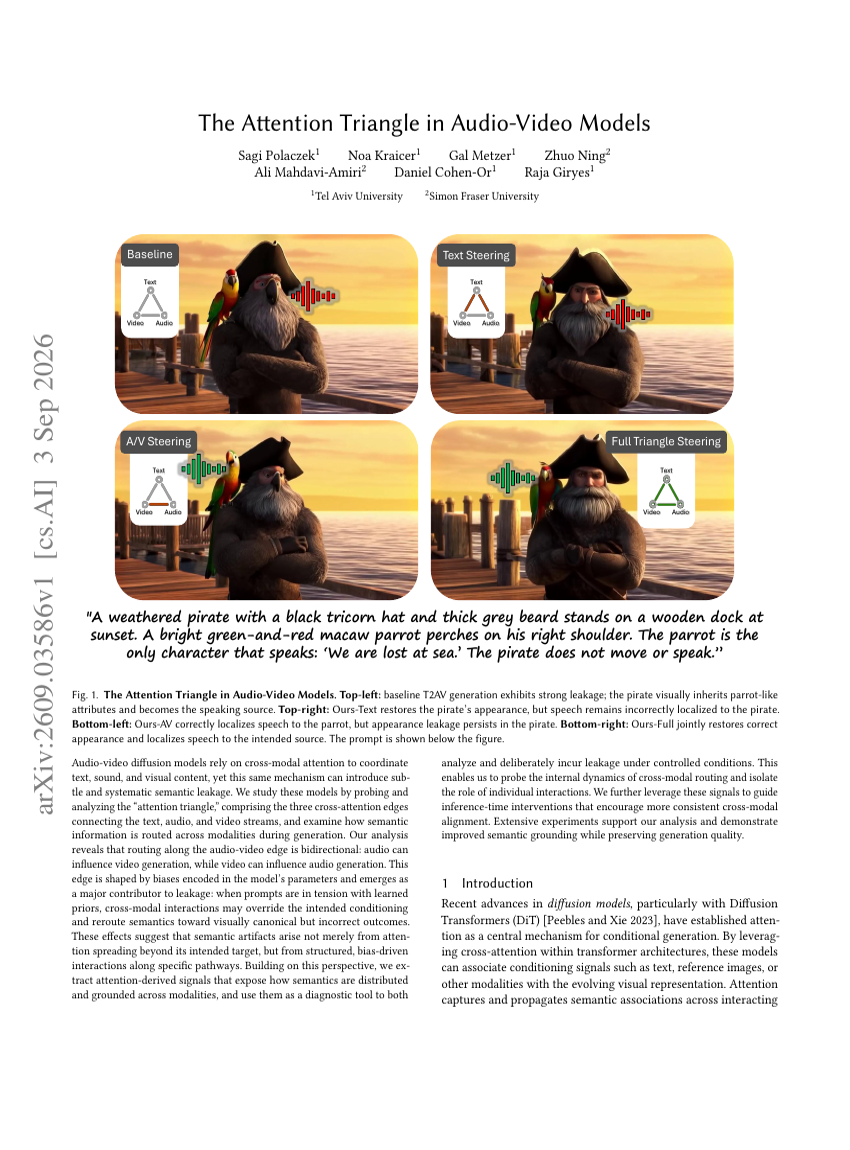
Das Aufmerksamkeitsdreieck in Audio-Video-Modellen
Bilevel koordinierte Reflexion: Ein spieltheoretischer Ansatz für Multi-Agenten-LLM-Systeme
Dr. Claw: Eine KI-Wissenschaftler-Arbeitsumgebung für Vibe-Forschung
WorldReward: Belohnungsmodellierung für kamerabedingte Weltmodelle
VIBEVOICE-ASR-STREAMING Technischer Bericht
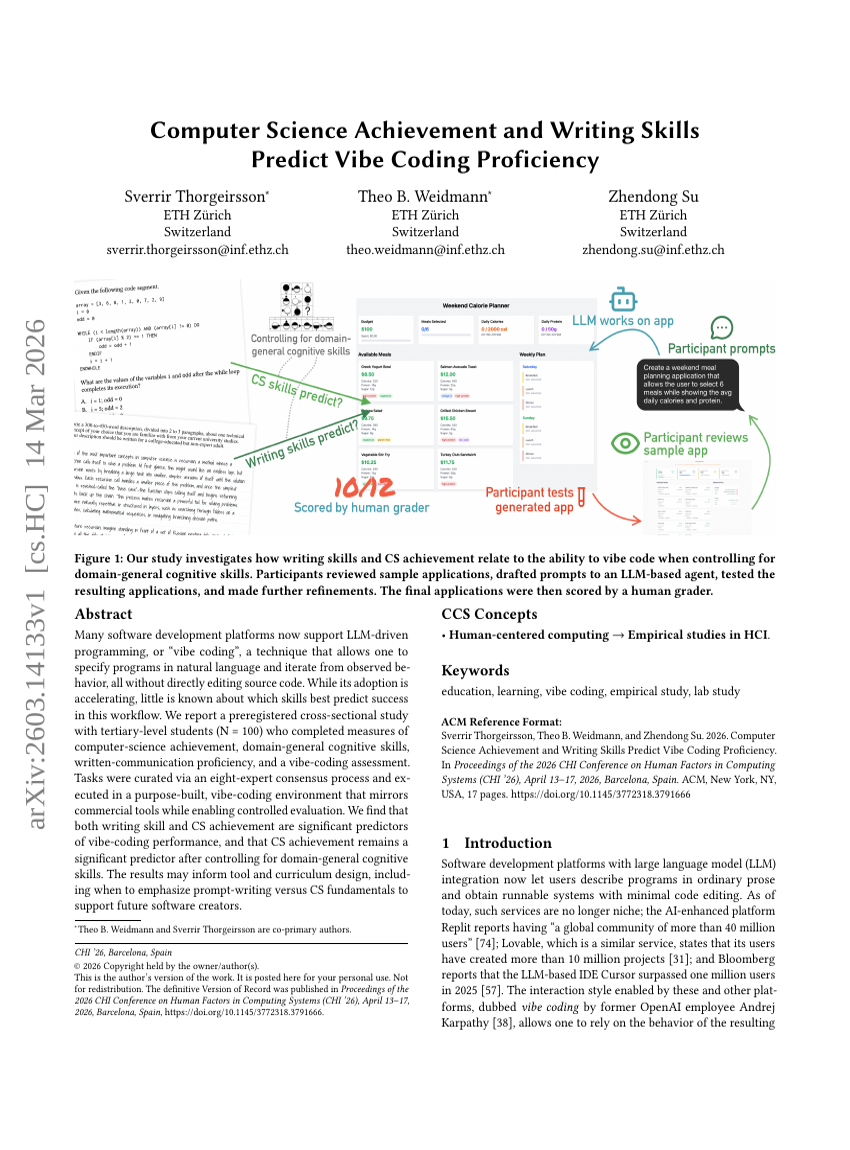
Informatikleistung und Schreibfähigkeiten sagen die Kompetenz im Vibe Coding voraus
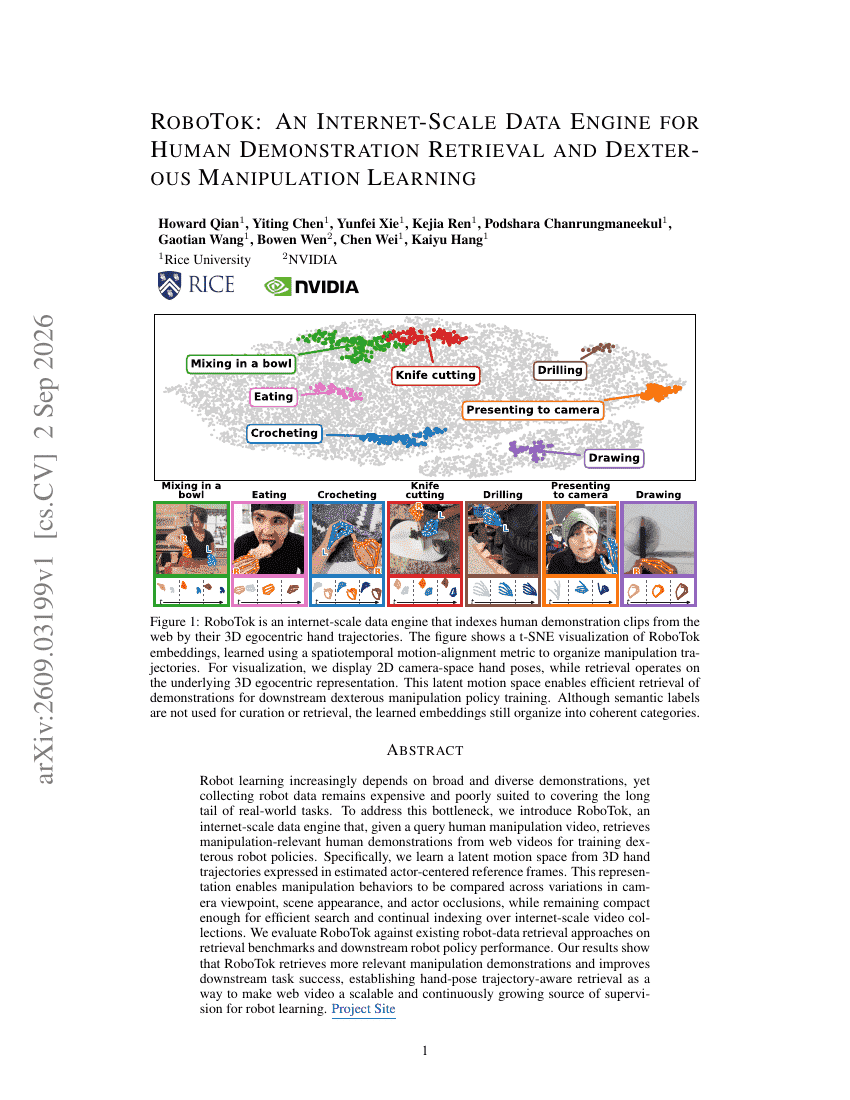
RoboTok: Eine internetweite Datenmaschine zur Beschaffung menschlicher Demonstrationen und zum Erlernen geschickter Manipulation
Wissen, wann man nicht wiederverwenden sollte: Bedingter Erfahrungstransfer im autonomen Post-Training von LLMs
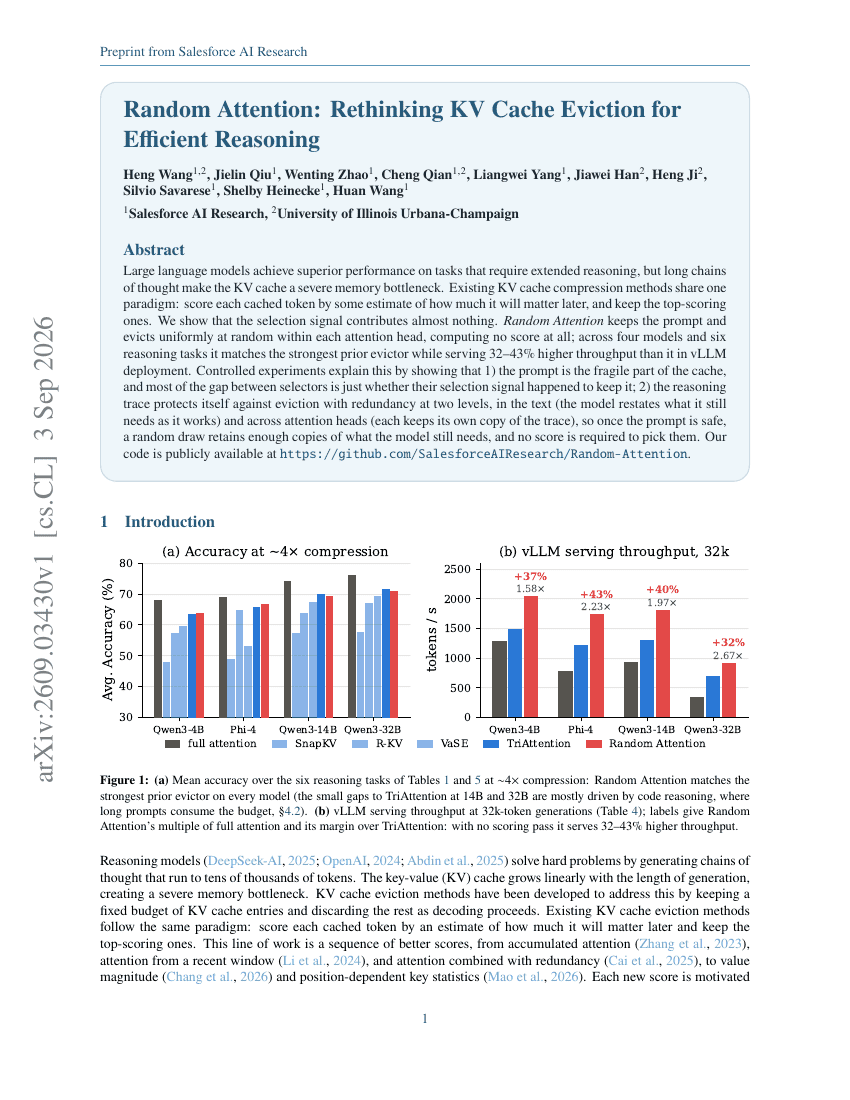
Random Attention: KV-Cache-Eviction für effizientes Reasoning neu gedacht
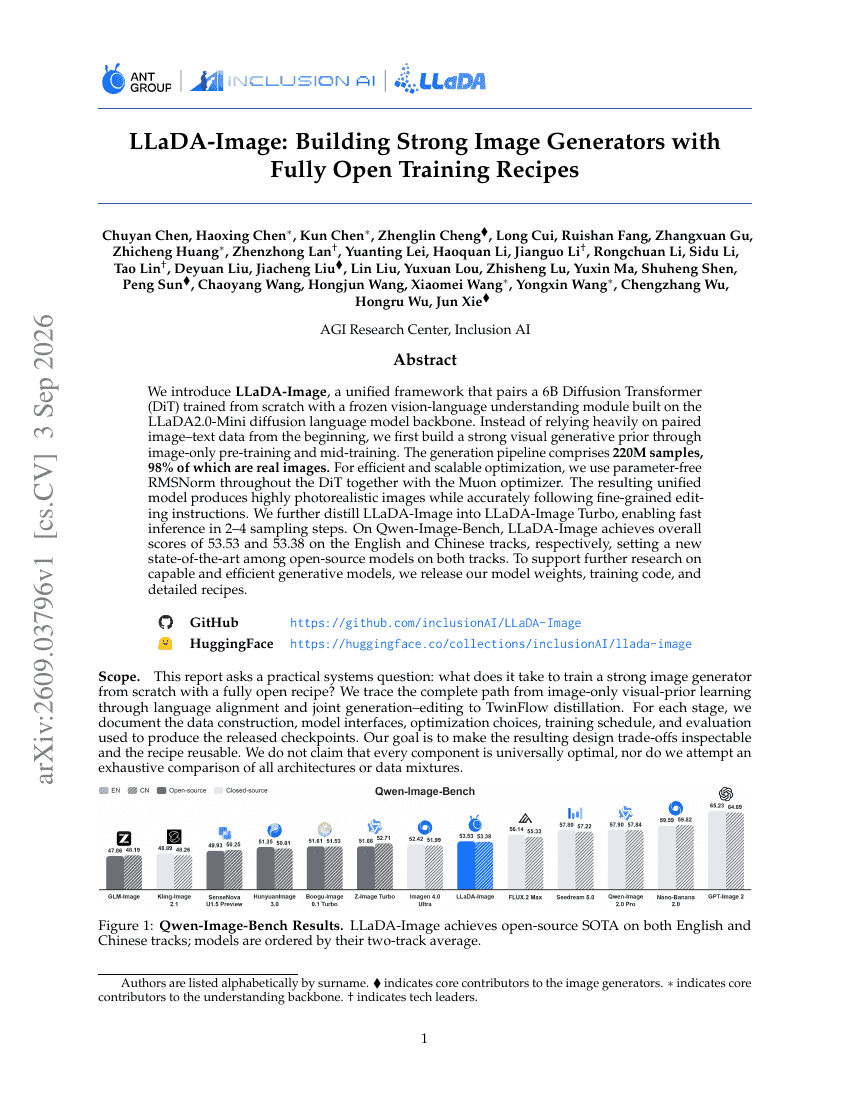
LLaDA-Image: Leistungsstarke Bildgeneratoren mit vollständig offenen Trainingsrezepten
Terminal-Universe: Umwandlung von Agenten-Trajektorien in skalierbare Terminal-Umgebungen
Kompilieren durch Training: Wie man natürlichsprachliche Spezifikationen in lokale neuronale Funktionen umwandelt
HarnessDev: Können LLMs ihre eigene Agenten-Infrastruktur erstellen und weiterentwickeln?
Sprachmodelle können ihre eigene Aufmerksamkeit steuern
Zum Abgleichen braucht es zwei: Ko-evolutionärer generativer Retriever mit bestärkendem Lernen
EarlyEval: Kostengünstigere Agentenevaluierung durch frühzeitige Ergebnisvorhersage
SolarWM: Offene Daten und skalierbares Training für Video-Weltmodelle mit langem Zeithorizont
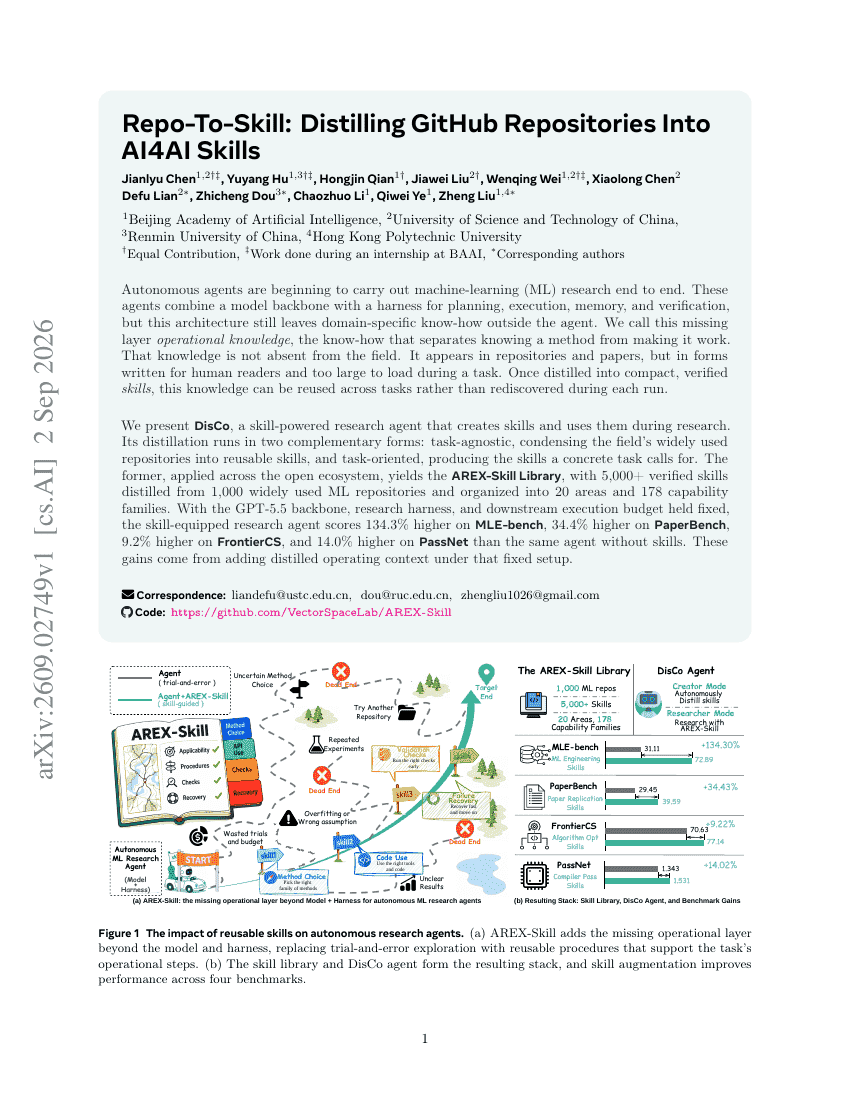
Repo-To-Skill: GitHub-Repositorien in KI-für-KI-Fertigkeiten destillieren
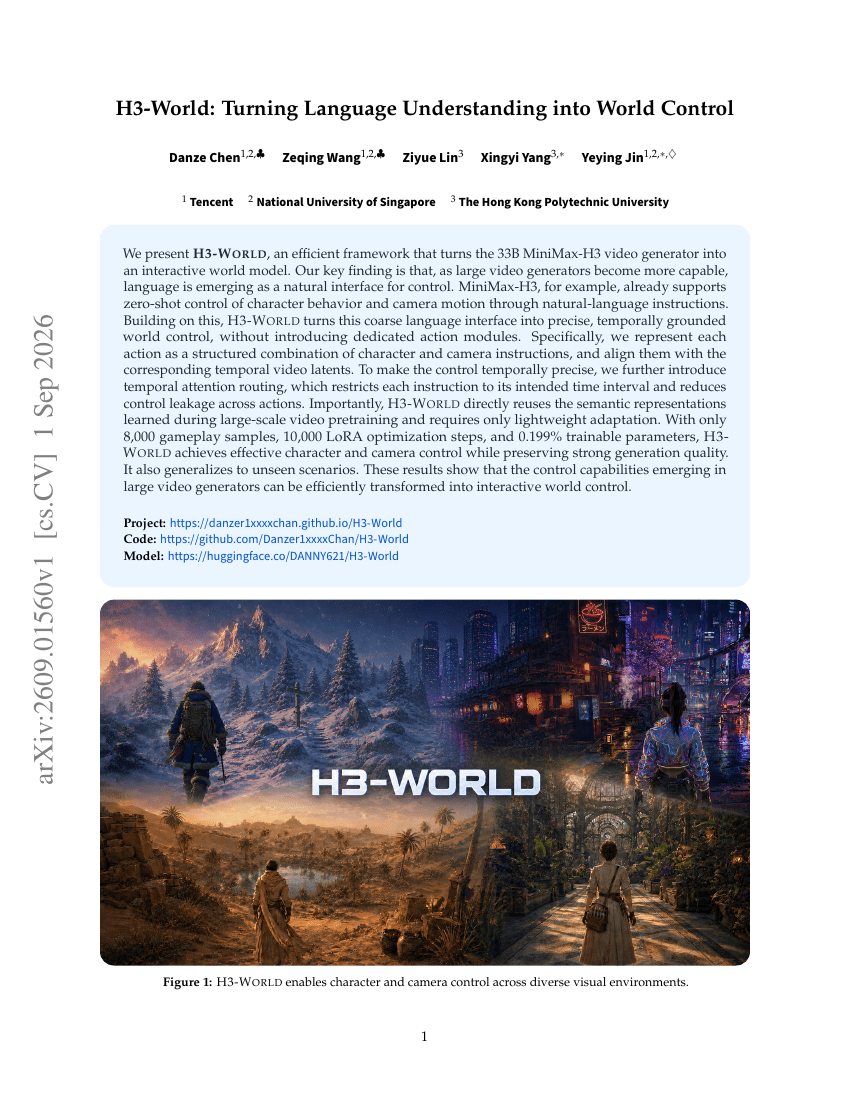
H3-World: Sprachverständnis in Weltsteuerung überführen
ZimaBlue: Entwicklung generalisierbarer Welt-Aktions-Modelle durch skalierbares Video-Vortraining
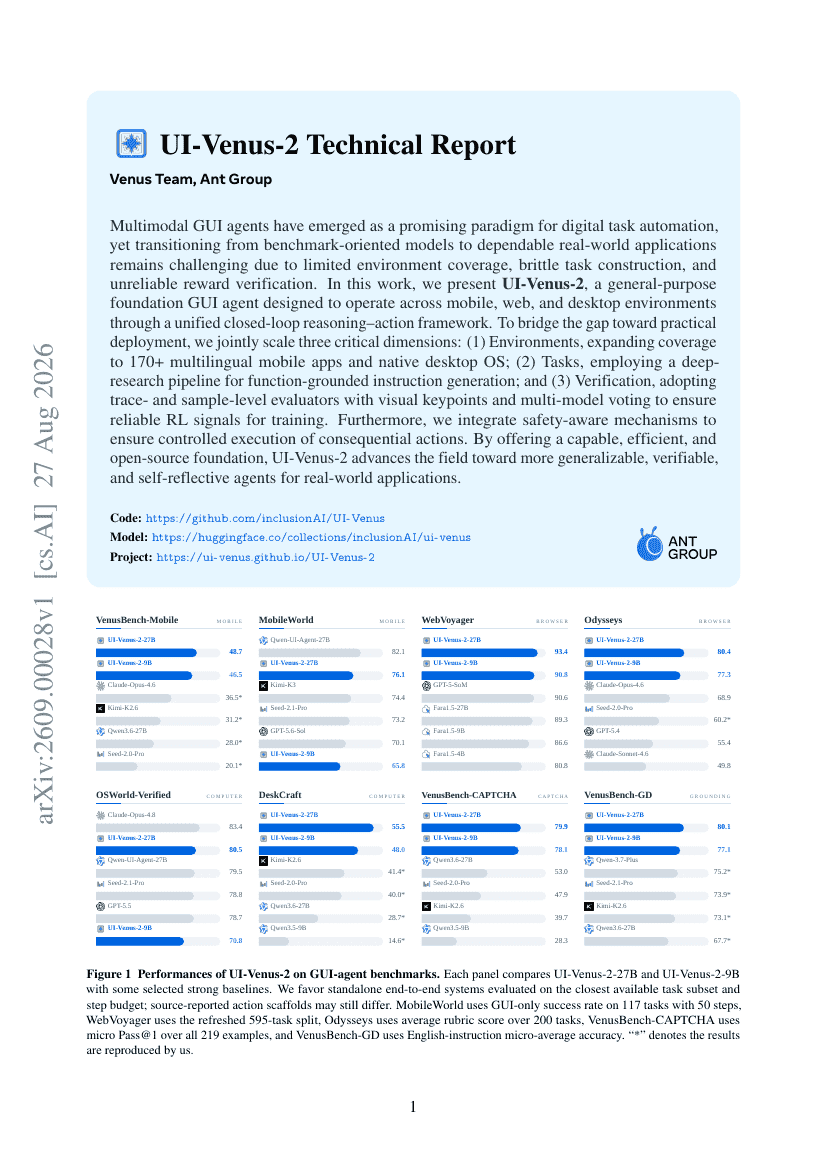
UI-Venus-2: Ein großes Sprachmodell für GUI-Agenten
SMELT: Skalierungsgesetze für rechenbudgetangepasste MoE-Looped-Transformer
Qwen-Drive-1.0: Ein erster Schritt zu einem Vision-Language-Foundation-Modell für das autonome Fahren
StudentSim: Training LLM-basierter Studentensimulatoren
SenseNova-U1: Vereinheitlichung von multimodalem Verstehen und Generieren mit der NEO-unify-Architektur
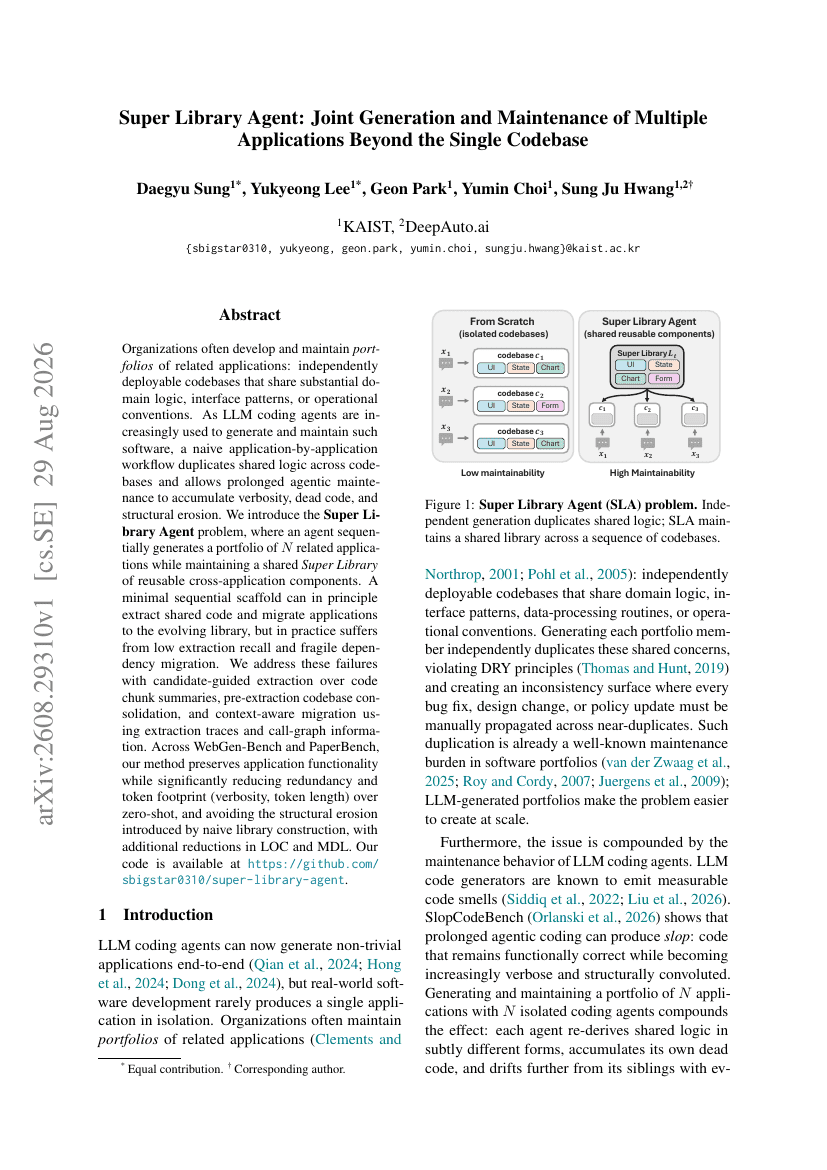
Super Library Agent: Gemeinsame Generierung und Pflege mehrerer Anwendungen jenseits einer einzelnen Codebasis
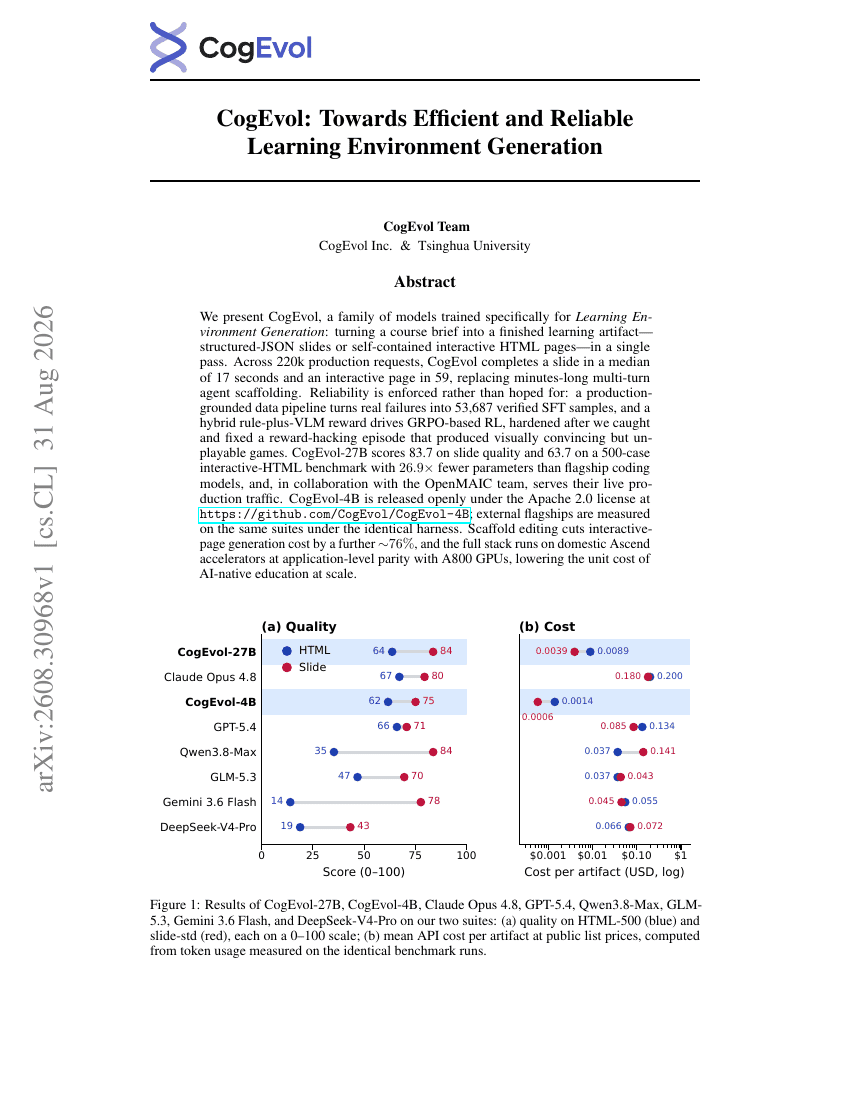
CogEvol: Auf dem Weg zu effizienter und zuverlässiger Generierung von Lernumgebungen
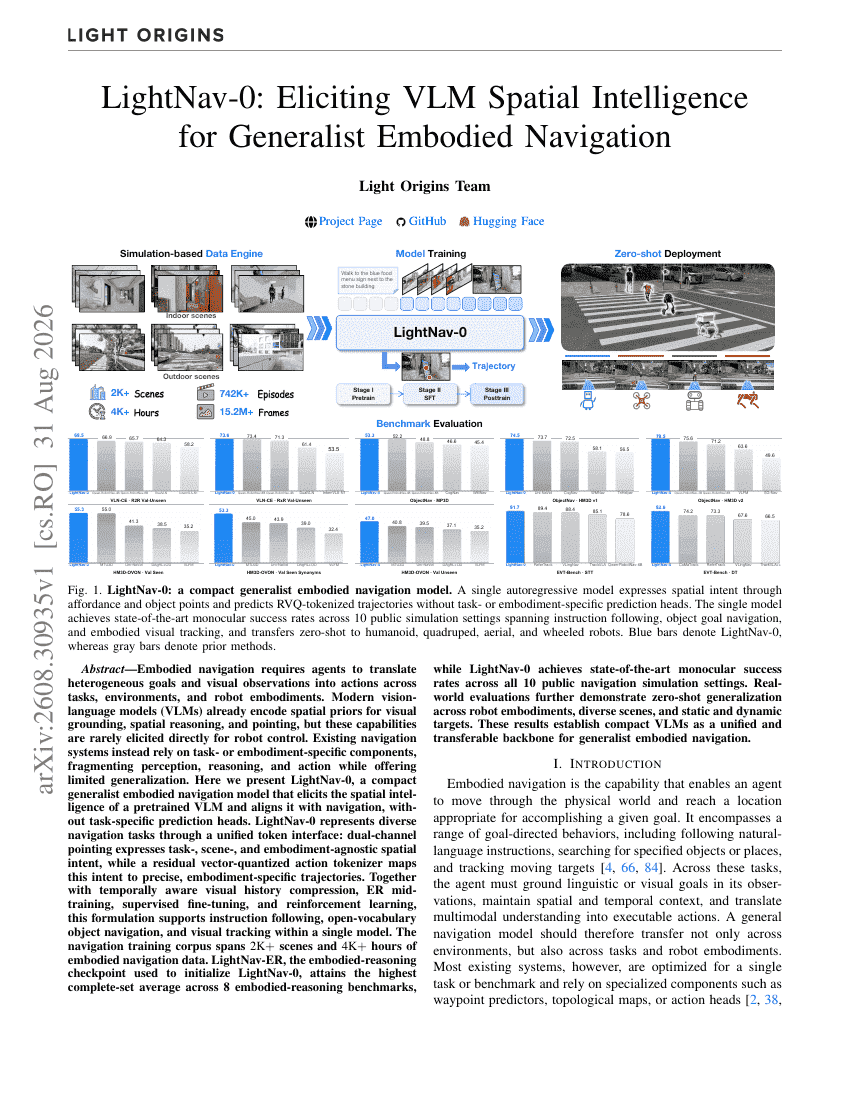
LightNav-0: Raumintelligenz von Vision-Language-Modellen für generalistische verkörperte Navigation nutzbar machen
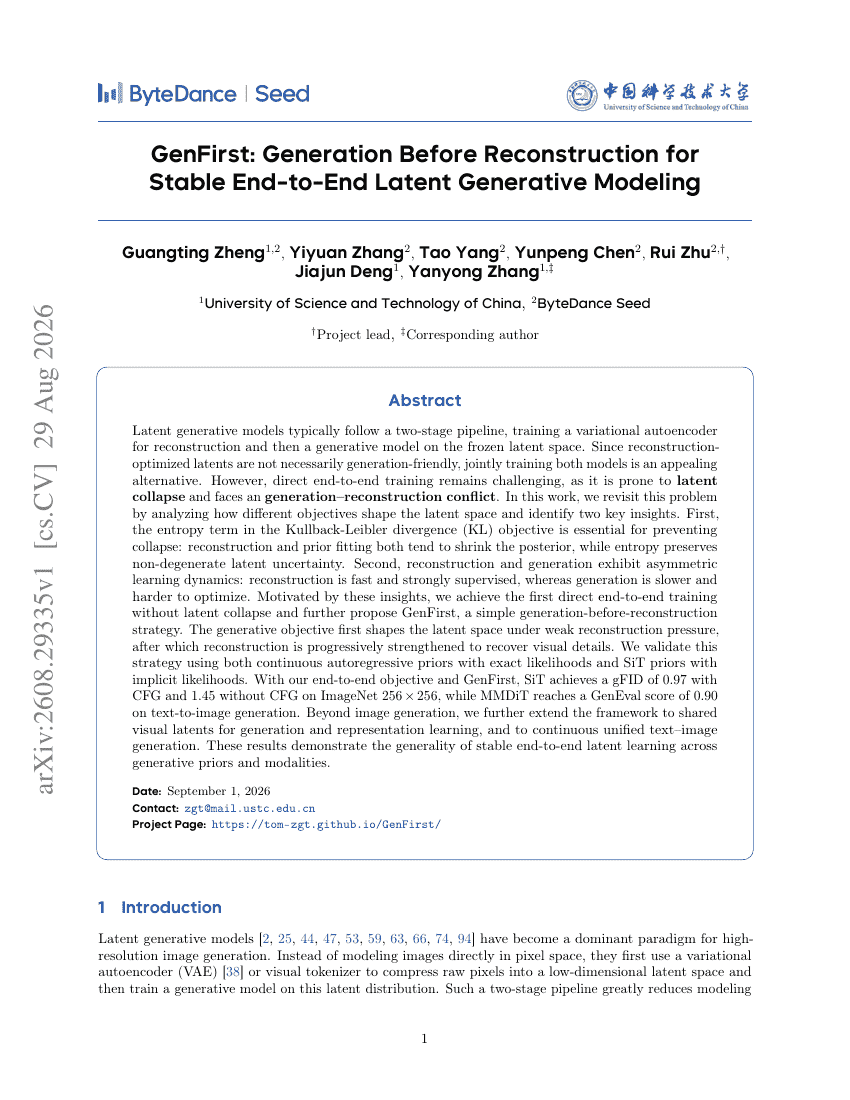
GenFirst: Generation vor Rekonstruktion für stabiles End-to-End latentes generatives Modellieren