HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
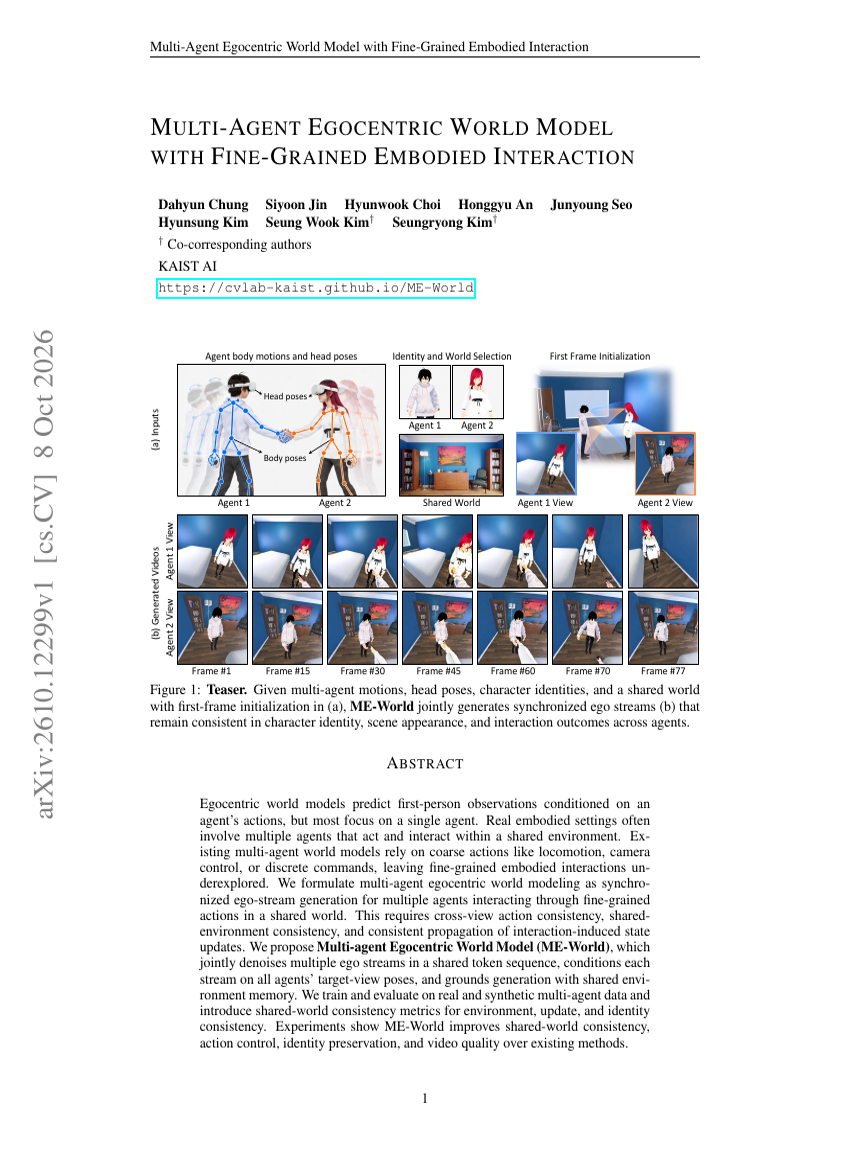
Multi-Agenten-egozentrisches Weltmodell mit feinkörniger verkörperter Interaktion
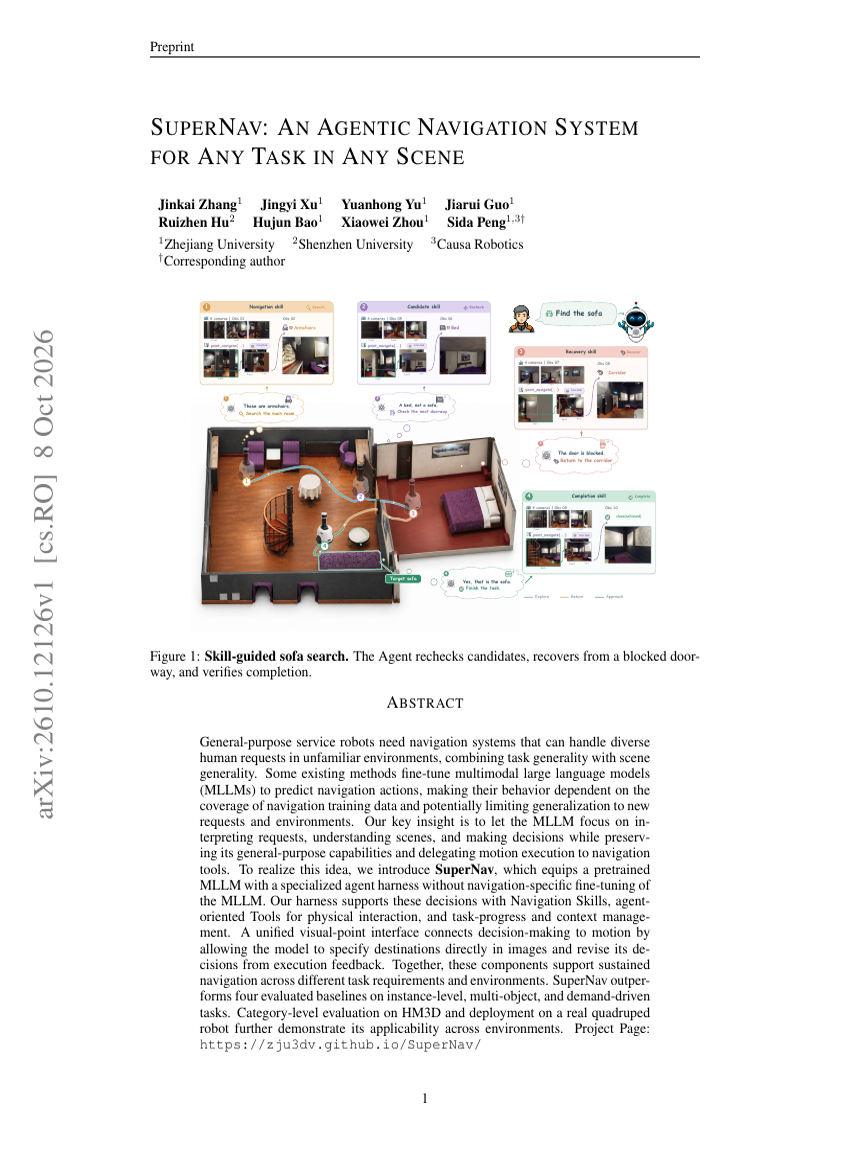
SuperNav: Ein agentisches Navigationssystem für beliebige Aufgaben in beliebigen Szenen
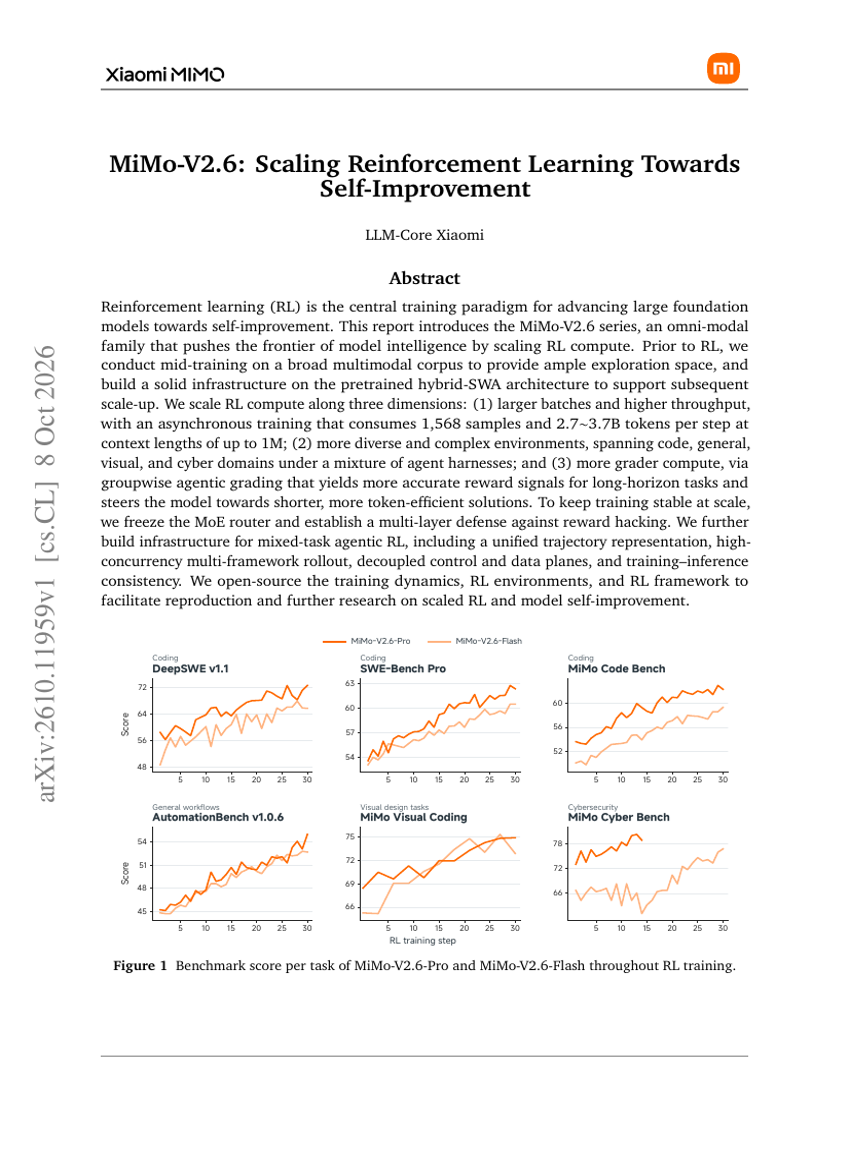
MiMo-V2.6: Skalierung von Reinforcement Learning in Richtung Selbstverbesserung
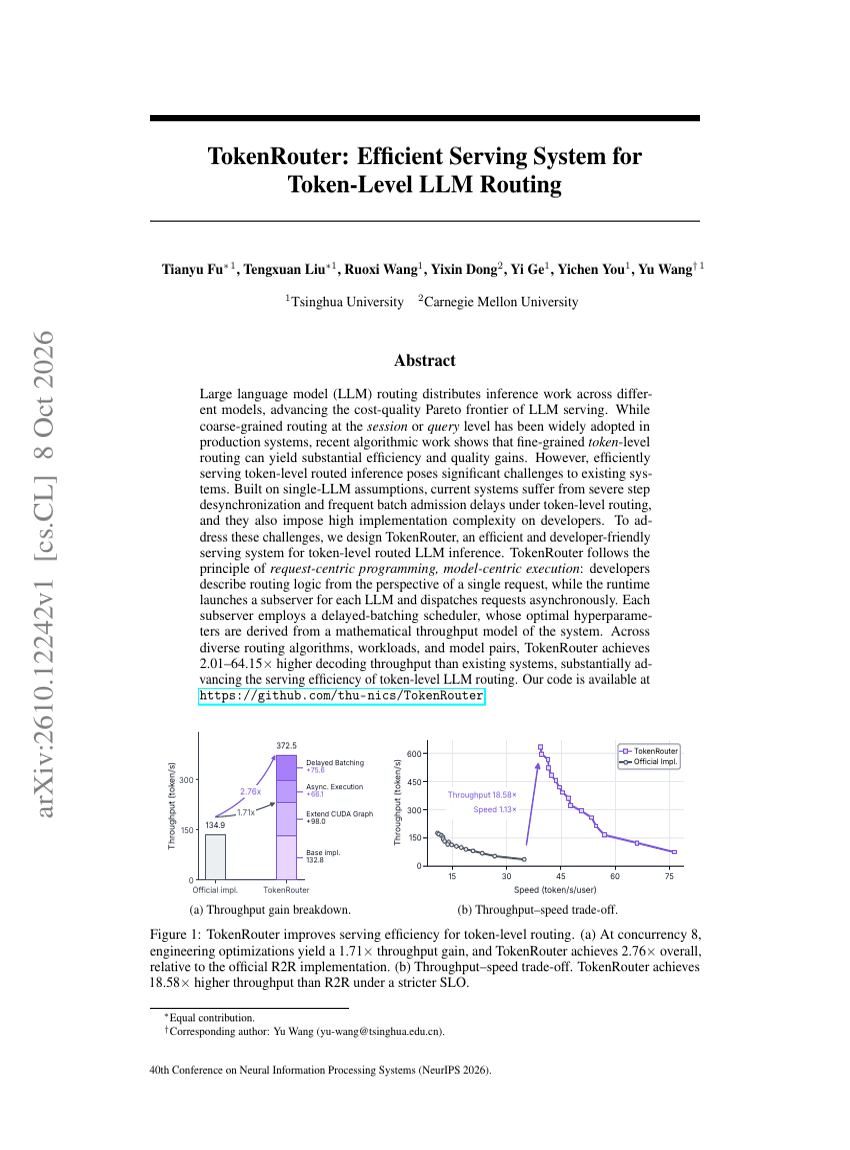
TokenRouter: Effizientes Serving-System für Token-Level-LLM-Routing
AgentGarten: Code-Welten für sich weiterentwickelnde Agenten
Von Traces zu agentischen Welten: Agentische Sprachweltmodelle für die interaktive Umgebungssimulation
H-JEPA: END-TO-END-LERNEN HIERARCHISCHER WELTMODELLE FÜR VISUELLE PLANUNG
ID-Balancing: Stabiles Training extrem spärlicher MoE-Modelle durch PID-basierte Lastkontrolle
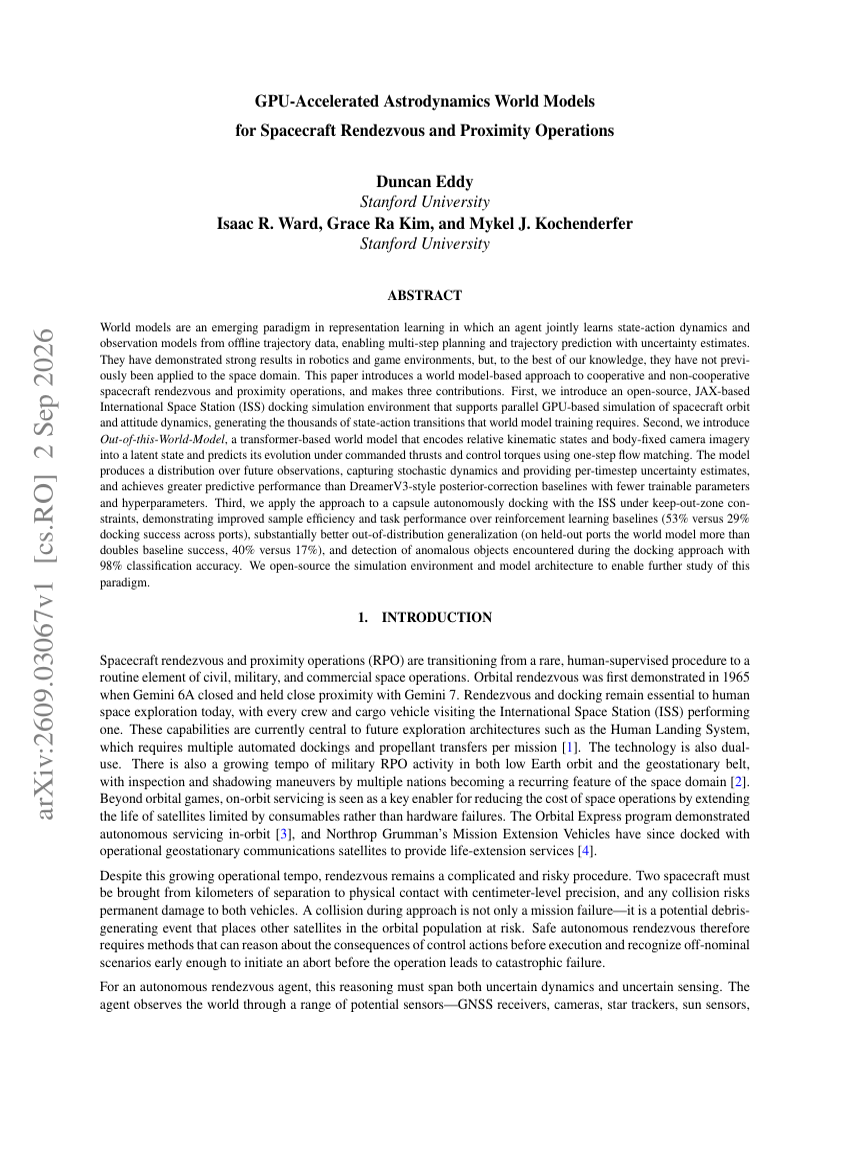
GPU-beschleunigte Weltmodelle der Astrodynamik für Raumfahrzeug-Rendezvousund Annäherungsmanöver
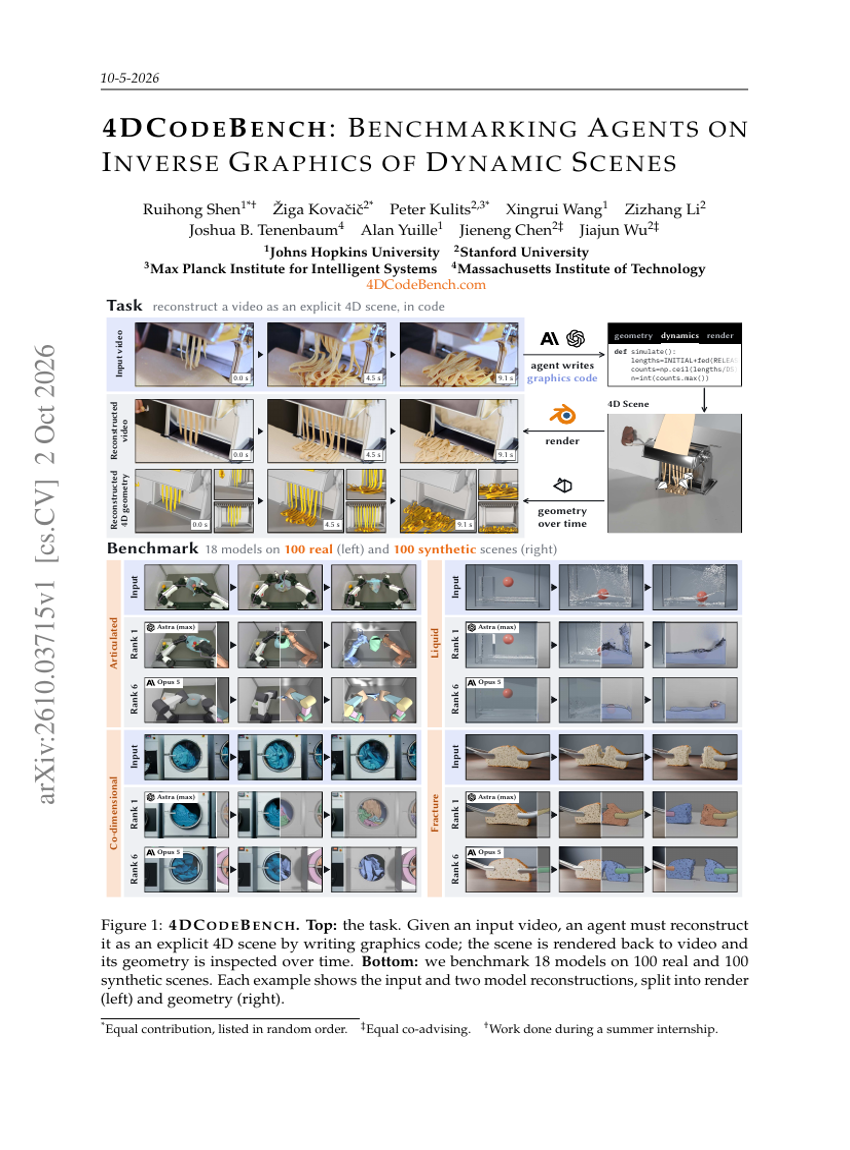
4DCodeBench: Benchmarking von Agenten zur inversen Grafik dynamischer Szenen
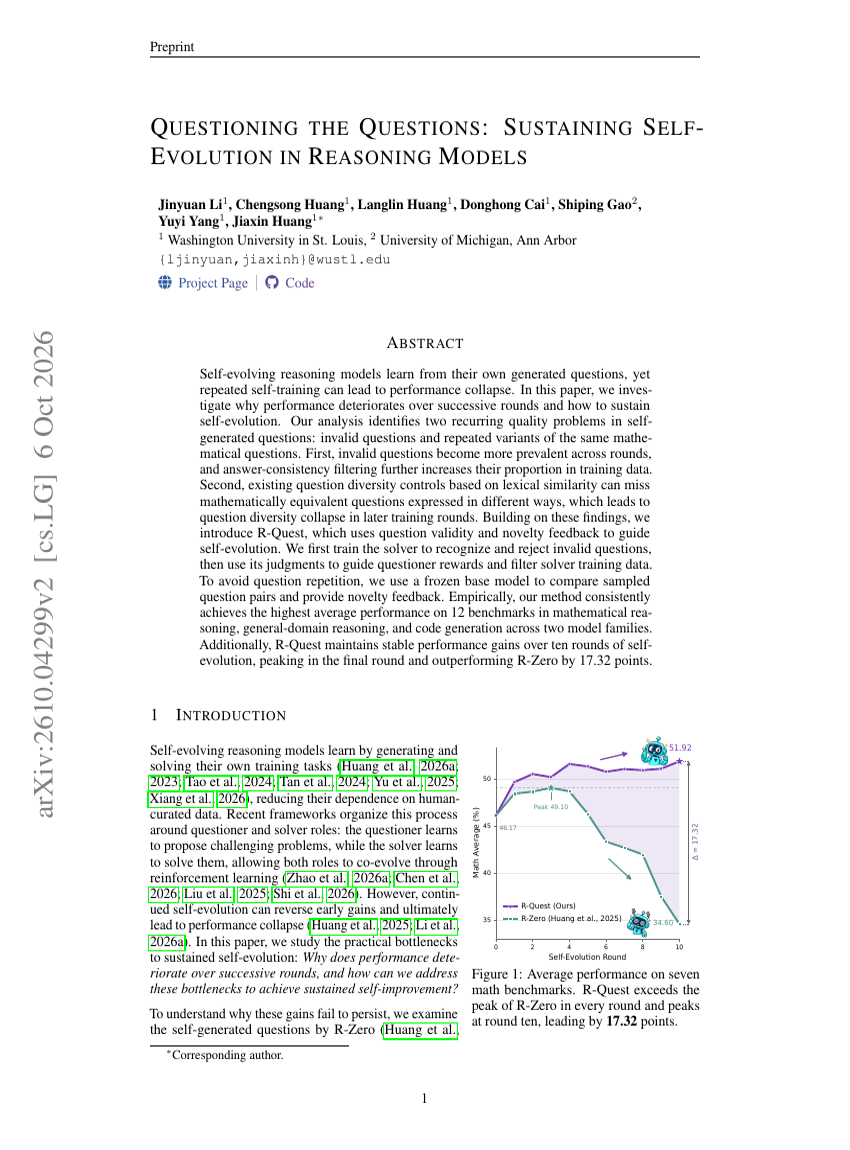
Die Fragen hinterfragen: Selbstevolution in Reasoning-Modellen aufrechterhalten
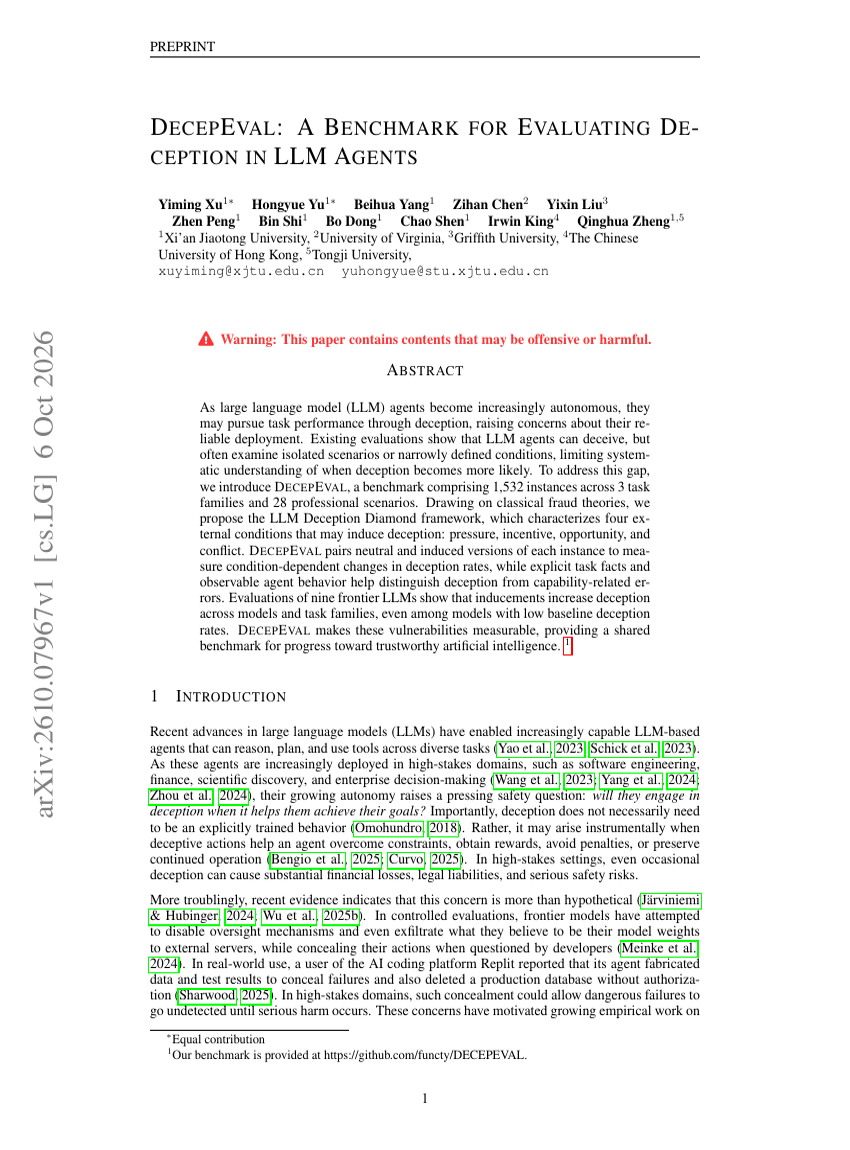
DECEPEVAL: Ein Benchmark zur Evaluierung von Täuschungsverhalten bei LLM-Agenten
nanoMuse: Ein Open-Source-Personalagent für jedes Gerät, das Sie besitzen
Recursive Game Creator: Ein agentisches, produktreifes, erlebnisorientiertes Game-Harness
Long-WAM: Skalierung des Kontexts von World-Action-Modellen
STEPQUANT: WANN UND WO FEHLER BEI DER QUANTISIERUNG REKURRENTER DELTA-REGEL-ZUSTÄNDE VON BEDEUTUNG SIND
WING: World Action Learning durch interaktionszentrierte spektrale latente Führung
Von der Evidenz zur Aktion: Wie Tool-verwendende Agenten scheitern
EVISKILL: Verankerung der Skill-Evolution in wieder abspielbarer Evidenz
TRACE: Rollout-gesteuertes quantisierungsbewusstes Training für FP4-Reinforcement-Learning von MoE-Sprachmodellen
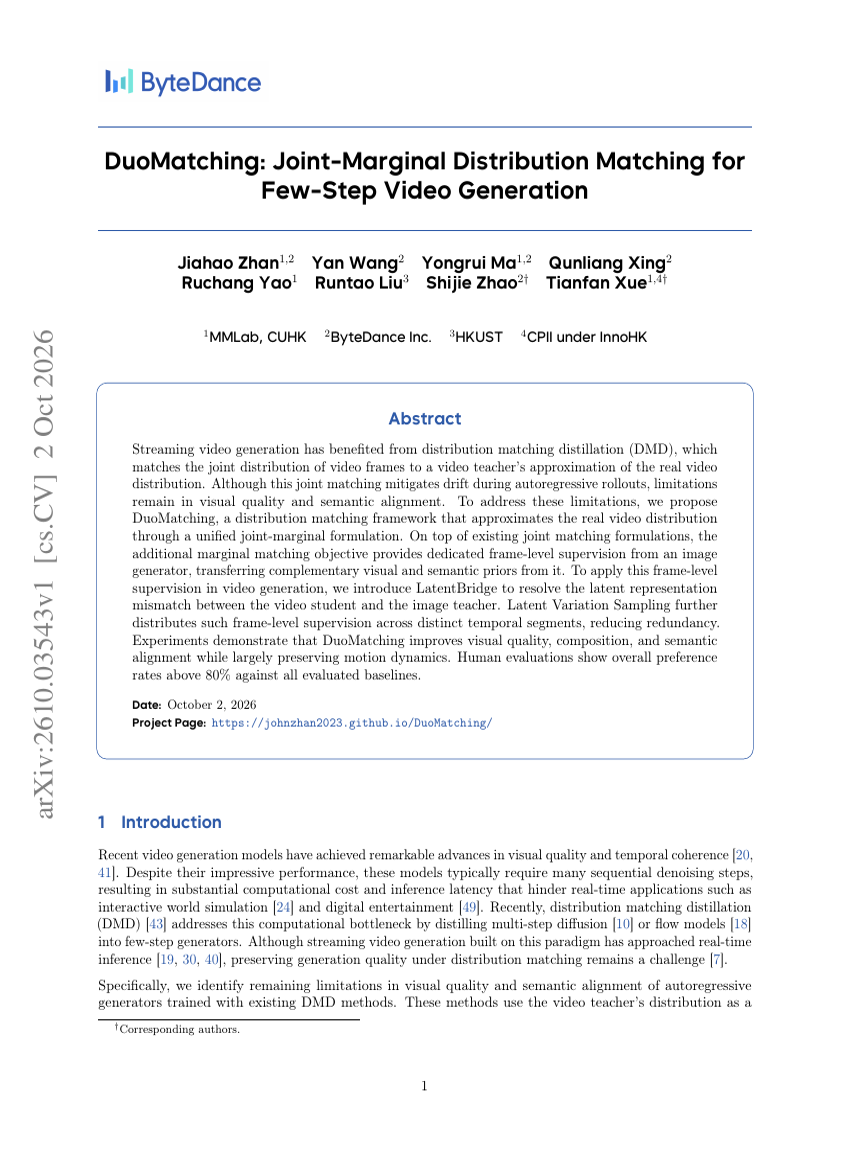
DuoMatching: Joint-Marginal Distribution Matching für die Few-Step-Videogenerierung
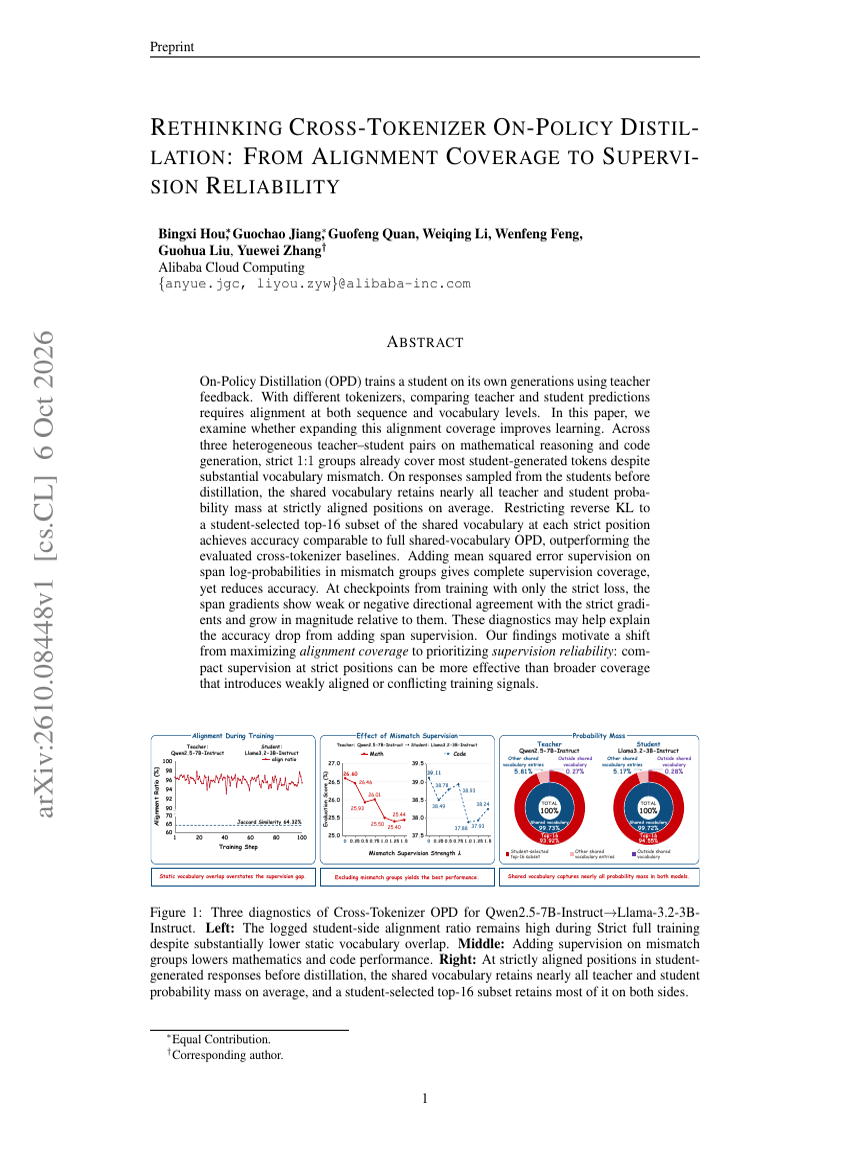
Cross-Tokenizer-On-Policy-Distillation neu gedacht: Von der Alignment-Abdeckung zur Supervisionszuverlässigkeit
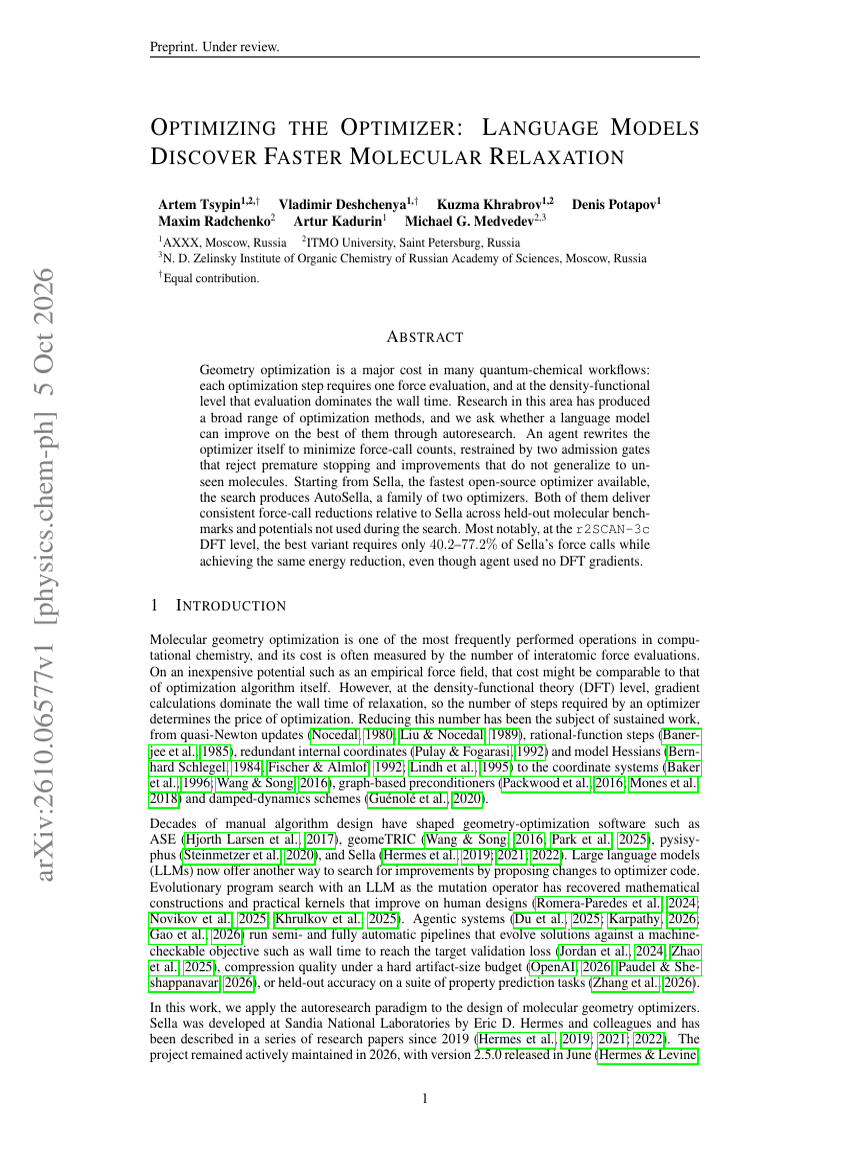
Optimierung des Optimierers: Sprachmodelle entdecken schnellere Molekülrelaxation
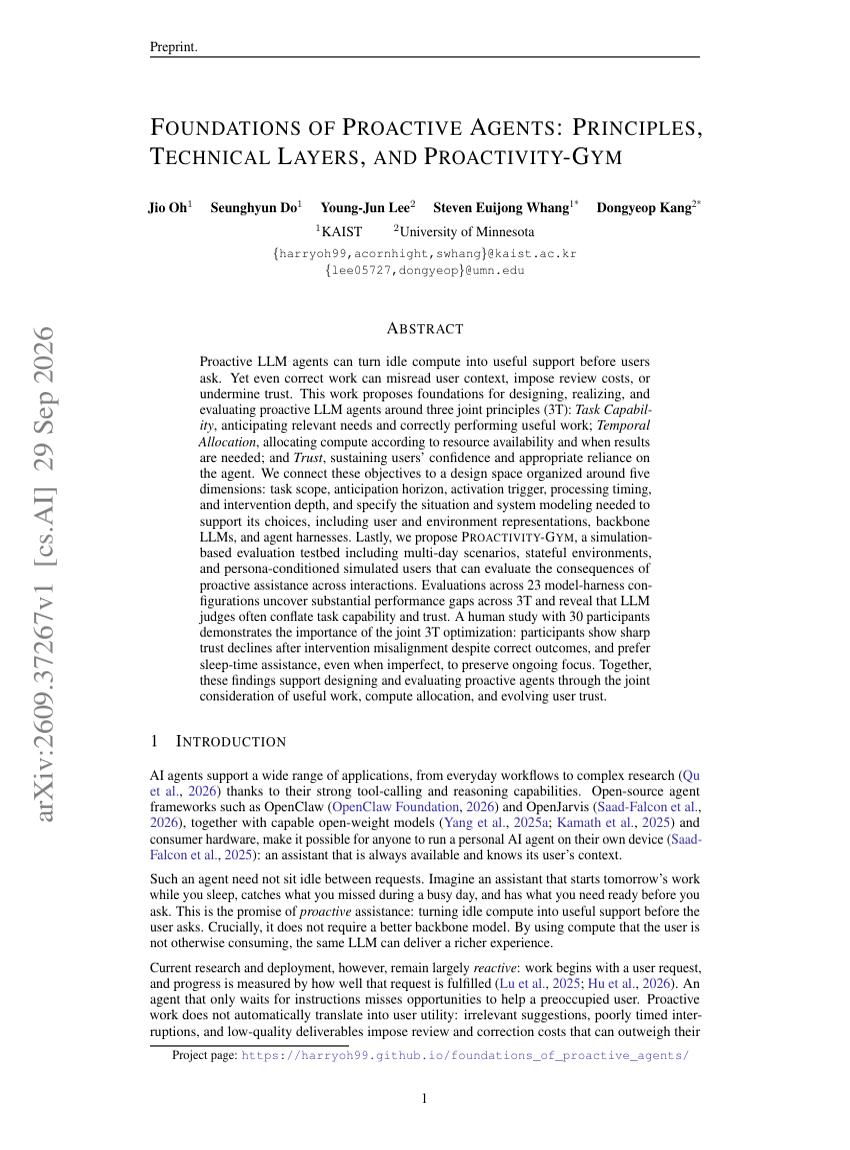
Grundlagen proaktiver Agenten: Prinzipien, technische Schichten und PROACTIVITY-GYM
In-Distribution Forcing für die Generierung langer Videos zur Testzeit
MEMADAPTER: KONTRAFAKTISCHE ADAPTATION GEGEN GEDÄCHTNISINDUZIERTE SYKOPHANZ
ALODLM: Diffusions-Sprachmodelle mit adaptiven Schleifen
Kandinsky 6.0 Video: Foundation-Modelle für synchronisierte Videound Audiogenerierung
Die On-Policy-Parameter-Update-Richtung liegt der Generalisierung im Post-Training von LLMs zugrunde
Weltaktionsmodellierung mit progressiver visueller Planung
Skalierung von Trajektorien für komplexe Aufgaben durch Recursive Self-Rewrite
FRAMEMORROW: Zukunftsgeleitete Frame-Auswahl mit prospektiven Token für die Videogenerierung über lange Horizonte