HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
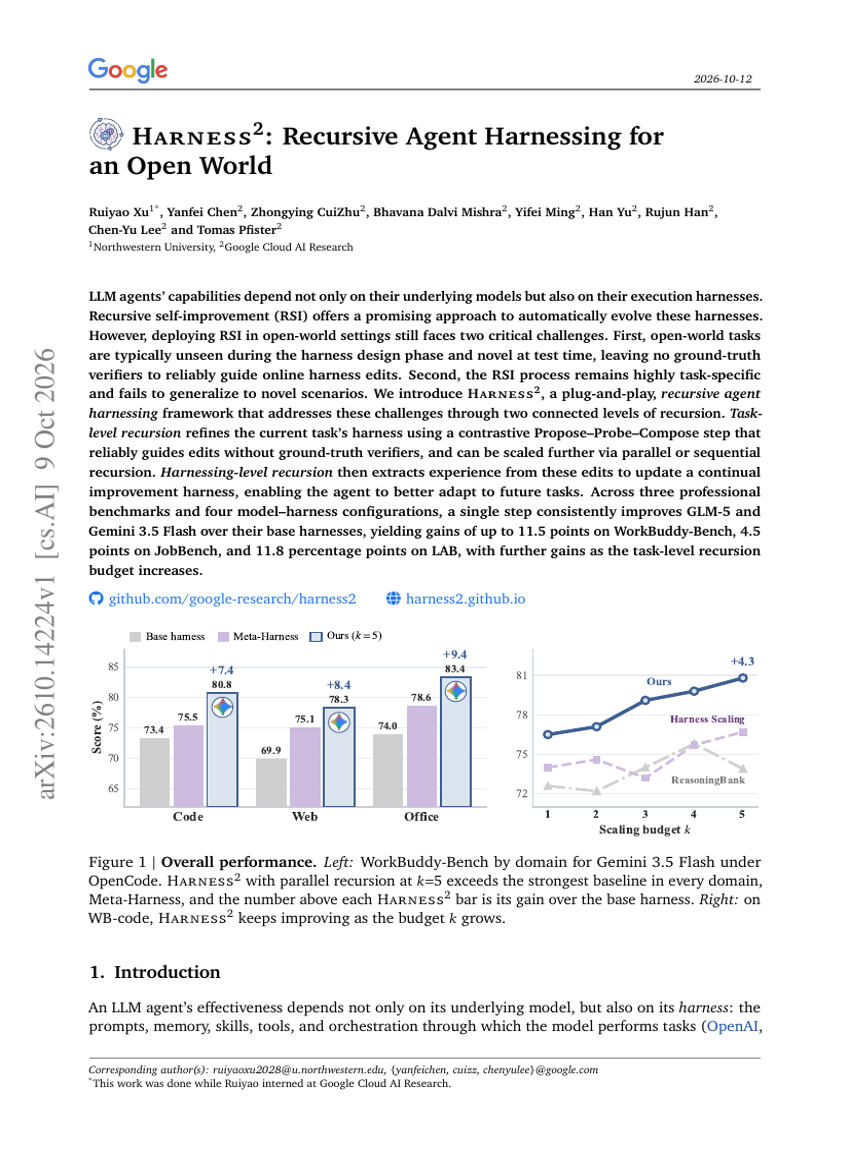
Harness2: Rekursives Agent-Harnessing für eine offene Welt
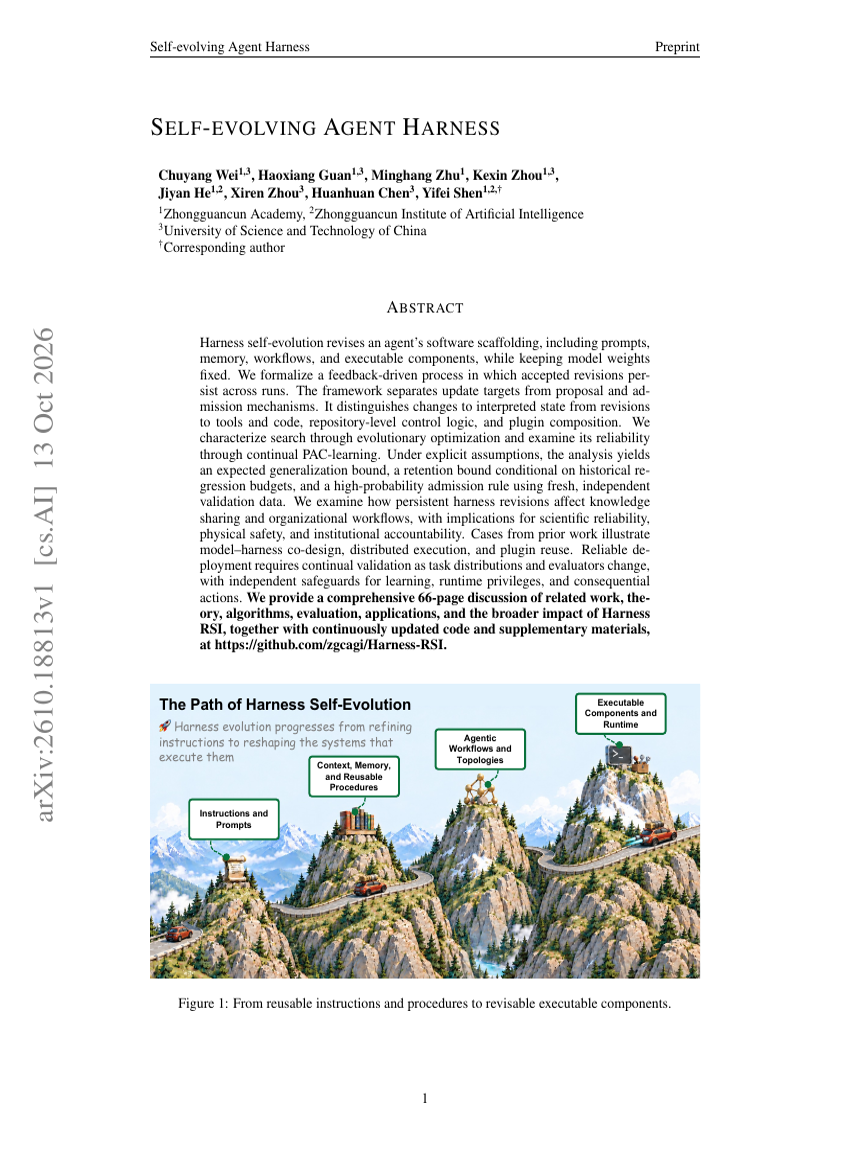
Selbst-evolvierender Agenten-Harness
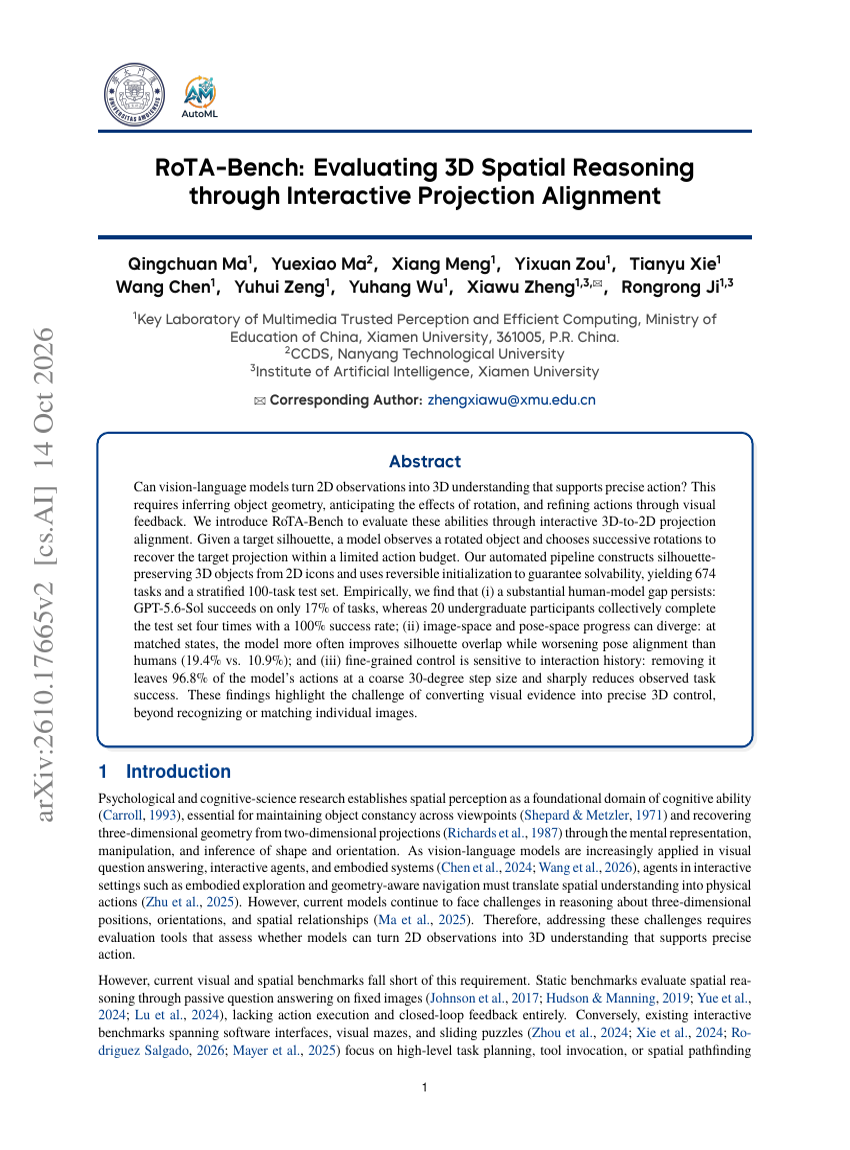
RoTA-Bench: Evaluierung von räumlichem Denken in 3D durch interaktive Projektionsausrichtung
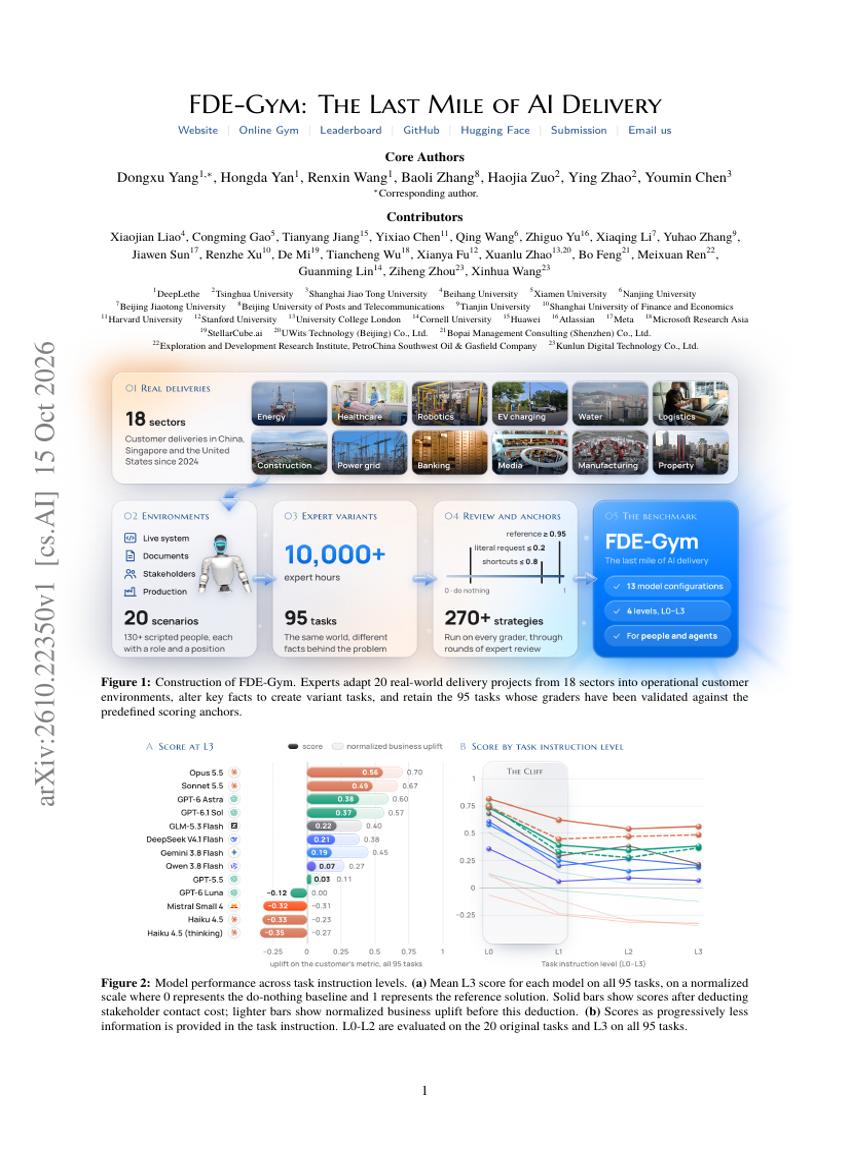
FDE-Gym: Die letzte Meile der KI-Bereitstellung
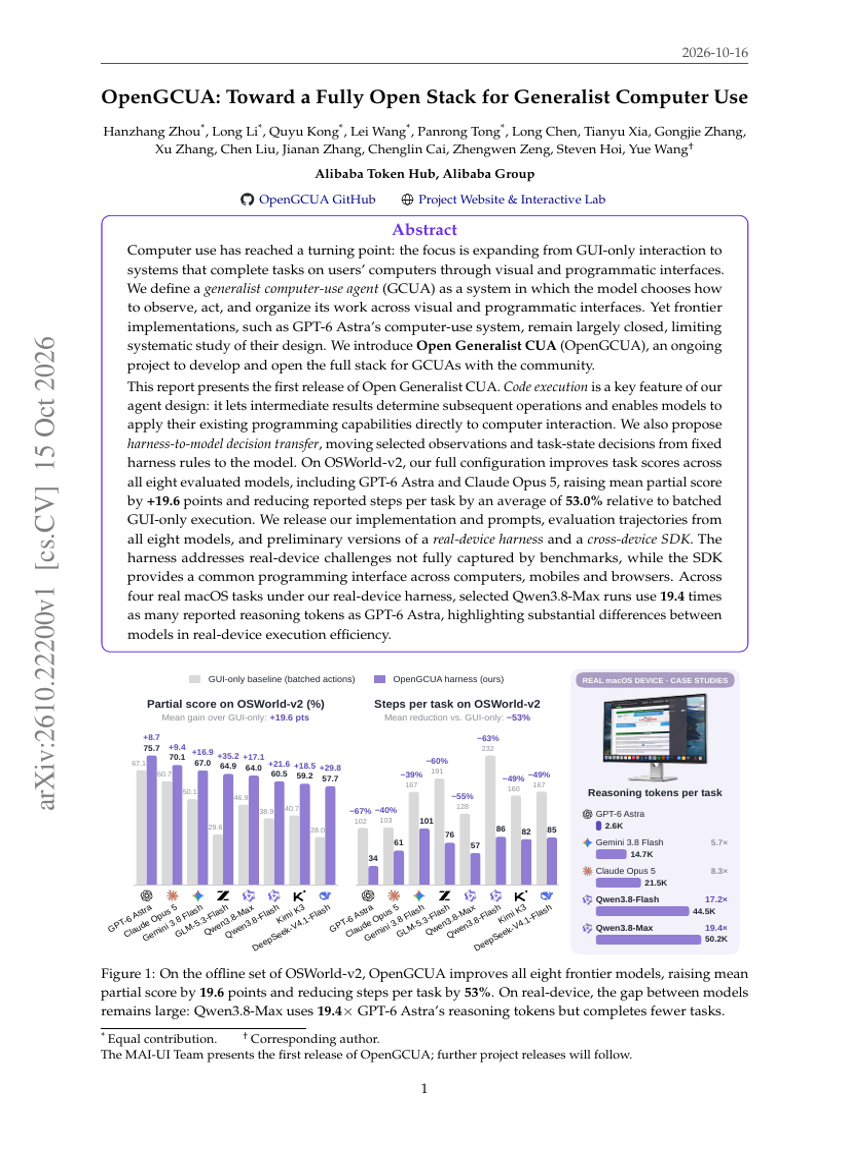
OpenGCUA: Auf dem Weg zu einem vollständig offenen Stack für die generalistische Computernutzung
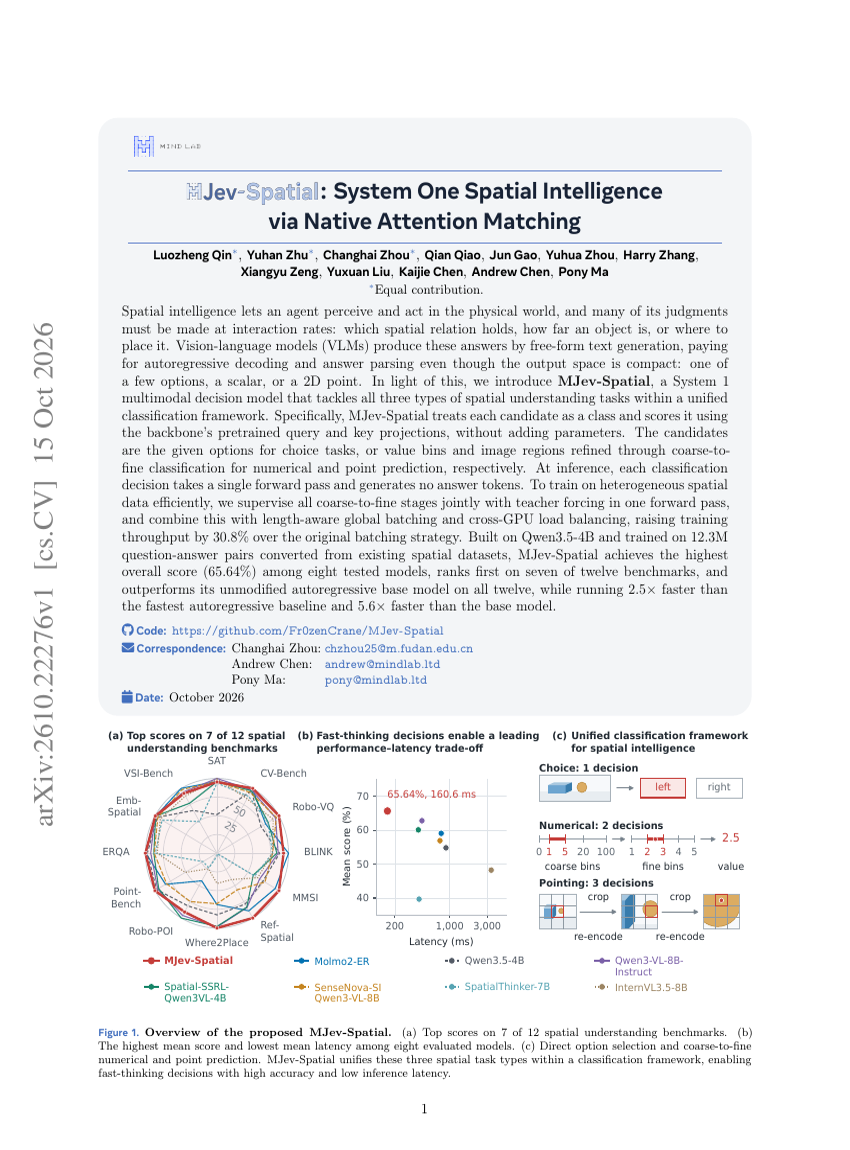
MJev-Spatial: System-1-Raumintelligenz durch natives Attention-Matching
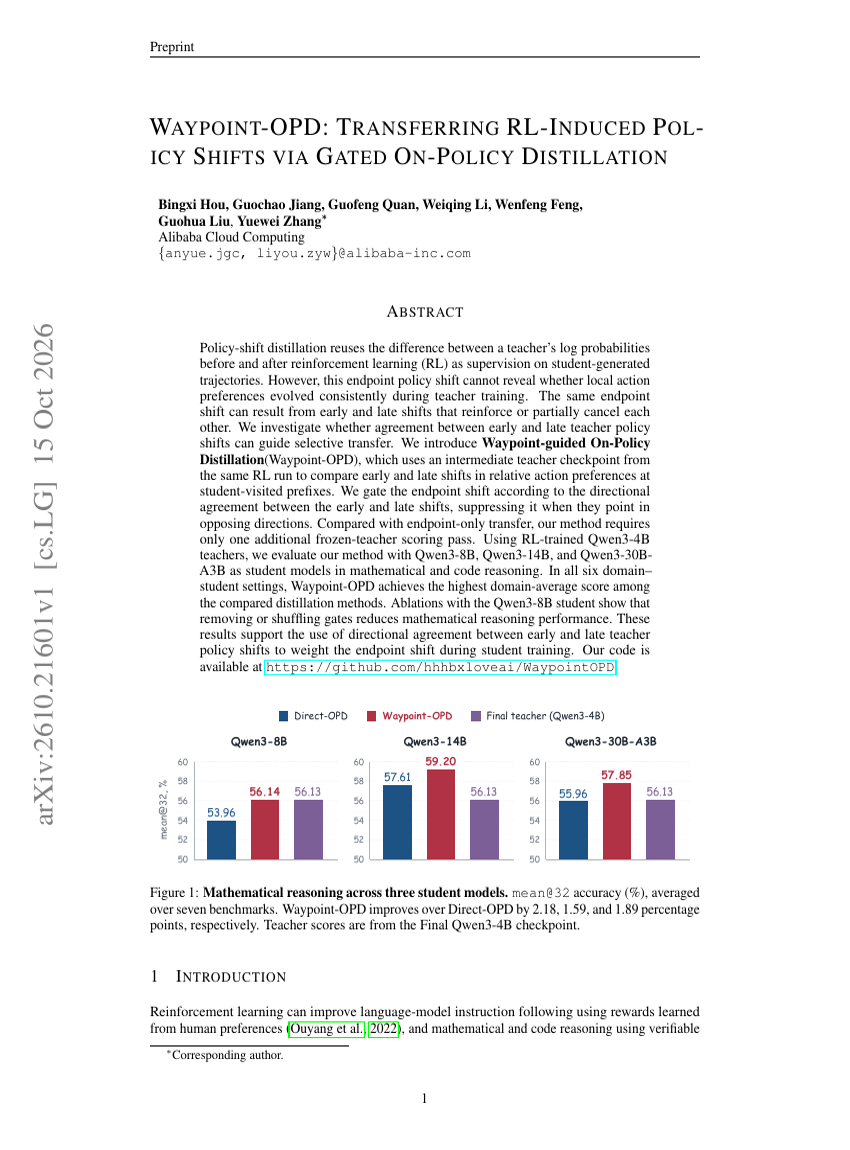
WAYPOINT-OPD: TRANSFER RL-INDUZIERTER POLICY-VERSCHIEBUNGEN DURCH GEGATETE ON-POLICY-DISTILLATION
TRAININGSBERICHT ZU TELECHAT3-MOE
RuleTrek: Benchmarking agentischen regelbasierten Schließens in komplexen Szenarien
Wiederherstellung verlässlicher Supervision durch kritikgeleitete On-Policy-Destillation
Doc2Harness: Benchmarking von LLMs für Harness-Engineering über lange Horizonte bei Coding-Agenten
Jenseits domänengerouteter Supervision: Cross-Teacher Guarding für Multi-Teacher-On-Policy-Distillation
PLAYER-1: Spielen lernen aus synthetischer Erfahrung
Any Time, Any Space: Ein weltzustandszentriertes Framework für agentische Videogenerierung
AesCode: Ästhetische Codegenerierung mit entkoppelten modalitätsübergreifenden Belohnungen
GreenWAM: Ein Welt-Grundlagenmodell für die Robotik
Urbex: Agentisches räumliches Grounding für 3D-Szenen im Stadtmaßstab
Agent-Reflex: Sprachagenten beibringen, reflektiert zu handeln
VideoJev: Ein System-One-Modell für Videoverständnis und -interaktion
Jeva: System-One-Modelle aus ersten Prinzipien
Multi-Stream Attention Residuals
VIS-Ground: Interaktives Video-Storytelling mit kontextueller Verankerung
Denkträgheit: LLMs denken weiter, wenn man ihnen sagt, sie sollen nicht denken
Skalierung agentischer Daten für Terminal-Intelligenz mit langem Horizont
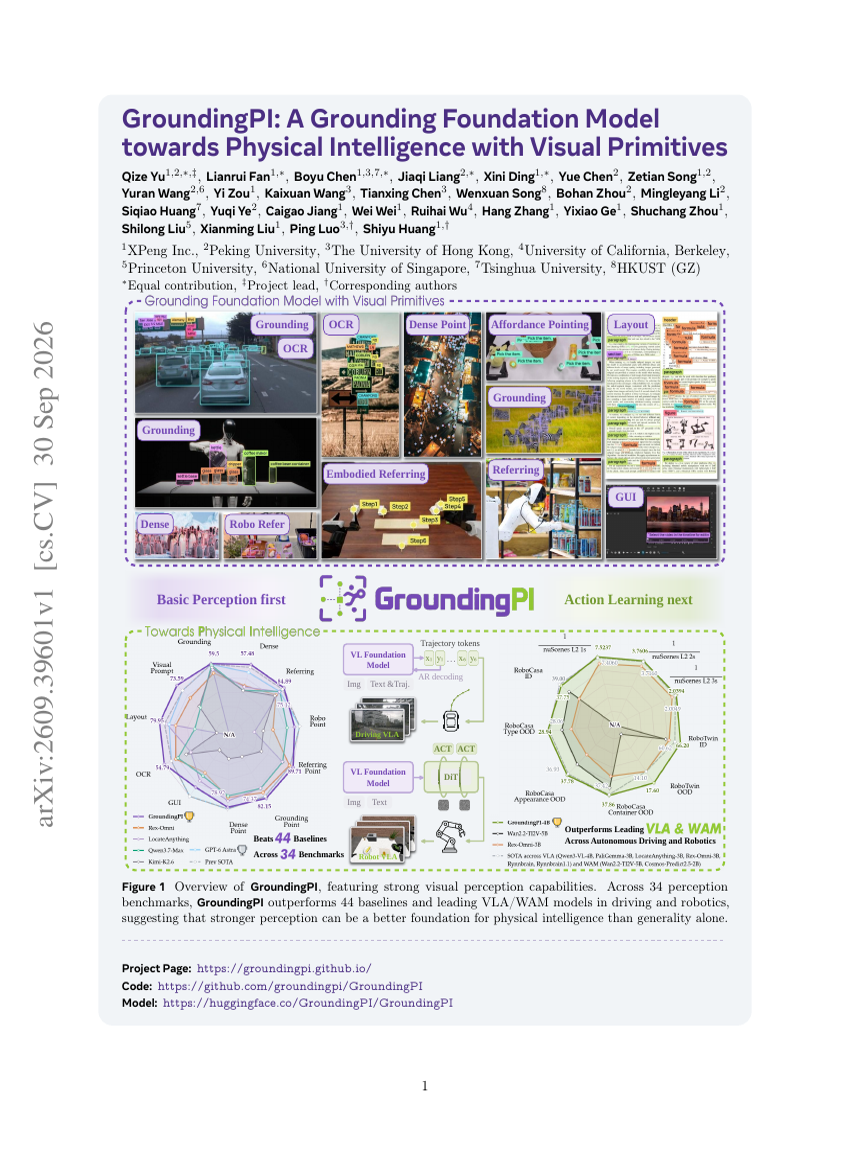
GroundingPI: Ein Grounding-Foundation-Modell für physische Intelligenz mit visuellen Primitiven
AGENTSWE: Können Coding-Agenten den Agenten bauen, den man tatsächlich will?
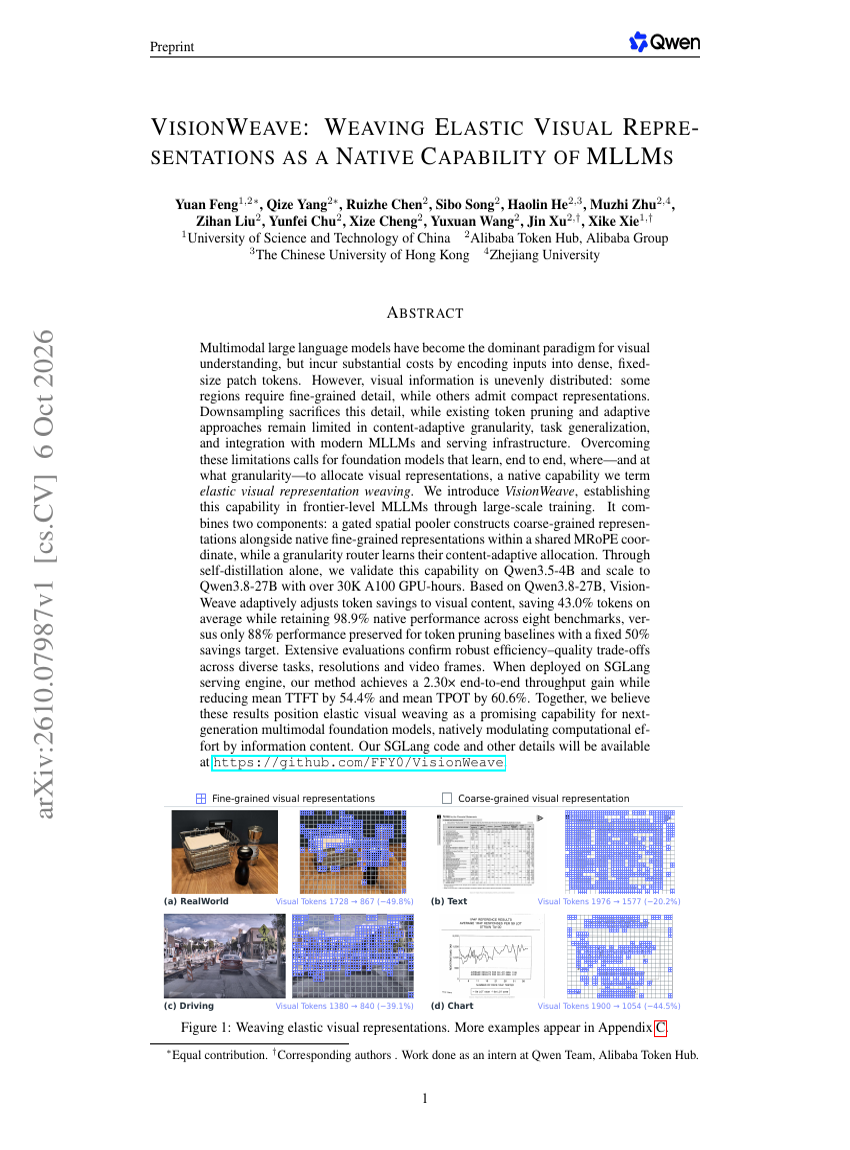
VisionWeave: Das Weben elastischer visueller Repräsentationen als native Fähigkeit von MLLMs
EmbodiedCLBench: Evaluierung des kontinuierlichen Lernens für sich selbst weiterentwickelnde verkörperte Agenten
SOFTWAREGYM: Skalierung des Trainings von Computer-Use-Agenten mit vielfältigen synthetisierten Softwareumgebungen
Reflex
S-Space: Erforschung des räumlichen Arbeitsbereichs in multimodalen Sprachmodellen
DIFFUSIONART: Effizientes, stabiles und skalierbares Verstärkungslernen für Diffusionsmodelle