HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
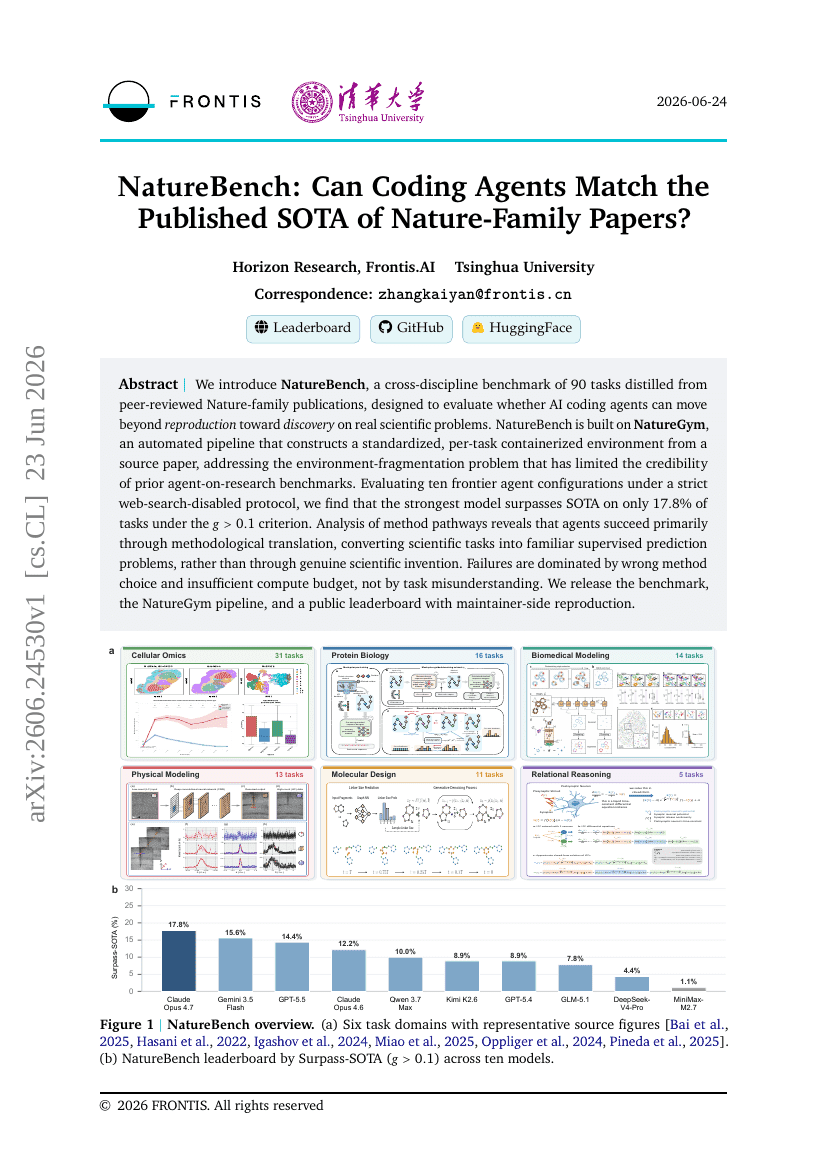
NatureBench: Können Coding Agents den veröffentlichten SOTA von Nature-Family-Publikationen erreichen?
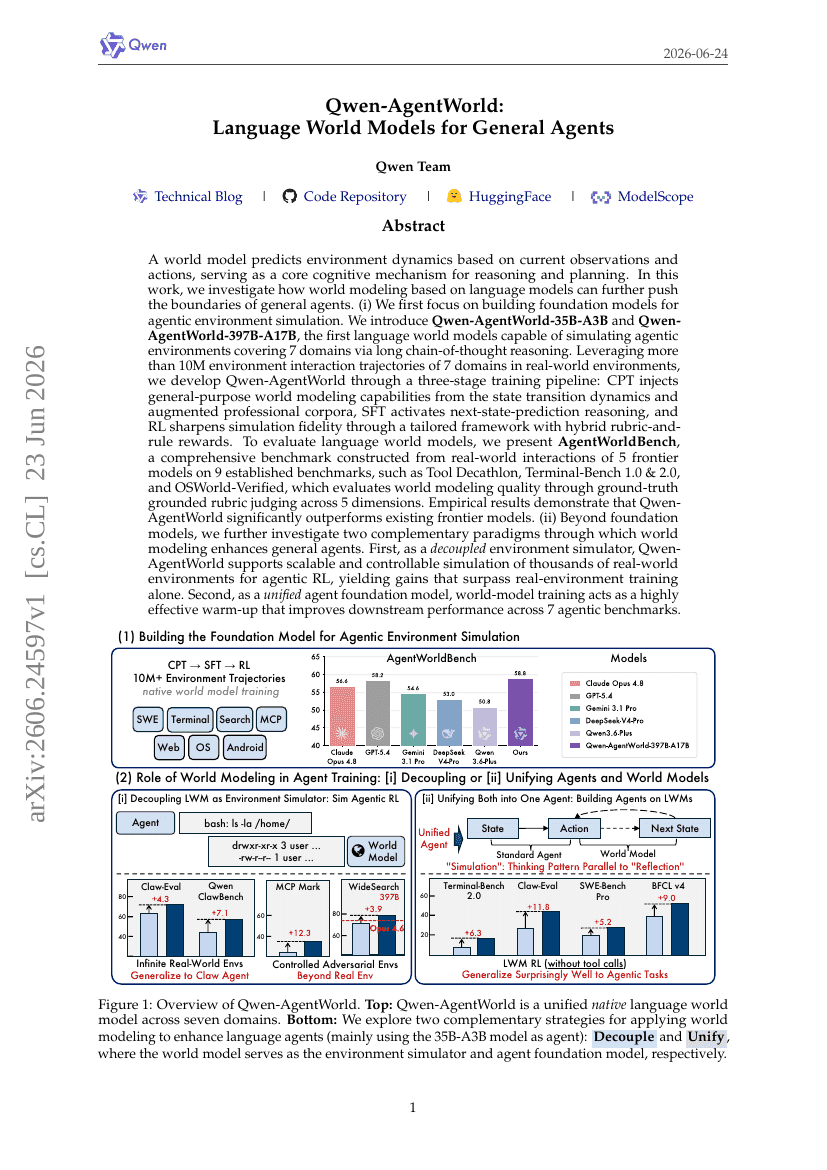
Qwen-AgentWorld: Sprachweltmodelle für allgemeine Agents
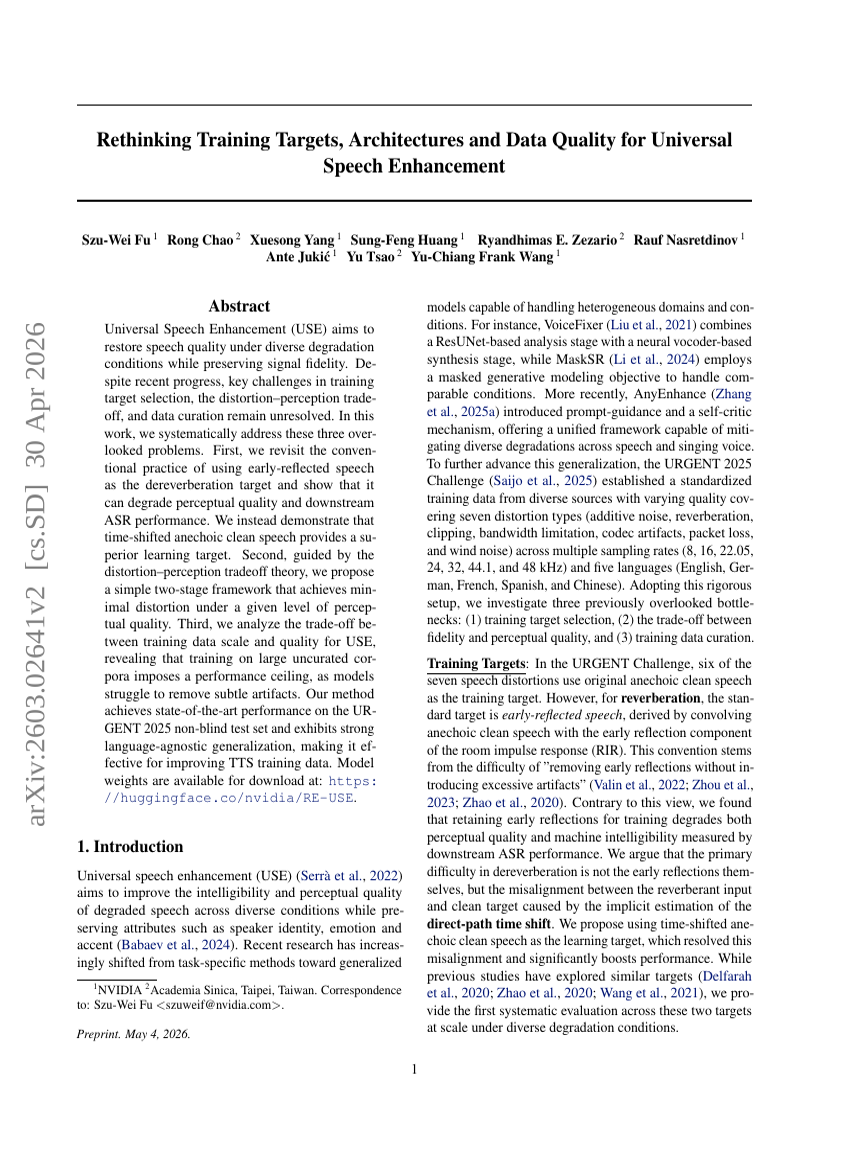
Überdenken der Trainingsziele, Architekturen und Datenqualität für universelle Spracher enhancement
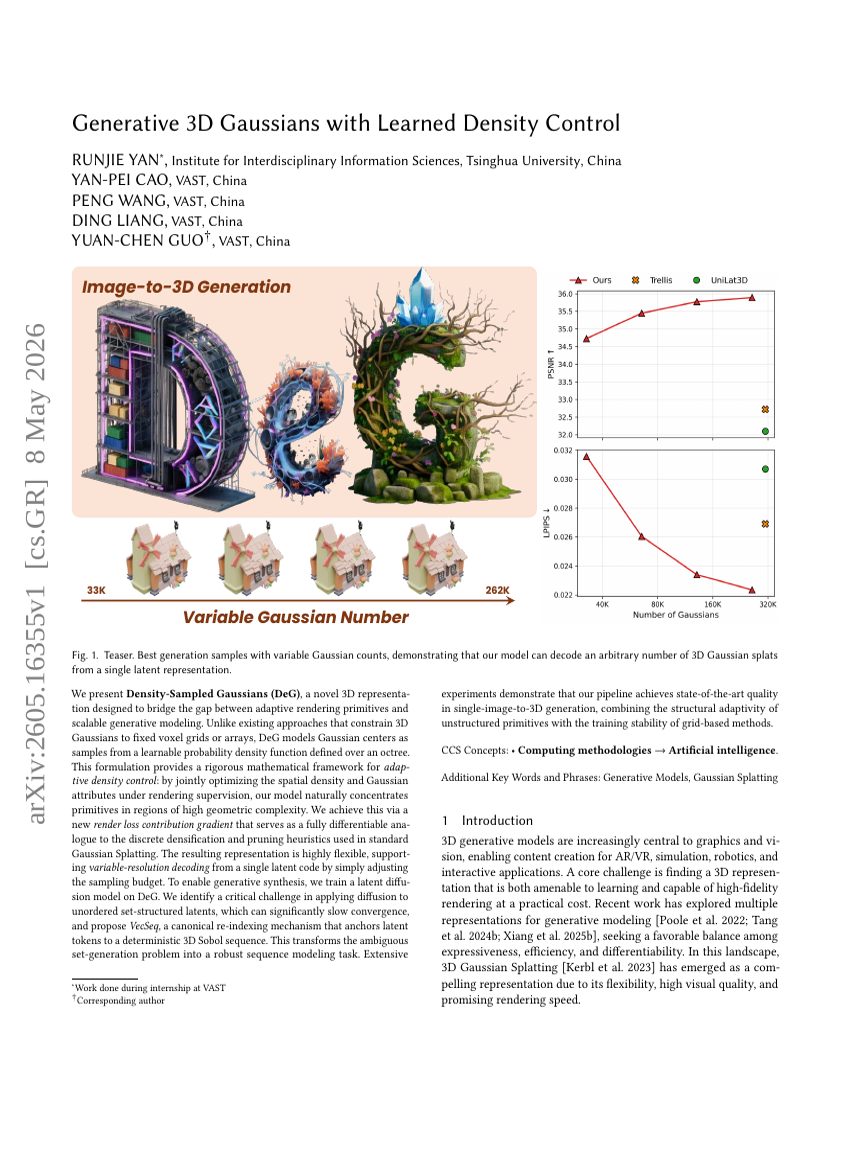
Generative 3D-Gausssche mit erlernter Dichtesteuerung
TADA: Ein generativer Rahmenwerk für die Sprachmodellierung durch text-akustische Dualausrichtung
Über isolierte Wörter hinaus: Diffusion Brush für die Generierung von handschriftlichen Textzeilen
gsplat: Eine Open-Source-Bibliothek für Gaussian Splatting
OmniVideo-100K: Ein Datensatz für audio-visuelle Schlussfolgerungen durch strukturierte Skripte und Evidenzketten
OPEN-SWE-TRACES: Fortschritte in der dualmodigen mehrsprachigen Distillation für Software Engineering Agents
Credit Assignment mit Resets in der Sprachmodell-Reasoning
Unbegrenzte OCR-Funktionalitäten: Begrüßung der Ära des One-shot Long-horizon Parsing
PlanBench-XL: Evaluation der Langzeitplanung von LLM Tool-Use Agents in großskaligen Tool-Ökosystemen
OpenRath: Sitzungszentrierter Laufzeitstatus für Agent-Systeme
EvoEmbedding: Evolutionäre Repräsentationen für Langkontext-Abfrage und agentisches Gedächtnis
Lernen aus den eigenen Fehlern: Konstruktion lernbarer mikroreflexiver Trajektorien für die Selbstdistillation
Weltaktionsmodelle: Eine Übersicht
KaLM-Reranker-V1: Schnell, aber keine späte Interaktion für das Reranking komprimierter Dokumente
Neubewertung des Schrumpfungs-Bias bei der FP4-Pretrainierung von LLMs: Geometrischer Ursprung, systemische Auswirkungen und das UFP4-Rezept
HydraHead: Von der funktionalen Heterogenität auf Head-Ebene zur spezialisierten Hybridisierung von Aufmerksamkeit
3DCodeBench: Benchmarking Agentic Procedural 3D Modeling Via Code
RadImageNet-VQA: Ein großflächiger CT- und MRI-Datensatz für radiologische visuelle Fragen-und-Antworten-Aufgaben
Training von Software-Engineering-Agenten und Verifikatoren mit SWE-Gym
MAKIEVAL: Ein mehrsprachiges automatisches Framework auf Grundlage von WiKIdata zur Evaluierung der kulturellen Sensibilität von LLMs
GeneralVLA-2: Geometriebewusste Rekonstruktion und gesteuerter Speicher für die Roboterplanung
Mehrfach-Reflektives Masking ermöglicht das Schlussfolgern in Mask-Diffusionsmodellen
BrainG3N: Ein Tokenizer mit zwei Verwendungszwecken zur kontrollierbaren 3D-Gehirn-MRT-Generierung
GateMem: Benchmarking der Speicherverwaltung in Multi-Principal Shared-Memory Agents
MemSlides: Ein hierarchisches, gedächtnisgesteuertes Agent-Framework für die personalisierte Folien-Generierung mit mehrstufiger lokaler Überarbeitung
PerceptionDLM: Parallele Regionswahrnehmung mit multimodalen Diffusionssprachmodellen
Code-World-Modelle für das allgemeine Spielen von Spielen
Jenseits statischer Leaderboards: Prädiktive Validität für die Evaluation von LLM Agents
S-Agent: Räumliche Werkzeugnutzung fördert das Schlussfolgern für räumliche Intelligenz