HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
Kandinsky 6.0 Video : modèles de fondation pour la génération synchronisée de vidéo et d'audio
La direction de mise à jour des paramètres on-policy sous-tend la généralisation dans le post-entraînement des LLM
Modélisation d’actions du monde avec planification visuelle progressive
Mise à l'échelle des trajectoires pour des tâches complexes par réécriture auto-récursive
FRAMEMORROW : sélection de trames guidée par le futur à l'aide de jetons prospectifs pour la génération vidéo à long horizon
MotorMind : échafauder des modèles vision-langage généralistes pour la manipulation robotique zéro-shot
L’apprentissage du repliement des protéines se généralise-t-il à un raisonnement plus large ?
Une pièce manquante pour des relecteurs IA dignes de confiance : de l’évaluation comparative de la robustesse rhétorique à l’examen SciCore
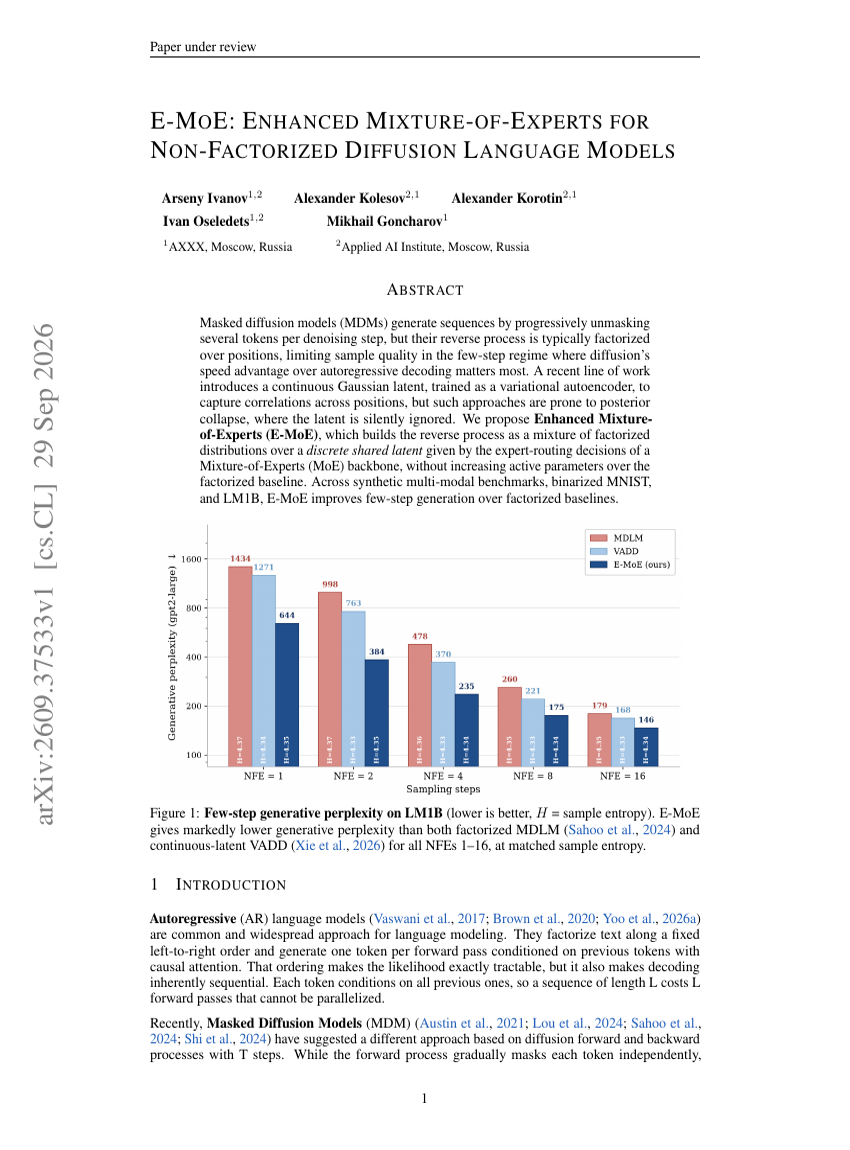
E-MoE : Mélange d'experts amélioré pour les modèles de langage à diffusion non factorisés
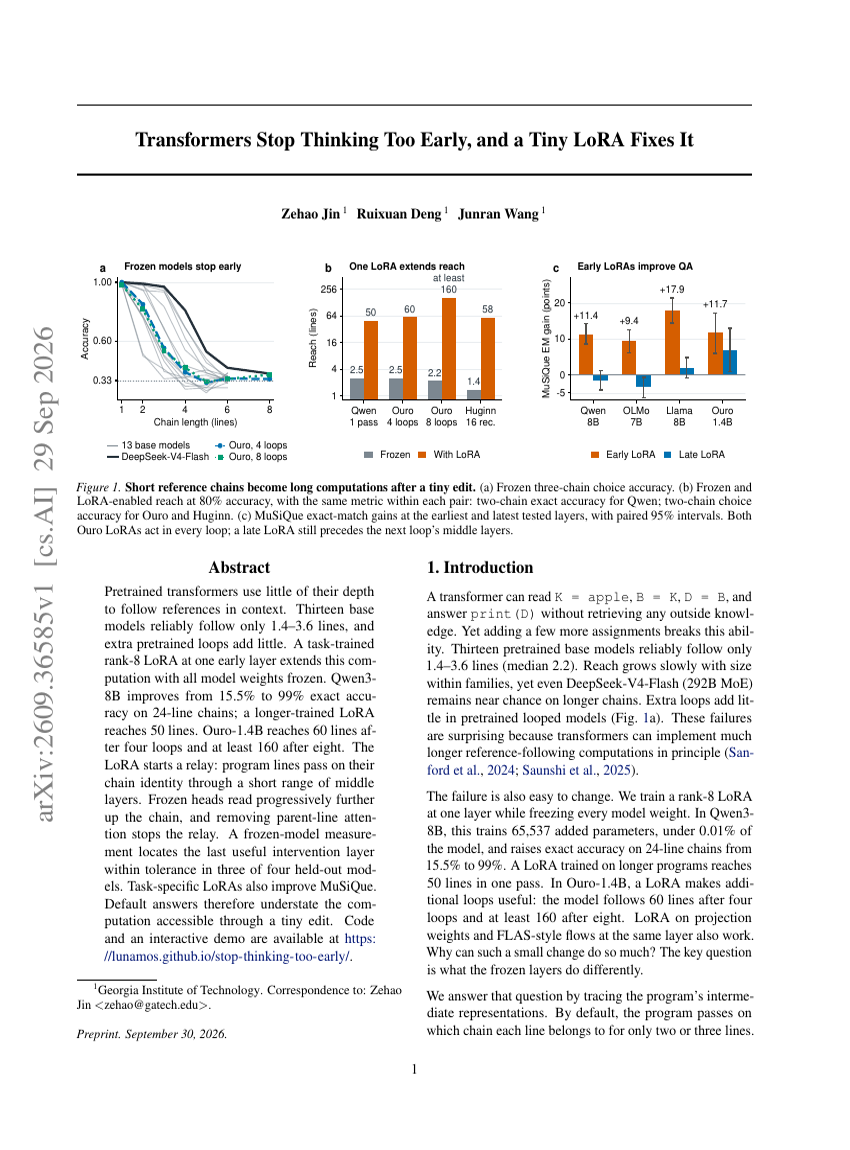
Les modèles Transformer cessent de réfléchir trop tôt, et une LoRA minuscule y remédie
Routage adaptatif des récompenses (Adaptive Reward Routing) : optimisation dynamique multi-récompenses pour la diffusion audio-vidéo conjointe via l’apprentissage par renforcement sur le processus direct
OneStreamer : unifier la perception, la mémoire et la réponse proactive dans l’interaction vidéo en continu
Apprentissage on-policy ou off-policy ? Une étude systématique de la dynamique de distillation
EVODUET : co-évolution bi-niveau de la recherche sur le web et de la résolution de tâches pour la découverte scientifique
Mid-Harness : mise à l’échelle des actions entre le modèle et le harnais pour les agents terminaux
AREX-2 : faire progresser les agents auto-améliorants grâce à des tâches réflexives à long horizon
Fausses frontières : diagnostic et atténuation du co-cheating dans les agents de recherche auto-évolutifs
UNIEVO-VL : une recette d’entraînement par auto-distillation on-policy pour l’auto-amélioration des modèles multimodaux
L’enseignant est une direction, pas une destination : extrapolation des résidus de représentation induits par RL dans la distillation on-policy
Qu'est-ce qui permet aux modèles d'action du monde (WAM) de généraliser ? Une étude empirique de la modélisation du futur à l'inférence
MaLiang-Harness : une voie programmable vers la génération d'images et de vidéos
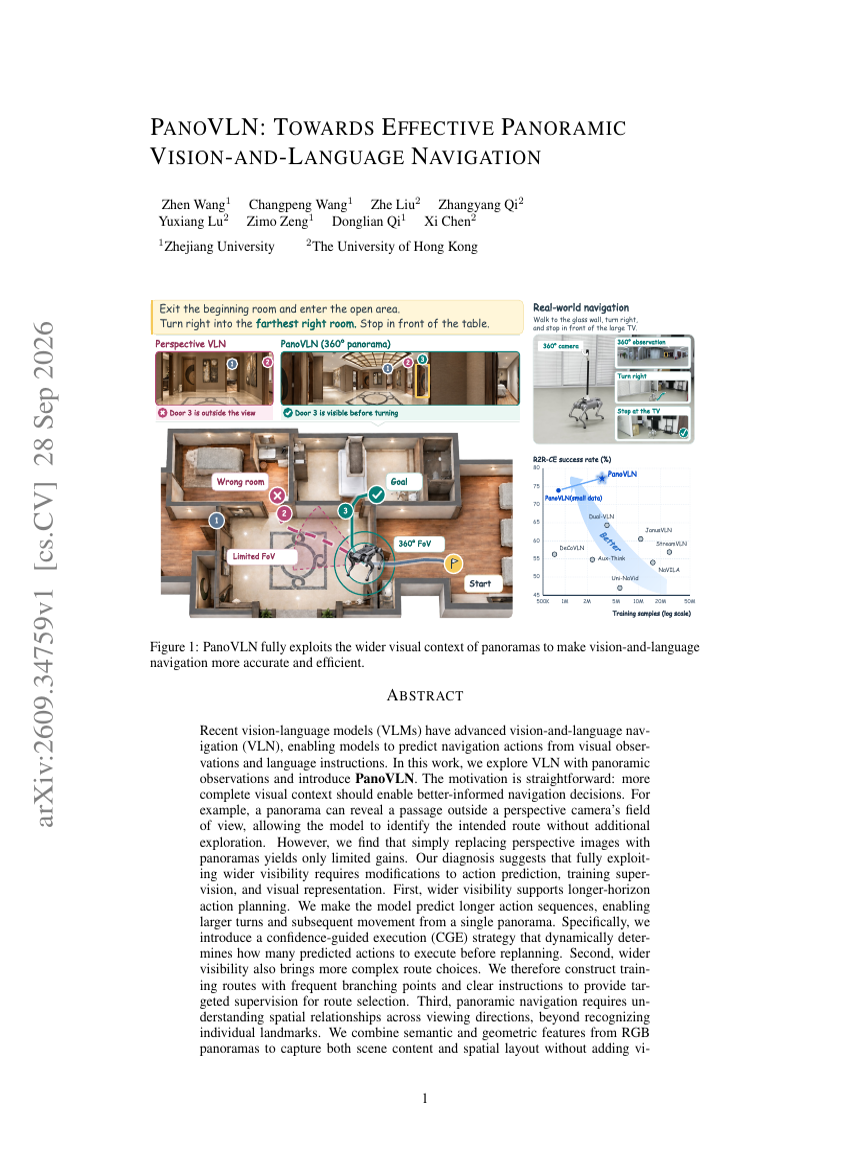
PanoVLN : vers une navigation vision-langage panoramique efficace
VoxMem : évaluation comparative de la mémoire multimodale dans les grands modèles de langage audio
Omni-IO Skills : rendre votre agent omni-natif
Raven : The Harness of Harnesses pour l’intelligence agentique composable
YuE2 : unifier la génération de musique symbolique et audio à une qualité de pointe
Évaluation agentique par groupes et redistribution des avantages pour le RL des agents de code
Où en sommes-nous de la suppression de l’encodeur visuel ? Lois d’échelle pour le pré-entraînement multimodal sans encodeur
Duplex-MPE : évaluation comparative de l’interaction multipartite dans le dialogue full-duplex
Le post-entraînement laisse des ombres comportementales sur des décisions sans rapport
Au-delà de l’affectation des enseignants : distillation multi-enseignants on-policy normalisée par domaine
Amélioration des modèles numériques de surface photogrammétriques au moyen de modèles de diffusion pré-entraînés et d'un conditionnement multimodal