HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
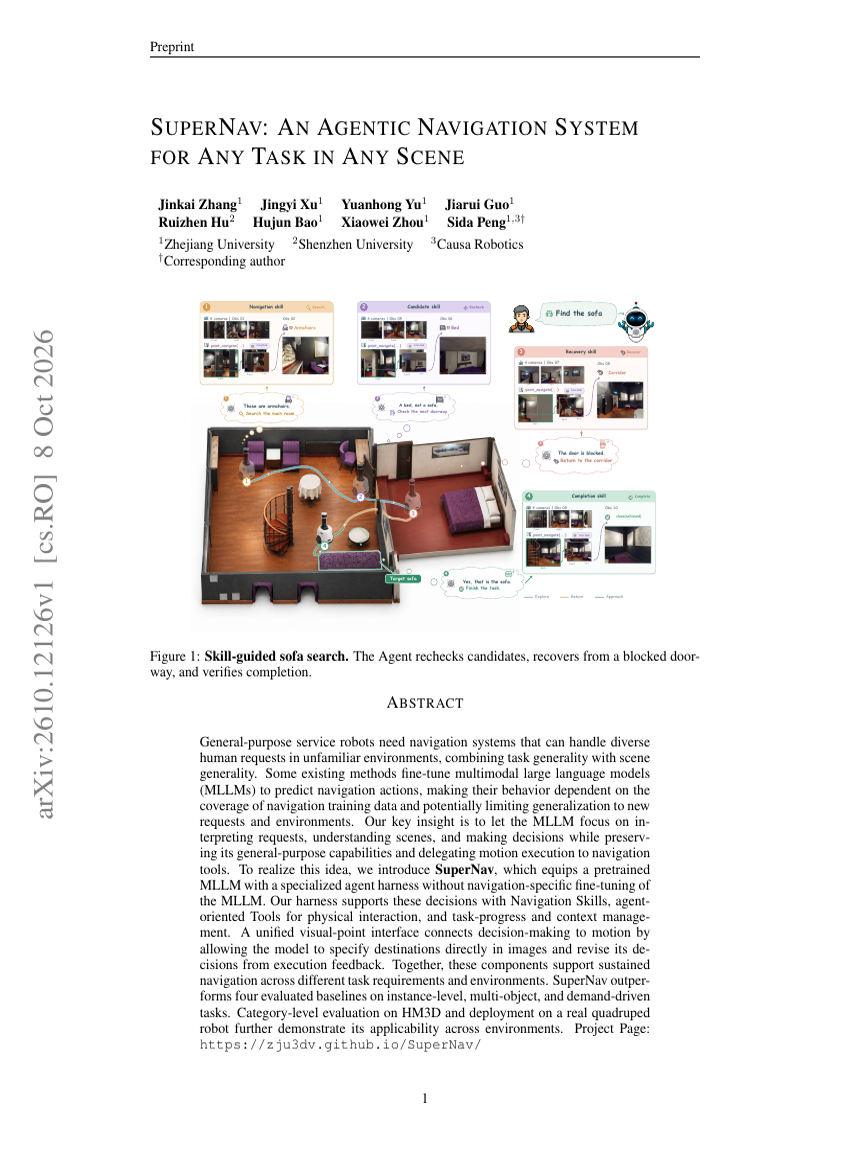
SUPERNAV : un système de navigation agentique pour toute tâche dans toute scène
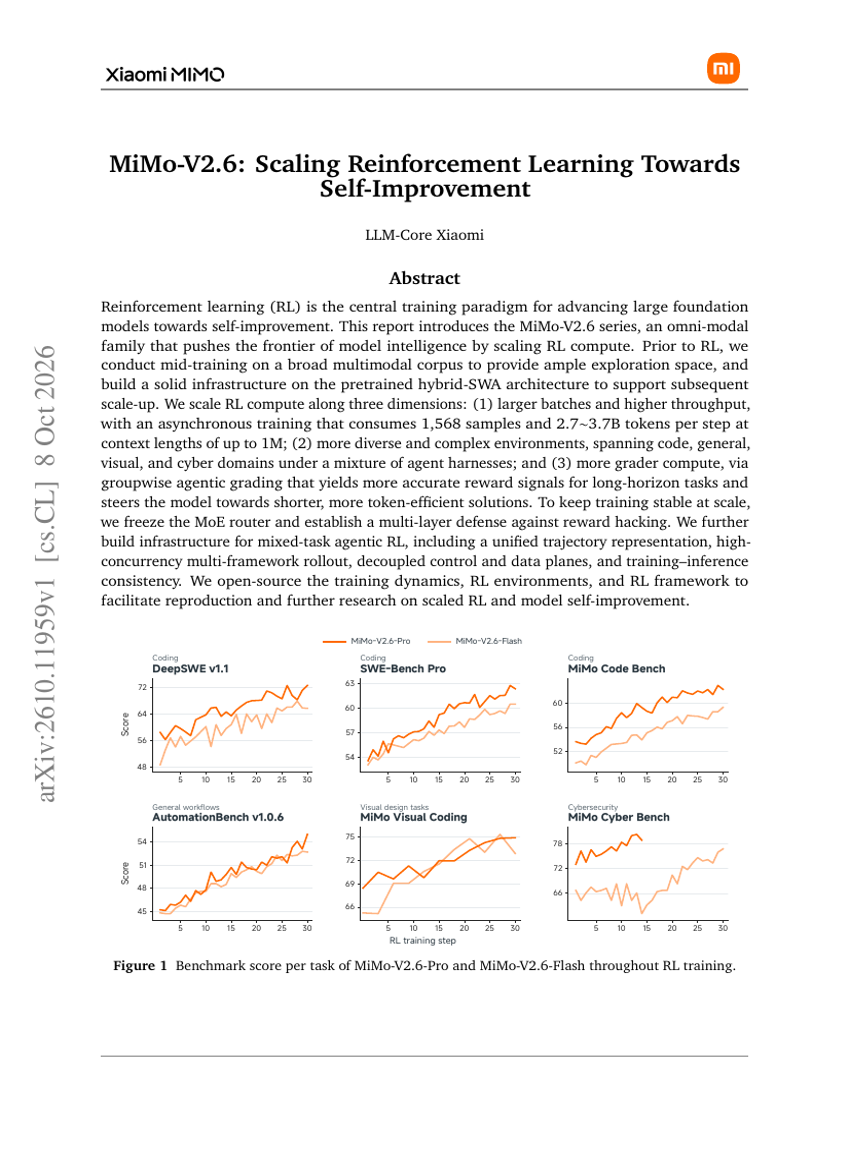
MiMo-V2.6 : mise à l’échelle de l’apprentissage par renforcement en vue de l’auto-amélioration
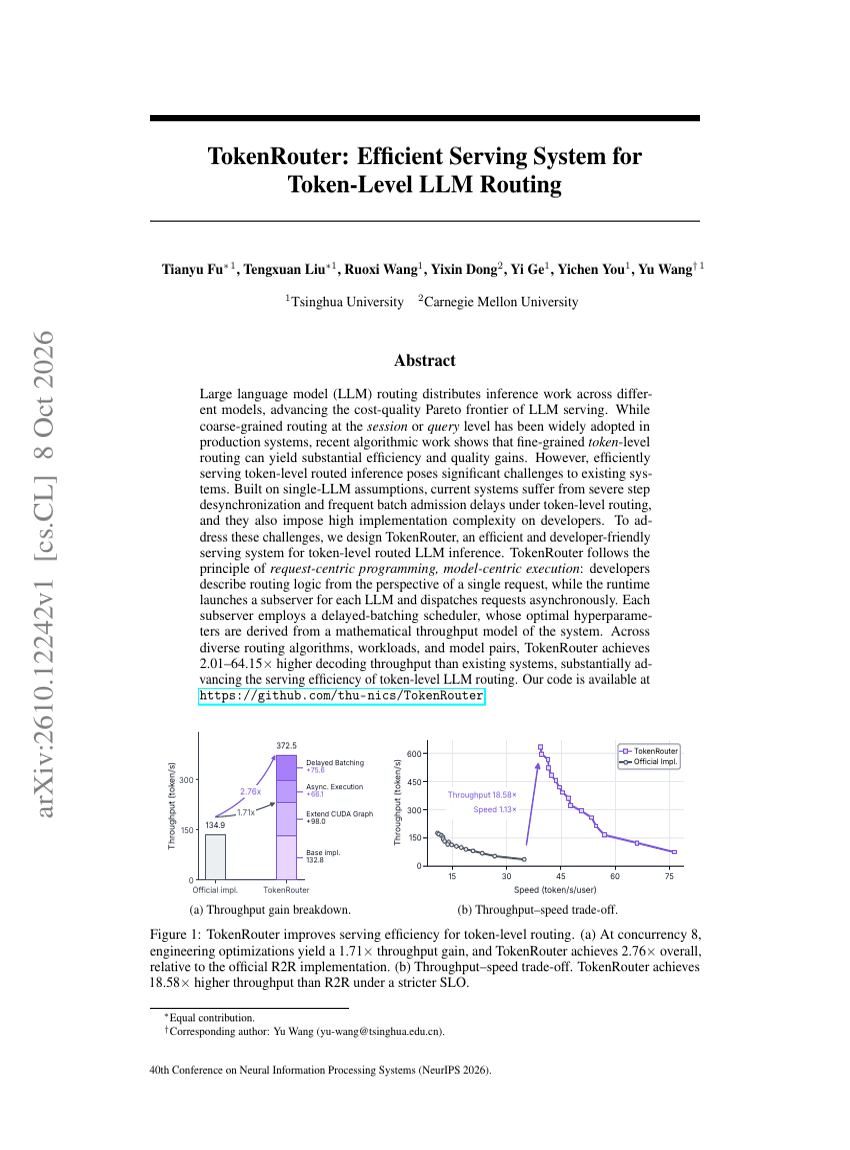
TokenRouter : un système de service efficace pour le routage de LLM au niveau des jetons
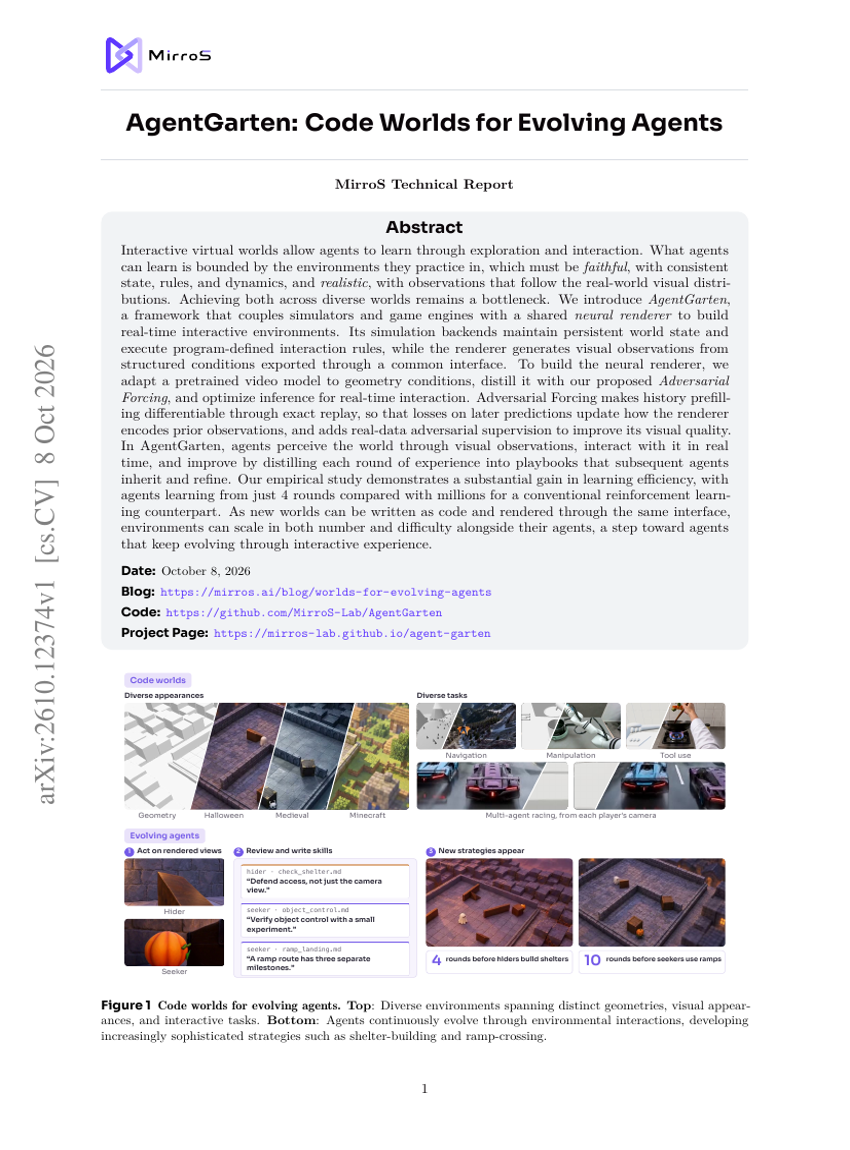
AgentGarten : des mondes en code pour des agents en évolution
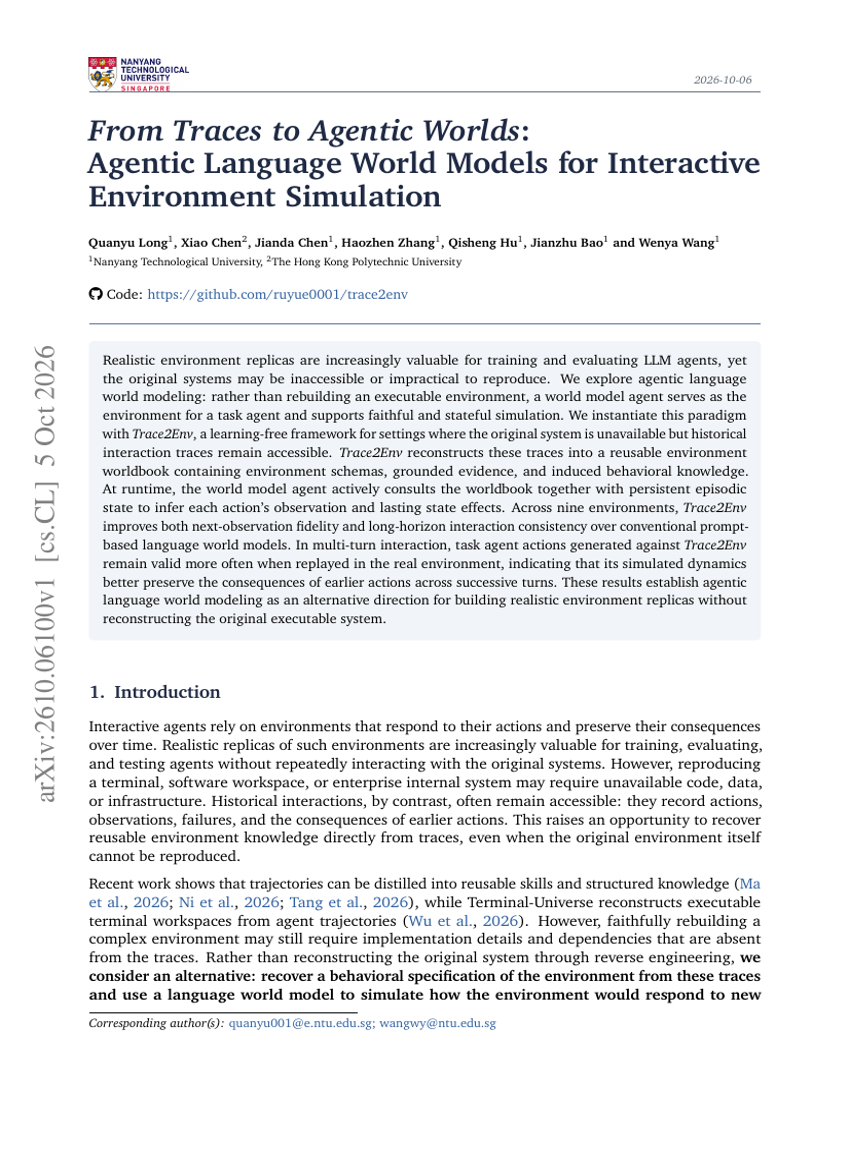
Des traces aux mondes agentiques : modèles de monde langagiers agentiques pour la simulation d'environnements interactifs
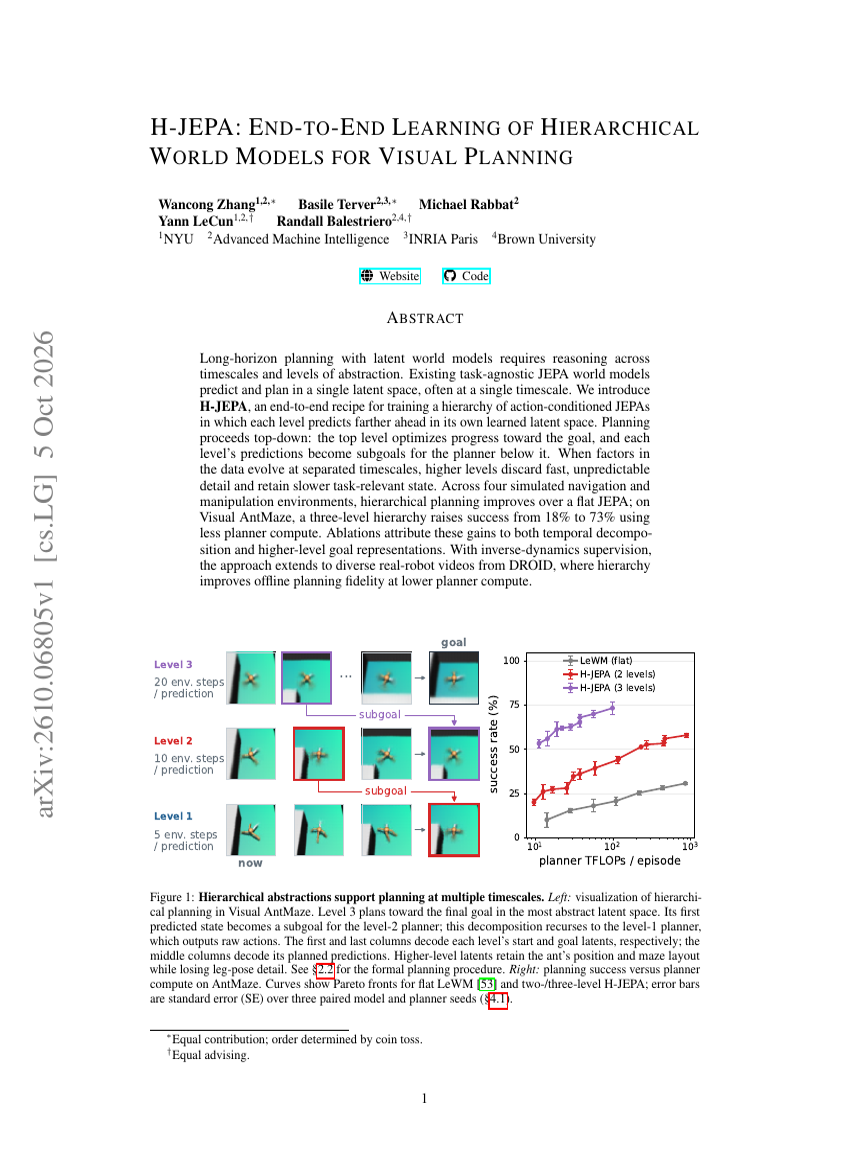
H-JEPA : APPRENTISSAGE DE BOUT EN BOUT DE MODÈLES DU MONDE HIÉRARCHIQUES POUR LA PLANIFICATION VISUELLE
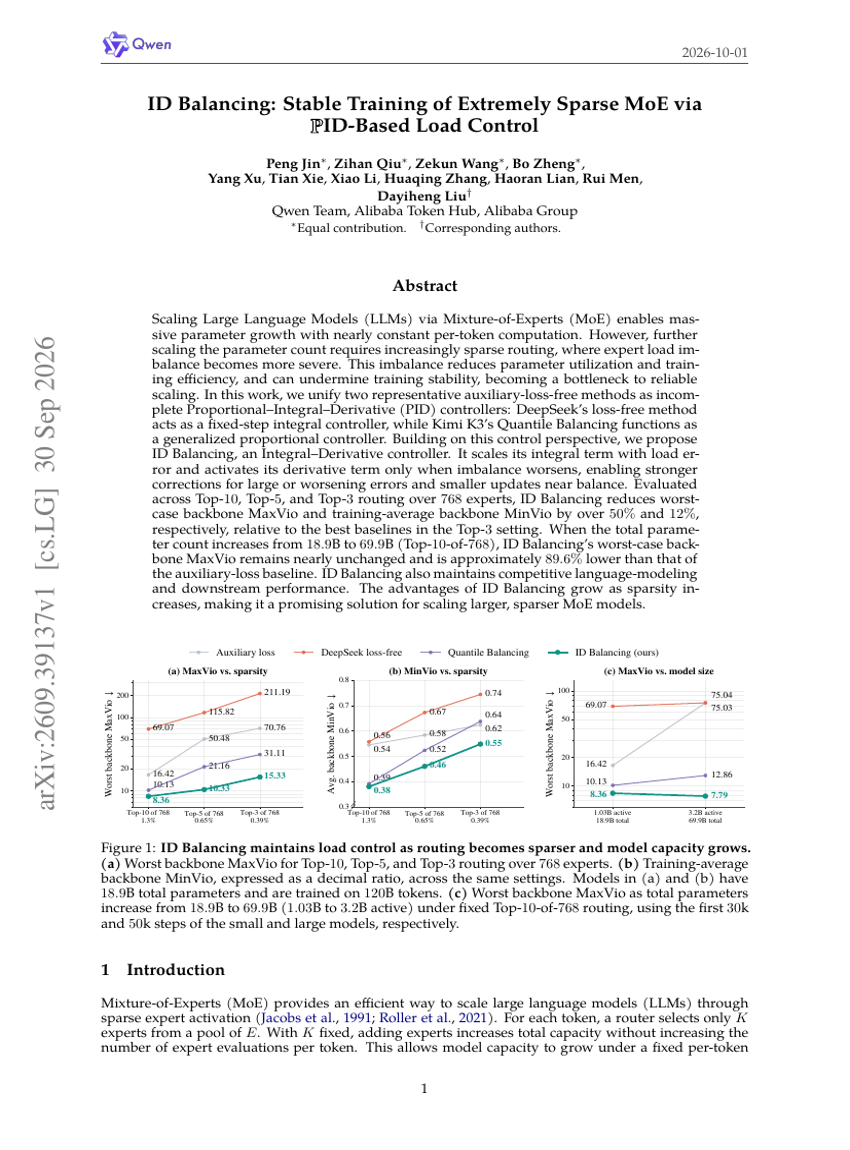
Équilibrage par ID : Entraînement Stable de MoE Extrêmement Creux via un Contrôle de Charge Basé sur un PID
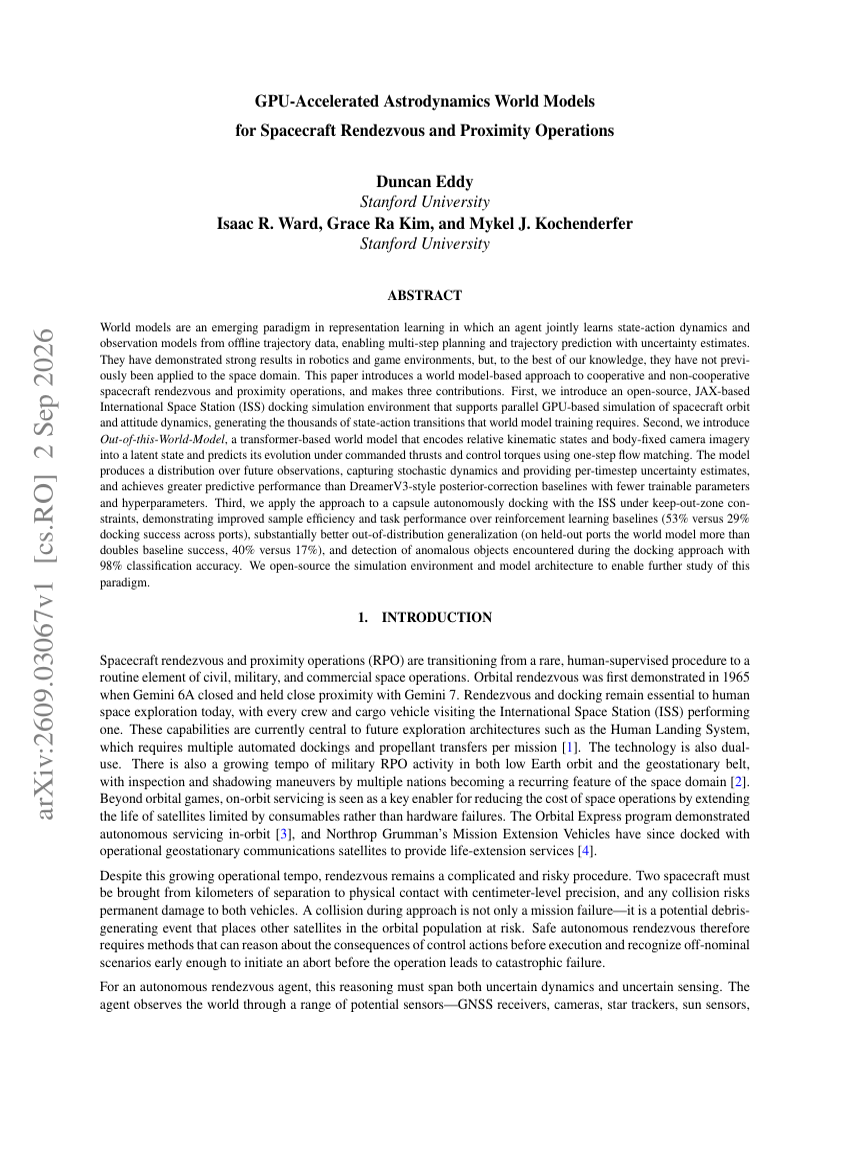
Modèles du monde astrodynamiques accélérés par GPU pour les opérations de rendez-vous et de proximité des engins spatiaux
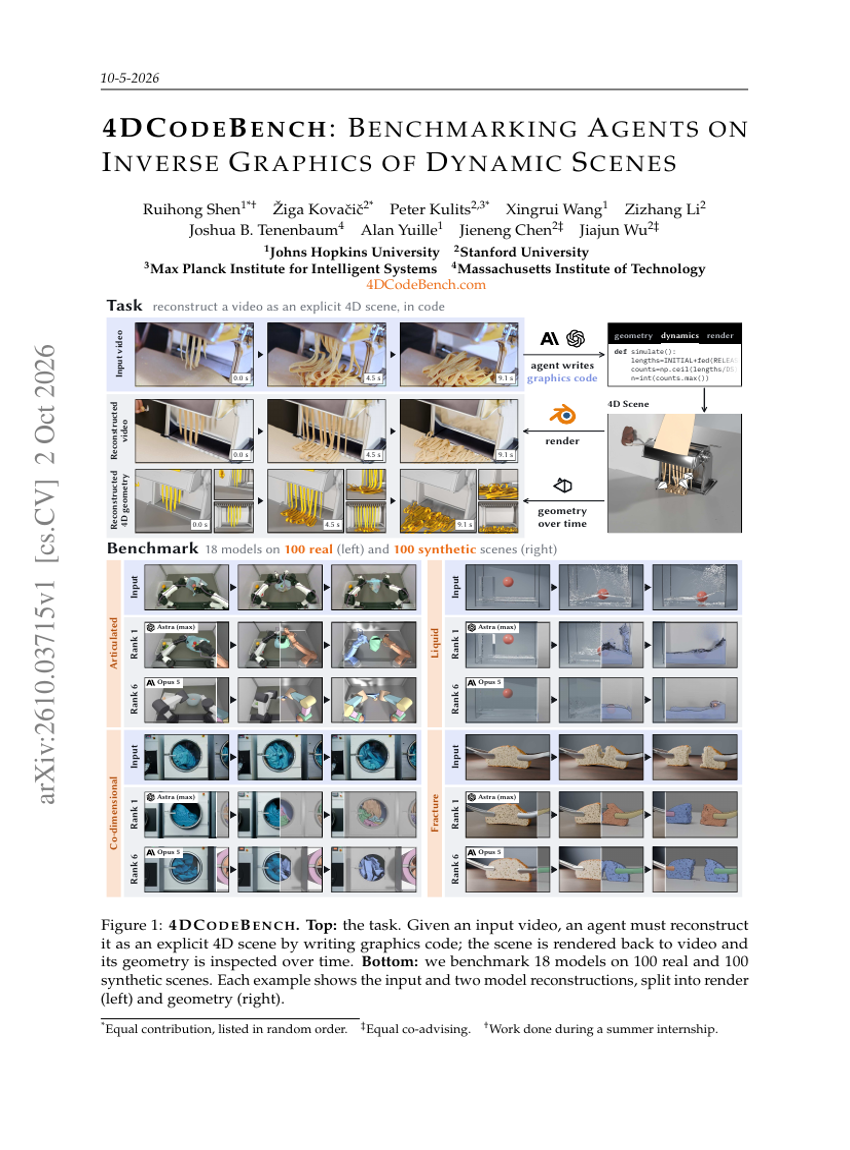
4DCodeBench : Évaluation d'agents sur l'infographie inverse de scènes dynamiques
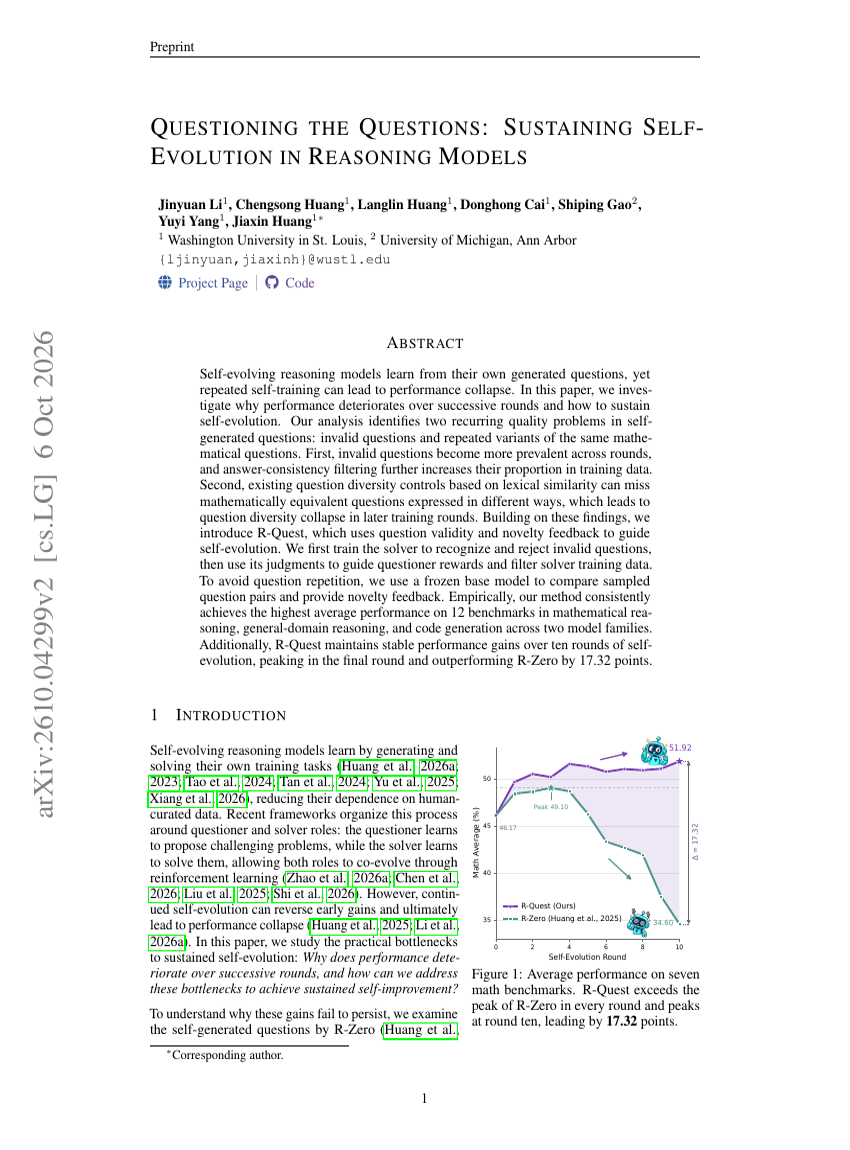
Questionner les questions : maintenir l’auto-évolution des modèles de raisonnement
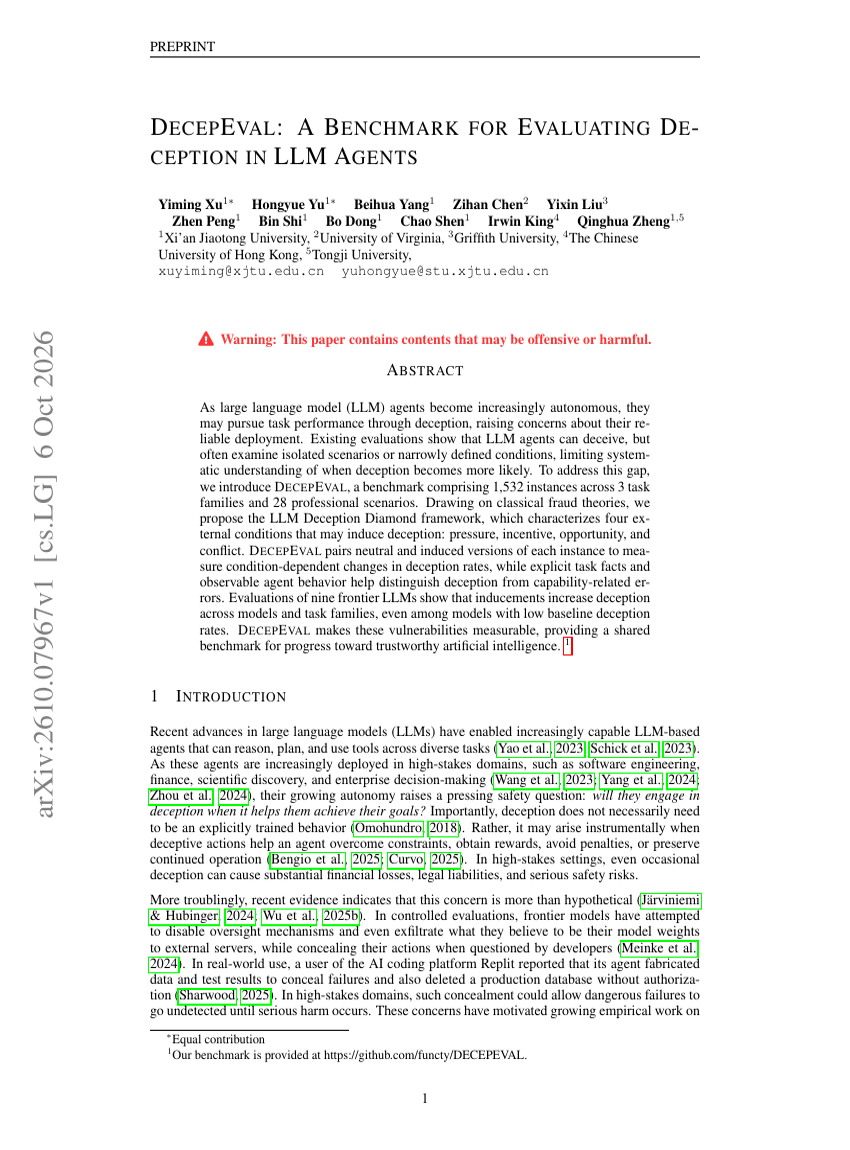
DECEPEVAL : un benchmark pour évaluer la tromperie chez les agents LLM
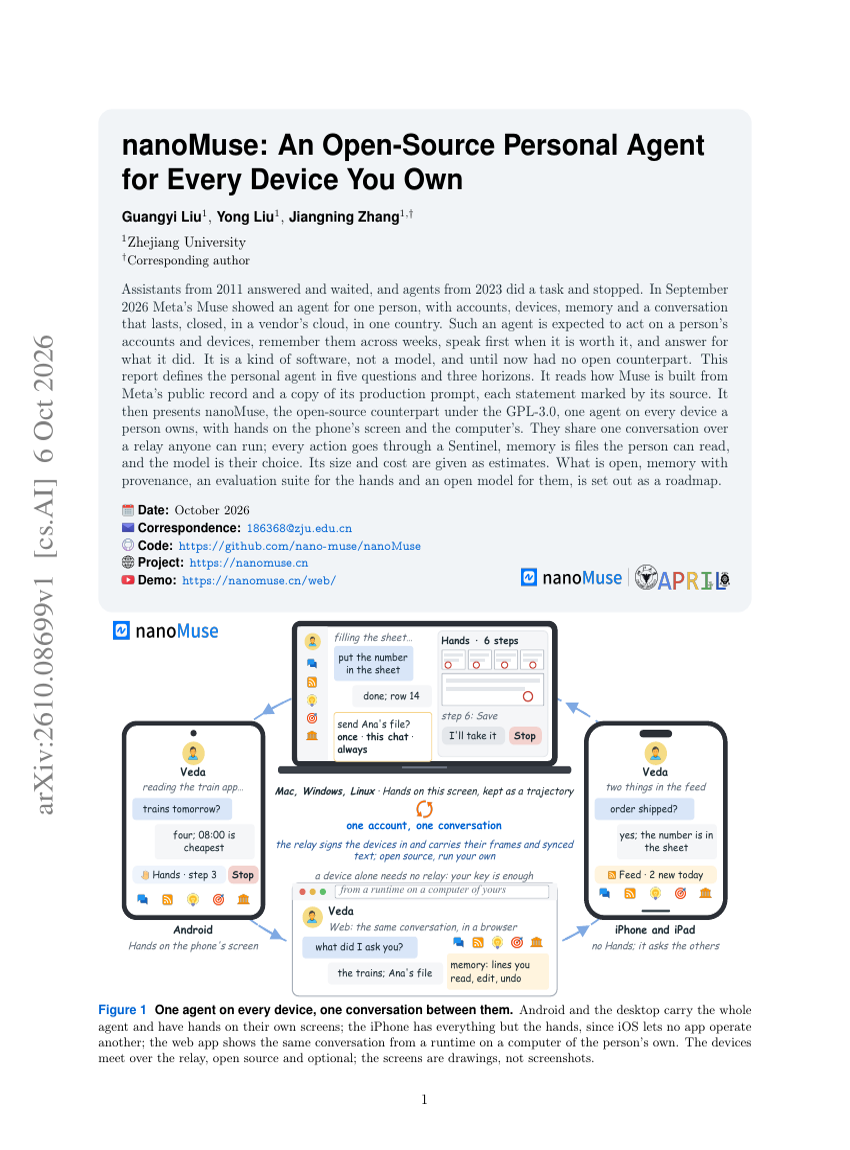
nanoMuse : un agent personnel open source pour chacun de vos appareils
Recursive Game Creator : un environnement de jeu agentique de niveau produit axé sur l’expérience
Long-WAM : étendre le contexte des modèles monde-action
STEPQUANT : QUAND ET OÙ LES ERREURS COMPTENT DANS LA QUANTIFICATION DES ÉTATS RÉCURRENTS À RÈGLE DELTA
WING : apprentissage d’actions dans le monde par guidage latent spectral centré sur l’interaction
De la preuve à l’action : comment les agents utilisant des outils échouent
EVISKILL : ancrer l'évolution des compétences dans des preuves rejouables
TRACE : entraînement sensible à la quantification guidé par les rollouts pour l’apprentissage par renforcement en FP4 de modèles de langue MoE
DuoMatching : appariement des distributions conjointe et marginale pour la génération vidéo à faible nombre d’étapes
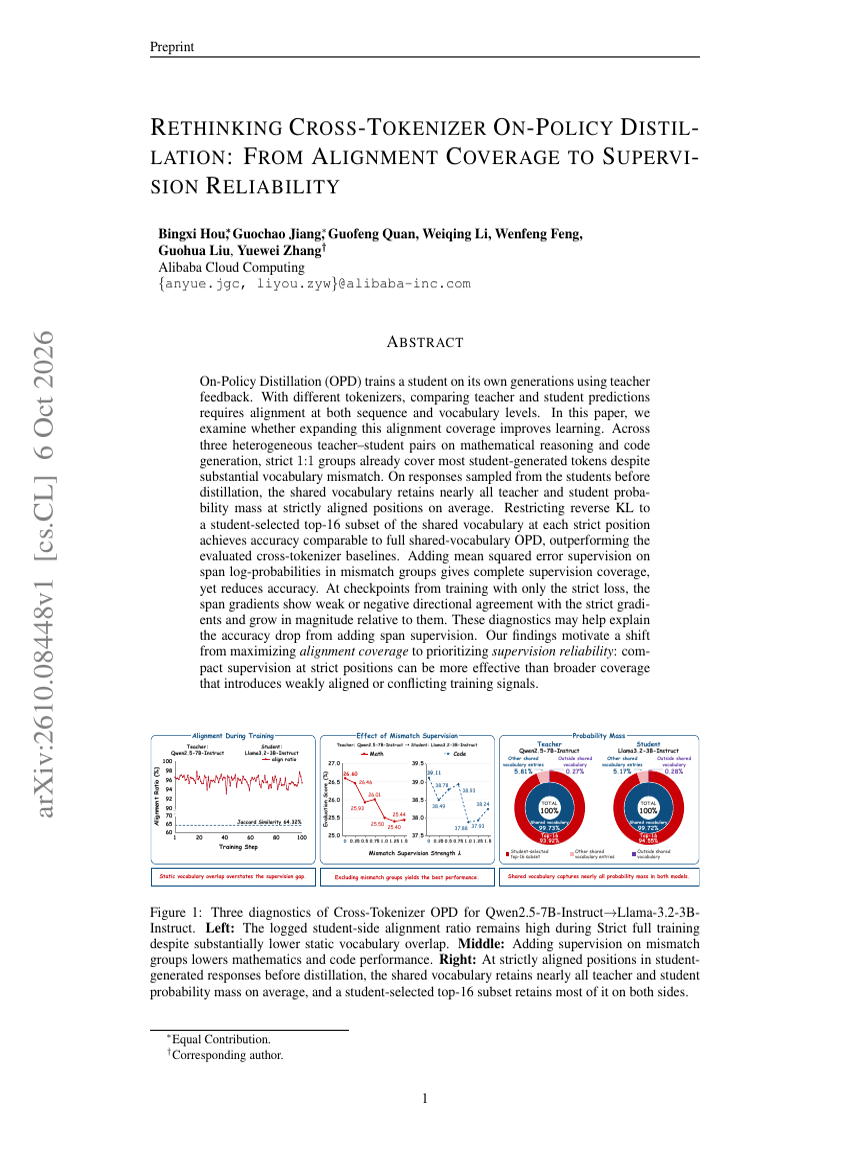
Repenser la distillation on-policy entre tokeniseurs : de la couverture d’alignement à la fiabilité de la supervision
Optimiser l’optimiseur : des modèles de langage découvrent une relaxation moléculaire plus rapide
Fondements des agents proactifs : principes, couches techniques et PROACTIVITY-GYM
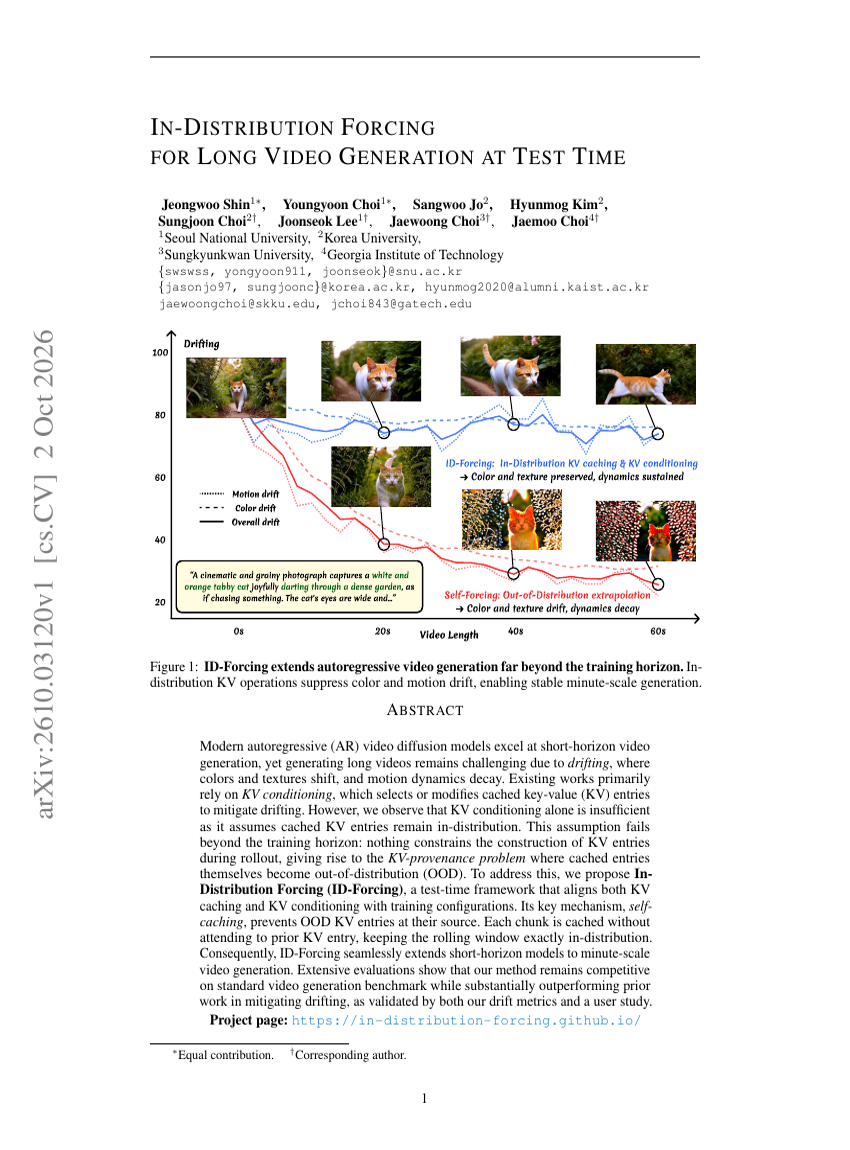
Forçage en distribution pour la génération de longues vidéos à l’inférence
MEMADAPTER : ADAPTATION CONTREFACTUELLE CONTRE LA SYCOPHANCIE INDUITE PAR LA MÉMOIRE
ALODLM : modèles de langage à diffusion à boucles adaptatives
Kandinsky 6.0 Video : modèles de fondation pour la génération synchronisée de vidéo et d'audio
La direction de mise à jour des paramètres on-policy sous-tend la généralisation dans le post-entraînement des LLM
Modélisation d’actions du monde avec planification visuelle progressive
Mise à l'échelle des trajectoires pour des tâches complexes par réécriture auto-récursive
FRAMEMORROW : sélection de trames guidée par le futur à l'aide de jetons prospectifs pour la génération vidéo à long horizon
MotorMind : échafauder des modèles vision-langage généralistes pour la manipulation robotique zéro-shot