HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
Briser le raccourci vision–action : entraînement par interface latente pour des modèles de fondation robotiques généralisables
Feyospace-v1 : Comment les Cyber Mercury Seven ont entraîné des modèles cybernétiques de pointe


X-AuT : compression progressive de l'encodeur audio pour les grands modèles de langage vocaux par distillation inter-échelle
Mi-Ripple : Restauration d'images dégradées par l'édition itérative par IA
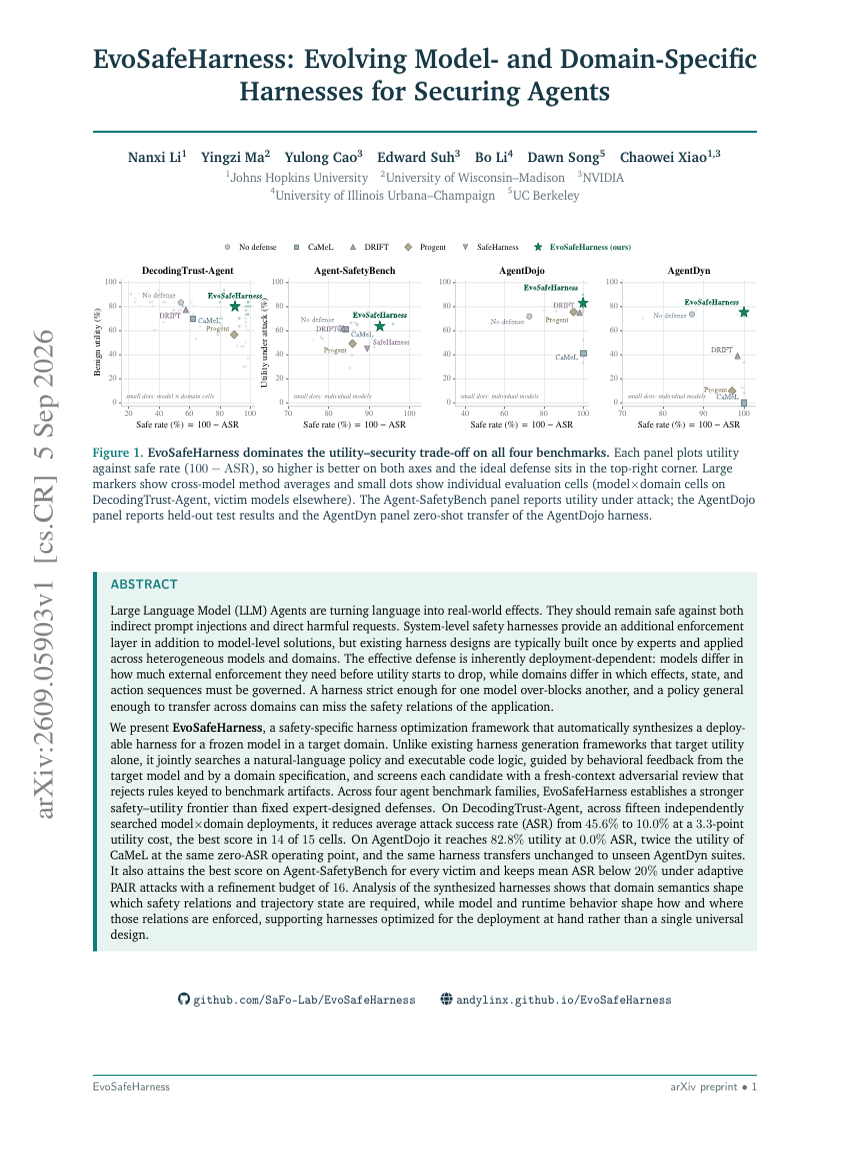
EvoSafeHarness : Évolution de harnais de sécurité spécifiques au modèle et au domaine pour sécuriser les agents
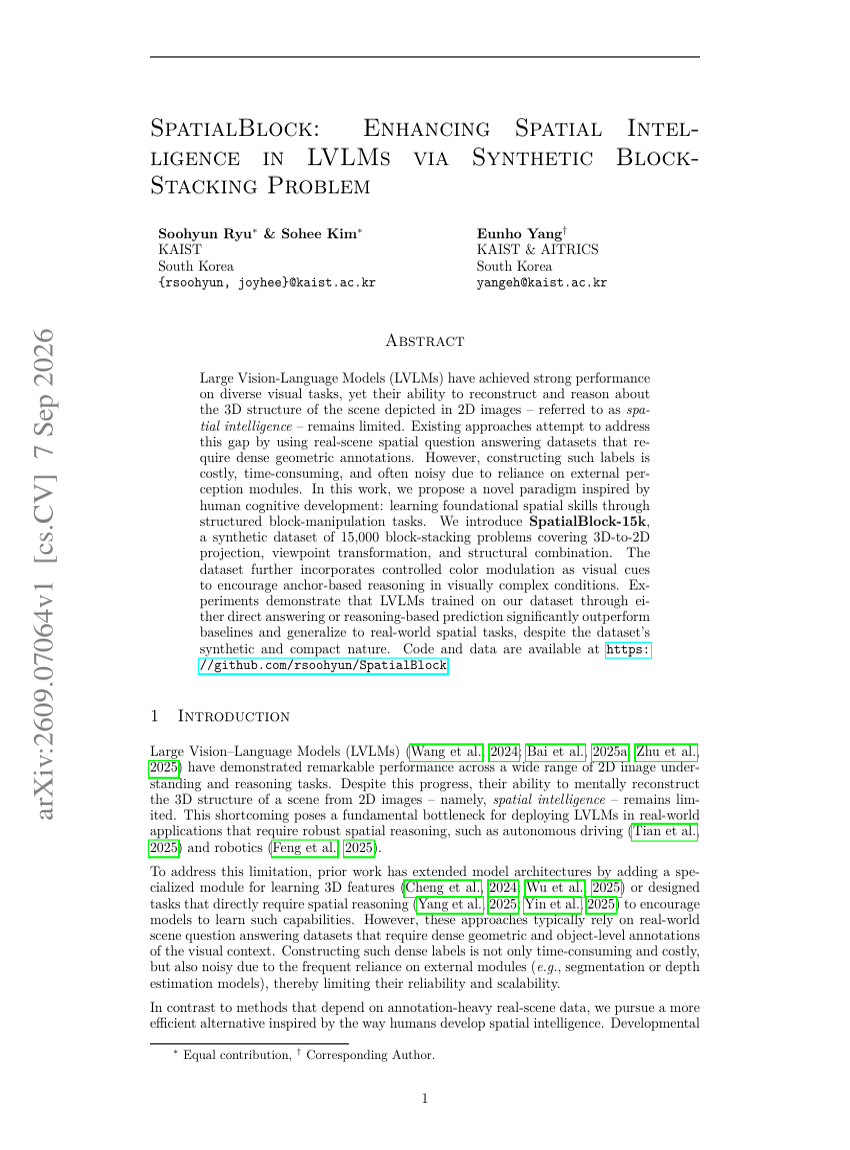
SpatialBlock : Améliorer l'intelligence spatiale des grands modèles vision-langage par un problème synthétique d'empilement de blocs
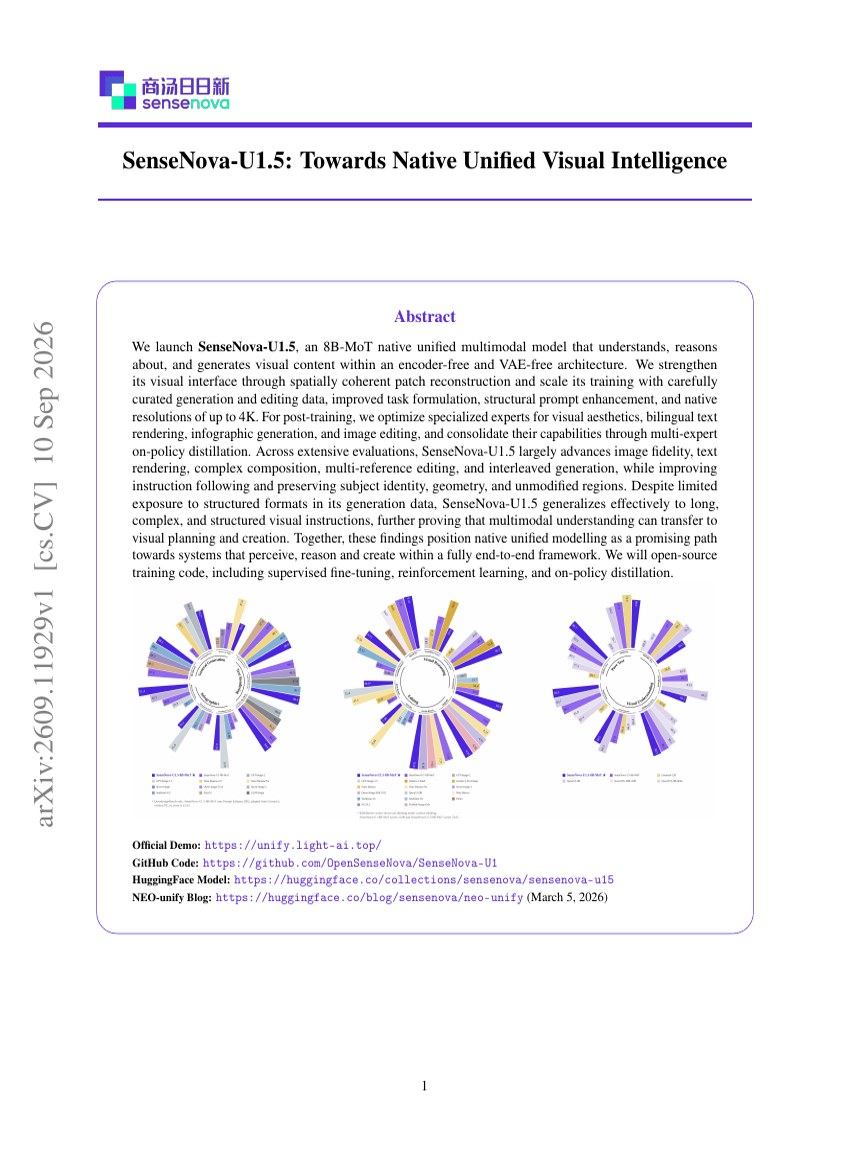
SenseNova-U1.5 : vers une intelligence visuelle unifiée native
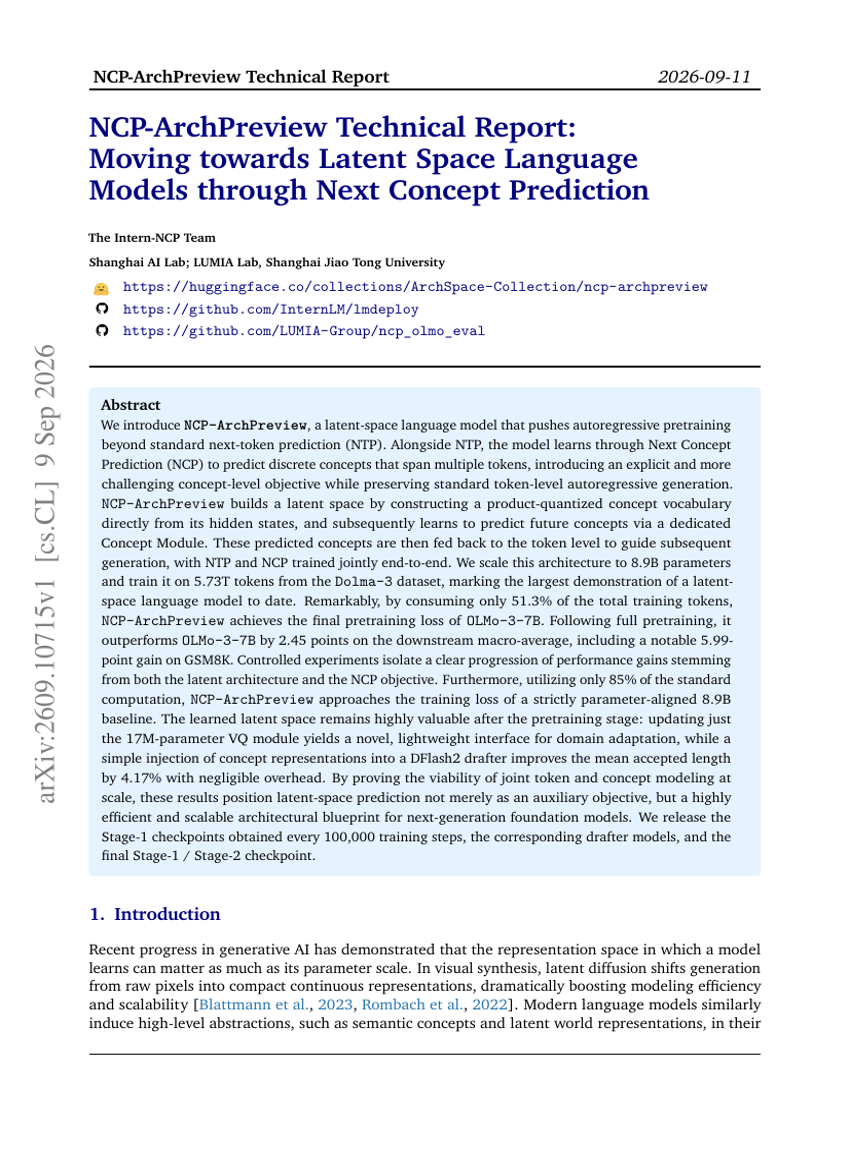
Rapport technique NCP-ArchPreview : Vers des modèles de langage à espace latent par la prédiction du concept suivant
SAESCIENTIST-BENCH : LES AGENTS IA PEUVENT-ILS MENER UNE RECHERCHE AUTONOME EN INTERPRÉTABILITÉ PAR SAE ?
SWE-Bench Pro Verified : un benchmark fiable pour les agents de génie logiciel
WearableQA : un banc d'essai pour le raisonnement en santé à partir de données réelles issues de dispositifs portables
AgentGrad : Optimisation des invites guidée par intervention pour les systèmes multi-agents
Modèle de monde programmable
Show-Harness : un simple agent VLM peut piloter des robots
Le Dernier Benchmark de Traduction
Vero : une recette open source d'apprentissage par renforcement pour le raisonnement visuel général
Science et technologie des données vers l'AGI, partie I : gestion des données à plusieurs niveaux
APEX–Agents
TERMINAL-BENCH : ÉVALUATION DES AGENTS SUR DES TÂCHES DIFFICILES ET RÉALISTES DANS DES INTERFACES EN LIGNE DE COMMANDE
Orca : Apprentissage progressif à partir de traces d'explication complexes de GPT-4
Rapport technique de l'agent d'interaction Omni
Rapport technique AuK : un modèle fondation open-source pour la génération et l'édition de la parole
Susciter une généralisation faible-à-forte par distillation inverse sur politique
NeoHorse-1 : Vers une auto-amélioration récursive via le post-entraînement agentique avec harnais d'acheminement
OpenWAM : une exploration ouverte et modulaire vers le pré-entraînement systématique de modèles monde-action
DriveZero : Conduite de bout en bout au-delà des démonstrations humaines
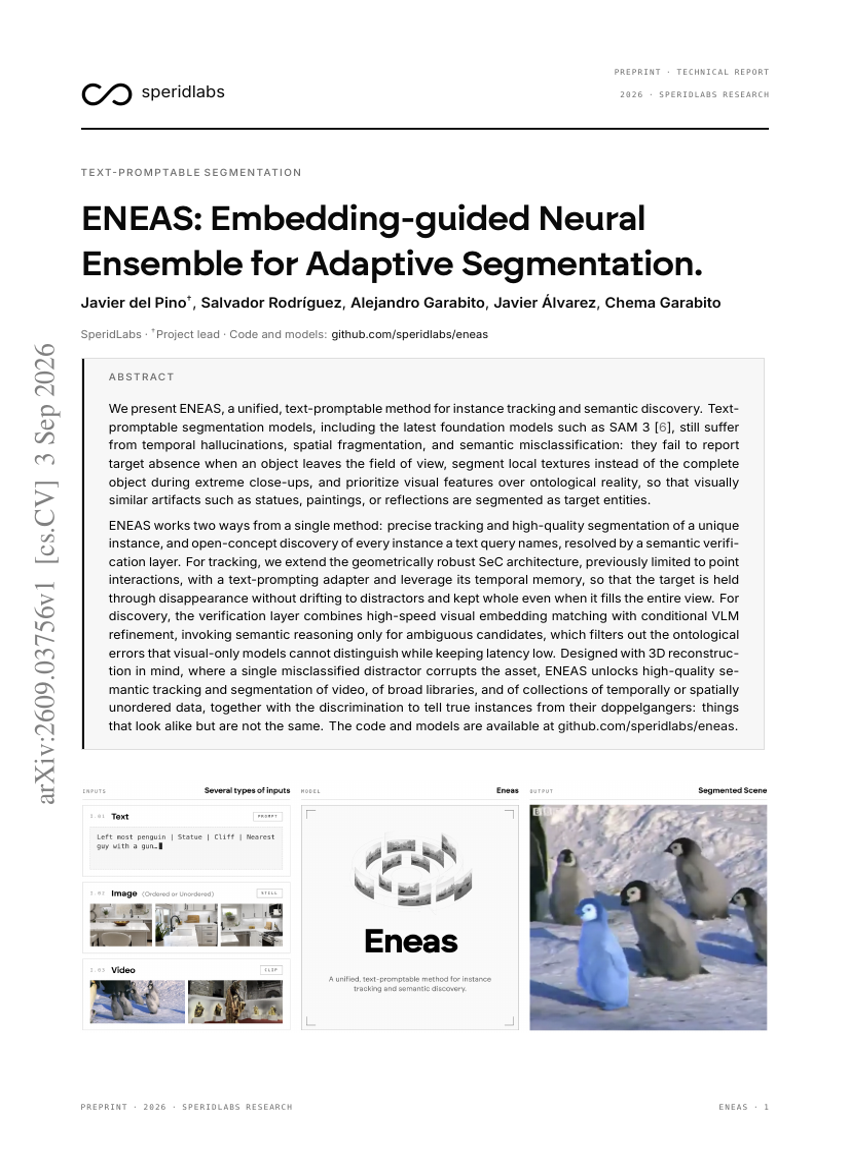
ENEAS : Ensemble neuronal guidé par embeddings pour la segmentation adaptative.
FlowBalance : auto-amélioration ancrée sur un vérificateur à partir d'une expérience de raisonnement on-policy
Modèles de fondation causaux
EmbodiedSkills : un cadre unifié pour orchestrer, entraîner et déployer des agents VLA
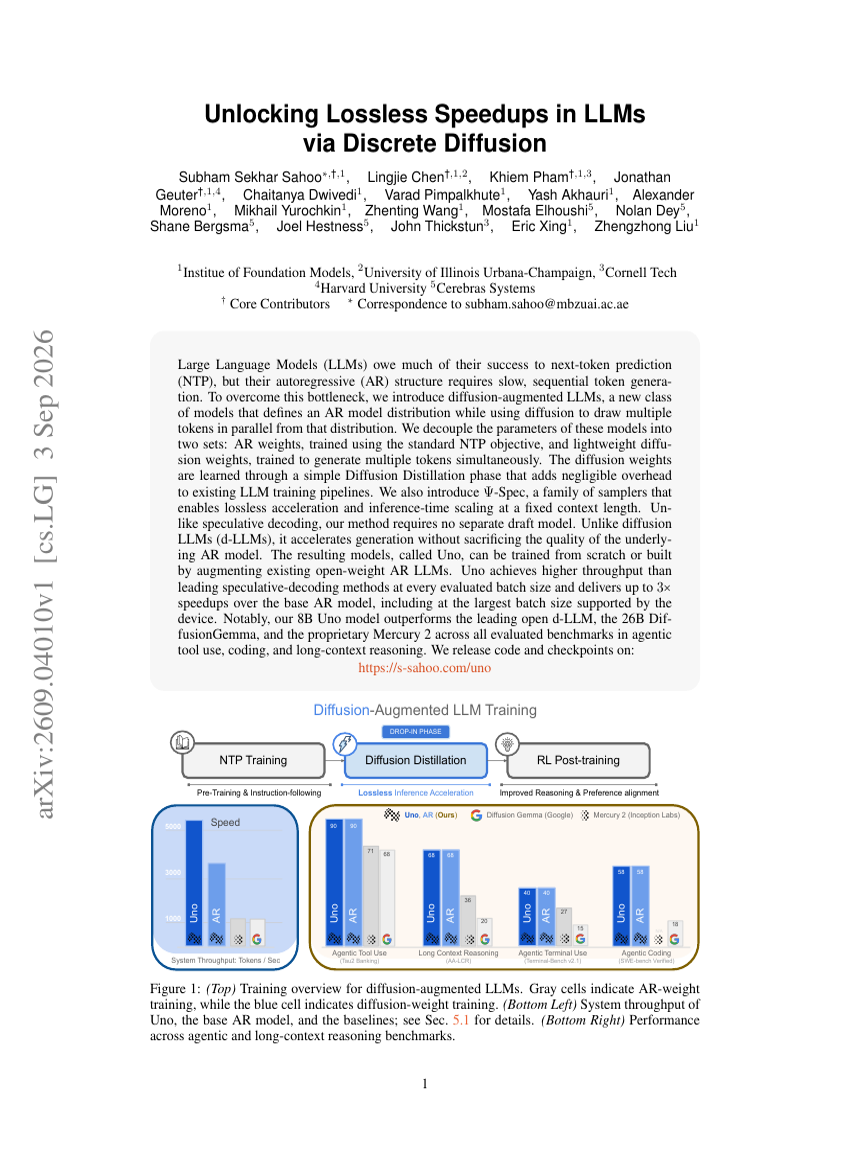
Déverrouiller des accélérations sans perte dans les LLM via la diffusion discrète
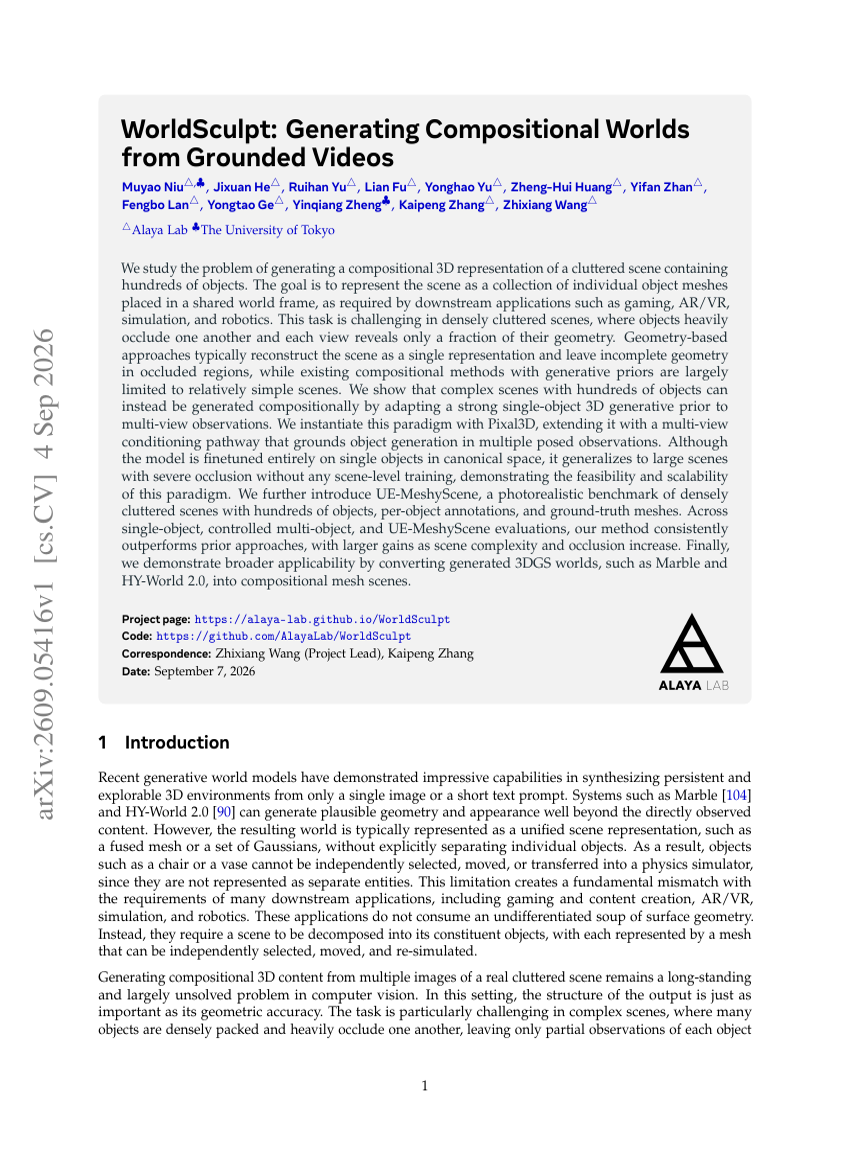
WorldSculpt : Génération de mondes compositionnels à partir de vidéos ancrées