HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
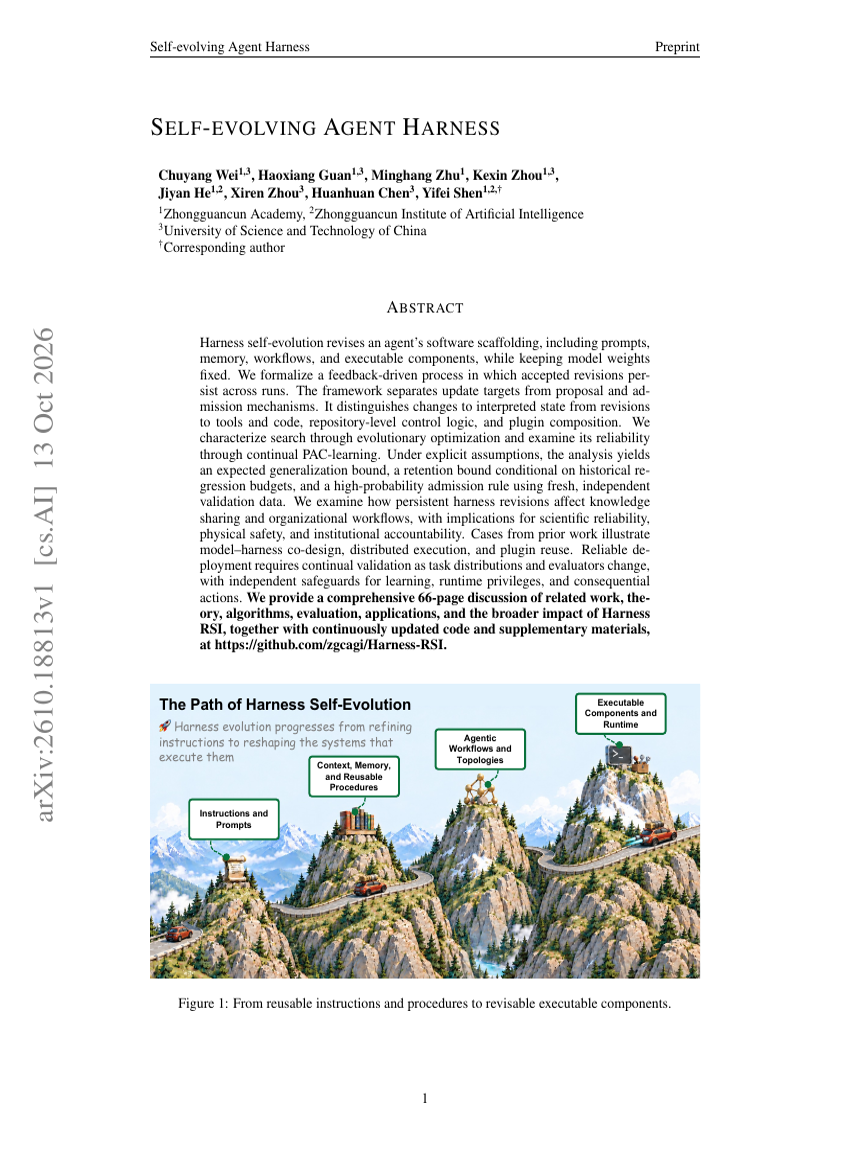
Harnais d’agent auto-évolutif
RoTA-Bench : évaluer le raisonnement spatial 3D par alignement interactif de projections
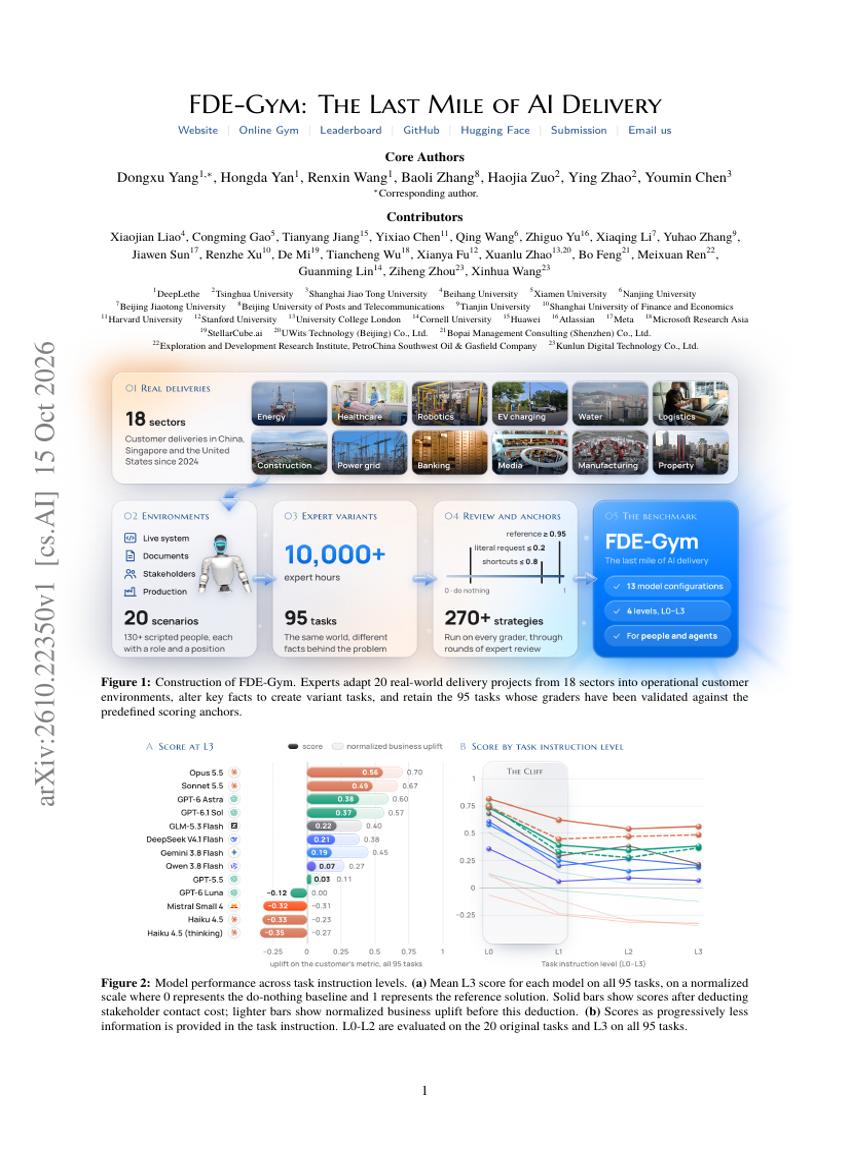
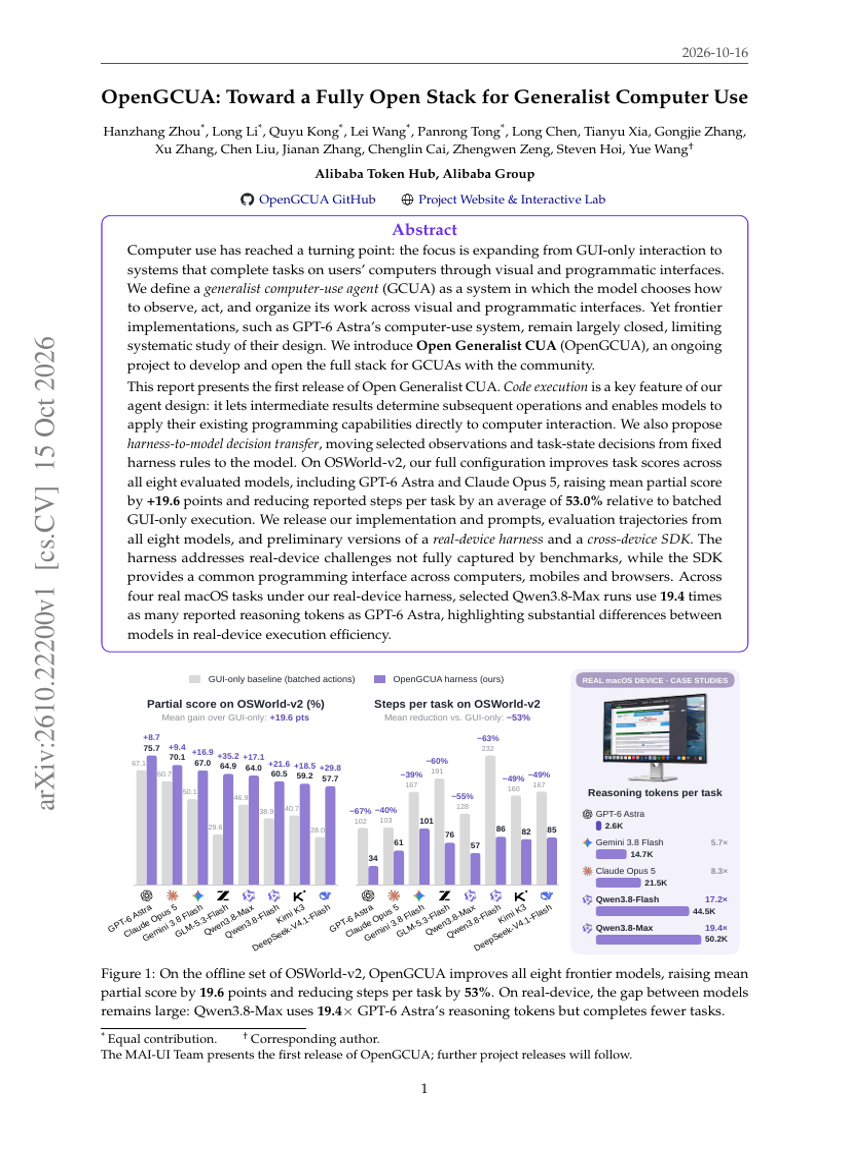
FDE-Gym : le dernier kilomètre de la livraison de l’IA
OpenGCUA : vers une pile entièrement ouverte pour l'utilisation généraliste de l'ordinateur
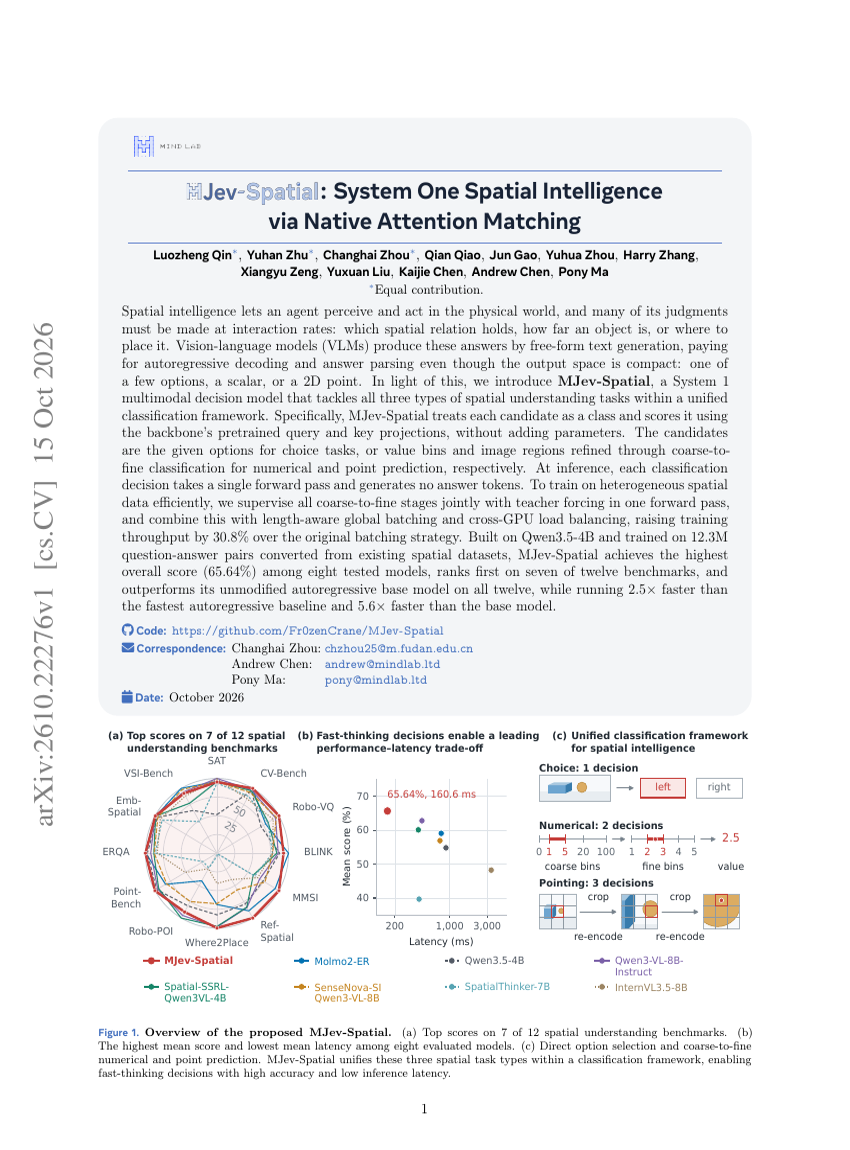
MJev-Spatial : intelligence spatiale de Système 1 par appariement natif d’attention
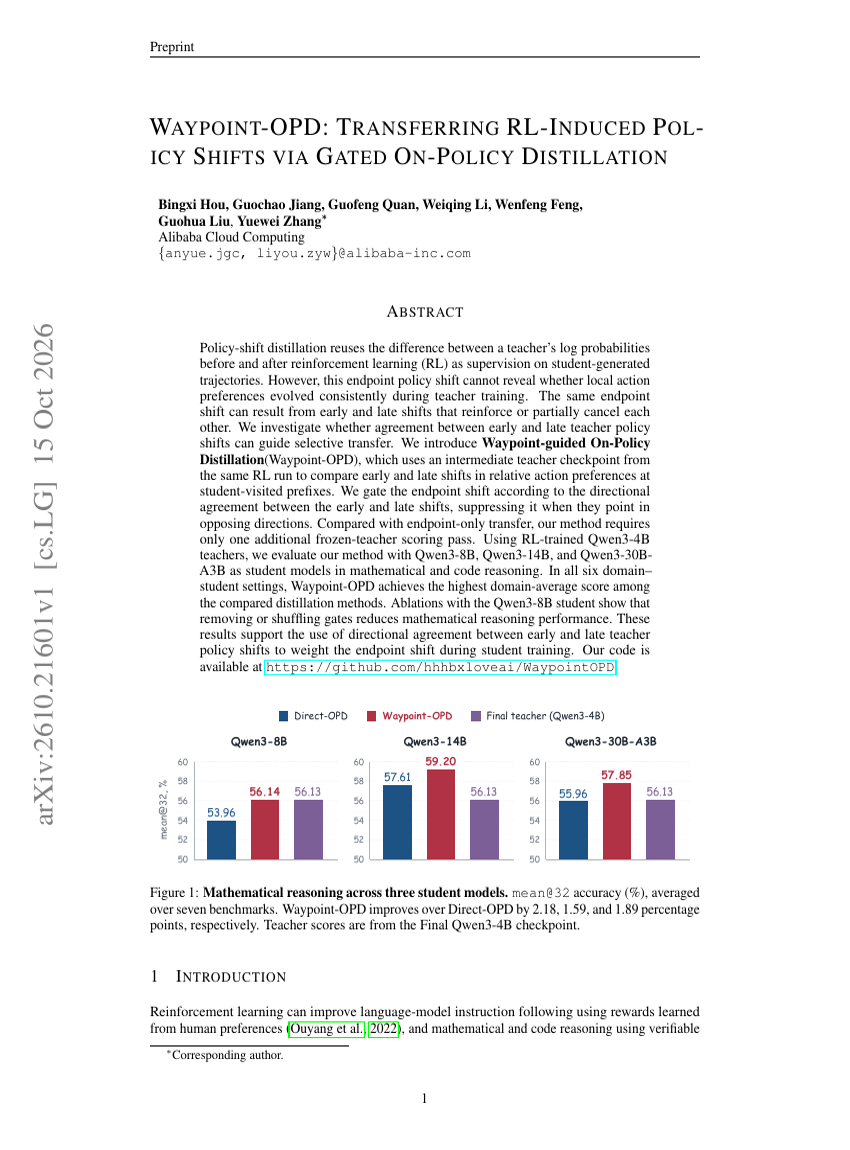
WAYPOINT-OPD : TRANSFERT DES DÉCALAGES DE POLITIQUE INDUITS PAR L’APPRENTISSAGE PAR RENFORCEMENT VIA UNE DISTILLATION ON-POLICY À PORTES
RAPPORT D'ENTRAÎNEMENT DE TELECHAT3-MOE
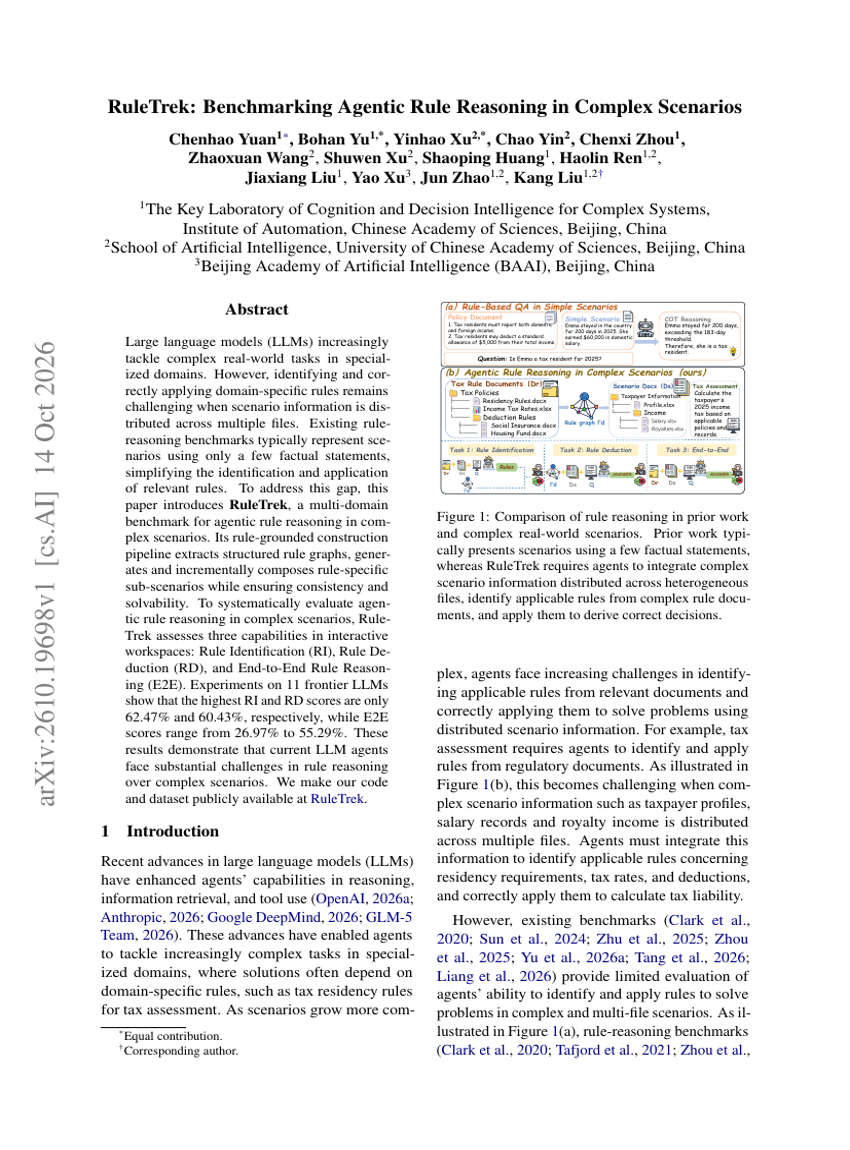
RuleTrek : Évaluation comparative du raisonnement agentique par règles dans des scénarios complexes
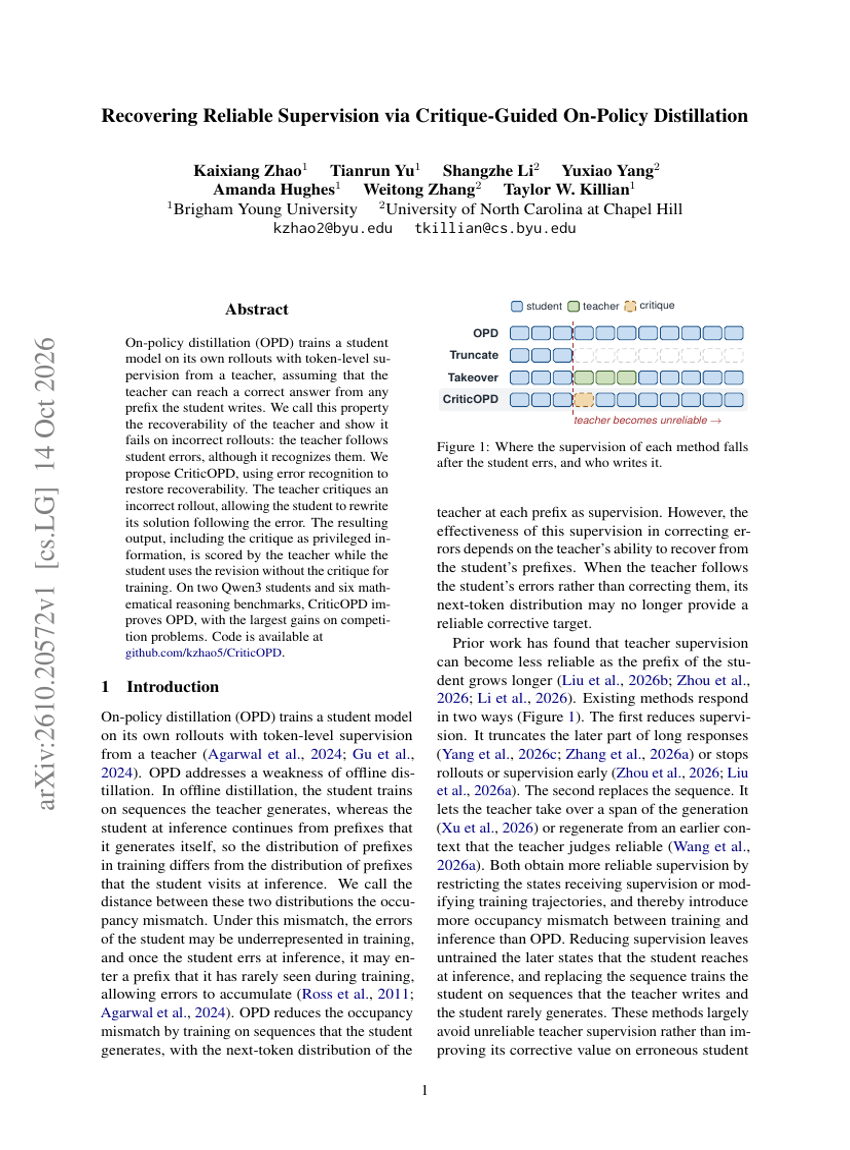
Récupérer une supervision fiable via une distillation on-policy guidée par la critique
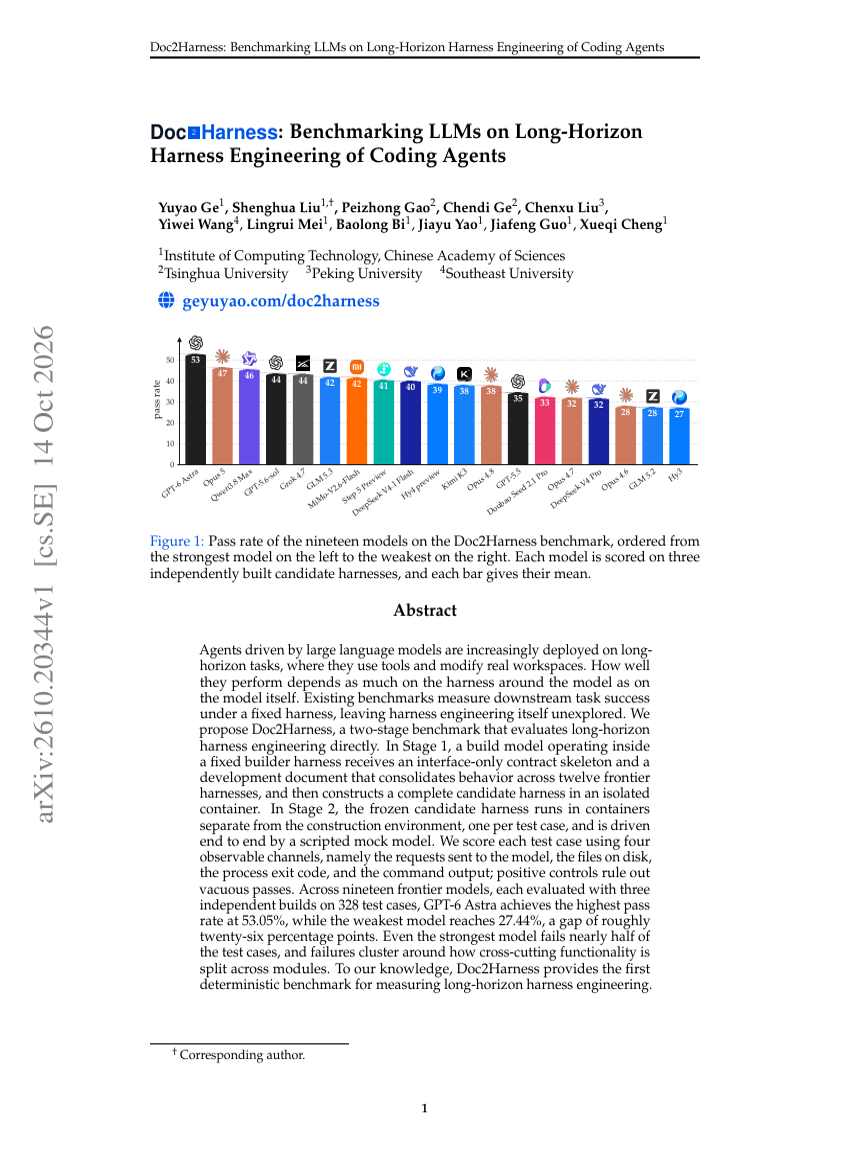
Doc 2 Harness : évaluation comparative des LLM sur l’ingénierie de harnais à long horizon des agents de codage
Au-delà de la supervision routée par domaine : garde inter-enseignants pour la distillation on-policy multi-enseignants
PLAYER-1 : apprendre à jouer à partir d’expérience synthétique
Any Time, Any Space : un cadre centré sur l'état du monde pour la génération vidéo agentique
AesCode : génération de code esthétique à l’aide de récompenses intermodales découplées
GreenWAM : un modèle de fondation du monde pour la robotique
Urbex : ancrage spatial agentique pour des scènes 3D à l’échelle urbaine
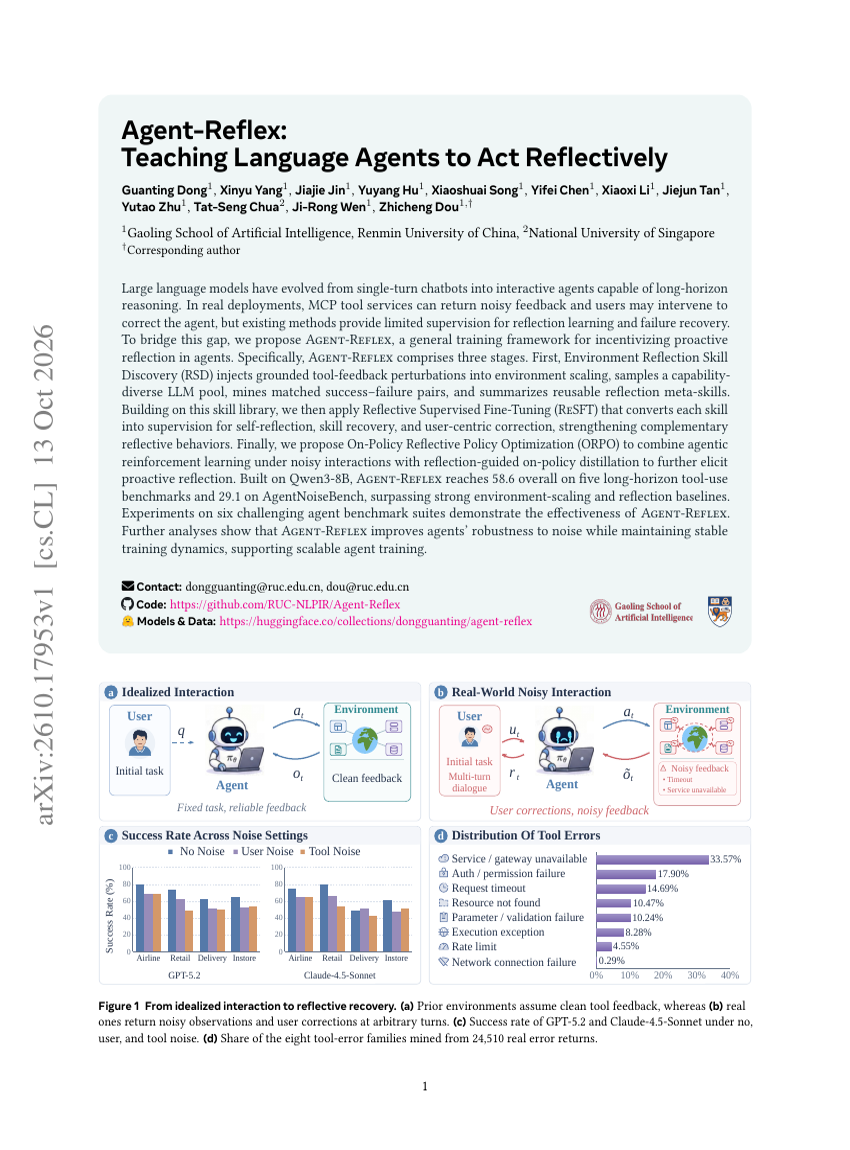
Agent-Reflex : apprendre aux agents langagiers à agir de manière réflexive
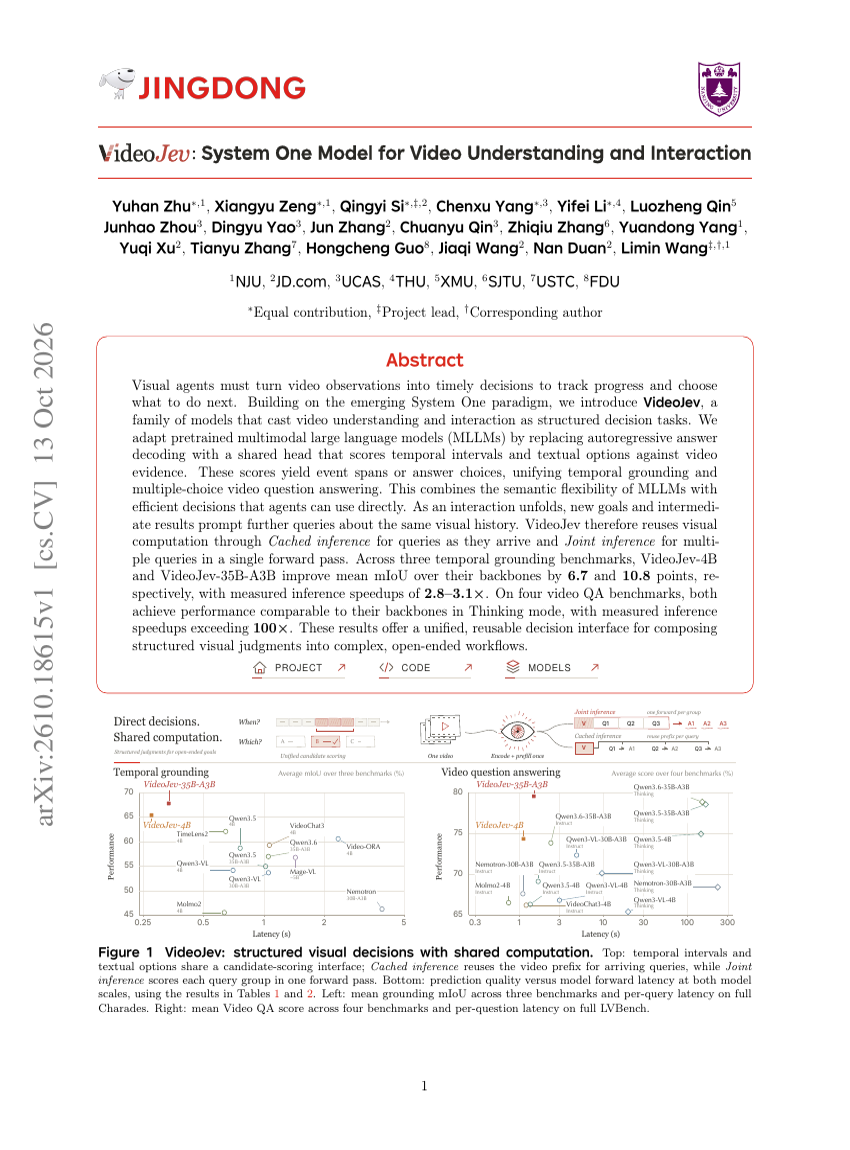
VideoJev : un modèle System One pour la compréhension et l’interaction vidéo
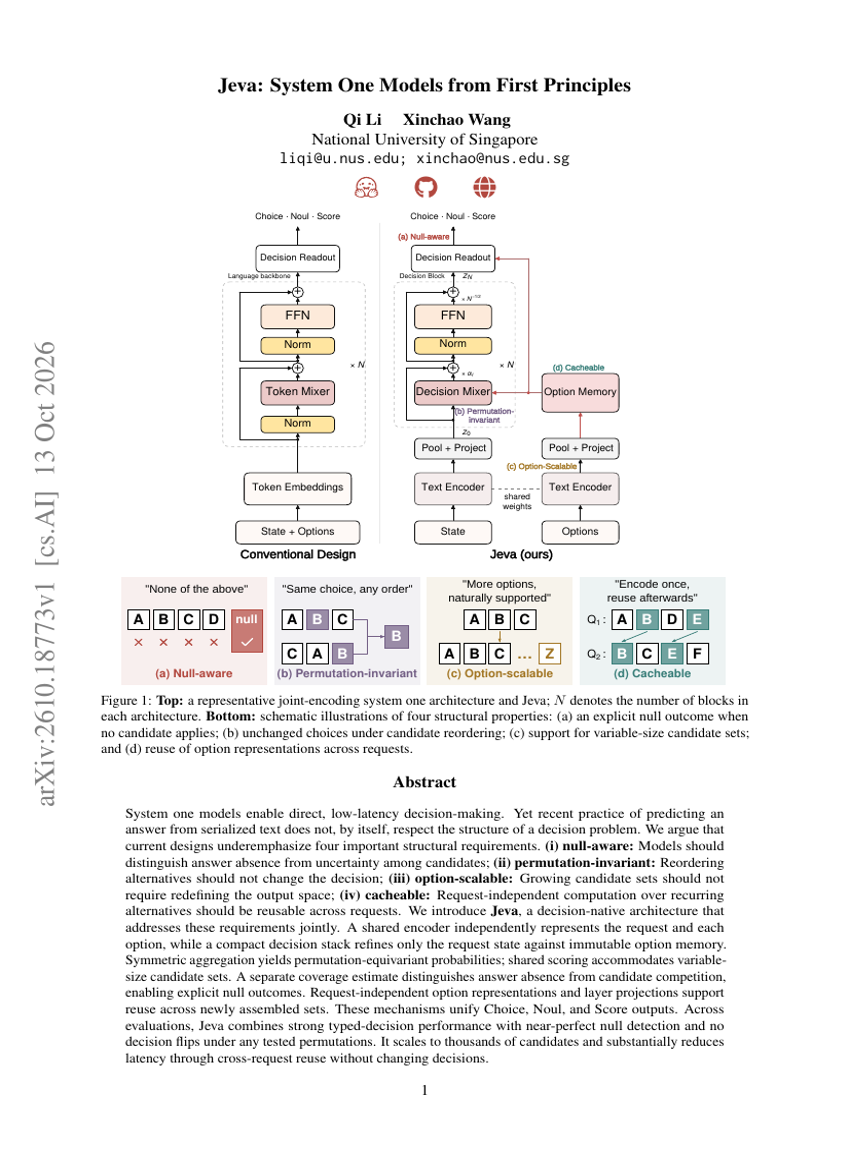
Jeva : des modèles System One fondés sur les premiers principes
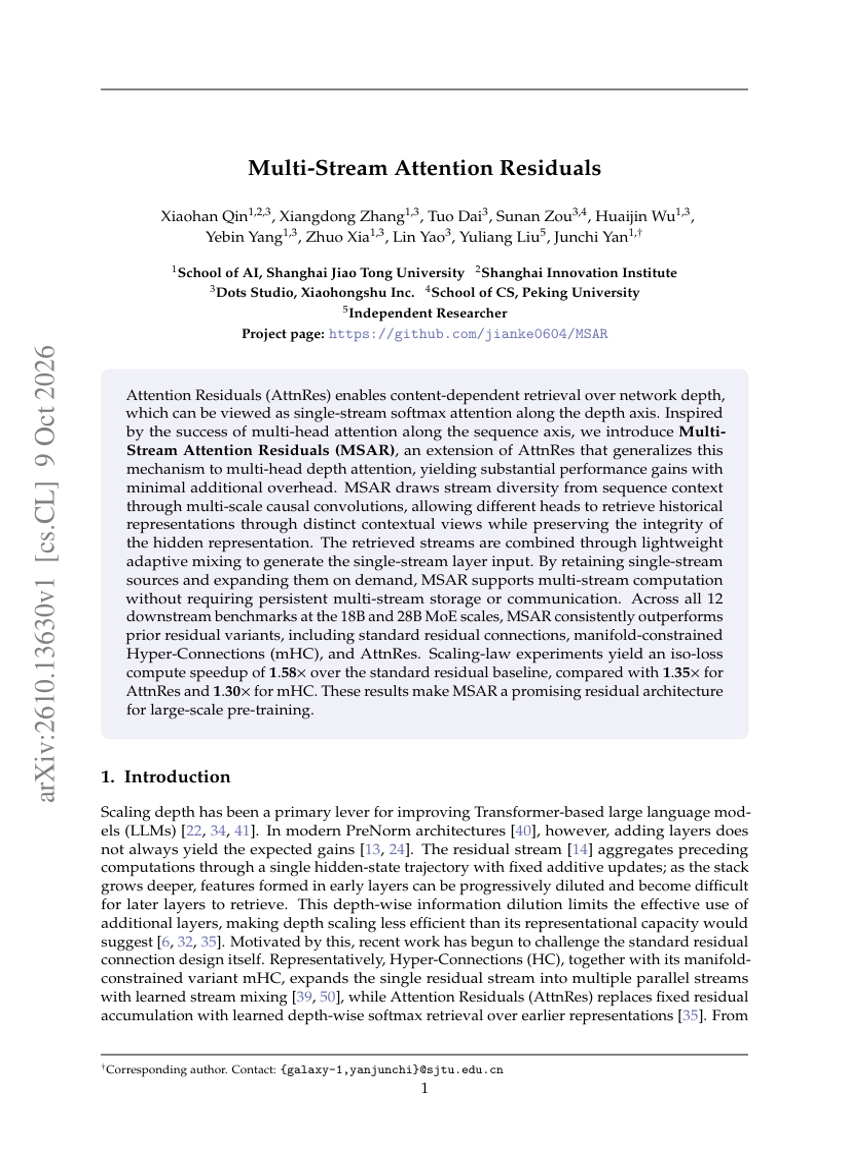
Résidus d’attention multi-flux (Multi-Stream Attention Residuals)
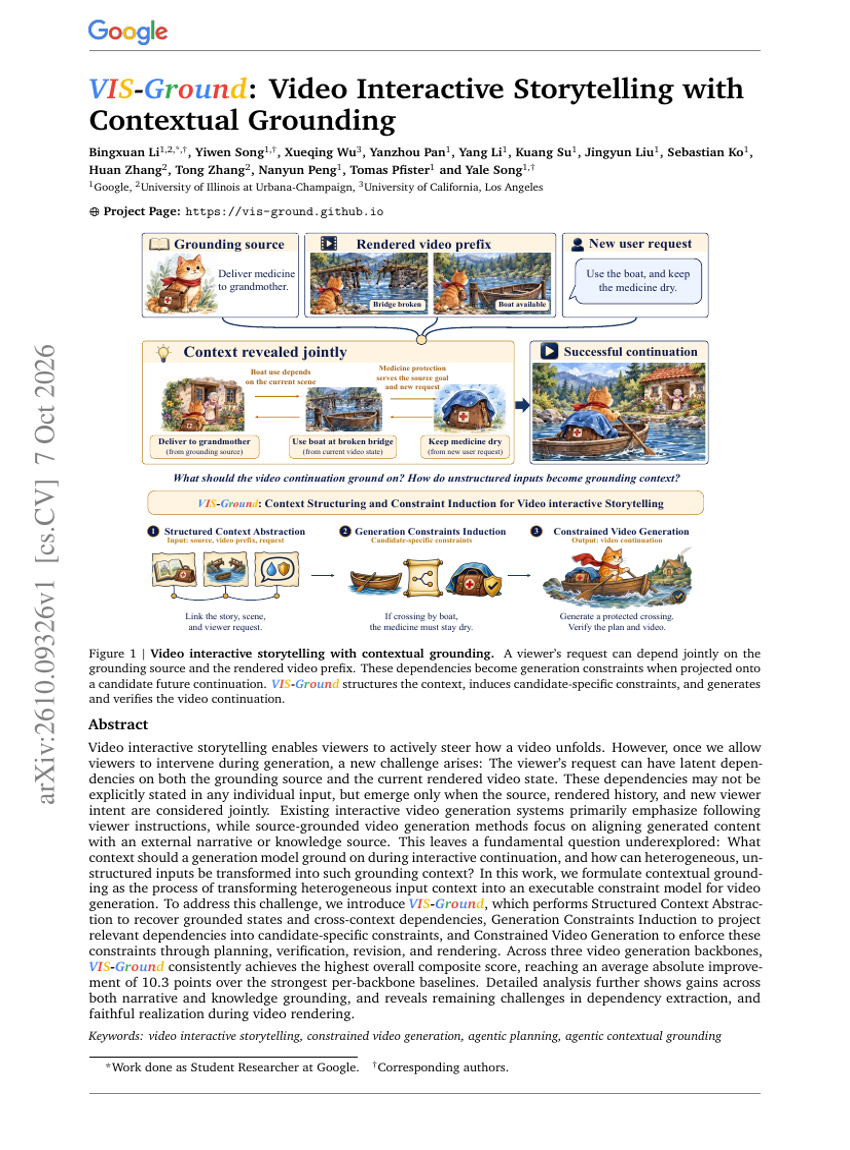
VIS-Ground : narration vidéo interactive avec ancrage contextuel
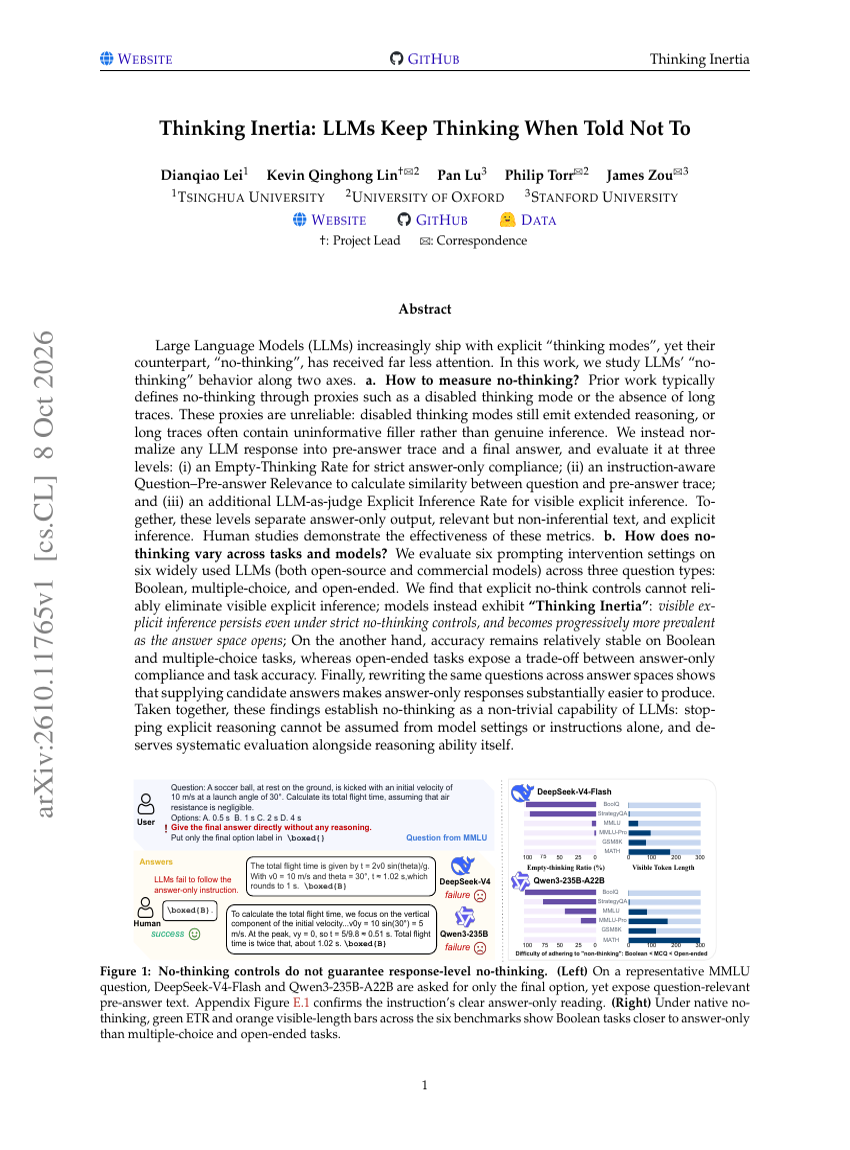
Inertie de la pensée : les LLM continuent de raisonner lorsqu’on leur demande de ne pas le faire
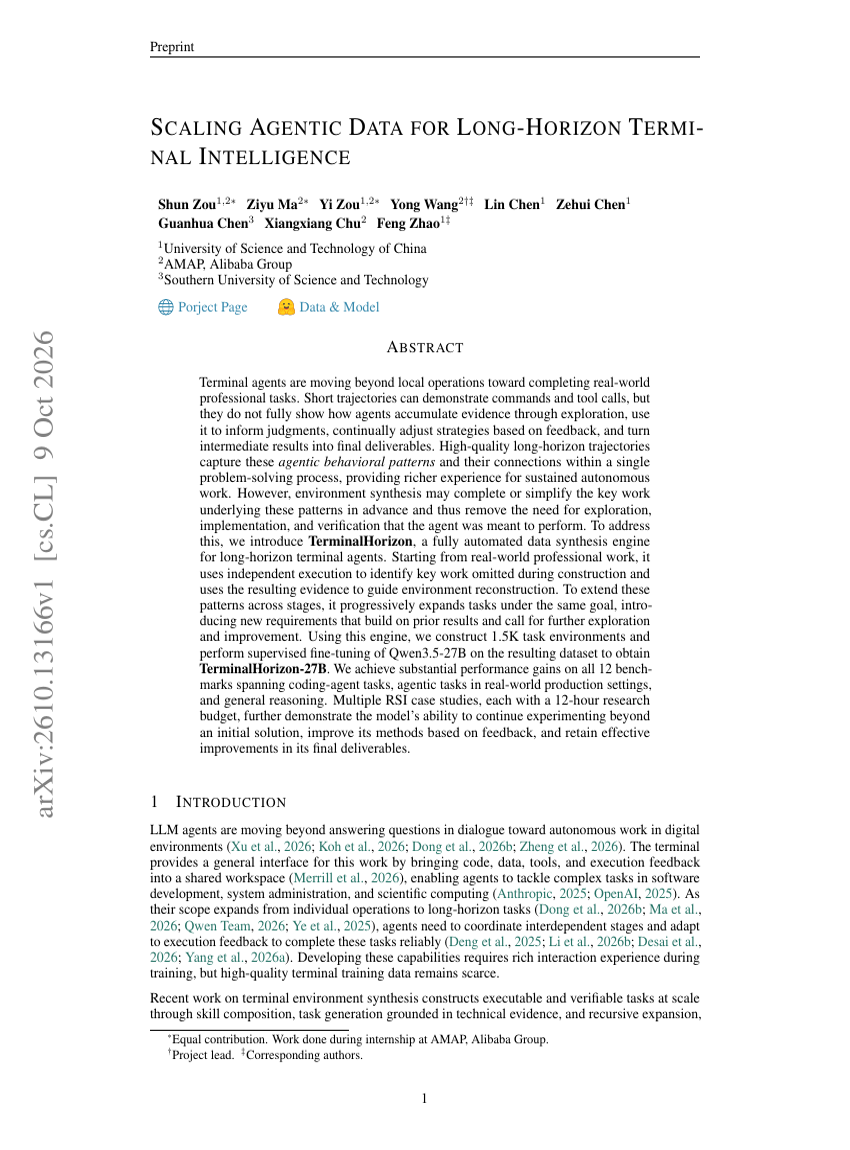
Mise à l’échelle des données agentiques pour l’intelligence terminale à long horizon
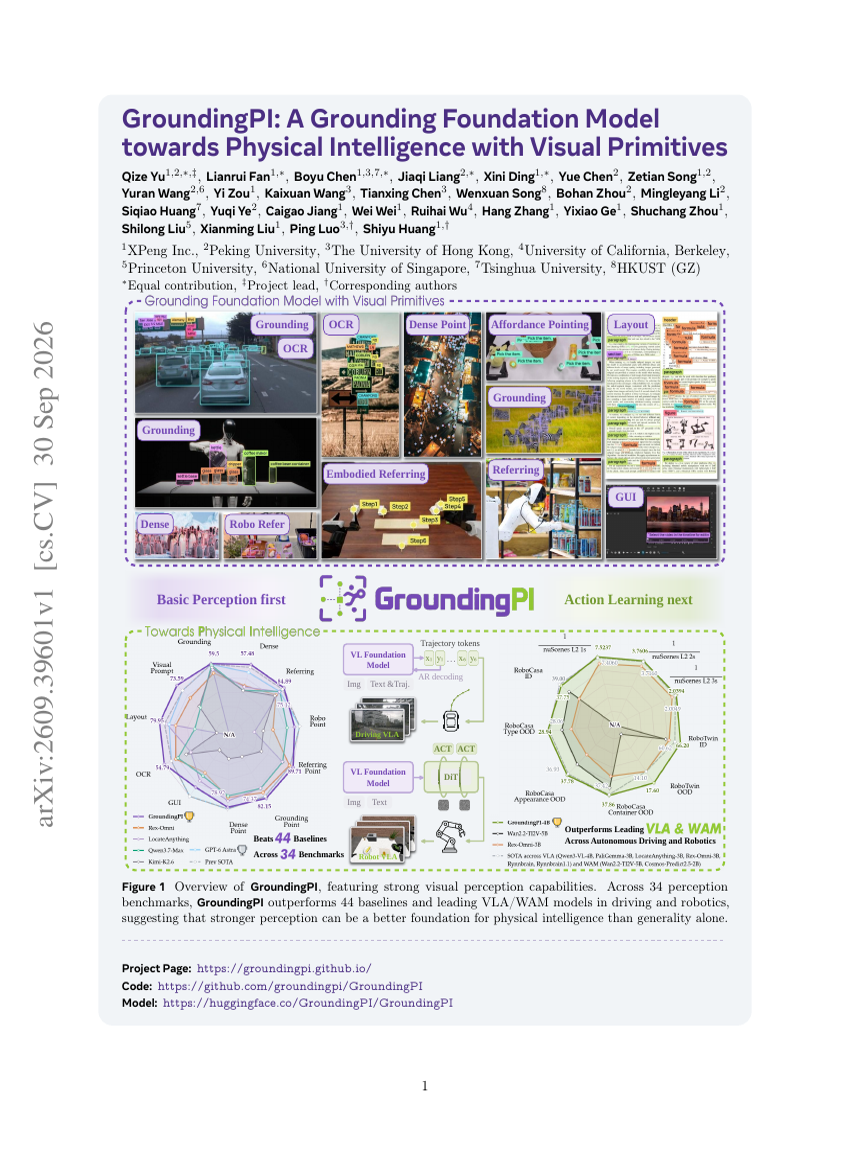
GroundingPI : un modèle de fondation d’ancrage vers l’intelligence physique avec des primitives visuelles
AgentSWE : les agents de codage peuvent-ils construire l’agent que vous voulez réellement ?
VISIONWEAVE : TISSER DES REPRÉSENTATIONS VISUELLES ÉLASTIQUES EN TANT QUE CAPACITÉ NATIVE DES MLLM
EmbodiedCLBench : évaluation de l’apprentissage continu pour des agents incarnés auto-évolutifs
SOFTWAREGYM : MISE À L'ÉCHELLE DE L'ENTRAÎNEMENT DES AGENTS D'UTILISATION D'ORDINATEUR À L'AIDE D'ENVIRONNEMENTS LOGICIELS SYNTHÉTISÉS DIVERSIFIÉS
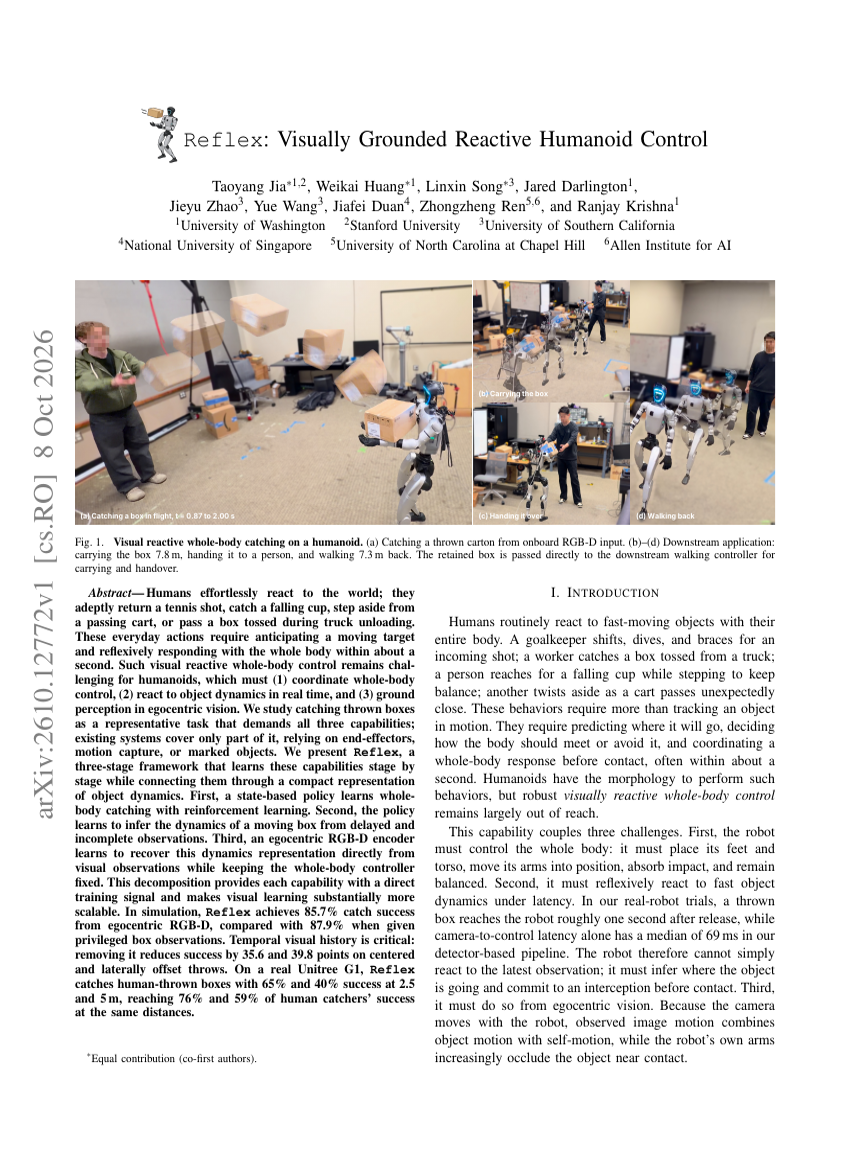
Reflex
S-Space : explorer l’espace de travail spatial dans les modèles de langage multimodaux
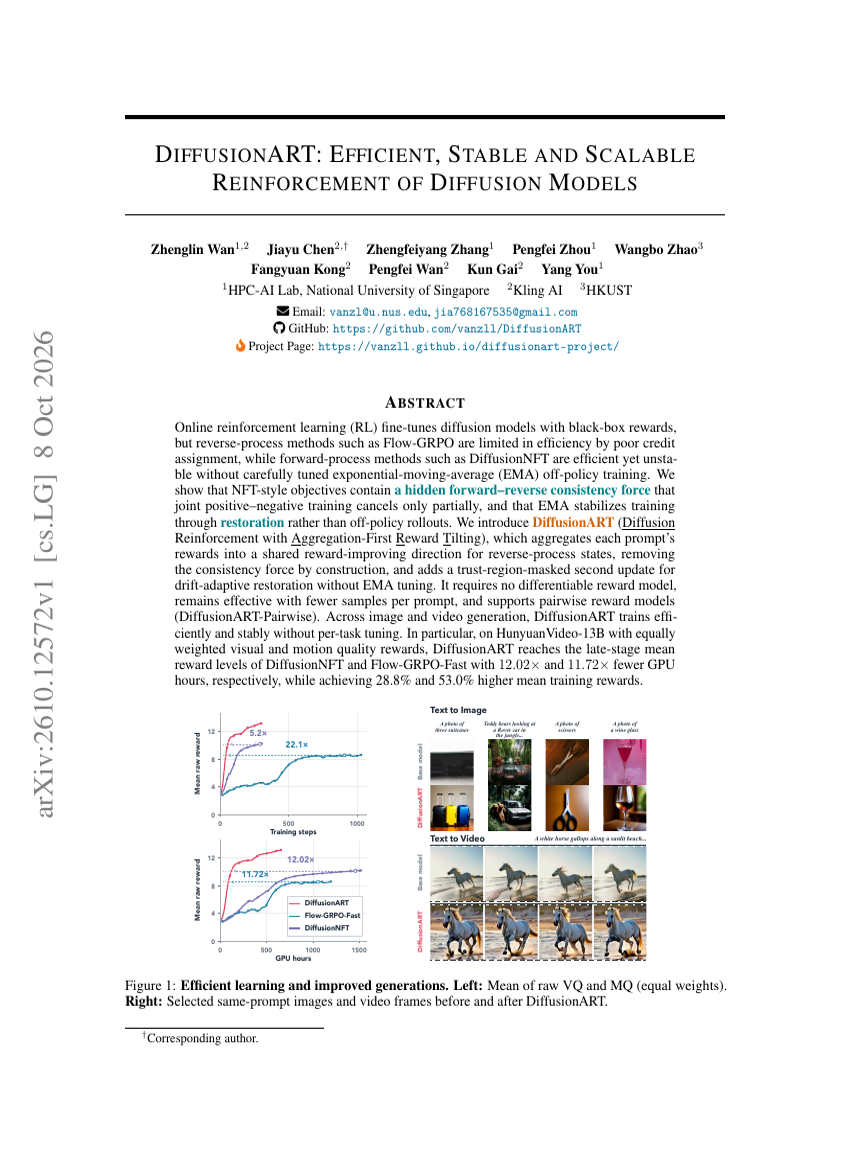
DIFFUSIONART : renforcement efficace, stable et à grande échelle des modèles de diffusion
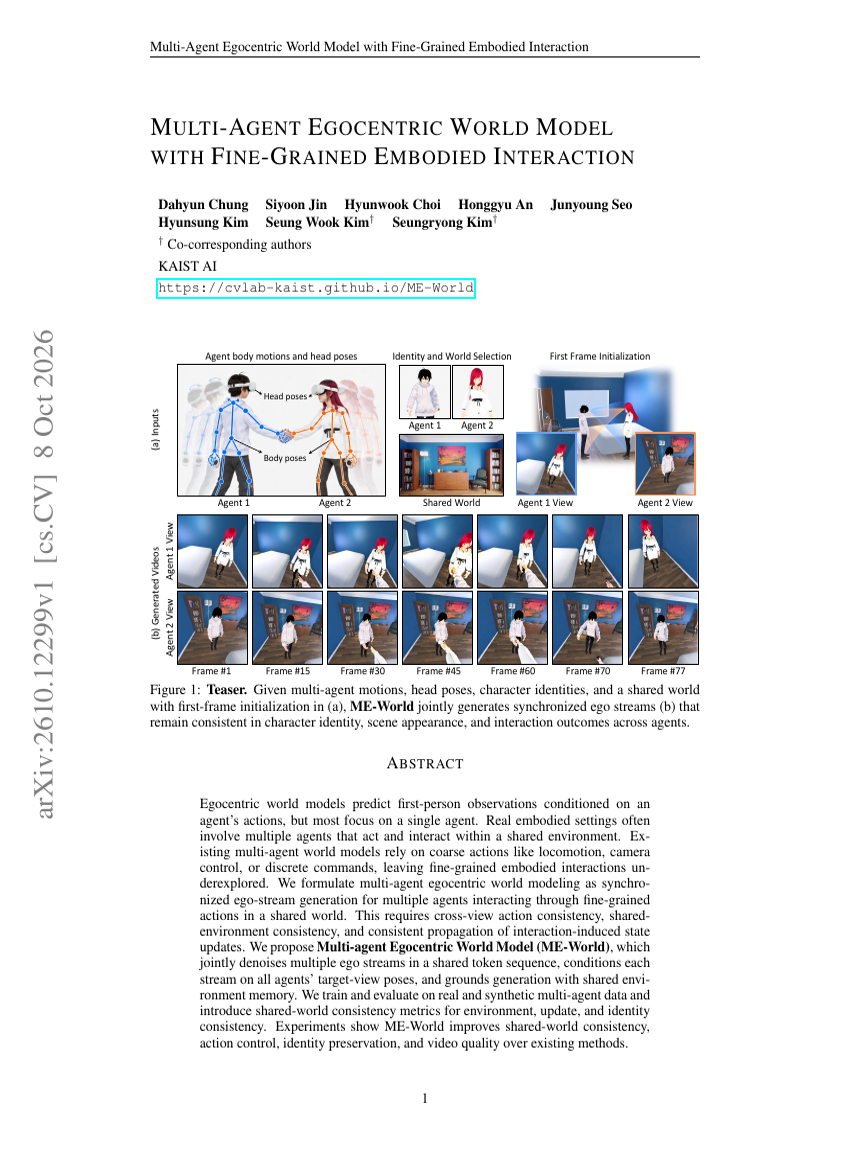
Modèle de monde égocentré multi-agents avec interaction incarnée à granularité fine