HyperAI
Command Palette
Search for a command to run...
Papers
Täglich aktualisierte hochmoderne KI-Forschungsarbeiten, um Sie über die neuesten KI-Trends auf dem Laufenden zu halten
Papers
Technischer Bericht zu Pangram 4
Können KI-Agenten offene KI-Forschung betreiben? Erste Erkenntnisse aus zwei Fallstudien
Code als Agenten-Harness: Auf dem Weg zu ausführbaren, verifizierbaren und zustandsbehafteten Agentensystemen
CAST: Spiel-Löser als Zug-ebene Lehrer für LLM-Agenten
CLBench-V: Evaluierung multimodalen Kontextlernens von der Verankerung bis zum Wissenserwerb
DecoEvo: Score-entkoppelte Koevolution von Löserund Rubrik-Generator-Fähigkeiten im Textraum
HumanCLAW: Können Vision-Language-Modelle durch einen Körper handeln?
CoRT: Kontrafaktisches Replay für tokenbasierte, rubrikengesteuerte Policy-Optimierung
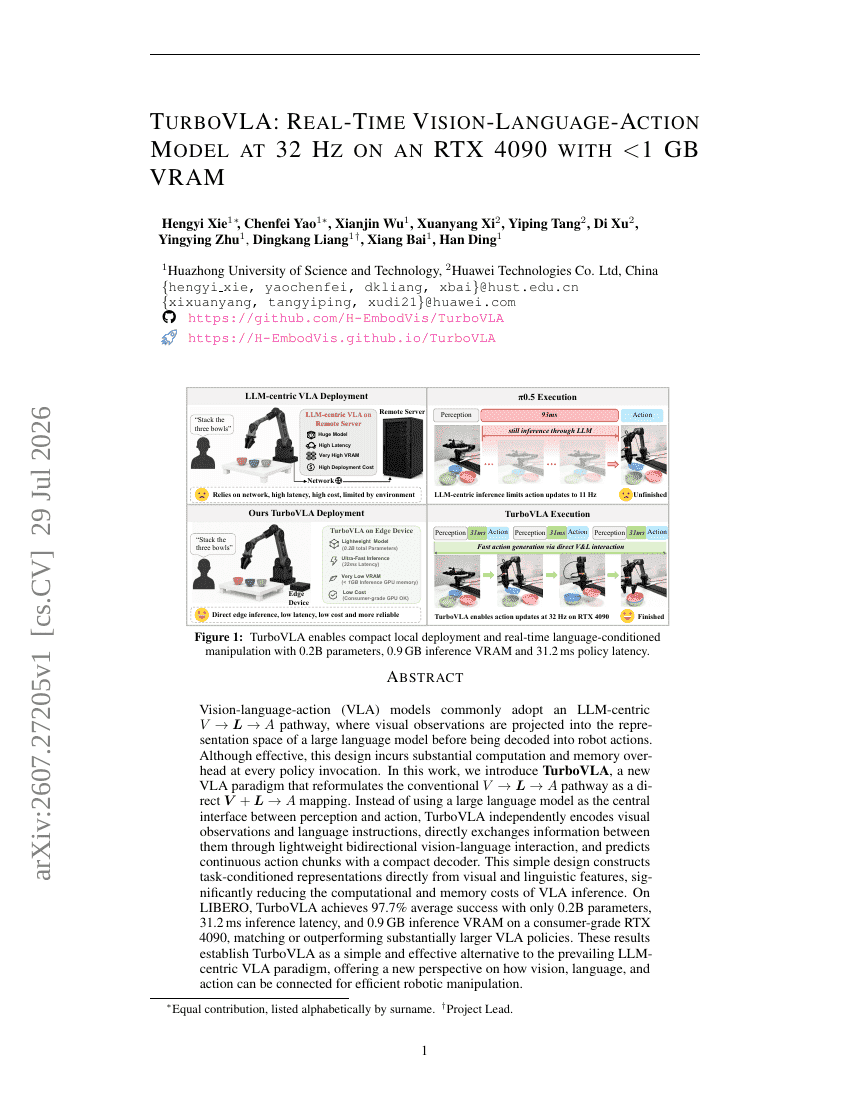
TurboVLA: Ein echtzeitfähiges Vision-Language-Action-Modell mit 32 Hz auf einer RTX 4090 und unter 1 GB VRAM
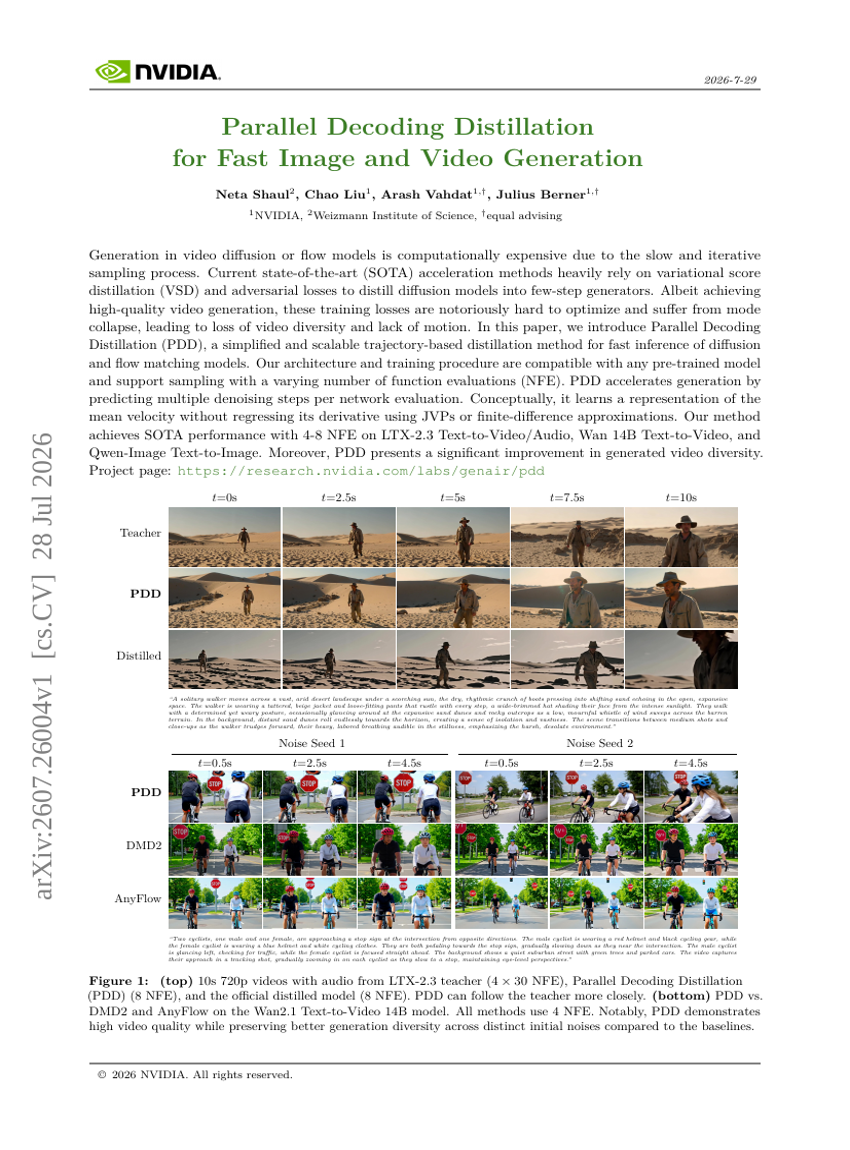
Parallel Decoding Destillation für schnelle Bildund Videogenerierung
Die Bestimmung des optimalen Exponenten in der Beziehung zwischen Summenund Differenzmengen
Testzeit-Skalierung durch Fehlerlokalisierung
NVIDIA-labs OO Agents: Native objektorientierte Agenten in Python
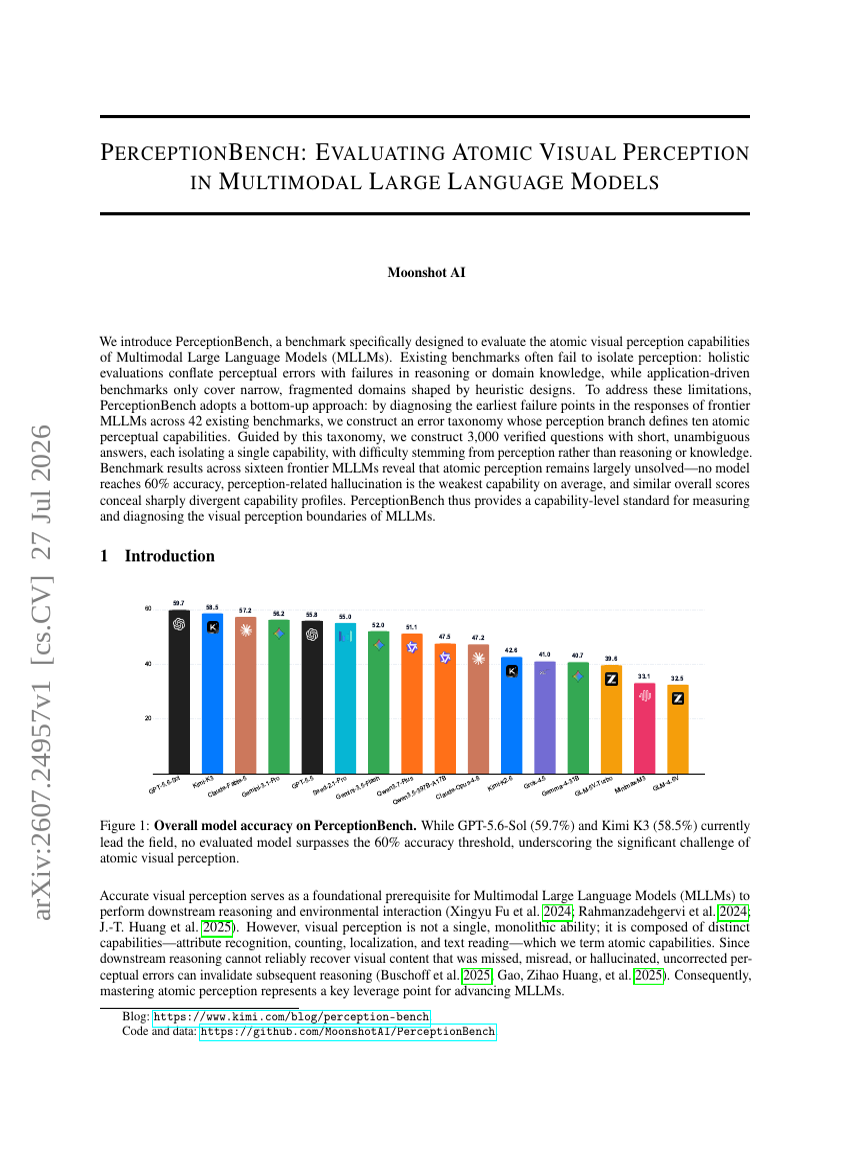
PERCEPTIONBENCH: EVALUIERUNG DER ATOMISCHEN VISUELLEN WAHRNEHMUNG IN MULTIMODALEN GROSSEN SPRACHMODELLEN
Horizontauswahl bei physikalisch angereicherten neuronalen Differentialgleichungen: Theoretische Einsichten und Anwendung auf die Flussverkettung
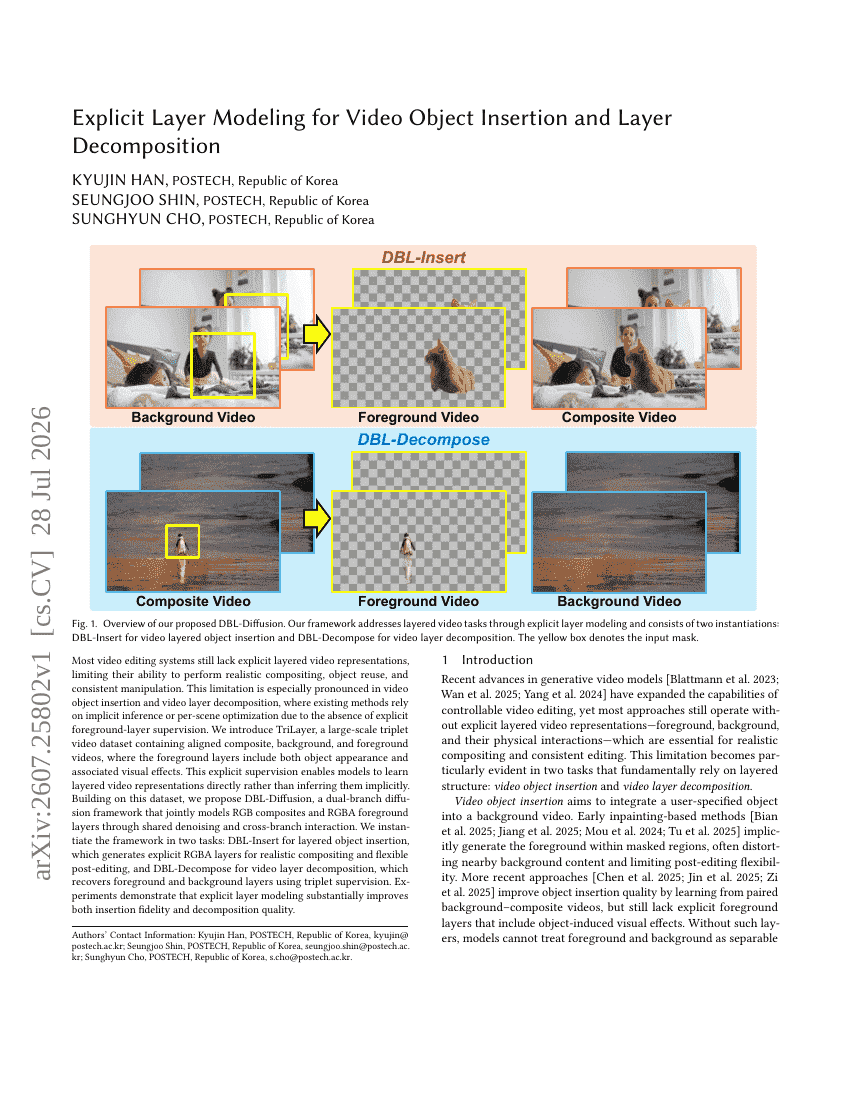
Explizite Schichtenmodellierung für Video-Objekteinbettung und Schichtzerlegung
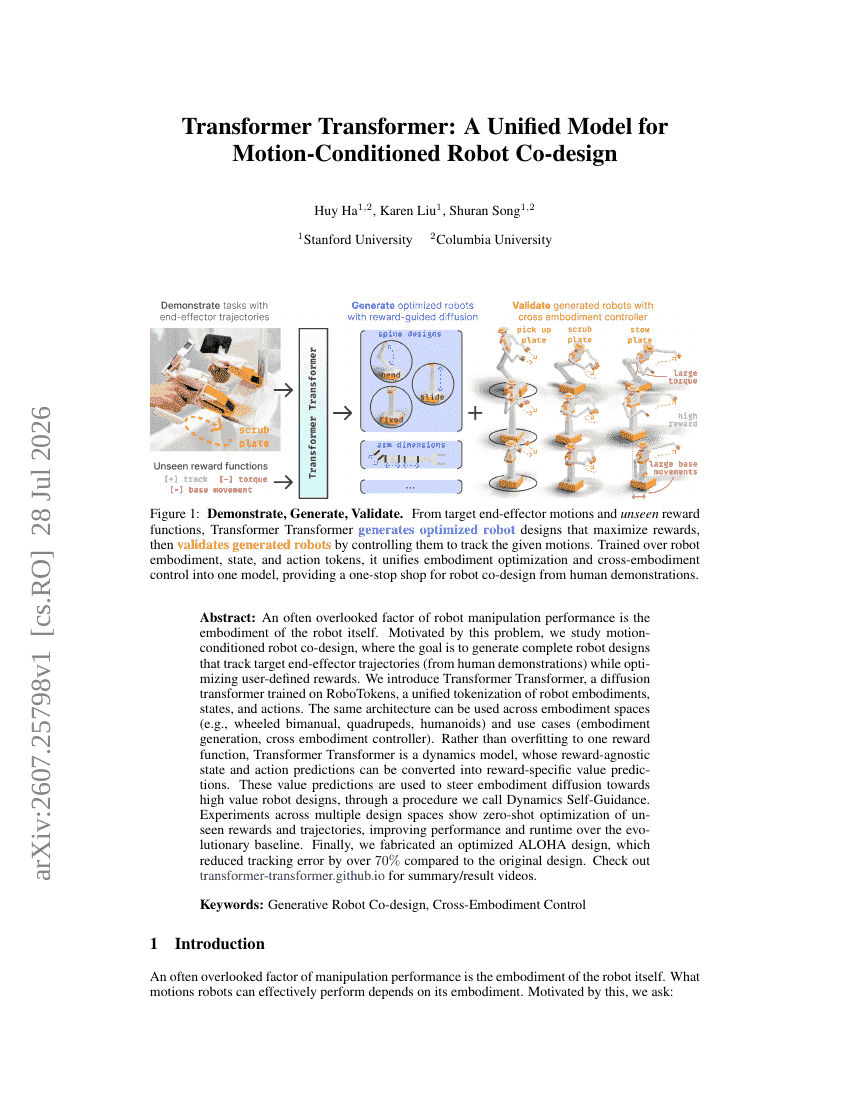
Transformer Transformer: Ein einheitliches Modell für bewegungskonditioniertes Roboter-Co-Design
Feinkörniges Lebensmittelbildverständnis durch zielbewusste Datenangleichung
Verifikation von Beweisern und Lösern
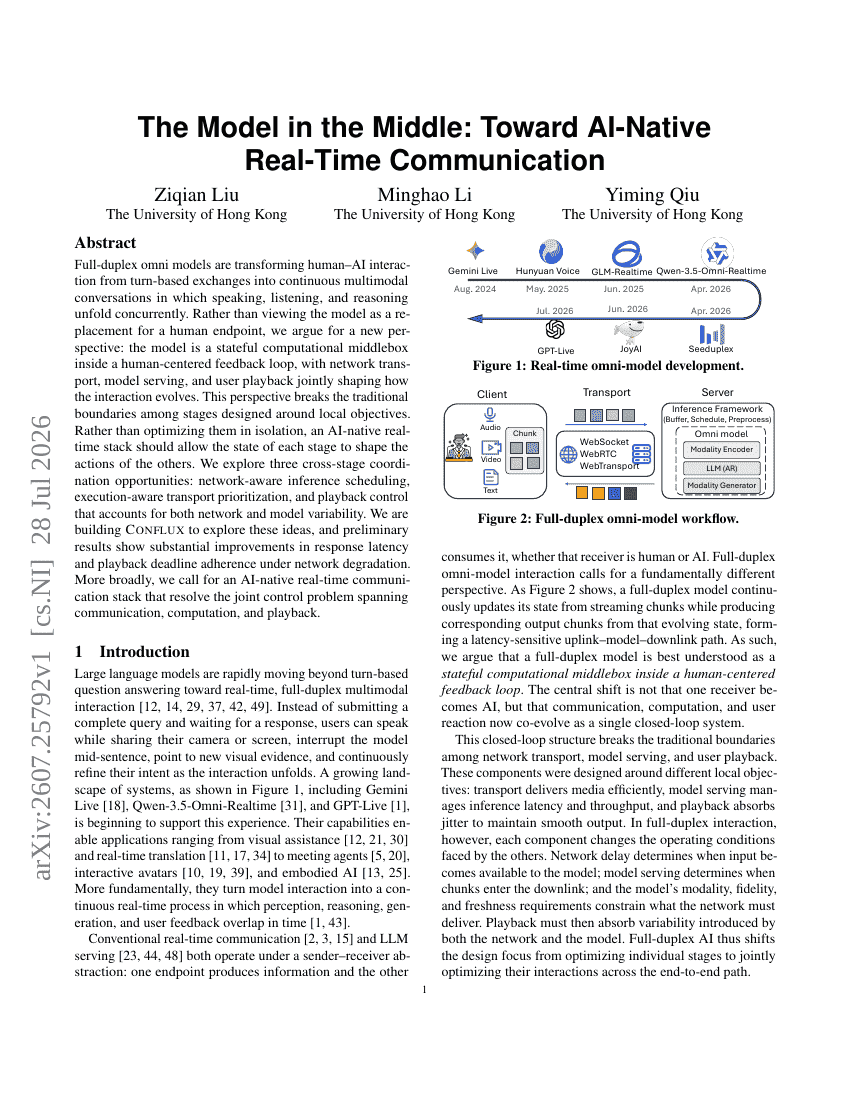
Das Modell in der Mitte: Auf dem Weg zu KI-nativer Echtzeitkommunikation
DynamiCrafter: Animierung von Open-Domain-Bildern mit Video-Diffusions-Priors
MemoHarness: Agenten-Harnesse, die aus Erfahrung lernen
Nanbeige4.2-3B: Erschließung agentischer Fähigkeiten in einem kompakten Modell
KLASSENFREIE STEUERUNG IN DER ON-POLICY-DIFFUSIONSDESTILLATION NEU GEDACHT
STATEACT: PROGRAMMZUSTAND VOR PIXELN FÜR COMPUTER-NUTZUNGSAGENTEN MIT LANGEM ZEITHORIZONT
Fortschrittsbasierte Belohnungsmodellierung für robotisches Lernen: Ein umfassender Überblick
Von proprietär zu Open-Source: Überbrückung der Verteilungslücke durch Multi-Agenten-Protokolldestillation in der agentischen Suche
JarvisHub: Ein offenes Framework für canvas-native multimodale kreative Agenten
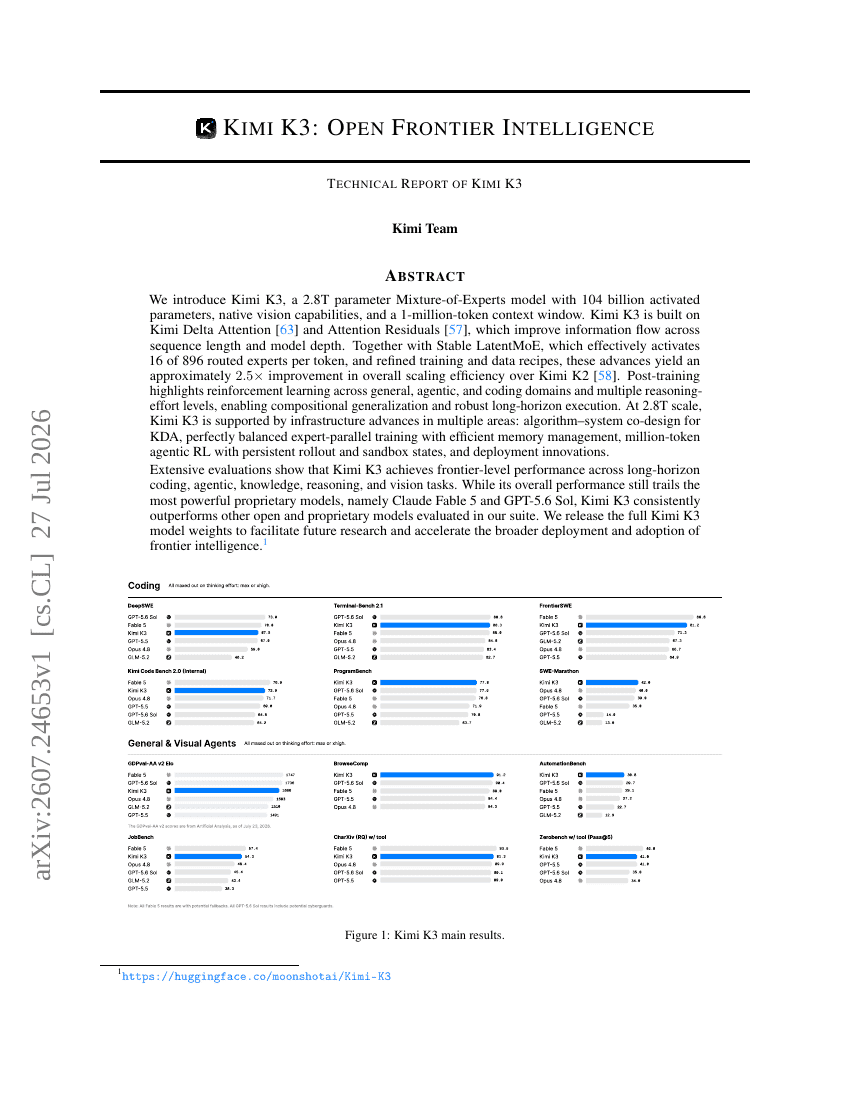
KIMI K3: OFFENE FRONTIER-INTELLIGENZ
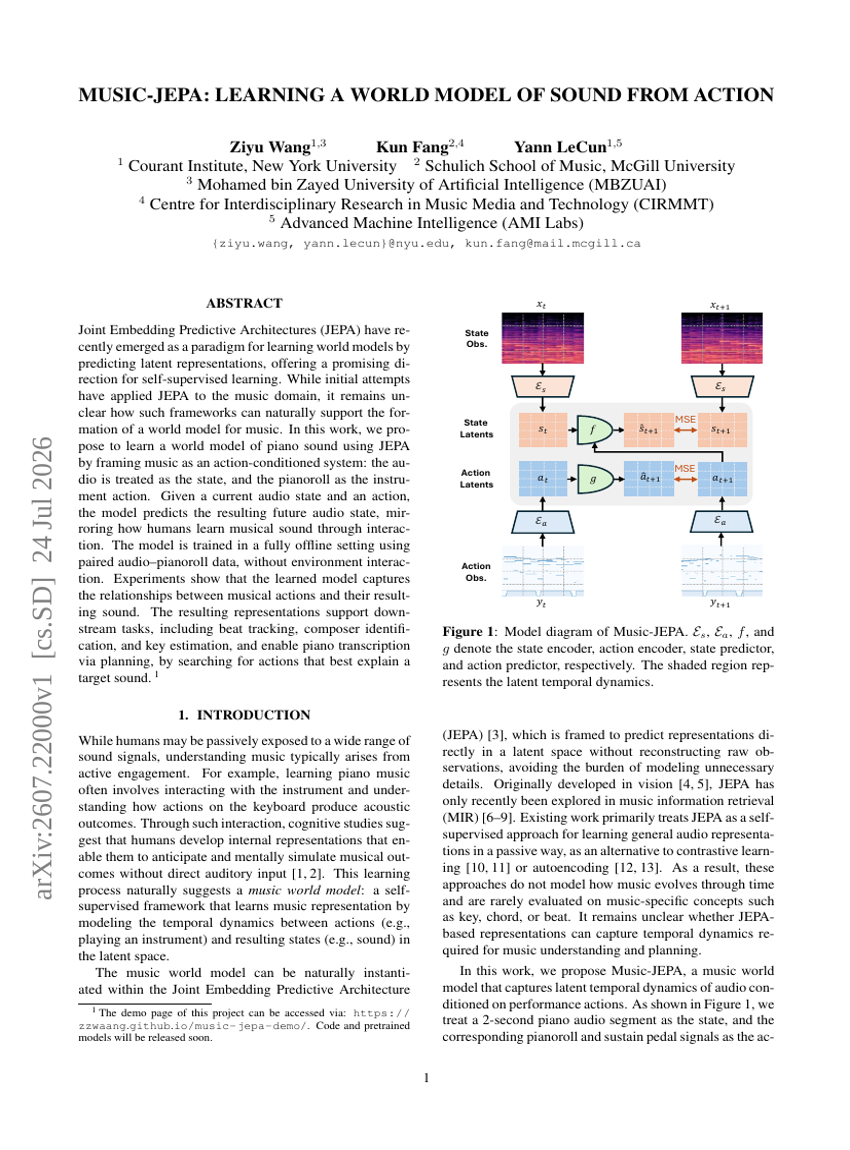
MUSIC-JEPA: Erlernen eines Weltmodells von Klang aus Handlungen
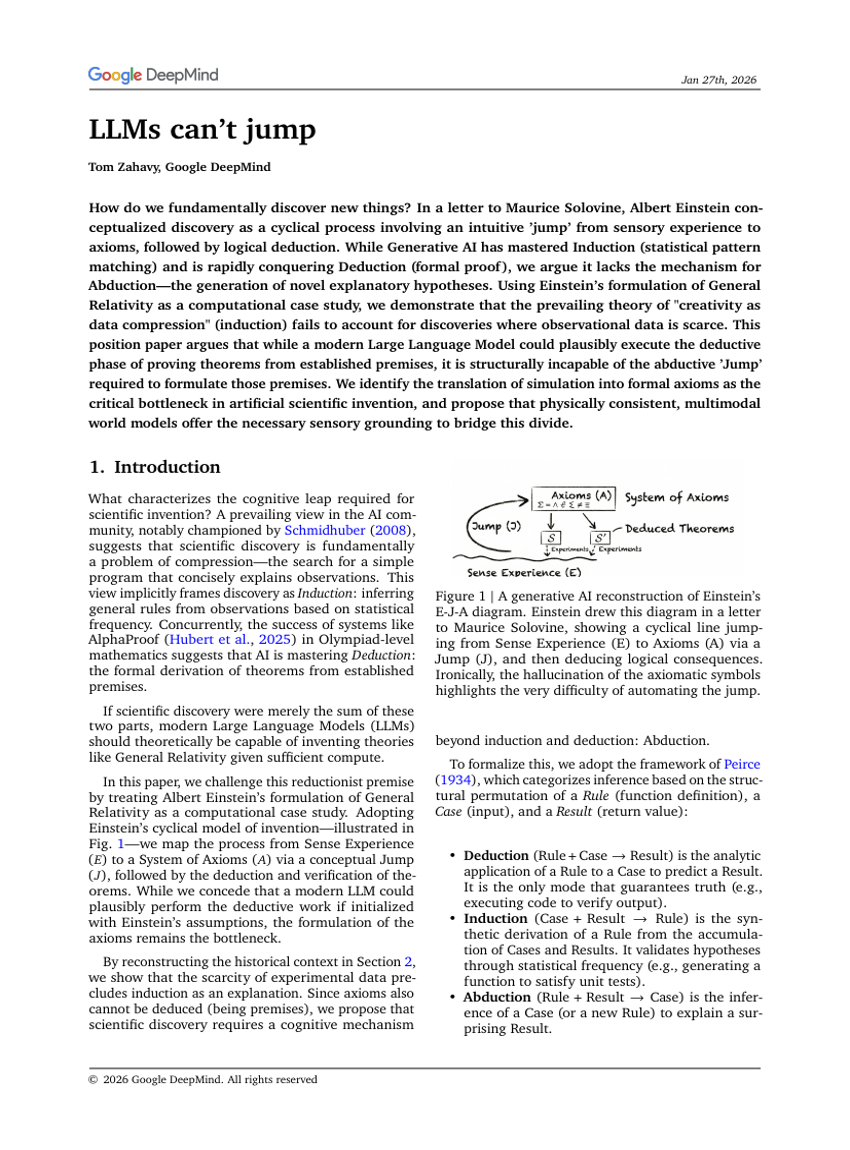
LLMs können nicht springen
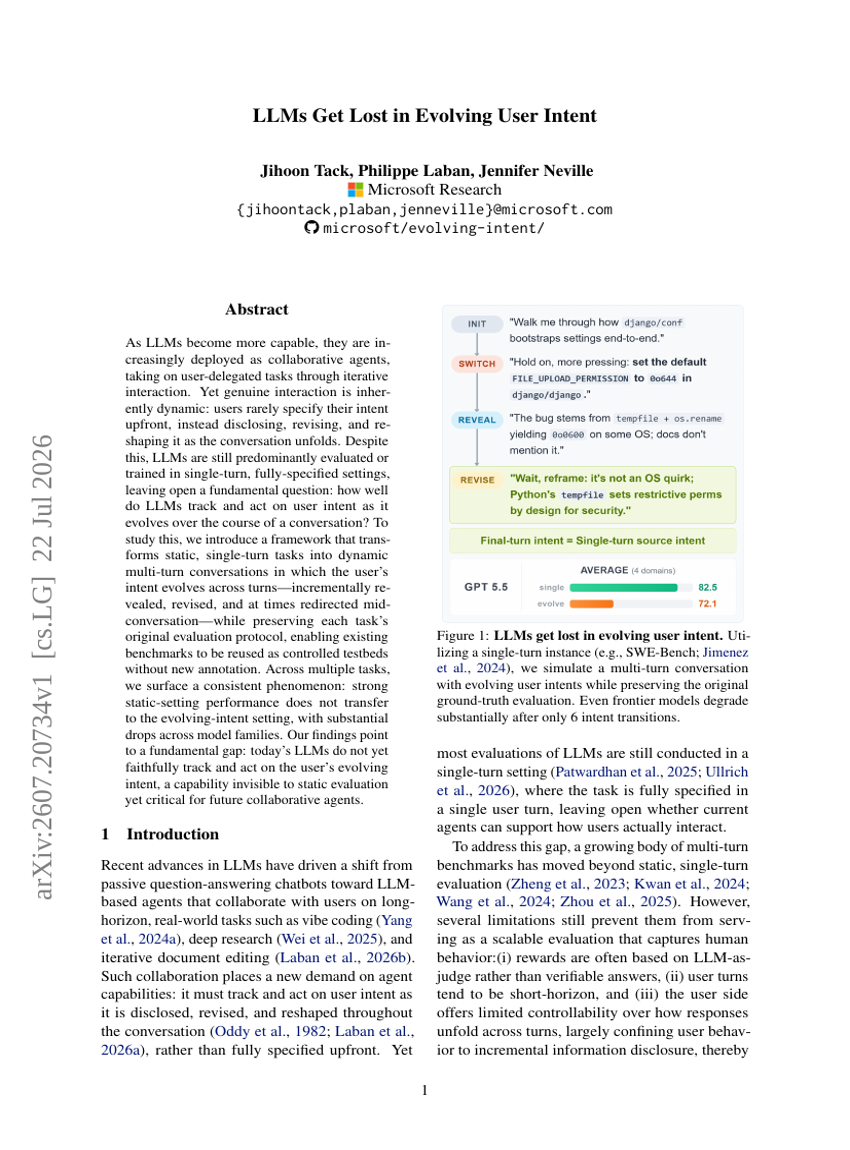
LLMs verlieren sich in sich entwickelnden Nutzerintentionen