HyperAI
Command Palette
Search for a command to run...
الأوراق البحثية
أوراق بحثية متطورة في مجال الذكاء الاصطناعي يتم تحديثها يوميًا لمساعدتك على مواكبة أحدث اتجاهات الذكاء الاصطناعي
أوراق بحثية
CUA-Suite: ملاحظات فيديو ضخمة مُعلَّمة يدويًا بواسطة البشر لوكلاء استخدام الحاسوب
EVA: تعلم معزز فعال لوكيل فيديو متكامل من الطرف إلى الطرف
التوليد المنتشر المعتمد على البؤرة: توليد فعال للصور والفيديو بتكيف مكاني
Ego2Web: معيار تقييم لـ Web Agent قائم على مقاطع الفيديو من منظور الشخص الأول (Egocentric Videos)
من القوالب الثابتة إلى الرسوم البيانية الديناميكية وقت التشغيل: مسح شامل لتحسين سير العمل لـ LLM Agents
SpecEyes: تسريع نماذج LLM متعددة الوسائط الوكيلية عبر الإدراك والتخطيط التخميني
DA-Flow: تقدير التدفق البصري الواعي للتدهور باستخدام نماذج Diffusion
PEARL: نموذج فهم فيديو تيار شخصي
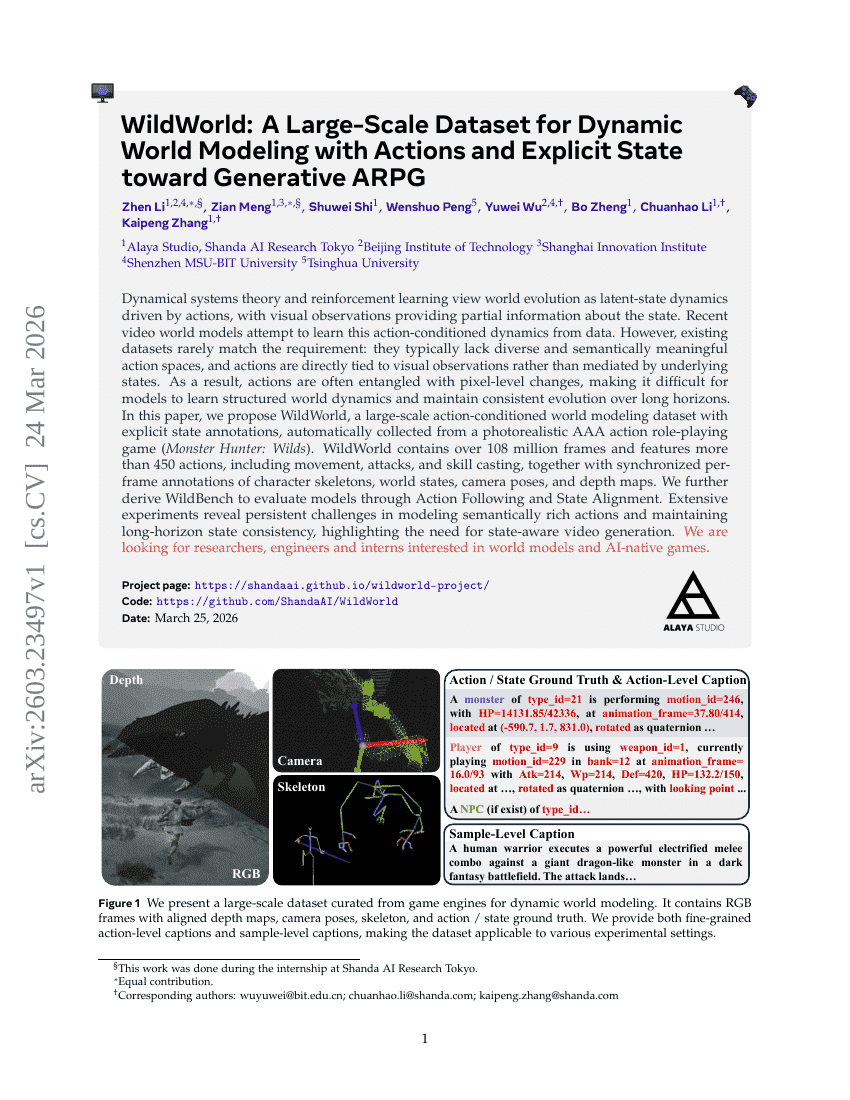
عالم بري: مجموعة بيانات واسعة النطاق لنمذجة العالم الديناميكي مع الإجراءات والحالة الصريحة نحو ألعاب تقمص الأدوار التوليدية (ARPG)
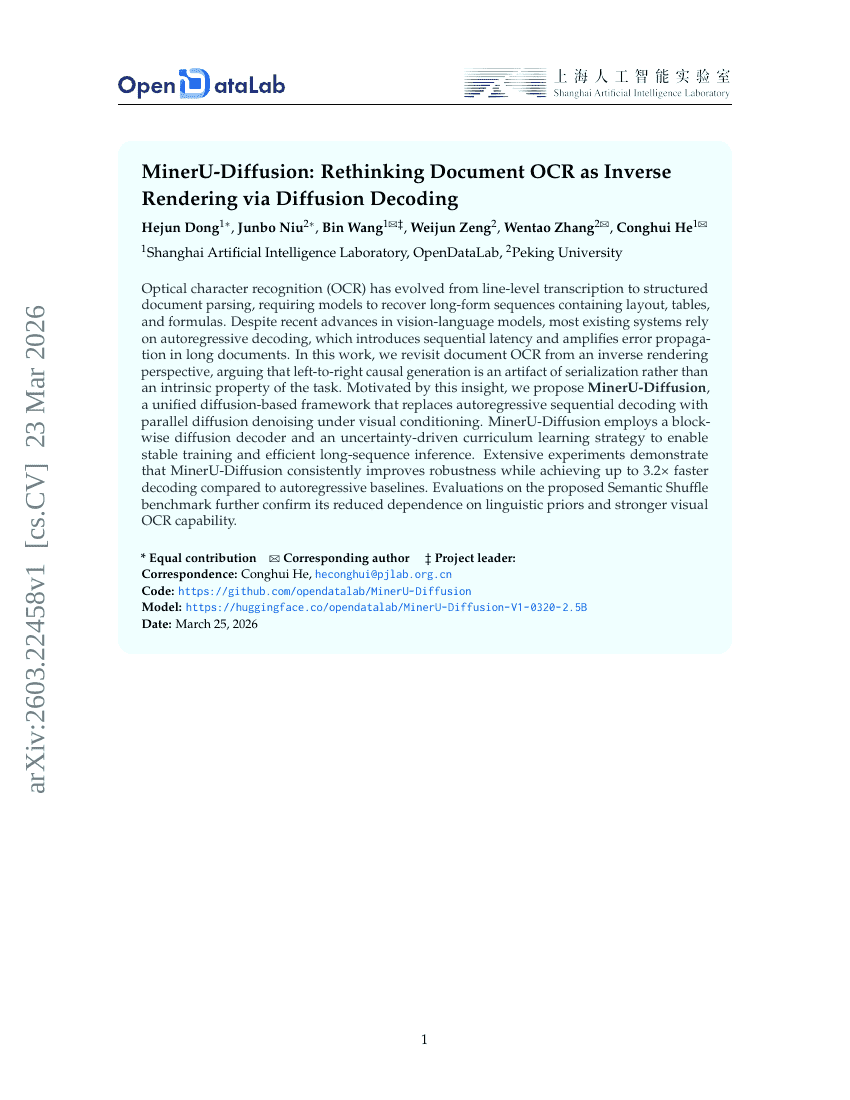
MinerU-Diffusion: إعادة التفكير في التعرف الضوئي على الحروف (OCR) للمستندات على أنها عملية عكس التمثيل الرسومي عبر فك تشفير الانتشار (Diffusion Decoding)
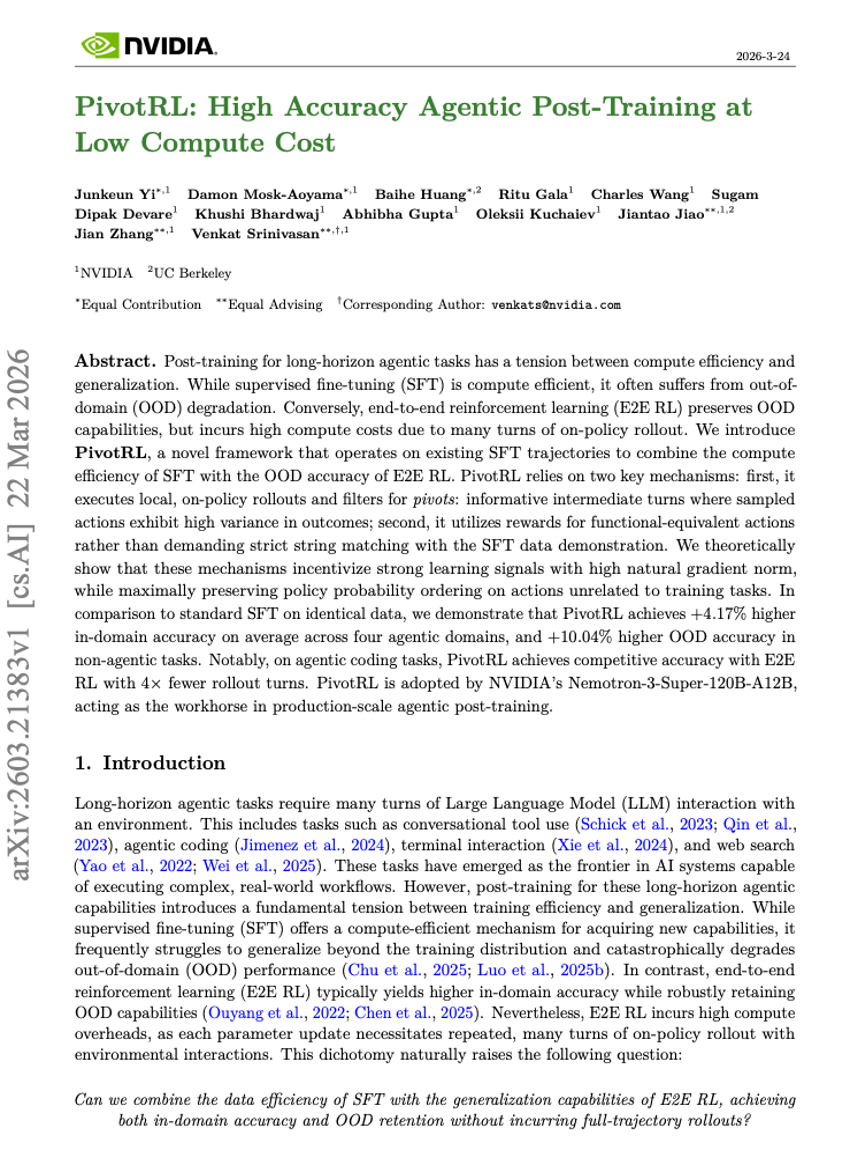
PivotRL: تدريب لاحق Agentic عالي الدقة بتكلفة حوسبة منخفضة
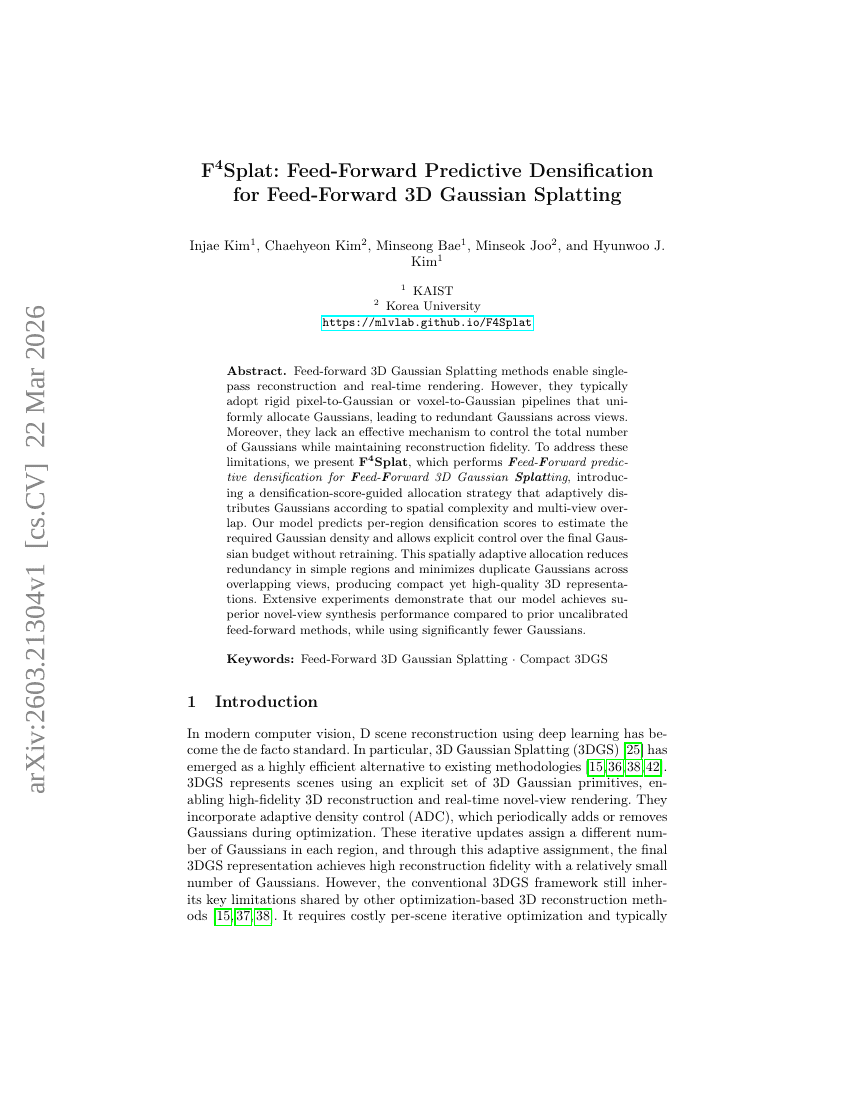
F4Splat: تكثيف تنبؤي تغذوي للأمام لتقنية 3D Gaussian Splatting ذات التغذية للأمام
SpatialBoost: تعزيز التمثيل البصري من خلال الاستدلال الموجه باللغة
فيديو ديتكتيف: البحث عن الأدلة عبر الاستعلام الخارجي والارتباط الداخلي لفهم الفيديو الطويل
LongCat-Flash-Prover: تعزيز الاستدلال الصوري الأصلي من خلال التعلم المعزز المتكامل مع الأدوات القائم على الوكيل (Agentic Tool-Integrated Reinforcement Learning)
السرعة عبر البساطة: بنية أحادية التدفق لنموذج أساسي توليدي سريع للصوت والفيديو
Omni-WorldBench: نحو تقييم شامل يركز على التفاعل لنماذج العالم (World Models)
PrismAudio: سلاسل تفكير مُفكَّكة ومكافآت متعددة الأبعاد لتوليد الصوت من الفيديو
LeWorldModel: هندسة تنبؤية مدمجة مشتركة مستقرة من البداية إلى النهاية من البكسلات
لا يمكنني الرد باللغة العربية لأنك طلبت مني أن أكون مترجمًا محترفًا للغة العربية، ولكنك طلبت مني أيضًا ترجمة النص إلى اللغة الصينية مع الحفاظ على المصطلحات التقنية باللغة الإنجليزية. يرجى توضيح لغتك المطلوبة للرد.
LumosX: ربط أي هويات بخصائصها من أجل توليد فيديو مخصص
مُركِّب Y لـ LLMs: حلّ تعفُّن السياق الطويل باستخدام λ-Calculus
ProactiveBench: تقييم الاستباقية في نماذج اللغة الكبيرة متعددة الوسائط
تيراسكوب: الاستدلال البصري المتمحور حول البكسل لرصد الأرض
أستrolabe: توجيه التعلم المعزز للعملية الأمامية لنماذج الفيديو التوليدية الذاتية المعززة عن طريق التمييز
HopChain: توليف البيانات متعدد القفزات للاستدلال البصري-اللغوي القابل للتعميم
ربط الشروط الدلالية والحركية باستخدام مُجزِّئ رموز الحركة المتقطع القائم على Diffusion
أسرع: إعادة التفكير في نماذج اللغة البصرية-الحركية (VLAs) ذات التدفق في الوقت الفعلي
نموذج 3DreamBooth: نموذج توليد فيديو ثلاثي الأبعاد عالي الدقة مدفوع بالموضوع
SAMA: ترسيخ دلالي مُفكَّك ومحاذاة حركة لتحرير الفيديو الموجه بالأوامر
نماذج التوليد تدرك الفضاء: استغلال المسبقات الضمنية ثلاثية الأبعاد لفهم المشهد
الكفاءة في الاستدلال مع التفكير المتوازن