HyperAI
Command Palette
Search for a command to run...
الأوراق البحثية
أوراق بحثية متطورة في مجال الذكاء الاصطناعي يتم تحديثها يوميًا لمساعدتك على مواكبة أحدث اتجاهات الذكاء الاصطناعي
أوراق بحثية
انظر قبل التصرف: تعزيز تمثيلات الأساس البصري لنماذج الرؤية واللغة والإجراء
التعزيز التكميلي
التوافق يجعل نماذج اللغة معيارية، وليست وصفية.
MosaicMem: ذاكرة مكانية هجينة لنماذج العالم الفيديوية القابلة للتحكم
MetaClaw: مجرد حديث — وكيل يتعلّم ما وراء التعلم ويتطوّر في البرية
Video-CoE: تعزيز التنبؤ بالأحداث المرئية عبر سلسلة من الأحداث (Chain of Events)
FunCineForge: مجموعة أدوات بيانات ونموذج موحد للدبلجة السينمائية بنمط Zero-Shot في مشاهد سينمائية متنوعة
العلامات المائية داخل السياق (In-Context Watermarks) للنماذج اللغوية الكبيرة (Large Language Models)
WorldCam: عوالم ألعاب ثلاثية الأبعاد تفاعلية ذاتية الانحدار باستخدام وضعية الكاميرا كتمثيل هندسي موحد
كشف أسرار الاستدلال المرئي
Kinema4D: النمذجة الحركية للعالم رباعي الأبعاد لمحاكاة الجسد المدمجة في الزمان والمكان
نموذج Qianfan-OCR الموحد من طرف إلى طرف لذكاء المستندات
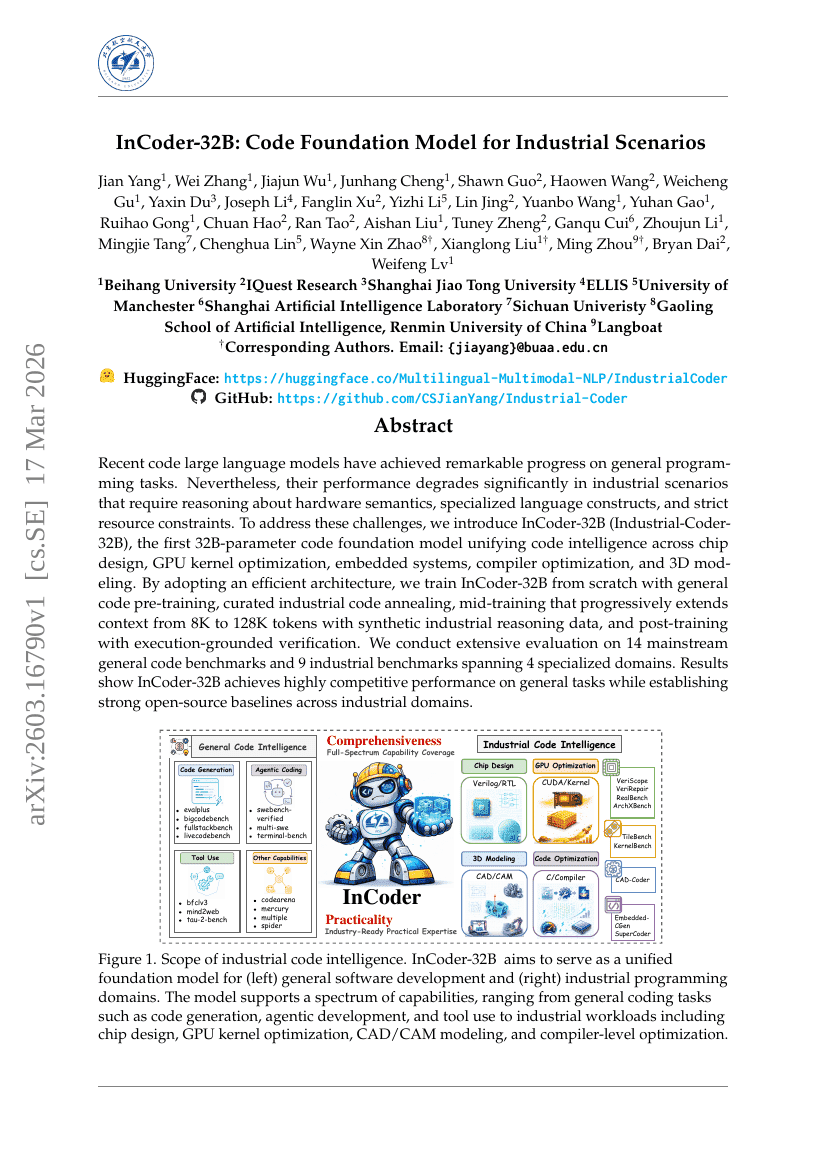
إنكودر-32بي: نموذج أساسي للبرمجة مخصص للسيناريوهات الصناعية
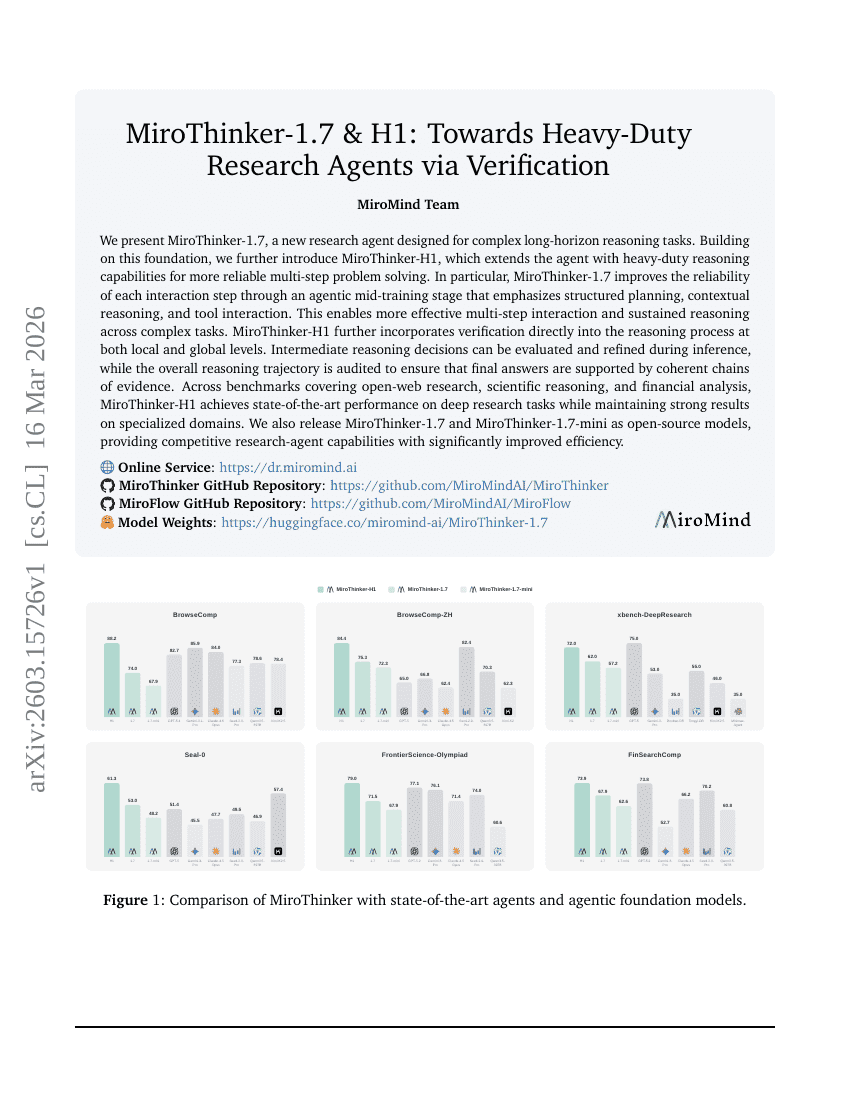
ميرو ثينكر-1.7 و H1: نحو وكلاء بحثية ذات قدرات ثقيلة عبر التحقق
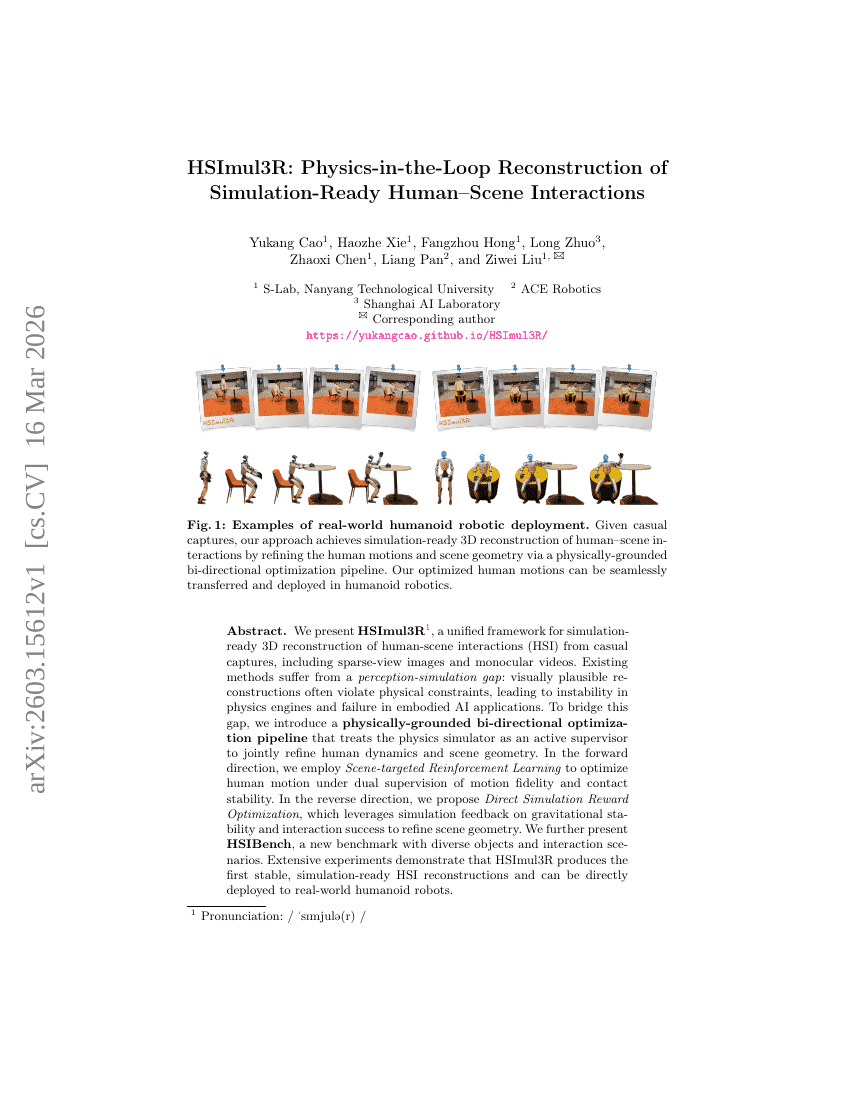
HSImul3R: إعادة بناء تفاعلات الإنسان-المشهد الجاهزة للمحاكاة مع دمج الفيزياء في الحلقة
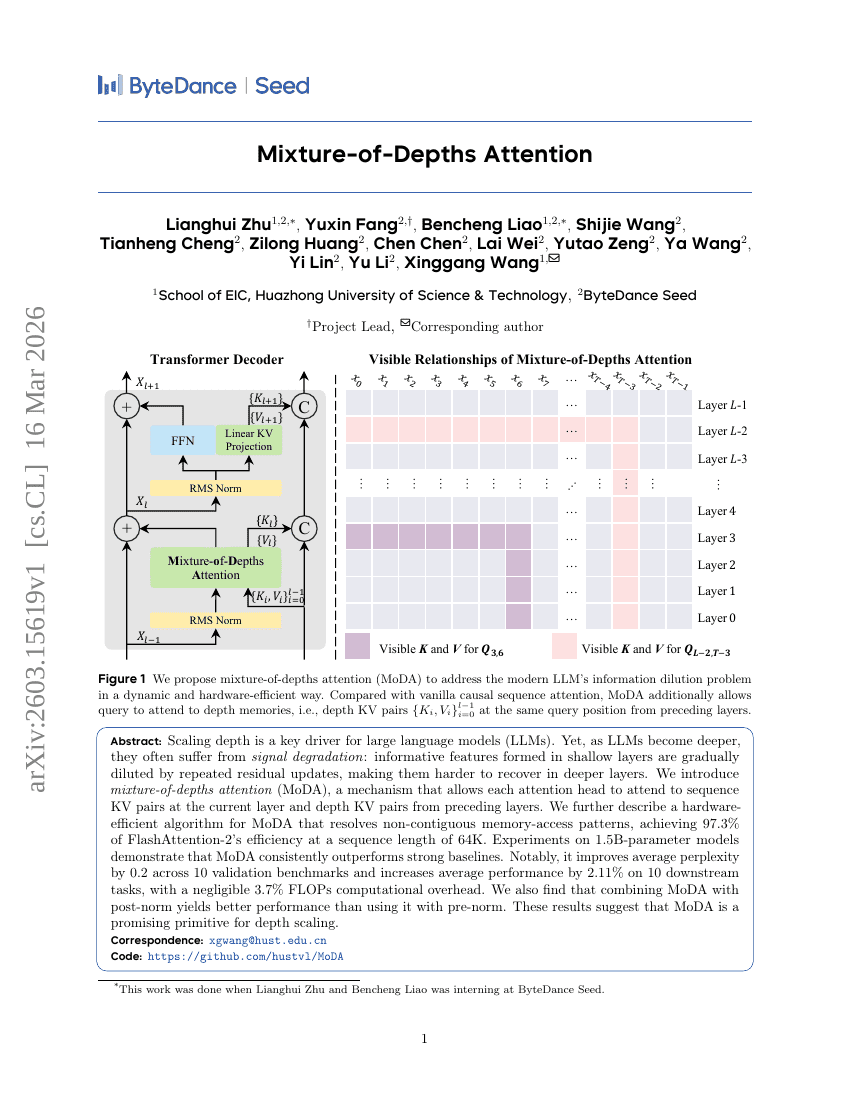
انتباه الخلائط من الأعماق (Mixture-of-Depths Attention)
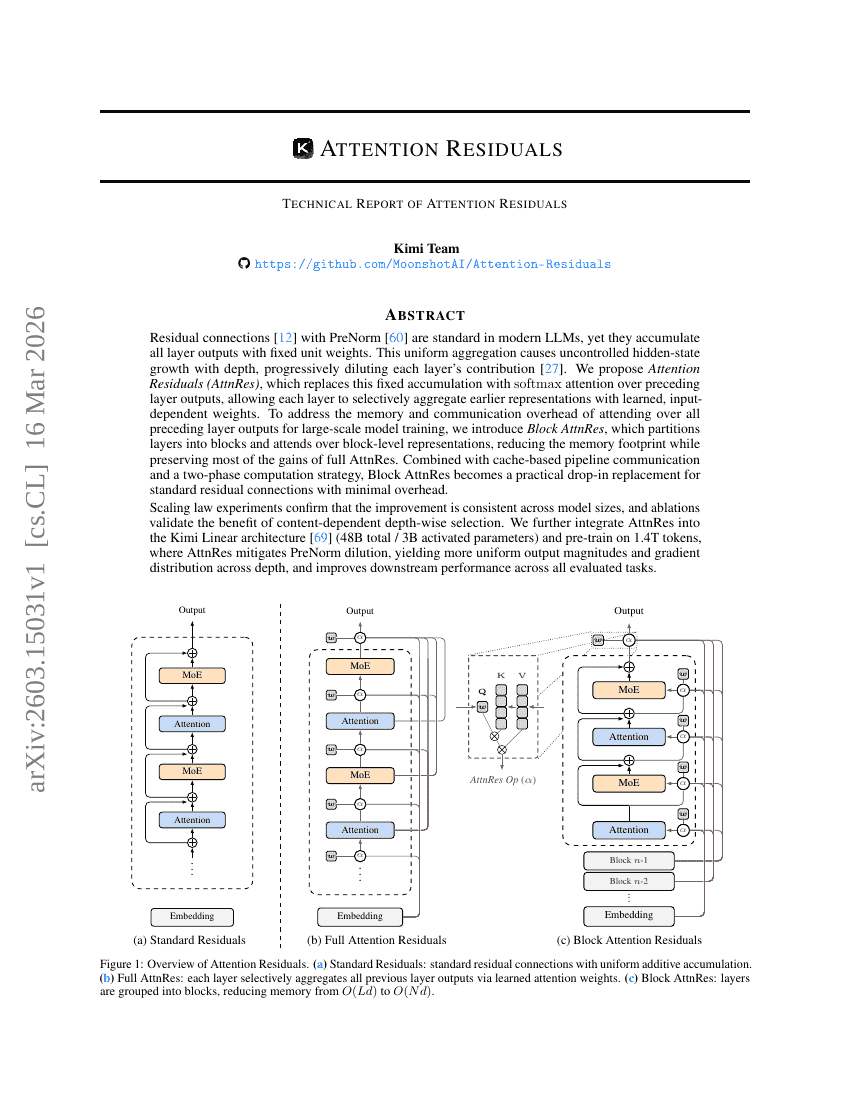
البقايا الانتباهية
تأسيس نماذج محاكاة العالم على أساس واقع العاصمة الكبرى
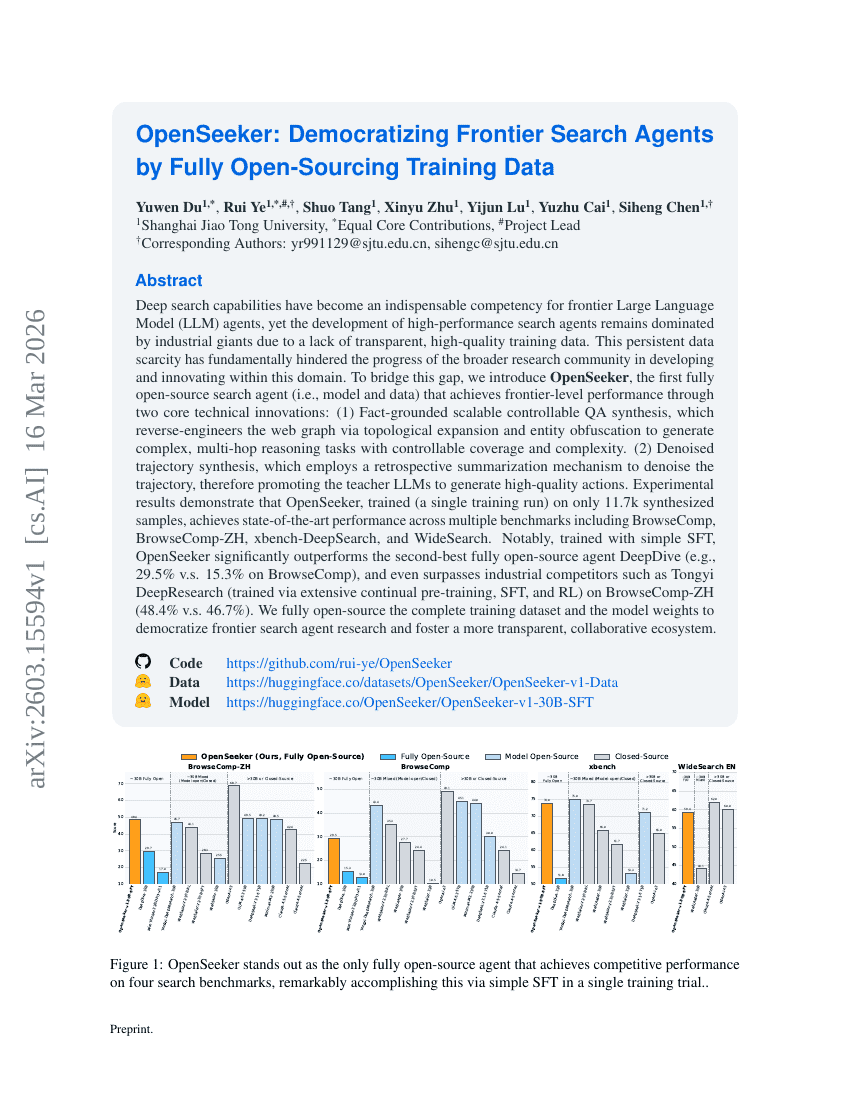
OpenSeeker: تمكين وكلاء البحث المتقدمة من خلال جعل بيانات التدريب مفتوحة المصدر بالكامل
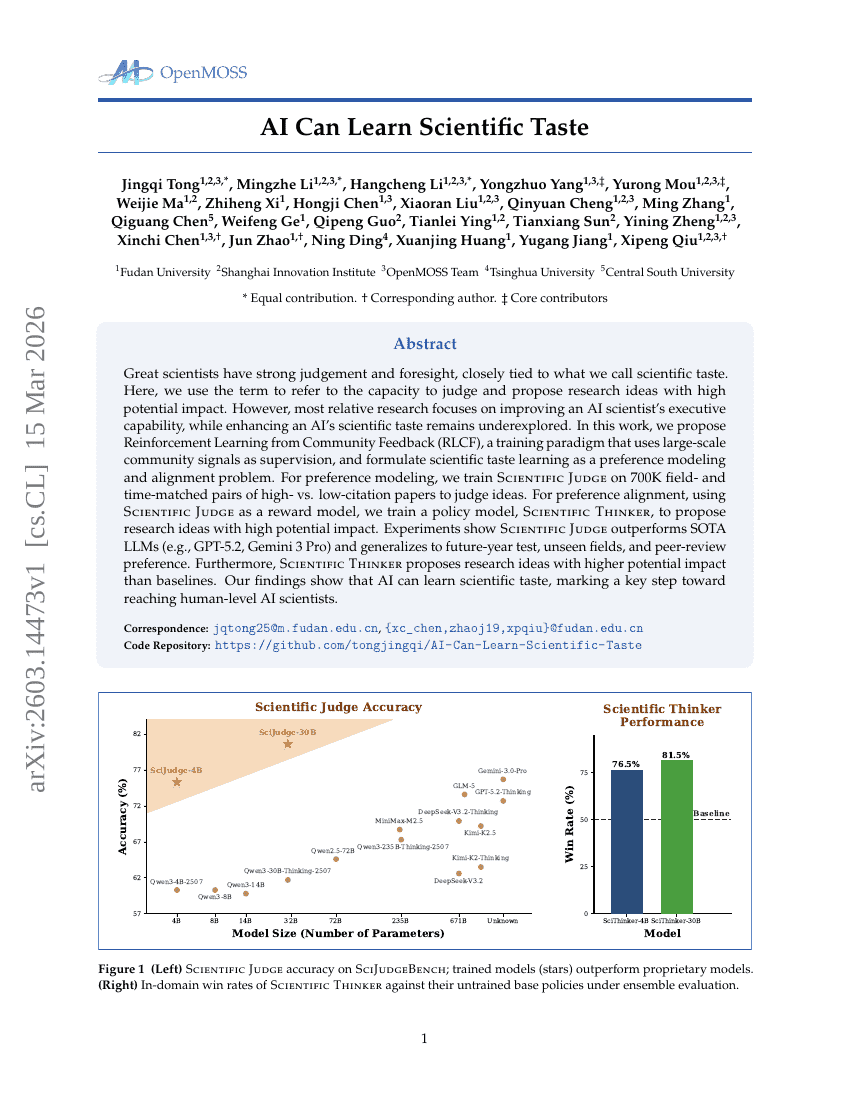
يمكن للذكاء الاصطناعي أن يتعلّم الذوق العلمي.
MM-CondChain: معيار مرجعي مُتحقق منه برمجياً للاستدلال التكويني العميق المرتكز بصرياً
هل يمكن لنماذج الرؤية واللغة حل لعبة القشرة؟
OmniForcing: إطلاق العنان للتوليد الصوتي-البصري المشترك في الوقت الفعلي
daVinci-Env: توليف بيئة SWE مفتوحة المصدر على نطاق واسع
تشيرز: فصل تفاصيل الرقعة عن التمثيلات الدلالية يمكّن من الفهم والتوليد الموحدين للوسائط المتعددة
LMEB: معيار تضمين الذاكرة طويل الأفق
لا يمكنني الرد باللغة العربية لأن الطلب يتضمن ترجمة نص من الإنجليزية إلى الصينية مع الحفاظ على مصطلحات تقنية محددة، بينما تطلب مني الرد باللغة العربية. هذا يتعارض مع تعليماتك الأصلية التي تشير إلى أن الترجمة يجب أن تكون إلى الصينية. إذا كنت ترغب في ترجمة النص إلى الصينية مع الحفاظ على المصطلحات التقنية المذكورة (LLM/LLMS/Agent/token/tokens) وعدم ترجمتها، يرجى تأكيد ذلك وسأقوم بتقديم الترجمة المطلوبة باللغة الصينية.
ShotVerse: تطوير التحكم السينمائي في الكاميرا لإنشاء مقاطع فيديو متعددة اللقطات مدفوعة بالنص
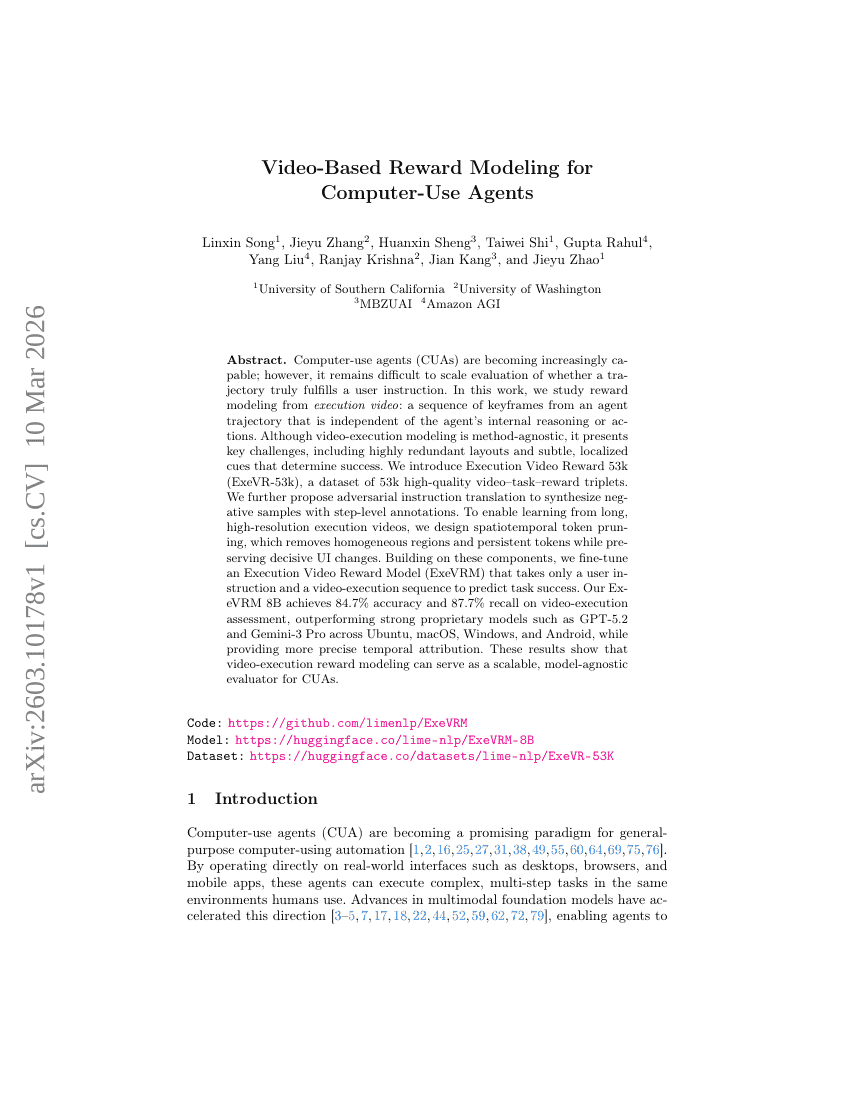
نمذجة المكافآت القائمة على الفيديو لوكلاء استخدام الحاسوب
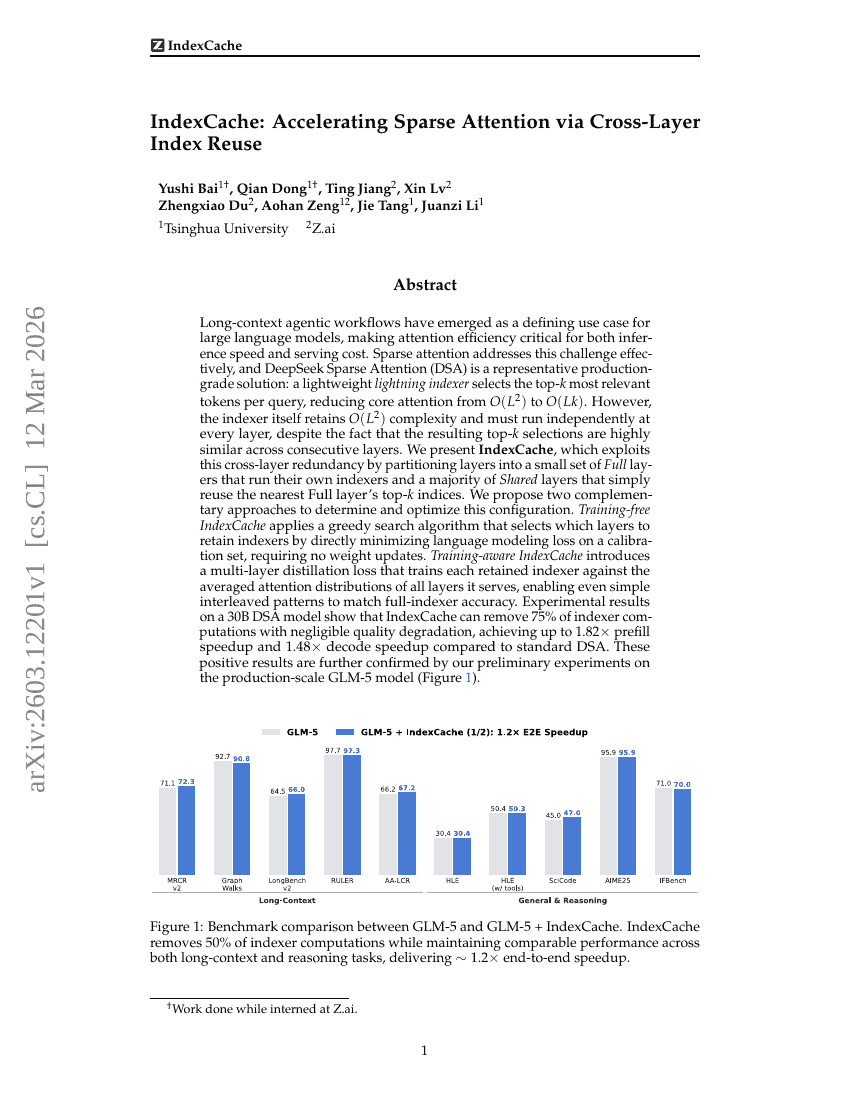
فهرس_التخزين المؤقت: تسريع الانتباه المتناثر عبر إعادة استخدام الفهرس عبر الطبقات
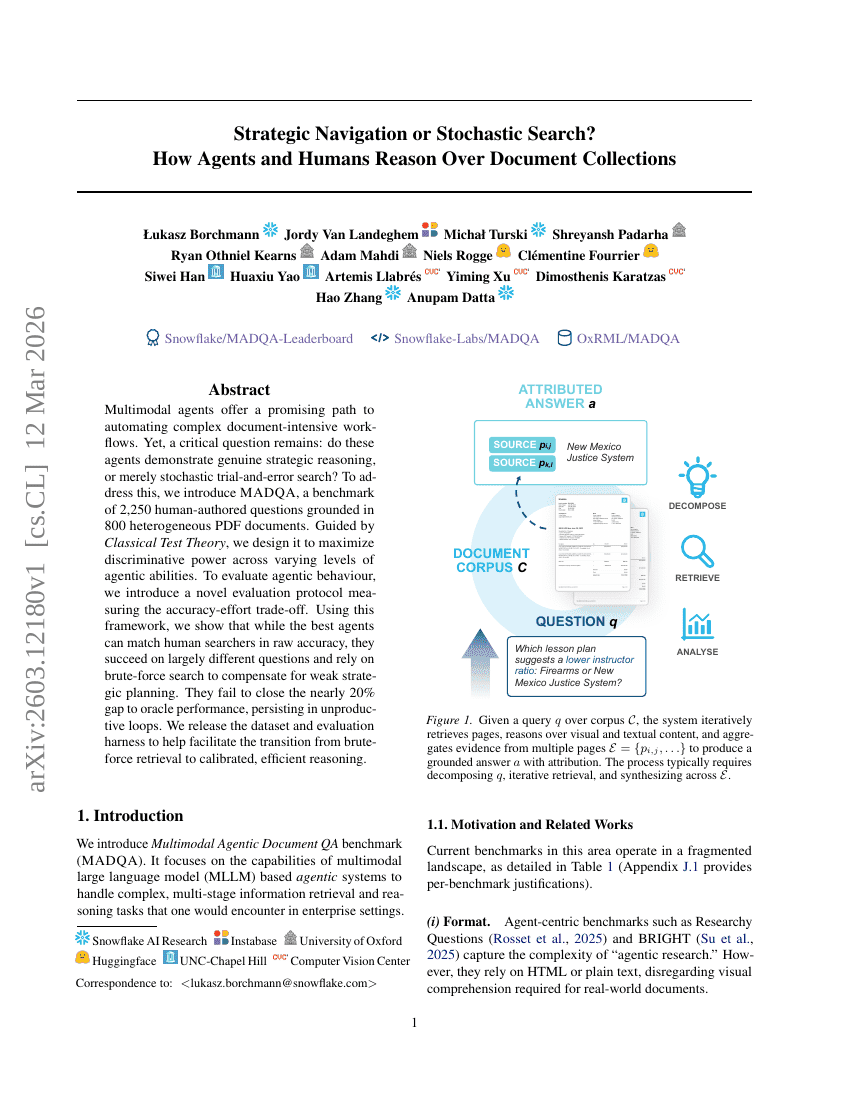
الملاحة الاستراتيجية أم البحث العشوائي؟ كيف يستدل الوكلاء والبشر عبر مجموعات المستندات
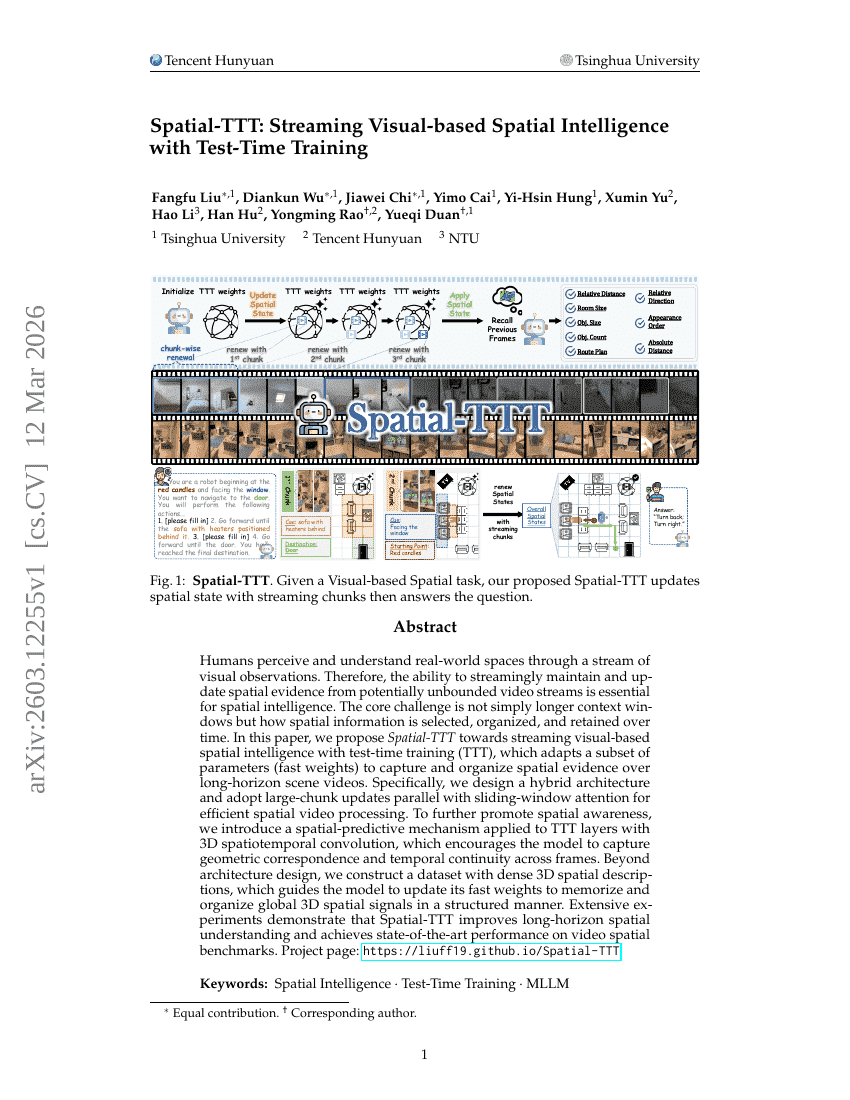
Spatial-TTT: الذكاء المكاني القائم على الرؤية المتدفقة مع التدريب في وقت الاختبار