HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
OmniVinci:オムニモーダル理解のためのアーキテクチャとデータの強化 LLM
大規模言語モデルの推論における内部確率と自己整合性を橋渡しする理論的研究
DeepSeek-OCR:コンテキスト光学圧縮
観測されない好みの異質性を伴う直接的好み最適化:三値好みの必要性
確率的気象予測のためのローリング拡散モデルの解明
ImagerySearch:意味的依存制約を越える動画生成のための適応的テスト時探索
ピクセルから文章へ ― スケールにおけるネイティブな視覚言語プリミティブへの道標
サービスにおけるAI:AIグラスによる能動的支援
WithAnyone:制御可能かつID一貫性を備えた画像生成へ向けて
エージェント的エントロピー・バランス型ポリシー最適化
モデルが嘘をつくとき、私たちは学ぶ:PsiloQAを用いた多言語スパンレベルの幻覚検出
深層学習を用いたマルチテンプレートPCRにおける塩基配列特異的増幅効率の予測
ゲノム解析ツールキット:次世代DNAシーケンシングデータ解析のためのMapReduceフレームワーク
LAMMPS - 原子、マクロおよび連続体スケールにおける粒子基準材料モデリングのための柔軟なシミュレーションツール
LabOS:人間と視覚的に認識し、協働するAI-XR共同研究者
ドルフィン:異種アンカー・プロンプトを用いたドキュメント画像解析
LiveCC:大規模なストリーミング音声転写を用いた動画言語モデルの学習
DeepMMSearch-R1:マルチモーダルWeb検索におけるマルチモーダルLLMの能力を強化する
次世代単細胞解析のための大規模言語モデルのスケーリング
大規模言語モデルを用いたバイブコーディングの現状調査
次のポイント予測によるAnything検出
言語中心のオムニモーダル表現学習のスケーリング
DITING:ウェブ小説翻訳のベンチマーク評価を目的としたマルチエージェント評価フレームワーク
自己教師あり事前学習を活用したエンドツーエンド型ピクセル空間生成モデリングの進展
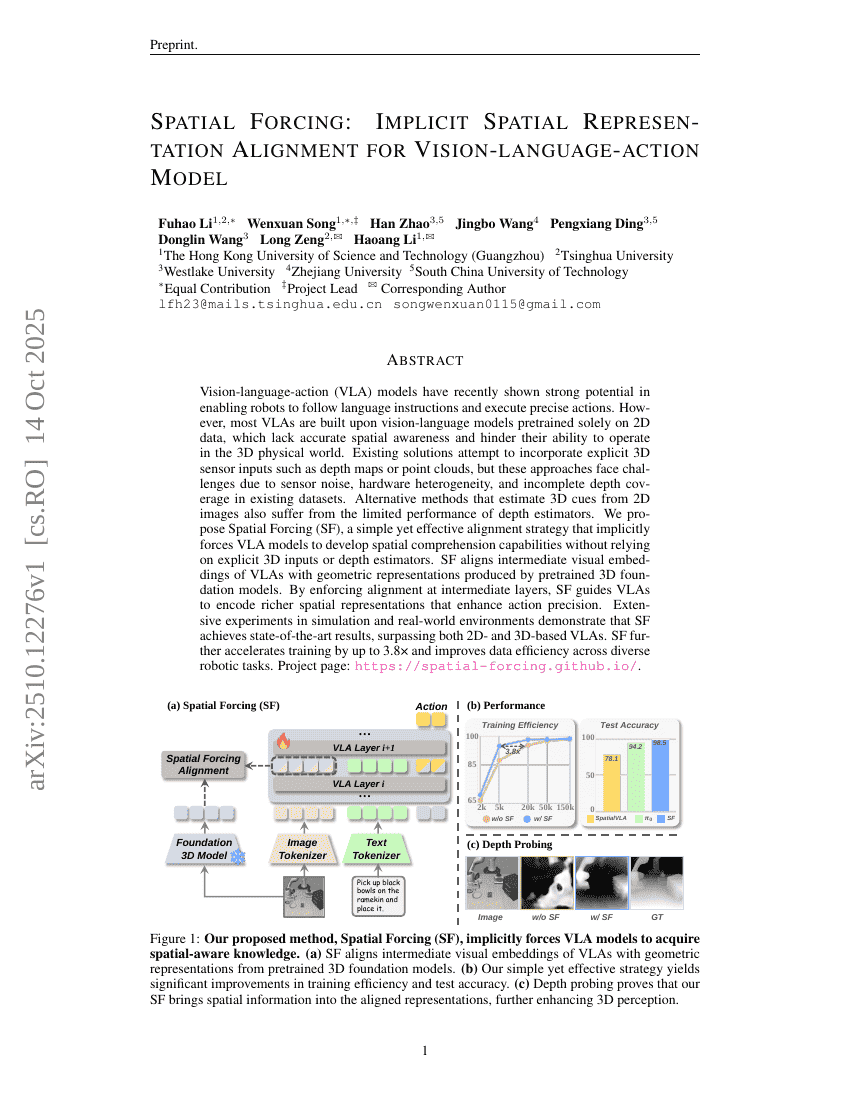
空間的強制:視覚言語行動モデルにおける暗黙的空間表現の整合
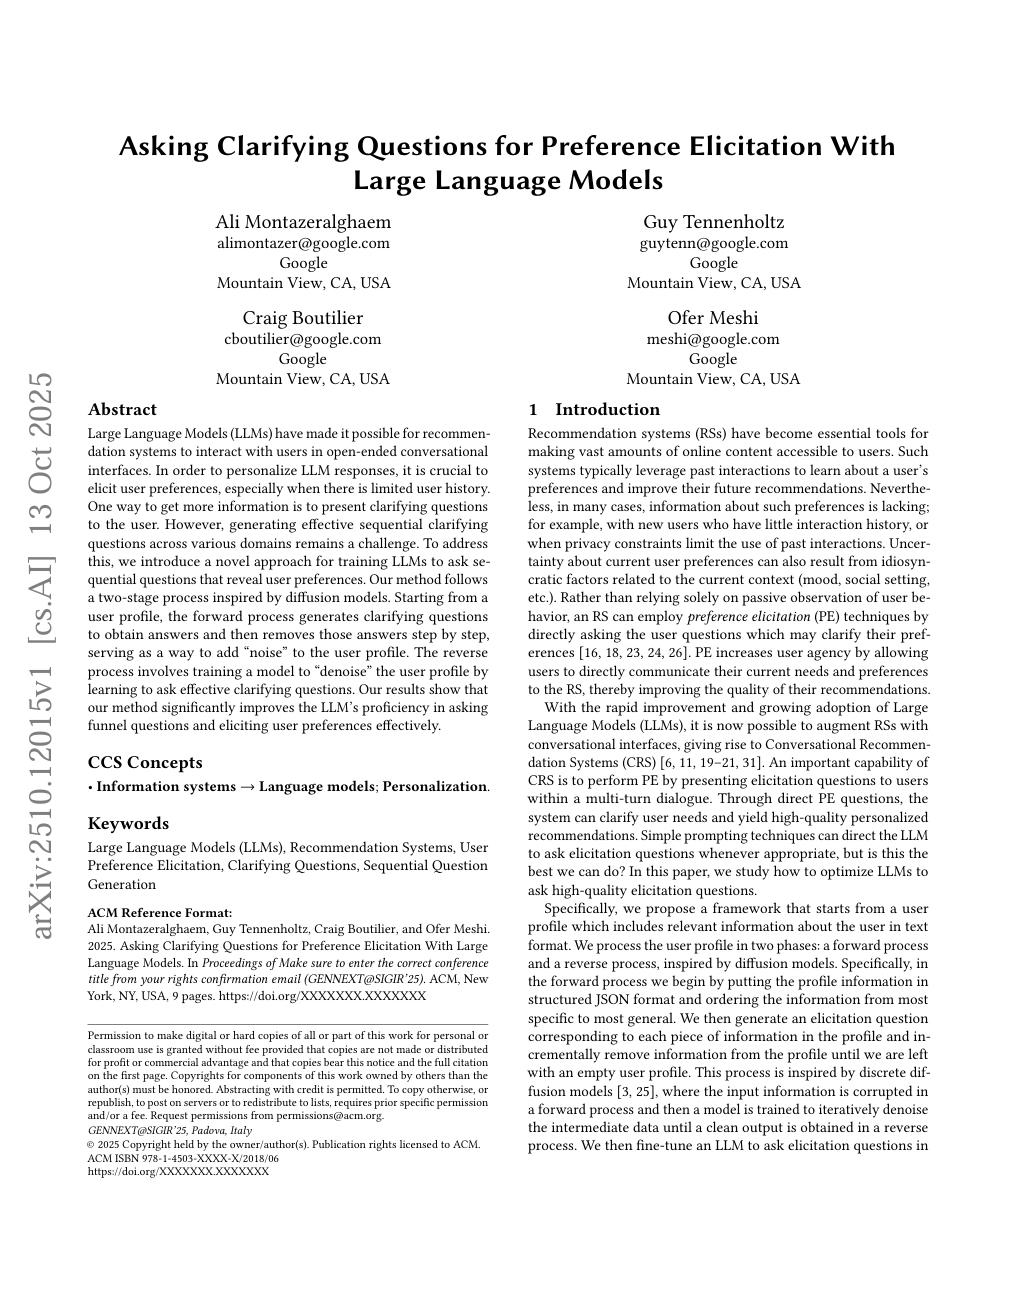
大規模言語モデルを用いた好みの獲得における明確化質問の提示
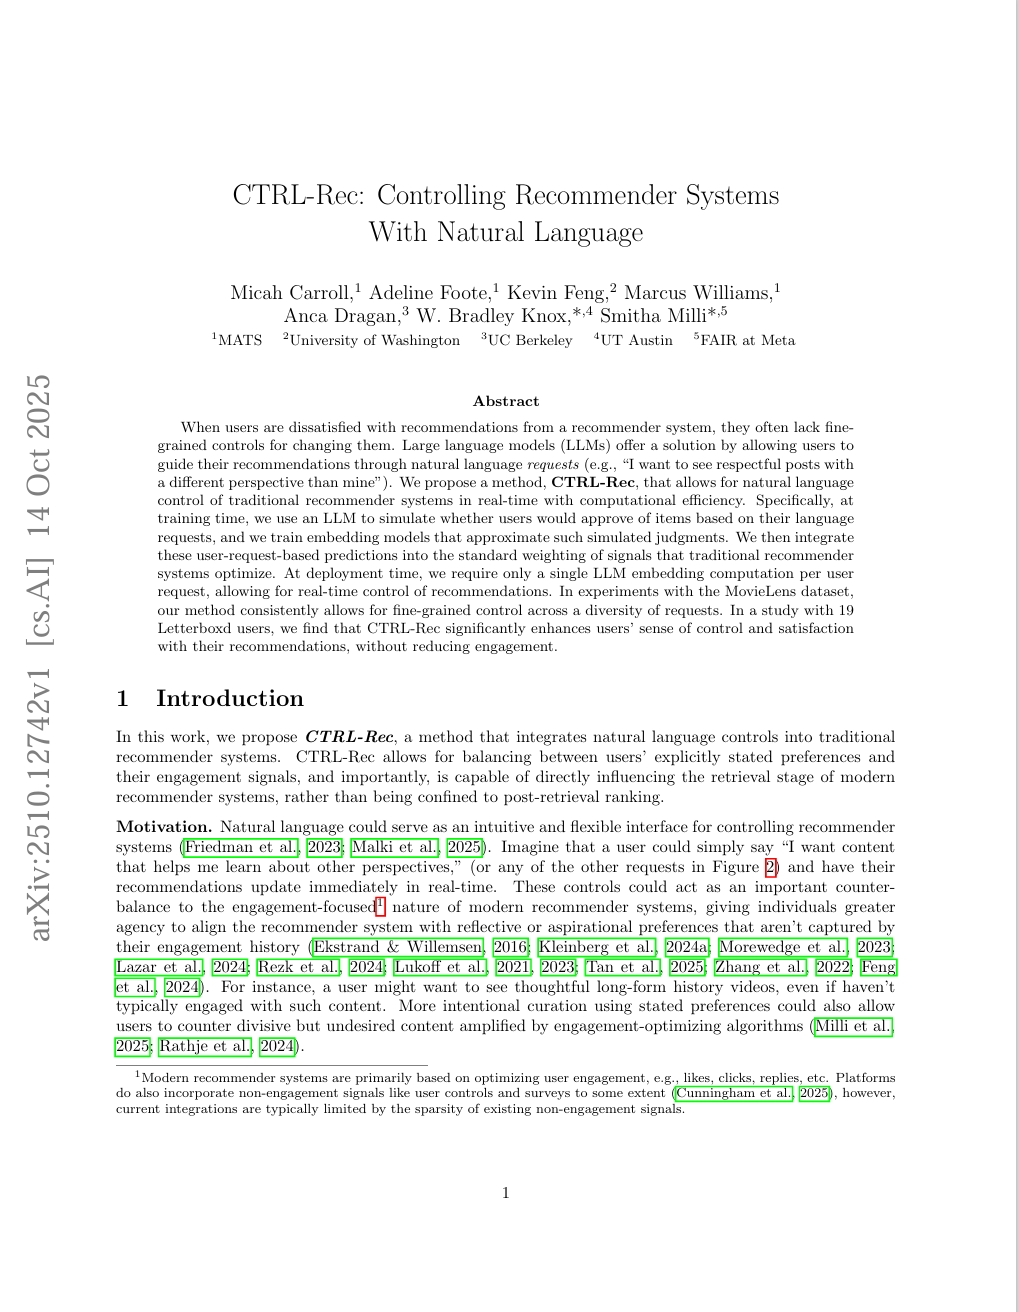
CTRL-Rec:自然言語によるレコメンデーションシステムの制御
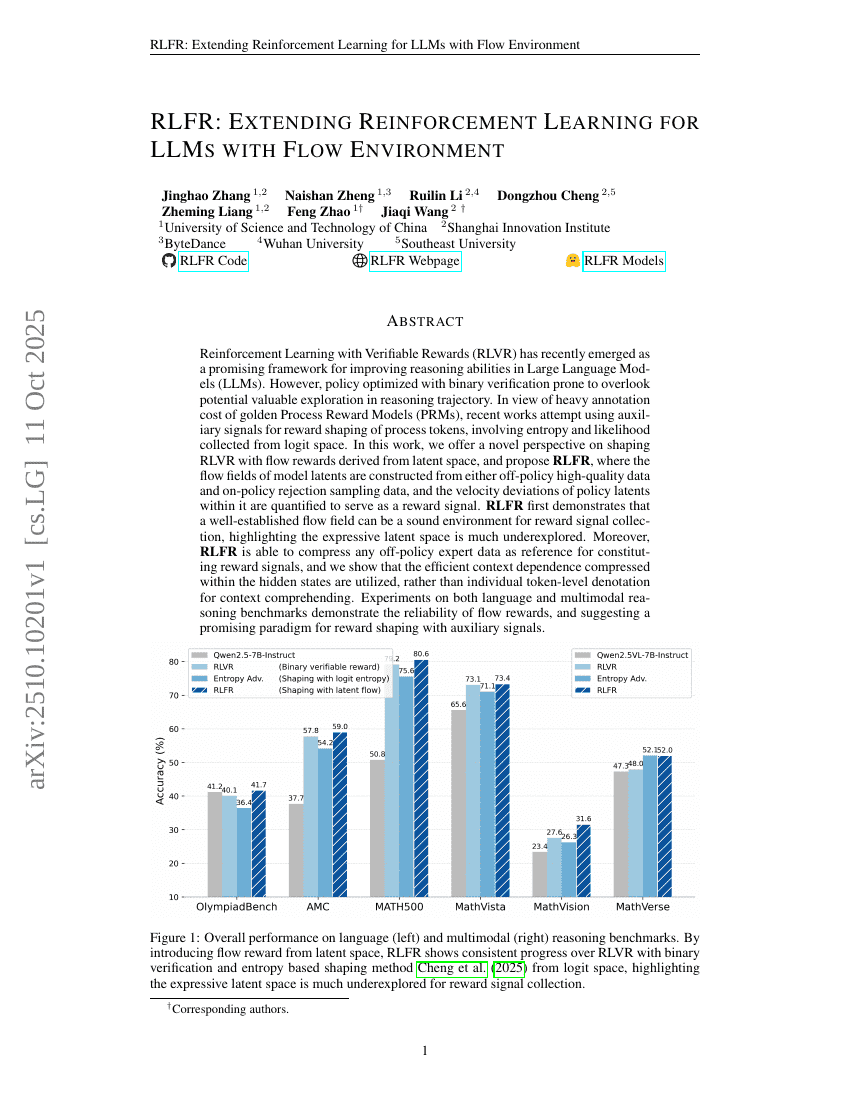
RLFR:フローエンバイロメントを用いた大規模言語モデル向け強化学習の拡張
潜在精製デコーディング:信念状態の精製による拡散型言語モデルの性能向上
OmniVideoBench:オムニマルチモーダル大規模言語モデルにおける音声視覚理解評価への道標
BEAR:原子的な身体的機能を備えたマルチモーダル言語モデルのベンチマーク設定と性能向上
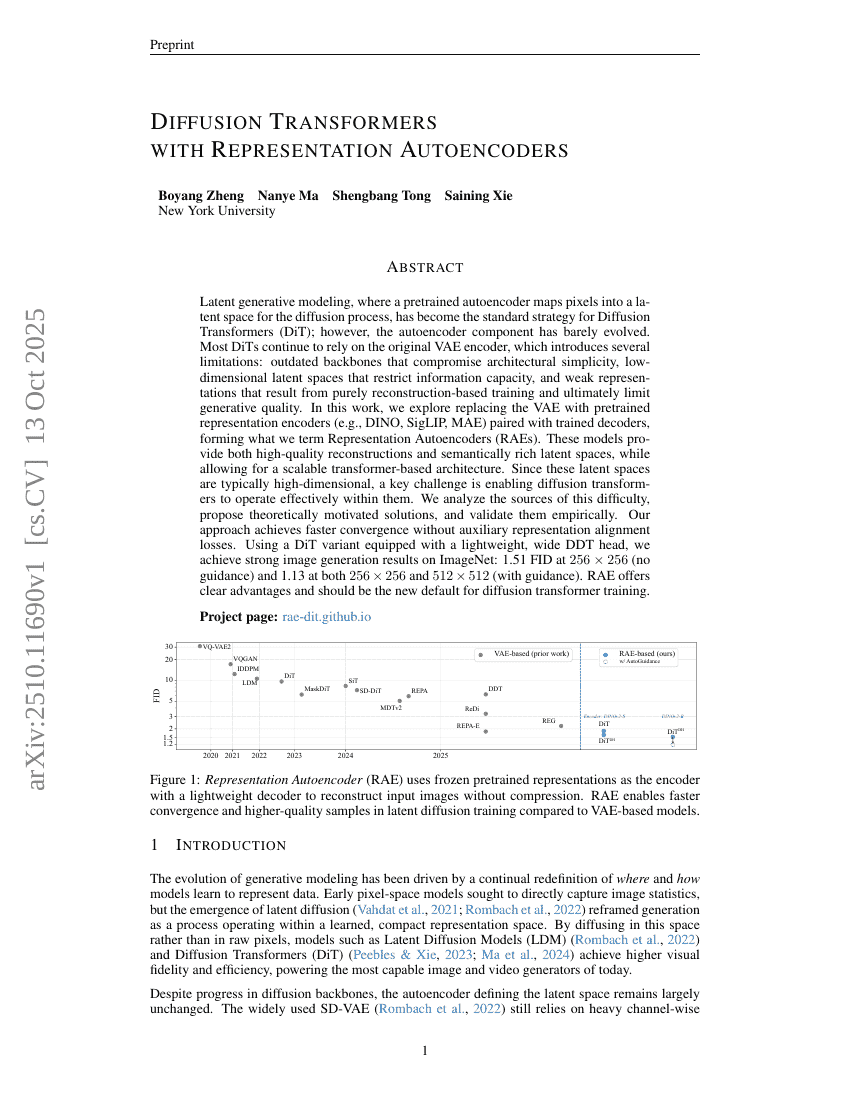
表現自己符号化器を用いた拡散変換器