HyperAI
Command Palette
Search for a command to run...
Papers
最新のAIトレンドを把握するための、日々更新される最先端AI研究論文
論文
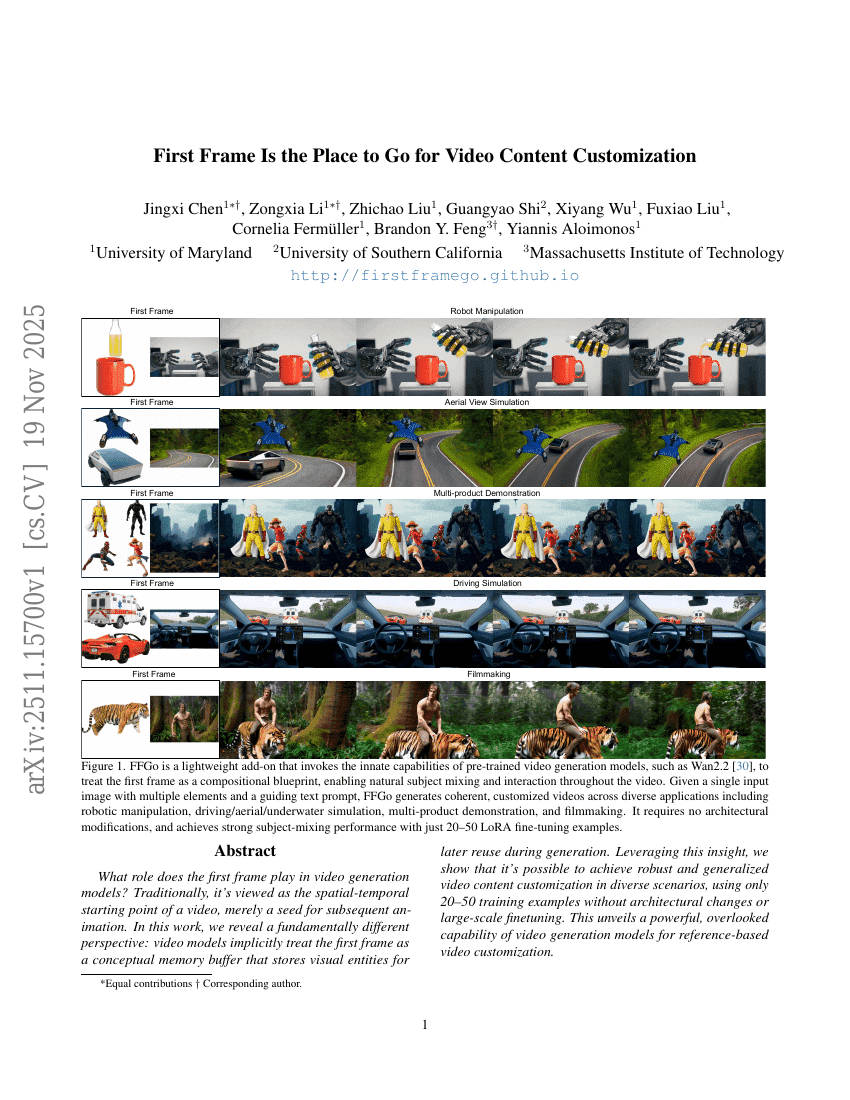
最初のフレームがビデオコンテンツカスタマイズの最適な場所である
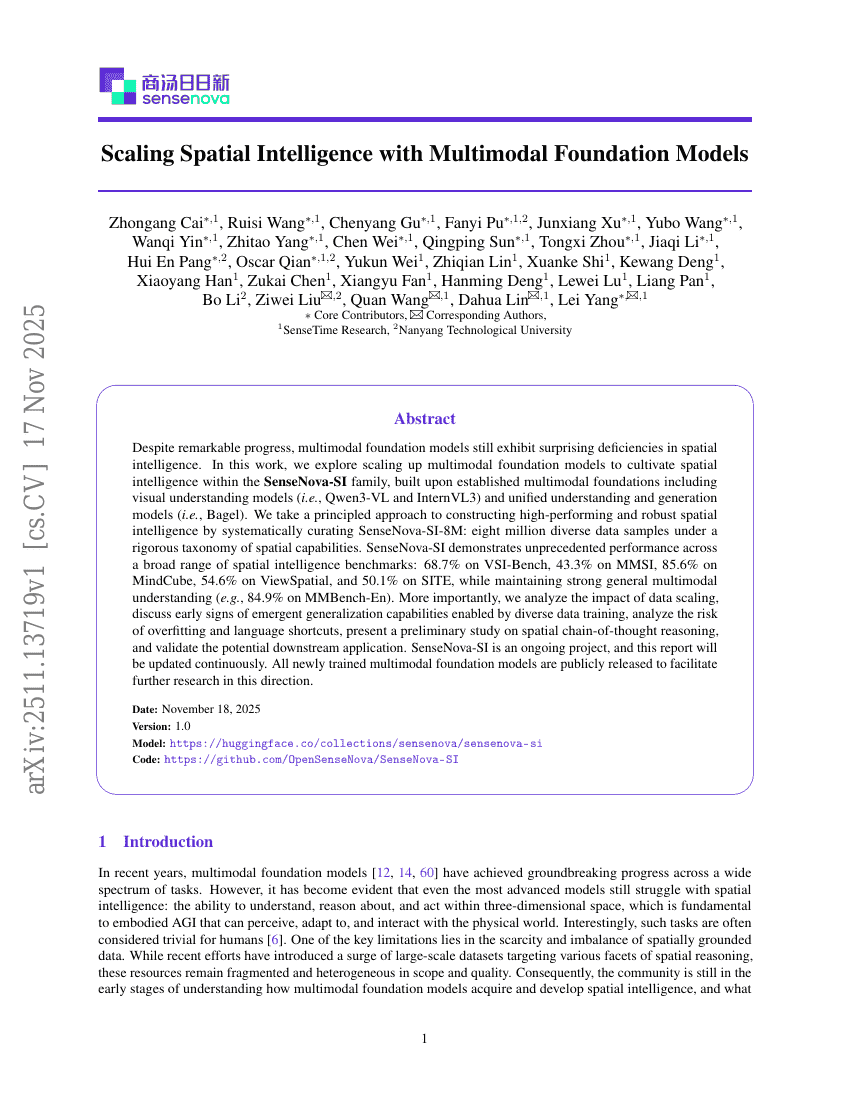
マルチモーダル基礎モデルによる空間知能のスケーリング
Step-Audio-R1 技術レポート
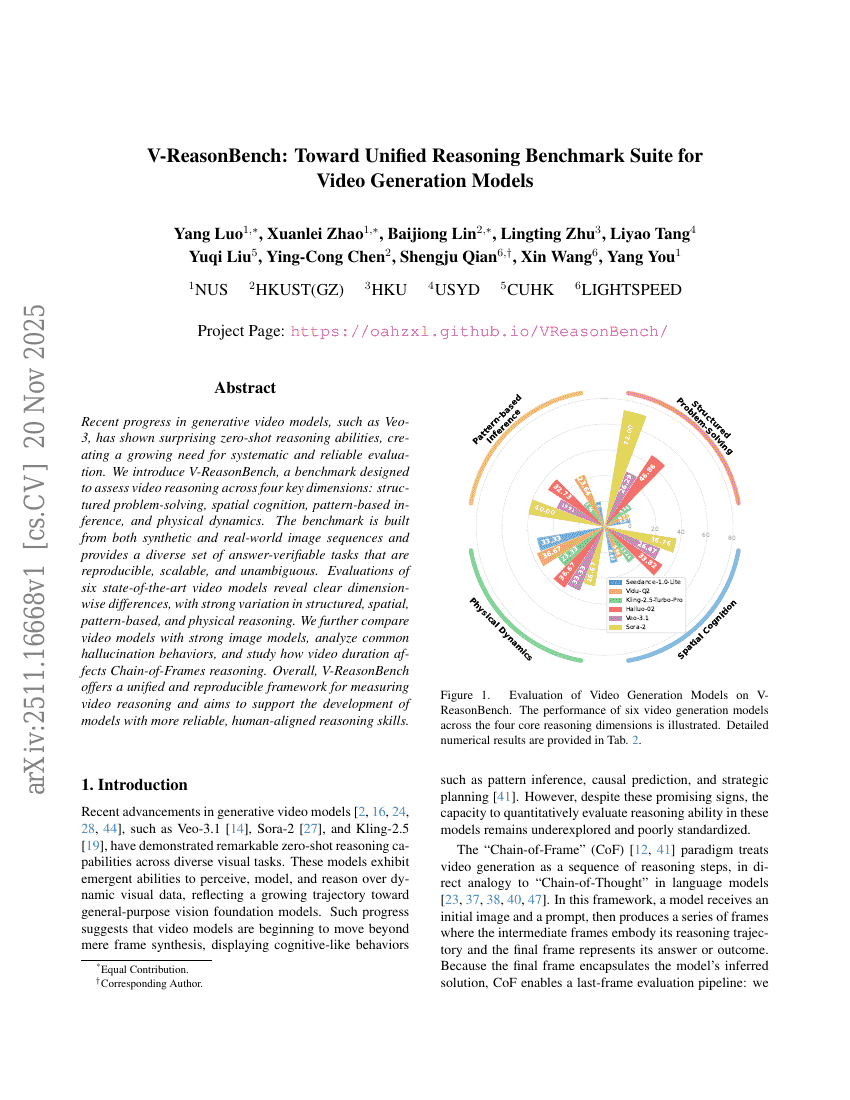
V-ReasonBench:動画生成モデル向け統合推論ベンチマークセットへの道
オルモ3
GPT-5を用いた初期の科学加速実験
医療画像における人工知能のバイアスに対する客観的かつ体系的な評価に向けて
優れたAI研究エージェントとなるために必要なものとは何か?アイデーション多様性の役割を検討する
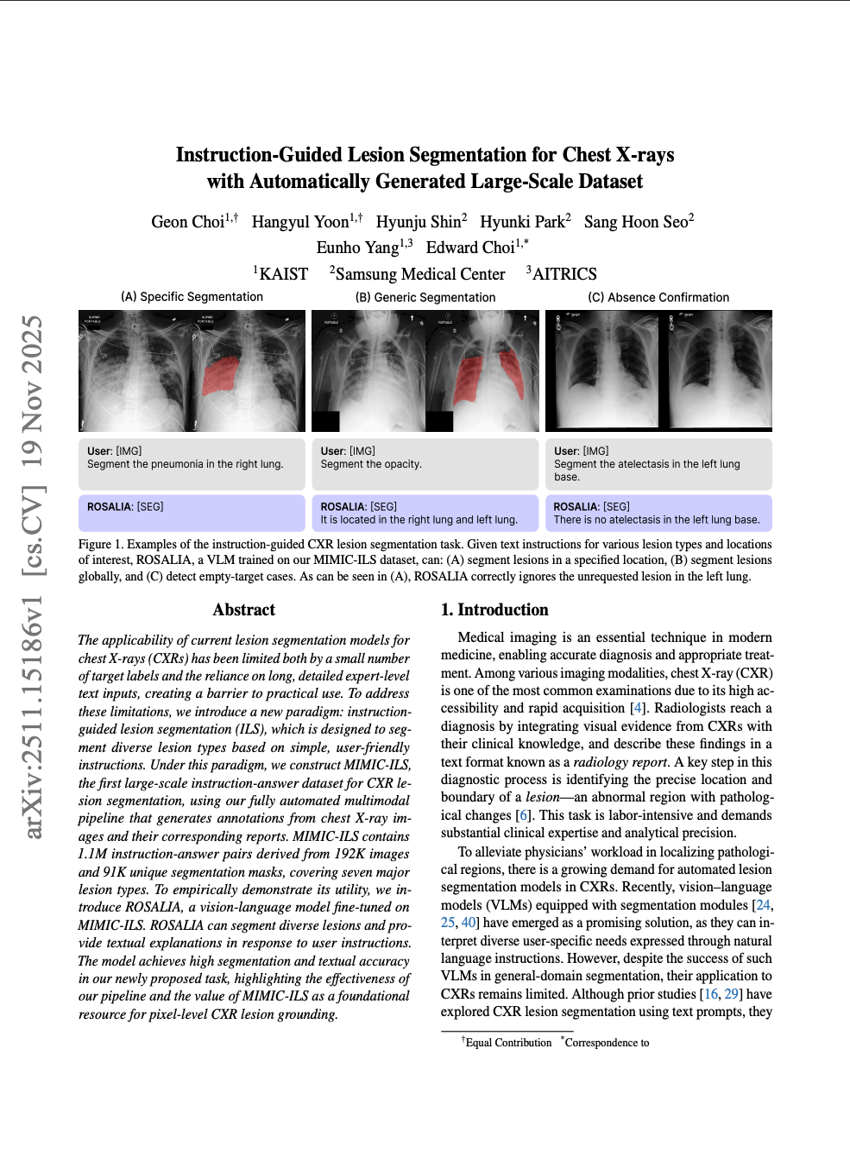
LLMを用いた自動生成大規模データセットを活用した、指示に従う胸部X線画像における病変セグメンテーション
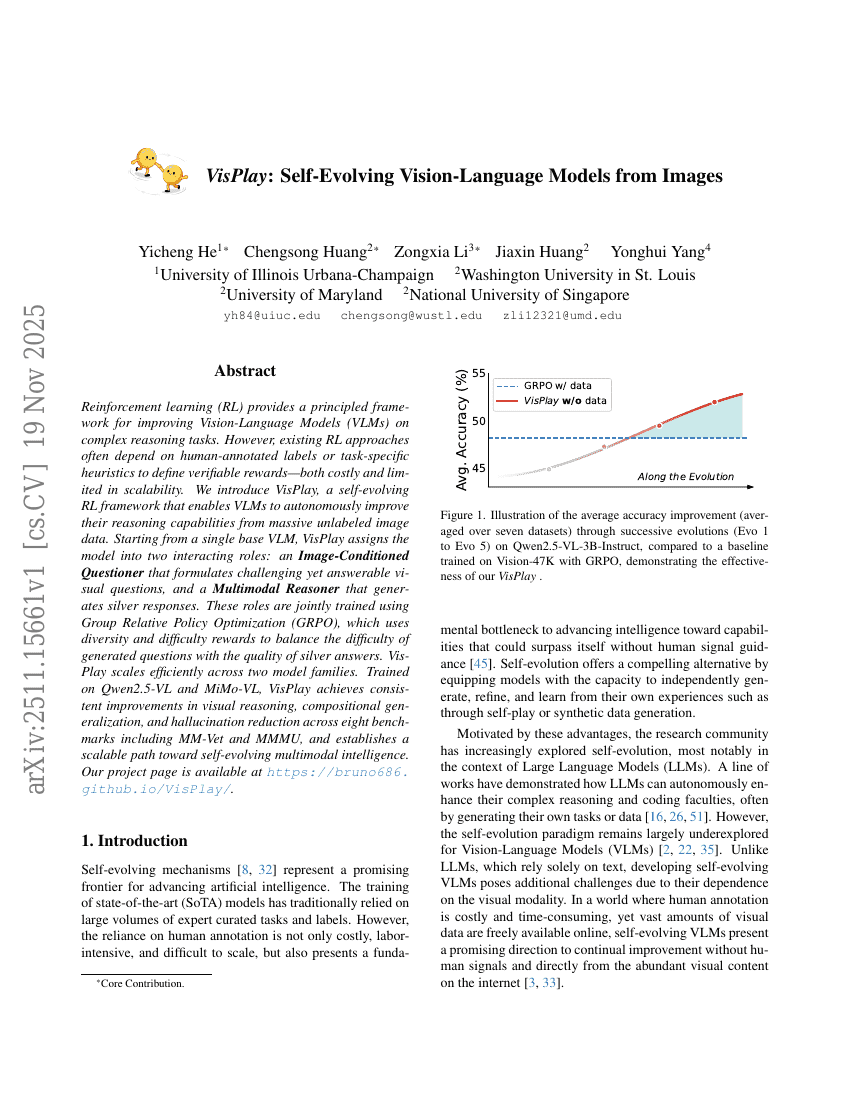
VisPlay:画像から自己進化する視覚言語モデル
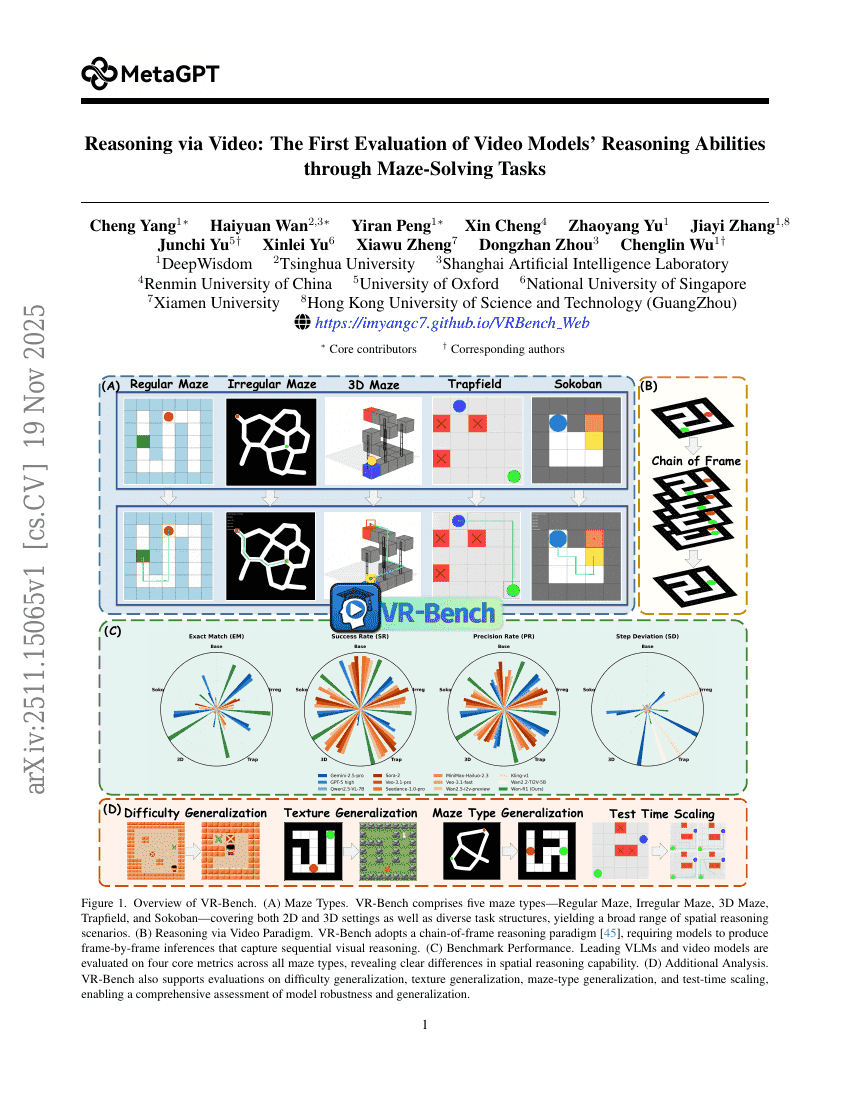
ビデオを用いた推論:迷路解法タスクを用いたビデオモデルの推論能力の初めての評価
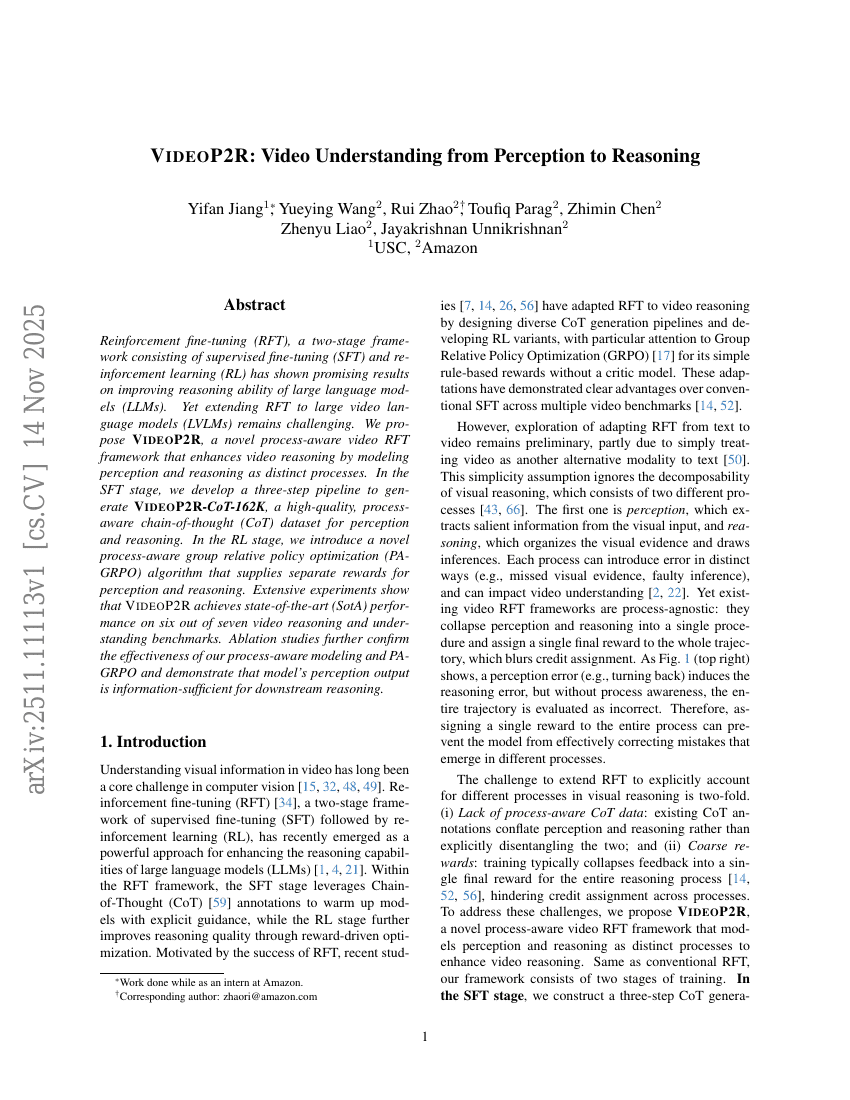
VIDEOP2R:認知から推論への動画理解
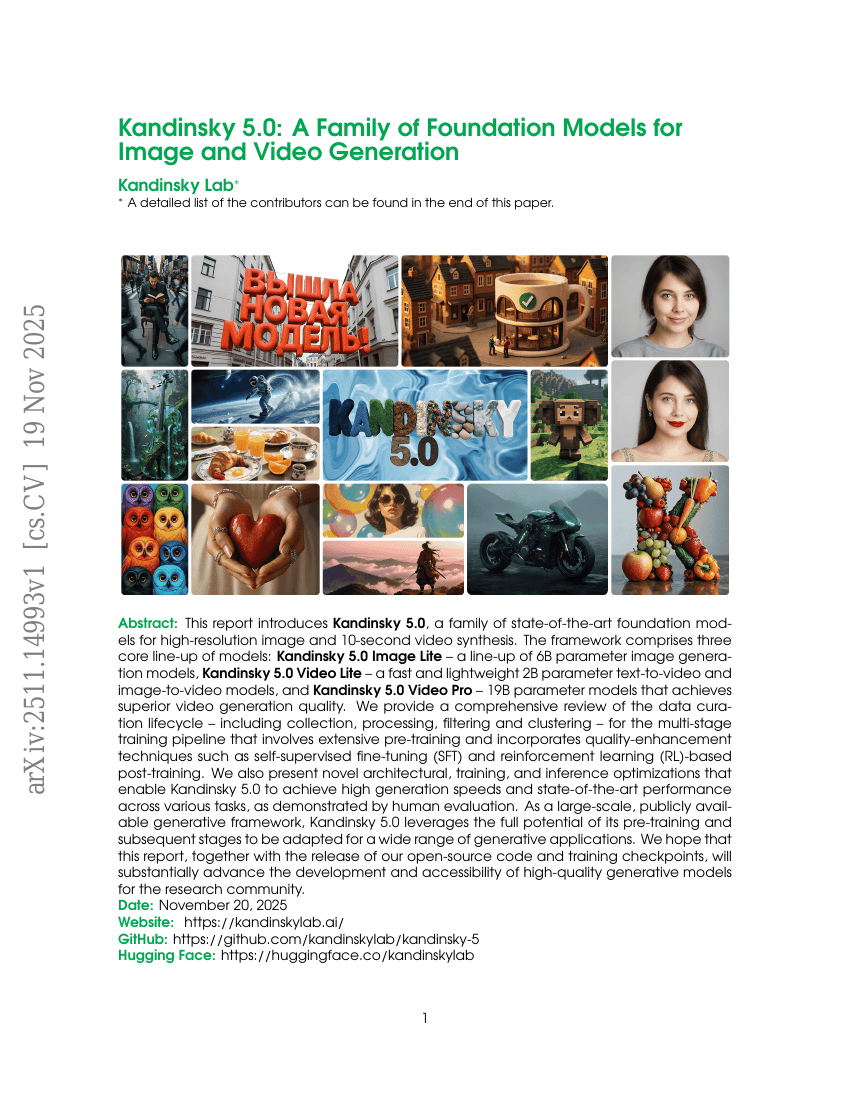
Kandinsky 5.0:画像および動画生成のためのファミリーファウンデーションモデル
JAM-2:高い成功率を示す薬物様抗体の完全計算設計
PathMind:大規模言語モデルを用いた知識グラフ推論のためのRetrieve-Prioritize-Reasonフレームワーク
レビューア:テキスト的内省を越えて、長編動画理解におけるマルチモーダル内省的推論へ
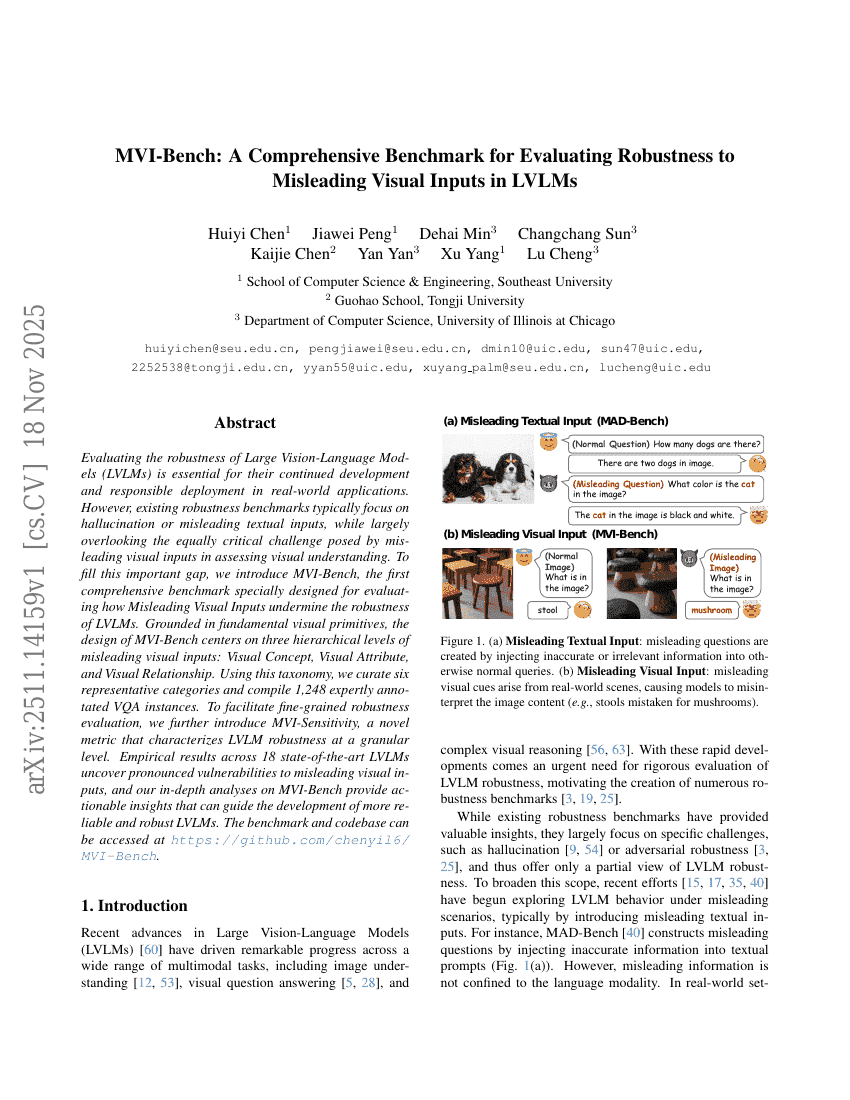
MVI-Bench:LVLMにおける誤った視覚入力に対するロバスト性評価のための包括的ベンチマーク
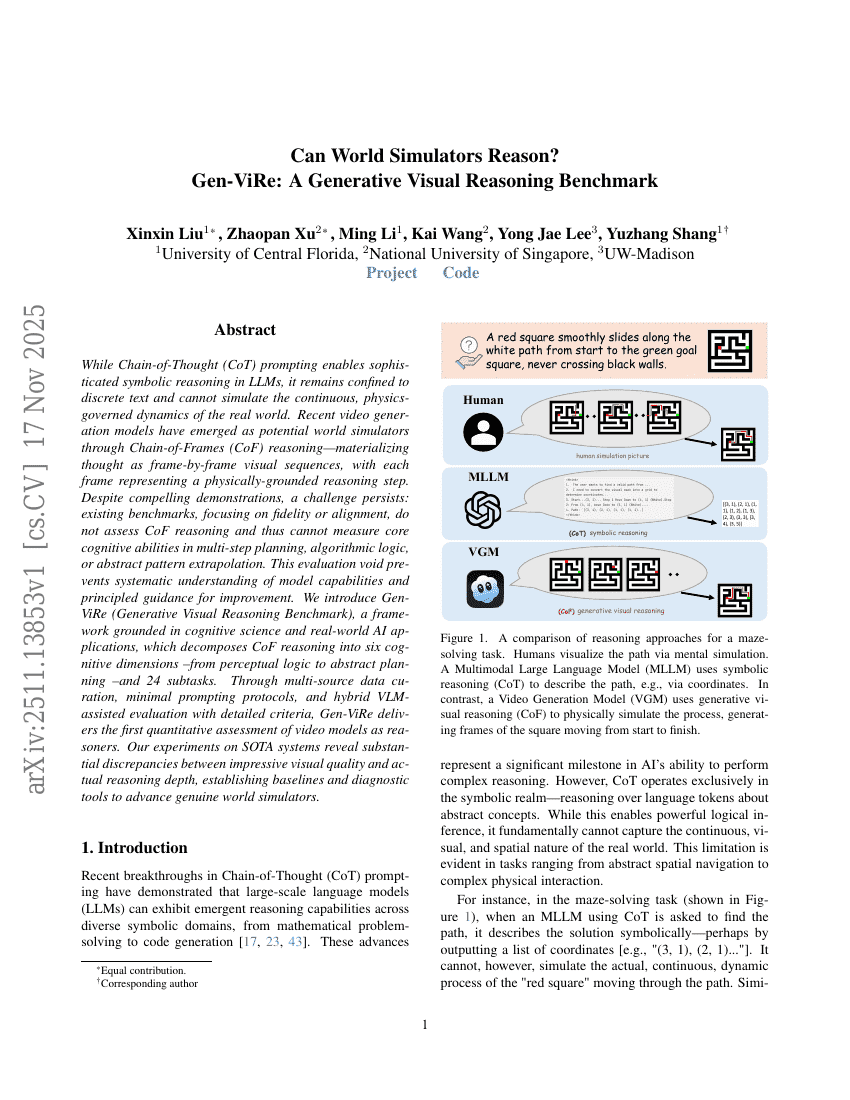
世界シミュレータは推論できるか?Gen-ViRe:生成型視覚推論ベンチマーク
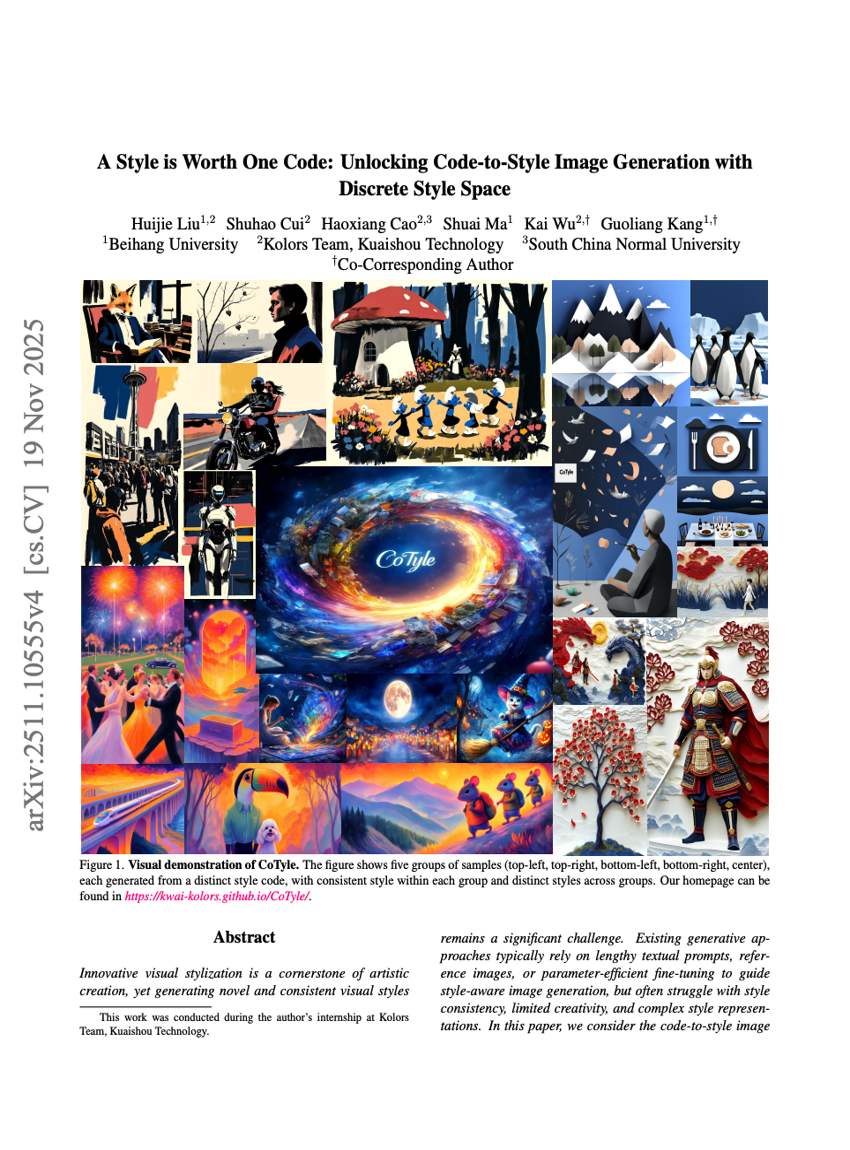
スタイル1つでコード1つに相当する:離散的スタイル空間を活用したコードからスタイル画像への生成
AraLingBench:大規模言語モデルのアラビア語言語能力を評価するためのヒューマンアノテートベンチマーク
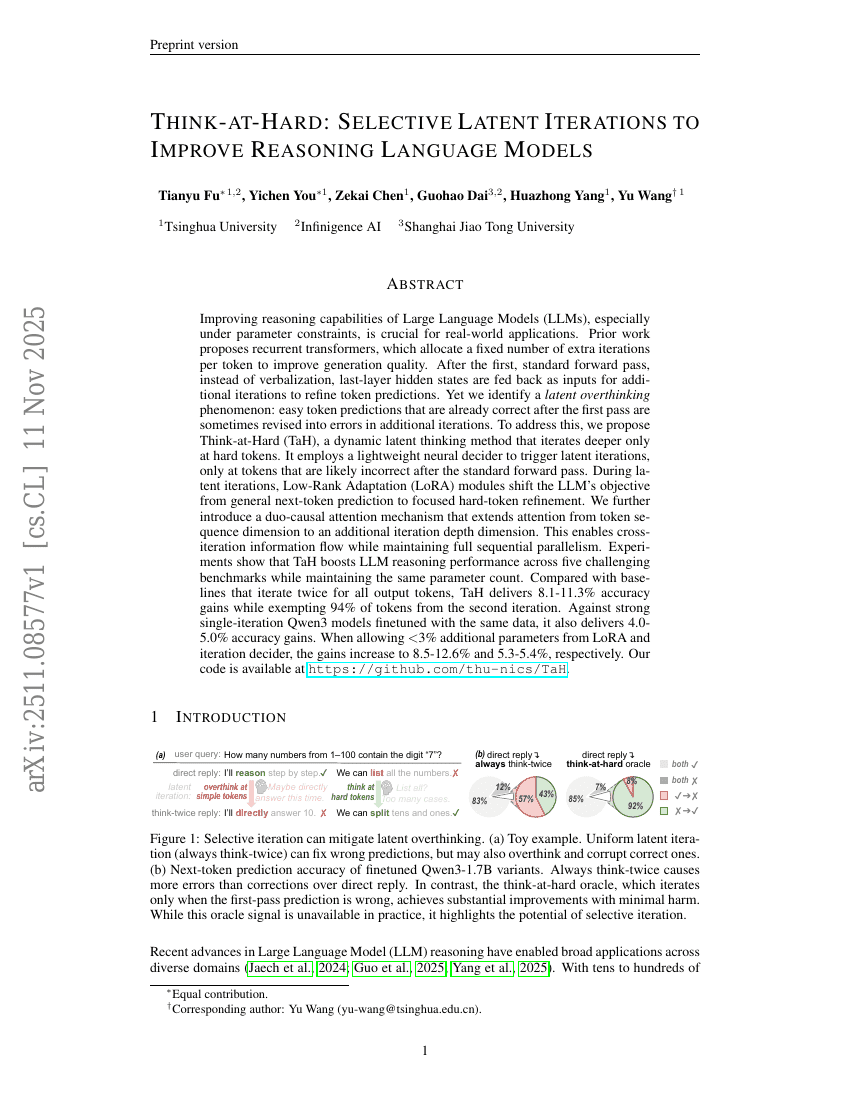
Think-at-Hard:推論言語モデルの性能向上のための選択的ラテン反復手法
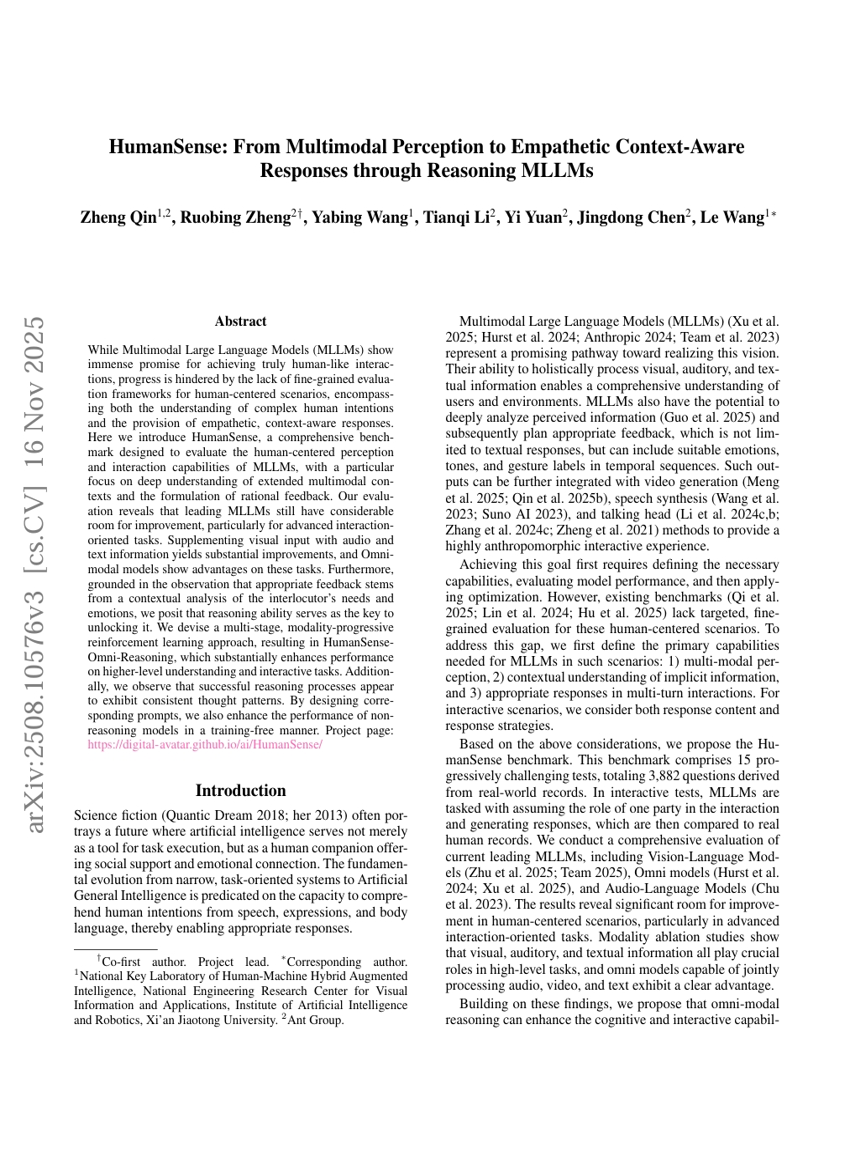
HumanSense:推論型MLLMを活用したマルチモーダル知覚から共感的で文脈に配慮した応答へ
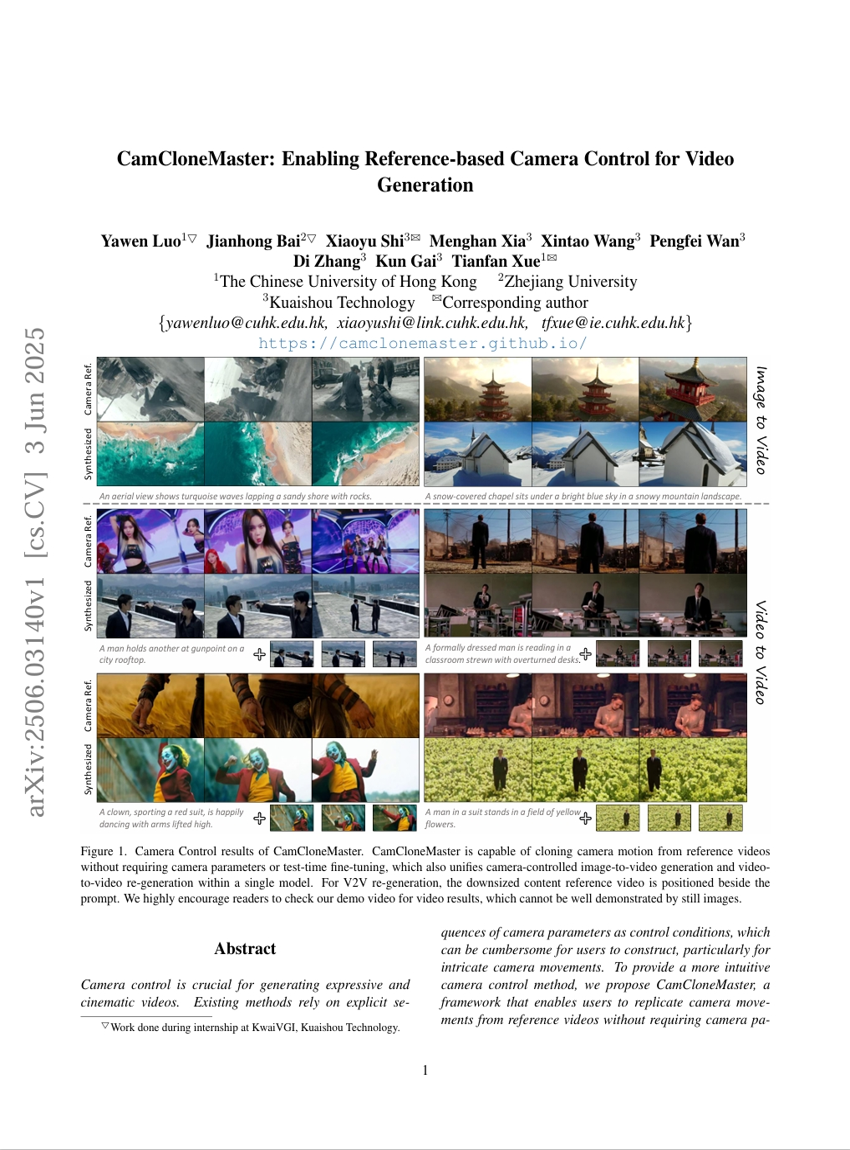
CamCloneMaster:ビデオ生成におけるリファレンスベースカメラ制御を可能にする
EditScore:高忠実度報酬モデリングによる画像編集向けオンライン強化学習の解禁
InteractMove:可動物体を有する3Dシーンにおけるテキスト制御型人間-物体インタラクション生成
WebCoach:セッション間メモリガイダンスを備えた自己進化型Webエージェント
信頼する力を学ぶ:順次的意思決定における提示者の信頼性の変動へのベイズ的適応
GroupRank:強化学習によって駆動されるグループワイドな再ランク付け枠組み
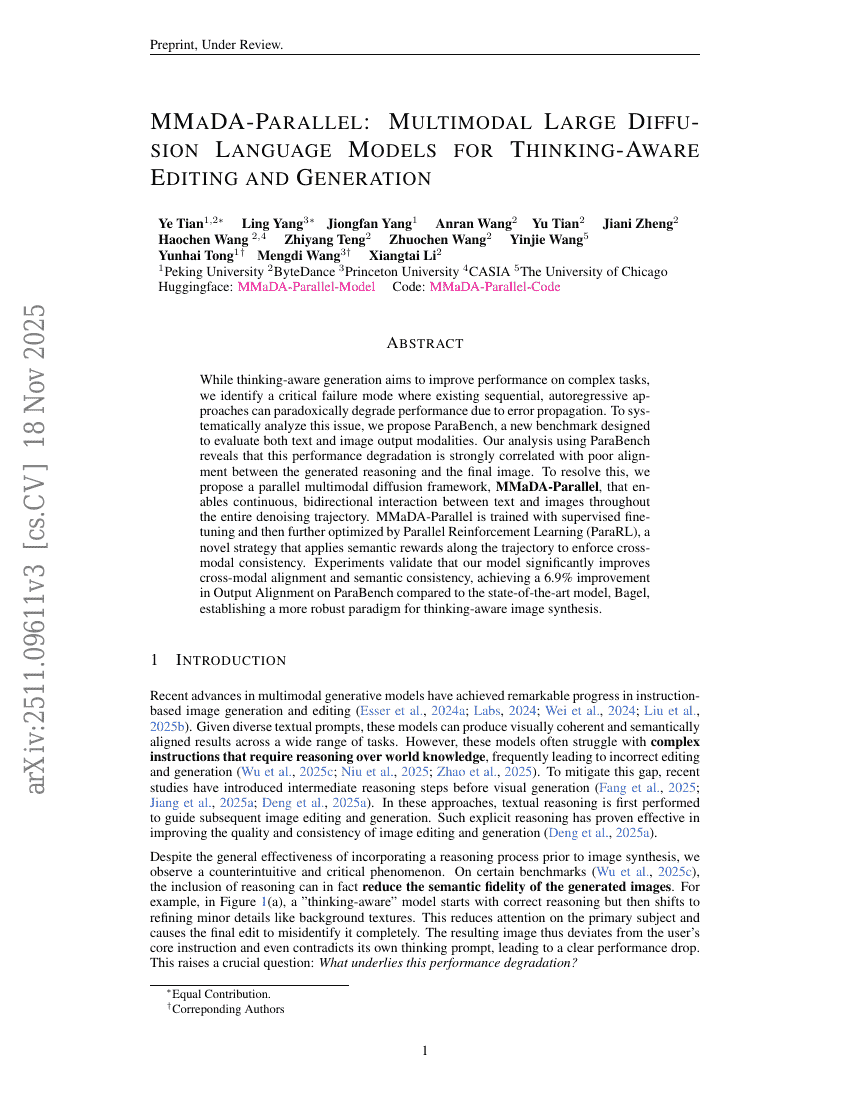
MMaDA-Parallel:思考認識型編集・生成のためのマルチモーダル大規模拡散言語モデル
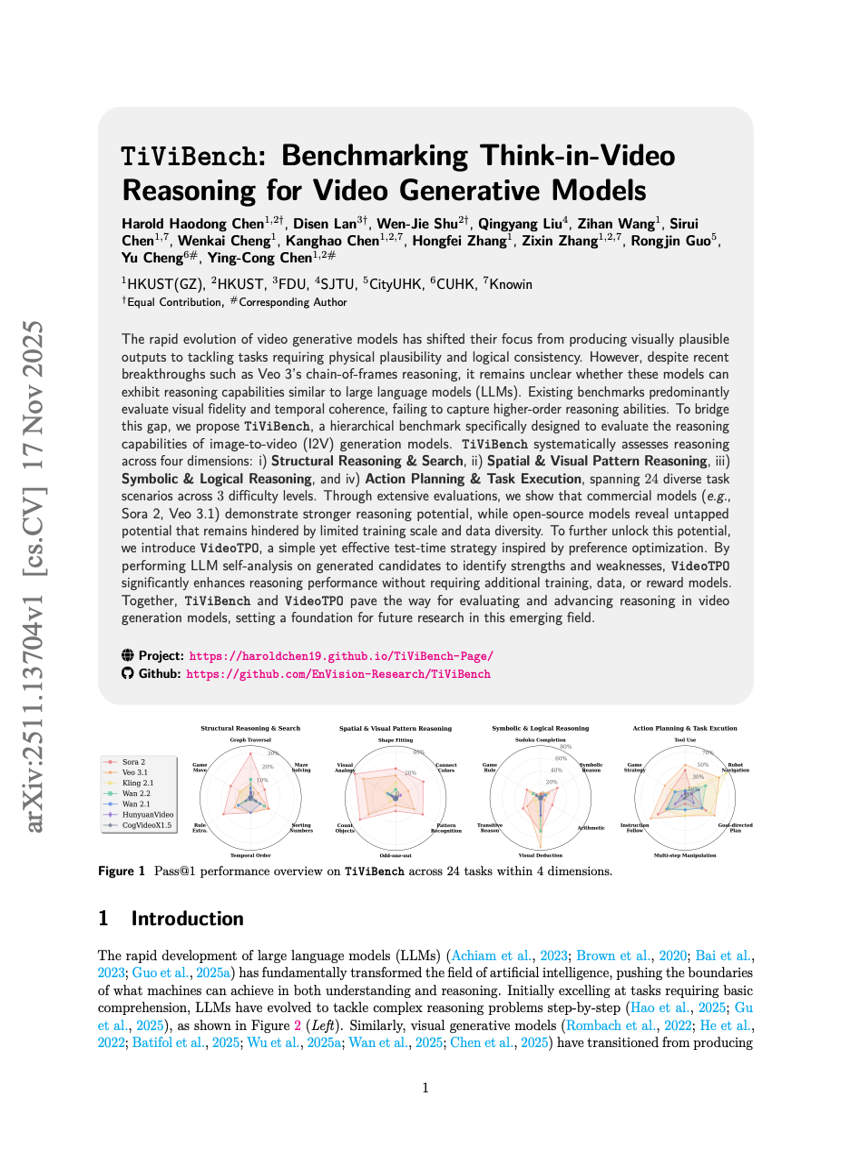
TiViBench:Video生成モデルにおけるThink-in-Video推論のベンチマーク
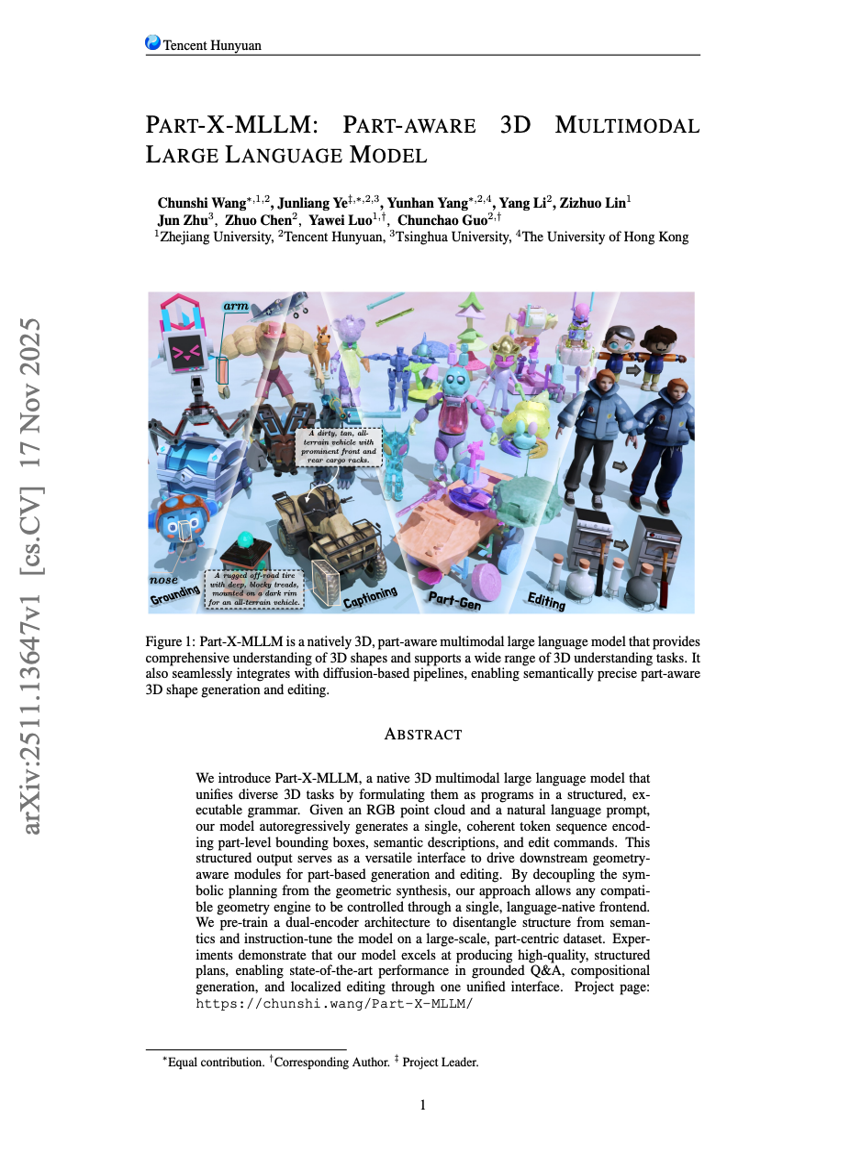
Part-X-MLLM:部位認識型3Dマルチモーダル大規模言語モデル
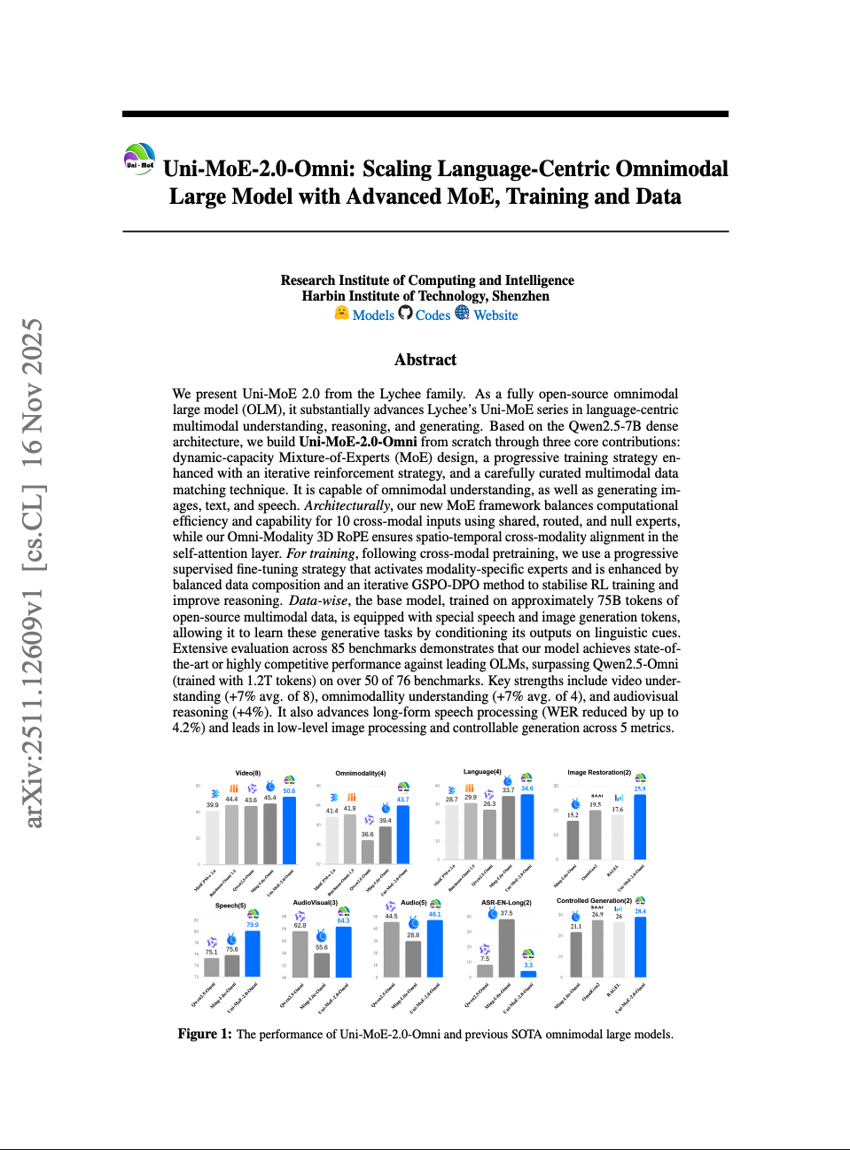
Uni-MoE-2.0-Omni:高度なMoE、トレーニングおよびデータを用いた言語中心型オムニモーダル大規模モデルのスケーリング