Command Palette
Search for a command to run...
Tutoriel En Ligne丨seuls Environ 3B Sont Activés À Chaque Fois, La Vitesse De Décodage Sur Appareil De MiniCPM-V 4.7 Atteint 13+ tokens/s
Si les modèles de langage ont permis à l’IA d’apprendre à lire et à s’exprimer, les modèles multimodaux ont encore élargi sa manière de percevoir le monde. De l’identification d’objets dans une image à la lecture de données dans des graphiques, jusqu’à la compréhension d’événements successifs dans une vidéo, le modèle ne traite plus seulement du texte, mais des combinaisons de différentes formes d’informations, qu’il transforme en contenus pouvant être raisonnés et utilisés pour répondre.
MiniCPM-V 4.7, proposé par ModelBest et la communauté OpenBMB, est précisément un modèle multimodal de langage et de vision destiné aux tâches de compréhension visuelle. Il adopte une architecture Mixture of Experts (MoE) 35B-A3B, avec un nombre total de paramètres atteignant 35B, mais seuls environ 3B de paramètres sont activés par token, ce qui permet de conserver les capacités d’un modèle relativement grand tout en contrôlant efficacement le coût de calcul lors de l’inférence.
En matière de compréhension visuelle, MiniCPM-V 4.7 prend en charge la compréhension d’images uniques, d’images multiples et de vidéos, et peut traiter différents types d’entrées visuelles. Le modèle introduit l’encodage positionnel visuel Canvas M-RoPE et des techniques efficaces de compression visuelle, afin de mieux capturer les relations spatiales et les détails dans les images. Face à des contenus visuels complexes, il peut non seulement identifier les objets présents dans l’image, mais aussi comprendre les informations de l’image en contexte et réaliser les tâches de questions-réponses et d’analyse correspondantes.
Plus intéressant encore, un tel modèle avec 35B de paramètres totaux n’a pas nécessairement besoin de grands serveurs pour fonctionner. MiniCPM-V 4.7 a été spécialement optimisé pour l’inférence sur appareil : grâce à des techniques telles que la planification anticipée des experts (Lookahead Expert Scheduling, LES), il améliore l’efficacité d’appel des experts du modèle MoE et permet une inférence fluide sur appareil sans sacrifier les performances du modèle ; combiné à une quantification hiérarchique fine, à l’échantillonnage spéculatif DSpark et à d’autres techniques, il réduit encore les coûts d’exécution. Dans la démonstration officielle, le modèle peut même atteindre une vitesse de décodage de plus de 13 tokens/s avec environ 3 Go de mémoire sur un iPhone 17 Pro Max. Autrement dit, un modèle multimodal n’est pas obligé de rester dans le cloud : il suffit de prendre son téléphone pour expérimenter les capacités de compréhension visuelle.
HyperAI propose désormais « MiniCPM-V 4.7 : grand modèle multimodal de langage et de vision (MoE 35B-A3B) », pour découvrir facilement comment le modèle comprend les images et autres entrées visuelles, et approfondir comment l’architecture Mixture of Experts équilibre, grâce à l’ordonnancement des experts et à l’optimisation de l’inférence, la taille du modèle, le coût de calcul et l’efficacité d’exécution réelle.
Exécution en ligne :
Plus de tutoriels en ligne :
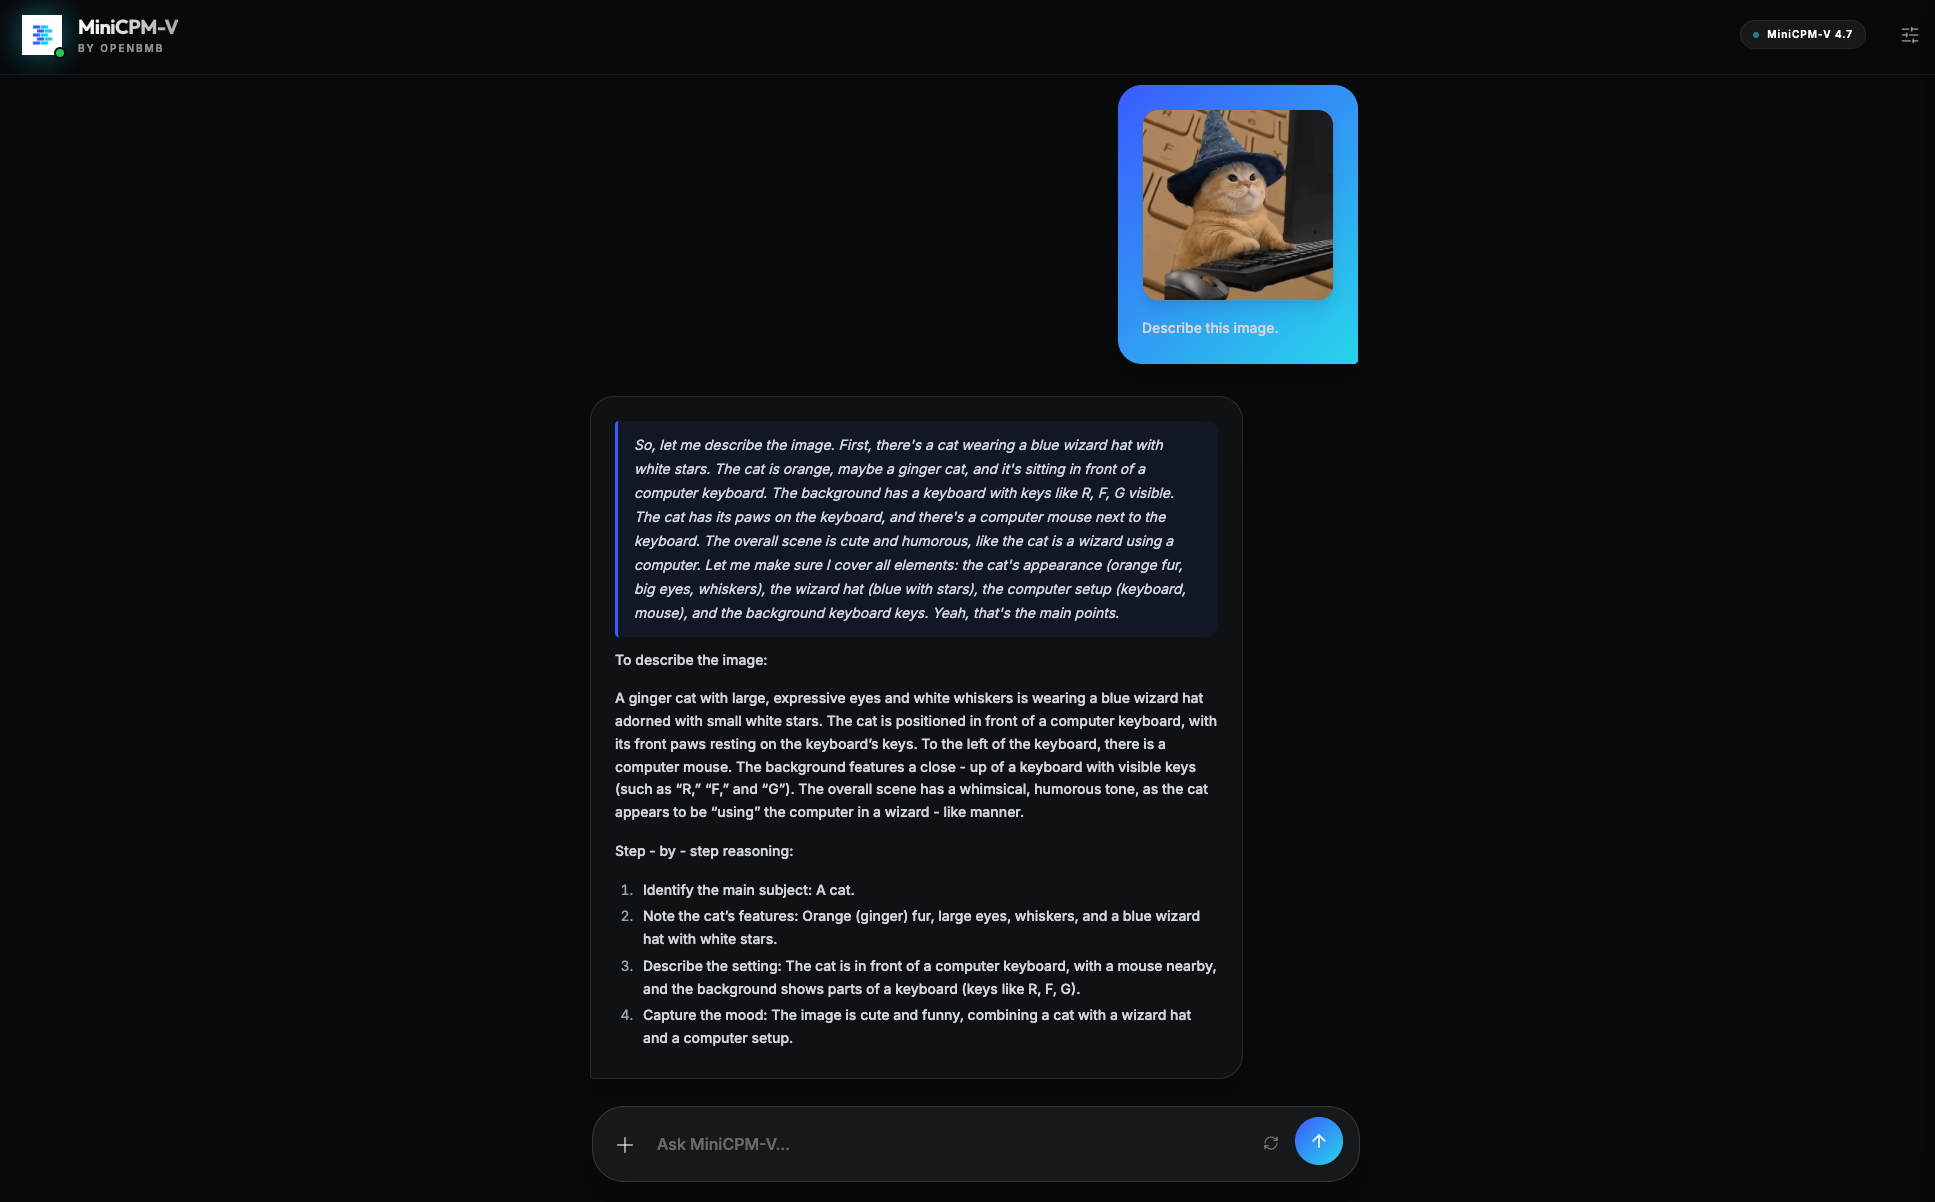
Exécution de la démo
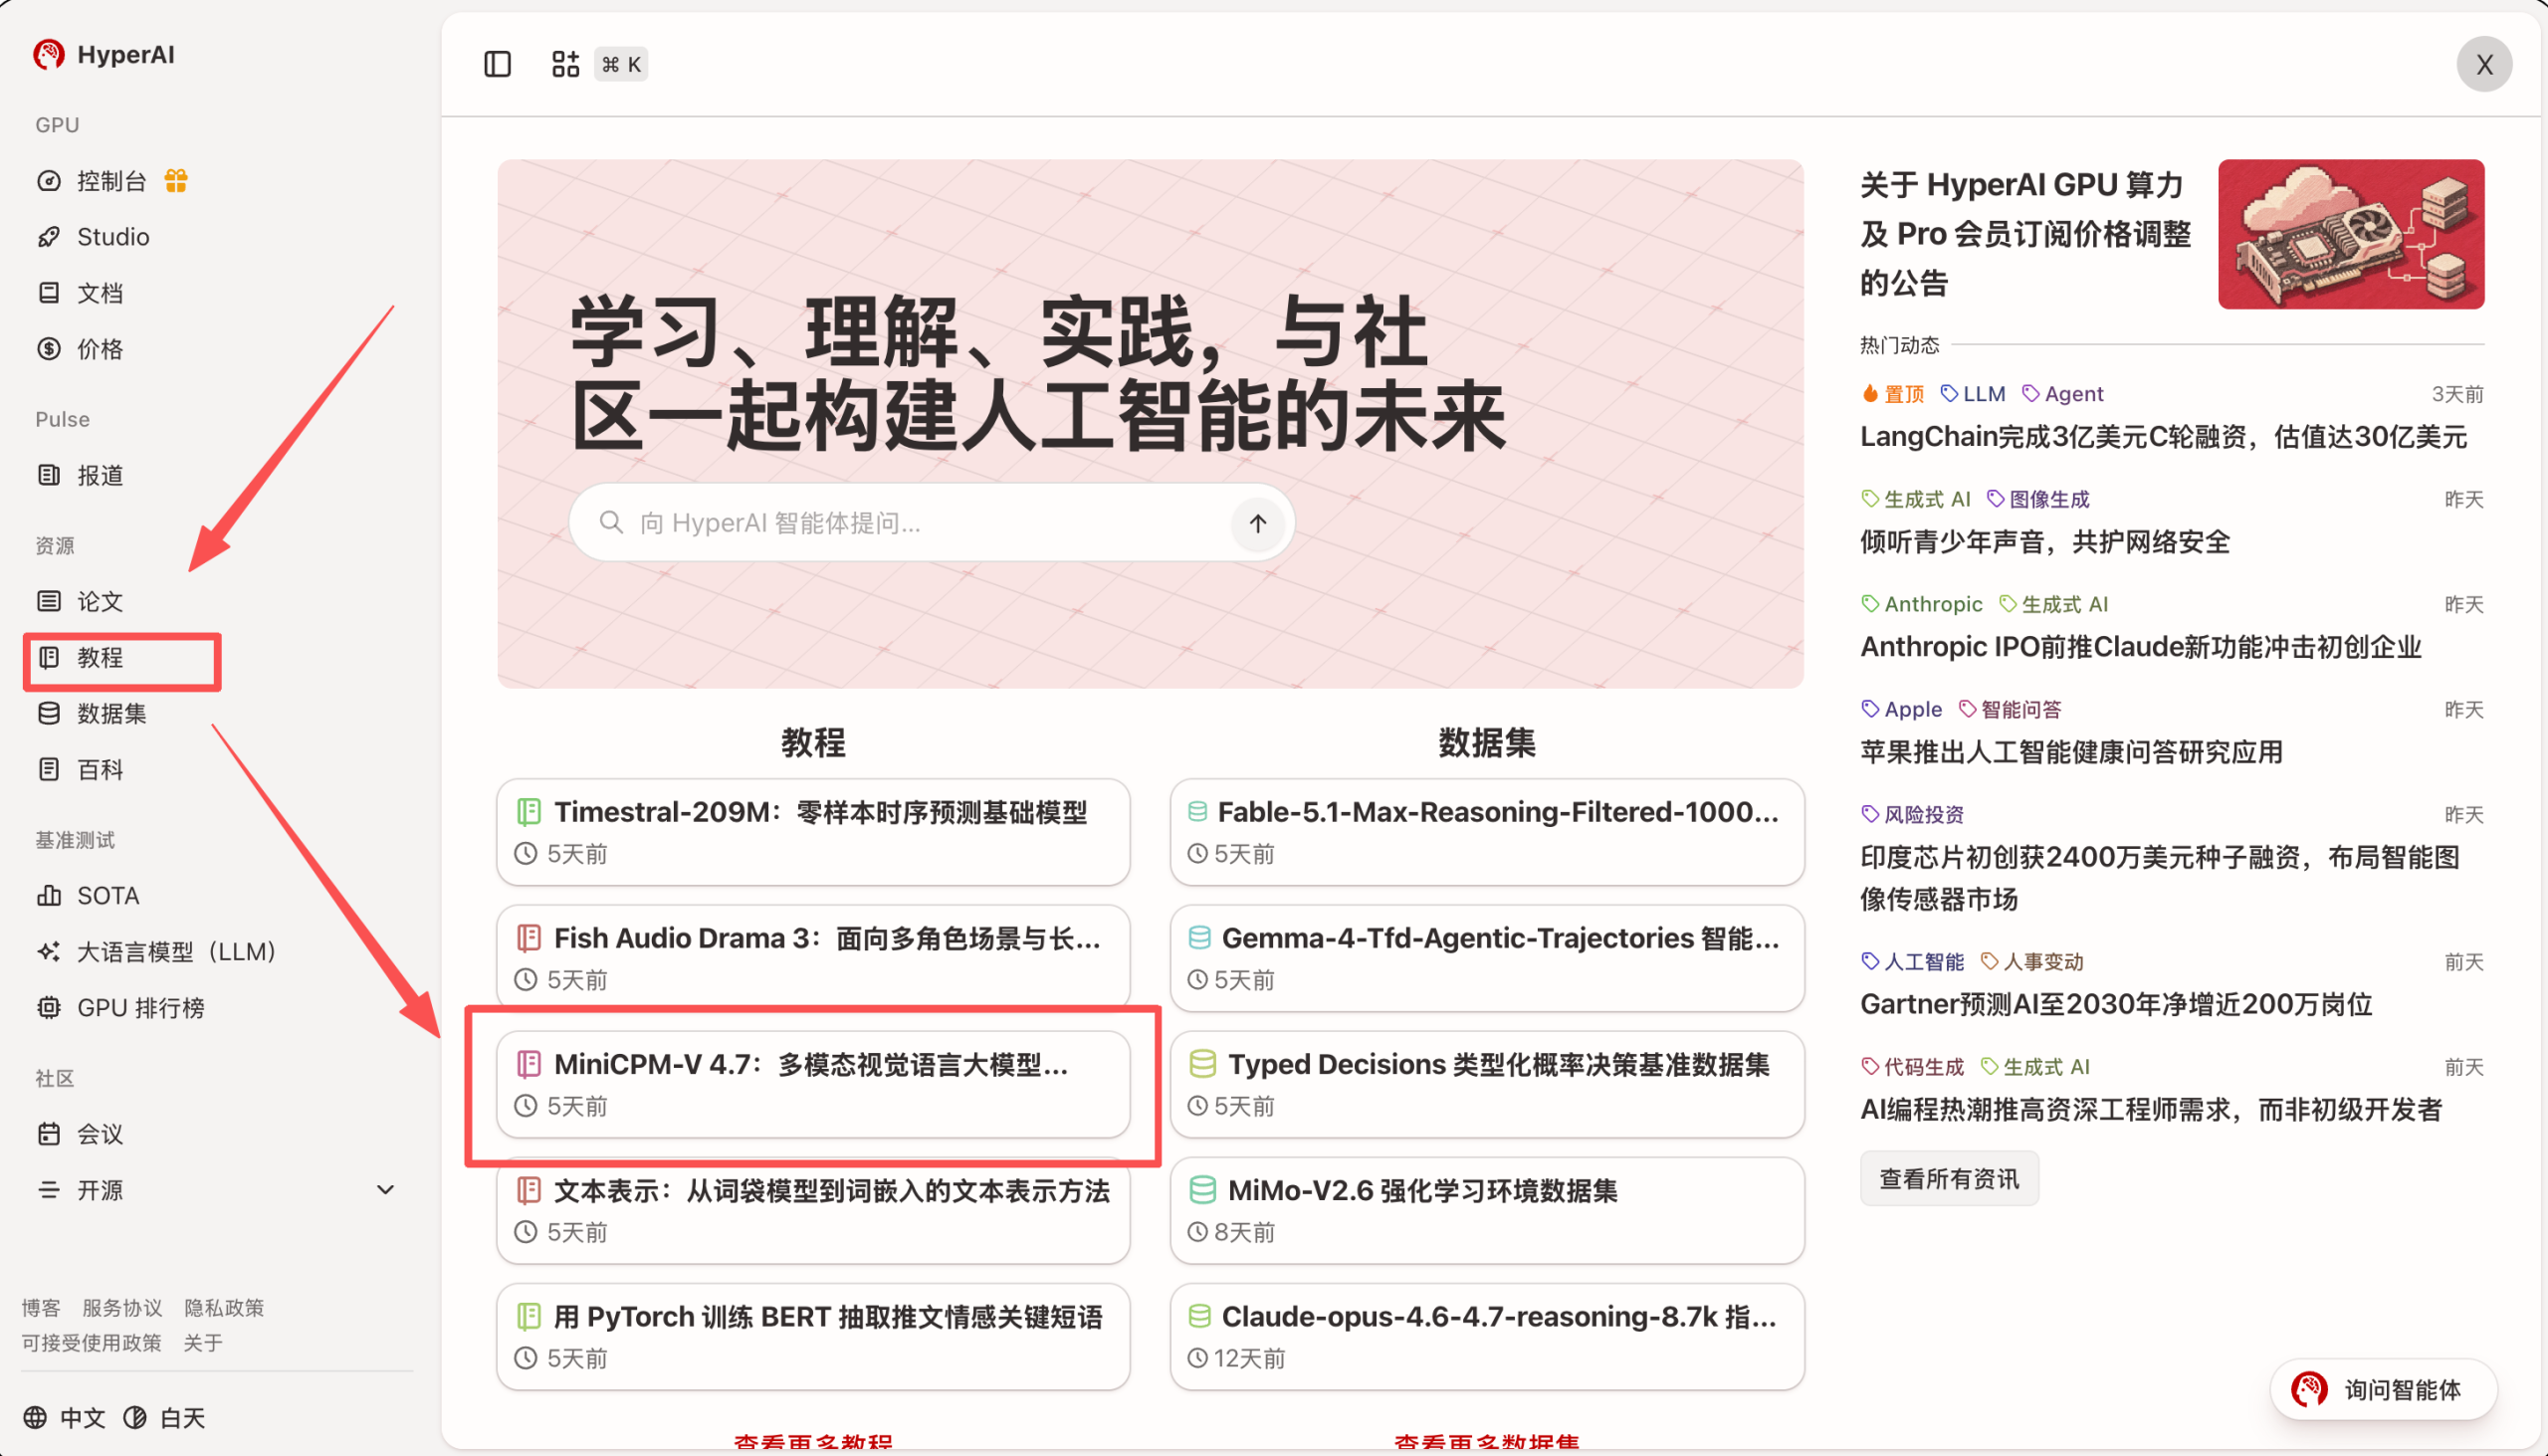
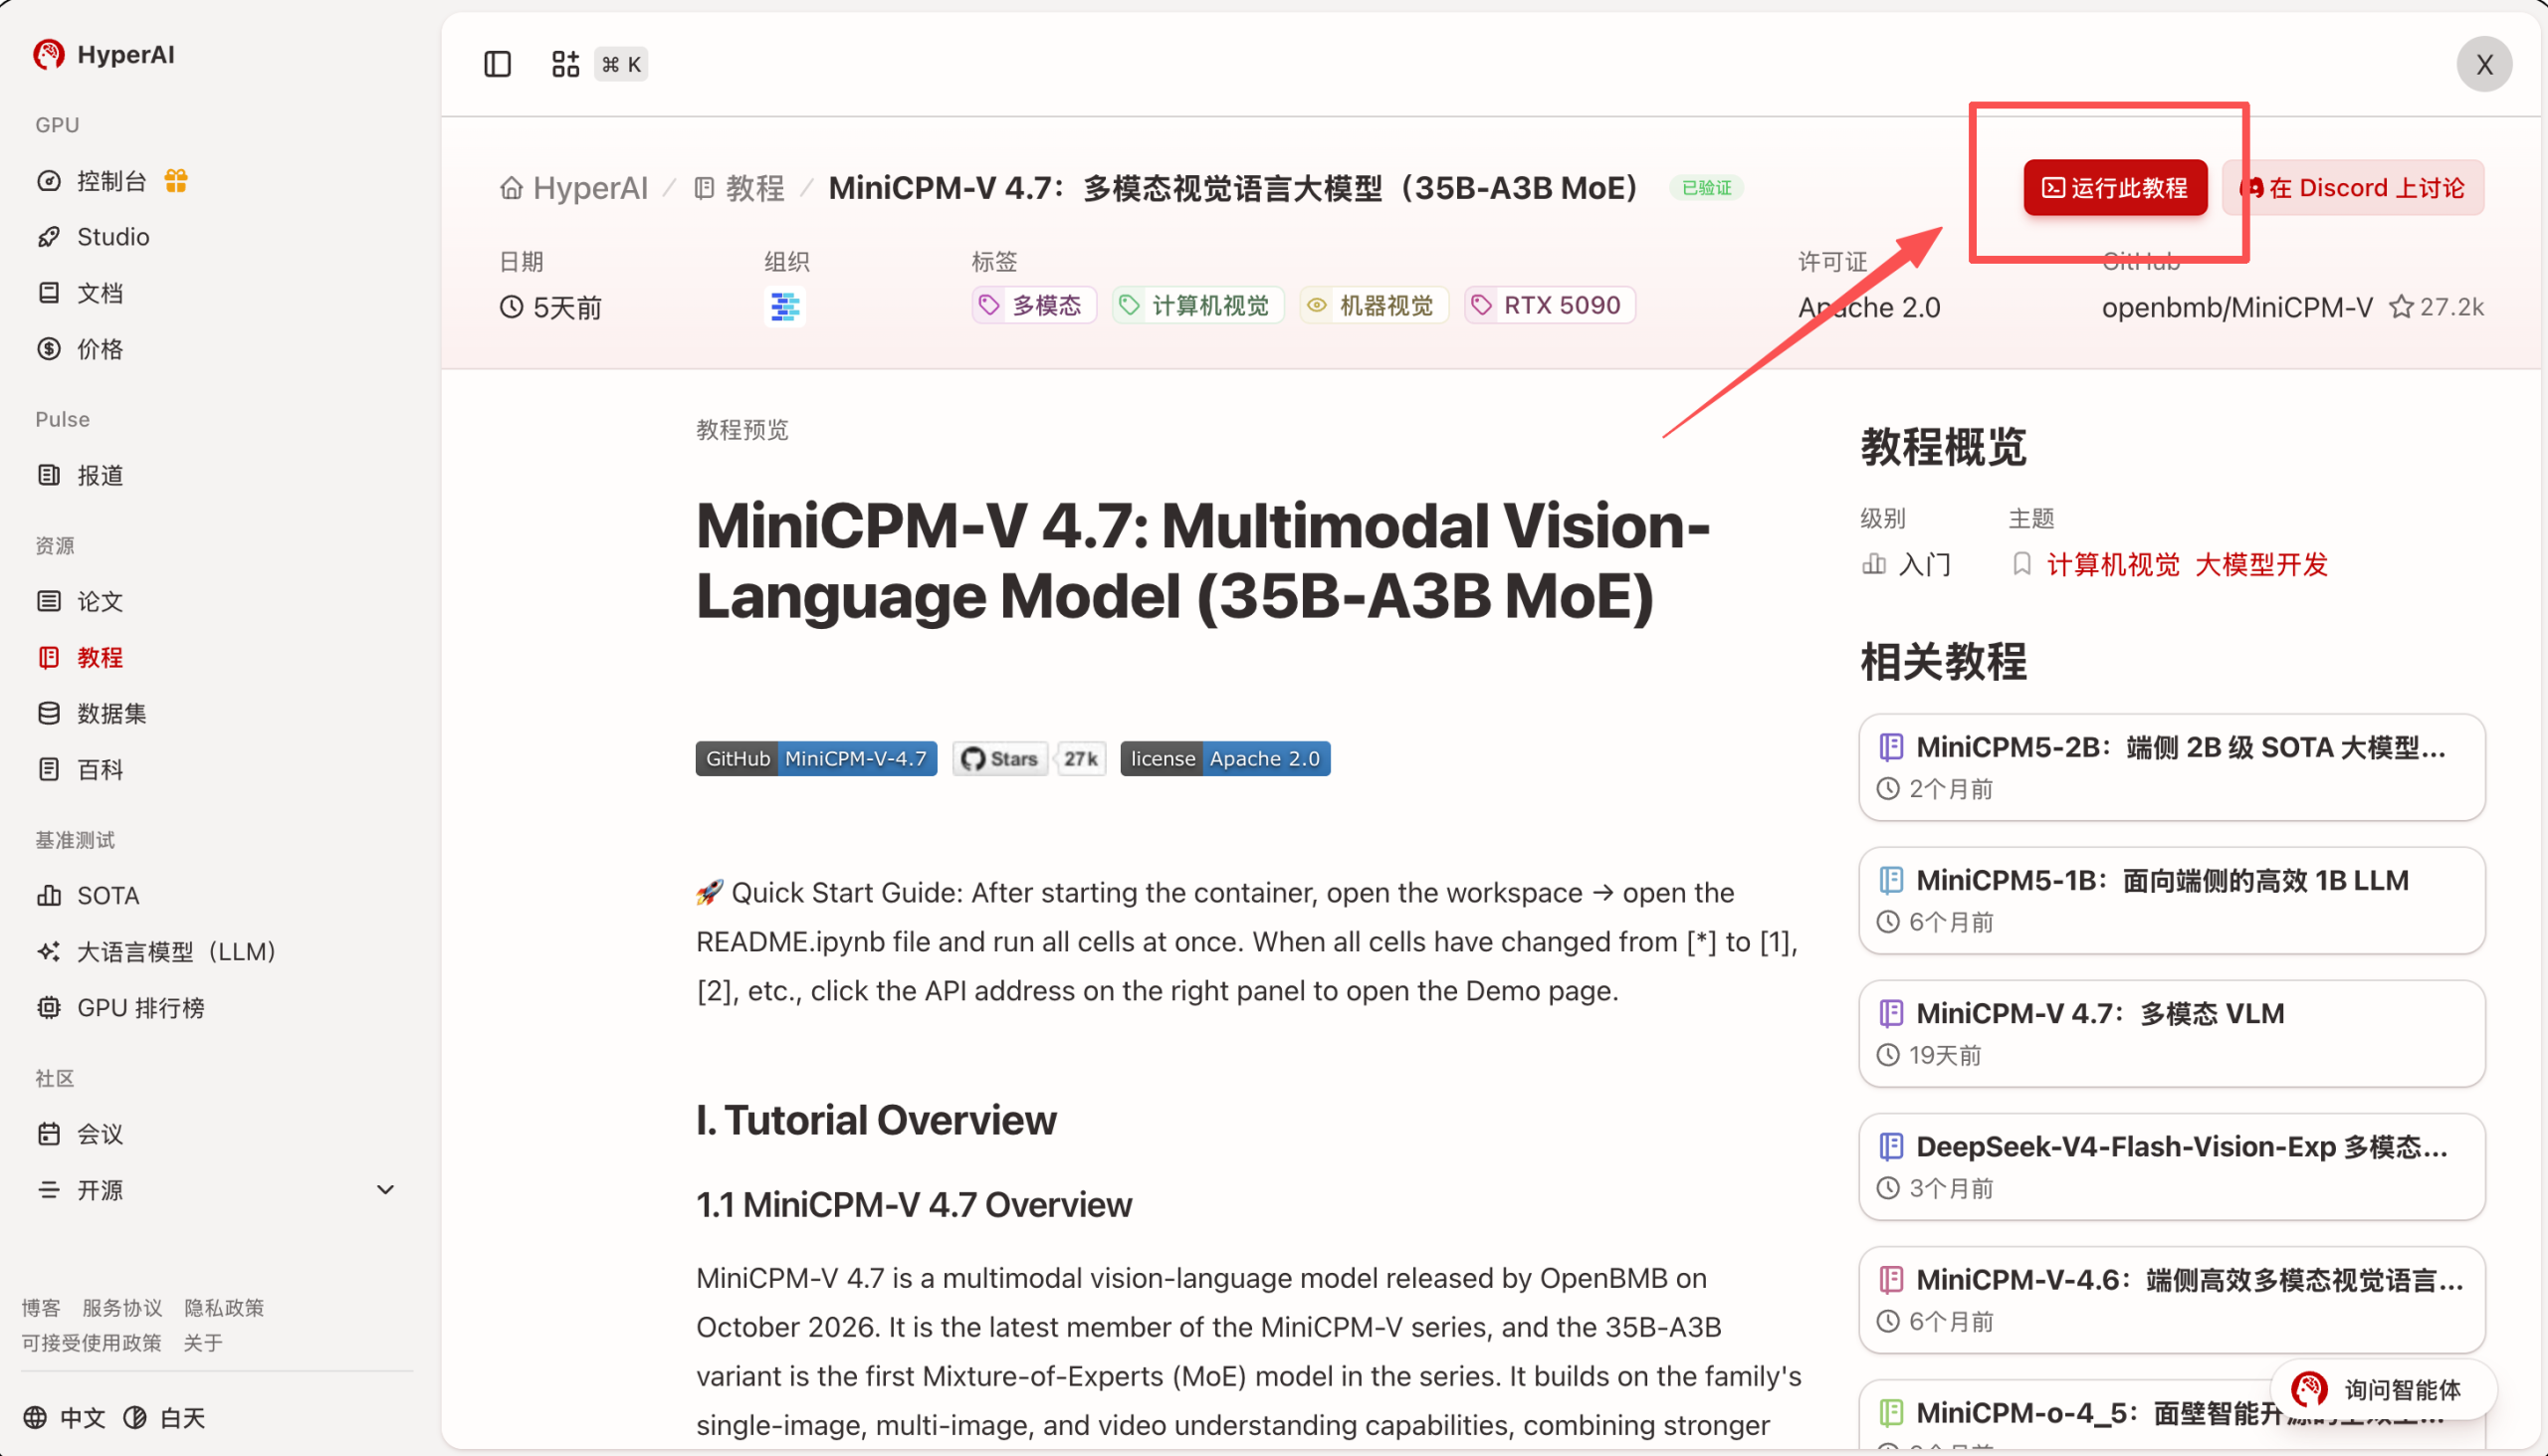
- Après être entré sur la page d’accueil de hyper.ai, sélectionnez la page « Tutoriels », ou cliquez sur « Voir plus de tutoriels », choisissez « MiniCPM-V 4.7 : grand modèle multimodal de langage et de vision (MoE 35B-A3B) », puis cliquez sur « Exécuter ce tutoriel ».
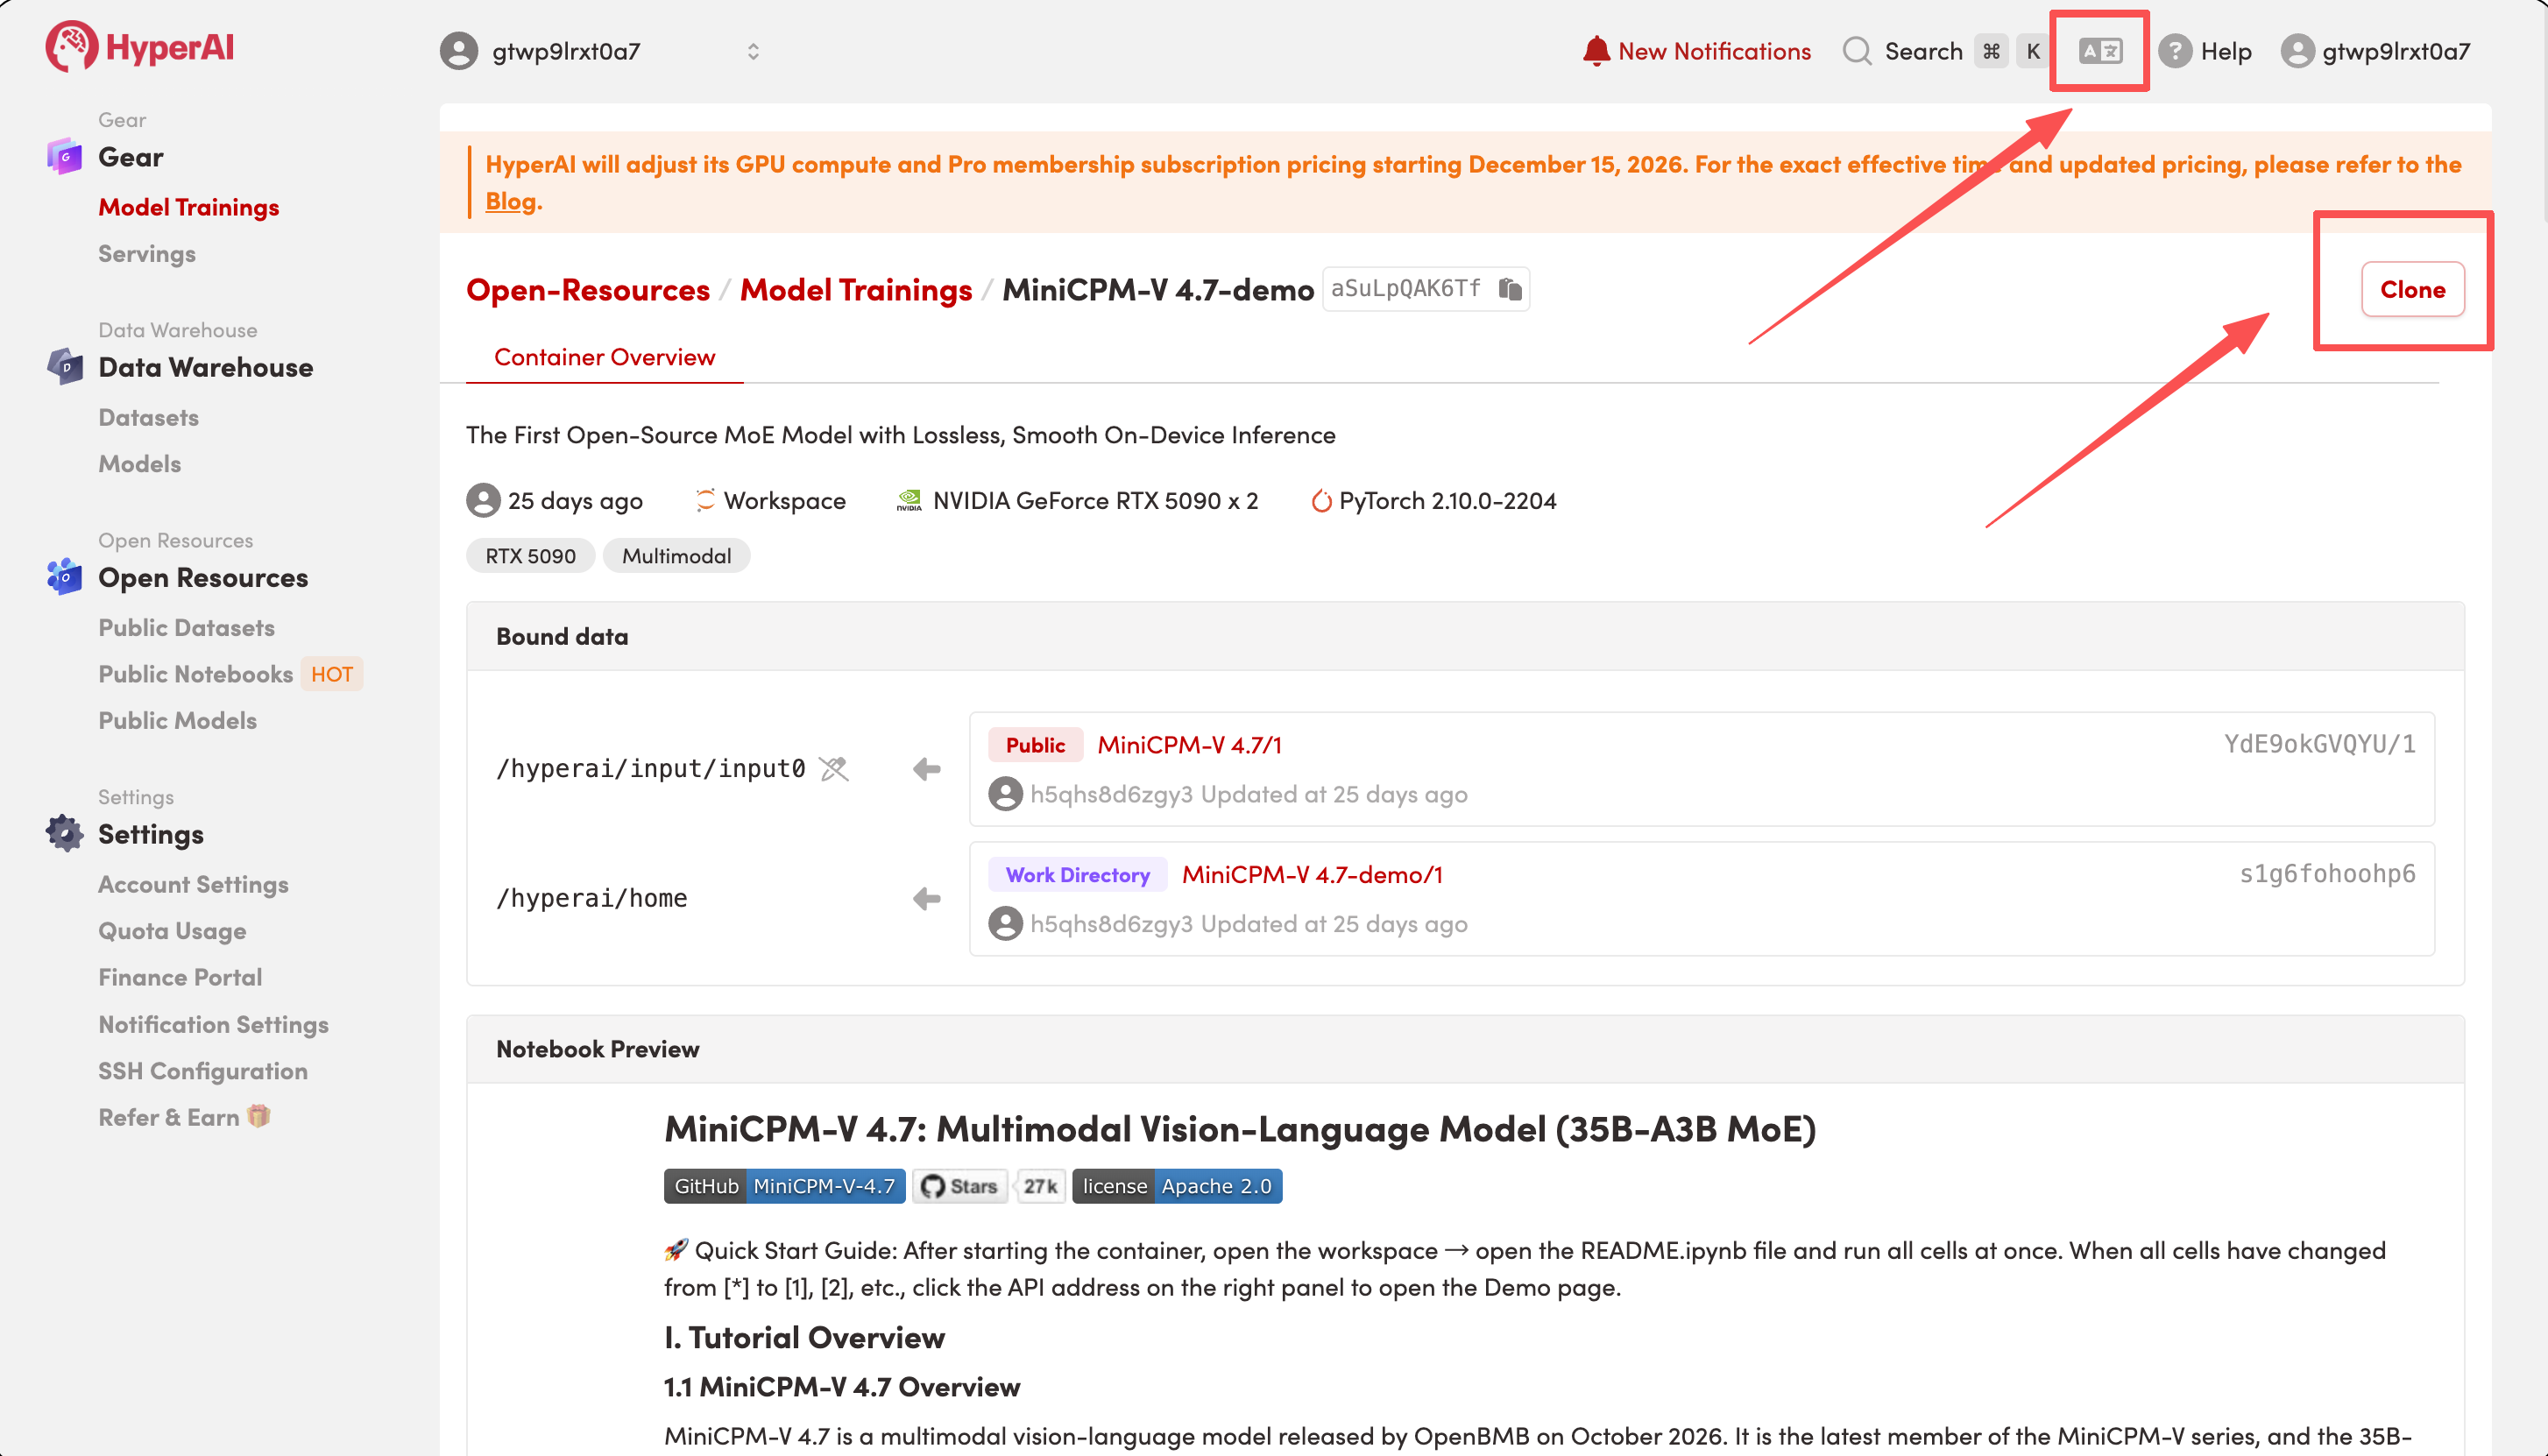
- Une fois la page redirigée, cliquez sur « Clone » en haut à droite pour cloner ce tutoriel dans votre propre conteneur.
Remarque : le coin supérieur droit de la page permet de changer de langue ; deux langues sont actuellement proposées, le chinois et l’anglais. Cet article de tutoriel utilise l’anglais pour illustrer les étapes.
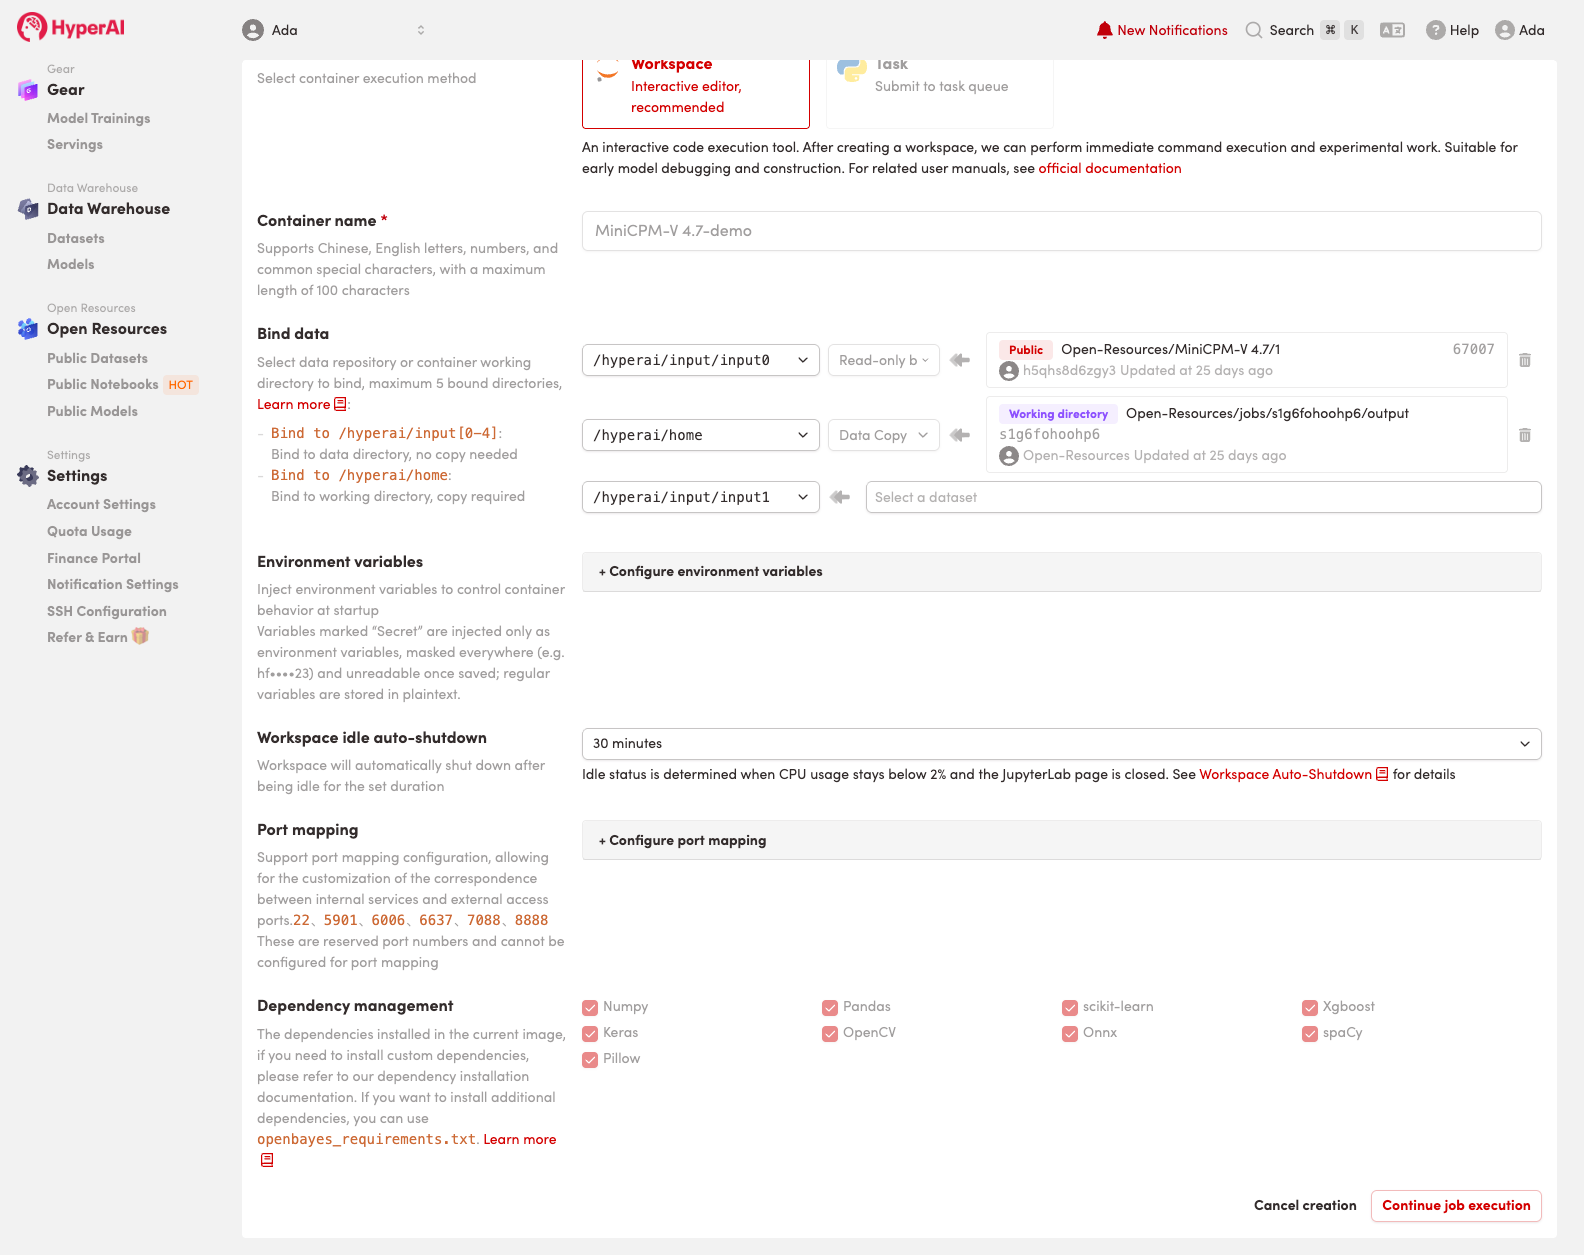
- Sélectionnez « 2 x NVIDIA GeForce RTX 5090 (32 GB) » ainsi que l’image correspondante, puis cliquez sur « Continue job execution (continuer l’exécution de la tâche) ».
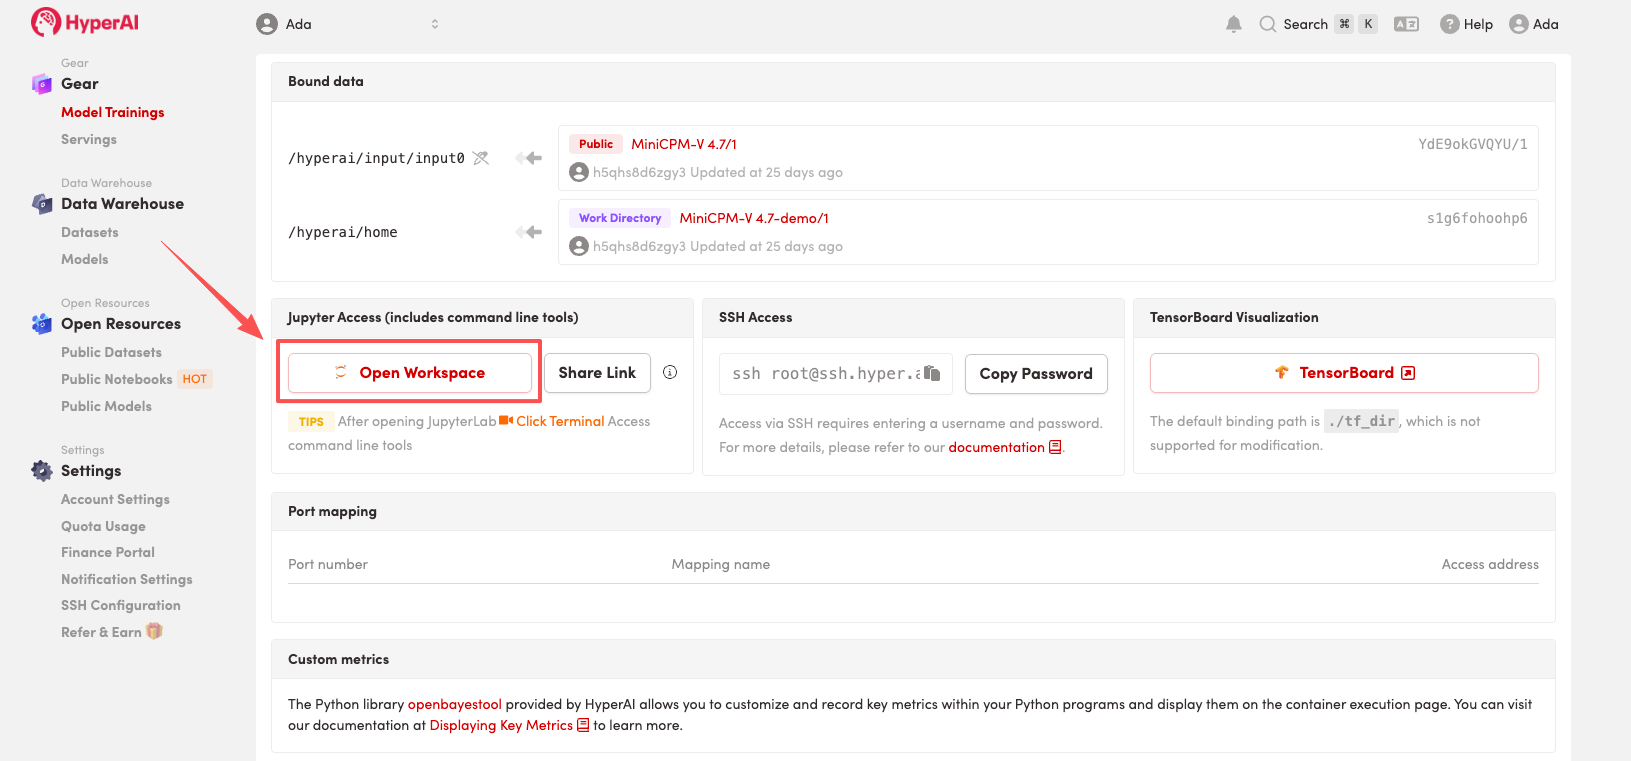
- Attendez l’attribution des ressources. Une fois le statut passé à « Running (en cours d’exécution) », cliquez sur « Open Workspace » pour accéder à Jupyter Workspace.
Présentation des résultats
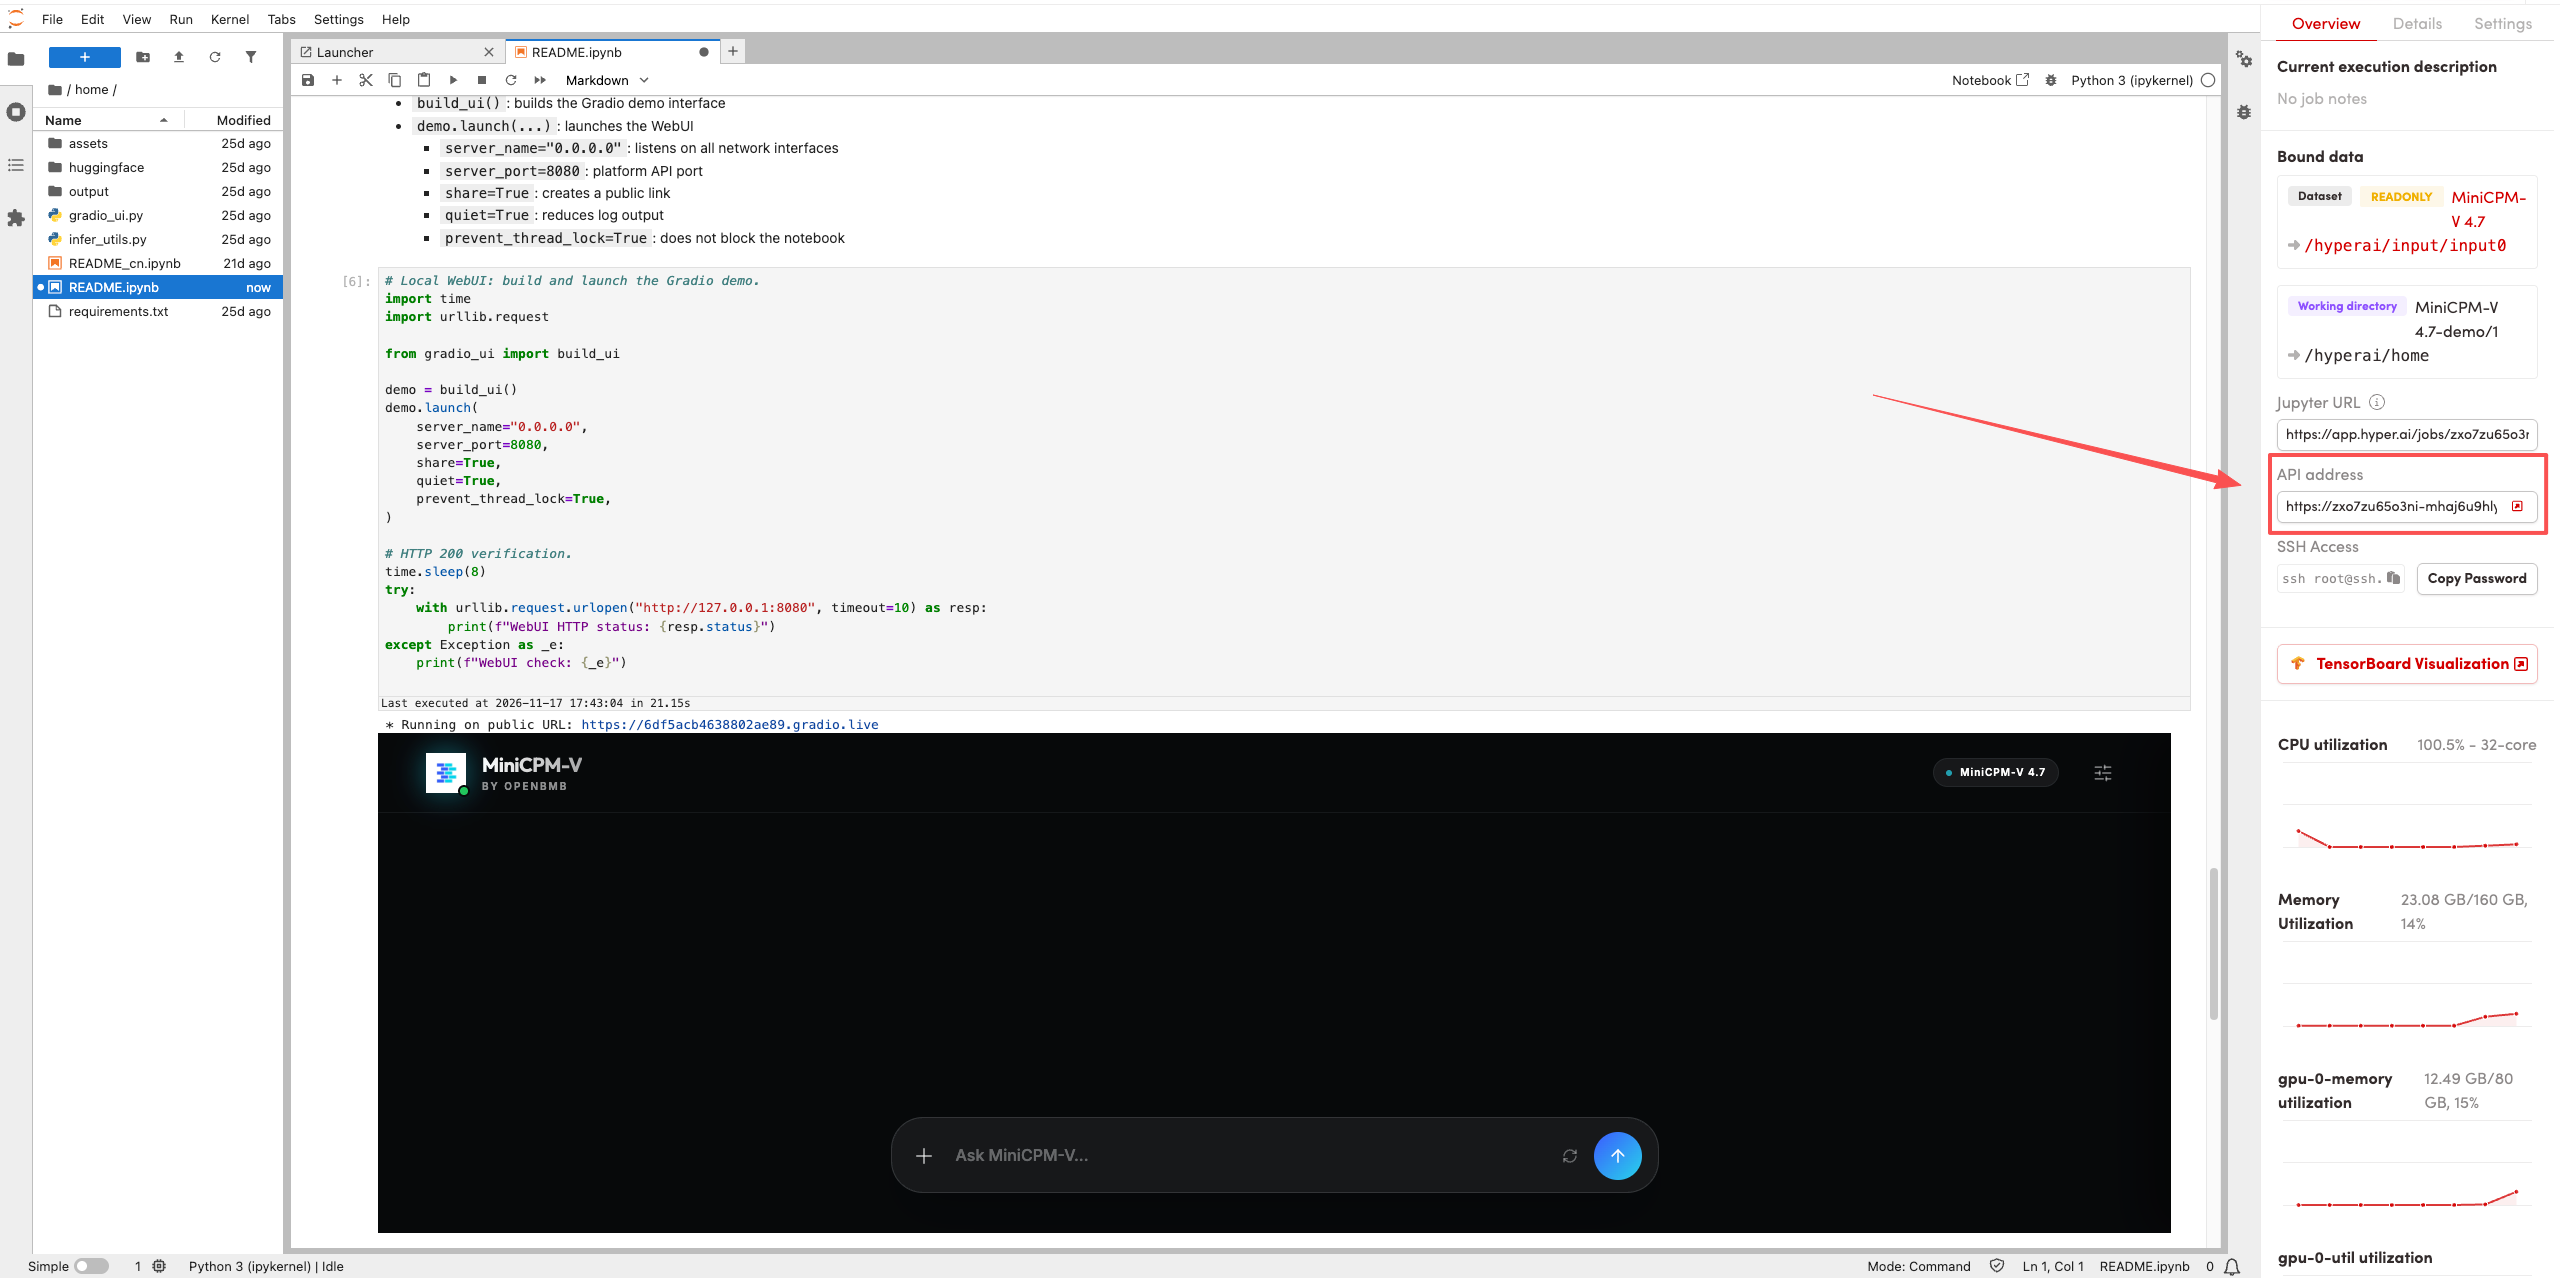
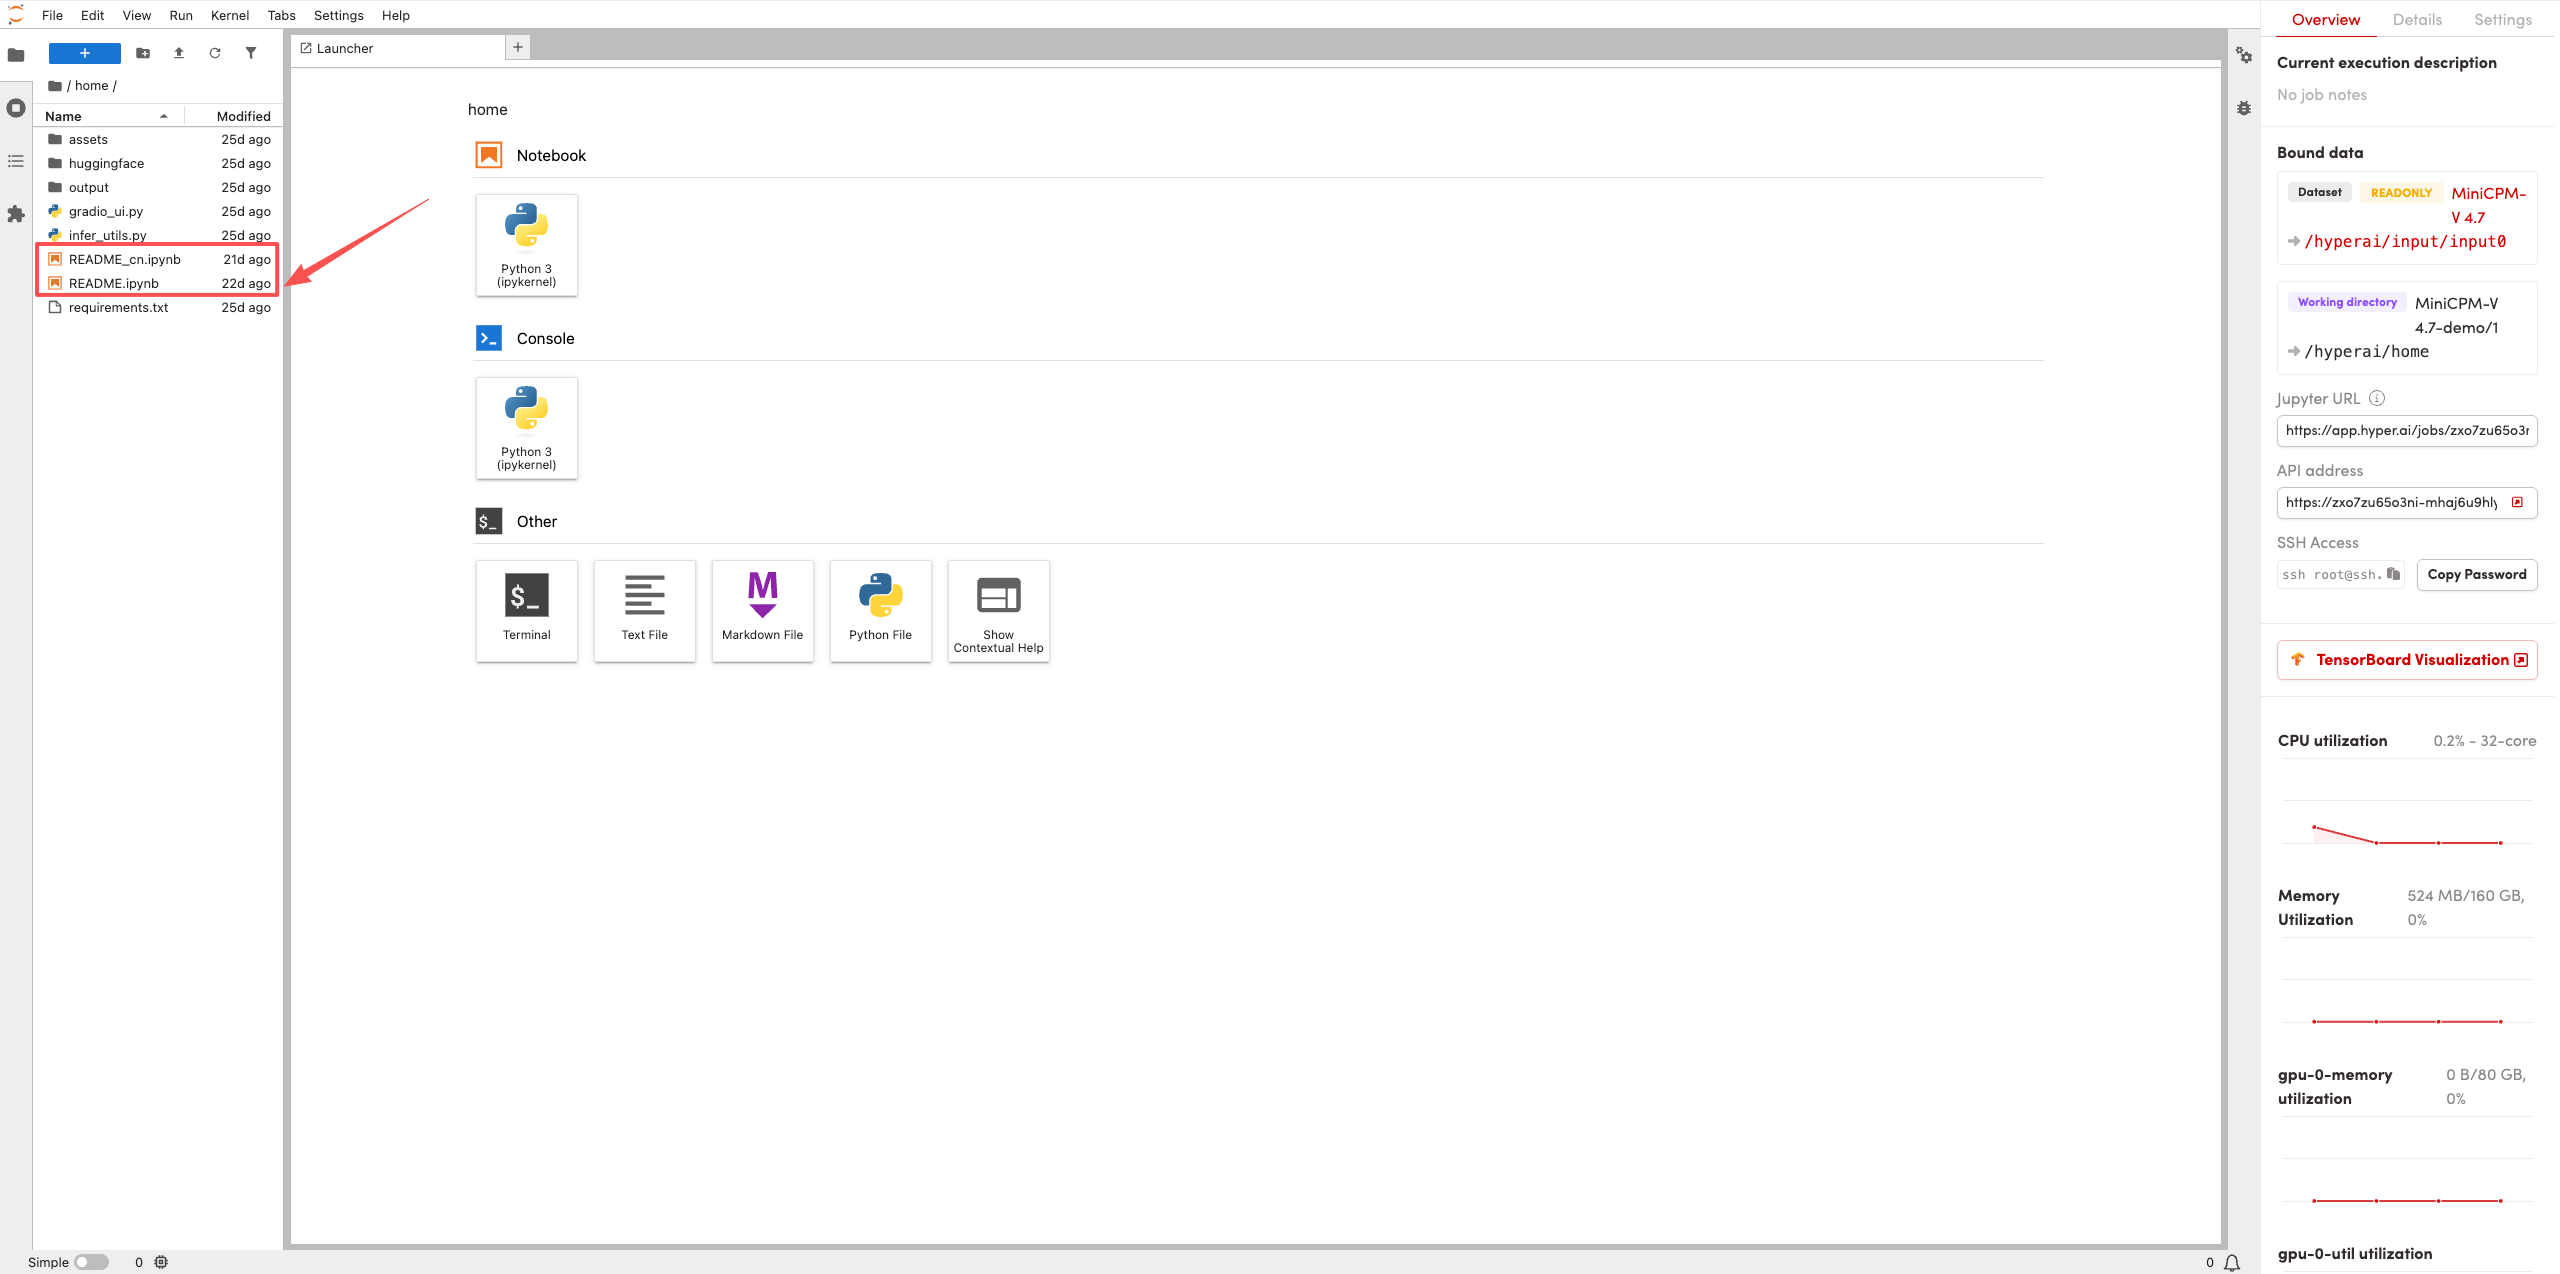
- Une fois la page redirigée, cliquez sur le fichier README à gauche, puis, après y être entré, cliquez sur Run (Exécuter) en haut.
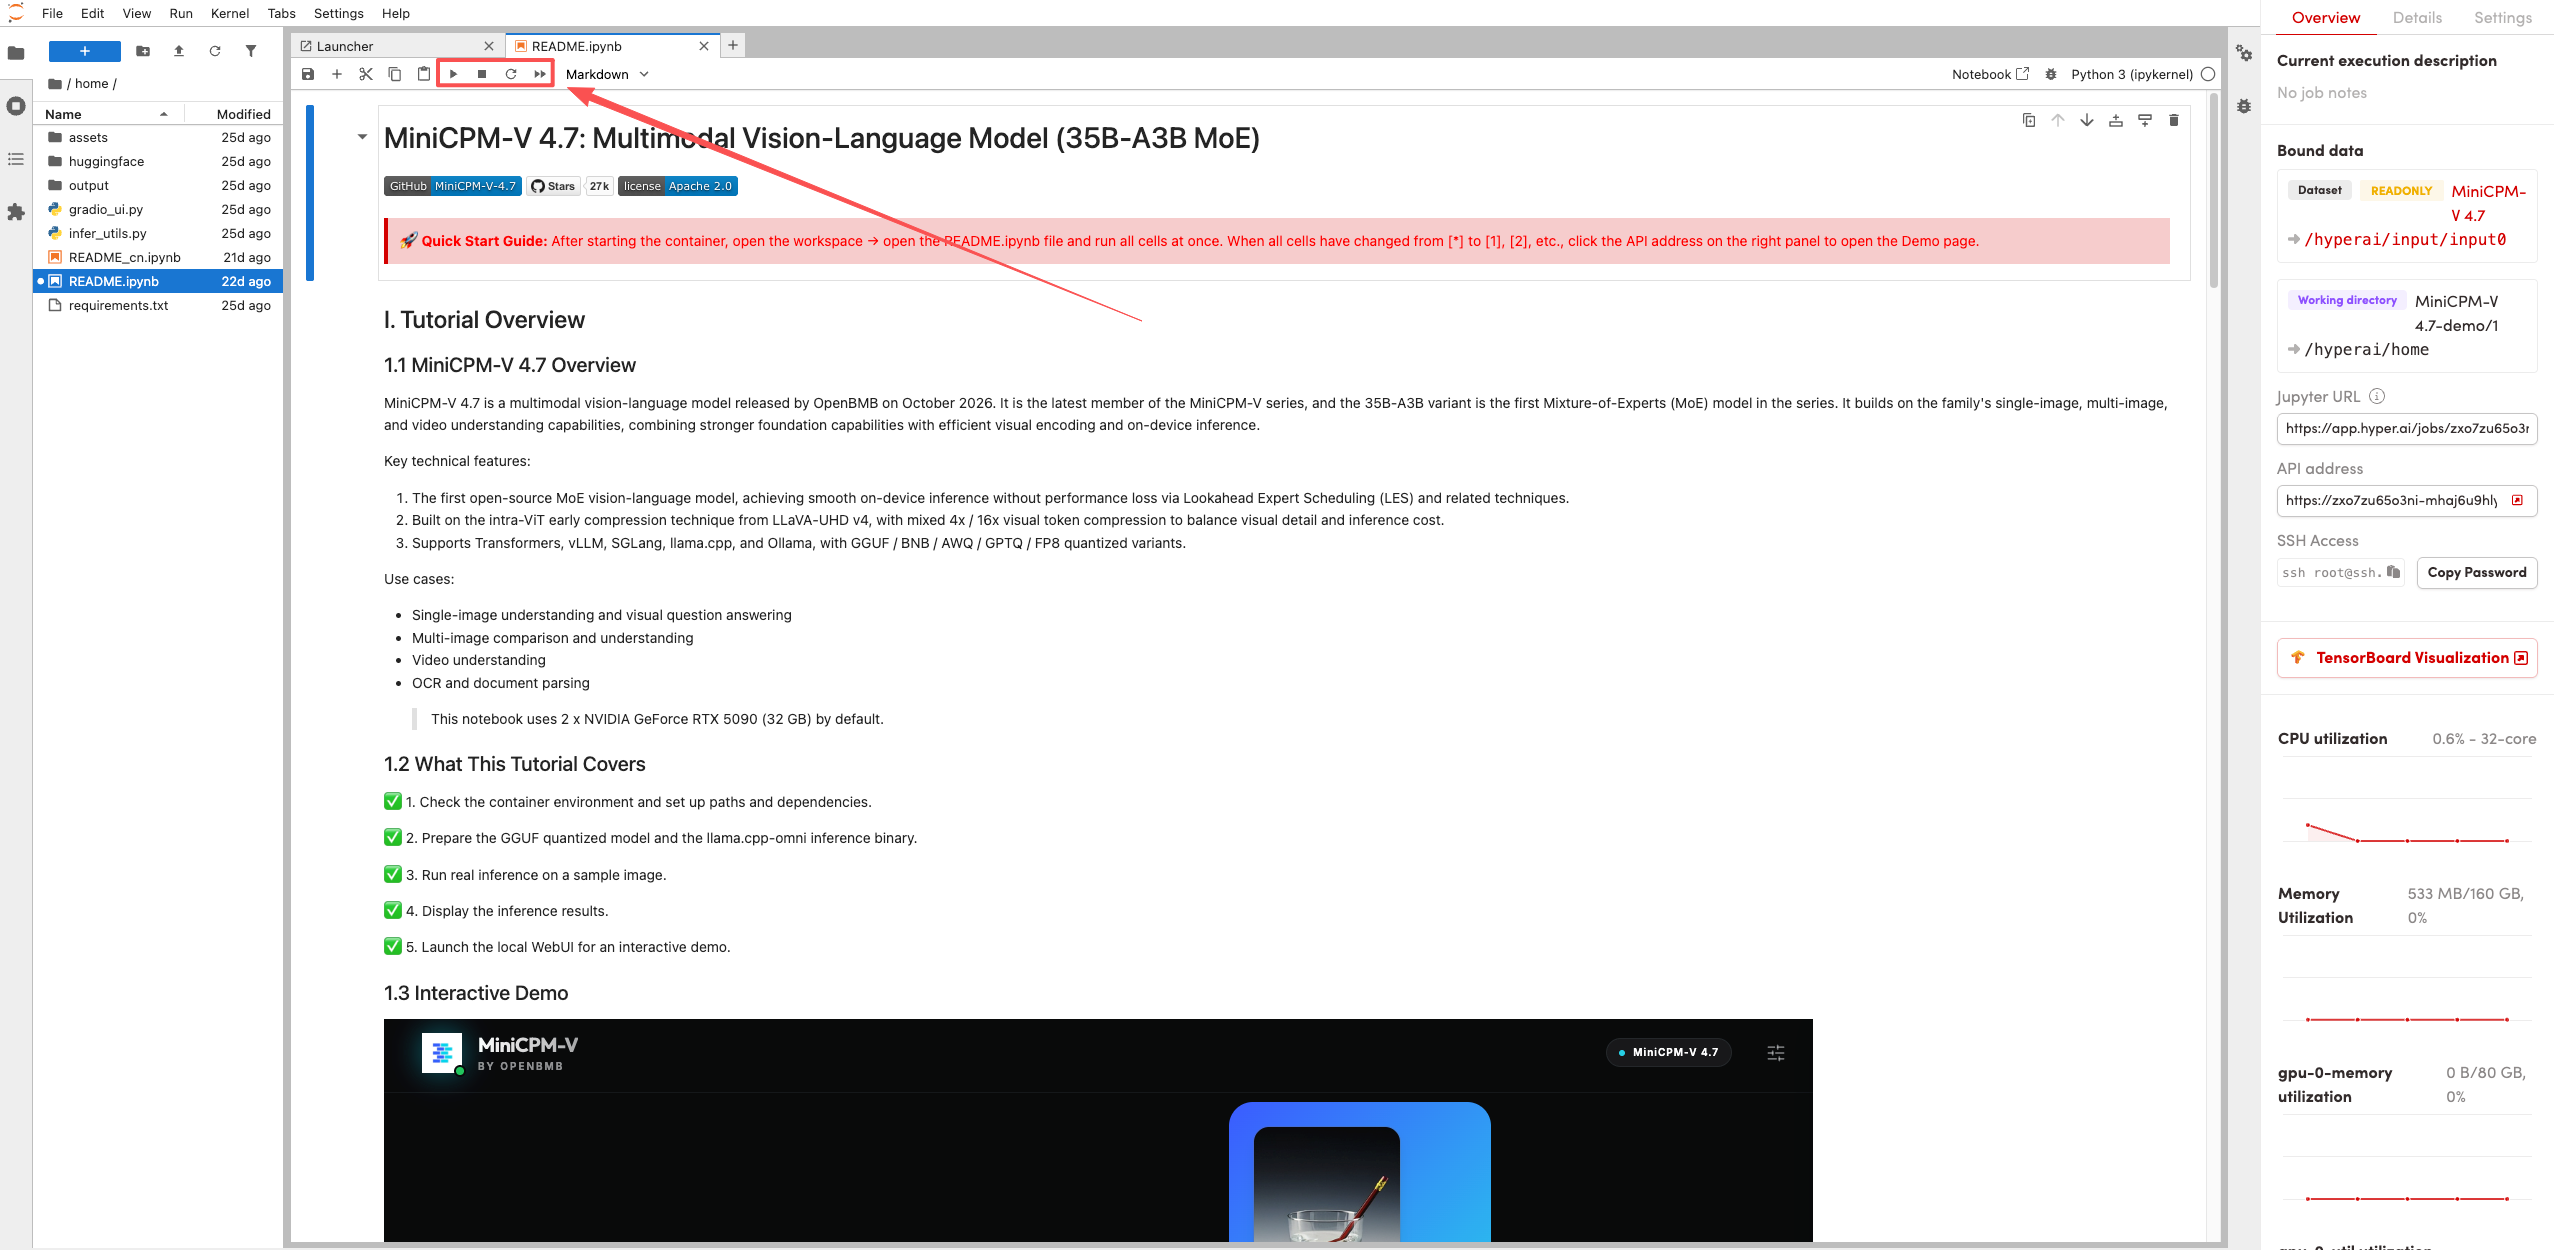
- Une fois l’exécution terminée, cliquez sur l’adresse API à droite pour accéder à la démo.