Command Palette
Search for a command to run...
Tutoriel En Ligne | Décision Rapide, Raisonnement À La Demande : JEV-27B-VL, Basé Sur Qwen3.8-27B, Prend En Charge L'évaluation Image-texte, Les Questions À Choix Multiples Et La Notation
Les modèles de vision-langage sont déjà capables de comprendre des images et de répondre à des questions ; cependant, pour qu'une IA analyse une image, il n'est pas toujours nécessaire de générer une longue réponse. Par exemple, déterminer si une image contient du contenu non conforme, choisir parmi plusieurs produits celui qui répond le mieux aux exigences, ou évaluer si la miniature d'une vidéo courte mérite d'être recommandée — pour ces tâches, ce qui est réellement nécessaire est souvent une décision claire et un niveau de confiance dans cette décision, plutôt qu'une analyse détaillée.
Le modèle de décision visuelle JEV-27B-VL, lancé par l'équipe AutoTrust en 2026, explore une approche différente. Il se classe premier dans le classement Vision du Jev Decision Index 0.3 de la communauté. Selon la présentation du projet, contrairement aux modèles de vision-langage principalement orientés vers la génération de texte ouvert, le JEV-27B-VL se concentre davantage sur les Décisions Typées (Typed Decisions) : permettre au modèle de fournir directement des jugements conformes au type spécifié pour des entrées textuelles et visuelles.
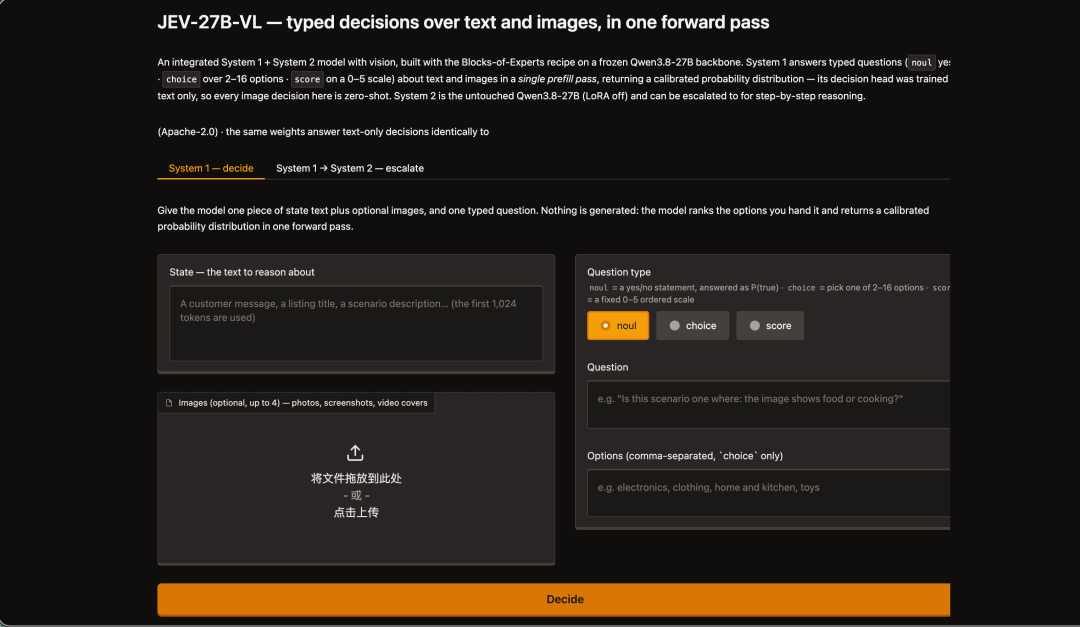
Techniquement, le JEV-27B-VL est basé sur Qwen3.8-27B et intègre deux chemins de traitement distincts via la solution Blocks-of-Experts : System 1 est responsable des décisions rapides, tandis que System 2 assure un raisonnement approfondi. Il réorganise les chemins de calcul pour différentes tâches, évitant d'engager le coût complet de la génération et du raisonnement à chaque jugement, ce qui permet ainsi d'alléger le modèle. System 1, via une tête de décision dédiée, produit en une seule passe avant les probabilités calibrées pour chaque option, supportant les jugements Oui / Non, les questions à choix multiples (2 à 16 options) ainsi que les évaluations sur une échelle de 0 à 5, sans nécessiter une génération autorégressive token par token. Si la confiance de la décision est faible, System 2 est alors invoqué, utilisant le modèle original Qwen3.8-27B pour un raisonnement étape par étape. Par rapport à un processus de génération complet pour toutes les tâches, cette allocation de calcul à la demande est plus adaptée aux applications sensibles à la latence et au coût d'inférence.
Lorsqu'une tâche ne requiert qu'une décision, il est inutile de faire générer une réponse complète par le modèle. Actuellement, la section tutoriels du site officiel HyperAI (hyper.ai) a mis en ligne « JEV-27B-VL : Un modèle de décision structurée pour le texte et les images », aidant les développeurs à exploiter rapidement les capacités du modèle.
Exécution en ligne :
Plus de tutoriels en ligne :
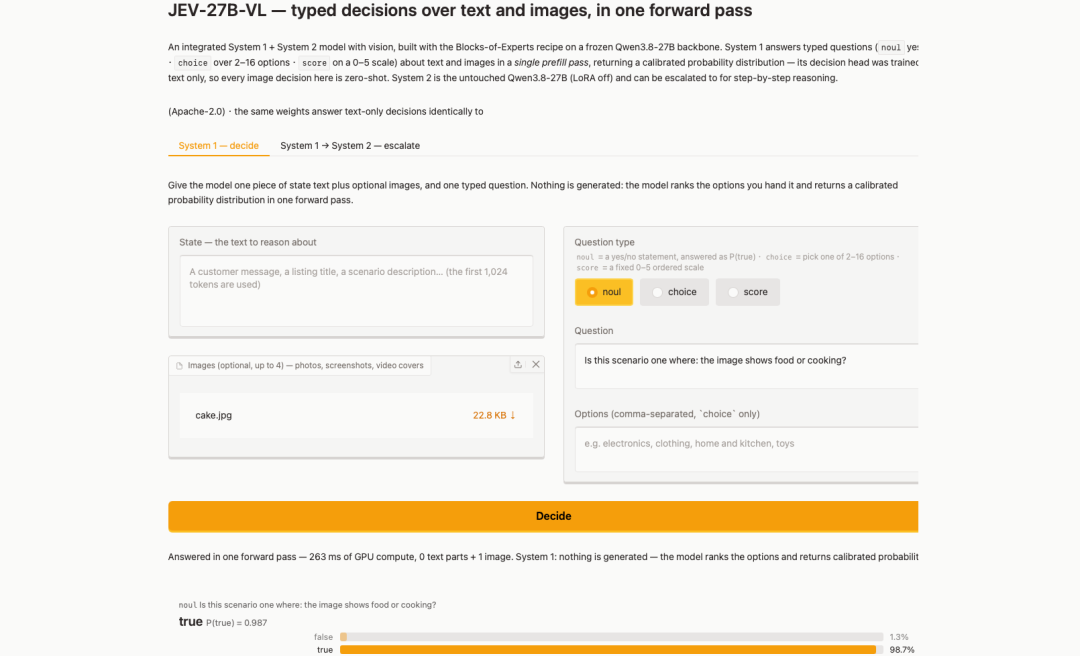
Exécution de la démo
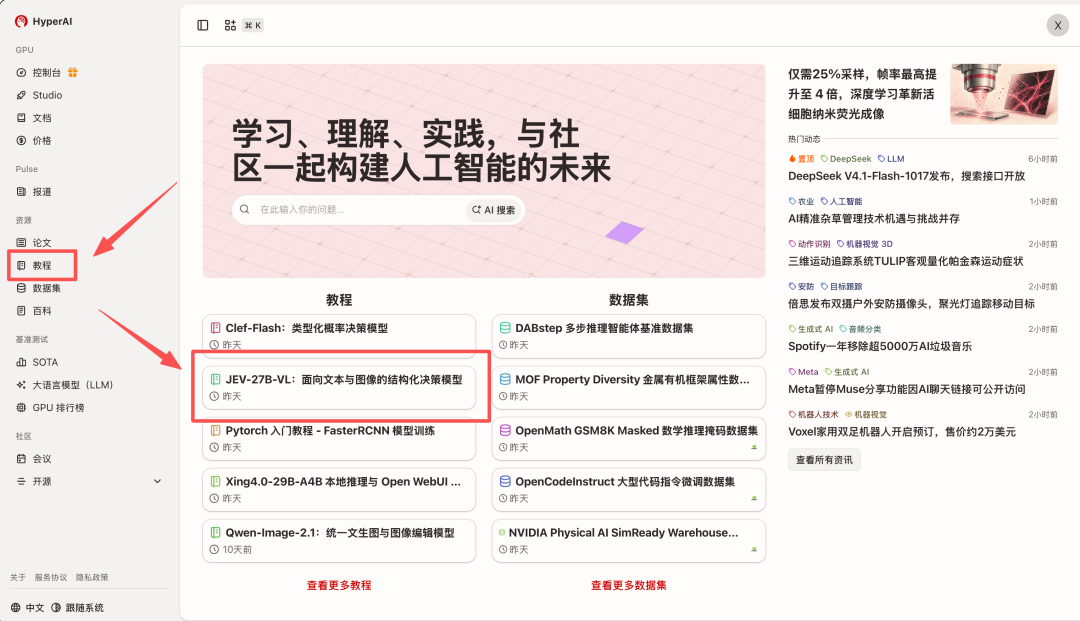
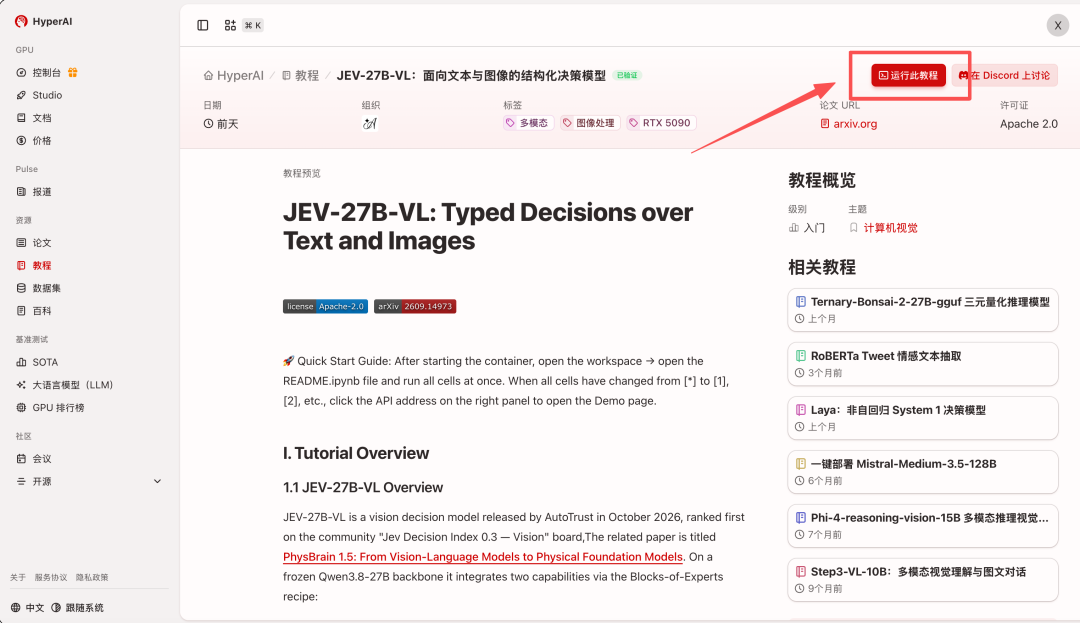
- Après être arrivé sur la page d'accueil de hyper.ai, sélectionnez la page « Tutoriels », ou cliquez sur « Voir plus de tutoriels », choisissez « JEV-27B-VL : Un modèle de décision structurée pour le texte et les images », puis cliquez sur « Exécuter ce tutoriel ».
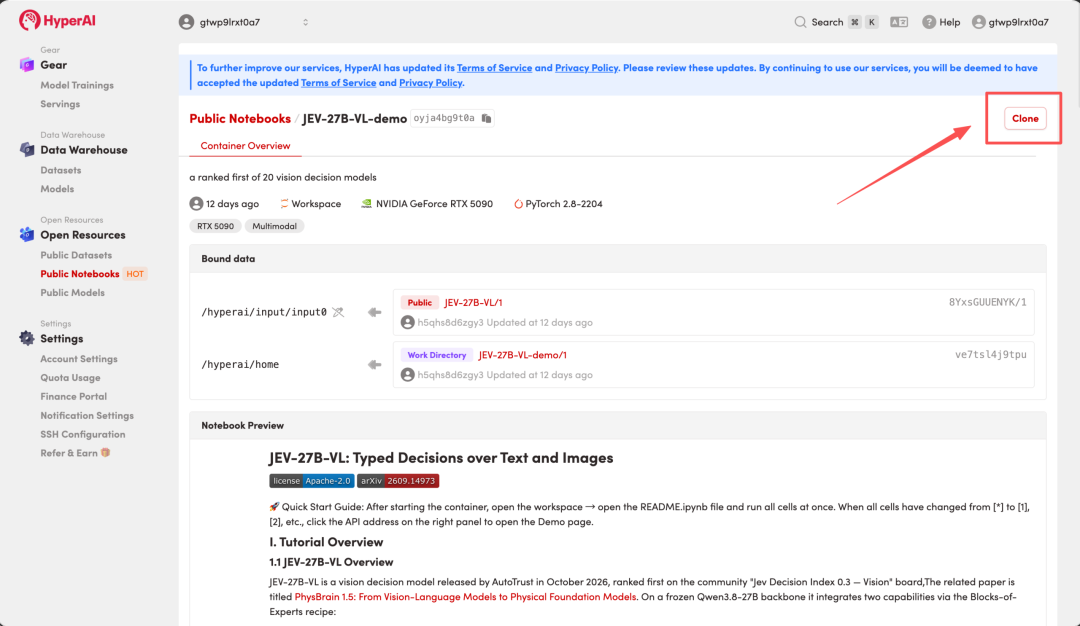
- Après la redirection de la page, cliquez sur « Clone » en haut à droite pour cloner ce tutoriel dans votre propre conteneur.
Note : Un sélecteur de langue est disponible en haut à droite de la page, offrant actuellement le chinois et l'anglais. Cet article tutoriel utilise l'anglais comme exemple pour la présentation des étapes.
- Sélectionnez « NVIDIA RTX 5090 » ainsi que l'image correspondante, puis cliquez sur « Continue job execution (Continuer l'exécution) ». Ce tutoriel utilise par défaut les ressources NVIDIA GeForce RTX 5090 (32 Go de mémoire vidéo).
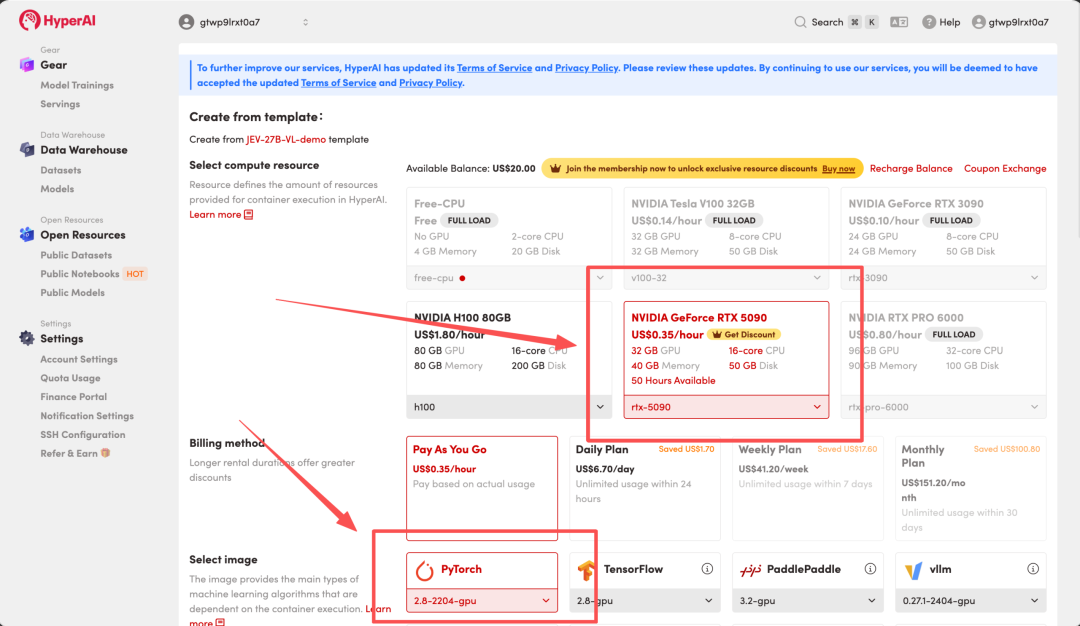
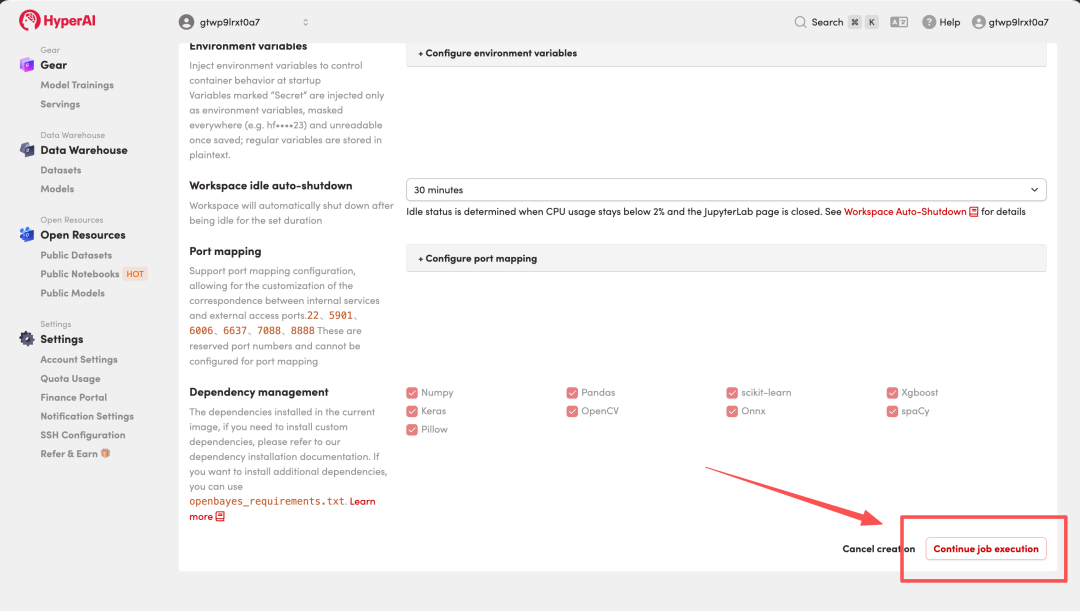
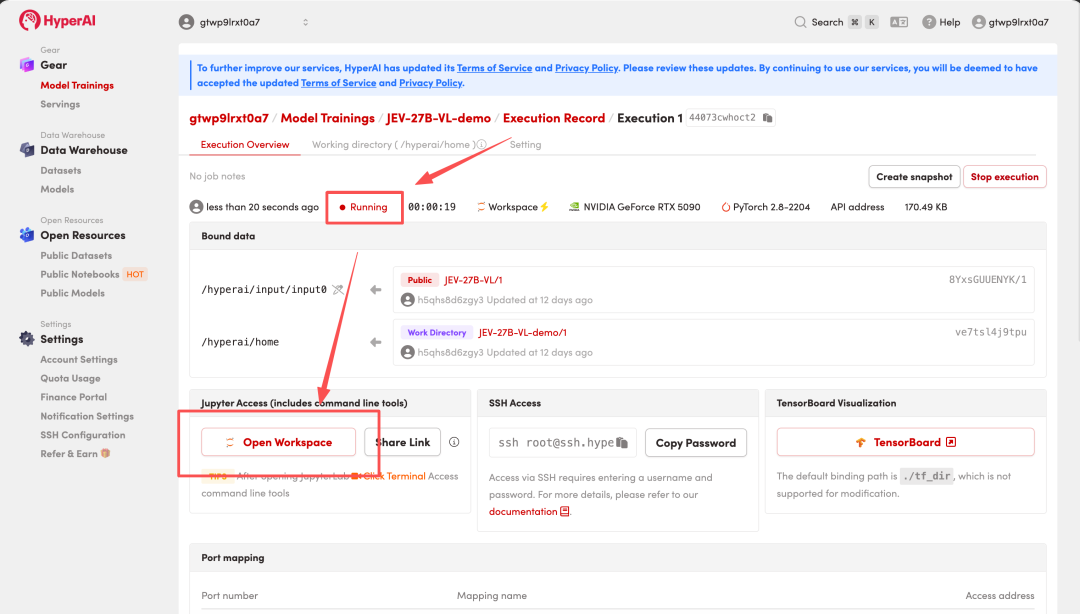
- Attendez l'allocation des ressources. Une fois l'état passé à « Running (En cours d'exécution) », cliquez sur « Open Workspace » pour accéder à l'espace de travail Jupyter.
Démonstration des résultats
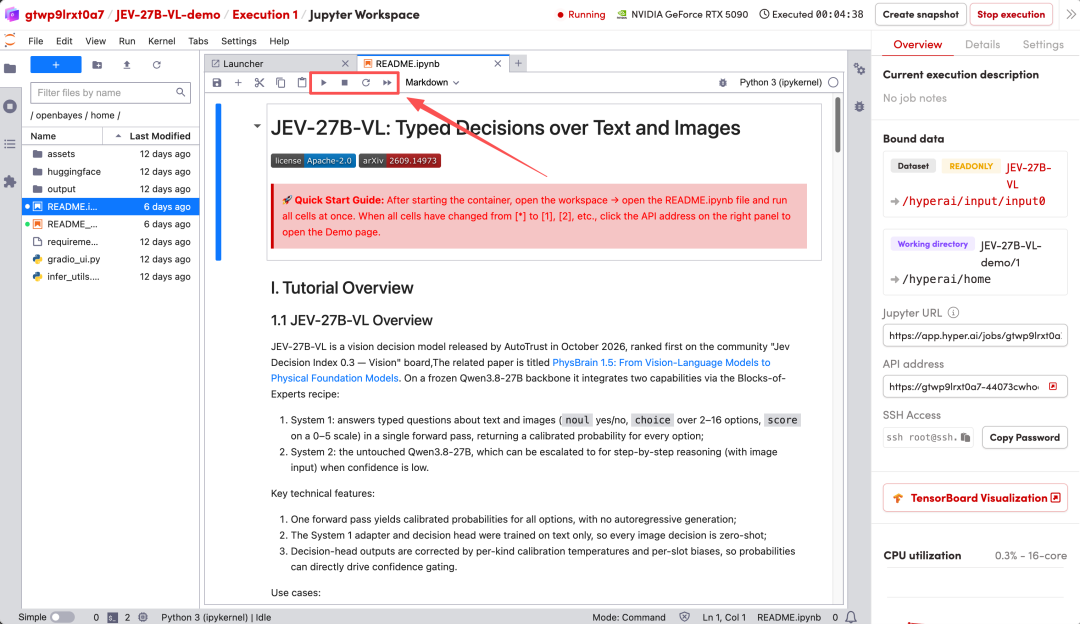
- Après la redirection de la page, cliquez sur le fichier README dans la partie gauche, puis cliquez sur Run (Exécuter) en haut.
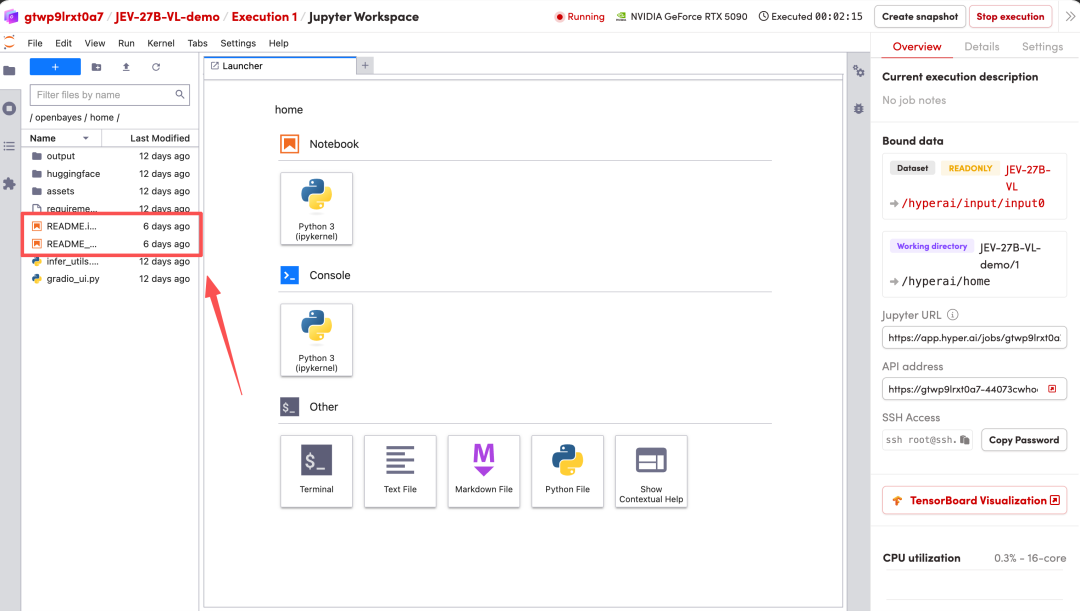
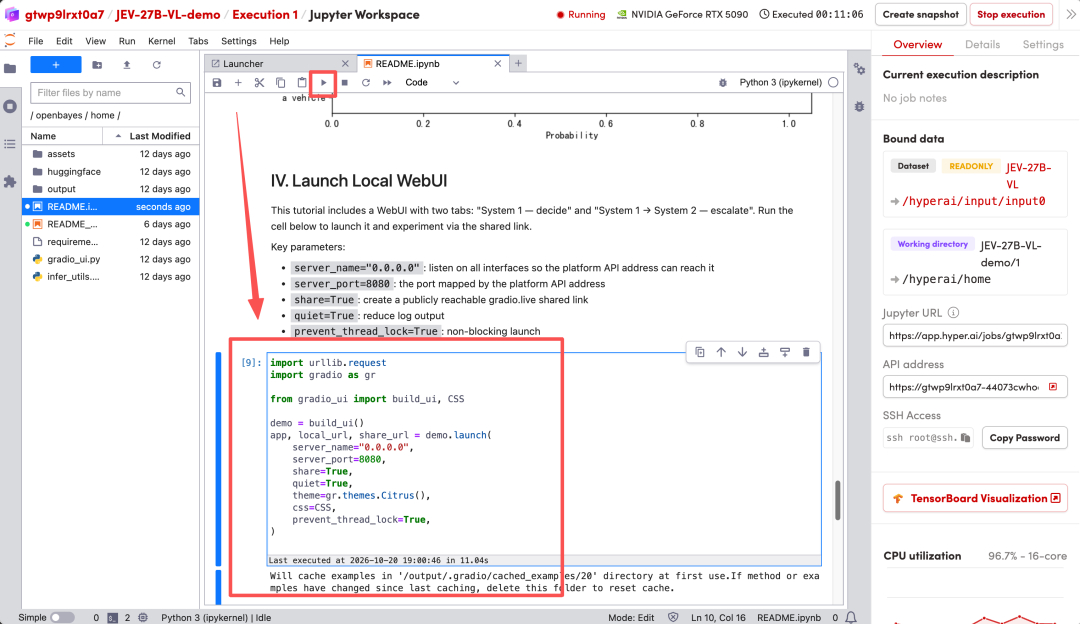
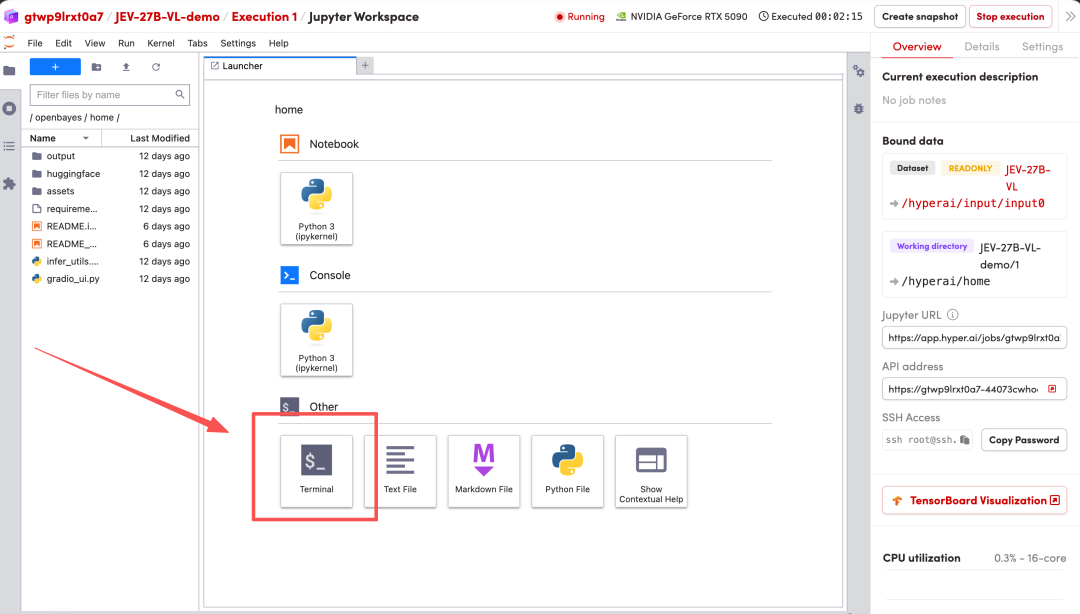
- Une fois l'exécution terminée, ouvrez un nouveau terminal et exécutez la commande suivante pour démarrer Open WebUI.
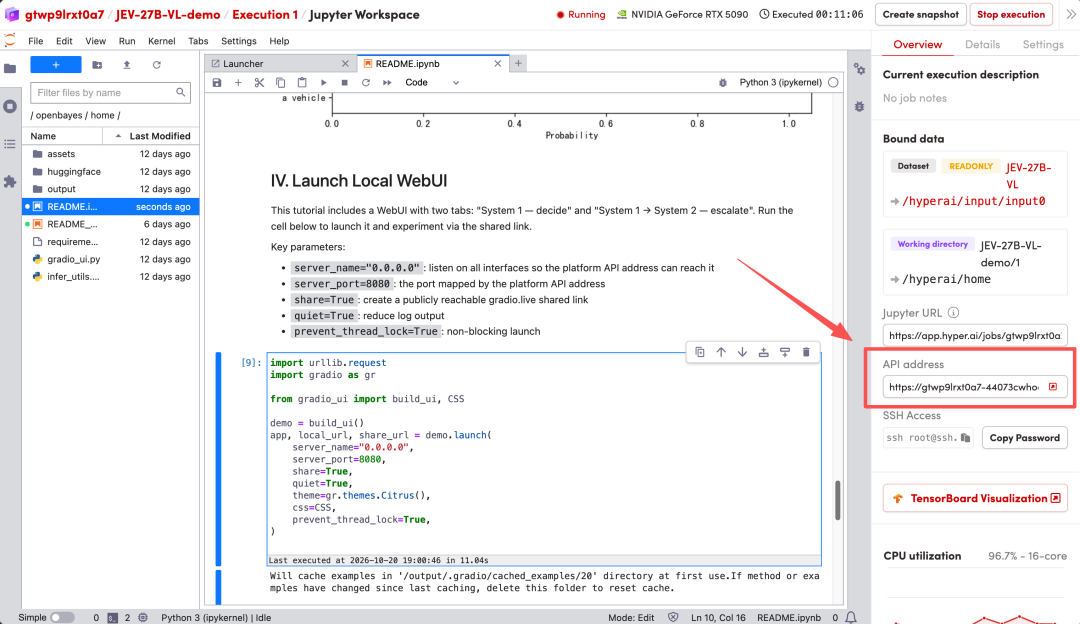
- Une fois démarré, cliquez sur l'adresse API à droite pour accéder à l'interface Open WebUI via le navigateur.