Command Palette
Search for a command to run...
Tutoriel En ligne丨2B Surpasse 4B, SOTA Parmi Les Modèles open-source De Même Niveau, OpenBMB Lance MiniCPM5-2B, Prenant En Charge Un Contexte Long De 131K Et L'appel D'outils
Des questions-réponses à la programmation en passant par l'appel d'outils, les capacités des assistants IA ne cessent de s'étendre. Comment concilier raisonnement, traitement de textes longs et applications d'agents avec des ressources limitées est devenu un enjeu clé du déploiement côté terminal.
MiniCPM5-2B offre une solution légère. En tant que deuxième modèle de la série MiniCPM5 d'OpenBMB, il adopte une architecture standard LlamaForCausalLM, destiné au déploiement côté terminal, à l'inférence locale et aux scénarios à ressources limitées, permettant aux développeurs de créer des applications IA pratiques autour d'un modèle à petits paramètres.
Selon les évaluations officielles, MiniCPM5-2B obtient un score moyen de 53,9 dans la plage de comparaison indiquée, atteignant un niveau de pointe parmi les modèles open source de niveau 2B, et dépasse même certains modèles de niveau 4B sur certains indicateurs. Ses capacités couvrent le raisonnement de code, le raisonnement mathématique, la compréhension de contextes longs, l'appel d'outils et les tâches d'agents, et peuvent être utilisées pour l'assistance à la programmation, la résolution de problèmes et les réponses à des questions de connaissances. Pour les besoins de traitement de textes longs, MiniCPM5-2B prend en charge nativement une fenêtre de contexte allant jusqu'à 131 072 jetons, offrant ainsi de l'espace pour des documents, codes et historiques de conversation plus longs.
Outre la génération de texte, MiniCPM5-2B prend également en charge l'appel d'outils au format XML, et peut servir de base de modèle pour les agents de programmation, les agents de recherche et d'autres flux de travail d'appel d'outils.
Actuellement, la section tutoriels de HyperAI a mis en ligne le tutoriel pratique « MiniCPM5-2B : inférence de modèle SOTA de niveau 2B côté terminal », avec prise en charge de l'expérience en ligne et du déploiement en un clic~
Exécution en ligne :
Plus de tutoriels en ligne :
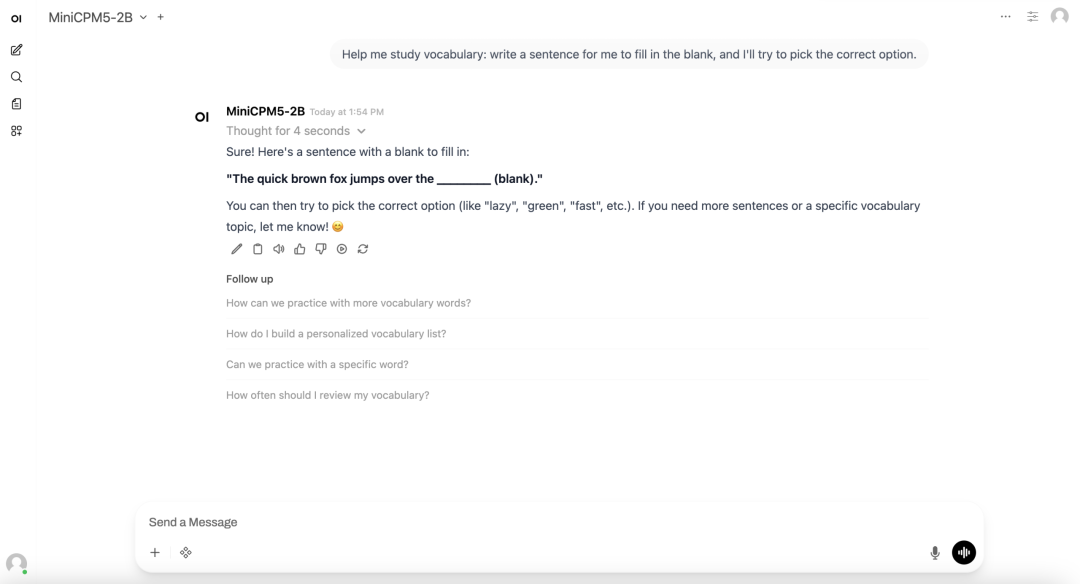
page de démo
Exécution de la démo
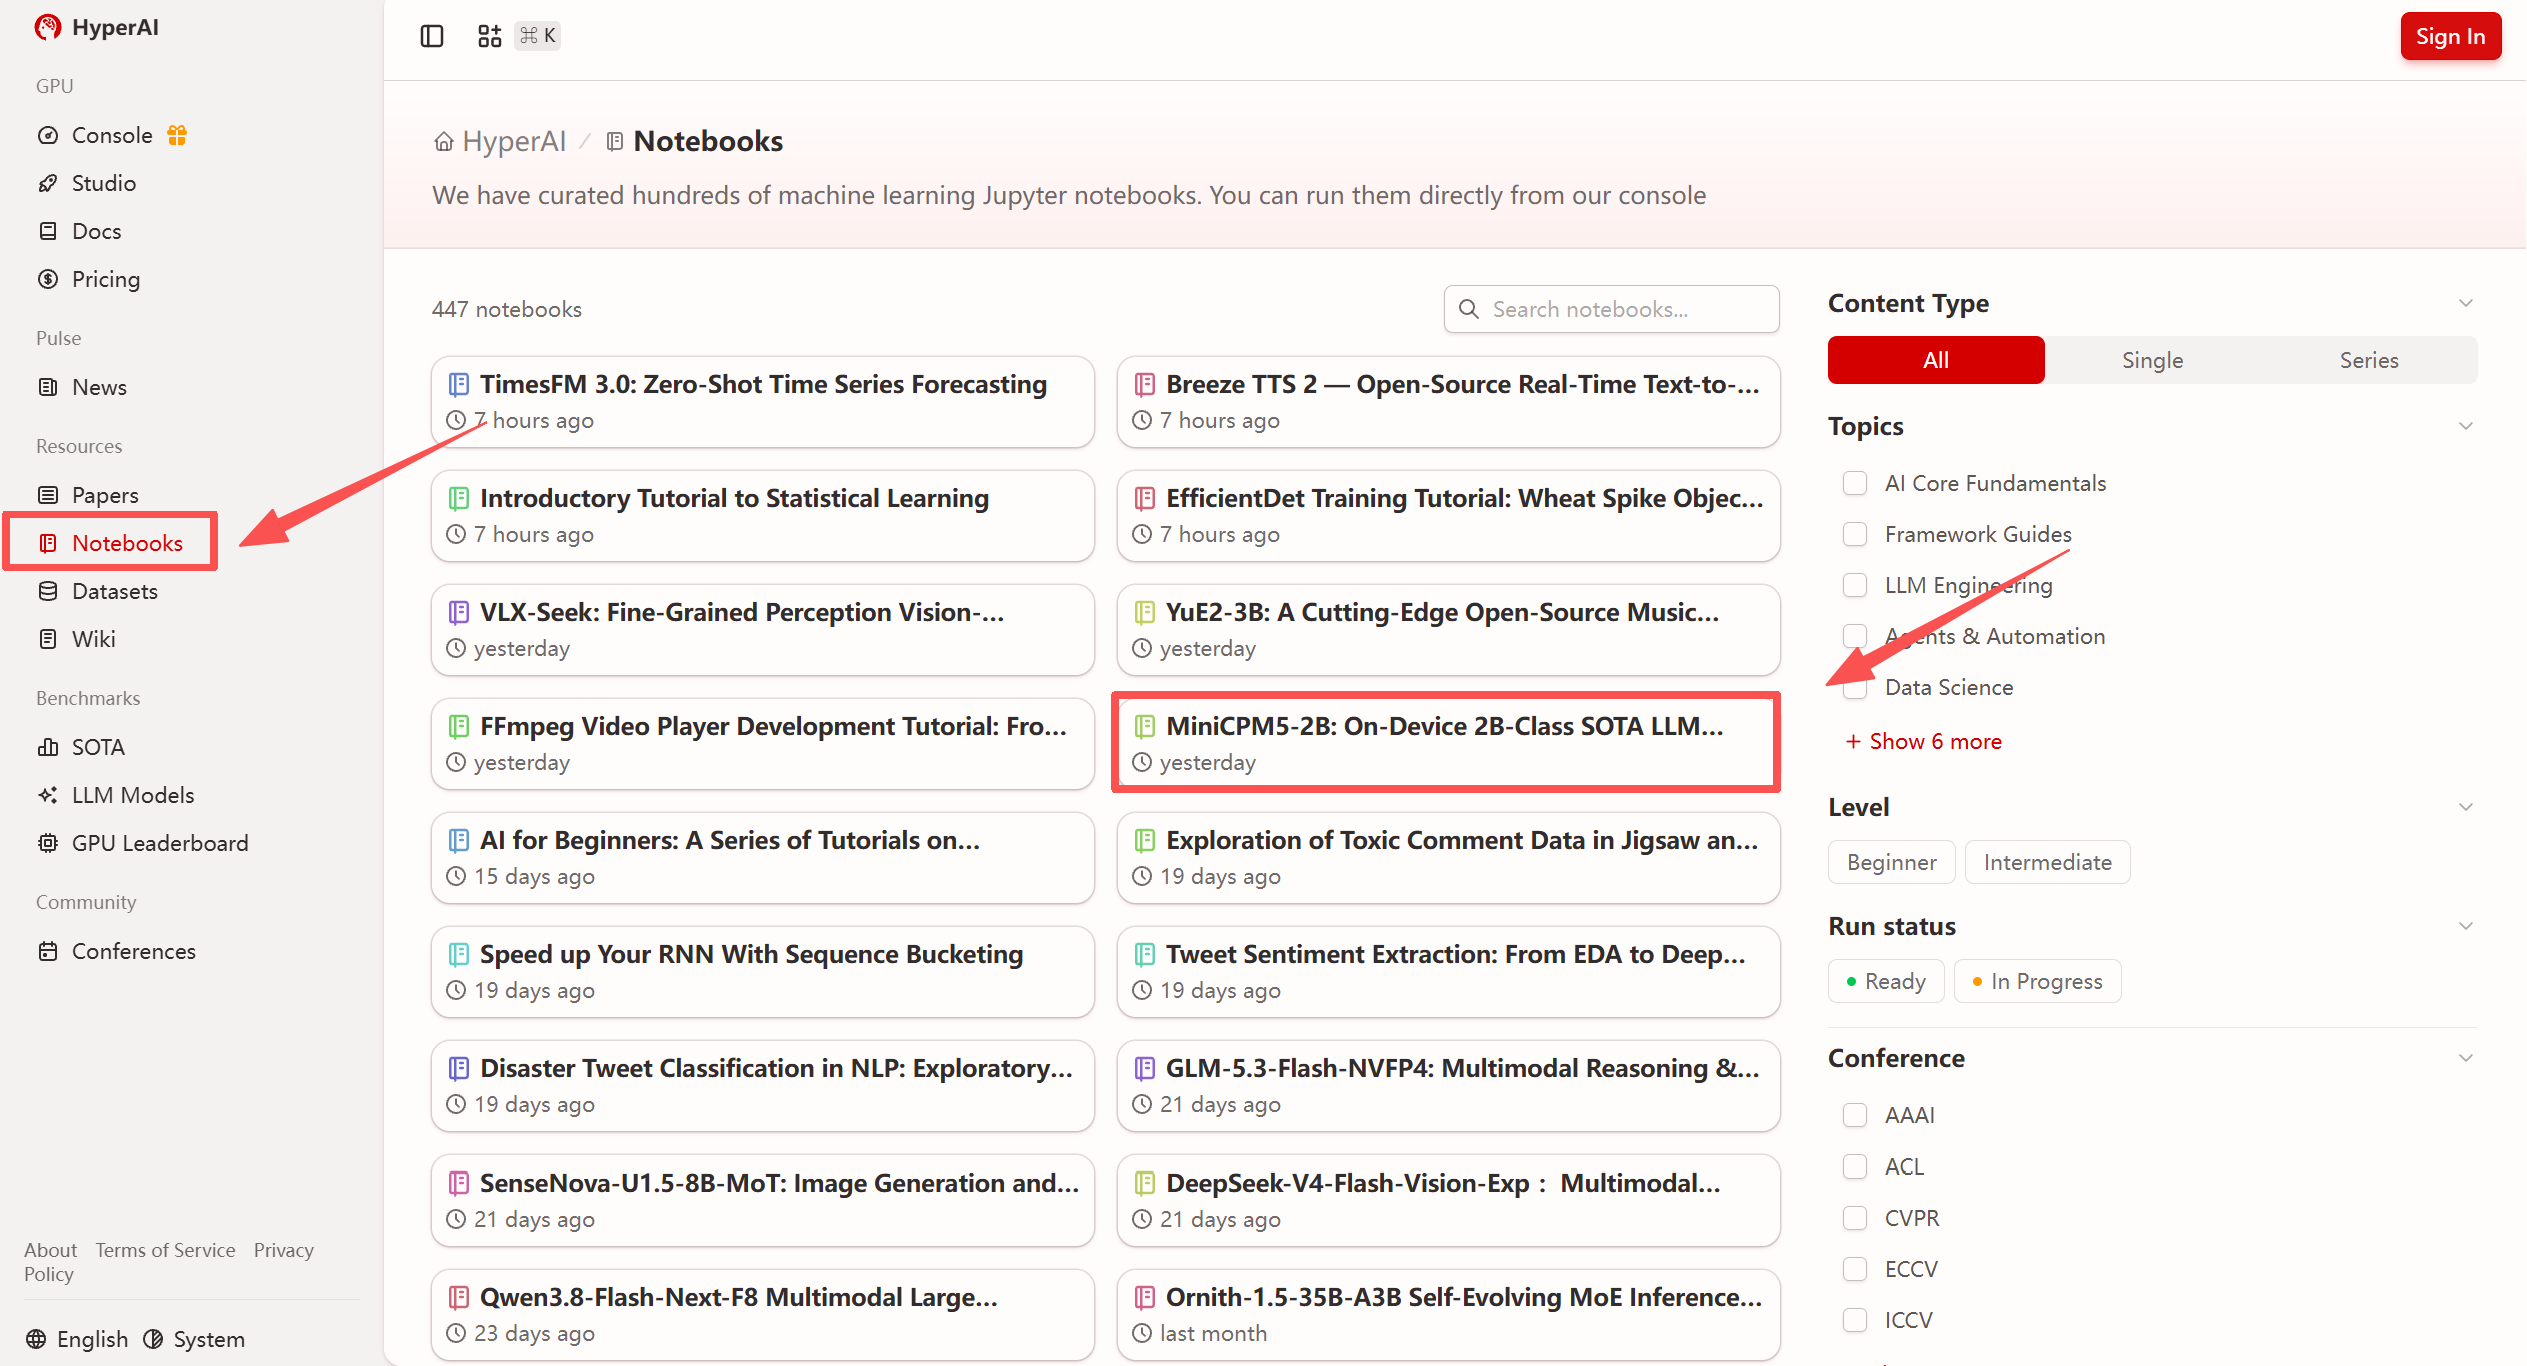
- Après avoir accédé à la page d'accueil de hyper.ai, sélectionnez la page « Tutoriels », ou cliquez sur « Voir plus de tutoriels », choisissez « MiniCPM5-2B : inférence de modèle SOTA de niveau 2B côté terminal », puis cliquez sur « Exécuter ce tutoriel ».
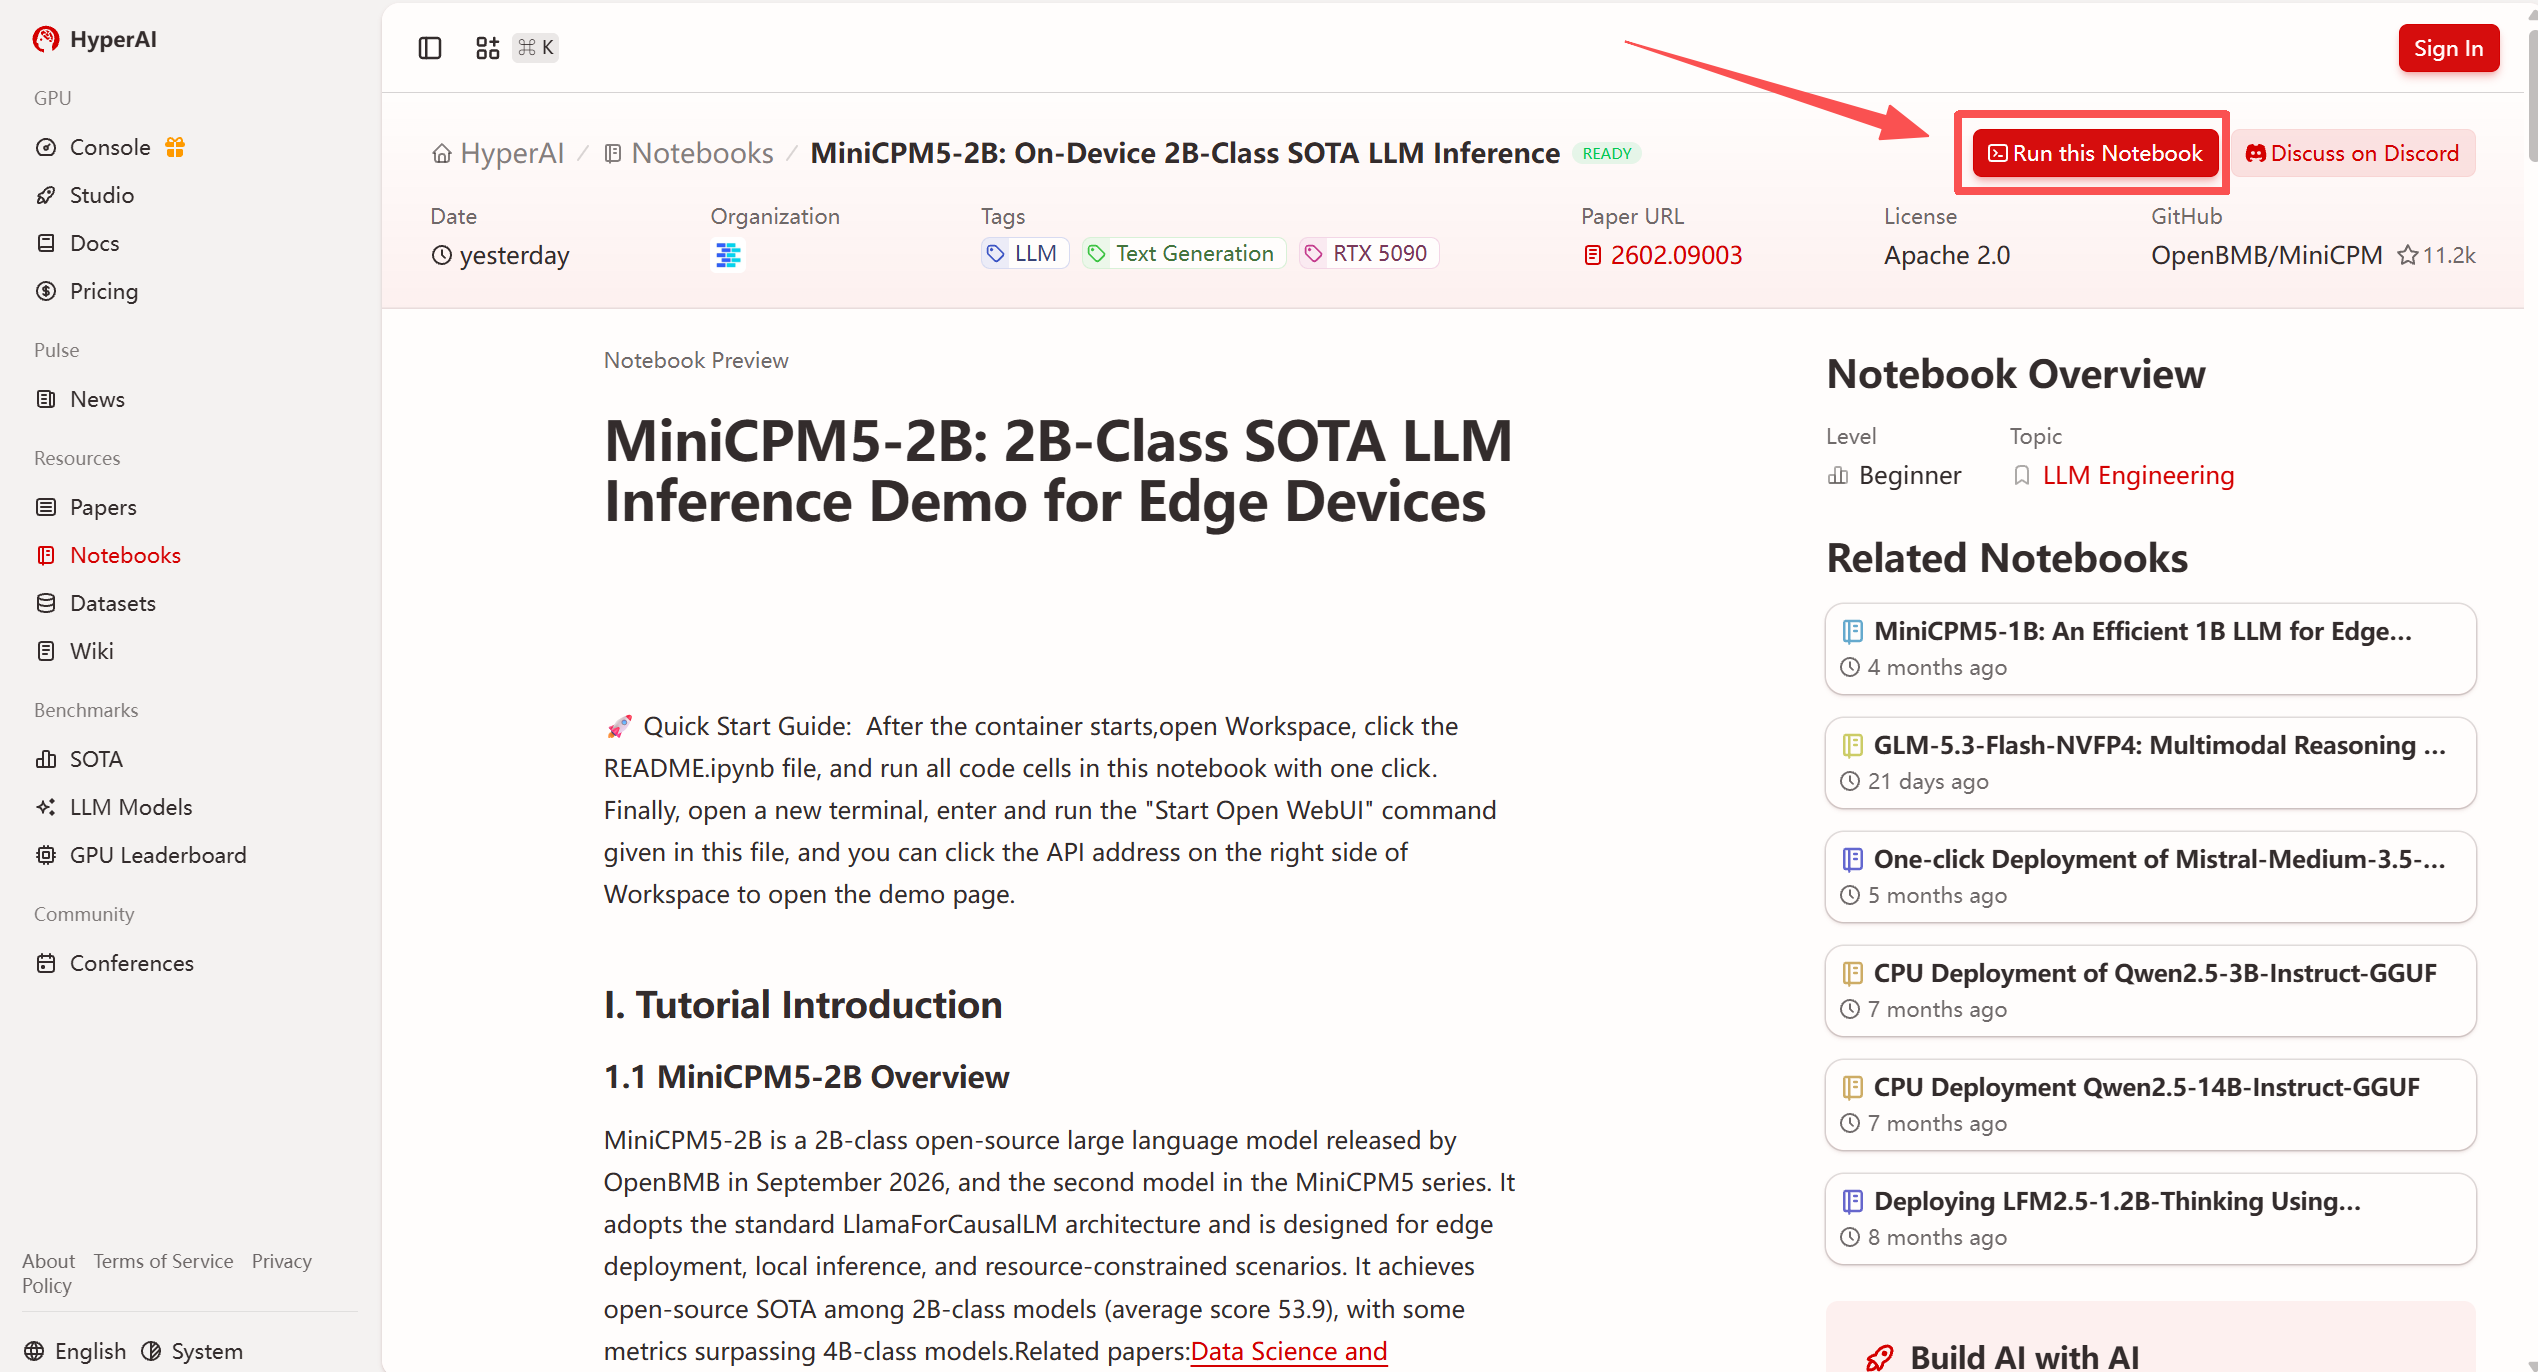
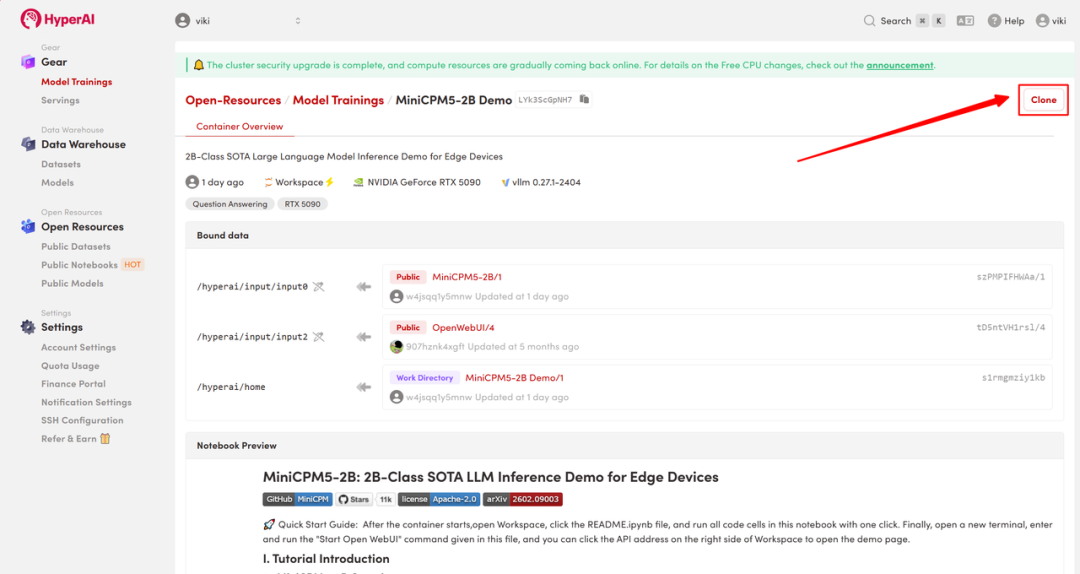
- Après le redirection de la page, cliquez sur « Clone » en haut à droite pour cloner ce tutoriel dans votre propre conteneur.
Remarque : le coin supérieur droit de la page permet de changer de langue, avec actuellement le chinois et l'anglais disponibles. Ce tutoriel utilise l'anglais pour illustrer les étapes.
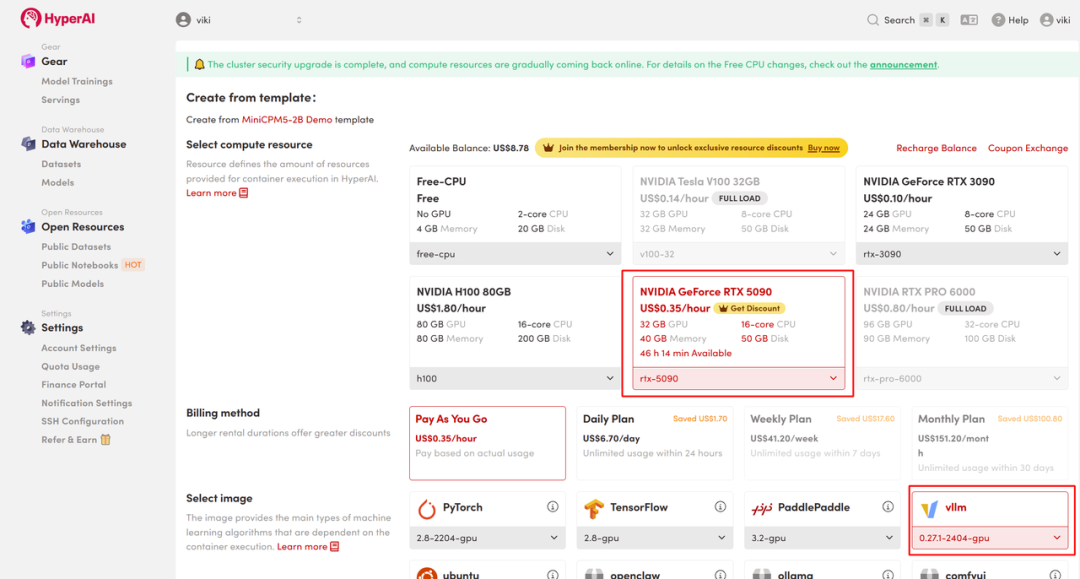
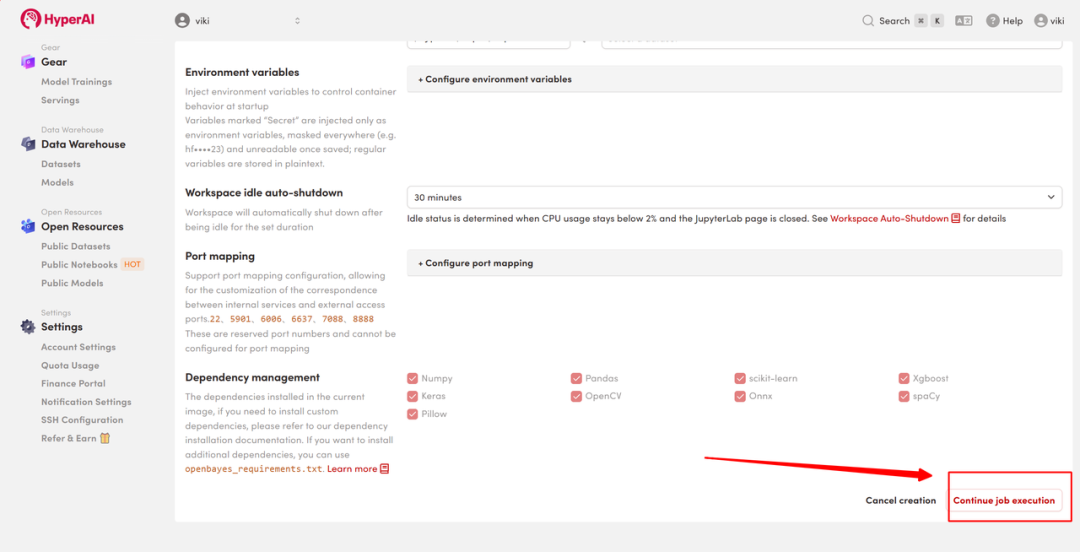
- Sélectionnez « NVIDIA RTX 5090 » et l'image « vllm », puis cliquez sur « Continue job execution (Continuer l'exécution) ».
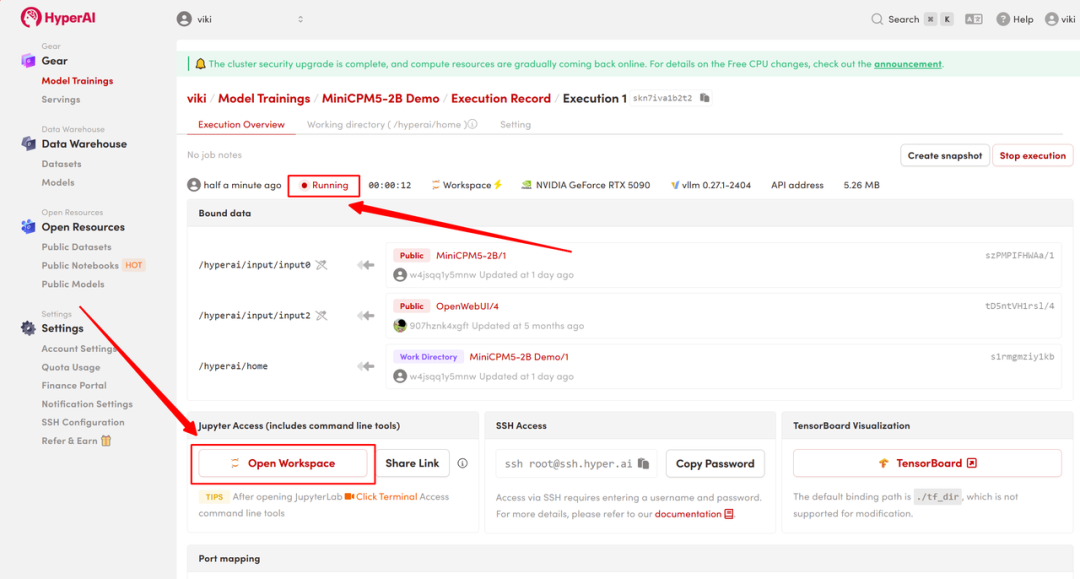
- Attendez l'allocation des ressources. Lorsque le statut passe à « Running (En cours) », cliquez sur « Open Workspace » pour accéder à Jupyter Workspace.
Présentation des résultats
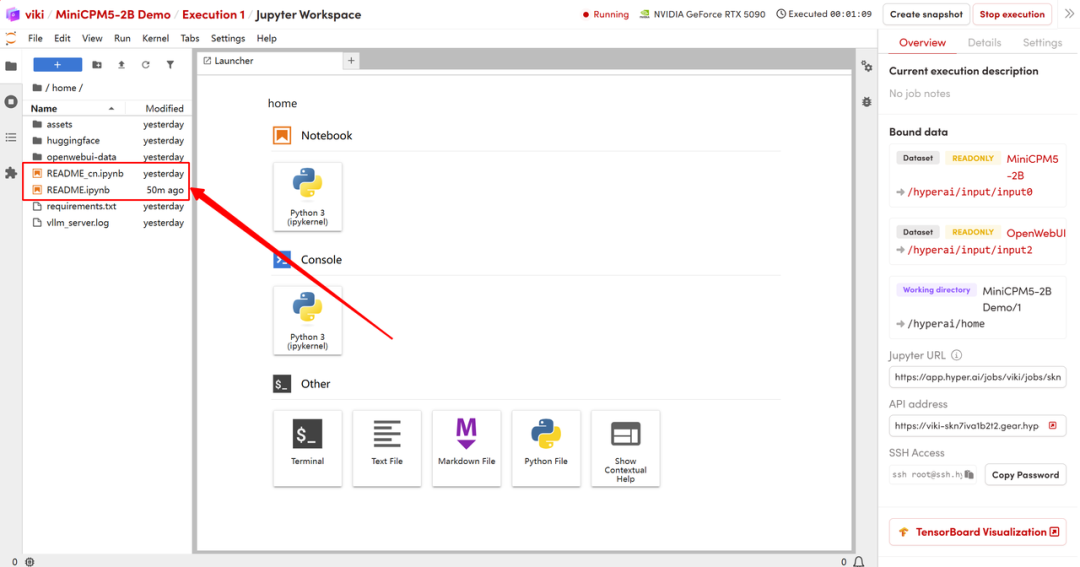
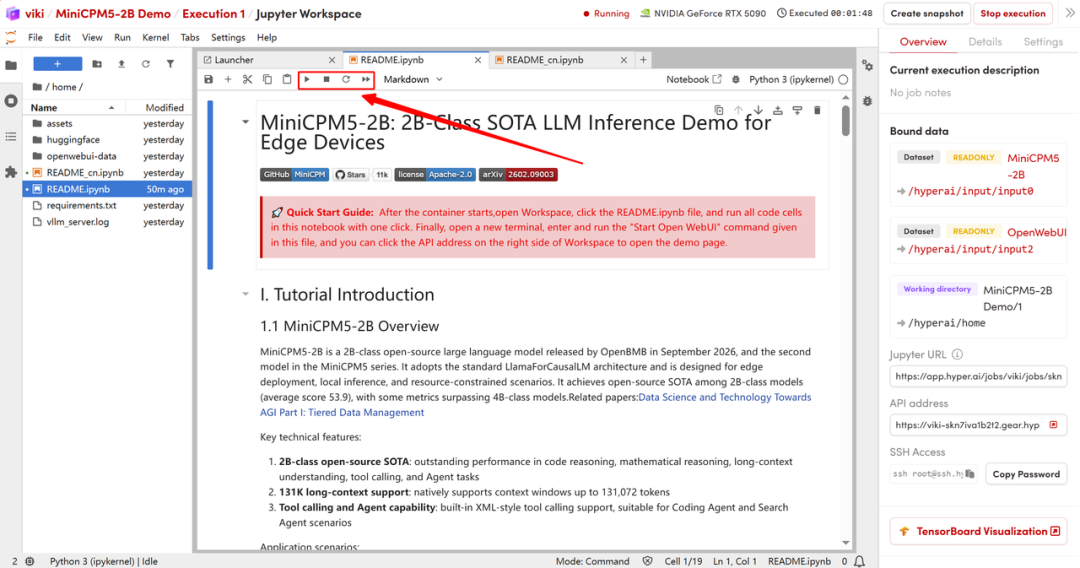
- Après le redirection de la page, cliquez sur le fichier README à gauche, puis cliquez sur Run (Exécuter) en haut une fois entré.
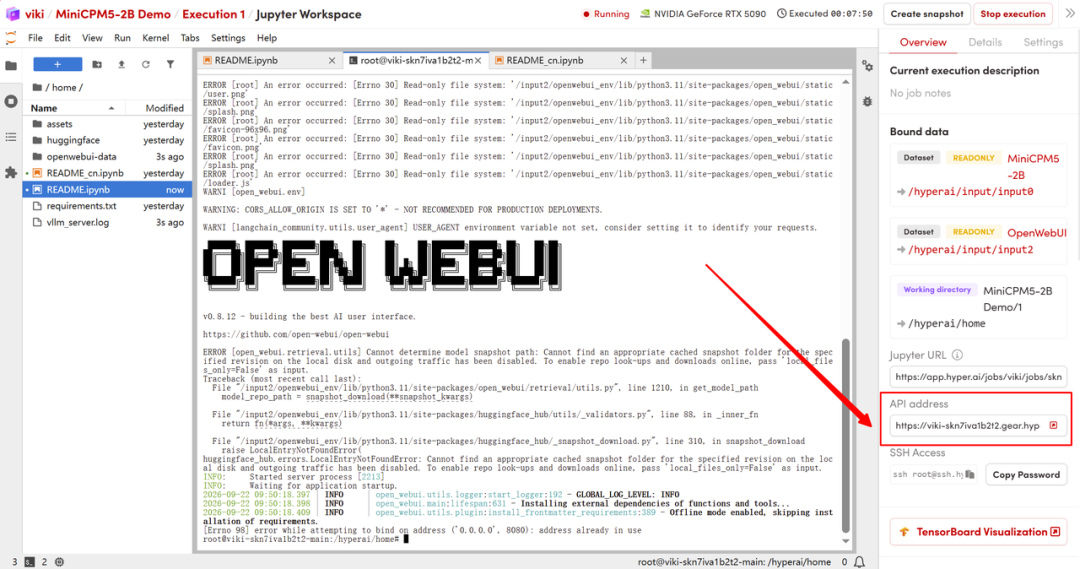
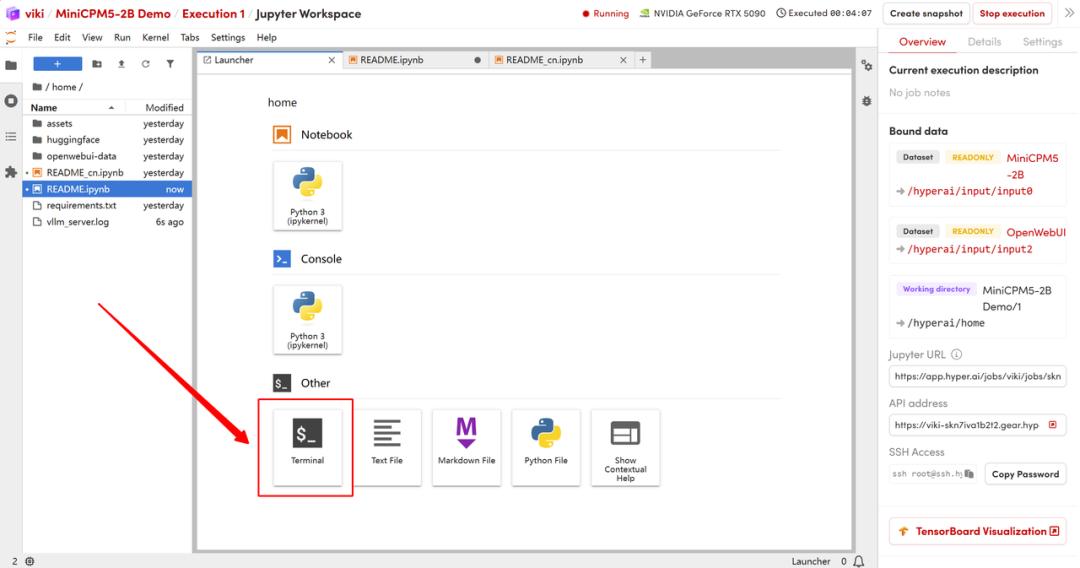
- Une fois l'exécution terminée, ouvrez un nouveau terminal et exécutez la commande suivante pour lancer Open WebUI.
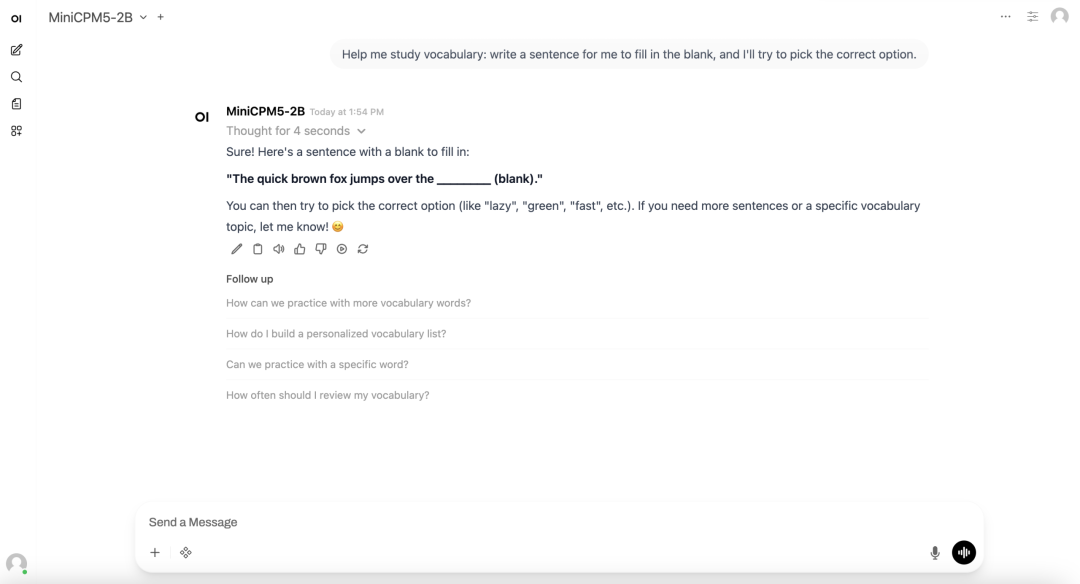
- Après le lancement, cliquez sur l'adresse API à droite pour accéder à l'interface Open WebUI dans le navigateur et commencer à dialoguer avec le modèle local.