Command Palette
Search for a command to run...
S’appuyant Sur Des Milliards De Gènes Provenant D’un Million D’espèces, NVIDIA Et D’autres Ont Construit La Série De Modèles EDEN, Atteignant Des Capacités De Prédiction De Génome Et De Protéines De Pointe (SOTA).
L'objectif fondamental de la biologie programmable est de parvenir à une conception rationnelle et à un contrôle précis des systèmes vivants, permettant ainsi des thérapies révolutionnaires pour les maladies complexes. Cependant,**Ce processus est depuis longtemps limité par la complexité inhérente aux systèmes biologiques.**Les réseaux de régulation à différentes échelles, les dépendances cachées à longue séquence et la grande adaptabilité des organismes aux changements environnementaux ont conduit la recherche et le développement traditionnels par « essais et erreurs » à un dilemme de personnalisation, de faible débit et de coût élevé.
En définitive, les données d'entraînement sur lesquelles reposent les modèles informatiques actuels, tant en termes d'échelle que de diversité, sont loin de couvrir l'immense espace de conception que la vie a développé au cours de milliards d'années d'évolution. Ces modèles peinent donc à saisir les principes de conception universels.Face à des modèles thérapeutiques innovants, multimodaux et à différentes échelles, la capacité de généralisation fait cruellement défaut.
Pour surmonter cette limitation fondamentale,**Basecamp Research, NVIDIA et plusieurs institutions universitaires de premier plan ont développé conjointement la série EDEN de modèles métagénomiques de base.**En exploitant d'immenses quantités de données d'évolution naturelle, communes à plusieurs espèces et liées à l'environnement, la « grammaire » profonde et les principes universels de la conception biologique ont été systématiquement extraits pour la première fois. Ce modèle, doté de 28 milliards de paramètres, a obtenu des résultats exceptionnels lors de nombreux tests de référence. Son avancée majeure réside dans sa capacité remarquable à comprendre et à générer des séquences interspécifiques, faisant ainsi passer le génie biologique du simple criblage à une nouvelle étape de « programmation prévisible ».
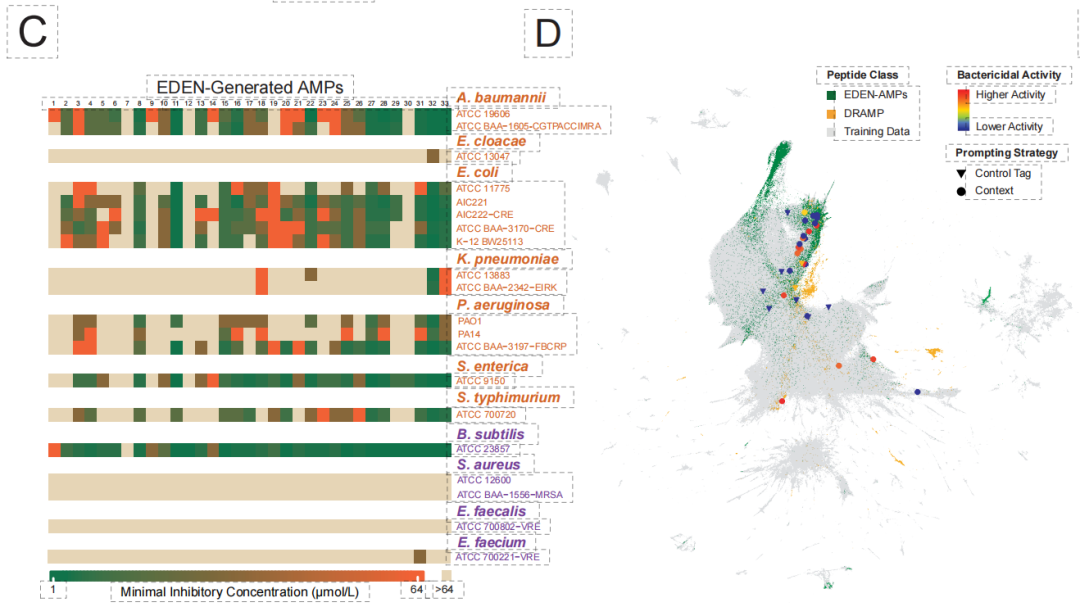
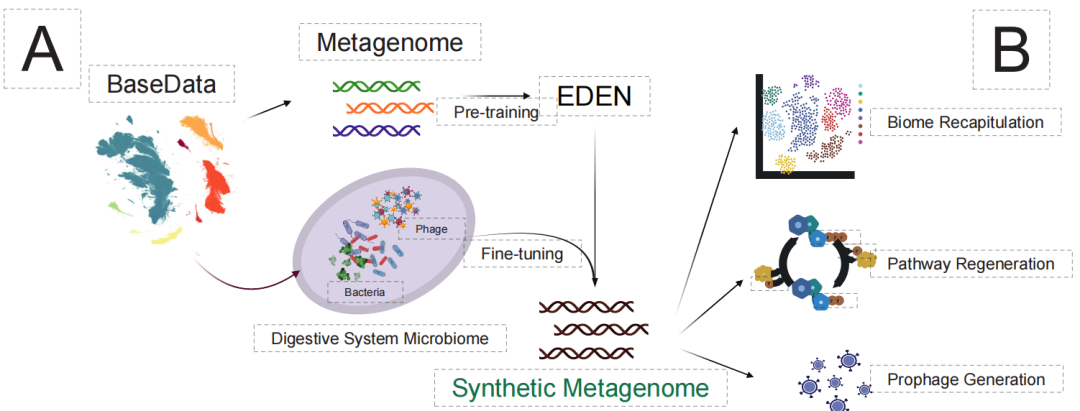
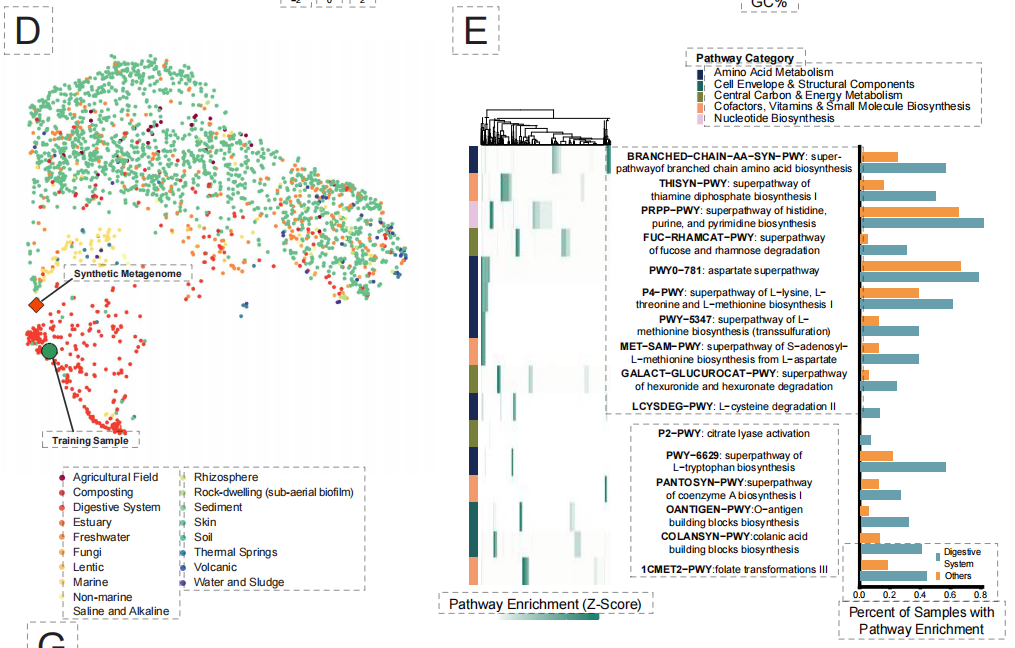
Pour valider les capacités d'EDEN en tant que moteur de bioconception unifié, l'équipe de recherche a mené des tests systématiques sur plusieurs modalités de traitement. En thérapie génique, EDEN, à partir d'une simple séquence de 30 bases indiquant un site cible, peut concevoir de novo des recombinases actives capables d'intégrer précisément de grands fragments dans le génome humain. Concernant la conception de peptides antimicrobiens…**La bibliothèque de peptides générée par le même modèle a montré une activité allant jusqu'à 97% contre des agents pathogènes multirésistants.**Elle possède également une puissance de l'ordre du micromolaire. À l'échelle de l'écosystème, EDEN a réussi à construire un microbiome synthétique contenant des dizaines de milliers de génomes artificiels, des voies métaboliques précises et des relations entre les espèces réalistes.
Les résultats de recherche associés, intitulés « Conception de thérapies programmables par l'IA avec la famille de modèles de base EDEN », ont été publiés en tant que prépublication sur bioRxiv.
Points saillants de la recherche :
* Elle a été pionnière dans un nouveau paradigme d'apprentissage des principes de conception universels directement à partir de l'histoire évolutive, et grâce à l'entraînement avec BaseData, une base de données métagénomiques couvrant la biodiversité mondiale, elle a atteint des capacités exceptionnelles de compréhension et de génération de séquences inter-espèces.
* Cette étude valide la grande polyvalence d'un modèle fondamental unique pour la conception de thérapies multimodales et multi-échelles, démontrant qu'un seul modèle peut répondre de manière uniforme à des défis de conception complexes allant des molécules aux écosystèmes.
* EDEN, utilisant uniquement des indices d'ADN, peut concevoir des recombinases fonctionnelles pour de multiples sites liés à la maladie, atteignant un taux de réussite fonctionnelle de 63,21 TP3T sur des cibles non entraînées.
 Adresse du document :
https://doi.org/10.64898/2026.01.12.699009Suivez notre compte WeChat officiel et répondez « EDEN » en arrière-plan pour obtenir le PDF complet.
Autres articles sur les frontières de l'IA : https://hyper.ai/papers
Jeu de données BaseData : redéfinir les critères de référence des données d’IA biologique grâce à des séquences longues de haute qualité.
L'ensemble de données BaseData utilisé dans cette étude s'affranchit fondamentalement des limitations des bases de données biologiques traditionnelles. Ces dernières s'appuient généralement sur un nombre limité de génomes de référence et de courtes séquences fragmentées, tandis que BaseData vise à capturer systématiquement des signaux évolutifs complets, construisant ainsi une chaîne d'approvisionnement de données génomiques évolutives couvrant la biodiversité mondiale.
La valeur fondamentale de BaseData réside principalement dans son envergure et sa composition stratégique. Comme le montre le diagramme ci-dessous,**Il contient 9,7 billions de marqueurs nucléotidiques pour l'entraînement, couvrant plus d'un million de nouvelles espèces et 100 milliards de nouveaux gènes.**Plus important encore, les données ne sont pas collectées aléatoirement, mais délibérément enrichies de séquences à haute densité d'information, telles que les données métagénomiques environnementales, les bactériophages et les éléments génétiques mobiles. Ces données enregistrent naturellement des dynamiques évolutives clés, comme les interactions bactériophage-hôte et les transferts horizontaux de gènes, fournissant ainsi un matériel essentiel aux modèles pour l'apprentissage de règles fonctionnelles universelles entre les espèces.
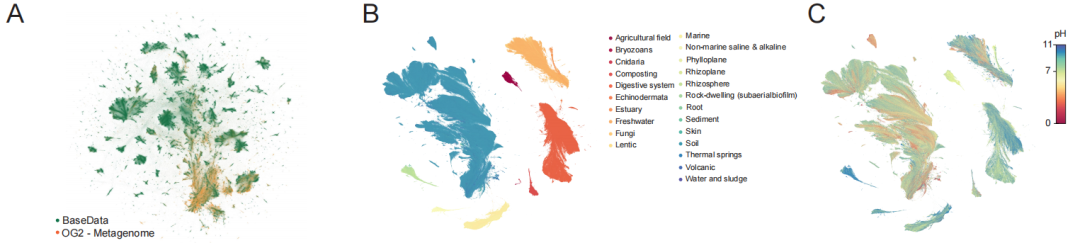
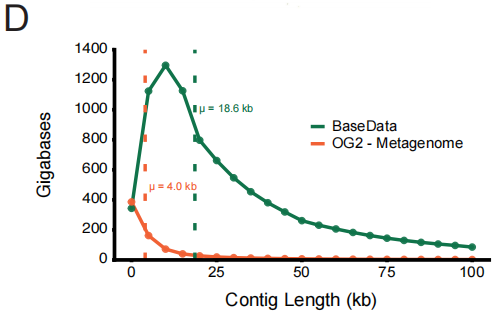
De plus, toutes les données ont été obtenues grâce à des accords juridiques standardisés couvrant 28 pays et 208 licences, établissant un cadre de traçabilité et de partage des avantages de la source à l'utilisation, et définissant les normes éthiques et de gouvernance nécessaires à la recherche en IA biologique à grande échelle.
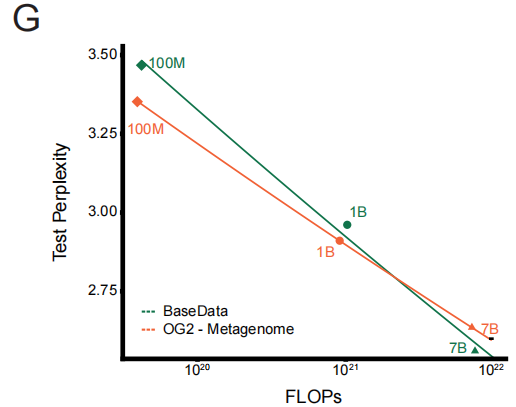
**La famille de modèles EDEN est conçue avec « l'évolutivité, l'universalité et l'évolutivité » comme principes de conception fondamentaux, avec des paramètres de modèle allant de 100 millions à 28 milliards.**Parmi eux, EDEN-28B, en tant que modèle de travail principal, possède une architecture et une stratégie d'entraînement profondément adaptées aux propriétés uniques des données métagénomiques.
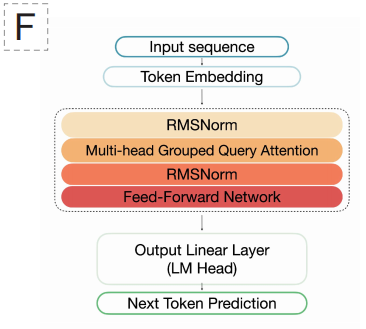
En termes d'architecture du modèle,**EDEN adopte une architecture Transformer uniquement basée sur le décodeur, validée par des modèles de langage à grande échelle, et plus précisément sur le style de conception de Llama 3.1.**Ce choix est rendu possible par la capacité supérieure du Transformer à modéliser les dépendances à longue portée. EDEN-28B est un réseau à 48 couches, comprenant 6 144 couches cachées, 48 nœuds d'attention et utilisant la fonction d'activation SwiGLU avec un encodage positionnel RoPE. Le modèle emploie une méthode de tokenisation à résolution mononucléotidique avec un vocabulaire de 512 caractères, ce qui lui permet de comprendre et de générer des séquences d'ADN au niveau le plus élémentaire, celui des « lettres ».
L'un des principaux atouts technologiques réside dans sa capacité à générer de longues séquences. Bien que la fenêtre de contexte du modèle soit fixée à 8 192 étiquettes, dans les applications pratiques,**Il peut générer de manière stable et assembler avec précision des séquences génomiques cohérentes de plus de 13 000 paires de bases tout en conservant l'ordre correct des gènes, les cadres de lecture et les structures des éléments régulateurs.**Cela indique que le modèle apprend bien plus qu'une simple correspondance de motifs locaux ; il peut inférer et appliquer une « grammaire » plus profonde de l'organisation génomique, qui dépasse la longueur de la fenêtre physique. L'entraînement complet a été réalisé sur 1 008 GPU H100, permettant un apprentissage efficace à partir d'une quantité massive de données évolutives grâce au calcul distribué à grande échelle.
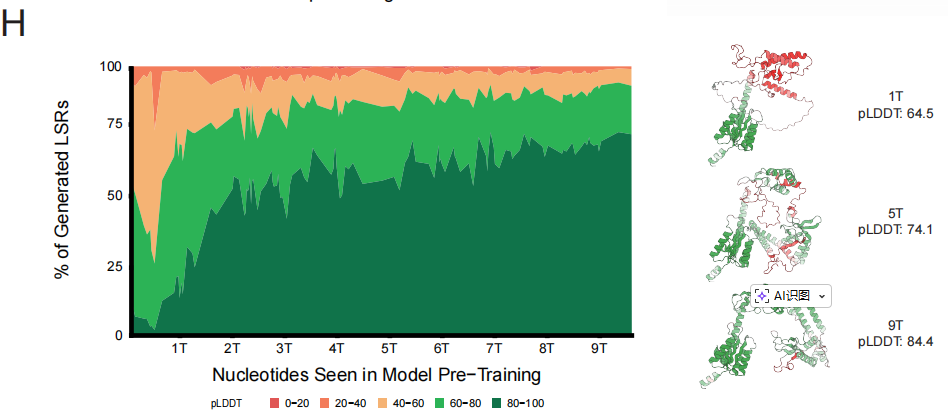
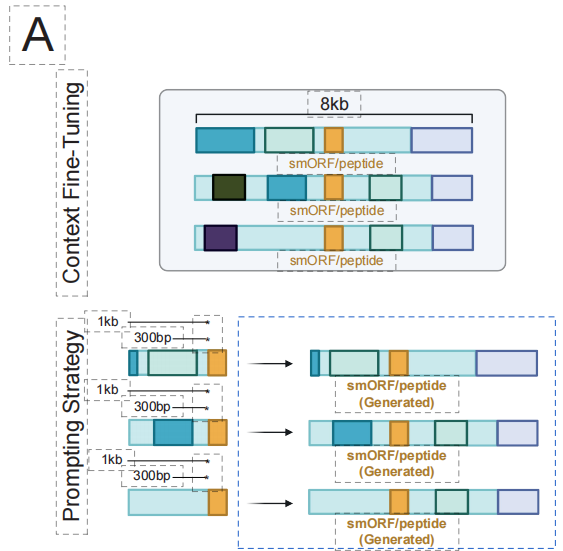
En nous appuyant sur ces bases solides, nous pouvons ensuite cibler des tâches de conception thérapeutique spécifiques, telles que la conception de recombinases ciblant des sites d'ADN spécifiques ou la génération de nouveaux peptides antimicrobiens.**Avec seulement une petite quantité de données de haute qualité appariées à la tâche pour un réglage fin léger, le modèle peut rapidement maîtriser le « dialecte » de la tâche.**Cette conception permet à un seul modèle EDEN de servir de « moteur de séquence biologique » universel, s'adaptant et pilotant avec souplesse diverses modalités thérapeutiques allant de l'insertion de gènes et de la conception de peptides à l'ingénierie du microbiome, réalisant ainsi véritablement la vision de la biologie programmable « un modèle, de multiples capacités ».
Stimuler l'innovation thérapeutique aux niveaux moléculaire, cellulaire et écosystémique
Afin de vérifier systématiquement l'universalité et l'efficacité du modèle EDEN dans la conception réelle des traitements, l'équipe de recherche a sélectionné quatre directions clés très différentes en termes d'échelle, de modèle et de complexité biologique pour une vérification expérimentale.
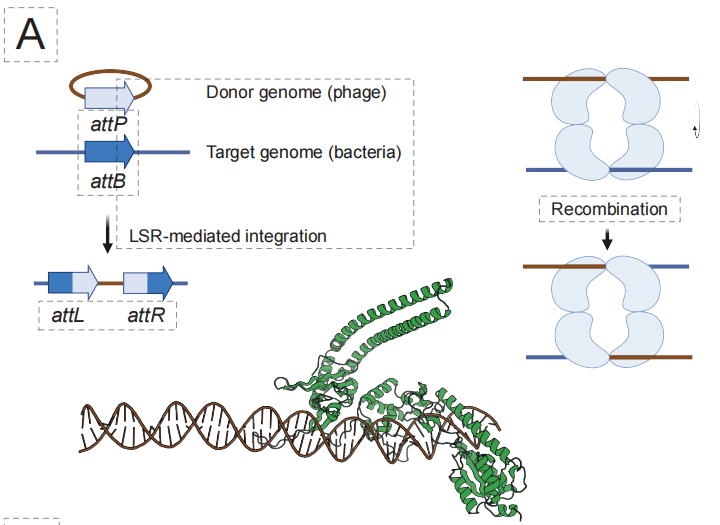
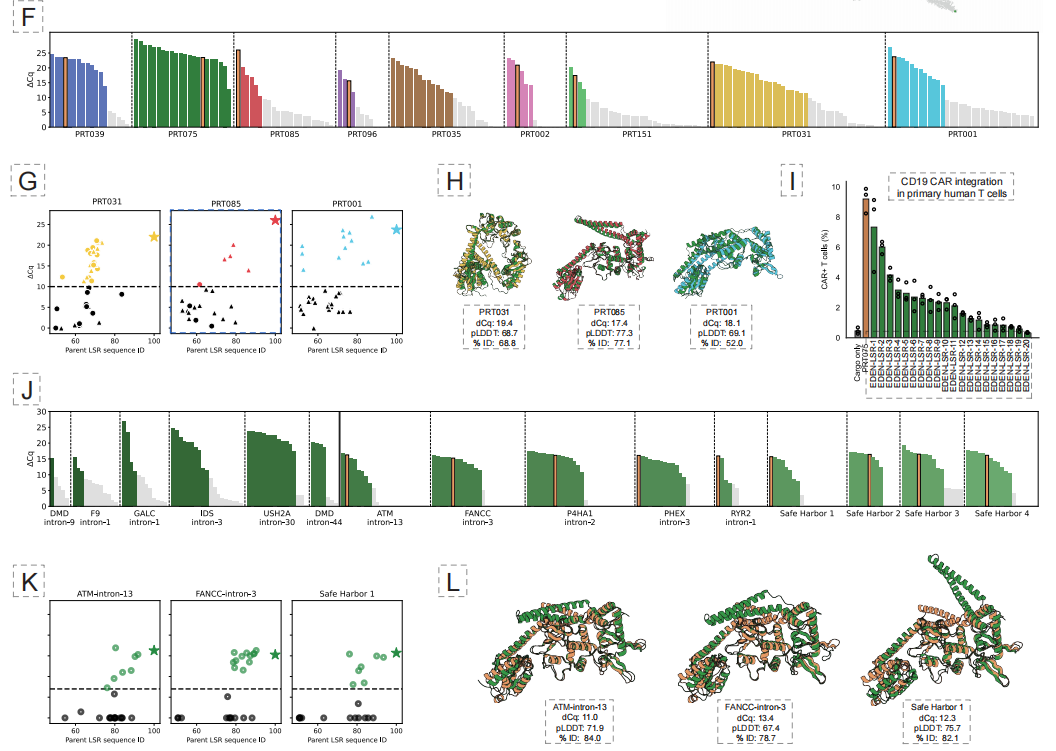
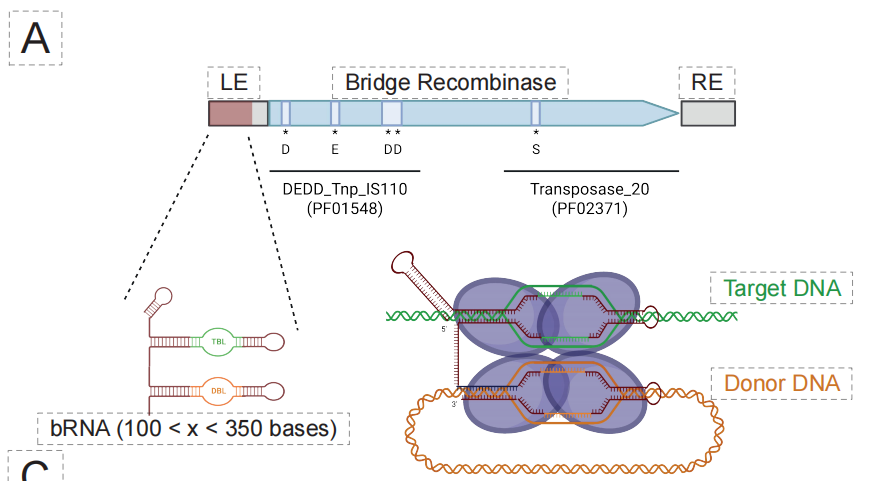
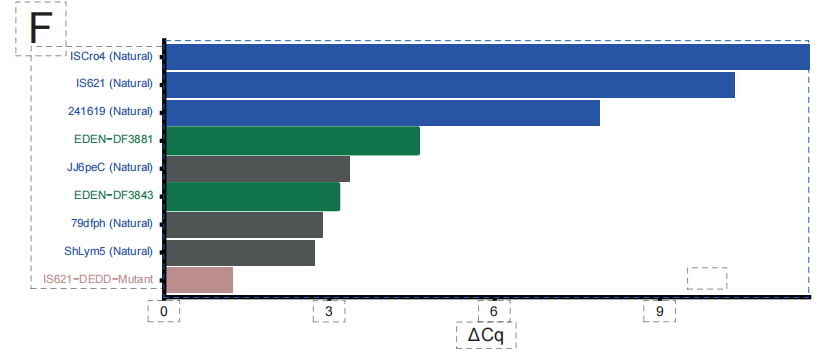
**Dans le domaine de l'insertion de gènes programmable par l'IA (aiPGI), l'équipe s'est concentrée sur le dépassement du goulot d'étranglement de longue date que représente « l'intégration précise de grands fragments d'ADN ».**La technologie CRISPR traditionnelle repose sur la création de cassures double brin, or les grandes recombinases à sérine naturelles ne peuvent pas reconnaître les séquences du génome humain. Comme illustré ci-dessous, la solution d'EDEN consiste à construire le modèle EDEN-LSR, capable de comprendre la relation de correspondance « séquence d'ADN cible → recombinase correspondante », grâce à un ajustement précis des millions d'appariements LSR-site d'attachement contenus dans le modèle.
L'innovation par l'intégration de l'IA et de la biologie synthétique
Ces dernières années, l'intégration et l'innovation entre le monde universitaire et l'industrie dans le domaine de la biologie programmable se sont considérablement accélérées, et une série d'avancées majeures redéfinissent les frontières de la bioconception.
Les plus grandes institutions académiques du monde transforment les connaissances sur l'évolution en modèles informatiques d'une ampleur et d'une précision sans précédent. Par exemple, début 2024, une équipe conjointe de DeepMind, d'Isomorphic Labs et de plusieurs universités a publié le modèle AlphaFold 3, capable de prédire simultanément la structure et les interactions des protéines, et de générer de nouvelles protéines aux fonctions spécifiques. Ce modèle est le premier à intégrer l'interaction complexe des biomolécules dans un cadre unifié pour la simulation de haute précision.La revue Nature l'a salué comme « un bond en avant dans la cartographie des mécanismes internes des machines moléculaires de la vie ».
L'industrie accélère la transformation de ces avancées en plateformes et thérapies. Dans le domaine du développement de médicaments piloté par l'IA, NVIDIA et Recursion Pharmaceuticals ont lancé BioNeMo, une bibliothèque de modèles d'IA en biochimie visant à faire évoluer la recherche de médicaments, d'une approche fastidieuse et répétitive à une approche guidée. La société de biologie synthétique Ginkgo Bioworks exploite sa plateforme automatisée pour concevoir systématiquement des communautés microbiennes destinées à la capture du carbone et à la production de composés chimiques, favorisant ainsi l'ingénierie d'écosystèmes synthétiques.
Cette nouvelle vague, portée par les données et les algorithmes, propulse la biologie d'une science observationnelle et descriptive vers une discipline d'ingénierie programmable, déboguable et prévisible. Cela signifie non seulement que nous pouvons programmer le vivant avec plus de précision pour vaincre les maladies, mais aussi que nous préfigurons notre capacité à concevoir systématiquement des systèmes biologiques pour relever les défis mondiaux liés aux ressources, à l'environnement et à la santé.
Liens de référence :
1.https://nvidianews.nvidia.com/news/nvidia-announces-broad-expansion-of-its-biomedicine-platform
2.https://www.ginkgobioworks.com/2024/01/04/ginkgo-bioworks-and-pfizer-expand-collaboration-to-advance-rna-based-therapeutics/