Command Palette
Search for a command to run...
Téléchargez Meta, Le Plus Grand Ensemble De Données De Segmentation Vidéo, En Un Clic ! Contient 50,9 000 Vidéos Du Monde Réel Couvrant 47 Pays
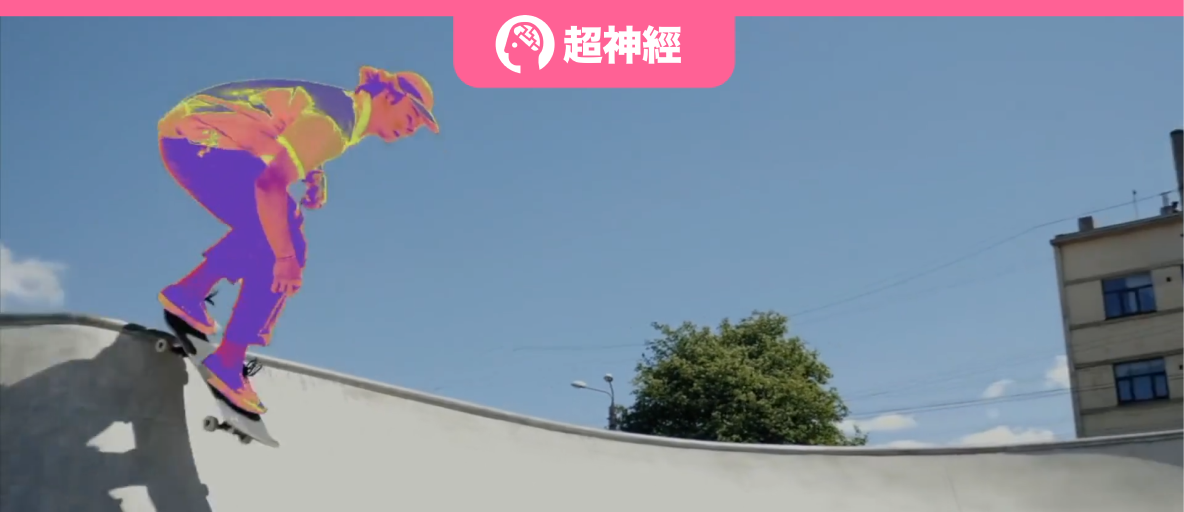
En avril 2023, Meta a publié le Segment Anything Model (SAM), prétendant pouvoir « tout segmenter ». Cette réalisation innovante qui subvertit les tâches traditionnelles de vision par ordinateur (CV) a suscité de nombreuses discussions dans l’industrie et a été rapidement appliquée à la recherche dans des domaines verticaux tels que la segmentation d’images médicales. Récemment, SAM a été à nouveau mis à niveau.Meta a publié le modèle open source Segment Anything Model 2 (SAM 2), marquant une nouvelle étape historique dans le domaine de la vision par ordinateur.
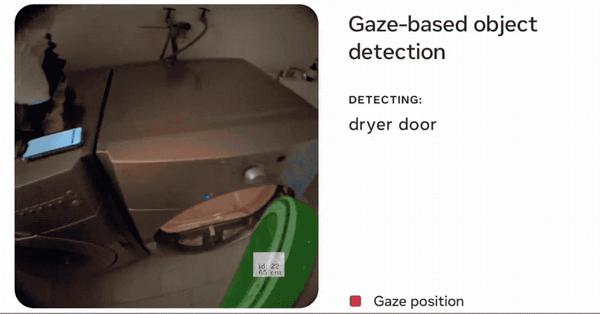
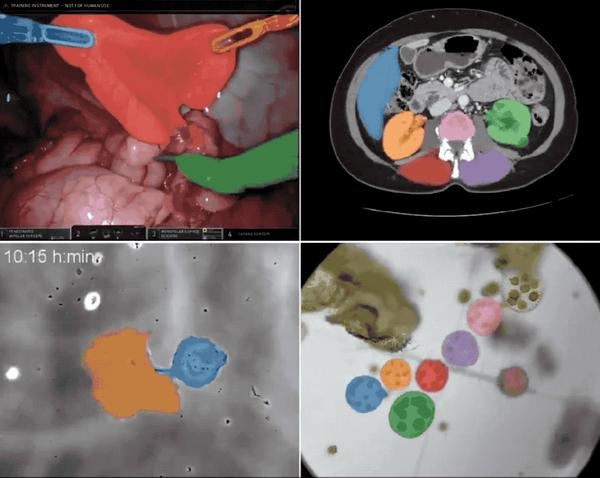
De la segmentation d'images à la segmentation vidéo,**SAM 2 démontre des performances supérieures dans la segmentation des signaux en temps réel.**Le modèle introduit les fonctions de segmentation et de suivi des images et des vidéos dans un modèle unifié. Il peut identifier et segmenter avec précision n'importe quel objet dans une image ou une vidéo en saisissant simplement une invite (clic, case ou masque) sur l'image vidéo. Cette capacité d’apprentissage unique sans échantillon confère à SAM 2 une polyvalence extrêmement élevée.Il présente un grand potentiel d’application dans les domaines de la médecine, de la télédétection, de la conduite autonome, de la robotique, de la détection d’objets camouflés, etc. Meta est confiant : « Nous pensons que nos données, nos modèles et nos informations deviendront une étape importante dans la segmentation vidéo et les tâches de perception associées ! »
C'est vrai. Dès le lancement de SAM 2, tout le monde était impatient de l’utiliser, et l’effet était incroyable !
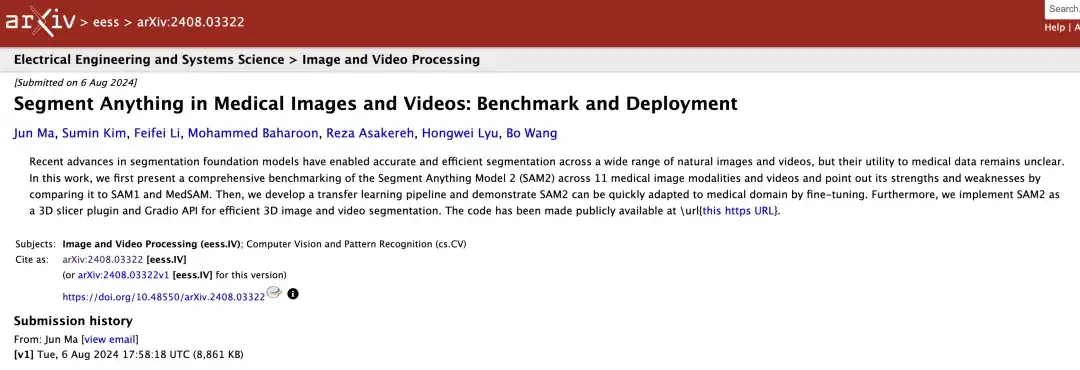
Article original :
https://arxiv.org/abs/2408.03322
 Téléchargement direct de l'ensemble de données de segmentation vidéo SA-V :
https://go.hyper.ai/e1Tth
Plus d'ensembles de données de haute qualité à télécharger : https://go.hyper.ai/P5Mtc
Au-delà des ensembles de données de segmentation vidéo existants ! SA-V couvre plusieurs sujets et scénarios
Les chercheurs de Meta ont collecté un ensemble de données de segmentation vidéo vaste et diversifié SA-V à l'aide de Data Engine, comme indiqué dans le tableau suivant,**L'ensemble de données contient 50,9 K vidéos, 642,6 K masques (191 K annotés manuellement avec l'aide de SAM 2, 452 K générés automatiquement par SAM 2),**Comparé à d'autres ensembles de données de segmentation d'objets vidéo (VOS) courants, SA-V a considérablement amélioré le nombre de vidéos, de masques et de masques.**Le nombre de masques annotés est 53 fois supérieur à celui de n’importe quel ensemble de données VOS existant.**Il fournit une riche ressource de données pour les futurs travaux de vision par ordinateur.
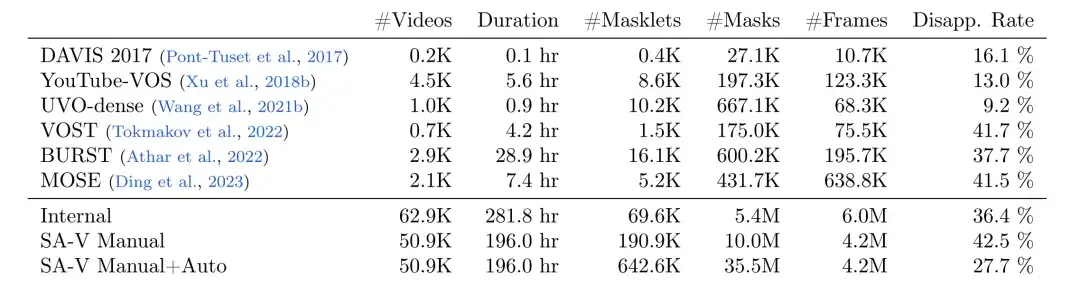
* SA-V Manuel+Auto combine des étiquettes annotées manuellement avec des segments de masque générés automatiquement
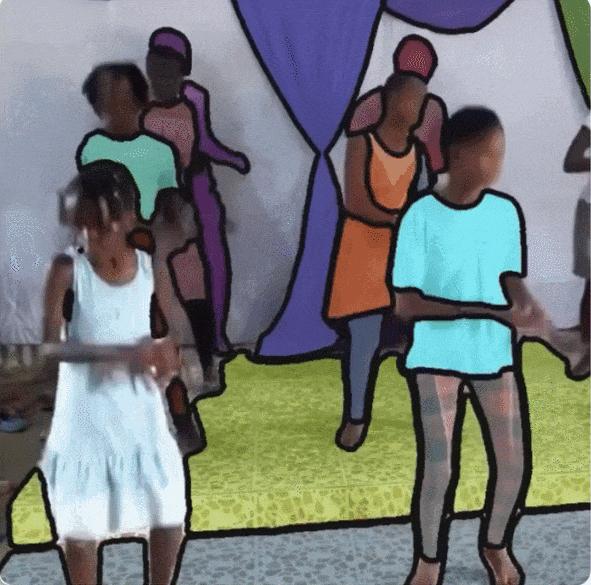
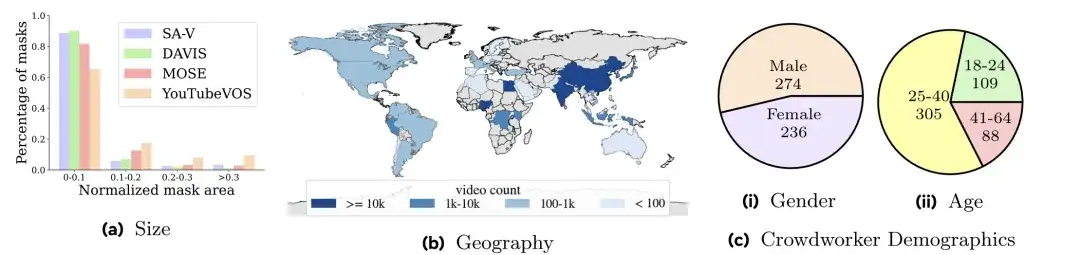
Il est entendu que le nombre de vidéos contenues dans SA-V dépasse l’ensemble de données VOS existant et que la résolution vidéo moyenne est de 1401 × 1037 pixels.**Les vidéos collectées couvrent diverses scènes quotidiennes.**Y compris 54% de vidéos de scènes intérieures et 46% de vidéos de scènes extérieures, d'une durée moyenne de 14 secondes. aussi,**Les thèmes de ces vidéos varient.**Incluant des lieux, des objets, des scènes, etc., les masques vont des grands objets (tels que des bâtiments) aux détails fins (tels que la décoration intérieure).
Téléchargement direct de l'ensemble de données de segmentation vidéo SA-V : https://go.hyper.ai/e1Tth
Les ensembles de données ci-dessus sont recommandés par HyperAI dans ce numéro. Si vous voyez des ressources de jeux de données de haute qualité, n'hésitez pas à laisser un message ou à soumettre un article pour nous le faire savoir !
Plus d'ensembles de données de haute qualité à télécharger :
https://go.hyper.ai/P5Mtc