Command Palette
Search for a command to run...
Juste! L'ACL 2024 Annonce Les 7 Meilleurs Articles, Le Premier Auteur De Premier Cycle De HUST Remporte Un Prix
Le 11 août, la réunion annuelle de renommée mondiale de l'Association for Computational Linguistics (ACL) s'est officiellement ouverte à Bangkok, en Thaïlande. L'ACL 2024 durera 6 jours et comprendra 34 ateliers en plus de la conférence principale.
Depuis 2022, l'ACL a adopté un mécanisme de révision continue (ACL Rolling Review, ARR), fixant une échéance chaque mois. En janvier de cette année, les autorités ont également annoncé une bonne nouvelle : la période d'anonymat pour la soumission des articles a été annulée et les auteurs ont été autorisés à publier leurs travaux pendant la période de soumission. Ce règlement entrera également en vigueur directement lors du prochain cycle de révision après sa publication.
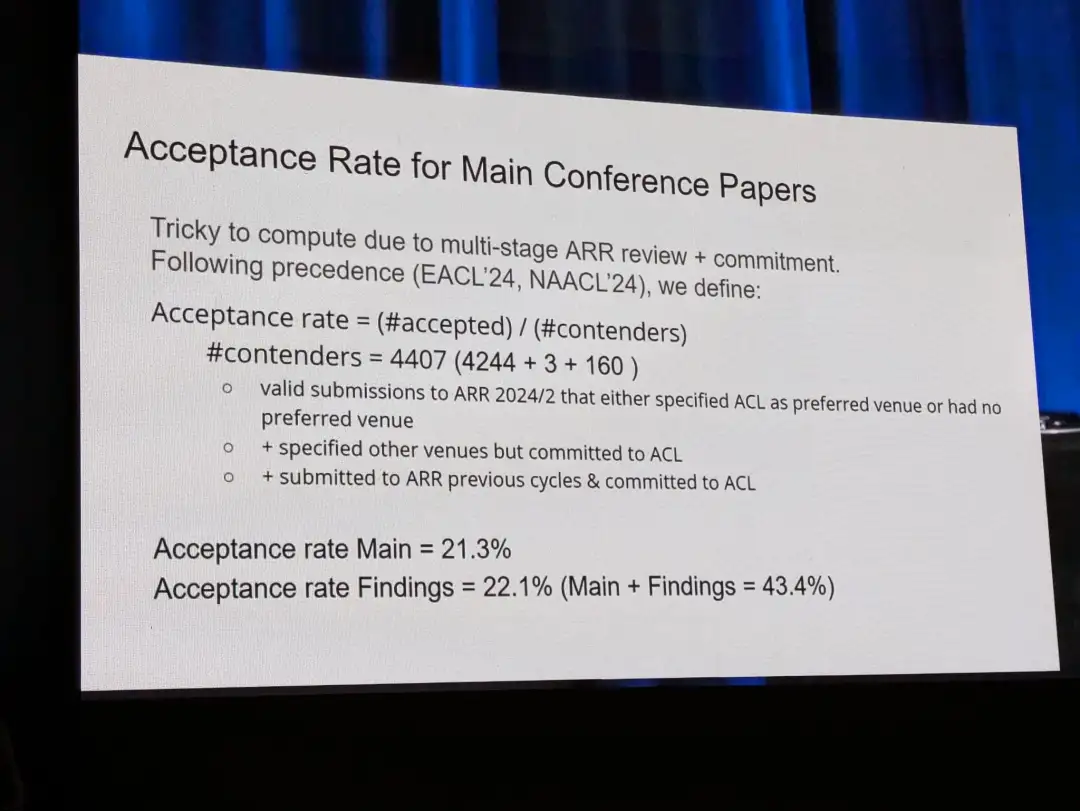
Selon les données officielles,Le taux d'acceptation de la conférence principale de cette année est de 21,3% et le taux d'acceptation des résultats est de 22,1%.
 Il convient de mentionner qu'ACL 2024 a également ajouté un thème spécial « Science ouverte, données ouvertes et modèles ouverts pour la recherche reproductible en PNL », qui accepte des ensembles de données open source de haute qualité, des modèles open source, des logiciels open source et d'autres résultats de recherche connexes, visant à stimuler les discussions dans l'industrie sur la science ouverte et la recherche reproductible en PNL, et à soutenir le développement de logiciels open source.
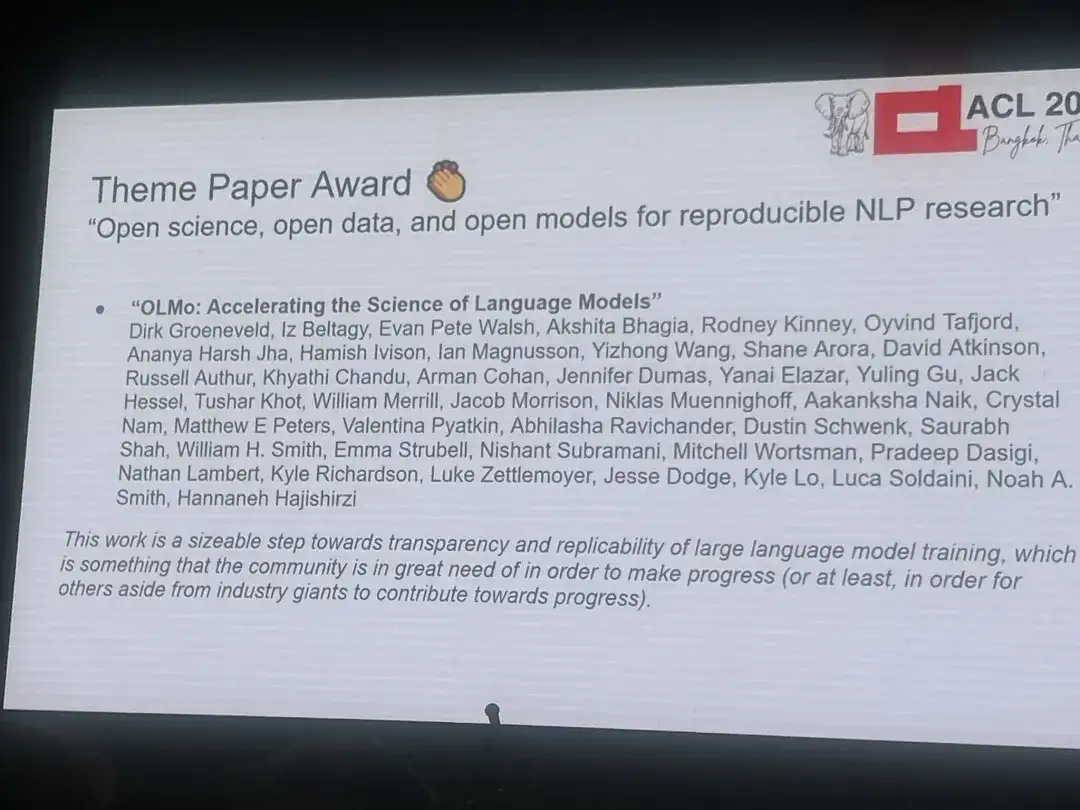
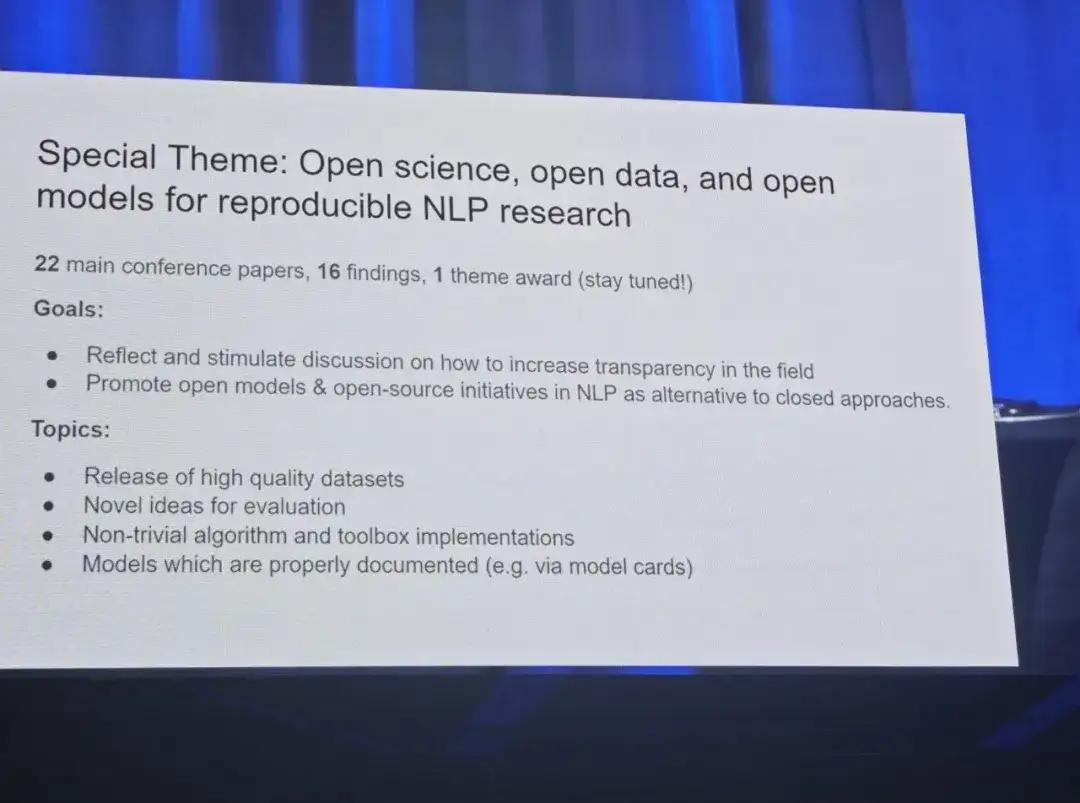 Le 14 août, une série de récompenses pour l'ACL 2024 a été annoncée. Ce sujet a reçu 22 articles principaux, et le lauréat du prix du sujet était « OLMo : Accélérer la science des modèles linguistiques ».
Adresse du document :https://arxiv.org/pdf/2402.00838
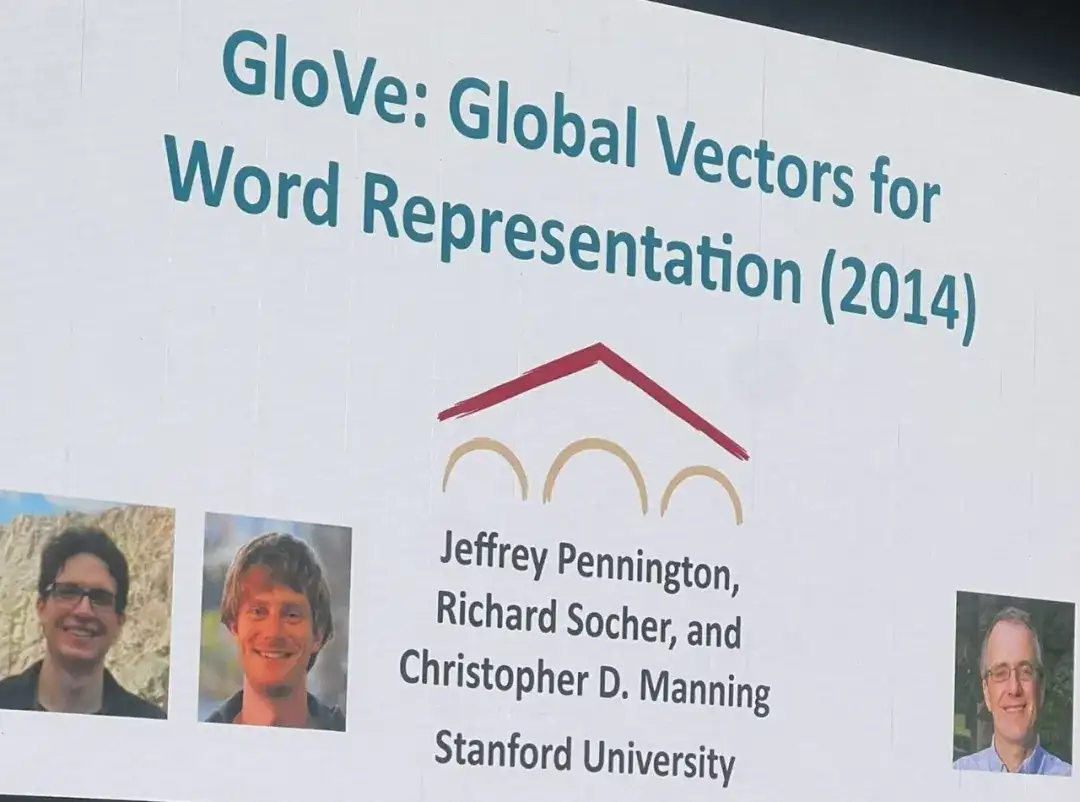
Adresse du document :https://aclanthology.org/D14-1162.pdf
Suivez le compte officiel et répondez « ACL 2024 » pour télécharger tous les articles gagnants.
Les 6 autres articles gagnants sont :
Estimation causale des profils de mémorisation
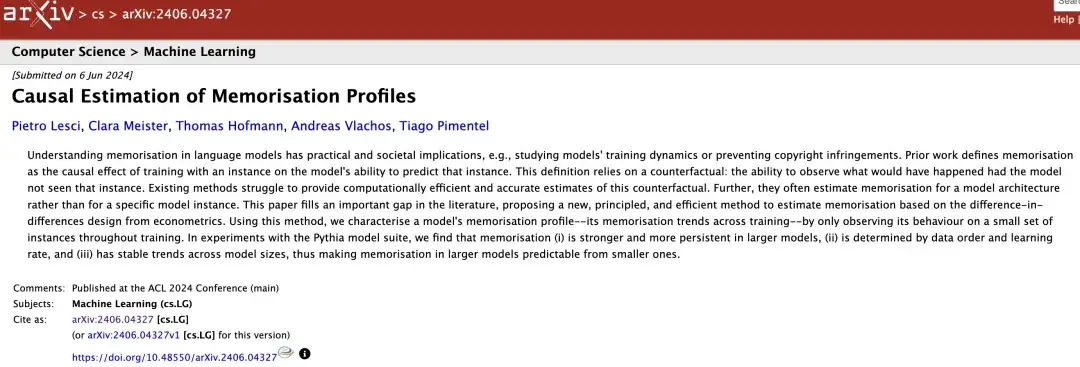 * Adresse du papier :https://arxiv.org/abs/2406.04327* Institutions de recherche : Université de Cambridge, ETH Zurich* Contenu de la recherche : Les chercheurs ont proposé une nouvelle méthode d'estimation de la mémoire, fondée sur des principes et efficace, qui n'a besoin d'observer qu'un petit nombre de comportements d'instance du modèle pendant tout le processus de formation pour caractériser les caractéristiques de mémoire du modèle, c'est-à-dire ses tendances de mémoire pendant le processus de formation.
Modèle Aya : un mode de langage multilingue en libre accès optimisé pour les instructions
 * Adresse du papier :
https://arxiv.org/abs/2402.07827
* Institutions de recherche : Cohere For AI, Brown University, Cohere, Cohere For AI Community, Massachusetts Institute of Technology, Carnegie Mellon University
* Contenu de la recherche : Les chercheurs ont présenté Aya, un modèle de langage génératif massivement multilingue qui suit des instructions dans 101 langues, triplant ainsi le nombre de langues couvertes. En outre, les chercheurs ont introduit une nouvelle suite d’évaluation complète qui étend la technologie d’évaluation multilingue à 99 langues.
Satisfaction du langage naturel : exploration de la distribution des problèmes et évaluation des modèles de langage basés sur des transformateurs
* Il n'existe pas encore de version pré-imprimée de l'article*
 * Adresse du papier :https://arxiv.org/abs/2406.05930* Institution de recherche : Université Carnegie Mellon, Université de Californie du Sud* Contenu de la recherche : Les chercheurs ont proposé une tâche de reconstruction historique semi-supervisée, dans laquelle le modèle est formé uniquement sur une petite quantité de données étiquetées et une grande quantité de données non étiquetées. Nous avons également développé une architecture neuronale de reconstruction de comparaison, DPDBiReconstructor, qui combine les connaissances de base des méthodes de comparaison des linguistes et est capable d'exploiter des ensembles non étiquetés de cognats, surpassant les solides lignes de base semi-supervisées sur de nouvelles tâches.
Mission : Modèles de langage impossibles
 * Adresse du papier :https://arxiv.org/abs/2401.06416* Institutions de recherche : Université de Stanford, Université de Californie, Université du Texas
* Contenu de la recherche : Les chercheurs ont synthétisé une série de langages complexes et inexistants et ont évalué la capacité du modèle GPT-2 à apprendre ces langages. Les résultats ont montré que GPT-2 avait des difficultés à apprendre des langues impossibles par rapport à l’apprentissage de l’anglais.
Pourquoi les fonctions sensibles sont-elles difficiles pour les transformateurs ?
 * Adresse du papier :
https://arxiv.org/abs/2402.09963
* Institution de recherche : Université de la Sarre, Allemagne
* Contenu de la recherche : Dans l'architecture Transformer, le paysage de perte est limité par la sensibilité à l'espace d'entrée. Grâce à des travaux théoriques et empiriques, cette théorie peut unifier un large éventail d’observations empiriques sur la capacité d’apprentissage et les préjugés des transformateurs.
Analyse approfondie des articles primés
Suivant,**HyperAI présentera quatre aspects : l’architecture du modèle, l’ensemble de données, les résultats de recherche et l’équipe.**Une interprétation approfondie de « Déchiffrer le langage Oracle Bone avec des modèles de diffusion » pour tout le monde.
Dans cette étude, l'équipe de recherche de Bai Xiang et Liu Yuliang de l'Université des sciences et technologies de Huazhong, en collaboration avec l'Université d'Adélaïde, l'Université normale d'Anyang et l'Université de technologie de Chine du Sud, a utilisé un modèle génératif basé sur l'image pour**Un modèle de diffusion conditionnelle Oracle Bone Script Decipher (OBSD) optimisé pour le déchiffrement de scripts Oracle Bone a été formé.**Le modèle utilise des catégories invisibles d'inscriptions sur os d'oracle comme entrée conditionnelle pour générer des images de caractères chinois modernes correspondantes, offrant une nouvelle approche de la tâche de reconnaissance de caractères anciens qui est difficile à résoudre dans le traitement du langage naturel.
Points saillants de la recherche :
* Fournir une nouvelle approche aux tâches de reconnaissance de textes anciens en utilisant la technologie de génération d'images
* OBSD utilise une technologie d'échantillonnage d'analyse locale pour améliorer la capacité du modèle à distinguer et à interpréter des modèles de caractères complexes
* Démontrer l'efficacité de l'OSBD dans le décodage grâce à des études d'ablation complètes et des tests de référence
Lien de téléchargement de l'ensemble de données utilisé dans cette étude :
* Ensemble de données d'évolution du script Oracle-Bone EVOBC :
* Ensemble de données de reconnaissance osseuse Oracle HUST-OBS :
Ensemble de données : Utilisation du plus grand référentiel d'Oracle, en utilisant la technologie OCR comme référence
Pour former et évaluer le modèle OSBD proposé,**Cette étude a sélectionné l’ensemble de données HUST-OBS et l’ensemble de données EVOBC.**Il s'agit de l'un des plus grands dépôts d'inscriptions sur os d'oracle, contenant 1 590 caractères différents représentés dans 71 698 images.
Considérant que le déchiffrement d’os d’oracle inconnus nécessite généralement une vérification professionnelle plus complète, cette étude n’a utilisé que les textes déchiffrés comme ensemble de test, simplifiant ainsi l’ensemble du processus d’évaluation. Plus important encore, l’étude a également spécifiquement exclu les catégories de caractères sélectionnées dans l’ensemble de test de l’ensemble d’entraînement pour garantir que le modèle était utilisé pour déchiffrer des caractères qui n’avaient jamais été traités. L'ensemble de données est divisé en ensembles d'entraînement et de test dans un rapport de 9:1, fournissant un cadre fiable pour l'évaluation.
De plus, bien que le modèle OSBD effectue un déchiffrement d'oracle du point de vue de la génération d'images, les mesures de génération d'images traditionnelles telles que SSIM ne conviennent pas à cette tâche. Par conséquent, cette étude a adopté la technologie OCR comme mesure plus objective pour déterminer les résultats de décryptage réussis. Plus précisément, les chercheurs ont personnalisé l'outil OBS-OCR en utilisant un classificateur simple avec un réseau dorsal ResNet-101, formé spécifiquement sur un grand ensemble de données contenant 88 899 catégories de caractères chinois modernes pour évaluer la sortie du modèle.
Les résultats montrent que **L'outil OCR personnalisé a atteint une précision de reconnaissance de 99,87%.**La fiabilité des résultats du déchiffrement a été prouvée. Dans le même temps, cette étude a également largement présenté l’outil OCR chinois open source PaddleOCR 1 pour une évaluation plus approfondie. Cette méthode OCR double offre une garantie solide quant à l’efficacité du modèle dans le déchiffrement des os d’oracle.
Reconstruire le modèle OBSD basé sur le modèle de diffusion conditionnelle
Cette étude représente l’ensemble d’entraînement comme S = {(si, ci) | si est une instance d'oracle, ci∈C}, c'est-à-dire faisant correspondre les instances d'oracle avec un ensemble de caractères chinois modernes dans une catégorie C connue et proposant de nouvelles formes de caractères lorsque les correspondances existantes sont manquantes. Pour y parvenir,Cette étude convertit l’image du caractère osseux d’oracle X en son équivalent chinois moderne basé sur le modèle de diffusion.
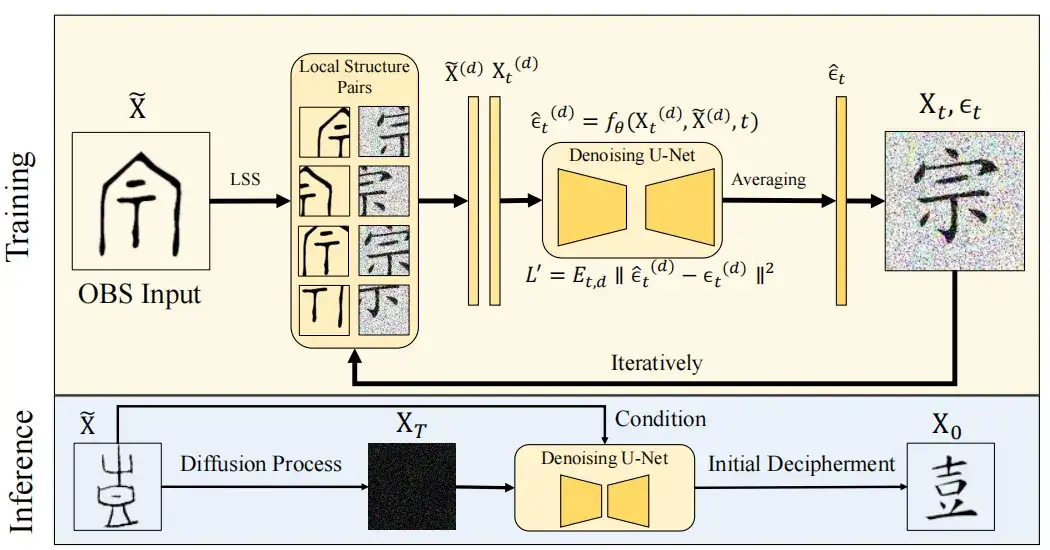
Comme le montre la figure ci-dessous, le modèle est divisé en deux étapes :
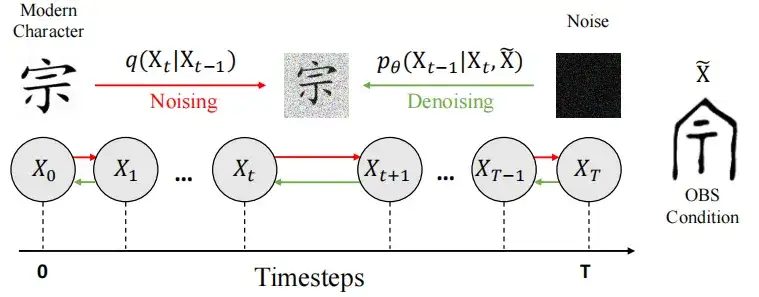
**Dans la phase de débruitage,**Les chercheurs ont utilisé l'architecture U-Net pour entraîner le modèle fθ à prédire le bruit e et à restaurer l'image, et ont utilisé et ∼ N(0, I) pour introduire du caractère aléatoire afin d'améliorer la diversité des résultats de génération du modèle. Le résultat final du décodage est l'image débruitée générée X0.
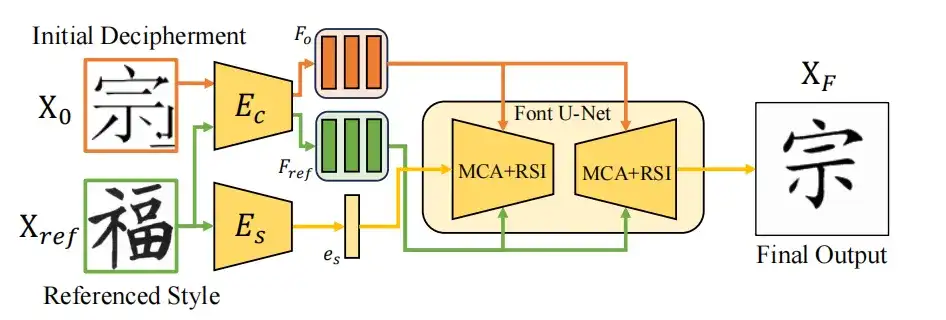
Sur cette base, le modèle OBSD intègre l'étape de déchiffrement initial et l'étape de raffinement à zéro coup pour améliorer la précision du déchiffrement, comme le montre la figure ci-dessous.
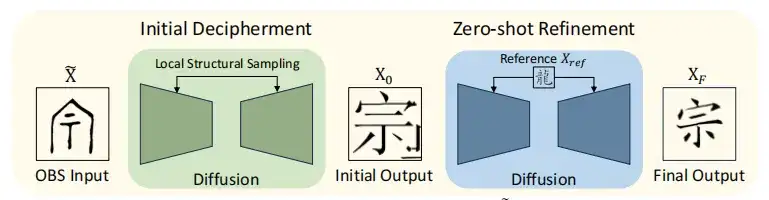
Présentation du concept LSS pour améliorer la capacité du modèle à connecter les caractères anciens aux caractères chinois modernes
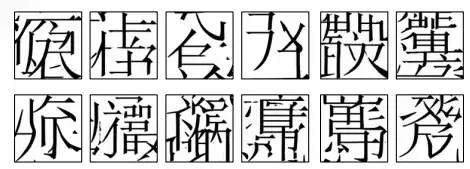
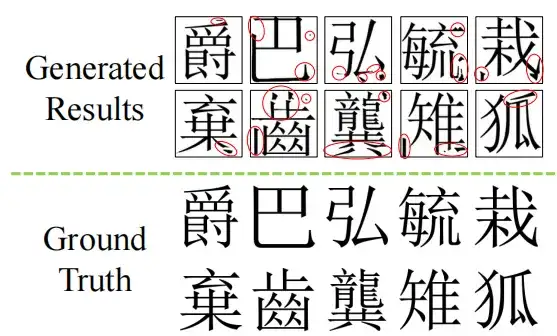
Cependant, dans les cas d'application réels, le modèle formé de cette manière ne peut pas générer avec précision les caractères chinois modernes correspondants, mais forme plutôt des absurdités basées sur un grand nombre de fragments aléatoires, comme le montre la figure ci-dessous.
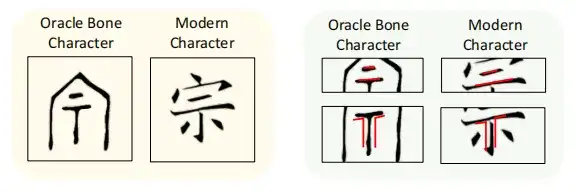
Afin de permettre au modèle de diffusion d'apprendre les caractéristiques de la structure locale, le module LSS utilise une méthode de fenêtre glissante pour diviser l'image cible du caractère chinois moderne X0∈RHxWx3 et l'image d'os d'oracle correspondante X∈RHxWx3 en D petits blocs de taille p×p, notés X(d) et Xt(D)∈Rp×p×3, D=1,2…D, p=64. Ici, Xt représente une image de texte moderne avec du bruit gaussien ϵt ajouté au pas de temps t.
Présentation de méthodes d'apprentissage sans intervention pour améliorer la capacité du modèle à comprendre la structure des personnages
Bien que certains progrès aient été réalisés dans la génération de caractères chinois modernes à l’aide d’un échantillonnage de structure locale, les efforts de déchiffrement initiaux rencontrent encore des obstacles évidents tels que la déformation structurelle et les artefacts.
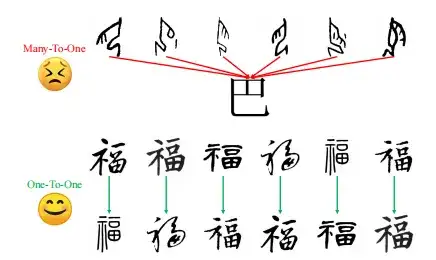
Comme le montre la figure ci-dessous, cette méthode d’apprentissage zéro coup est basée sur un cadre de transfert de style de police universel. Grâce à un système d'encodeur double, le style de l'image de police source X0 est adapté au style cible Xref tout en conservant l'intégrité du contenu. L'encodeur de style Es extrait la fonctionnalité de style es de Xref, tandis que l'encodeur de contenu Ec traite Xo et Xref pour obtenir la fonctionnalité de contenu multi-échelle Fo, qui est affinée par Font U-Net avec l'agrégation de contenu multi-échelle (MCA) et la structure de référence. Une fois la formation terminée, le module d'apprentissage zéro-shot peut être utilisé directement pour optimiser les résultats générés par le modèle de diffusion.
Évaluation des performances de l'OSBD : le taux de précision de la reconnaissance est le plus élevé selon plusieurs critères d'évaluation
Afin d’évaluer quantitativement les performances de l’OSBD, cette étude a utilisé deux critères d’évaluation différents : le décryptage à un seul tour et le décryptage à plusieurs tours. Comme il n’existe pas d’outils dédiés au déchiffrement des os d’oracle, cette étude adopte un cadre comparatif pour adapter les principales méthodes de traduction d’image à image à cette tâche.
Plus précisément, ces méthodes incluent des méthodes basées sur GAN telles que Pix2Pix, CycleGAN, DRIT++ et des modèles de diffusion tels que CDE, Palette et BBDM. Ce paramètre garantit que la méthode OBSD peut être évaluée dans le contexte d'une traduction d'images de pointe et garantit une cohérence équitable dans les conditions de formation et de test.
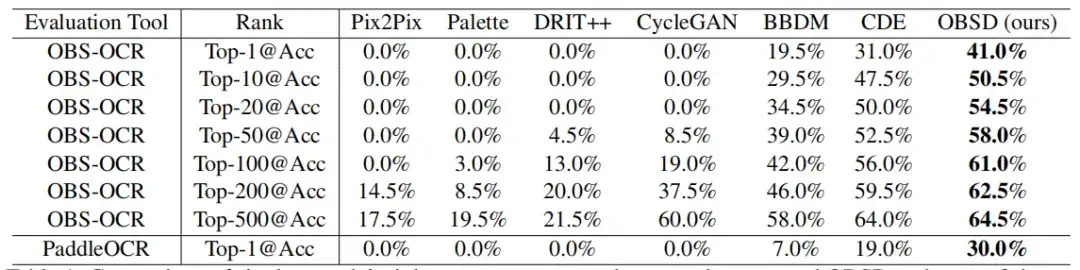
Au cours d'un seul cycle d'évaluation de décryptage,**L'OBSD présente des avantages significatifs par rapport aux méthodes de conversion d'image en image modifiées pour déchiffrer les os d'oracle.**Comme le montre la figure ci-dessous.
La précision maximale obtenue par OSBD via OBS-OCR et PaddleOCR est respectivement de 41,0% et 30,0%, ce qui est plus performant que les autres méthodes. À mesure que le classement augmente, la précision montre une nette tendance à l’amélioration. En dessous de la précision top-500, OSBD atteint une précision de reconnaissance OBS-OCR de 64,5%.
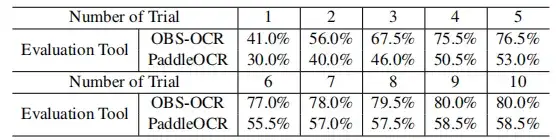
Au cours de plusieurs cycles d’évaluation de décryptage,**Le taux de réussite de l’OBS-OCR s’est progressivement amélioré au fil de plusieurs tentatives.**L'indicateur s'est continuellement amélioré, passant d'un taux de réussite de 41,0% à 80,0%, comme le montre la figure ci-dessous.
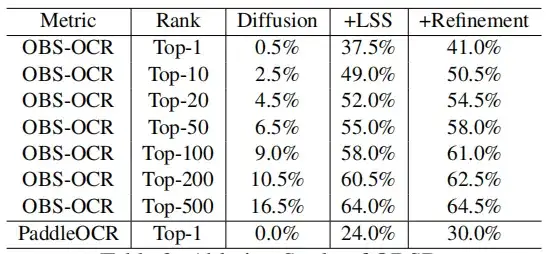
Pour examiner plus en détail l’impact de chaque composant, cette étude a également mené une étude d’ablation, en se concentrant sur le module LSS et l’apprentissage zéro coup. Les résultats montrent que le décodage des inscriptions sur os d'oracle en utilisant uniquement le modèle de diffusion conditionnelle de base présente des limites et une précision nettement inférieure. Plus précisément, l’entraînement d’un modèle de diffusion sans aucune augmentation produit des résultats qui sont essentiellement dénués de sens.
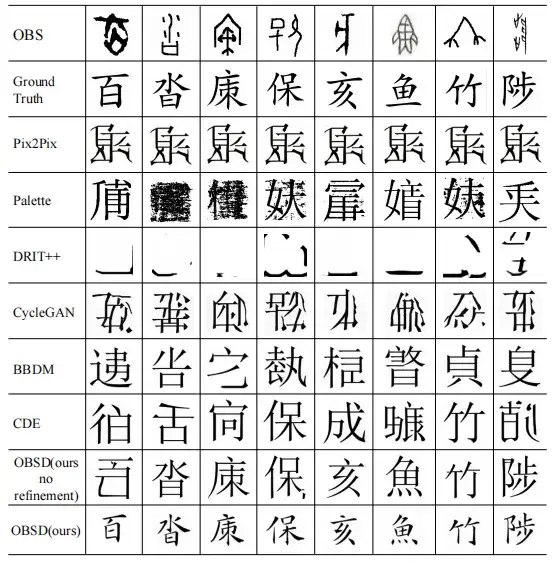
Enfin, cette étude mène également une étude qualitative sur différents modèles de traduction d’image en image.
L'équipe de recherche brille de mille feux, pionnière de l'IA + Oracle
Dans le domaine de la recherche sur les caractères chinois anciens, en particulier la recherche sur l'écriture osseuse oraculaire, l'Université des sciences et technologies de Huazhong a toujours été à l'avant-garde de son époque. C'est l'une des premières universités en Chine à avoir créé une base de données indépendante de scripts Oracle Bone. Avec le développement rapide de la technologie de l’intelligence artificielle, le traitement intelligent du texte et des images est devenu l’un des points chauds dans le domaine de la recherche en intelligence artificielle. L'Université des sciences et technologies de Huazhong, représentée par l'équipe de recherche de Bai Xiang et Liu Yuliang, est une fois de plus devenue le pionnier et le leader de l'intelligence du texte et de l'image.
Le professeur Bai Xiang est un jeune scientifique exceptionnel au niveau national et membre de l'IAPR. Il est actuellement doyen de l'École de logiciels de l'Université des sciences et technologies de Huazhong et directeur du Centre de recherche en ingénierie du Hubei pour la vision industrielle et les systèmes intelligents. Précédemment,**Le grand modèle multimodal Monkey développé sous la direction du professeur Bai Xiang a remporté la première place dans la version open source OpenCompass de la liste des grands modèles faisant autorité.**Les résultats ont été appliqués aux produits innovants des principales sociétés de logiciels de Wuhan.
En tant que membre principal de l'équipe de Bai Xiang, Liu Yuliang a été sélectionné pour le 9e projet de soutien aux jeunes talents de l'Association chinoise pour la science et la technologie. Il s'est concentré sur l'intelligence du texte et de l'image et a obtenu une série de résultats de travail dans l'analyse intelligente des documents, la vision et la compréhension du langage naturel et les grands modèles multimodaux.
À mesure que la technologie se développe et mûrit, afin de réaliser de plus grandes avancées dans la recherche sur les os d'oracle, Bai Xiang et le professeur Liu Yuliang ont résolument choisi de mener une coopération approfondie avec l'Université normale d'Anyang, l'une des principales institutions de recherche sur les os d'oracle en Chine. En 2018, la construction du laboratoire clé du ministère de l'Éducation pour le traitement de l'information Oracle à l'Université normale d'Anyang a été approuvée ; En 2019, le « Yinqiwenyuan », une plate-forme de big data Oracle Bone Script soigneusement construite par le laboratoire qui intègre la bibliothèque de documents Oracle Bone Script, la bibliothèque de catalogues et la bibliothèque de caractères, a été ouverte au monde.**Il s’agit de la plateforme de données Oracle la plus complète, la plus standardisée et la plus fiable au monde.**Son ouverture marque l’entrée de la recherche sur les os d’oracle dans l’ère intelligente.
Il convient de noter que Liu Yongge, l'un des auteurs correspondants de cet article, est le directeur du laboratoire clé de traitement de l'information Oracle du ministère de l'Éducation à l'Université normale d'Anyang.
Afin de mieux enregistrer et diffuser les recherches sur les os d'oracle, le laboratoire s'est concentré sur deux choses majeures en 2023 : d'une part, il a lancé conjointement le « Oracle Bone Global Digital Return Plan » avec Tencent SSV, la station de travail d'Anyang de l'Institut d'archéologie, l'Académie chinoise des sciences sociales et le Bureau municipal des reliques culturelles d'Anyang, en utilisant des caméras avec des centaines de millions de pixels pour réaliser une restauration et une protection haute fidélité des os d'oracle physiques dans l'espace numérique. D'autre part, le mini-programme « Amazing Oracle » lancé conjointement par le laboratoire et Tencent a rapproché Oracle du public.
Par coïncidence, afin de permettre aux chercheurs de trouver plus facilement des informations sur l'épissage des os d'oracle et de raccourcir le temps de collecte des données au début de la recherche,**Début 2023, Yang Yi, Huang Bo et Cheng Minghui, doctorants du Centre de recherche sur les documents excavés et les caractères anciens de l'Université Fudan, ont créé conjointement la base de données d'informations sur l'épissage des os d'oracle « Jade et Perle ».**Il rassemble plus de 6 700 ensembles de résultats d'épissage d'os oracle provenant de nombreux chercheurs depuis la publication de la « Oracle Bone Collection ». Il est non seulement devenu un outil en ligne pour la communauté universitaire pour rechercher les principaux résultats d'épissage d'os d'oracle, mais permet également à de nombreux passionnés d'os d'oracle en dehors de la « tour d'ivoire » d'avoir la possibilité de participer au travail de résolution des fragments d'os d'oracle et de fournir des corrections et de nouvelles informations sur l'épissage d'os d'oracle.
On peut constater qu’avec l’aide des technologies numériques telles que le big data, le cloud computing et l’intelligence artificielle, la recherche sur les os d’oracle est entrée dans une nouvelle ère. Alors que la recherche continue de s'approfondir, je pense que cette « compétence secrète impopulaire » finira par révéler davantage de codes dans un avenir proche et servira de référence très importante pour déchiffrer d'autres caractères anciens.