Command Palette
Search for a command to run...
超大規模病理画像解析に!華中科技大学がシェーグレン症候群の診断精度を向上させる医療画像セグメンテーションモデルを提案
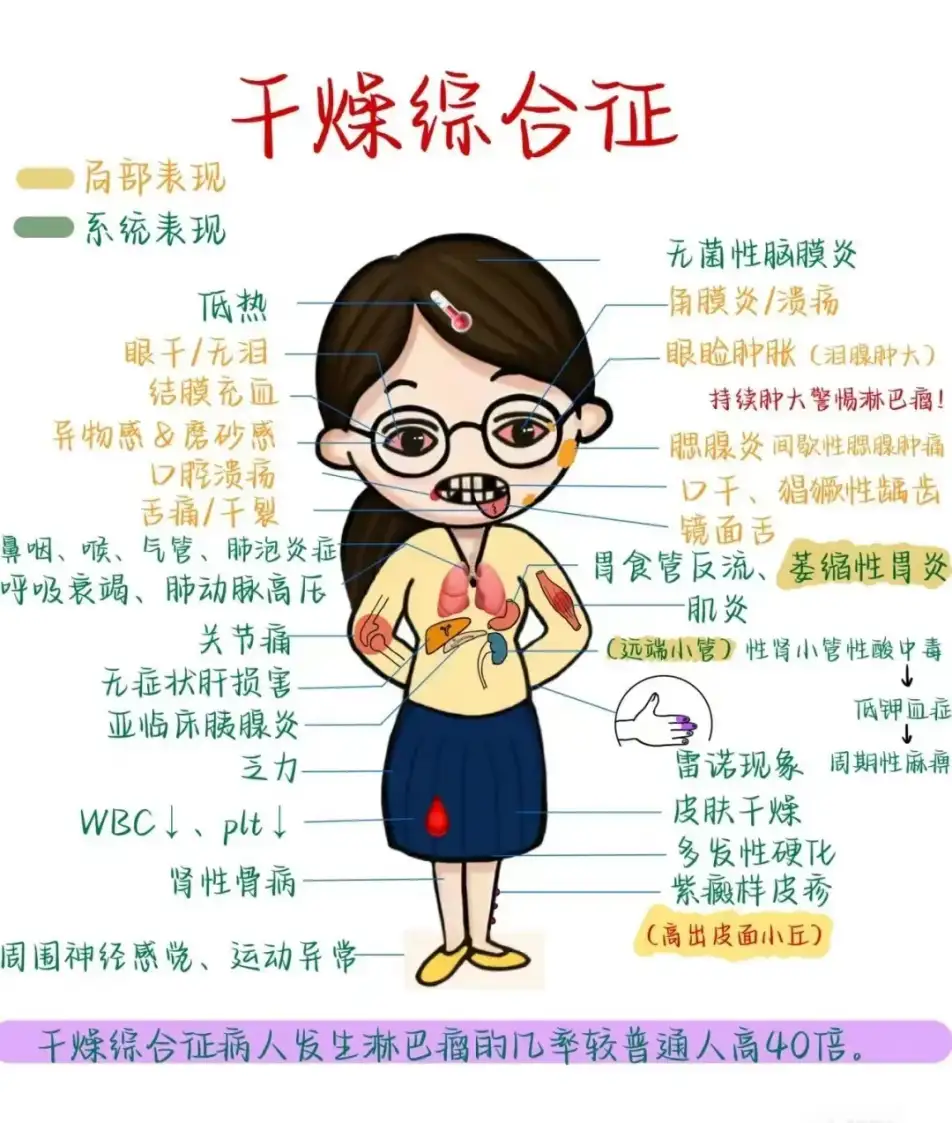
口渇、目の乾き、皮膚の乾燥、原因不明の筋肉痛や全身倦怠感を毎日伴う上記の症状に「悩まされている」場合は、冬の乾燥に加えて、一般的な症状にも注意する必要があります。私たちから常に無視される病気 - シェーグレン症候群 (SS)。
シェーグレン症候群は、外分泌腺へのリンパ球浸潤の増加を特徴とする自己免疫疾患です。わが国では約500万人がこの病気に苦しんでいます。病気の初期段階では、外分泌腺(唾液腺、涙腺など)が高度に浸潤したリンパ球によって破壊され、その結果、患者はしばしば口や目の乾燥を感じ、痛みなどの症状を伴うこともあります。肩関節の中。同時に、この病気は肺、肝臓、腎臓などの他の重要な臓器にも影響を及ぼし、生殖能力にも影響を与える可能性があります。
ただし、完全な病理学的スキャン画像は 100,000*100,000 ピクセル、つまり約 10 億ピクセルに達する場合があり、医師は画像全体を注意深く検査してリンパ球凝集巣の数を判断する必要があり、これには時間がかかるだけでなく、多くの場合、専門の医師の経験と主観的な判断により、誤診や診断漏れのリスクが高まります。
上記の課題に対処するために、華中科技大学のTu Wei教授とLu Feng教授は、自動運転や顔認識などの分野でおなじみのコンピュータビジョン技術を利用した医用画像セグメンテーションモデルM2CF-Netを提案した。マルチ解像度およびマルチスケールの画像認識テクノロジーを統合することにより、M2CF-Net モデルは、病理学的画像の微妙な違いを「見る」だけでなく、主要なバイオマーカーであるリンパ球凝集巣を正確に特定して計数することができるため、医師がより迅速に、より多くの画像を作成するのに役立ちます。正確な診断。
「M2CF-Net: 局所リンパ球性唾液腺炎の病理病変をセグメント化するためのマルチ解像度およびマルチスケールのクロスフュージョンネットワーク」と題された研究結果は、2023 IEEE International Conference on Medical Artificial Intelligence (MedAI) で発表されました。
研究のハイライト:
* 超大規模組織病理画像における微小なリンパ球凝集巣の特定が困難であるという問題を解決
* マルチ解像度とマルチスケールを統合した M2CF-Net のパフォーマンスは、他の 3 つの主流の医療画像セマンティック セグメンテーション モデルよりも優れています
* M2CF-Net は、ぼやけた境界、小さなターゲット、複雑なテクスチャを持つ画像の処理に優れた性能を発揮します。そのセグメント化された画像はより複雑な形状を持ち、人間による現実の注釈と非常に一致します。
 用紙のアドレス:
https://doi.ieeecomputersociety.org/10.1109/MedAI59581.2023.00063
オープンソース プロジェクト「awesome-ai4s」は、100 を超える AI4S 論文の解釈をまとめ、大規模なデータ セットとツールを提供します。
https://github.com/hyperai/awesome-ai4s
データセット: 同済病院の臨床データ
この研究では、同済病院からの小唾液腺の病理学的スライド データ セットを使用します。このうち、小唾液腺は原発性シェーグレン症候群の患者から切除されました。
*小唾液腺は、人間の口腔および咽頭の粘膜下に分布しており、唾液を分泌し、口腔の水分を維持し、消化を助け、口腔組織を感染から保護することです。
小唾液腺の病理学的切片を染色することで、医師は顕微鏡を使用して細胞の明確な構造を観察できます。具体的には、研究者らはすべてのスライドを再検査して品質を確保し、腺周囲の4平方ミリメートルあたり50個を超えるリンパ球の蓄積を特徴とする限局性リンパ球性咽頭炎の存在を確認した。病変がある場合はラベルを付けます。
最終的なデータセットには、171 個の陽性サンプル (病変の特徴と一致) と 32 の陰性サンプル (病変の特徴と一致しない) を含む 203 個のサンプルがあります。研究者らは、これらのサンプルを特定の割合に従ってトレーニング セット、検証セット、テスト セットに分割し、それぞれモデルのトレーニング、調整、パフォーマンス評価に使用しました。実際のプロセスでは、研究者がデータを前処理することで、計算量が削減されただけでなく、モデルの汎化能力も向上しました。
非常に大規模な画像処理パイプラインを設計し、モデル トレーニングの最初のステップを最適化します。
この研究の目標は、小唾液腺組織切片から限局性リンパ球性唾液腺炎 (FLS) の病変領域を 100,000 * 100,000 の解像度で抽出することでした。ただし、ギガピクセル画像をニューラル ネットワークに直接入力してトレーニングすることは不可能です。その主な理由は、そのような画像が大きすぎて、コンピューティング リソース、トレーニング時間、既存のフレームワークなどではサポートできないためです。
そこで研究者らは、超大規模な病理画像処理のためのパイプラインを設計した。パイプラインには主に、関心領域 (ROI) 抽出、染色正規化 (Stain Normalization)、および画像パッチング (WSl Patching) の 3 つのステップが含まれています。以下に示すように:
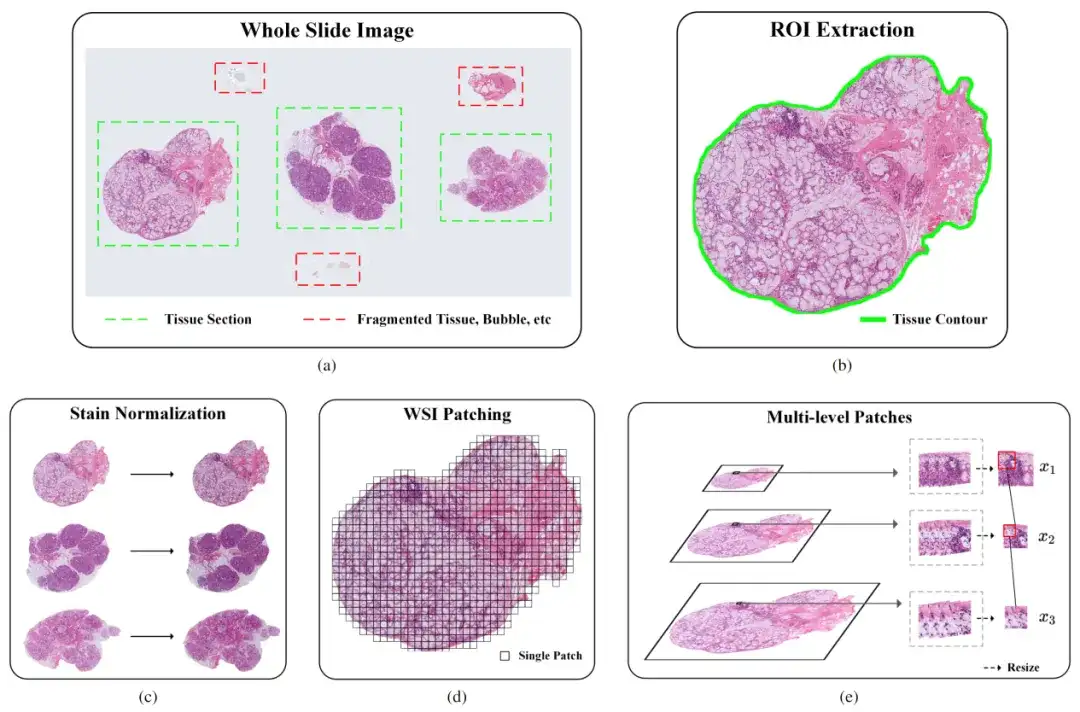
* 手動アノテーション: サンプルの一部には慎重にアノテーションが付けられ、データセットを強化した後に分類モデルが再トレーニングされました。
* データの強化: 回転、スケーリング、変換などの手法を使用してトレーニング データの多様性を高め、それによって分類器の精度を向上させます。
パート 2、染色の標準化 病理学的画像染色の標準化の主な目的は、さまざまなソースからの画像の視覚的な色とコントラストが一貫していることを保証することです。具体的には、実際の染色プロセスでは、染料の濃度、pH値、温度、時間などの要因の影響により、染色ムラや強度の不均一が発生し、同じ種類の組織であっても異なる視覚効果を示すことがよくあります。この違いは、コンピューター ビジョン モデルの精度に影響します。
この問題を解決するために、研究者たちは Vahadane アルゴリズムを採用しました。このアルゴリズムは、ソース画像の発色特性を調整してターゲット画像に似せることで、色の標準化の効果を実現します。具体的には、ソース画像とターゲット画像の間のカラー マトリックス変換を計算して、ソース画像の色変換を実現します。
パート 3、画像のブロック ROIの抽出と染色の標準化後も画像サイズが大きすぎるため、サンプルをトレーニング用の深層学習モデルに入力できないという問題に対処するため。研究者らはパッチベースのトレーニング方法を採用し、重複領域を持つ小さなブロックに画像を分割しました。これにより、モデルのトレーニングの効率が向上しただけでなく、元の情報も保持されました。
大きな管の近くにある小さなリンパ球の詳細な特徴を分析するには、より広い視野にわたって組織レベルの特徴を捕捉する必要があります。ただし、セグメンテーション結果の精度を確保するには、より狭い視野で細胞レベルの特徴をキャプチャする必要があります。両者の関係をどのように天秤にかけるかが特に重要です。
この目的を達成するために、研究者らは、主に元の画像を数回ダウンサンプリングし、これらのダウンサンプリングされた画像上で同じサイズの画像ブロックを抽出する、多重解像度での画像ブロック化方法を検討しました。異なるサンプリング倍率で画像からセグメント化されたこれらのパッチは、異なるサイズの視野を持ち、組織レベルの特徴と細胞レベルの特徴の両方を捉えることができます。
マルチ解像度とマルチスケールの融合モデル、効率的なパフォーマンス向上
研究者が選択したモデル M2CF-Net には、マルチブランチ エンコーダと Fusion ベースのカスケード デコーダが含まれています。エンコーダーは、異なる解像度、異なるスケールでパッチの特徴をダウンサンプリングします。一方、デコーダーは、カスケード フュージョン ブロックを使用して、マルチブランチ エンコーダーによって生成された特徴マップを融合します。
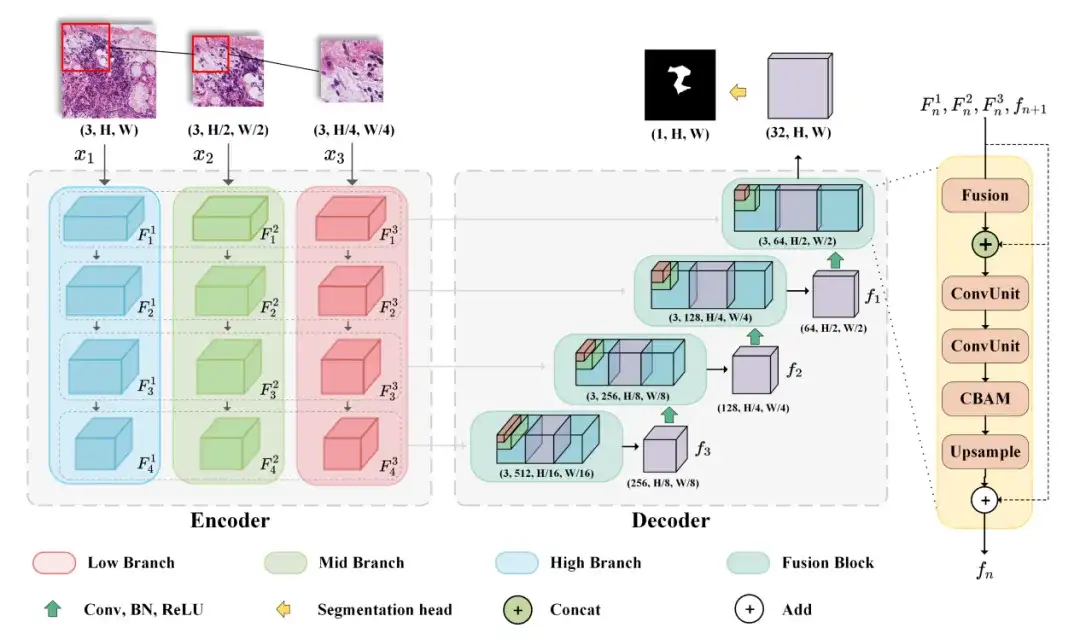
このプロセスでは、研究者らは空間アテンションとチャネル アテンションのメカニズムも使用して、入力特徴の表現能力を強化しました。最後に、BCEDice 損失がモデルの損失関数として使用され、この損失関数はバイナリ クロスエントロピー損失と Dice 損失を重み付けし、モデルの最適化の方向を効果的に導くことができます。
実験の結論: M2CF-Net は、他の 3 つの主流の医療画像セマンティック セグメンテーション モデルよりも優れたパフォーマンスを発揮します。
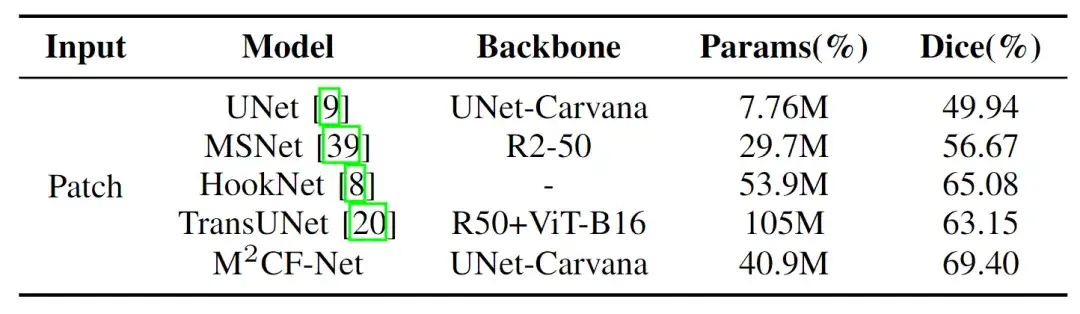
研究者らは、提案したモデル (M2CF-Net) を他の 4 つの一般的な医療画像セマンティック セグメンテーション モデル (UNet、MSNet、HookNet、および TransUNet) と比較した結果、M2CF-Net モデルがマルチ解像度およびマルチスケール機能の利用に優れていることがわかりました。 . さらなる利点。
* UNet: エンコーダー/デコーダー構造を採用してマルチスケールの特徴をキャプチャし、正確なセグメンテーションを実現します。
* MSNet: マルチスケール サブトラクション ネットワークを導入して特徴抽出を強化し、セグメンテーションの精度を向上させます。
* HookNet: 多重解像度機能をキャプチャして利用し、U-Net 構造を強化し、医療画像内のさまざまなサイズの画像のセグメンテーションを効果的に処理するためのフックを追加します。
* TransUNet: Transformer をベースに、セルフアテンション機構を導入することでセグメンテーションの精度を向上させます。
下図に示すように、M2CF-Net の Dice は 69.40% で最高であり、パラメータ数は UNet および MSNet と比較して 3 番目に高い TransUNet の半分しかないことがわかりました。パラメータの数が少ない場合、パフォーマンスはそれぞれ 38.9% と 22.5% 向上します。画像内のさまざまなスケールの特徴を効果的にキャプチャして融合できます。
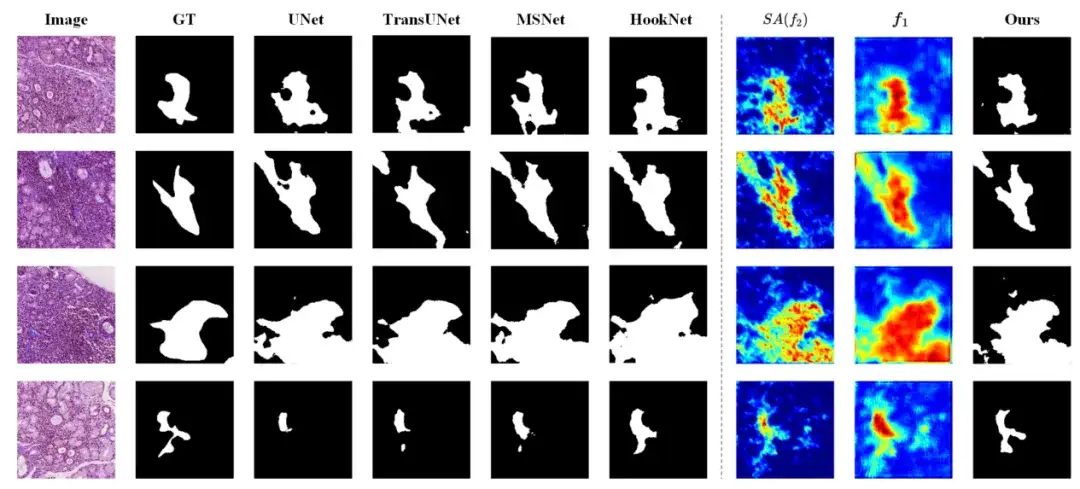
さらに、綿密な分析を行った結果、この研究では、M2CF-Net が境界がぼやけている画像、小さなターゲット、複雑なテクスチャを含む画像の処理で優れたパフォーマンスを発揮することがわかりました。以下の図に示すように、M2CF-Net のセグメンテーション結果はより複雑な形状をしており、人間が注釈を付けたグラウンド トゥルースとよく一致しています。
コンピュータービジョンテクノロジーが医療画像のセグメンテーションに革命をもたらす
医療画像解析は病気の診断に不可欠であり、コンピューター技術により医療画像を正確に分割し、患部、臓器、感染部位を効果的に特定できるため、診断効率が向上します。近年、ディープラーニングなどの先端技術の進歩により、医療画像のセグメンテーション技術は手作業から自動処理へと急速に移行しており、専門的に訓練されたAIシステムは医療従事者にとって欠かせない補助ツールとなっています。
華中科技大学同済医科大学付属同済病院リウマチ・免疫科副院長のトゥ・ウェイ教授、リウマチ性疾患および免疫疾患の診断と治療に 20 年以上の経験があり、シェーグレン症候群の診断にも豊富な経験があります。この記事の研究において、Tu Wei教授はシェーグレン症候群の病理学的診断プロセスを深く分析し、混同されやすい重要なポイントを指摘し、実際の症例を通じてさまざまな状況での診断結果を実証しました。シェーグレン症候群の病理診断法を習得した上で、Lu Feng 教授のチームは、診断上の課題に対処するためにコンピューター ビジョンで画像セグメンテーション テクノロジを使用することを提案しました。両者は高度な AI テクノロジーを使用して、シェーグレン症候群の診断に新たな道を切り開きました。
トゥ・ウェイ教授の個人ホームページ:
https://www.tjh.com.cn/MedicalService/outpatient_doctor.html?codenum=101110
Lu Feng 教授の個人ホームページ: http://faculty.hust.edu.cn/lufeng2/zh_CN/index.htm
上記の研究者以外にも、医療画像と AI の交差点に関する最先端の研究に熱心に取り組んでいる科学者が数多くいます。
たとえば、MIT コンピューター サイエンスおよび人工知能研究所 (MIT CSAIL) チームは、マサチューセッツ総合病院およびハーバード大学医学部の研究者と協力して、生物医学画像セグメンテーションの汎用モデルであるインタラクティブな ScribblePrompt を提案しました。このニューラル ネットワーク ベースのセグメンテーション ツールは、アノテーターが落書き、クリック、境界ボックスなどのさまざまなアノテーション方法を使用して柔軟な生物医学画像セグメンテーション タスクを実行できるようサポートするだけでなく、トレーニングされていないラベルや画像タイプでも適切に実行します。
より高度な技術が開発され、臨床現場に適用されるにつれて、腫瘍学や神経学などの複数の医療分野が恩恵を受け、医療画像分析の分野は明るい発展の見通しをもたらすと考えられています。