HyperAI
Command Palette
Search for a command to run...
Papers
Articles de recherche en IA de pointe mis à jour quotidiennement pour vous aider à suivre les dernières tendances en IA
articles
Tuna-2 : Les embeddings de pixels surpassent les encodeurs visuels pour la compréhension et la génération multimodales
Sécurité Vision-Language-Action : Menaces, Défis, Évaluations et Mécanismes
ReVSI : Rétablir l’évaluation de l’intelligence spatiale visuelle pour une évaluation précise du raisonnement 3D des VLM
De la compétence au talent : organiser des agents hétérogènes comme une entreprise dans le monde réel
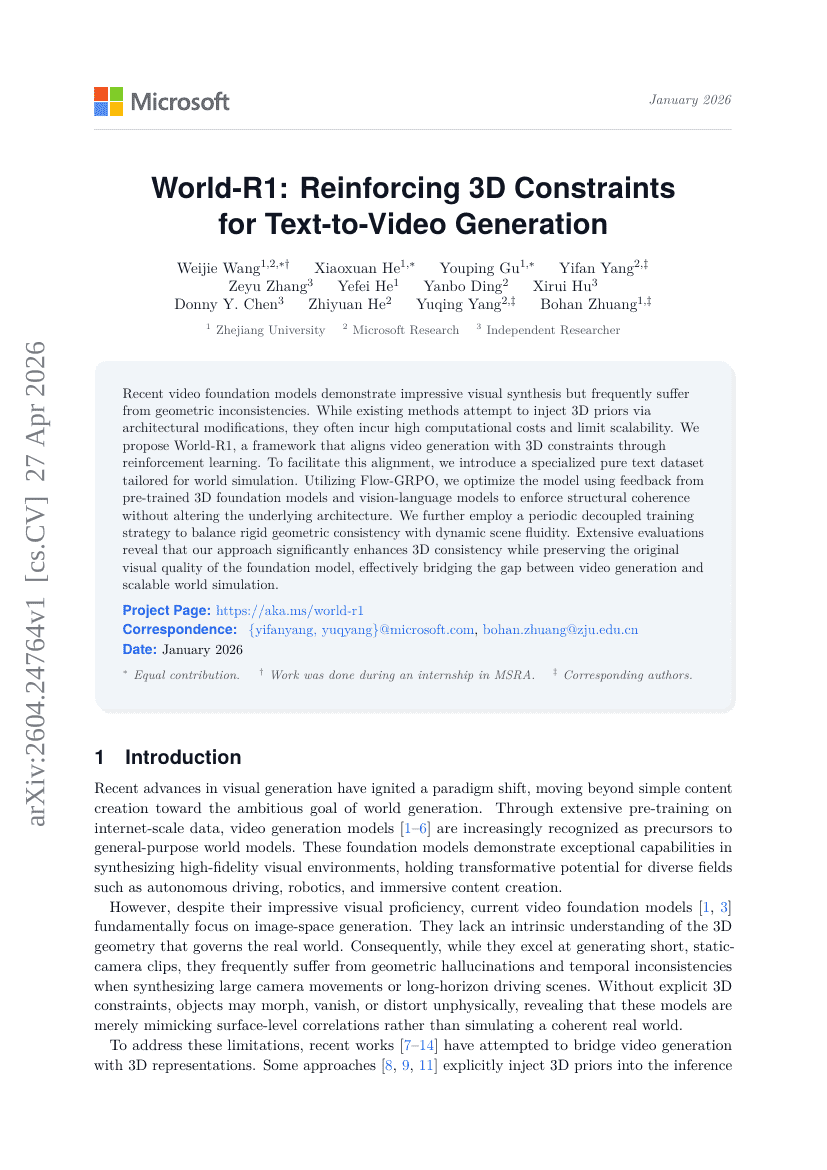
World-R1 : Renforcement des contraintes 3D pour la génération de vidéos à partir de texte
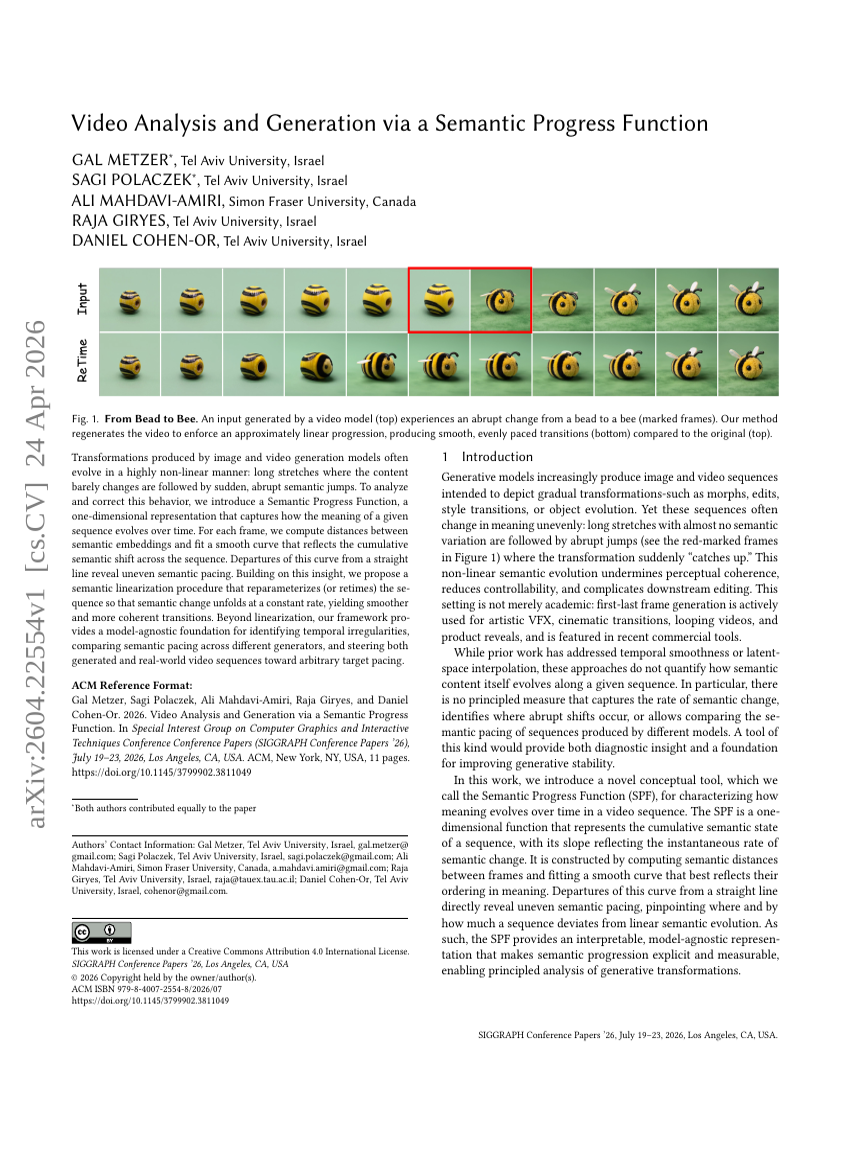
Analyse et génération de vidéos via une fonction de progression sémantique
SmartPhotoCrafter : Raisonnement, génération et optimisation unifiés pour l'édition automatique d'images photographiques
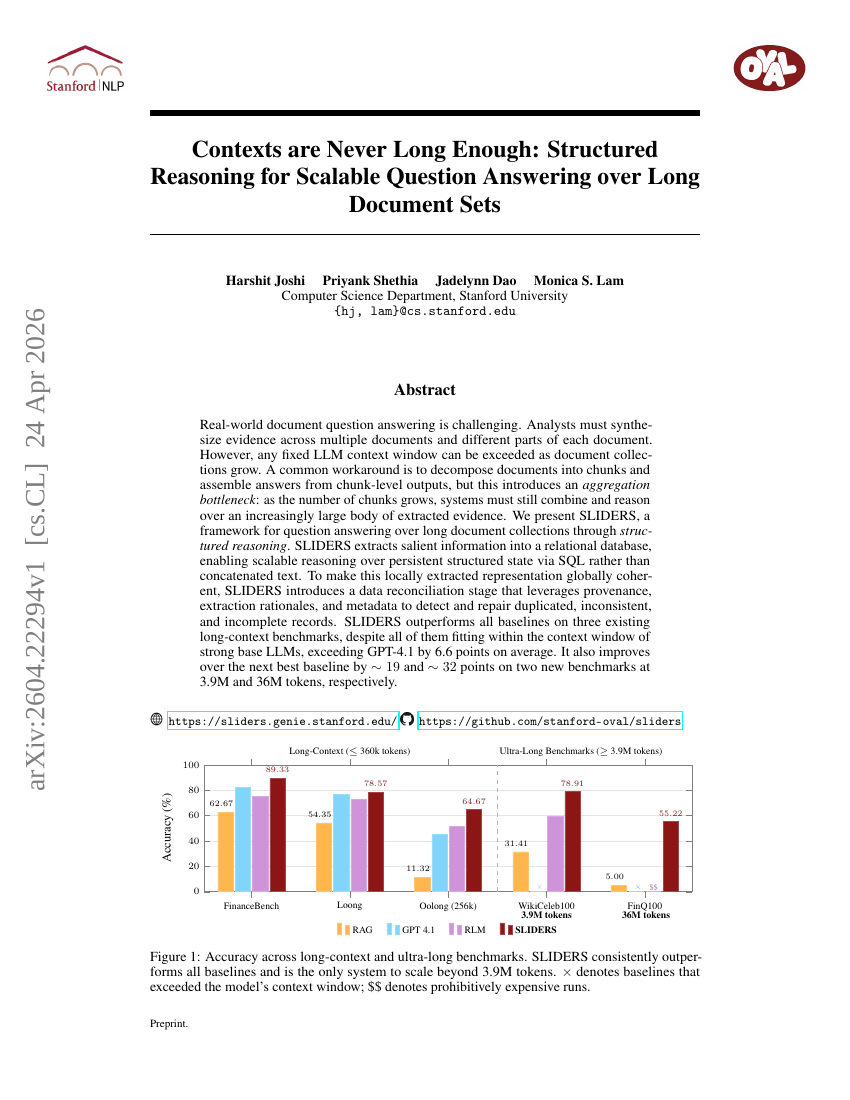
Les contextes ne sont jamais assez longs : un raisonnement structuré pour une question-réponse scalable sur des ensembles de documents longs
AgentSearchBench : un benchmark pour la recherche par AI agent en milieu réel
FlowAnchor : Stabilisation du signal d'édition pour une édition vidéo sans inversion
La sécurité des LLM de l'intérieur : détection de contenus préjudiciables via les représentations internes
DiffNR : Optimisation de la représentation neuronale assistée par diffusion pour la reconstruction tomographique 3D à vues éparses
Modélisation du monde agentic : fondements, capacités, lois et au-delà
DiLoCo découplé pour un pré-entraînement distribué résilient
EVENT TENSOR : UNE ABSTRACTION UNIFIÉE POUR LA COMPILATION DE MÉGAKERNELS DYNAMIQUES
Percevoir le rapide et le lent : apprendre le flux temporel dans les vidéos
Co-Évolution de la décision des LLM et des skill bank agents pour les tâches à long horizon
StyleID : un jeu de données et une métrique sensibles à la perception pour la reconnaissance de l'identité faciale indépendante du style
UniT : Vers un langage physique unifié pour l'apprentissage de policy de l'humain vers l'humanoïde et la modélisation du monde
WorldMark : une suite de référence unifiée pour les modèles de monde vidéo interactifs
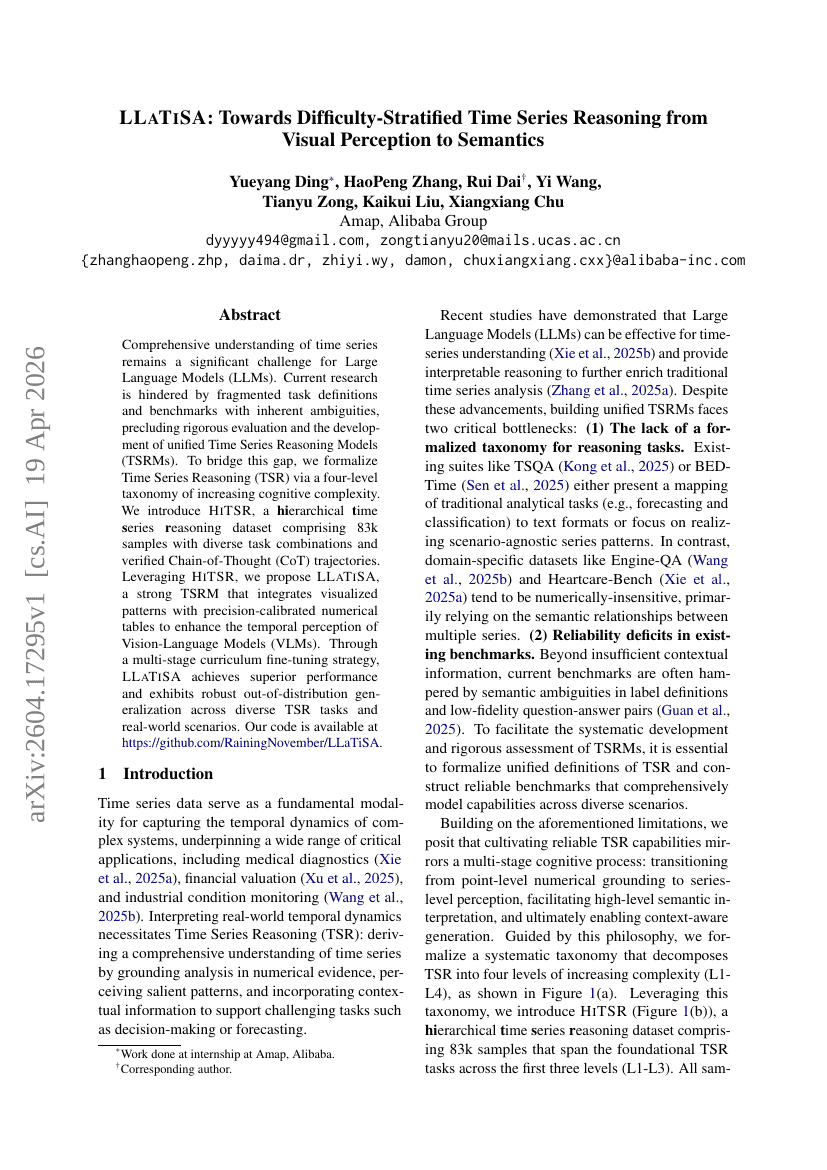
LLaTiSA : Vers un raisonnement sur séries temporelles stratifié par difficulté, de la perception visuelle à la sémantique
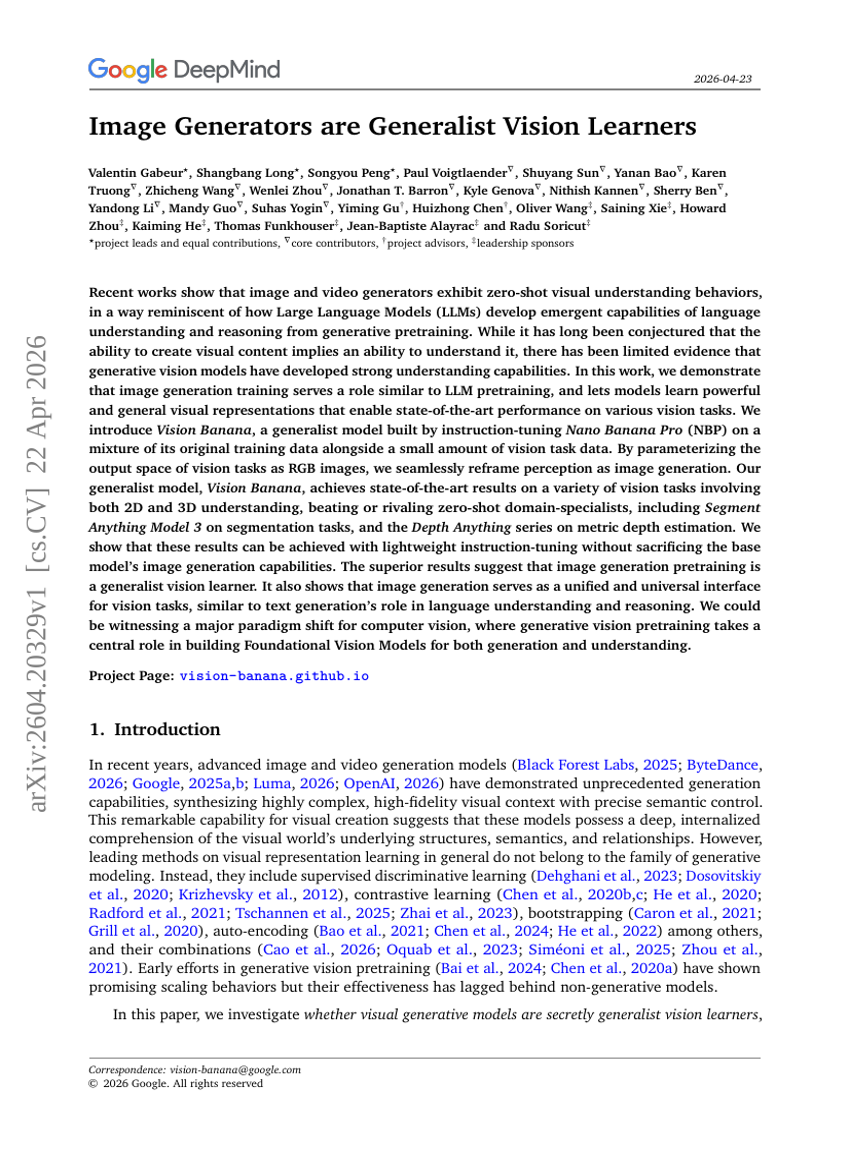
Les générateurs d'images sont des apprenants de vision généralistes
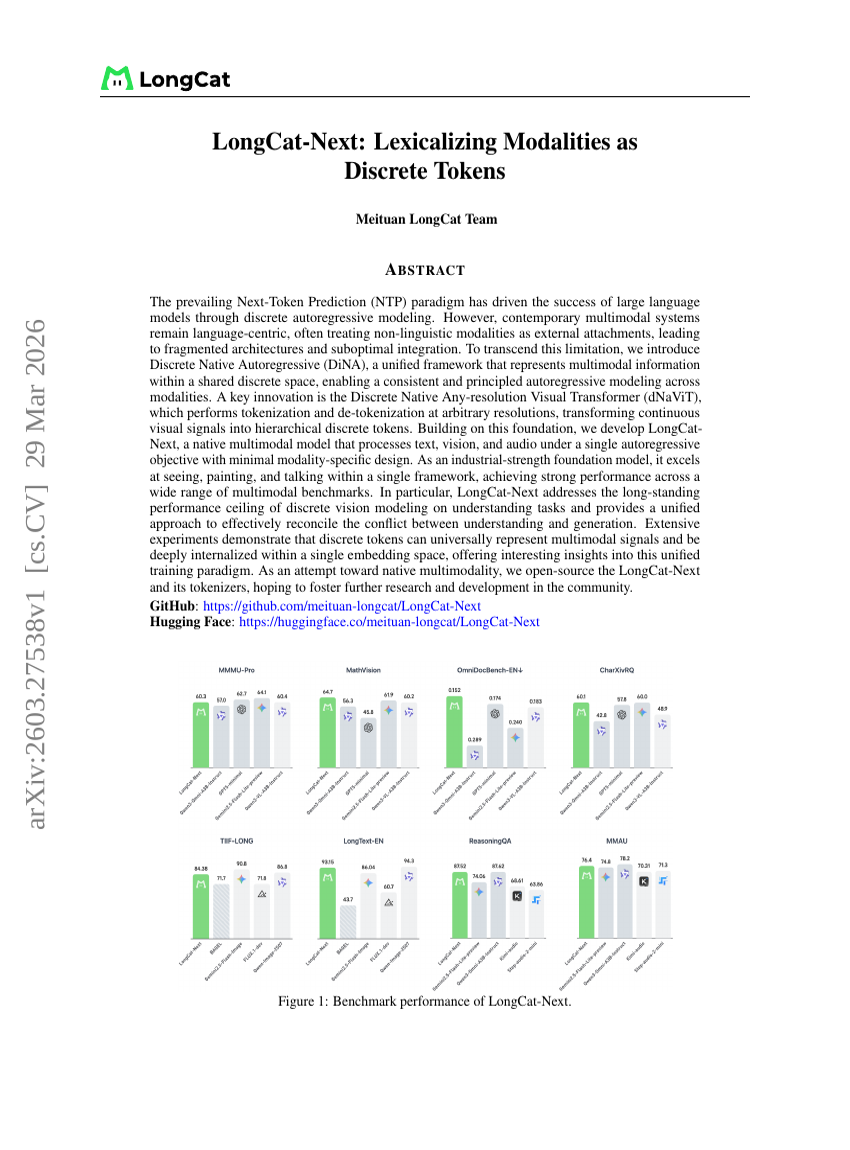
LongCat-Next : Lexicalisation des modalités sous forme de tokens discrets
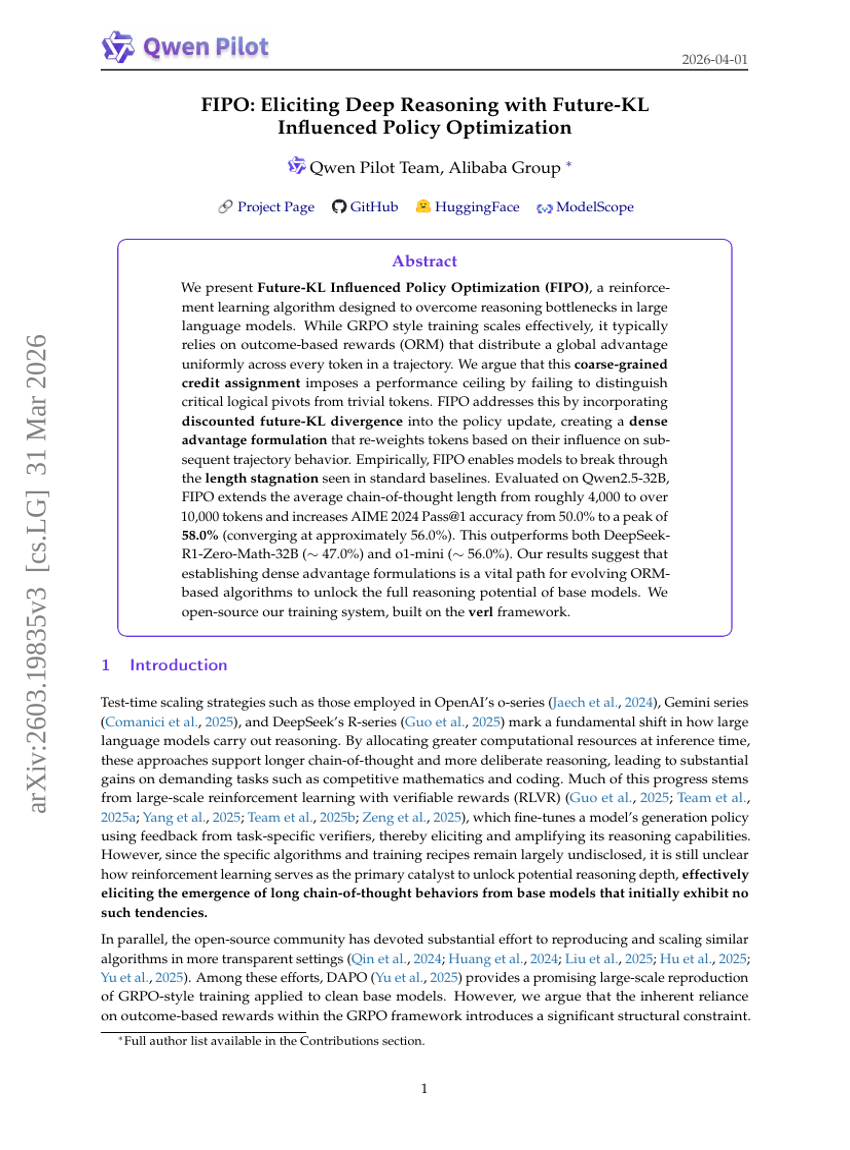
FIPO : Éliciter un raisonnement profond via une optimisation de politique influencée par le Future-KL
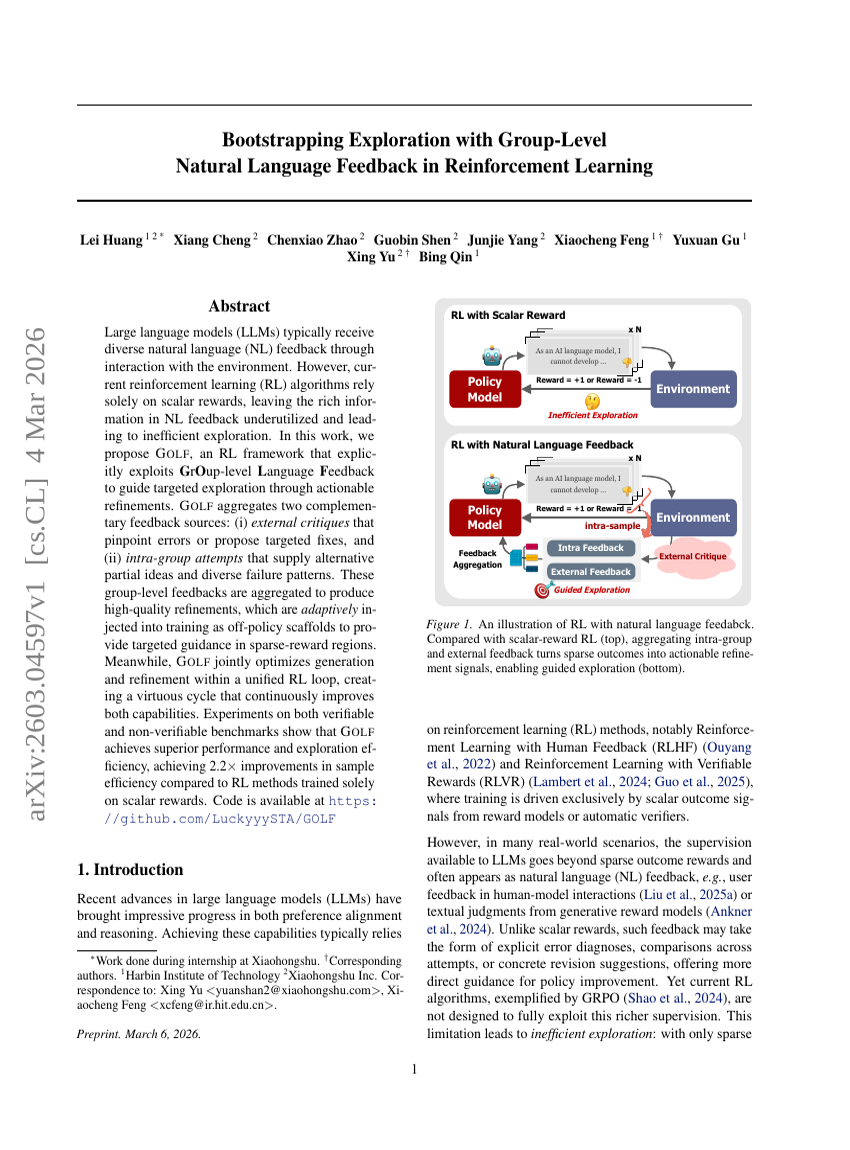
Exploration par bootstrapping avec feedback de langage naturel au niveau du groupe dans l'apprentissage par renforcement
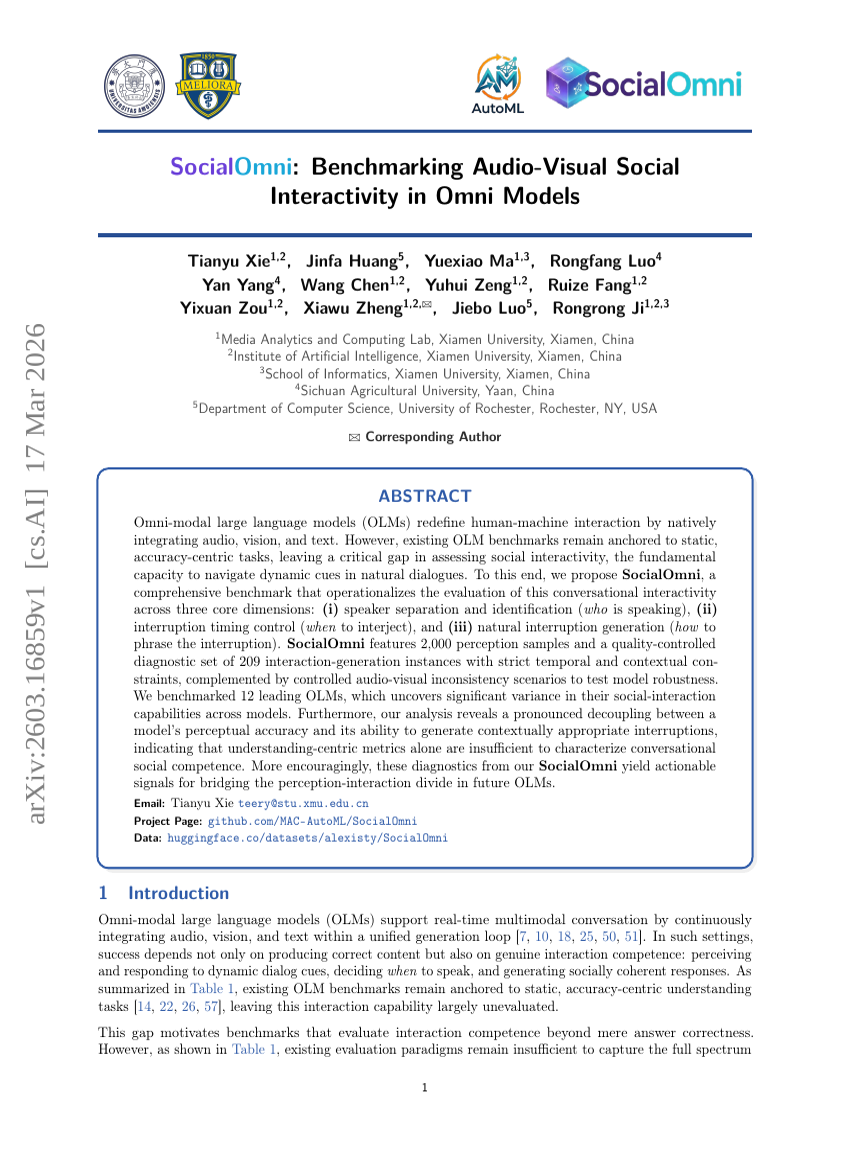
SocialOmni : Évaluation de l'interactivité sociale audio-visuelle dans les modèles Omni
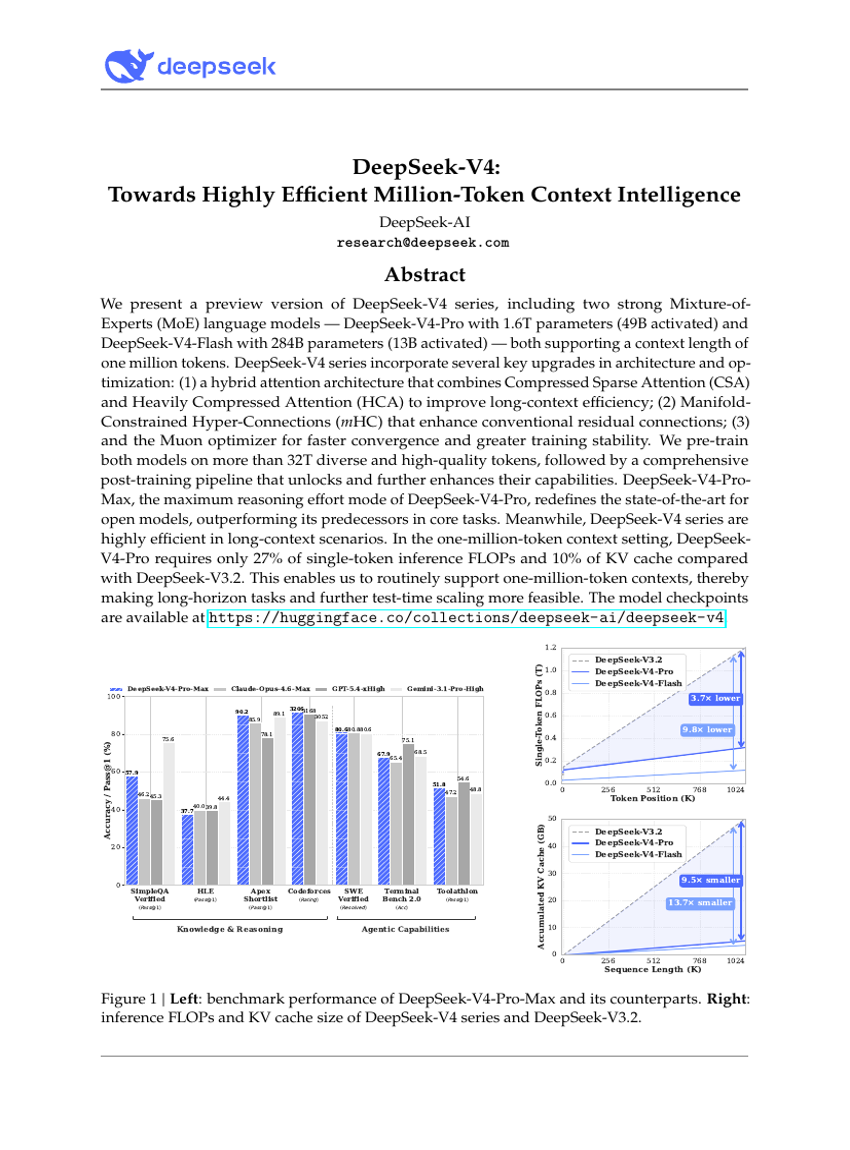
DeepSeek-V4 : Vers une intelligence contextuelle hautement efficace à un million de tokens
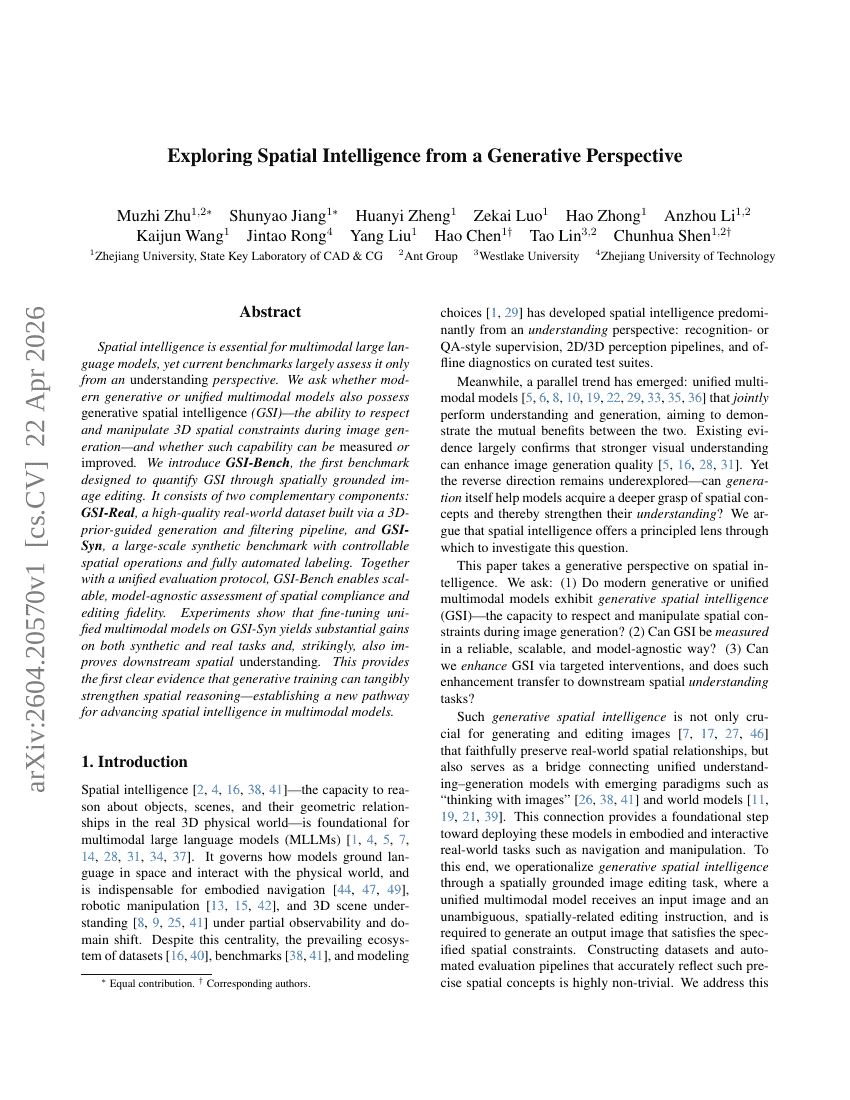
Exploration de l'intelligence spatiale d'un point de vue génératif
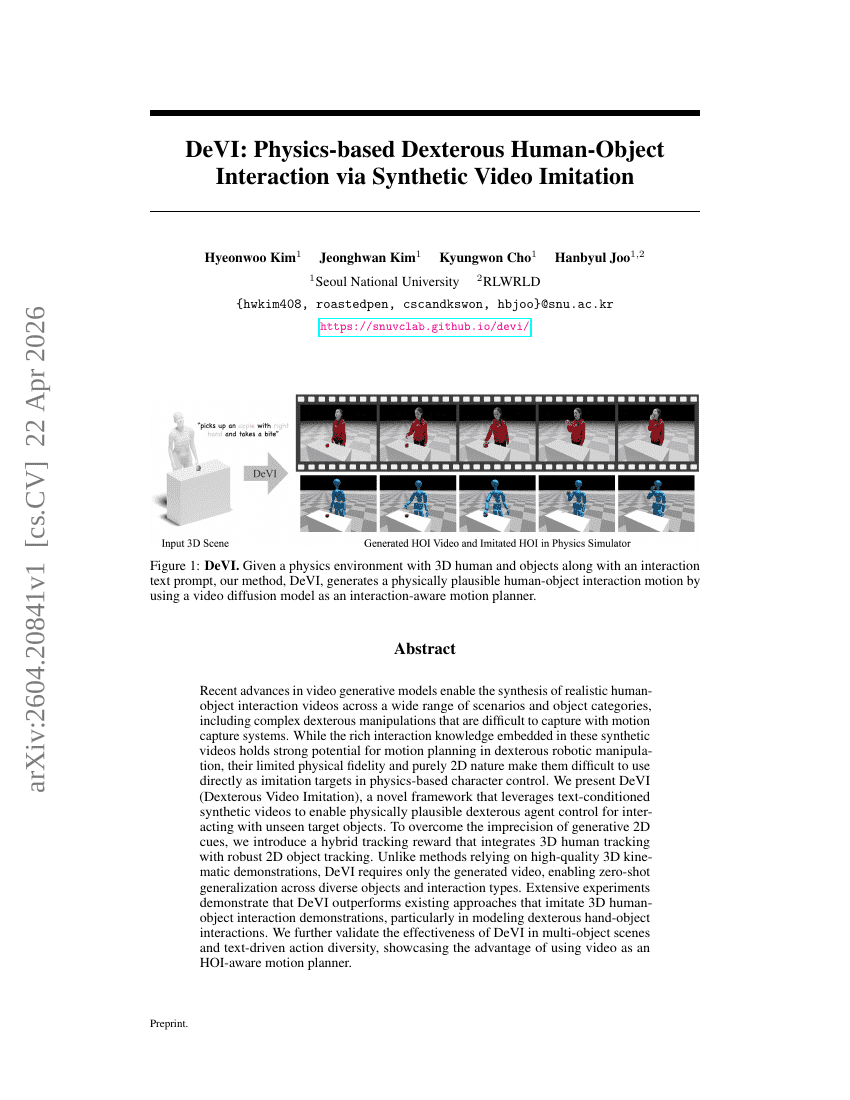
DeVI : Interaction humaine-objet dextre basée sur la physique via l'imitation de vidéos synthétiques
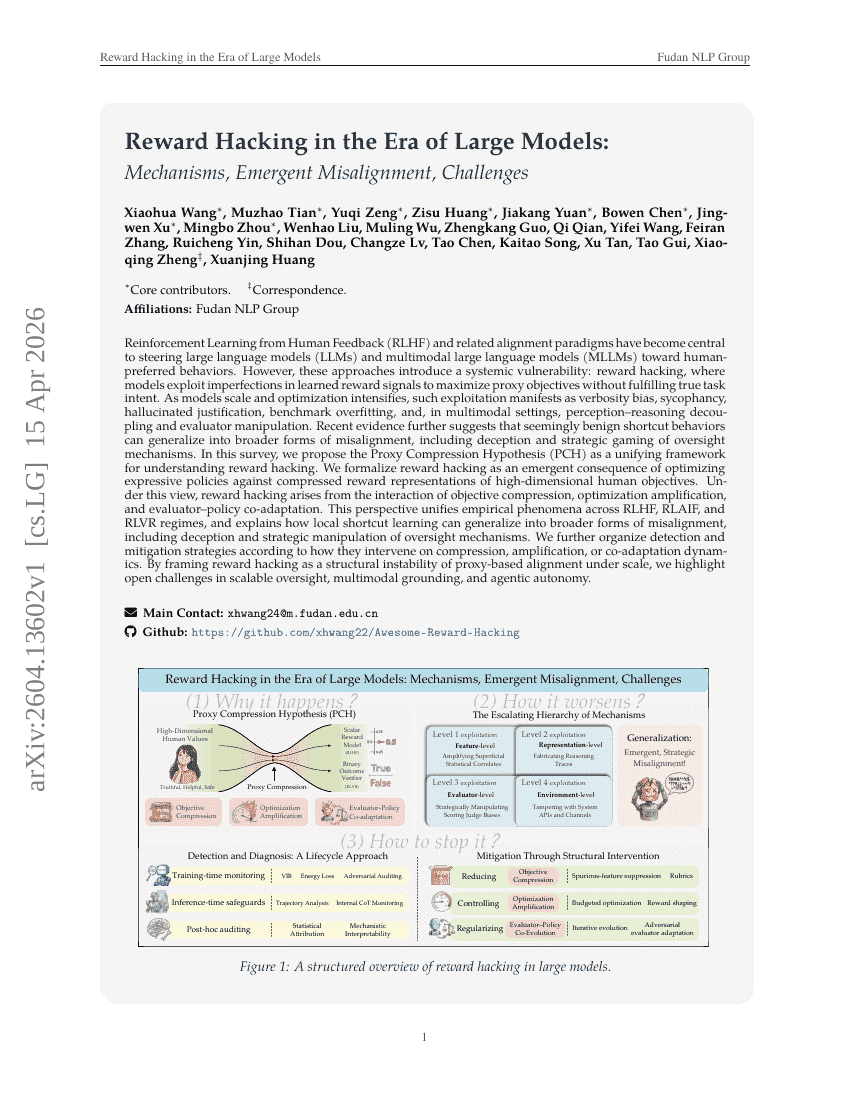
Le Reward Hacking à l'ère des grands modèles : mécanismes, désalignement émergent et défis
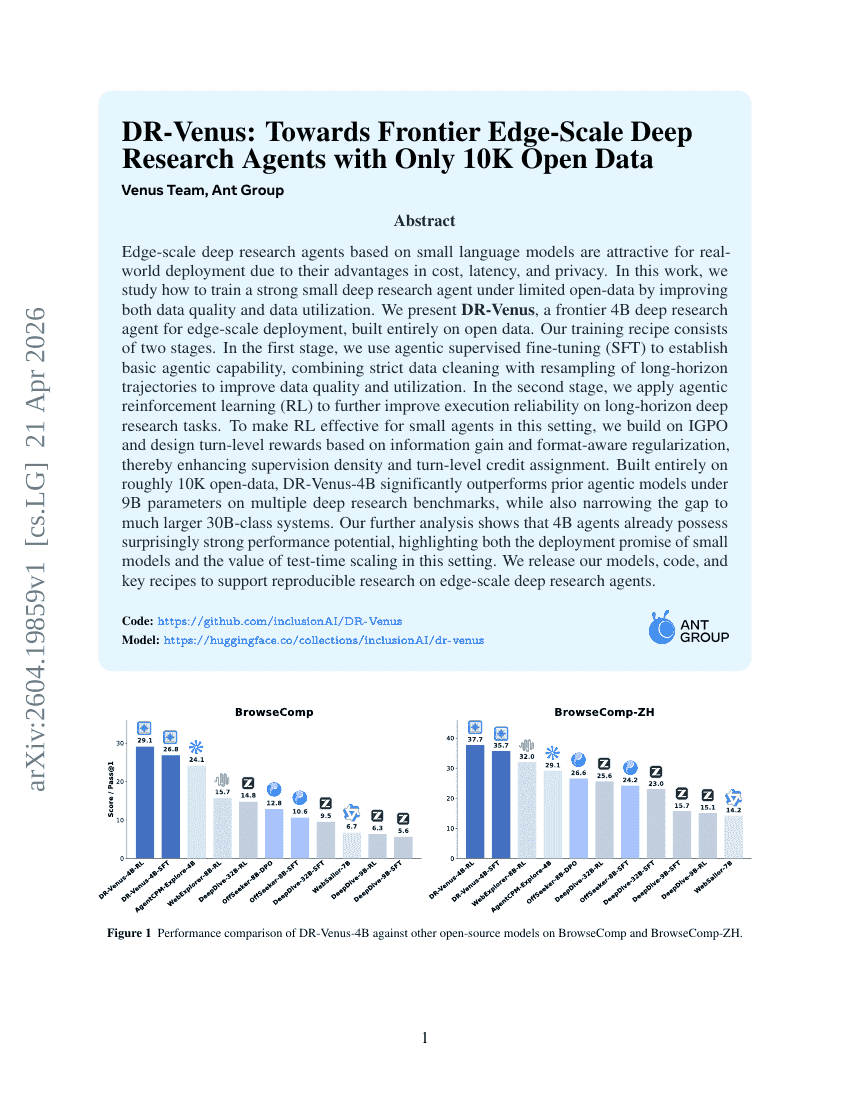
DR-Venus : Vers des agents de recherche profonde à l'échelle de l'edge à la frontière, avec seulement 10k données ouvertes
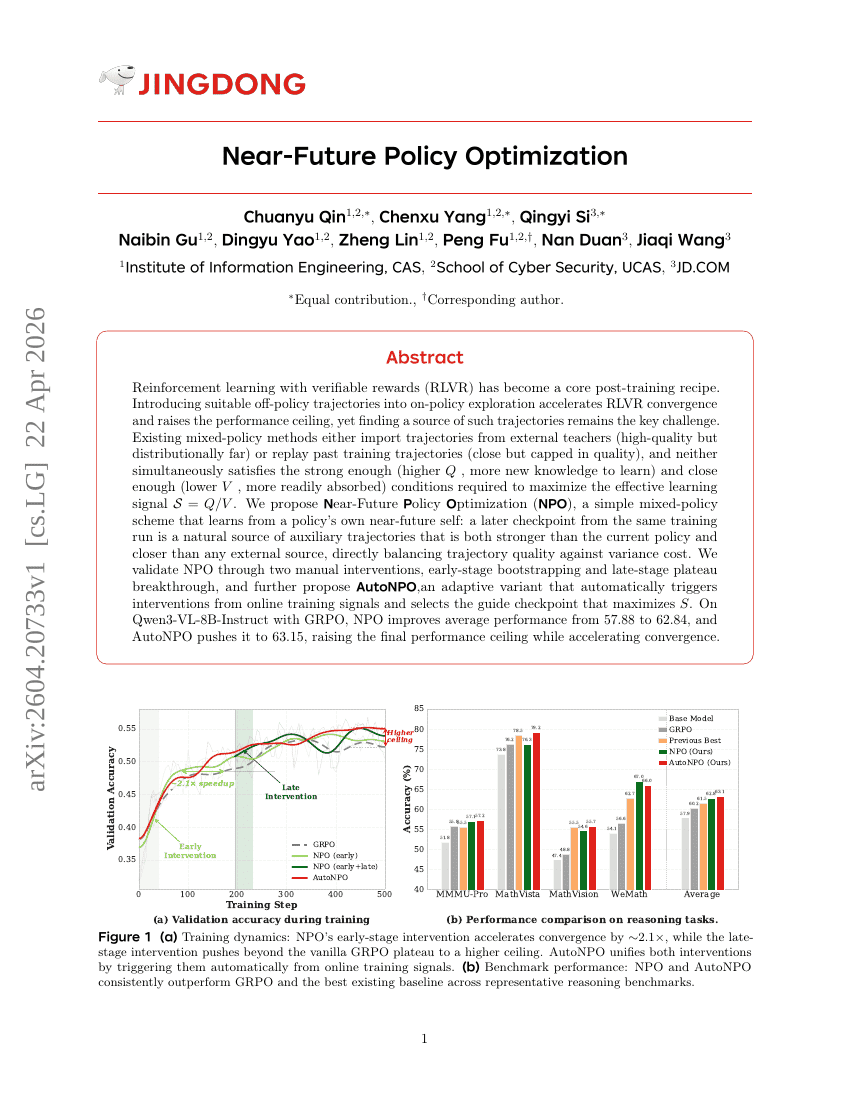
Optimisation de politique à court terme