Command Palette
Search for a command to run...
Meilleur Article Étudiant Au CVPR ! Un Grand Ensemble De Données De 10 Millions d'images Et Plus De 450 000 Espèces, Le Modèle Multimodal BioCLIP Permet Un Apprentissage Sans Prise De Vue
Contrairement au domaine académique traditionnel qui accorde une grande importance à la publication de revues, dans le monde informatique, en particulier dans les domaines de l'apprentissage automatique, de la vision par ordinateur, de l'intelligence artificielle, etc., les conférences de haut niveau sont reines. D’innombrables « directions de recherche brûlantes » et « méthodes innovantes » en découleront.
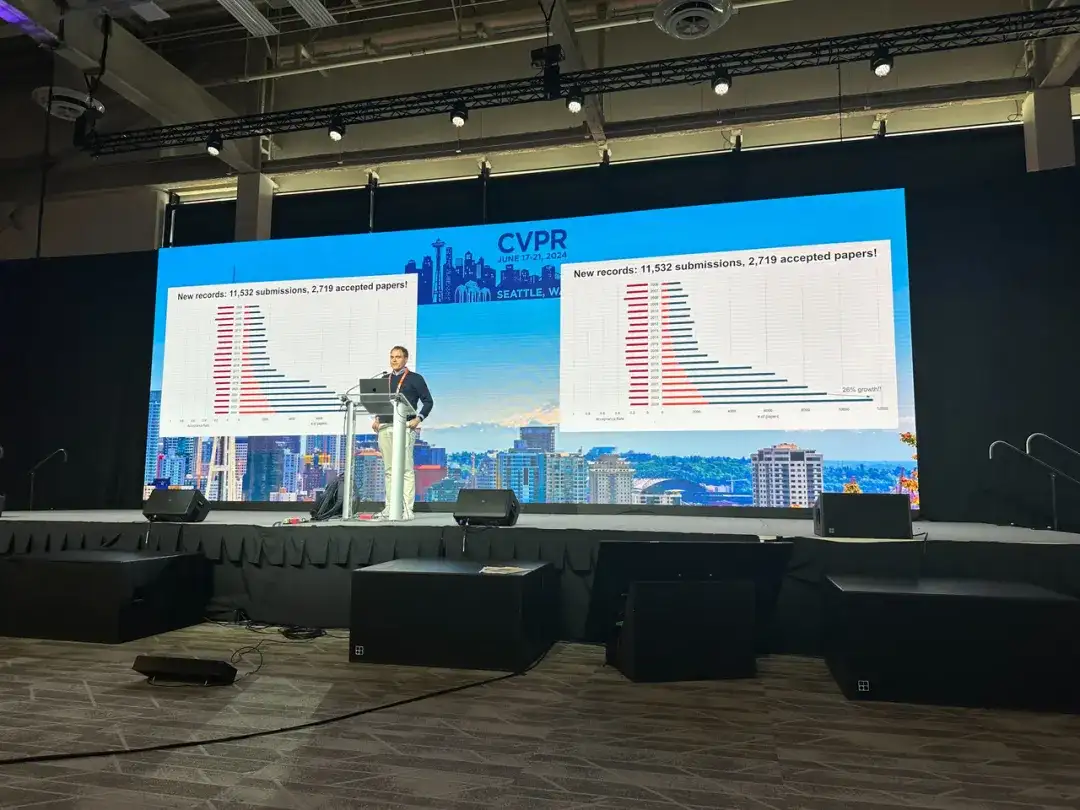
En tant que l'une des trois conférences les plus influentes sur le plan académique dans le domaine de la vision par ordinateur et même de l'intelligence artificielle, la Conférence internationale sur la vision par ordinateur et la reconnaissance de formes (CVPR) de cette année a battu des records précédents en termes d'échelle de conférence et de nombre d'articles acceptés.
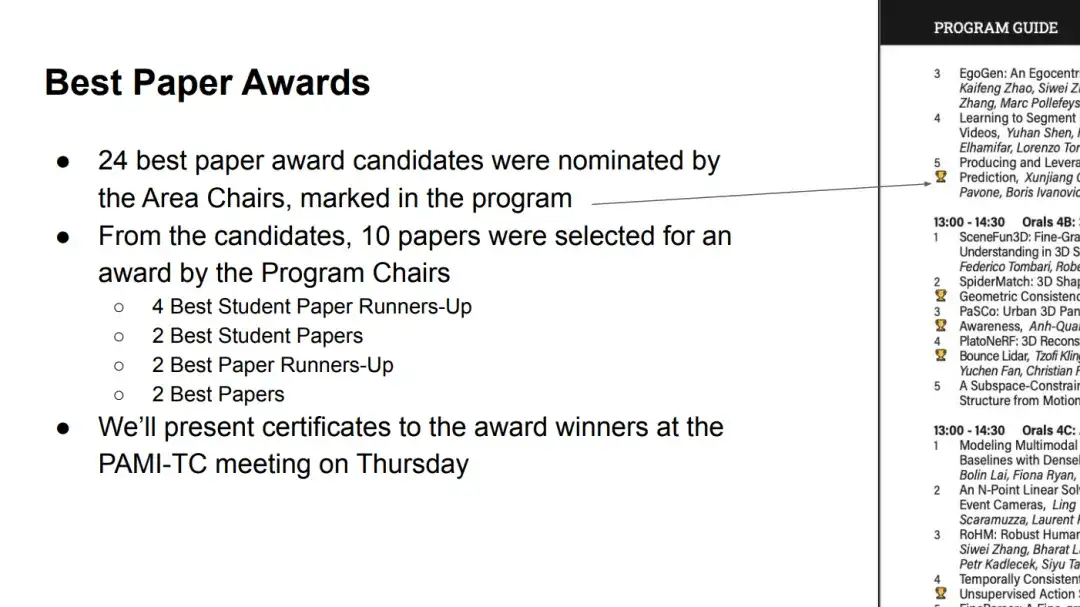
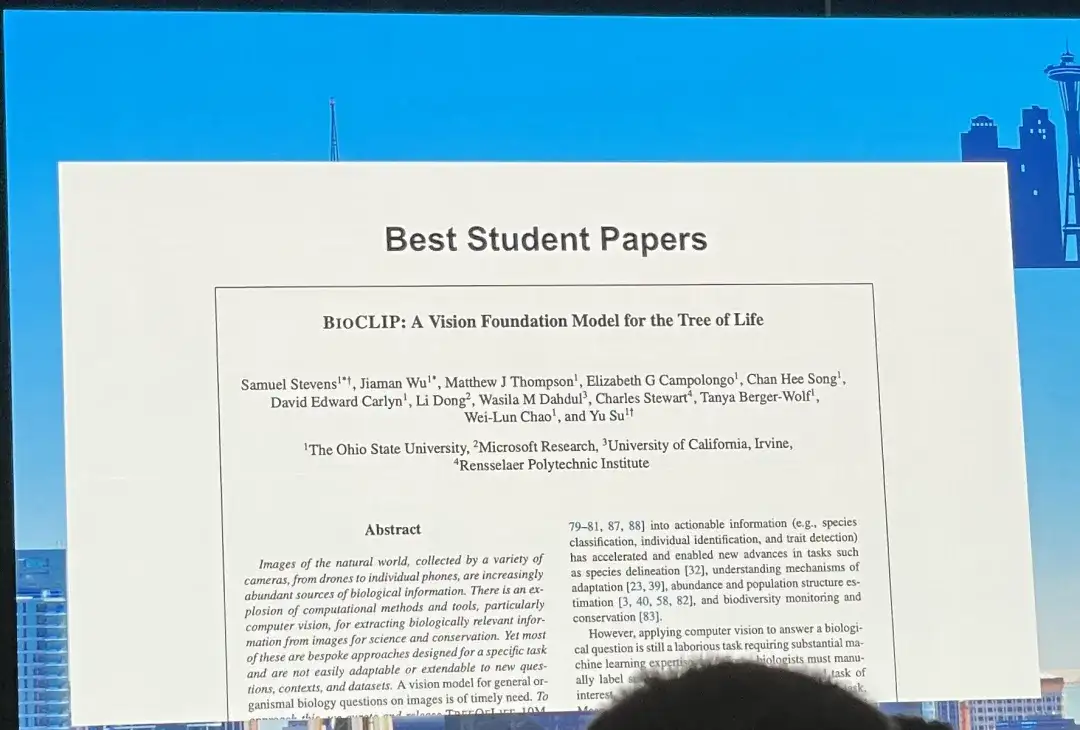
Adresse de téléchargement : https://arxiv.org/pdf/2311.18803
Création de l'ensemble de données d'images biologiques le plus vaste et le plus diversifié
Actuellement, le plus grand ensemble de données d’images biologiques pour l’apprentissage automatique est iNat21, qui contient 2,7 millions d’images et couvre 10 000 espèces. Bien que l'étendue de la classification d'iNat21 ait été grandement améliorée par rapport aux ensembles de données du domaine général tels qu'ImageNet-1k, 10 000 espèces sont encore rares en biologie. L'Union internationale pour la conservation de la nature (UICN) a recensé plus de 2 millions d'espèces connues en 2022, dont plus de 10 000 espèces d'oiseaux et de reptiles seulement.
Pour résoudre le problème des restrictions de catégories d’espèces dans les ensembles de données d’images biologiques,**Les chercheurs ont construit un ensemble de données appelé TreeOfLife-10M contenant 10 millions d’images.**Couvrant plus de 450 000 espèces, il a réalisé une avancée révolutionnaire en termes de taille des ensembles de données et de diversité des espèces.
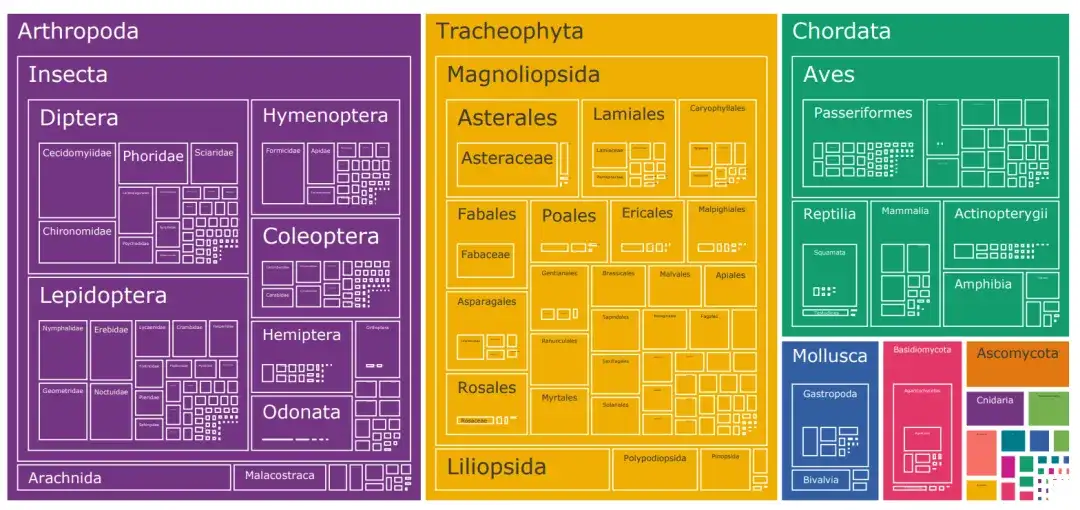
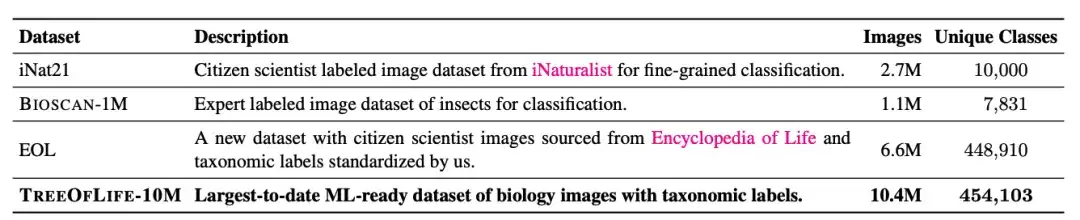
Adresse de téléchargement de TreeOfLife-10M : https://go.hyper.ai/Gliol
Modèle multimodal BioCLIP : Améliorer les capacités de généralisation basées sur CLIP
Comparé aux tâches générales, l’espace d’étiquetage de la vision par ordinateur biologique est plus riche. Non seulement le nombre d’annotations de classification est énorme, mais les annotations sont également interconnectées dans le système de classification hiérarchique. Cela pose sans aucun doute d’énormes défis pour la formation de modèles de base avec une couverture d’espèces élevée et de fortes capacités de généralisation.
S'appuyant sur des centaines d'années d'expérience en recherche biologique, les chercheurs pensent que si le modèle sous-jacent peut encoder avec succès la structure de l'espace d'annotation, alors même si une espèce particulière n'a pas été observée, le modèle peut être en mesure d'identifier son genre ou sa famille correspondant et de donner une représentation correspondante. Cette représentation hiérarchique permettra d’obtenir un apprentissage en quelques coups, voire en zéro coup, de nouveaux taxons.
Sur cette base, les chercheurs ont choisi CLIP, une architecture de modèle multimodale développée par OpenAI.Et utilisez l'objectif d'apprentissage contrastif multimodal de CLIP pour vous pré-entraîner en continu sur TREEOFLIFE-10M.
Plus précisément, CLIP entraîne deux modèles d'intégration unimodale, l'encodeur visuel et l'encodeur de texte, pour maximiser la similarité des caractéristiques entre les paires positives et minimiser la similarité des caractéristiques entre les paires négatives, où les paires positives proviennent des données d'entraînement et les paires négatives sont toutes les autres paires possibles dans le lot.
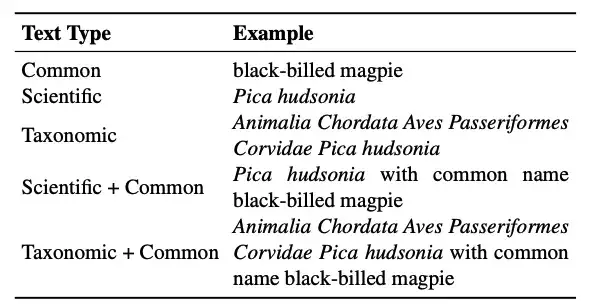
*** Nom taxonomique :**La classification biologique standard à sept niveaux va du plus haut au plus bas : Royaume, Embranchement, Classe, Ordre, Famille, Genre et Espèce. Pour chaque espèce, la taxonomie est « aplatie » en concaténant toutes les étiquettes de la racine aux feuilles en une seule chaîne, qui est le nom taxonomique.
*** Nom scientifique :**Se compose du genre et de l'espèce.
*** Nom commun :**Les noms de classe sont généralement en latin, ce qui n'est pas courant dans les ensembles de données de pré-formation image-texte généraux. Au lieu de cela, des noms communs tels que « pie à bec noir » sont plus courants. Il convient de noter qu’il n’existe peut-être pas de correspondance biunivoque entre les noms communs et les taxons ; une espèce peut avoir plusieurs noms communs, ou le même nom commun peut faire référence à plusieurs espèces.
Dans les applications pratiques, il peut n’y avoir qu’un seul type d’entrée d’annotation. Afin d'augmenter la flexibilité lors du raisonnement,**Les chercheurs ont proposé une stratégie de formation de type texte mixte.**Autrement dit, à chaque étape de formation, chaque image d’entrée est associée à un texte échantillonné de manière aléatoire parmi tous les types de texte disponibles. Les expériences montrent que cette stratégie de formation non seulement maintient l’avantage de généralisation des noms de classification, mais offre également plus de flexibilité lors du raisonnement.
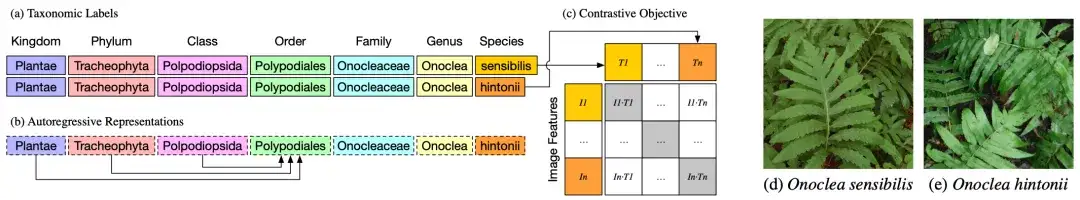
Comme le montre la figure 2b ci-dessus, l'encodeur de texte est un modèle de langage autorégressif qui peut encoder naturellement les représentations hiérarchiques de la taxonomie, où la représentation d'ordre Polypodiales ne peut dépendre que des ordres supérieurs et absorber les informations des jetons Royaume, Embranchement et Classe. Ces représentations hiérarchiques d'étiquettes taxonomiques sont introduites dans un objectif de pré-formation contrastif standard et mises en correspondance avec les représentations d'images (d) et (e).
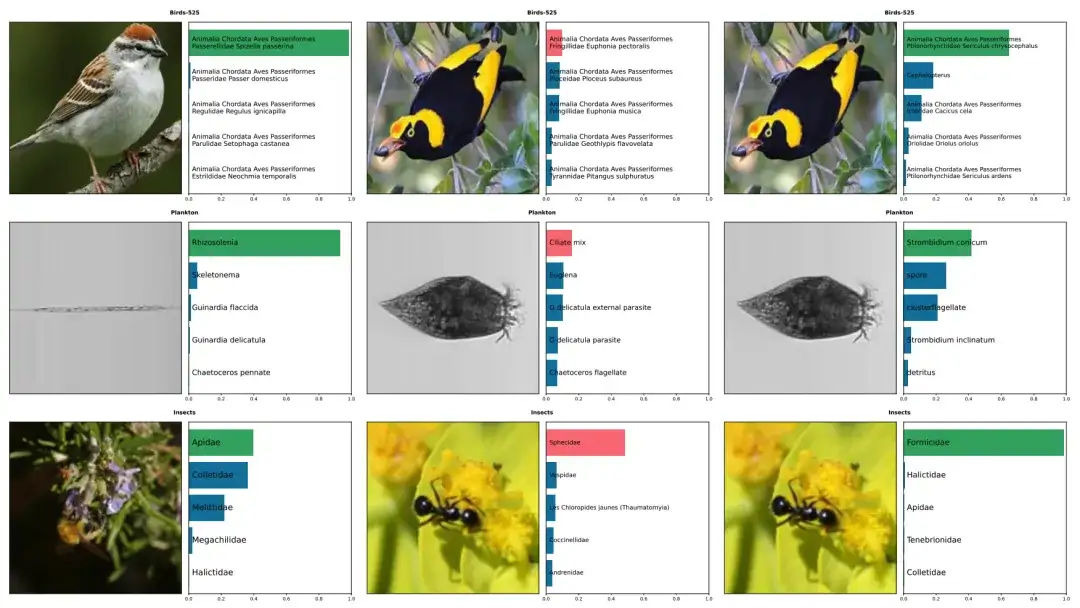
BioCLIP fonctionne bien sur les tâches à zéro tir et à peu de tirs
Les chercheurs ont comparé BioCLIP à un modèle de vision générale. Résultats**BioCLIP fonctionne bien dans les tâches à zéro tir et à quelques tirs, et surpasse considérablement CLIP et****OpenCLIP,**L'amélioration absolue moyenne dans les tâches à zéro tir et à quelques tirs est respectivement de 17% et 16%. L’analyse intrinsèque a également montré que BioCLIP apprenait une représentation hiérarchique plus fine, cohérente avec l’arbre de la vie, expliquant sa capacité de généralisation supérieure.
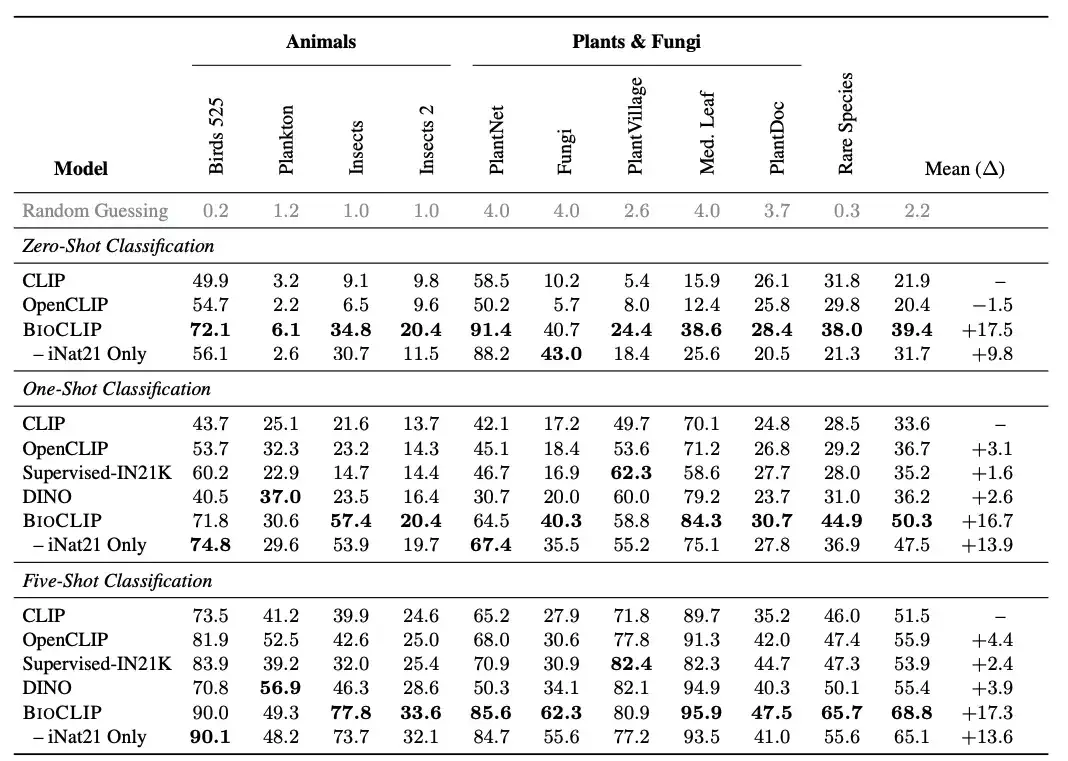
Comme le montre la figure ci-dessus, BioCLIP surpasse considérablement le modèle CLIP de base et le modèle CLIP formé avec iNat21 dans la classification zéro-shot, en particulier dans les classifications invisibles (voir la colonne Espèces rares).
Des résultats fructueux, explorant la recherche scientifique derrière le meilleur BioCLIP
« BioCLlP : un modèle de fondation de vision pour l'arbre de vie » a été publié conjointement par l'Université d'État de l'Ohio, Microsoft Research, l'Université de Californie, Irvine et le Rensselaer Polytechnic Institute.Le premier auteur de l'article, le Dr Samuel Stevens, et l'auteur correspondant, Jiaman Wu, sont tous deux de l'Université d'État de l'Ohio.
Bien que Samuel Stevens se décrive modestement sur son site Web personnel comme « une personne qui ne se prend pas très au sérieux », à en juger par ses résultats de recherche scientifique fructueux et ses efforts incessants au cours des dernières années, il est manifestement une personne qui prend la recherche scientifique au sérieux.
Il est entendu que Samuel Stevens se consacre à des travaux informatiques depuis 2017. Le modèle multimodal BioCLlP est un résultat de recherche qu'il a publié en décembre 2023 et a été accepté par CVPR 2024 en février 2024.
En fait, les travaux de vision par ordinateur comme BioCLlP ne sont qu’une de ses directions de recherche. Il a un large éventail d’intérêts et a mené une série de recherches dans des domaines tels que l’IA pour la cryptographie et divers projets LLM.
Par exemple, il a participé au « MMMU : un benchmark massif de compréhension et de raisonnement multimodal multidisciplinaire pour l'AGI expert ».**Un nouveau benchmark MMMU (Massive Multi-Task Language Understanding) est proposé.**En tant que l'un des référentiels d'évaluation de grands modèles les plus influents du secteur, MMMU se concentre sur l'exploitation des connaissances dans des domaines spécifiques (sciences, santé et médecine, sciences humaines, etc.) pour une perception et un raisonnement avancés, nécessitant des modèles multimodaux pour pouvoir effectuer des tâches similaires à celles auxquelles sont confrontés les experts.
Les chercheurs l'ont utilisé pour évaluer 14 LMM open source et le GPT-4V propriétaire (ision) et ont constaté que même le GPT-4V avancé n'atteignait qu'une précision de 56%, ce qui montre qu'il y a encore beaucoup de place pour l'amélioration du modèle. À cet égard, les chercheurs ont exprimé l’espoir que le benchmark inspirerait la communauté à construire la prochaine génération de modèles de fondation multimodaux pour atteindre une intelligence générale artificielle de niveau expert.
MMMU :https://mmmu-benchmark.github.io
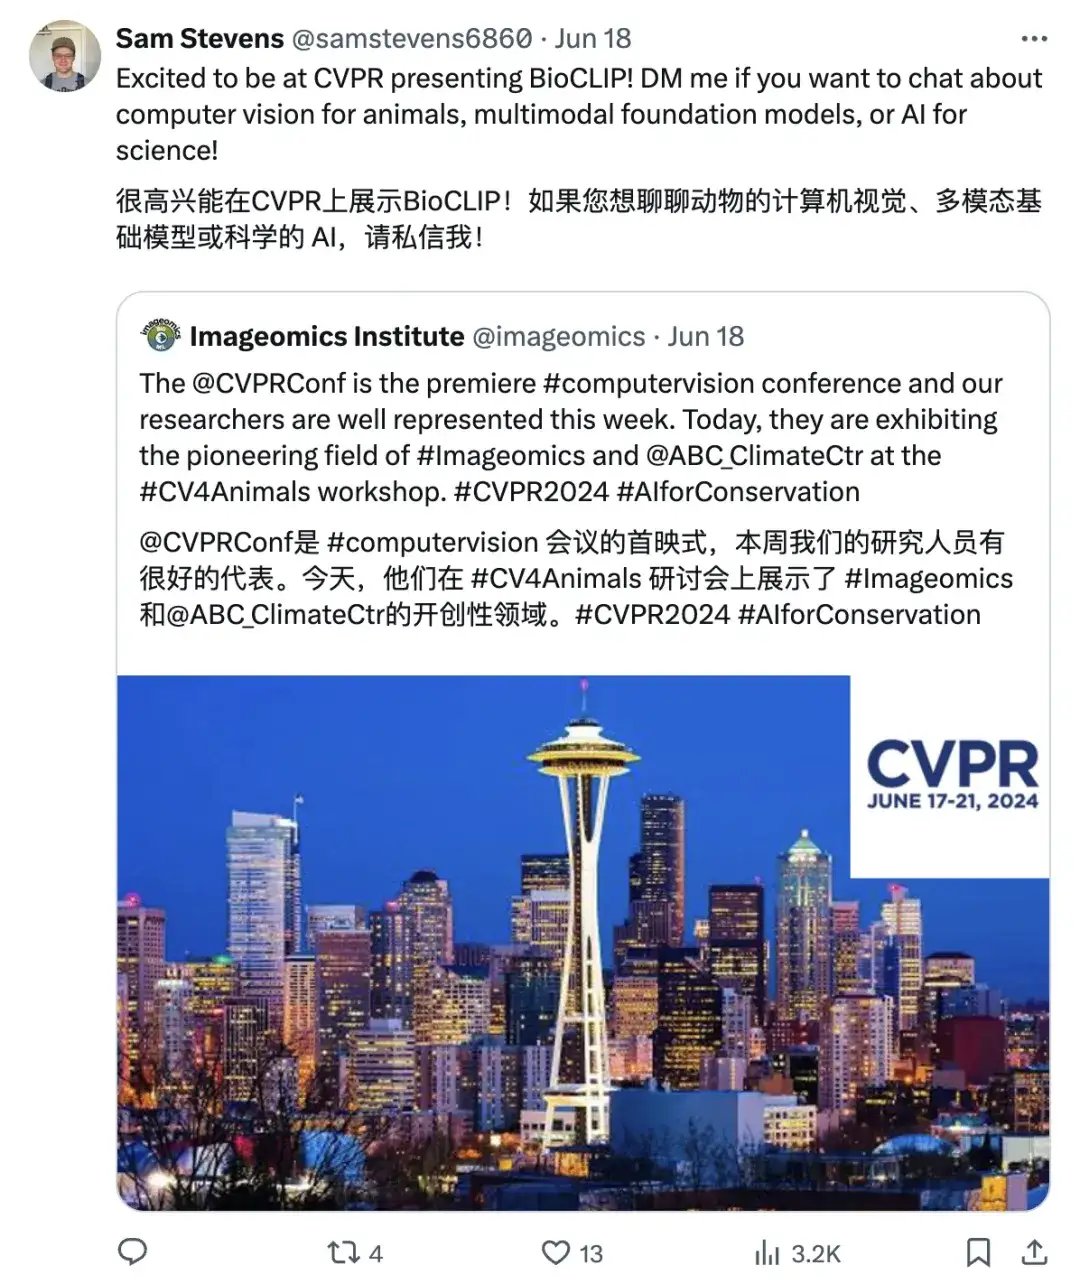
Bien entendu, sa passion pour la recherche scientifique et son attitude ouverte sont également des facteurs clés de son succès. Hier, la nouvelle que BioCLlP avait été nommé meilleur article étudiant est tombée, et le Dr Samuel Stevens a immédiatement exprimé son point de vue au monde extérieur via les plateformes sociales : « Si vous voulez parler de vision par ordinateur des animaux, de modèles multimodaux de base ou d'IA pour la science, envoyez-moi un message privé ! »
Références : 1.https://samuelstevens.me/#news
Enfin, je vous recommande une activité !
Scannez le code QR pour vous inscrire au 5e rassemblement hors ligne du salon technologique « Meet AI Compiler »↓