Command Palette
Search for a command to run...
Ensemble De Données De Paires image-texte CC12M
Date
Organisation
URL de publication
URL du document
Licence
Other
Balises
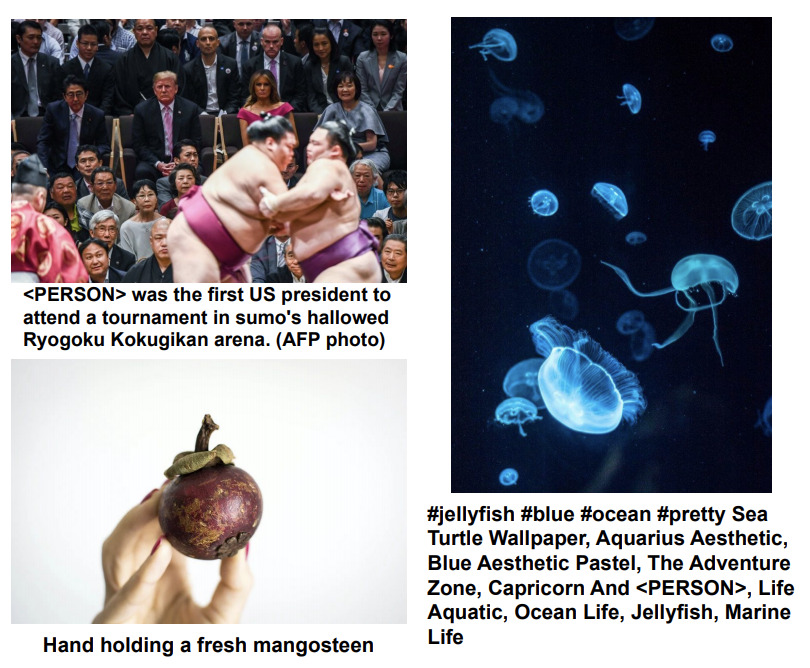
CC12M (Conceptual 12M) est un ensemble de données de paires image-texte spécialement conçu pour la pré-formation de la vision et du langage. L'ensemble de données contient 12 millions de paires image-texte. Comparé à CC3M, cet ensemble de données est plus performant en matière de reconnaissance visuelle à longue traîne pour plusieurs tâches en aval.
Citation
@inproceedings{changpinyo2021cc12m, titre = {{Conceptual 12M} : Propulser le pré-entraînement image-texte à l’échelle du Web pour reconnaître les concepts visuels à longue traîne}, auteur = {Changpinyo, Soravit et Sharma, Piyush et Ding, Nan et Soricut, Radu}, titre du livre = {CVPR}, année = {2021}, }
Créer de l'IA avec l'IA
De l'idée au lancement — accélérez votre développement IA avec le co-codage IA gratuit, un environnement prêt à l'emploi et le meilleur prix pour les GPU.