Command Palette
Search for a command to run...
Branchenneuheit! NVIDIA Und Das Team Des Nobelpreisträgers David Baker Veröffentlichen RFD4-Proteina Zur Bewältigung Der Entkopplung Von Sequenz, Struktur Und Funktion
In den letzten Jahren hat die Befähigung durch künstliche Intelligenz-Technologien das Feld der Proteinengineering grundlegend verändert. Bereiche wie die Biopharmazeutika, die Impfstoffentwicklung, die Gentherapie und die Biomanufacturing profitieren davon und haben vielversprechende Aussichten. Kehrt man jedoch zur Berechnung des Protein-Designs selbst zurück, so ist der Übergang von der Lösung der Frage „Kann es erzeugt werden?“ zur Frage „Wie kann es besser erzeugt werden?“ die zentrale Herausforderung der nächsten Phase. Frühere Ergebnisse haben gezeigt, dass es keine schwierige Aufgabe mehr ist, künstlich Proteine mit spezifischen Bindungsfähigkeiten oder katalytischen Aktivitäten zu designen. Bei komplexen molekularen Maschinen, die globale Konformationsdynamiken und gekoppelte multiple Constraints erfordern, bleibt eine stabile Realisierung jedoch weiterhin schwierig.
Vereinfacht ausgedrückt ist die Funktion eines Proteins im Wesentlichen das Ergebnis spezifischer chemischer Gruppen, die in einer spezifischen dreidimensionalen Form mit einer präzisen räumlichen Anordnung mit anderen Molekülen interagieren. Daher müssen beim Protein-Design-Stadium die starken Kopplungsbeziehungen zwischen molekularen Eigenschaften (molecular identity), strukturellen Konformationen (structural conformation) und Interaktionsgeometrien (interaction geometry) gleichzeitig berücksichtigt werden. Bestehende Methoden wie RFdiffusion3 können die Ganzatom-Strukturgenerierung in vielfältigen molekularen Umgebungen ermöglichen, sind jedoch nicht in der Lage, für die generierten Strukturen hochwertige Sequenzen zu entwerfen. Proteina-Complexa kann gleichzeitig Proteinsequenzen und -strukturen generieren und erweitert den Suchraum durch belohnungsgeführte Suche, wobei seine Repräsentationsweise speziell auf das Protein-Design ausgerichtet ist und die Konformation der Interaktionspartner-Moleküle fixiert und unveränderlich bleibt.
Um diese Herausforderung anzugehen, haben das Institute for Protein Design der University of Washington, NVIDIA und andere Institutionen gemeinsam das branchenweit erste integrierte Sequenz-Struktur-Ko-Generierungsmodell RFD4-Proteina vorgestellt, das sich auf latente Inferenz für multikomponentige Biomakromolekül-Komplexe stützt. Dieses Modell verschiebt das Protein-Design vom Generierungsparadigma „Verteilungssampling + nachträgliche Selektion“ hin zu einem Constraint-Suchparadigma mit intrinsischer/extrinsischer Inferenz. Es durchbricht die Engpässe traditioneller Modelle wie die enge Molekültypenbreite, die Entkopplung von Sequenz und Struktur sowie die starre Annahme der Partnermoleküle und beweist seine Wirksamkeit durch umfangreiche Laborexperimente.
Die relevanten Ergebnisse wurden unter dem Titel „Biomolecular design through latent reasoning with RFD4-Proteina“ veröffentlicht.
Forschungshighlights:
- Erste Einführung eines einheitlichen latenten Raums + doppelten Inferenzparadigmas, um das Entkopplungsproblem von Sequenz-Struktur-Funktion an der Wurzel zu lindern
- Ein einzelnes Modell deckt den gesamten Moleküldesign-Workflow ab und kann mehrere spezialisierte Tools ersetzen
- Die Validierung durch Laborexperimente hat mehrere Meilenstein-Durchbrüche erreicht, einschließlich der ersten De-novo-Design-Synthese von enzymatisch aktiven Wirkstoffen
Link zur Publikation:
https://rfd4-proteina.org/assets/paper/RFD4-Proteina.pdf
Aufbau von Trainings- und Testbenchmarks durch multimodale molekulare Daten
Trainingsdatensatz
Der Trainingsdatensatz von RFD4-Proteina besteht aus einer Mischung aus öffentlichen biologischen Strukturdatenbanken, synthetischen Datensätzen, die durch physikalische Simulationen erzeugt wurden, und destillierten Datensätzen. Die gesamte Datenverarbeitung und Annotation wird mit dem Tool AtomWorks durchgeführt. Die Abtastverhältnisse der verschiedenen Datensätze in den unterschiedlichen Trainingsphasen sind im folgenden Diagramm dargestellt:
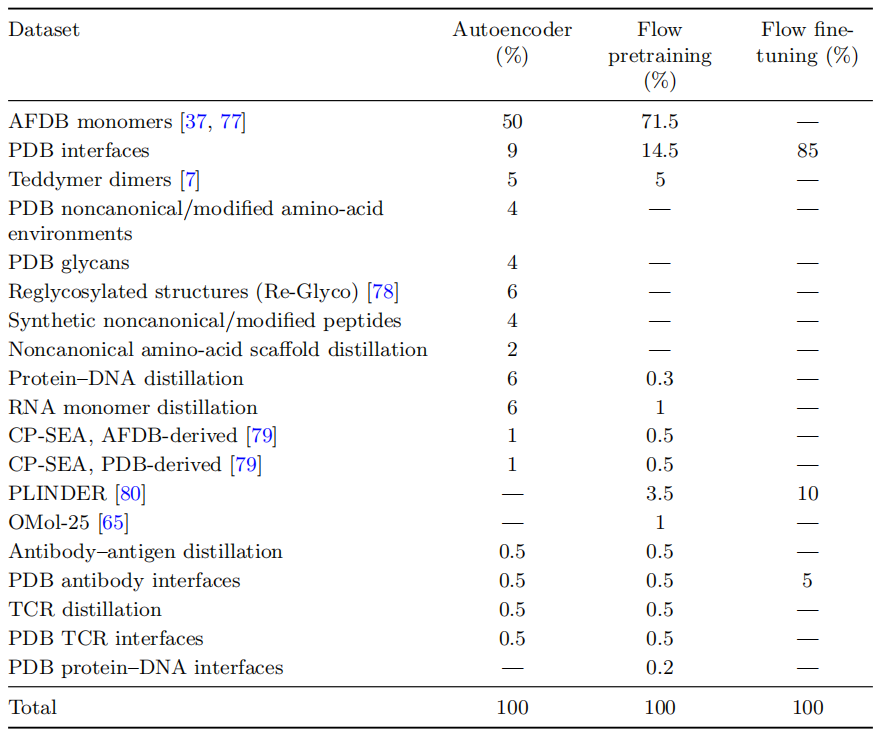
Der Datensatz umfasst nicht nur Standardproteine, sondern wurde auch um Proben von kleinen Molekülen, Nukleinsäuren, Zuckern und posttranslationalen Modifikationen (nicht-kanonische Aminosäuren, NCAA) erweitert, um den Mangel an Proben seltener Molekültypen in realen experimentellen Strukturen auszugleichen.
Während des Trainings werden verschiedene Constraint-Bedingungen online abgetastet, um reale Protein-Design-Aufgaben zu simulieren und das Verständnis des Modells für verschiedene funktionale Constraints zu verbessern.
Testdatensatz
Der Testdatensatz für die Side-chain-Packing-Aufgabe ist der PackBench-Benchmark-Datensatz, der 114 echte Hauptketten-Gerüste natürlicher Proteine aus CASP14 und CASP15 enthält. Der Testdatensatz für das Design mit fixiertem Backbone-Sequenzgerüst umfasst natürliche Proteingerüste und De-novo-Design-Gerüste. Ersteres sind natürliche Strukturen, die im Training nicht gesehen wurden und als Test zurückgehalten wurden; letztere sind künstliche Proteingerüste, die vom unabhängigen Modell RFD3 generiert wurden. Der Testdatensatz für die Liganden-Stereochimie ist die CCD-Datenbank, die 43 im Training nicht gesehene Liganden enthält. Der Testdatensatz für Designoptimierungsaufgaben besteht aus 102 Komplexen, die zuvor von RFdiffusion generiert, aber durch das AF3-Struktur-Screening nicht bestanden wurden. Der Testdatensatz für die Bindung von Peptid-MHC-Komplexen enthält drei Zielpeptide: MART-1 (Tumorantigen), das Membranproteinpeptid von SARS-CoV-1 und das Phox2B-Peptid. Der Testdatensatz für die Aufgabe „Intrinsically Disordered Regions“ (IDRs) enthält 8 IDR-Peptide, die in zwei Kategorien unterteilt sind: 5 bilden nach der Bindung Sekundärstrukturen; 3 bilden selbst bei Bindung keine stabilen Sekundärstrukturen. Der Testdatensatz für die Aufgabe der Tropomyosin-Rezeptorkinasen (TrkA, TrkB und TrkC) enthält 94 Design-codierende Gene.
Einheitlicher latenter Raum + doppelte Inferenz schaffen das erste Full-Chain-Generierungsparadigma
Der Kerngedanke des RFD4-Proteina-Modells besteht darin, einen einheitlichen chemisch-konformationellen latenten Raum zu etablieren, der durch Flow-Matching generiert wird. Gleichzeitig wird eine doppelte latente Inferenz (intrinsisch/extrinsisch) im latenten Raum durchgeführt, und eine sinnvolle Atomrekonstruktion wird unter der Aufsicht von differenzierbaren physikalischen Kraftfeld-Constraints realisiert.
Einheitlicher chemisch-konformationeller latenter Raum
Zunächst trainierte das Forschungsteam einen Autoencoder, der natürliche/modifizierte Aminosäuren, Zucker und Nukleotide in Ankeratom-Koordinaten (bei Aminosäuren z. B. das α-Kohlenstoffatom) und einen 32-dimensionalen latenten Vektor (molekulare Identität) kodiert, wie im folgenden Diagramm gezeigt. Natürlich werden nicht alle Komponenten in den latenten Vektor komprimiert; ein Teil der molekularen Komponenten behält explizite Informationen über Atomarten und chemische Bindungsverknüpfungen bei, um sicherzustellen, dass die chemische Struktur nicht durcheinandergerät.
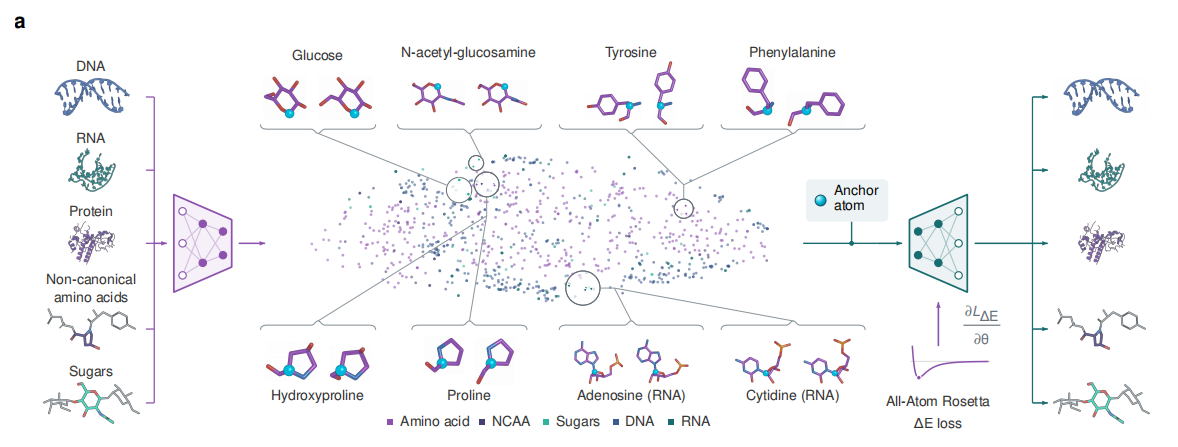
Um physikalisch plausible rekonstruierte Strukturen zu erhalten, wurde während des Feinabstimmungsprozesses speziell eine auf der Rosetta-Energieverlustfunktion basierende Methode eingeführt, wobei die Gradienten der dekodierten Koordinaten mit Hilfe von TMol berechnet wurden.
Flow-Matching-Modell
Anschließend trainierte das Forschungsteam ein Flow-Matching-Modell zur simultanen Generierung von Molekülkoordinaten und latente Vektoren. Dies stellt eine Erweiterung des teilweisen latenten Variablen-Frameworks dar, das von La-Proteina / Proteina-Complexa vorgeschlagen wurde.
Im Vergleich zu früheren ko-design Ansätzen für Sequenz und Struktur wurde das Modell in vier Schlüsselbereichen verbessert:
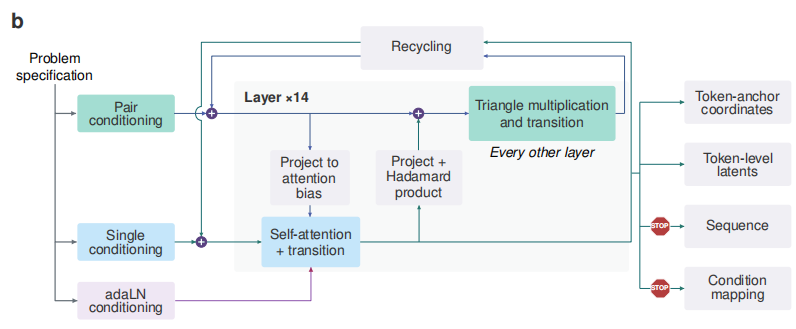
Erweiterung der Trainingsdaten: Einführung multimodaler, physikalisch simulierter synthetischer Daten sowie strukturvorhersagebasierter Distillationsdaten, die kleine Moleküle, Nukleinsäuren und Protein-Grenzflächen abdecken. Während des Trainings wurden die Bedingungsinformationen so abgetastet, dass die Merkmale gezielt angepasst wurden, um den tatsächlichen Designanforderungen zu entsprechen und das Verständnis des Modells für praktisch wirksame Einschränkungen zu verbessern. Beispielsweise wurden Positionseinschränkungen für Spitzenatome in Taschen ähnlich wie bei Enzymaktiven Zentren abgetastet, und durch die Nutzung großer, rein proteinbasierter Datensätze wurden realistische atomare Motiv-Gerüstaufgaben generiert. Stärkung der paarweisen Repräsentation: Trianguläre Multiplikationsupdates wurden in jedem zweiten Transformer-Block durchgeführt (wie im folgenden Diagramm gezeigt), um die Informationsinteraktion von einzelnen Merkmalen zu paarweisen Merkmalen zu verstärken und gleichzeitig die Breite der versteckten Schichten zu erhöhen; sowie intrinsische / extrinsische Schlussfolgerung.
Doppelte Schlussfolgerung
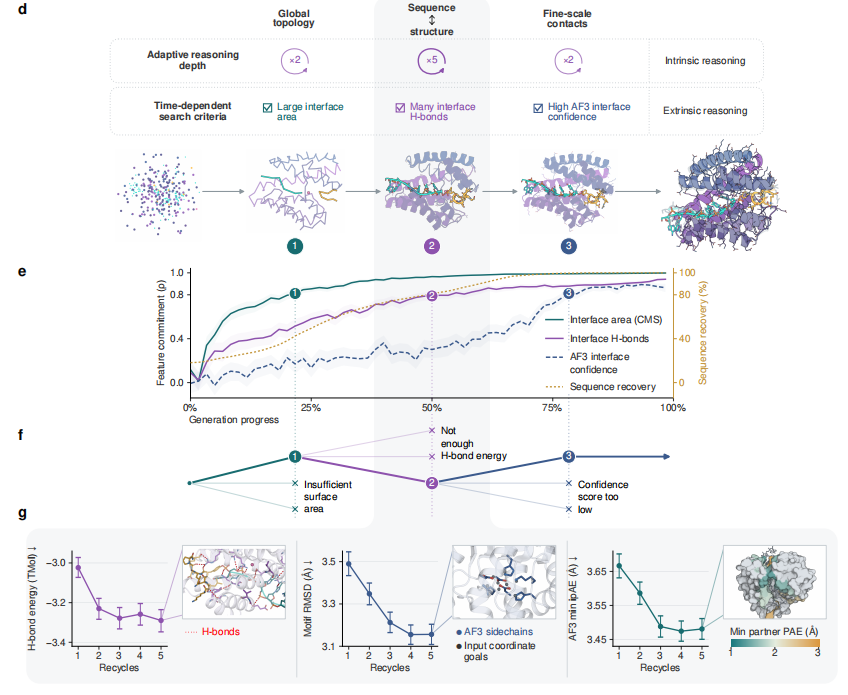
Intrinsische Schlussfolgerung (intrinsic reasoning): Es wird eine iterative Verfeinerung bei jedem Diffusions-Zeitschritt durchgeführt, nicht nur in der anfänglichen Vorverarbeitungsphase. Die Anzahl der Iterationsdurchläufe kann sich je nach Zeitschritt ändern, um in kritischen Generierungsphasen eine feinere Optimierung zu ermöglichen.
Extrinsische Schlussfolgerung (extrinsic reasoning): Es wird eine spurgeübergreifende Suche über mehrere Generierungstrajektorien durchgeführt, wobei die Abtastergebnisse zugunsten von Designs gelenkt werden, die benutzerdefinierte Metriken erfüllen. Gleichzeitig kann die extrinsische Schlussfolgerung an Merkmale und Zeitschritte gekoppelt erfolgen, d.h., dass die Optimierung spezifischer Metriken erst dann gezielt durchgeführt wird, wenn sich die entsprechenden molekularen Merkmale allmählich ausgebildet und stabilisiert haben, anstatt alle Ziele während des gesamten Prozesses gleichzeitig zu optimieren.
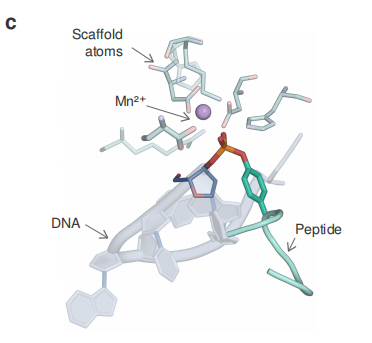
Das Forschungsteam analysierte den Generierungsprozess des Modells anhand eines Testfalls: Design eines Enzyms, das die kovalente Bindung zwischen der Peptidkette in einem flexiblen Substrat und DNA spaltet. Wie im folgenden Diagramm gezeigt:
Die Untersuchung ergab, dass verschiedene Designziele zu unterschiedlichen Zeitpunkten im Generierungsprozess schrittweise erreicht werden. Konkret lag der Zeitpunkt, zu dem die Korrelation zwischen unabhängigen Vorhersagen und dem Endergebnis in 500 Trajektorien etwa 0,8 erreichte, bei:
- Vorhersagbarkeit des Grenzflächenflächen-Generierungsprozesses bei etwa 20 % des Fortschritts;
- Vorhersagbarkeit von Wasserstoffbrückenbindungen bei etwa 50 % des Fortschritts;
- Vorhersagbarkeit der AlphaFold3 (AF3)-Grenzflächenkonfidenz bei etwa 80 % des Fortschritts.
Während der Suche im Inferenzprozess wurden die Trajektorien nacheinander basierend auf Grenzflächenfläche, Wasserstoffbrückenbindungen und AF3-Grenzflächenkonfidenz gefiltert. Trajektorien, die von den aktuellen Kriterien abwichen, wurden an jedem Prüfknoten beendet. Diese sequenzielle Suche ermöglicht eine effiziente Durchsuchung des latenten Raums, um Ausgabeergebnisse zu finden, die alle Kriterien erfüllen (wie im folgenden Diagramm gezeigt). Im Vergleich zum einfachen Abtasten war die Anzahl der eindeutigen qualifizierten Designs pro GPU-Stunde im oben genannten Fallbeispiel dreimal höher.
Zahlreiche Innovationen, insbesondere die Einführung der doppelten intrinsischen/extrinsischen Schlussfolgerung, ermöglichten es RFD4-Proteina, zwei wesentliche Engpässe früherer traditioneller Protein-Generierungsmodelle zu überwinden: die begrenzte Abdeckung des molekularen chemischen Raums und die unzureichende Fähigkeit zur effizienten Suche nach Ergebnissen, die gekoppelte chemisch-geometrische Einschränkungen erfüllen. Dies hebt das Proteindesign von reinem Diffusions-Abtasten auf eine großangelegte, vereinheitlichte Biomolekül-Design-Paradigma, die Schlussfolgerung, physikalische Einschränkungen sowie eine gemeinsame Optimierung von Sequenz und Struktur umfasst.
Doppelte Validierung der Modellfähigkeiten durch Simulations-Benchmarks und Nasslabor-Experimente
Validierung in verschiedenen molekularen Szenarien
Das Forschungsteam verglich RFD4-Proteina zunächst in computergestützten Simulationstests mit anderen generativen, Halluzinations- und Strukturverfeinerungsmethoden. Die Testaufgaben umfassten vier Hauptkategorien: Design von Protein-Bindern (24 Zielmoleküle), Design von Kleinmolekül-Bindern (77 Zielmoleküle), Aufbau von Enzym-Gerüsten (37 Zielmoleküle) und Design von DNA-Bindern (3 Zielmoleküle). Wie im folgenden Diagramm gezeigt:
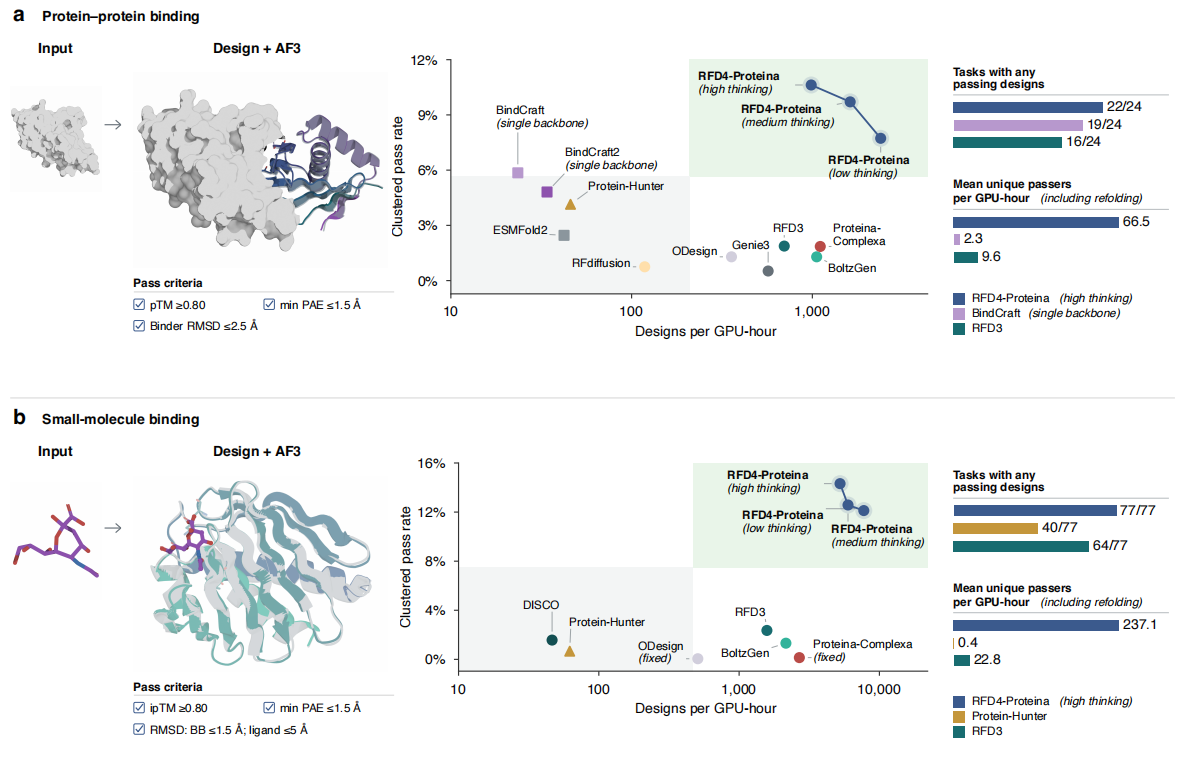
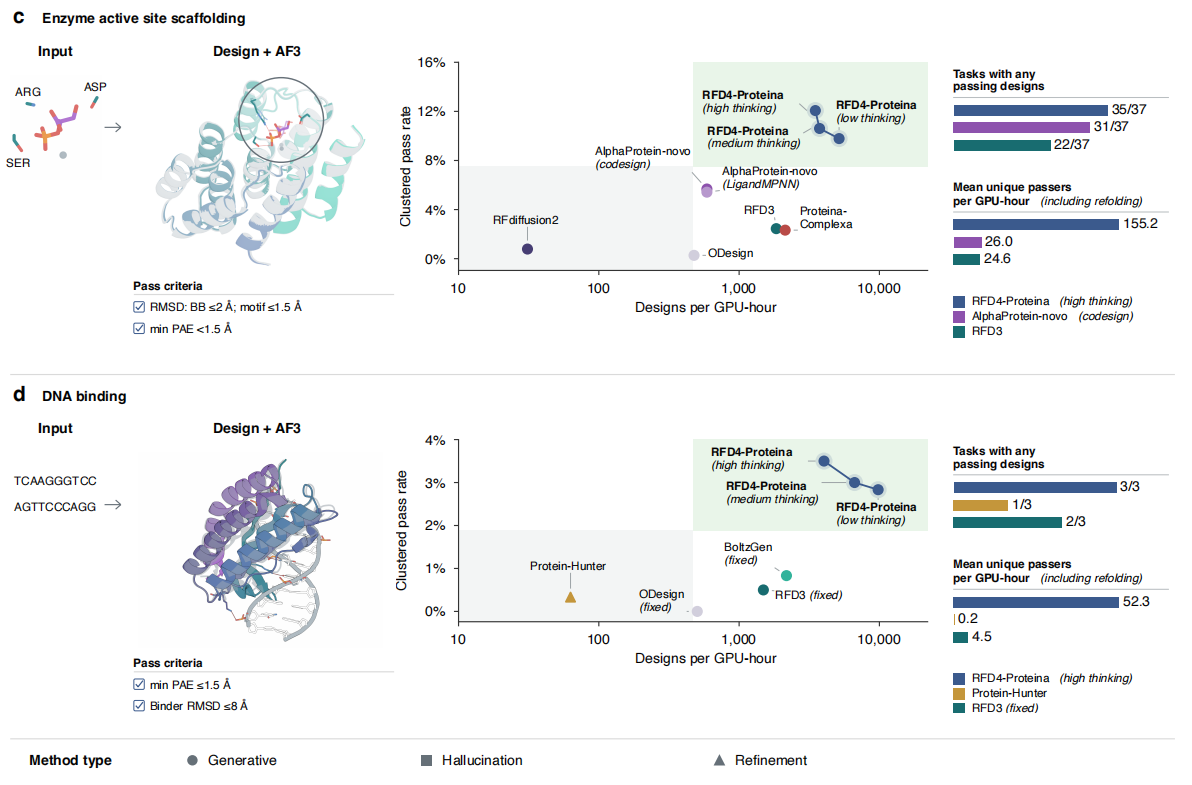
Die Bewertung erfolgte, indem AF3 die Struktur unabhängig von den designten Sequenzen vorhersagte, und zwar anhand der Übereinstimmung mit der Zielstruktur sowie der Erfüllung aufgabenspezifischer Struktur- und Konfidenzkriterien. Zwei Kernmetriken:
- Generierungsdurchsatz (generation throughput): Wie viele Designs pro GPU-Stunde erzeugt werden können;
- Cluster-Pass-Rate (clustered pass rate): Der Anteil der qualifizierten Strukturen, die die Bewertungskriterien bestehen und sich strukturell nicht wiederholen, bei jedem ersten Versuch.
Unter der High-Thinking-Bedingung zeigen die Ergebnisse, dass bei der Proteindocking-Aufgabe die Cluster-Durchlassrate von RFD4-Proteina 10,6 % beträgt, während das nächstbeste Modell, BindCraft, nur 5,9 % erreicht, was einer 42-fachen Steigerung des Durchsatzes entspricht. Bei der Aufgabe des Enzym-Gerüst-Designs liegt die Cluster-Durchlassrate von RFD4-Proteina bei 12,1 %, im Vergleich zu 5,7 % beim Co-Design-Modell AlphaProtein-novo, was einer 5,9-fachen Steigerung des Durchsatzes entspricht. Bei der Aufgabe des Small-Molecule-Binding liegt die Cluster-Durchlassrate von RFD4-Proteina bei 14,3 %, im Vergleich zu 2,4 % bei RFD3, was einer 3,3-fachen Steigerung des Durchsatzes entspricht. Alle 77 Zielstrukturen bestanden das Design (bei RFD3 waren es 64). Bei der DNA-Binding-Aufgabe liegt die Cluster-Durchlassrate von RFD4-Proteina bei 3,5 %, im Vergleich zu 0,8 % bei BoltzGen.
Somit löst RFD4-Proteina in allen vier Benchmark-Tests mehr Design-Herausforderungen als alle verglichenen Baseline-Modelle, ohne dass während des Generierungsprozesses Rückmeldungen von Strukturvorhersagern erforderlich sind, und weist gleichzeitig eine höhere Cluster-Durchlassrate und eine schnellere Generierungsgeschwindigkeit auf. Unter Einbeziehung der AF3-Bewertungszeit erzeugt RFD4-Proteina unter High-Thinking-Bedingungen pro GPU-Stunde 5-mal, 10,4-mal, 6-mal und 5,5-mal mehr gültige Cluster als die jeweils nächstbesten Baseline-Modelle in den Aufgaben Proteindocking, Small-Molecule-Binding, Enzym-Gerüst-Design und DNA-Binding.
Bei der Untersuchung, ob die Steigerung der internen推理fähigkeit (Inference-Fähigkeit) die Design-Erfolgsrate erhöht, stieg die Cluster-Durchlassrate in der Proteindocking-Aufgabe von 7,7 % in der Low-Einstellung schrittweise auf 10,6 % in der High-Thinking-Einstellung. In der Small-Molecule-Binding-Aufgabe stieg sie von 12,1 % auf 14,3 %, in der Enzym-Gerüst-Design-Aufgabe von 9,8 % auf 12,1 % und in der DNA-Binding-Aufgabe von 2,8 % auf 3,5 %. Der Generierungsdurchsatz nahm jedoch mit steigendem Rechenaufwand ab; so sank beispielsweise in der Proteindocking-Aufgabe die Anzahl der Designs pro GPU-Stunde von 2388 (Low) auf 986 (High-Thinking).
Bei der Untersuchung, ob die Zulassung von Konformationsänderungen der molekularen Umgebung während des Generierungsprozesses die Design-Erfolgsrate erhöht, stieg unter High-Thinking-Bedingungen bei RFD4-Proteina die Cluster-Durchlassrate von 8,1 % auf 14,3 %, wenn die gemeinsame Generierung der Ligandenkonformation mit dem Designprotein zugelassen wurde. Wenn Änderungen der Seitenketten des Zielproteins und der DNA-Konformation zugelassen wurden, stieg die Cluster-Durchlassrate für Proteindocking von 9,6 % auf 10,6 % und für DNA-Binding von 2,0 % auf 3,5 %.
Bei der Untersuchung, ob externe推理 (Inference) die Design-Erfolgsrate durch Integration von Daten anderer Tools steigern kann, wurde festgestellt, dass die Suche durch den Einsatz externer Tools vermeiden kann, Rechenressourcen in aussichtslosen Trajektorien zu verschwenden. In schwierigen Aufgaben wie Enzym-Gerüst-Design und Small-Molecule-Binding stieg die Effizienz bei der Generierung qualifizierter, einzigartiger Designs um 22,6 % bzw. 24,6 %.
Schließlich bestätigten Ablationsstudien einzeln, dass Trianguläre Aktualisierung, Hadamard-Produkt-Operation, der Mechanismus der internen推理 und exploratives Training entscheidende Komponenten für die Leistungssteigerung des Modells sind. Dabei trägt die trianguläre Multiplikations-Aktualisierung am meisten zur Leistung bei, während die anderen Komponenten unterschiedliche Gewinne erzielen, sodass die gesamte Verbesserung nicht durch einen einzelnen Trick erreicht wird.
Validierung in spezifischen molekularen Workflows
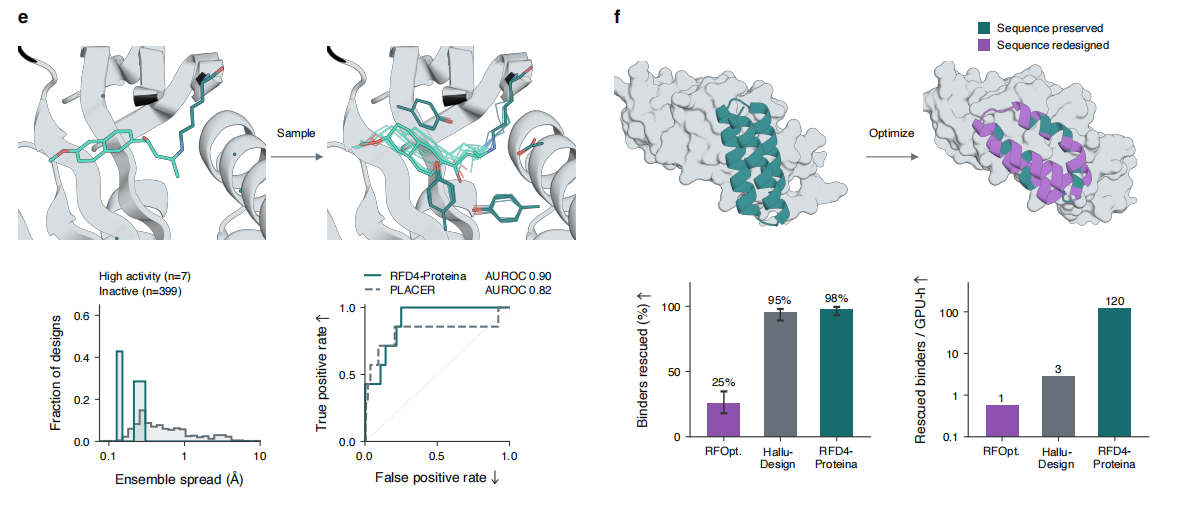
Nach der Validierung der neu generierten Designs evaluierten die Forscher, ob dasselbe Modell auch die anderen molekularen Prozesse unterstützt, die für Konstruktion, Bewertung und Optimierung von Designs erforderlich sind. Experimente testeten sechs Anwendungsfälle, darunter Sequenzzuweisung, Konformationsaufnahme und Optimierung bestehender Strukturen, wie in der folgenden Abbildung dargestellt:
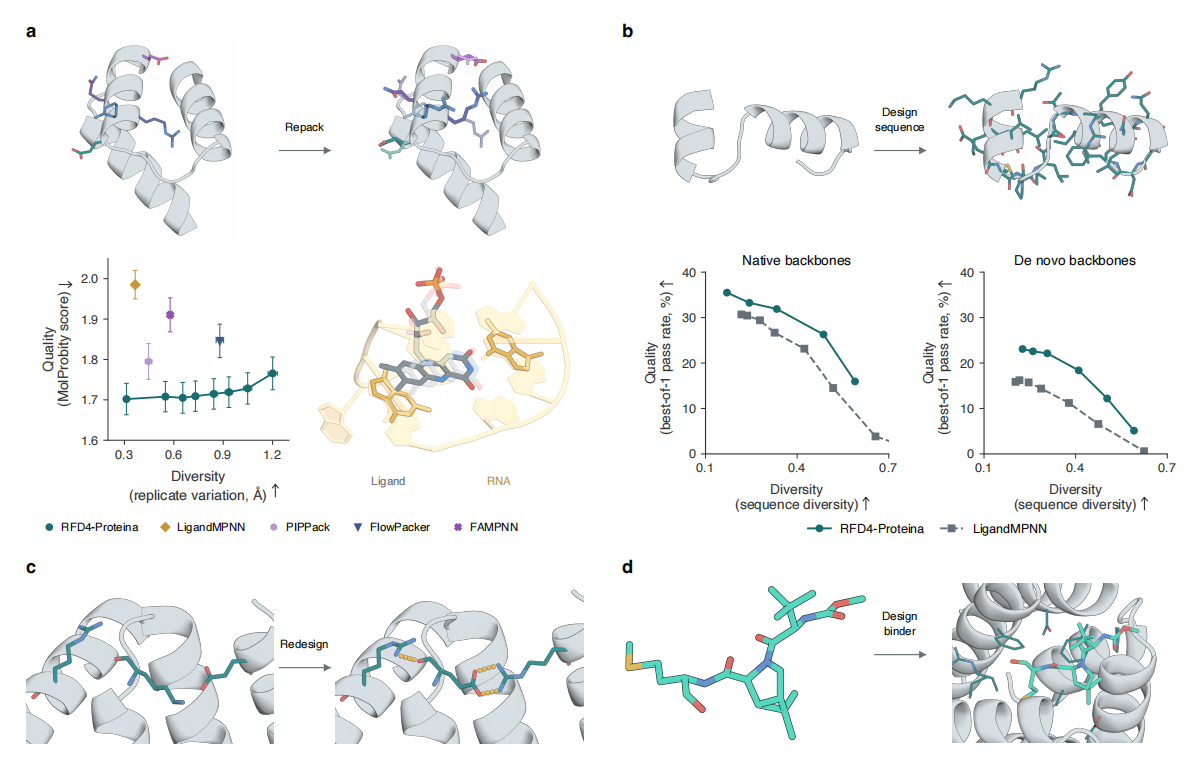
Bei der Aufgabe des Side-chain-Packing (Seitenketten-Packung) erzielt RFD4-Proteina bei gegebener Proteinsequenz und Backbone-Koordinaten eine niedrigere durchschnittliche MolProbity-Score von 1,70 im Vergleich zu 1,99 bei LigandMPNN bei ähnlicher Konformationsdiversität.
MolProbity: Ein Qualitätskontrolltool für Proteinstrukturen, das Bindungslängen, Bindungswinkel, sterische Kollisionen und unangemessene Torsionen überprüft. Es ist die am häufigsten verwendete Metrik für Side-chain-Packing-Aufgaben; ein niedrigerer MolProbity-Score bedeutet eine bessere stereochemische Qualität der Struktur.
Durch Erhöhung des Sampling-Rauschens kann die durchschnittliche Differenz zwischen den Seitenkettenpaaren von 0,31 Å auf 1,20 Å erhöht werden, was zeigt, dass vielfältige Konformationen ohne Beeinträchtigung der Strukturqualität erzeugt werden können, wobei der MolProbity-Score nur leicht von 1,70 auf 1,77 ansteigt.
Bei der Aufgabe des Fixed-Backbone-Sequenzdesigns wurde RFD4-Proteina als inverses Faltungstool evaluiert. Die Ergebnisse zeigen, dass RFD4-Proteina bei zwei Testsets, die aus nativen Protein-Gerüsten und von RFD3 generierten de novo entworfenen Gerüsten bestehen, stets eine höhere Durchlassrate als LigandMPNN bei vergleichbarer Diversität der Übereinstimmungen aufweist.
In der Aufgabe zum Design flexibler Skelettsequenzen betrug die durchschnittliche Differenz der Spezifität (ΔipTM) von RFD4-Proteina mit flexiblem Skelett auf den 13 Testdatensätzen (Ziel/Off-Target) von HBDesigner 0,25, während RFD4-Proteina mit festem Skelett nur 0,18 erreichte. Dieser Wert ist der höchste unter allen Vergleichsmethoden.
ΔipTM bezeichnet die Differenz der ipTM zwischen Ziel und Off-Target; ein höherer Wert steht für eine stärkere Spezifität des Zielproteins im Vergleich zu Off-Target-Proteinen.
Bei der Aufgabe zur Stereochemie von Liganden erreichte RFD4-Proteina eine Korrektheit der Chiralität von 98,8 %; die Korrektheit der Doppelbindungs-Stereochemie betrug 92,2 %; und der PoseBusters-Score (gesamte chemische Plausibilität) lag bei 92,3 %. Alle Werte sind besser als die von AF3 und dem auf Platz zwei liegenden generativen Modell.
Bei der Optimierungsaufgabe zeigte die Untersuchung, ob bereits generierte, aber experimentell nicht getestete Designs noch gerettet werden können, dass RFD4-Proteina nach jeweils sechs Optimierungsversuchen pro Design 100 von 102 Designs erfolgreich reparieren konnte, während HalluDesign nur 97 und RFoptimization nur 26 reparieren konnte. Es ist außerdem hervorzuheben, dass die Rechenzeit von RFD4-Proteina extrem kurz ist und kürzer als bei jedem anderen Modell.
Experimentelle Validierung im Labor
Das Forschungsteam testete die Leistungsfähigkeit von RFD4-Proteina bei verschiedenen Designaufgaben, bei denen Spezifität eine zentrale Einschränkung darstellt.
Zunächst wurde Calmodulin betrachtet (siehe Abbildung unten), das zwei Zustände aufweist: den calciumfreien Zustand (eine Konformation) und den Ca²⁺-gebundenen Zustand (eine vollständig andere Konformation). Das Ziel des Forschungsteams war es, Calmodulin ausschließlich im letzteren Zustand zu erkennen. Von den getesteten 18 Designsequenzen zeigten 12 eine calciumabhängige Bindung, mit gemessenen scheinbaren Affinitäten im Bereich von 69 pM bis 37 nM.
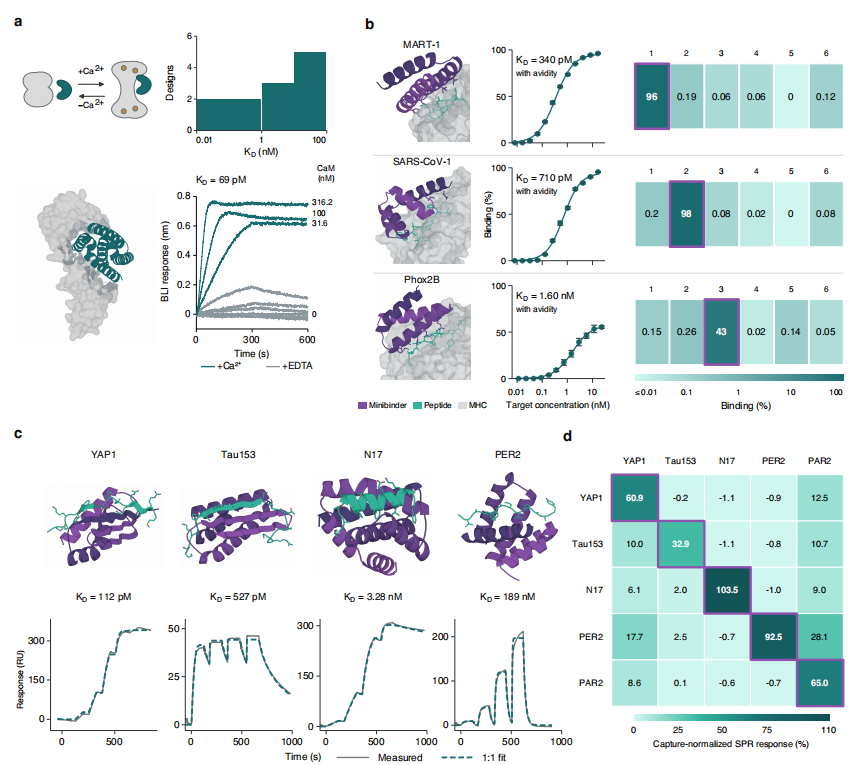
Bei der pMHC-Aufgabe bewertete das Forschungsteam die Fähigkeit von RFD4-Proteina, präzise an Zielpeptide zu binden, und entwickelte Bindungsproteine für MART-1, das Membranprotein-Peptid von SARS-CoV-1 und das Phox2B-Peptid. Yeast-Display-Titrationsversuche zeigten, dass die scheinbaren halbmaximalen Bindungskonzentrationen der Bindungsproteine für die drei Peptide 340 pM, 710 pM bzw. 1,60 nM betrugen. Bei weiteren Screening-Durchläufen mit strukturell ähnlichen Off-Target-Peptiden wurde in allen Fällen eine Spezifitätsdifferenz von mehr als dem 100-fachen erreicht.
Bemerkenswert ist, dass einige Zielpeptide den Nicht-Ziel-Peptiden sehr ähnlich sind; so unterscheidet sich das Off-Target-Peptid von Phox2B nur durch eine einzelne Aminosäure vom Zielpeptid, und bei SARS sind es nur zwei Aminosäuren. Dies zeigt, dass RFD4-Proteina hochspezifische pMHC-Mikro-Binder designen kann.
Bei der IDR-Aufgabe testete das Forschungsteam, ob die Konformationsinferenz von RFD4-Proteina die Entwicklung von Bindern für 8 IDR-Peptide ermöglicht. Die Ergebnisse zeigten je einen Fehlschlag bei zwei Klassen von IDR-Peptiden, während die übrigen 6 hochaffine Binder hervorbrachten. Unter diesen waren die ersten künstlich从头 (de novo) entworfenen Bindungsproteine, die auf die IDR-Epitope von YAP1 und Tau abzielen, mit den stärksten Affinitäten von 112 pM bzw. 527 pM.
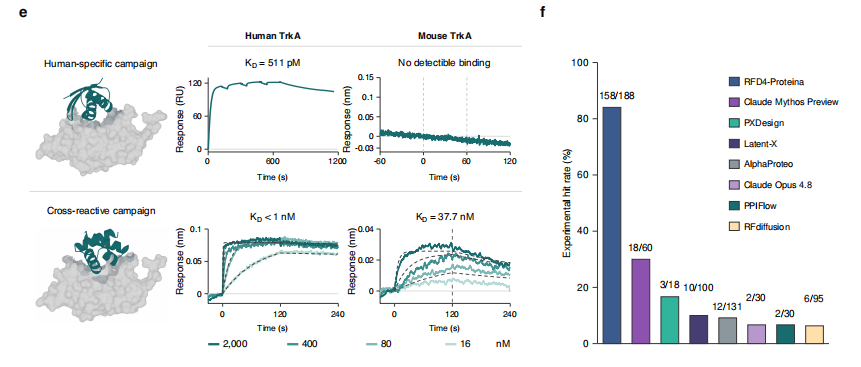
Bei der Kinase-Protein-Design-Aufgabe definierte das Forschungsteam zwei Szenarien: Bindung nur an humanes TrkA, ohne Bindung an murines TrkA sowie ohne Bindung an humanes TrkB und TrkC; und gleichzeitige Bindung an humanes und murines TrkA, weiterhin ohne Bindung an TrkB und TrkC. In den artspezifischen Kreuzreaktivitätsexperimenten erfüllten 18 von 94 Designs das erwartete Muster. Die beste Affinität zu humanem TrkA lag unter 1 nM, zu murinem TrkA bei 37,7 nM.
Ohne spezielle Einschränkungen, wenn nur die Bindung an humanes TrkA gefordert war, erreichten 158 von 188 Designs von RFD4-Proteina eine Affinität unter 1 μM, was einer Erfolgsquote von 84 % entspricht. Im Vergleich dazu erzielte Claude Mythos Preview (unter Verwendung von Open-Source-Protein-Design-Tools) nur 18 von 60, was einer Erfolgsquote von lediglich 30 % entspricht.
Anschließend testeten die Forscher, ob RFD4‑Proteina mit komplexen Molekülsystemen umgehen kann, die posttranslationale Modifikationen aufweisen: Glykosylierung und Phosphorylierung.
Bei der Glykosylierungs-Aufgabe bestand die bisherige Einschränkung darin, dass nur kurze Hochmannose-Zuckerketten wie Man5~Man8 stabil gebunden werden konnten, während die längsten Ketten Man9 oder GlcMan9 nicht stabil gehalten werden konnten. Das Ziel bestand darin, mit RFD4‑Proteina kleinere Proteine zu designen, die primär Man9 / GlcMan9 binden, wobei die terminalen Mannosereste weiterhin zugänglich bleiben.
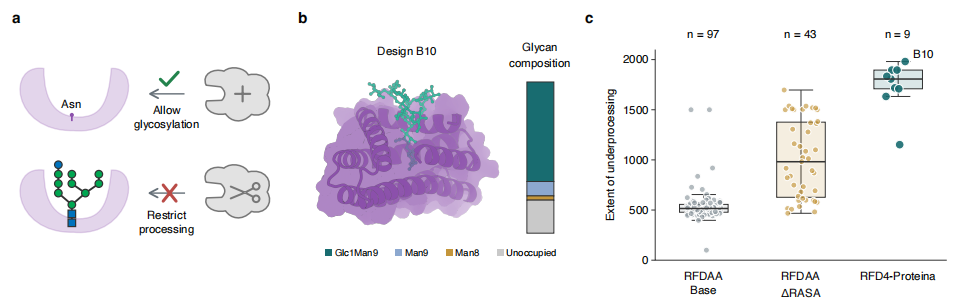
Die Ergebnisse zeigten, dass RFD4‑Proteina im Vergleich zum herkömmlichen RFDAA eine deutlich höhere Rate an computergestützten Designs erzielte, die die Kriterien erfüllten. Bei der LC-MS/MS-Massenspektrometrie wiesen 8 von 9 Designs an den Modifikationsstellen zu mehr als 90 % Hochmannose-Zuckerketten auf (nicht prozessiert). Die Erfolgsrate bei nicht prozessierten Zuckerketten war höher als bei allen bisherigen Methoden.
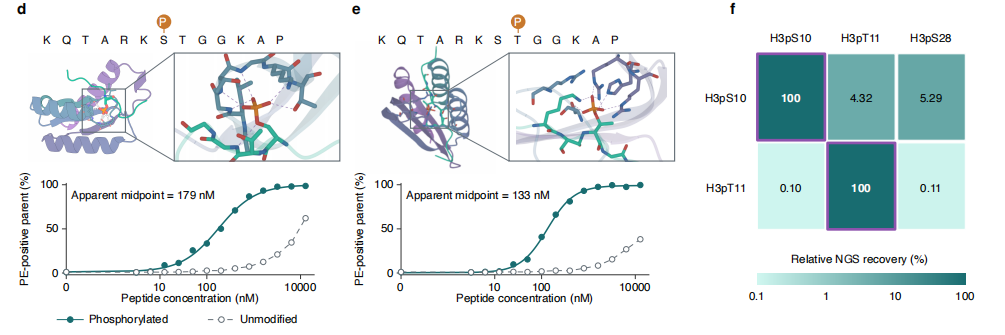
Bei der Phosphorylierungsaufgabe stellte das Forschungsteam die Histone-H3-Schwanz-Region mit den benachbarten Stellen pS10 und pT11 auf die Probe, um phosphorylierungsabhängige Bindungsproteine zu identifizieren. Die Ergebnisse zeigten, dass die getroffenen Sequenzen bevorzugt an ihre jeweiligen phosphorylierten Zielstrukturen binden und dabei selektiv bleiben gegenüber der Phosphorylierung der benachbarten Nicht-Zielstellen. Dies unterstreicht, dass RFD4‑Proteina nicht nur eine einzelne Phosphatgruppe erkennt, sondern auch die feinen Unterschiede der lokalen chemischen Mikroumgebung wahrnimmt – etwa an welchem Aminosäurerest die Phosphatgruppe angebracht ist und in welchem Sequenzkontext sie sich befindet – was eine präzise Unterscheidung auf Stellenebene ermöglicht.
Das Enzymdesign ist ein vielversprechendes Forschungsfeld, das die Entwicklung hocheffizienter, umweltfreundlicher und hochselektiver Biokatalysatoren für eine Vielzahl chemischer Reaktionen ermöglicht. Das Forschungsteam wählte zwei anspruchsvolle Enzymdesign-Aufgaben aus, um die Fähigkeit von RFD4‑Proteina zur Konstruktion von aktiven Zentren zu validieren: die eines dimetallischen Enzyms und die einer Cystein-Ligase.
Zunächst wurde getestet, ob RFD4‑Proteina ein Triesterase-Enzym entwerfen kann, das Paraoxon hydrolysiert. Zuvor hatte das Team mit RFD3 sechs katalytische Reste um zwei Metall-Cofaktoren und das Paraoxon-Substrat herum konstruiert, was jedoch nur zu einer relativ geringen katalytischen Effizienz von maximal 4±3 M⁻¹s⁻¹ führte. In diesem Experiment wurde die Hypothese aufgestellt, dass die Hinzufügung von zwei weiteren katalytischen Resten die katalytische Effizienz steigern könnte.
Die Ergebnisse zeigten, dass von 1000 Designs, die mit RFD4‑Proteina für dieses achtrestantige künstliche Enzym generiert wurden, 15 (1,5 %) die Standards für RMSD gängiger Motive und Substratkonfidenz erfüllten; im Gegensatz dazu bestand keines der 1000 mit RFD3 erstellten Designs diese Kriterien.
Ein kleinerer RMSD-Wert bedeutet, dass das designte aktive Zentrum der idealen Theozym-Konformation näherkommt.
In nachfolgenden experimentellen Screenings wiesen 89 von 288 RFD4‑Proteina-Designs eine Aktivität auf, verteilt auf 25 von 47 Gerüst-Familien; hingegen zeigten alle 192 mit RFD3 entworfenen Designs keine Aktivität.
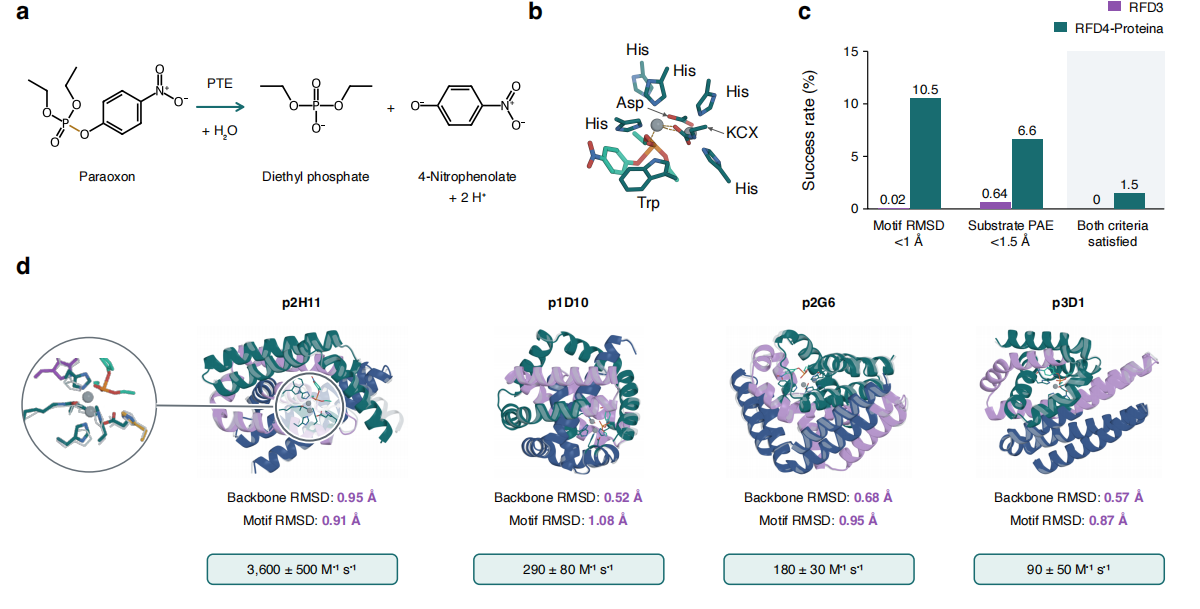
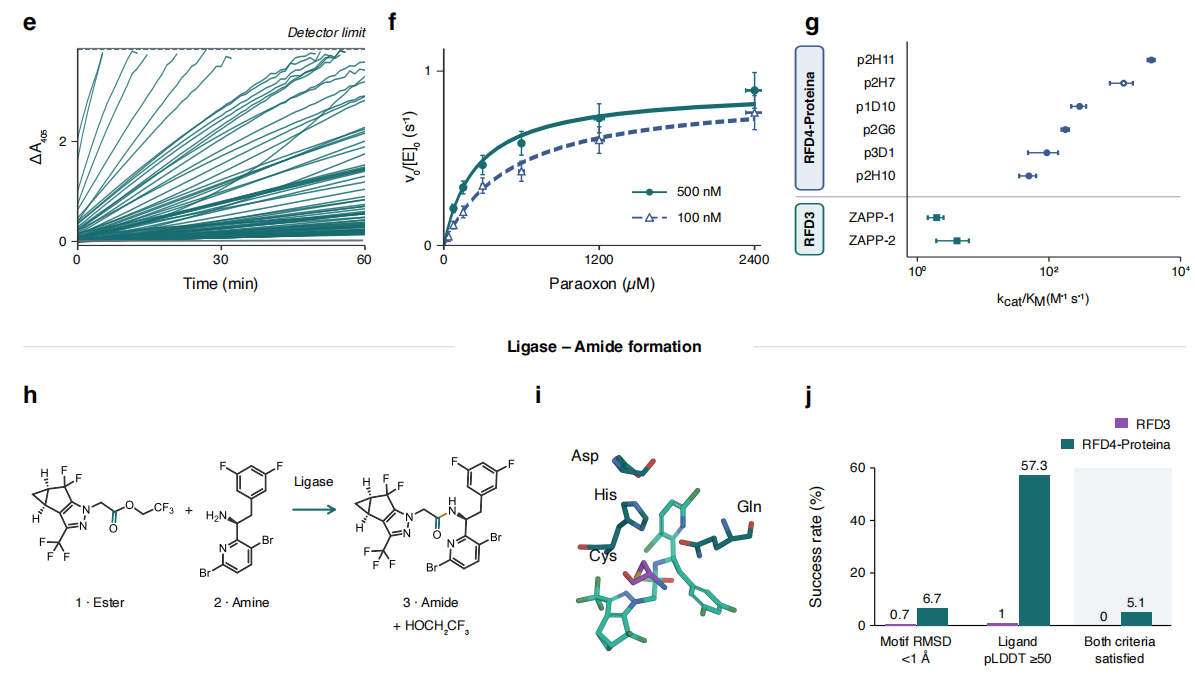
Anschließend wurden sechs Designs aus vier Gerüst-Familien charakterisiert. Das beste Design erreichte katalytische Effizienzen von kcat / KM = 3600 ± 500 M⁻¹s⁻¹ bzw. kcat = 0,9 s⁻¹, was einer Steigerung der Reaktionsgeschwindigkeit um den Faktor 1,5 × 10⁷ im Vergleich zur unkatalysierten Hydrolyse entspricht. Alle sechs identifizierten Designs wiesen eine 10- bis 1000-fach höhere katalytische Effizienz auf als das zuvor mit sechs Resten entworfene Triesterase-Künstliche-Enzym.
Das Forschungsteam untersuchte weiter, ob RFD4‑Proteina bindende Enzyme für die Biopharmazie designen kann. Als Testreaktion wurde ein Schritt in der Syntheseroute von Lenacapavir ausgewählt, bei dem ein aktivierter Ester mit einem sterisch gehinderten chiralen Amin zu einer Amidbindung kondensiert wird.
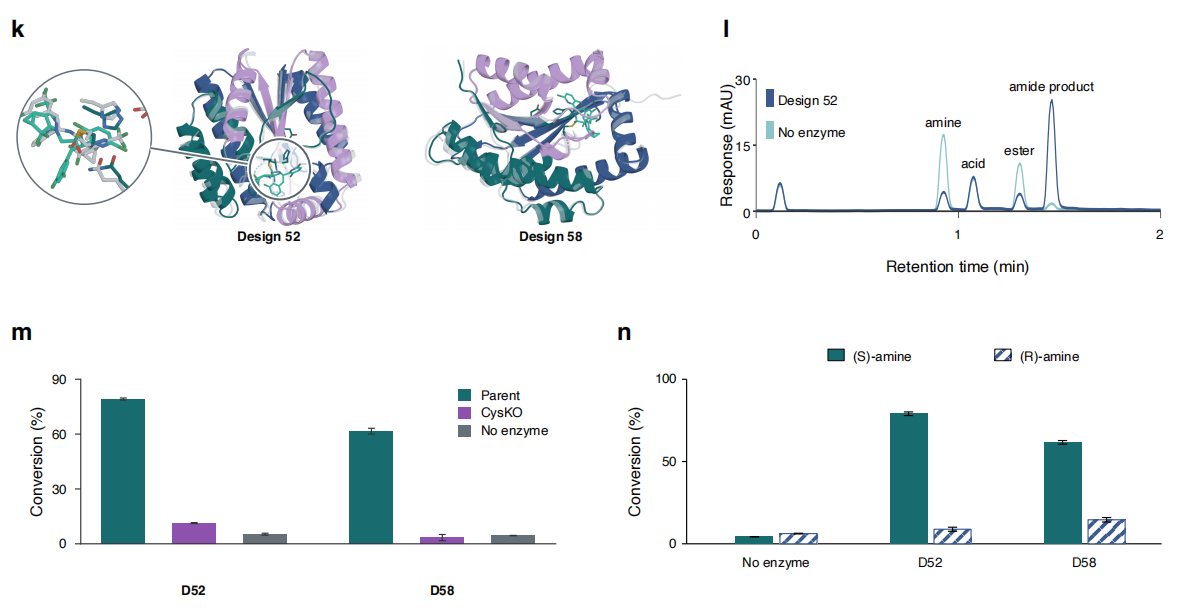
Die computergestützten Screening-Ergebnisse zeigten, dass die Berechnungsdurchlassrate von RFD4‑Proteina um mehrere Größenordnungen höher lag als die von RFD3. Von den Genen der 67 ausgewählten Designsequenzen, die für experimentelle Tests verwendet wurden, gelang es vier Designsequenzen, die Bildung der Amidbindung erfolgreich zu katalysieren, wobei der Anteil des gewünschten S-Amin-Produkts über dem Hintergrundwert lag; im Gegensatz dazu erbrachten alle 72 zuvor mit RFD3 entworfenen Designs keine gültigen Ergebnisse.
Die beiden besten Designs waren Nr. 52 und Nr. 58, die 79 % bzw. 61 % des S-konfigurierten Amins in das Amid umwandelten; die Umsatzraten für das R-konfigurierte Amin lagen lediglich bei 8,8 % bzw. 14,6 %, während die Kontrollgruppe ohne Enzym Umsatzraten von 4,3 % bzw. 6,2 % aufwies.
Fazit
Zusammenfassend lässt sich sagen, dass RFD4‑Proteina die physikalische Modellierung und das Deep Learning tiefgreifend integriert, indem es nicht mehr ausschließlich auf die statistische Verteilung natürlicher Proteine in der PDB-Datenbank zurückgreift, sondern zusätzlich synthetische Datensätze aus physikalischen Simulationen einbezieht und den Generierungsprozess durch ein differenzierbares Rosetta-Kraftfeld überwacht und lenkt. Es bricht die bisherige Fragmentierung durch zahlreiche spezialisierte Werkzeuge auf und nutzt ein Paradigma der Inferenz im latente Raum, um das Protein-Design von blindem Sampling und Generierung hin zu einem evaluierten, iterativ optimierten, eingeschränkten Suchmodus zu transformieren, was in Computer-Benchmarks die Erfolgsquoten und die Recheneffizienz bei komplexen Moleküldesigns erheblich steigert.
Natürlich ist das Modell nicht perfekt; die Inferenz-Scheduling-Parameter müssen oft durch kleine Vorversuche ermittelt und optimiert werden, und komplexe Aufgaben verursachen einen gewissen Rechenaufwand. Doch die Open-Source-Bereitstellung von Code und Gewichten bietet dem gesamten Feld einen neuen Ausgangspunkt. Sie zeigt uns, dass die enge Verknüpfung von KI-Generierung mit biophysikalischen Regeln die Grenzen des Protein-Designs erweitern kann, um Forschern dabei zu helfen, computergestützt entworfene Moleküle schneller in funktionale Bindungsproteine und völlig neue künstliche Enzyme im Labor zu überführen, was der Wirkstoffentwicklung und der synthetischen Biologie neue Möglichkeiten eröffnet.