Command Palette
Search for a command to run...
Online-Tutorial | Pro Aktivierung Nur Etwa 3B Aktiv, MiniCPM-V 4.7 Erreicht Auf Endgeräten Eine Dekodiergeschwindigkeit Von 13+ Tokens/s
Wenn Sprachmodelle KI das Lesen und Ausdrücken beigebracht haben, erweitern multimodale Modelle die Art und Weise, wie sie die Welt wahrnimmt, noch weiter. Von der Erkennung von Objekten in Bildern über das Auslesen von Daten aus Diagrammen bis hin zum Verstehen kontinuierlicher Ereignisse in Videos muss das Modell nicht mehr nur Text verarbeiten, sondern Kombinationen aus verschiedenen Informationsformen und diese in Inhalte umwandeln, die es reasoning-basiert beantworten kann.
MiniCPM-V 4.7, vorgestellt von ModelBest und der OpenBMB-Community, ist genau ein multimodales Vision-Sprachmodell für Aufgaben zum visuellen Verständnis. Es verwendet eine 35B-A3B-Mixture-of-Experts-(MoE)-Architektur mit einer Gesamtparameterzahl von 35B, aktiviert aber pro Token nur etwa 3B Parameter. Damit bleiben die Fähigkeiten eines größeren Modells erhalten, während der Rechenaufwand bei der Inferenz effektiv kontrolliert wird.
Beim visuellen Verständnis unterstützt MiniCPM-V 4.7 das Verständnis einzelner Bilder, mehrerer Bilder und von Videos und kann unterschiedliche Arten visueller Eingaben verarbeiten. Das Modell führt die visuelle Positionskodierung Canvas M-RoPE und eine effiziente visuelle Kompressionstechnik ein, die dem Modell helfen, räumliche Beziehungen und Detailinformationen in Bildern besser zu erfassen. Bei komplexen visuellen Inhalten kann es nicht nur Objekte im Bild erkennen, sondern Bildinformationen auch im Kontext verstehen und entsprechende Frage-Antwort- und Analyseaufgaben erledigen.
Noch interessanter ist, dass ein Modell mit einer Gesamtparameterzahl von 35B nicht unbedingt auf großen Servern laufen muss. MiniCPM-V 4.7 wurde speziell für die Inferenz auf Endgeräten optimiert: Durch Techniken wie Lookahead Expert Scheduling (LES) wird die Effizienz der Expertenaufrufe im MoE-Modell verbessert, sodass ohne Einbußen bei der Modellleistung eine flüssige Inferenz auf Endgeräten erreicht wird; in Kombination mit feingranularer schichtweiser Quantisierung, DSpark-Speculative-Sampling und weiteren Techniken wird der Betriebsaufwand weiter gesenkt. In der offiziellen Demonstration kann das Modell sogar auf einem iPhone 17 Pro Max mit etwa 3 GB Arbeitsspeicher eine Dekodierungsgeschwindigkeit von 13+ tokens/s erreichen. Das heißt, multimodale Modelle müssen nicht unbedingt in der Cloud bleiben; auch mit dem Smartphone lässt sich die Fähigkeit zum visuellen Verständnis erleben.
HyperAI bietet jetzt „MiniCPM-V 4.7: Multimodales Vision-Sprachmodell (35B-A3B MoE)“ an. Erleben Sie mit niedriger Einstiegshürde, wie das Modell Bilder und andere visuelle Eingaben versteht, und erfahren Sie weiter, wie die Mixture-of-Experts-Architektur durch Experten-Scheduling und Inferenzoptimierung ein Gleichgewicht zwischen Modellgröße, Rechenaufwand und tatsächlicher Betriebseffizienz erreicht.
Online ausführen:
Weitere Online-Tutorials:
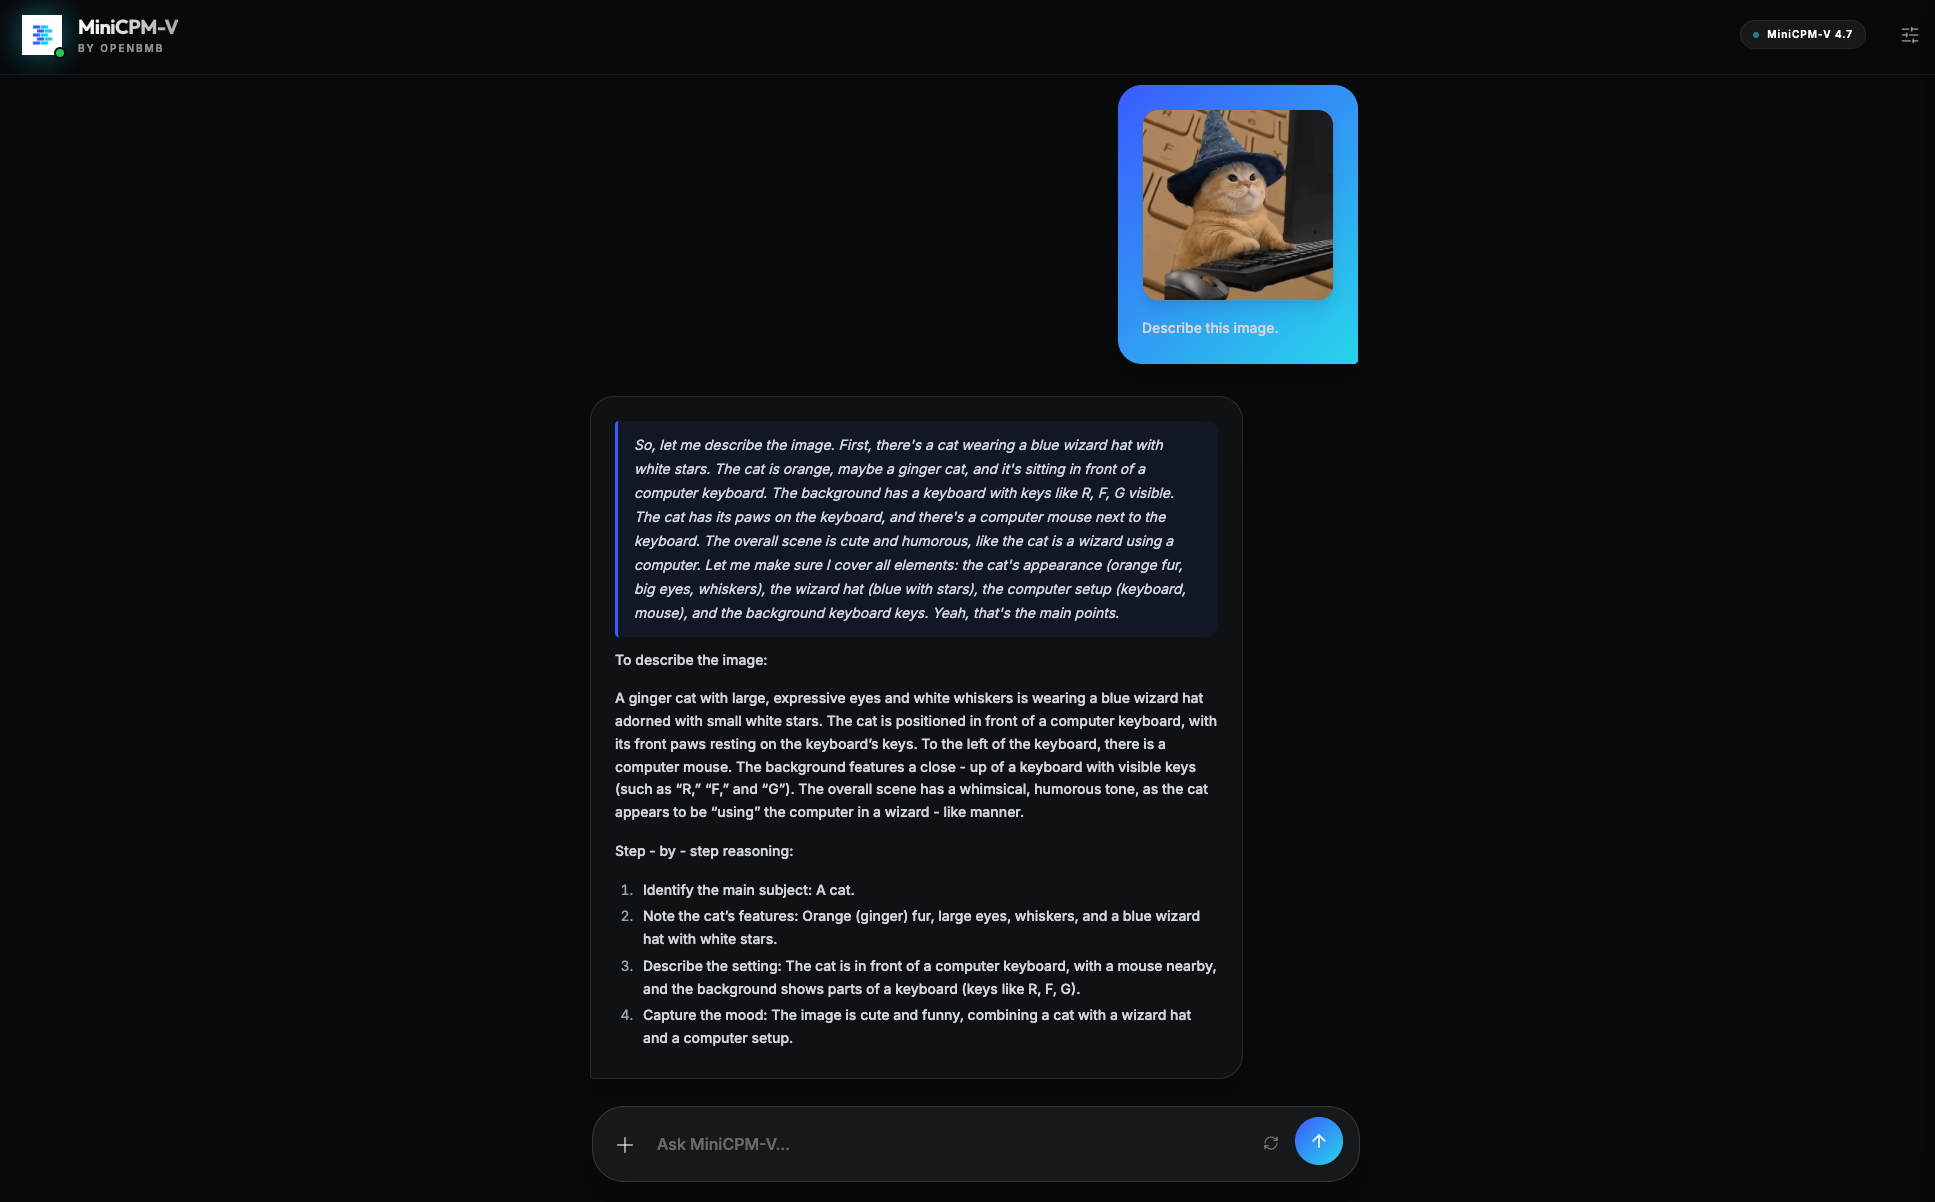
Demo ausführen
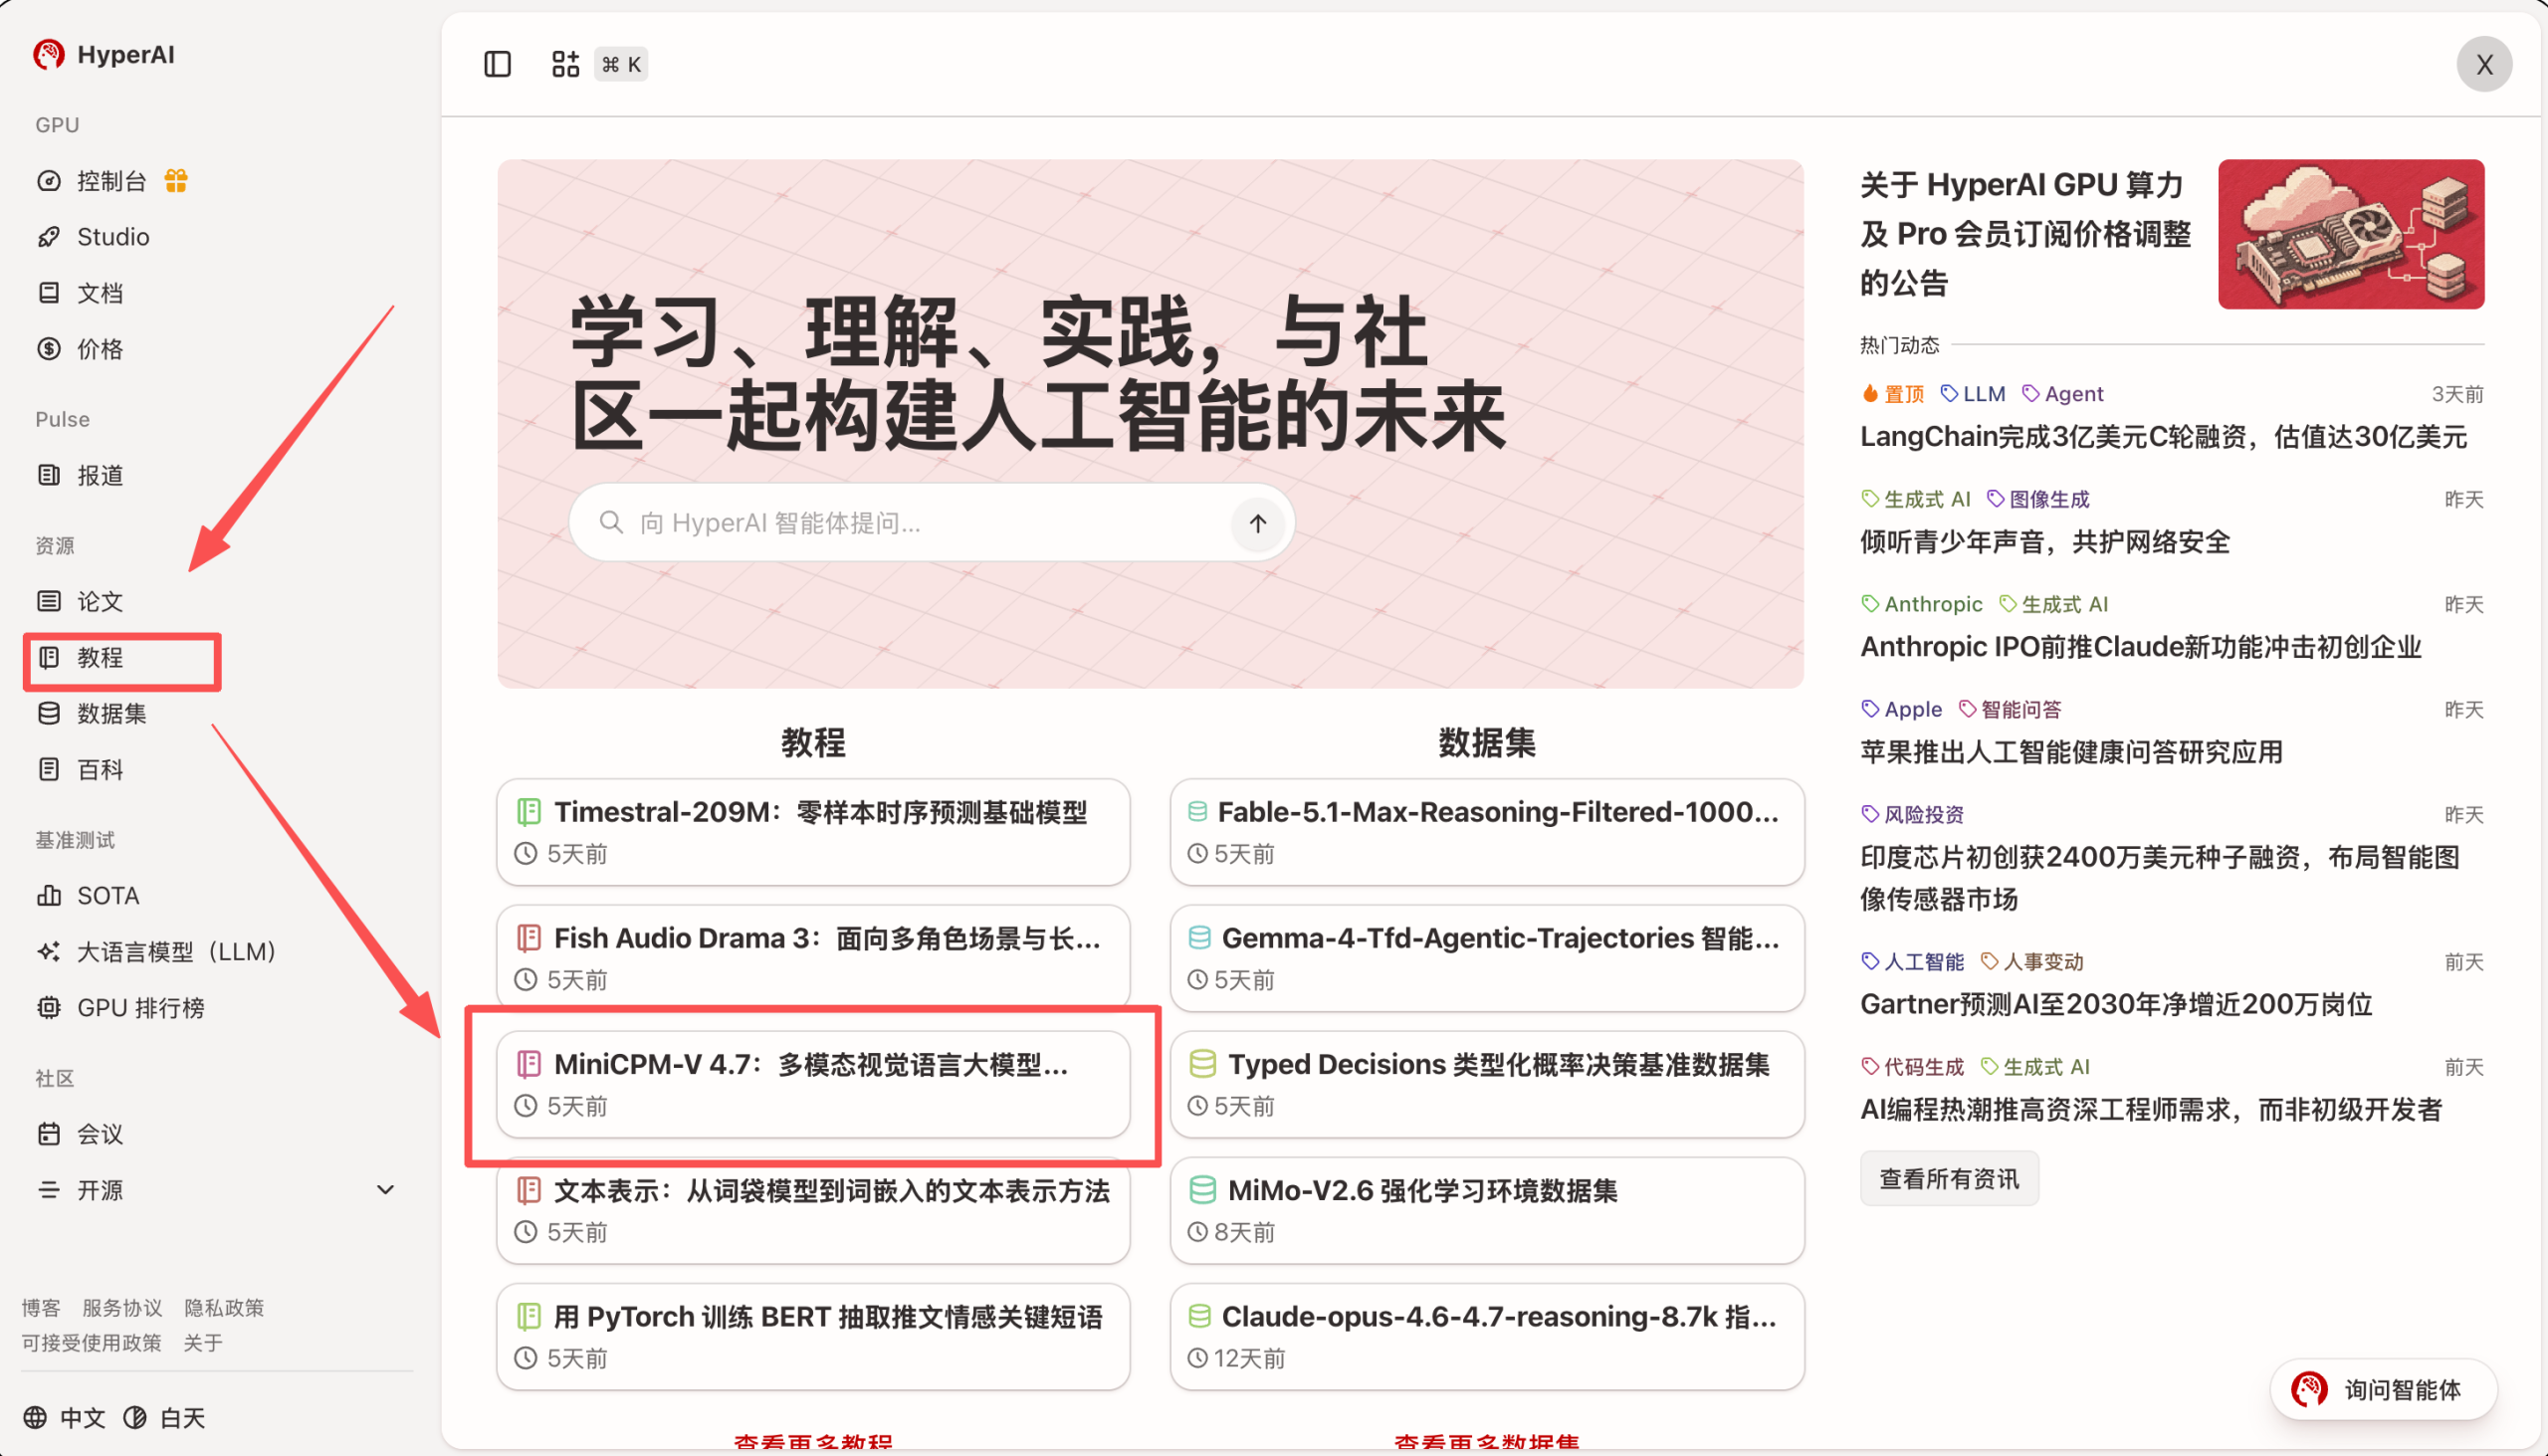
- Rufen Sie die Startseite von hyper.ai auf, wählen Sie die Seite „Tutorials“ oder klicken Sie auf „Weitere Tutorials anzeigen“, wählen Sie „MiniCPM-V 4.7: Multimodales Vision-Sprachmodell (35B-A3B MoE)“ und klicken Sie auf „Dieses Tutorial ausführen“.
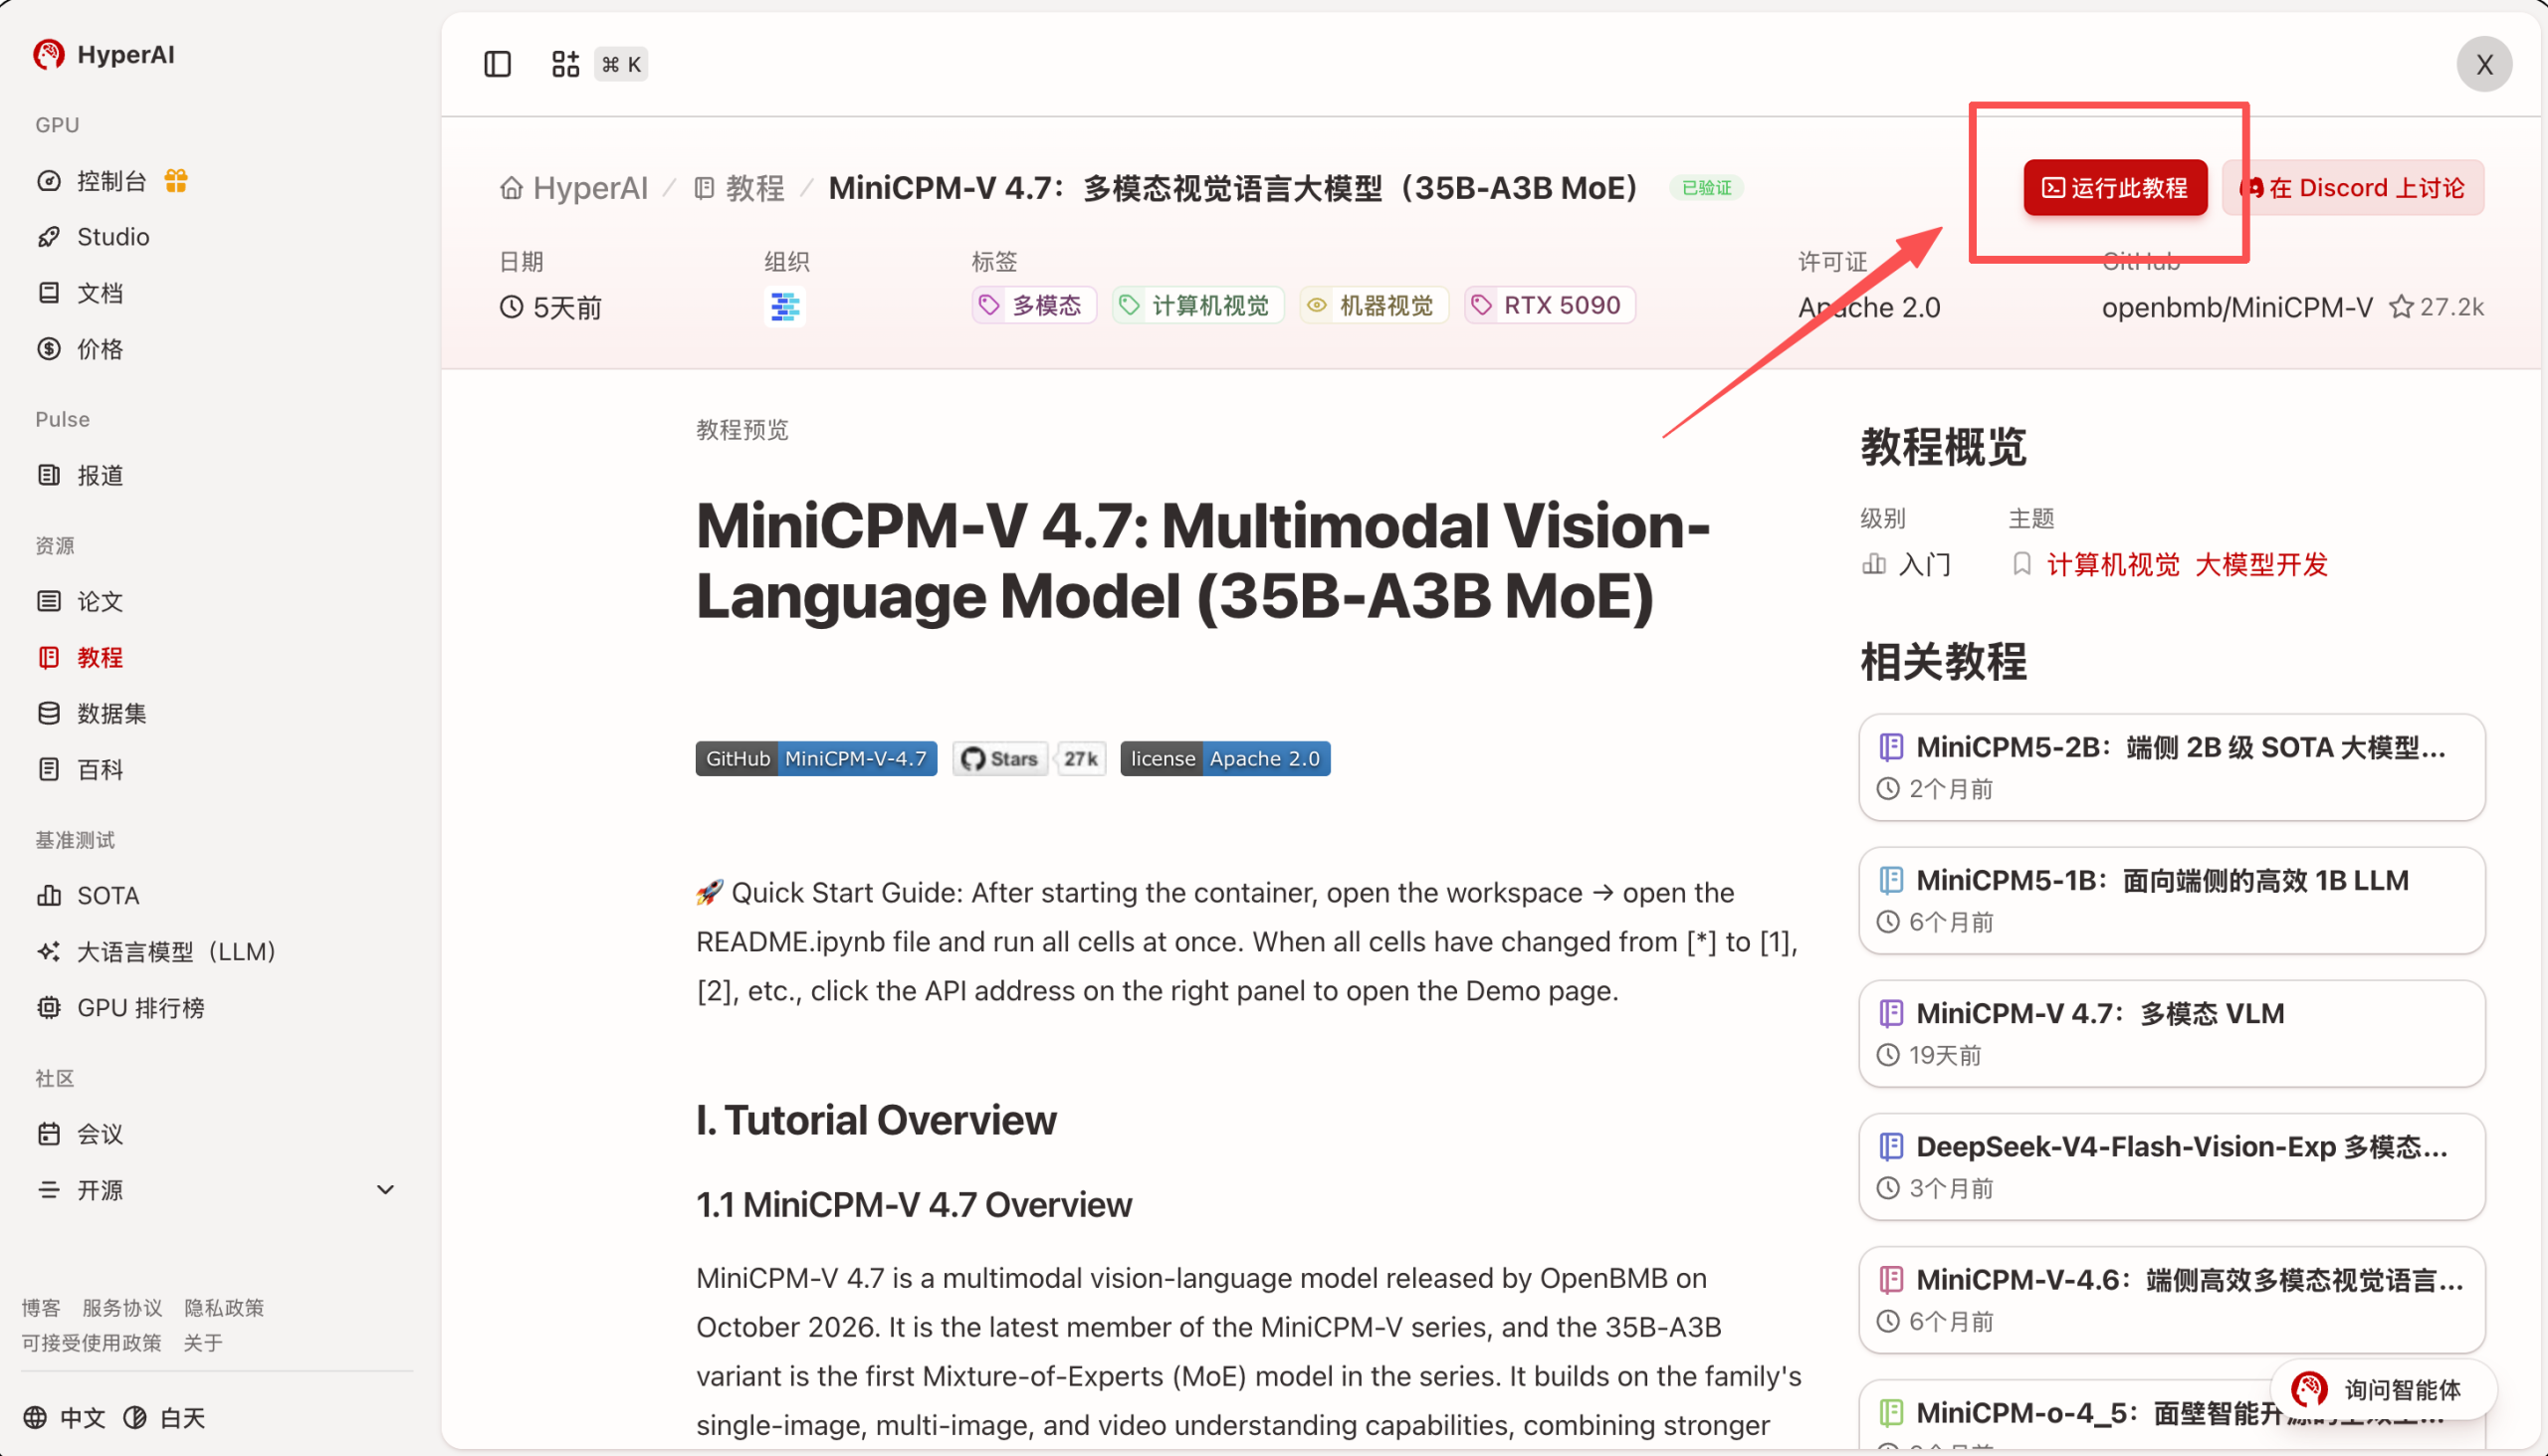
- Nach dem Weiterleiten klicken Sie oben rechts auf „Clone“, um das Tutorial in Ihren eigenen Container zu klonen.
Hinweis: Oben rechts auf der Seite kann die Sprache gewechselt werden; derzeit werden Chinesisch und Englisch angeboten. In diesem Tutorial werden die Schritte beispielhaft auf Englisch gezeigt.
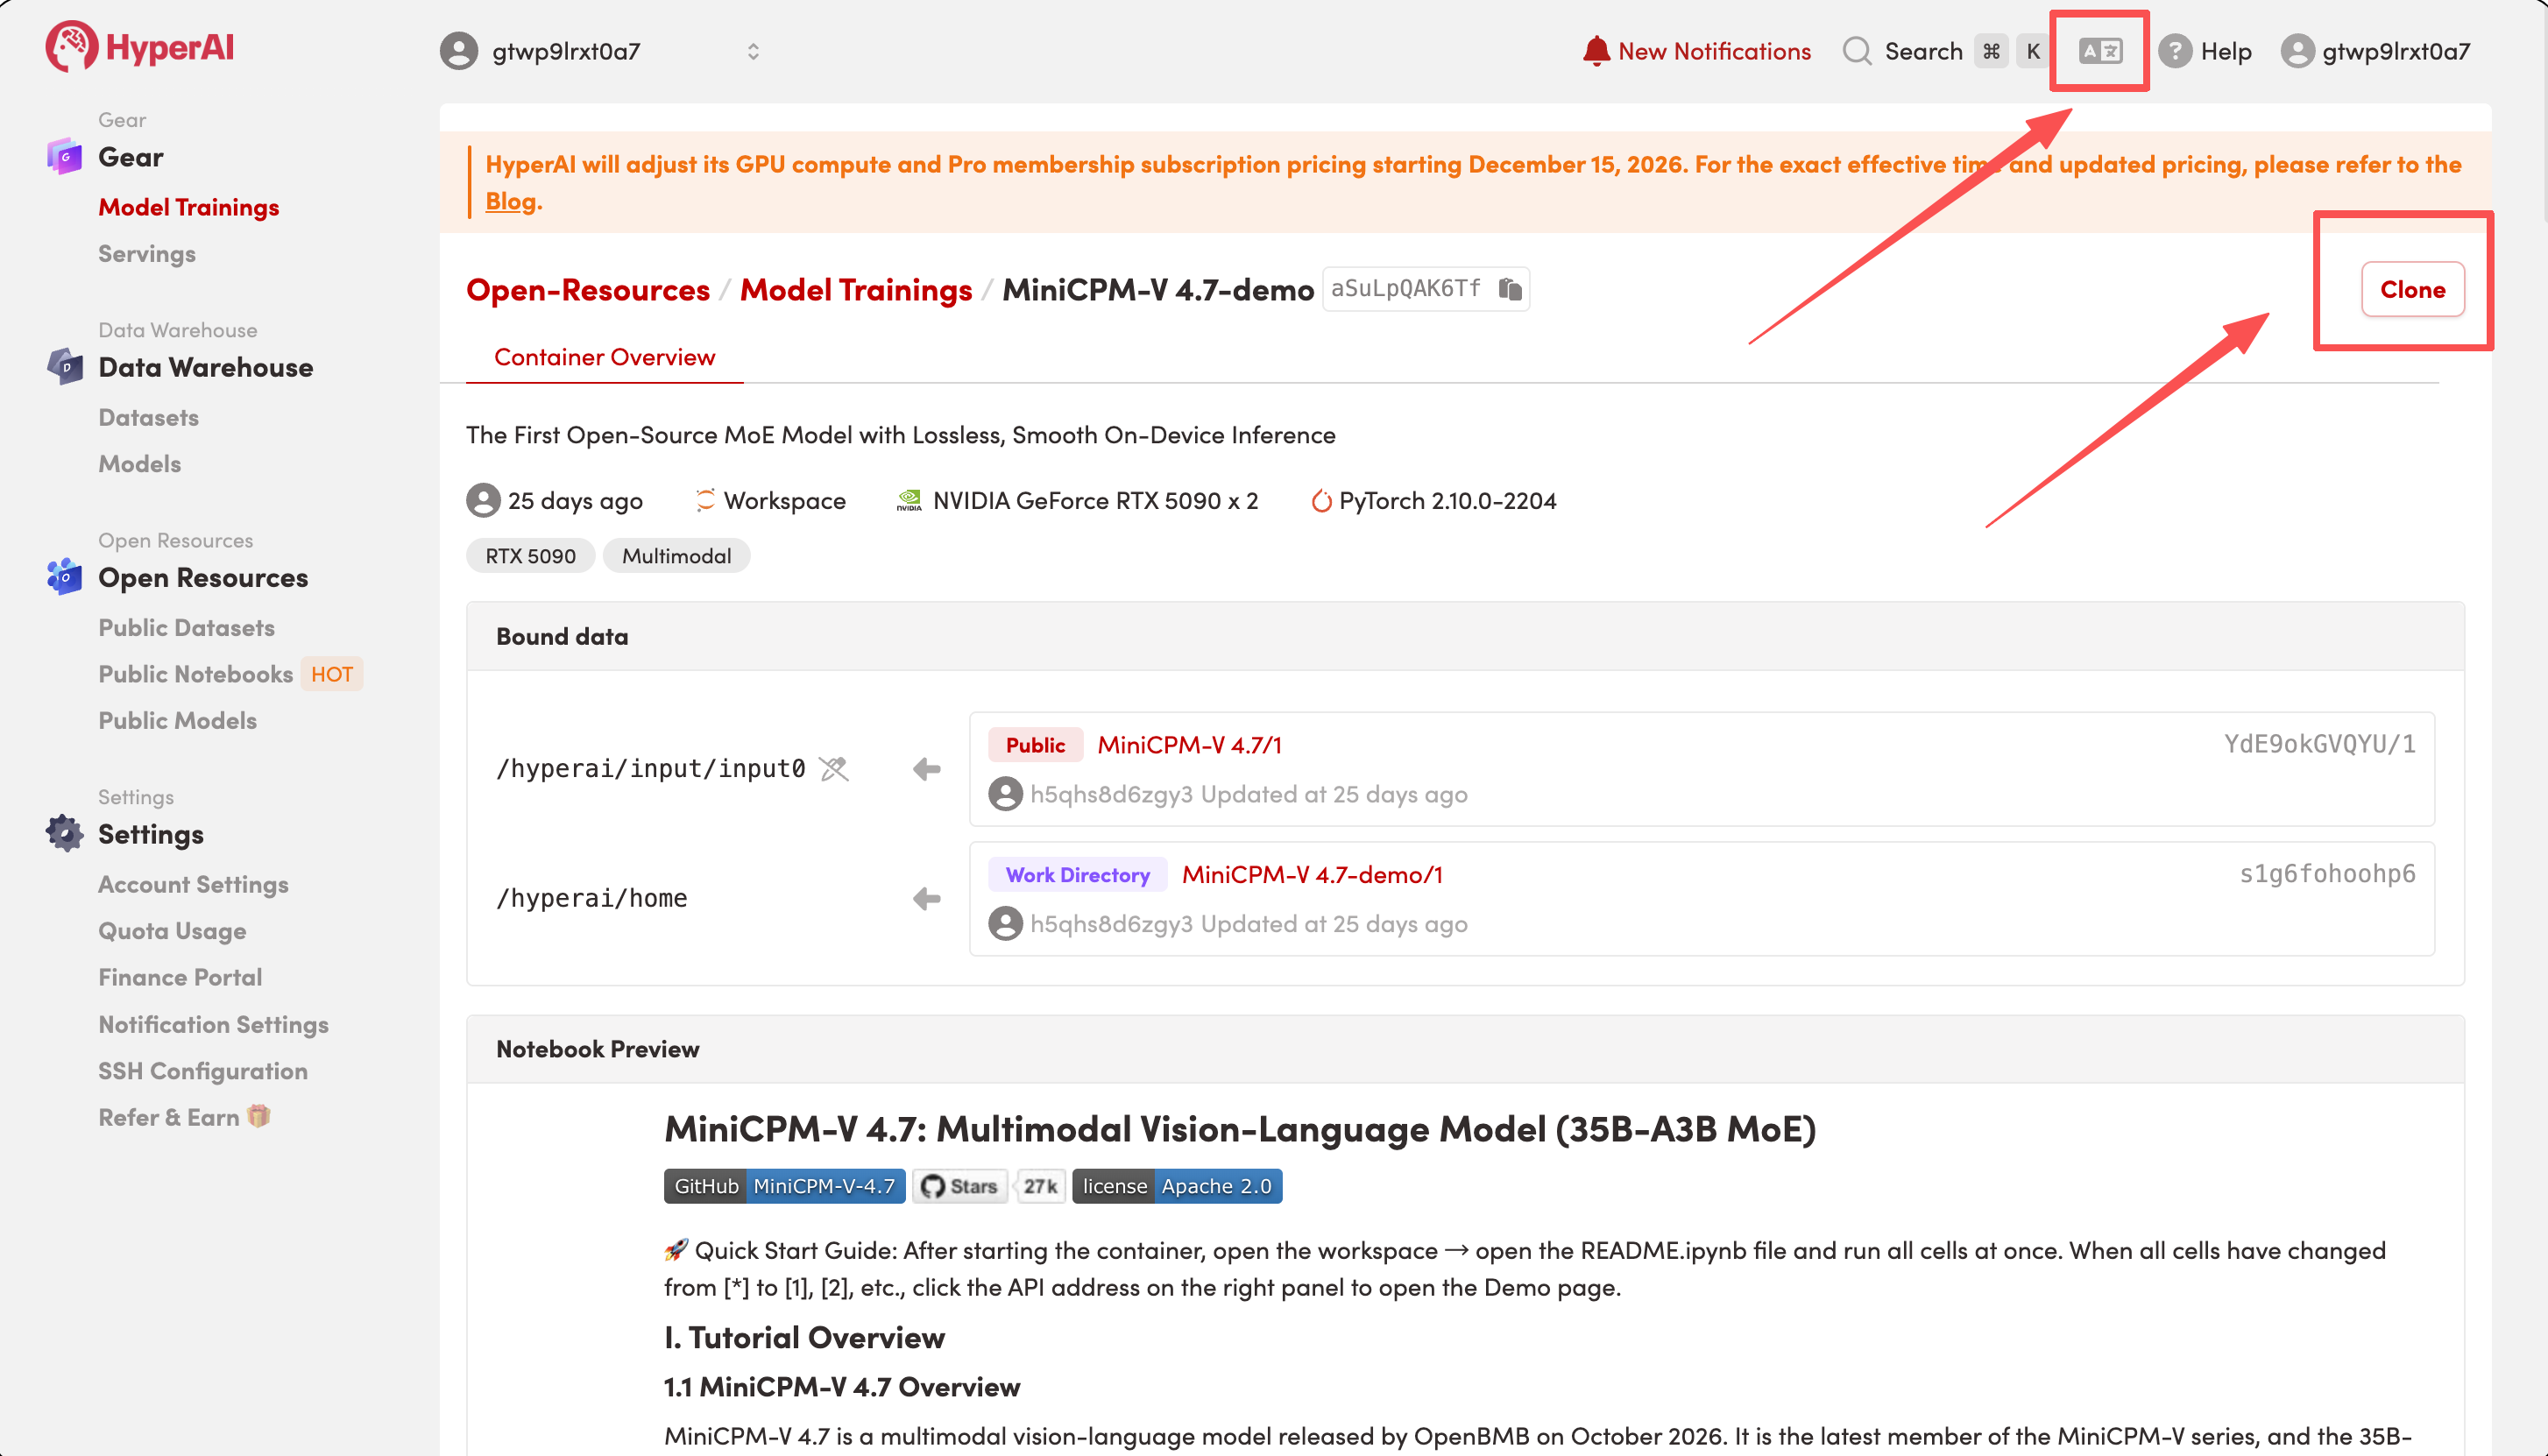
- Wählen Sie „2 x NVIDIA GeForce RTX 5090 (32 GB)“ sowie das entsprechende Image und klicken Sie auf „Continue job execution (Weiter ausführen)“.
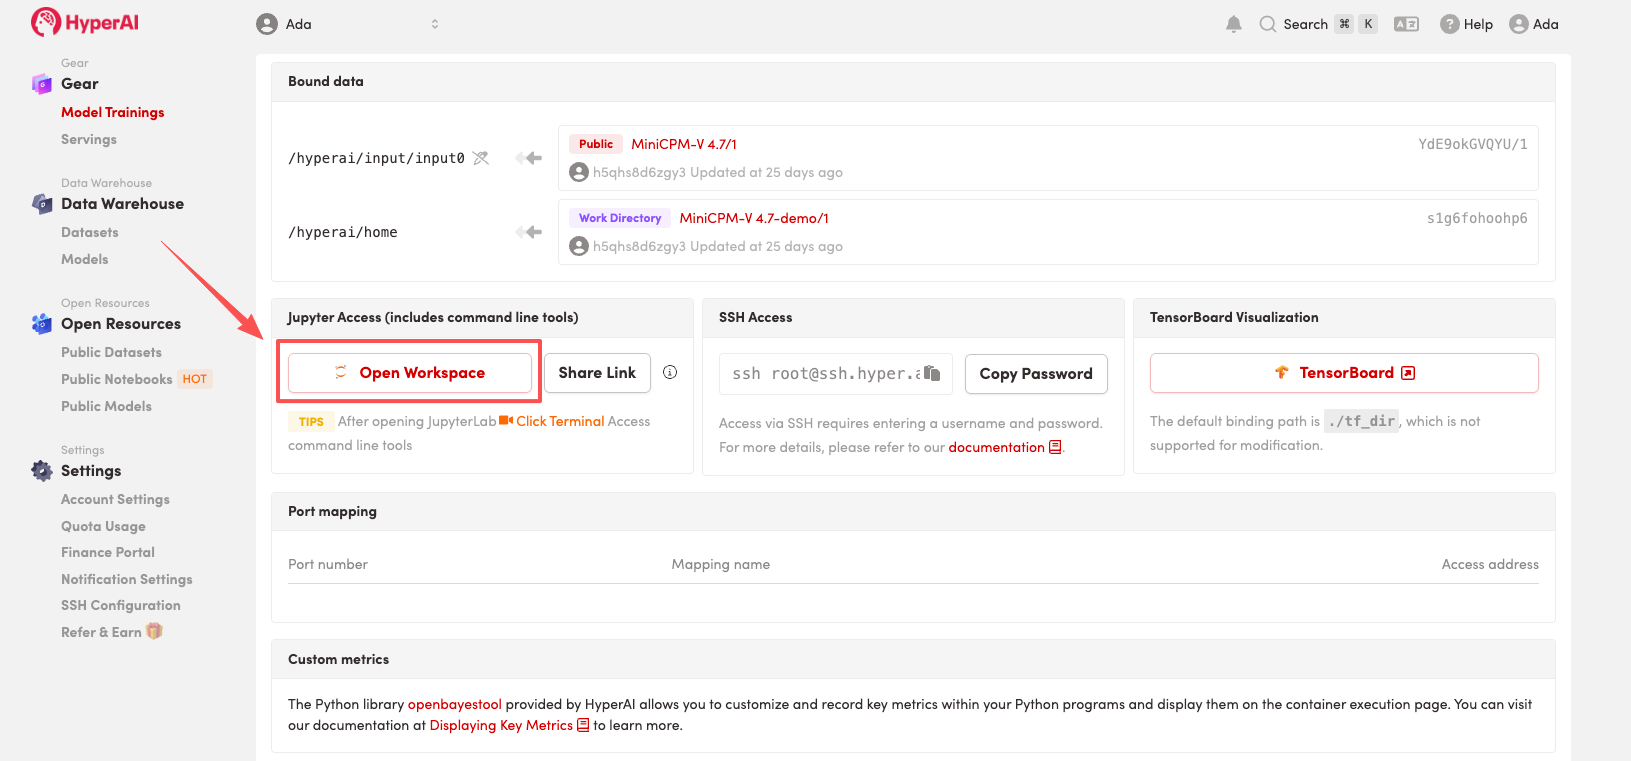
- Warten Sie, bis Ressourcen zugewiesen sind. Wenn der Status „Running (Wird ausgeführt)“ lautet, klicken Sie auf „Open Workspace“, um den Jupyter Workspace zu öffnen.
Ergebnispräsentation
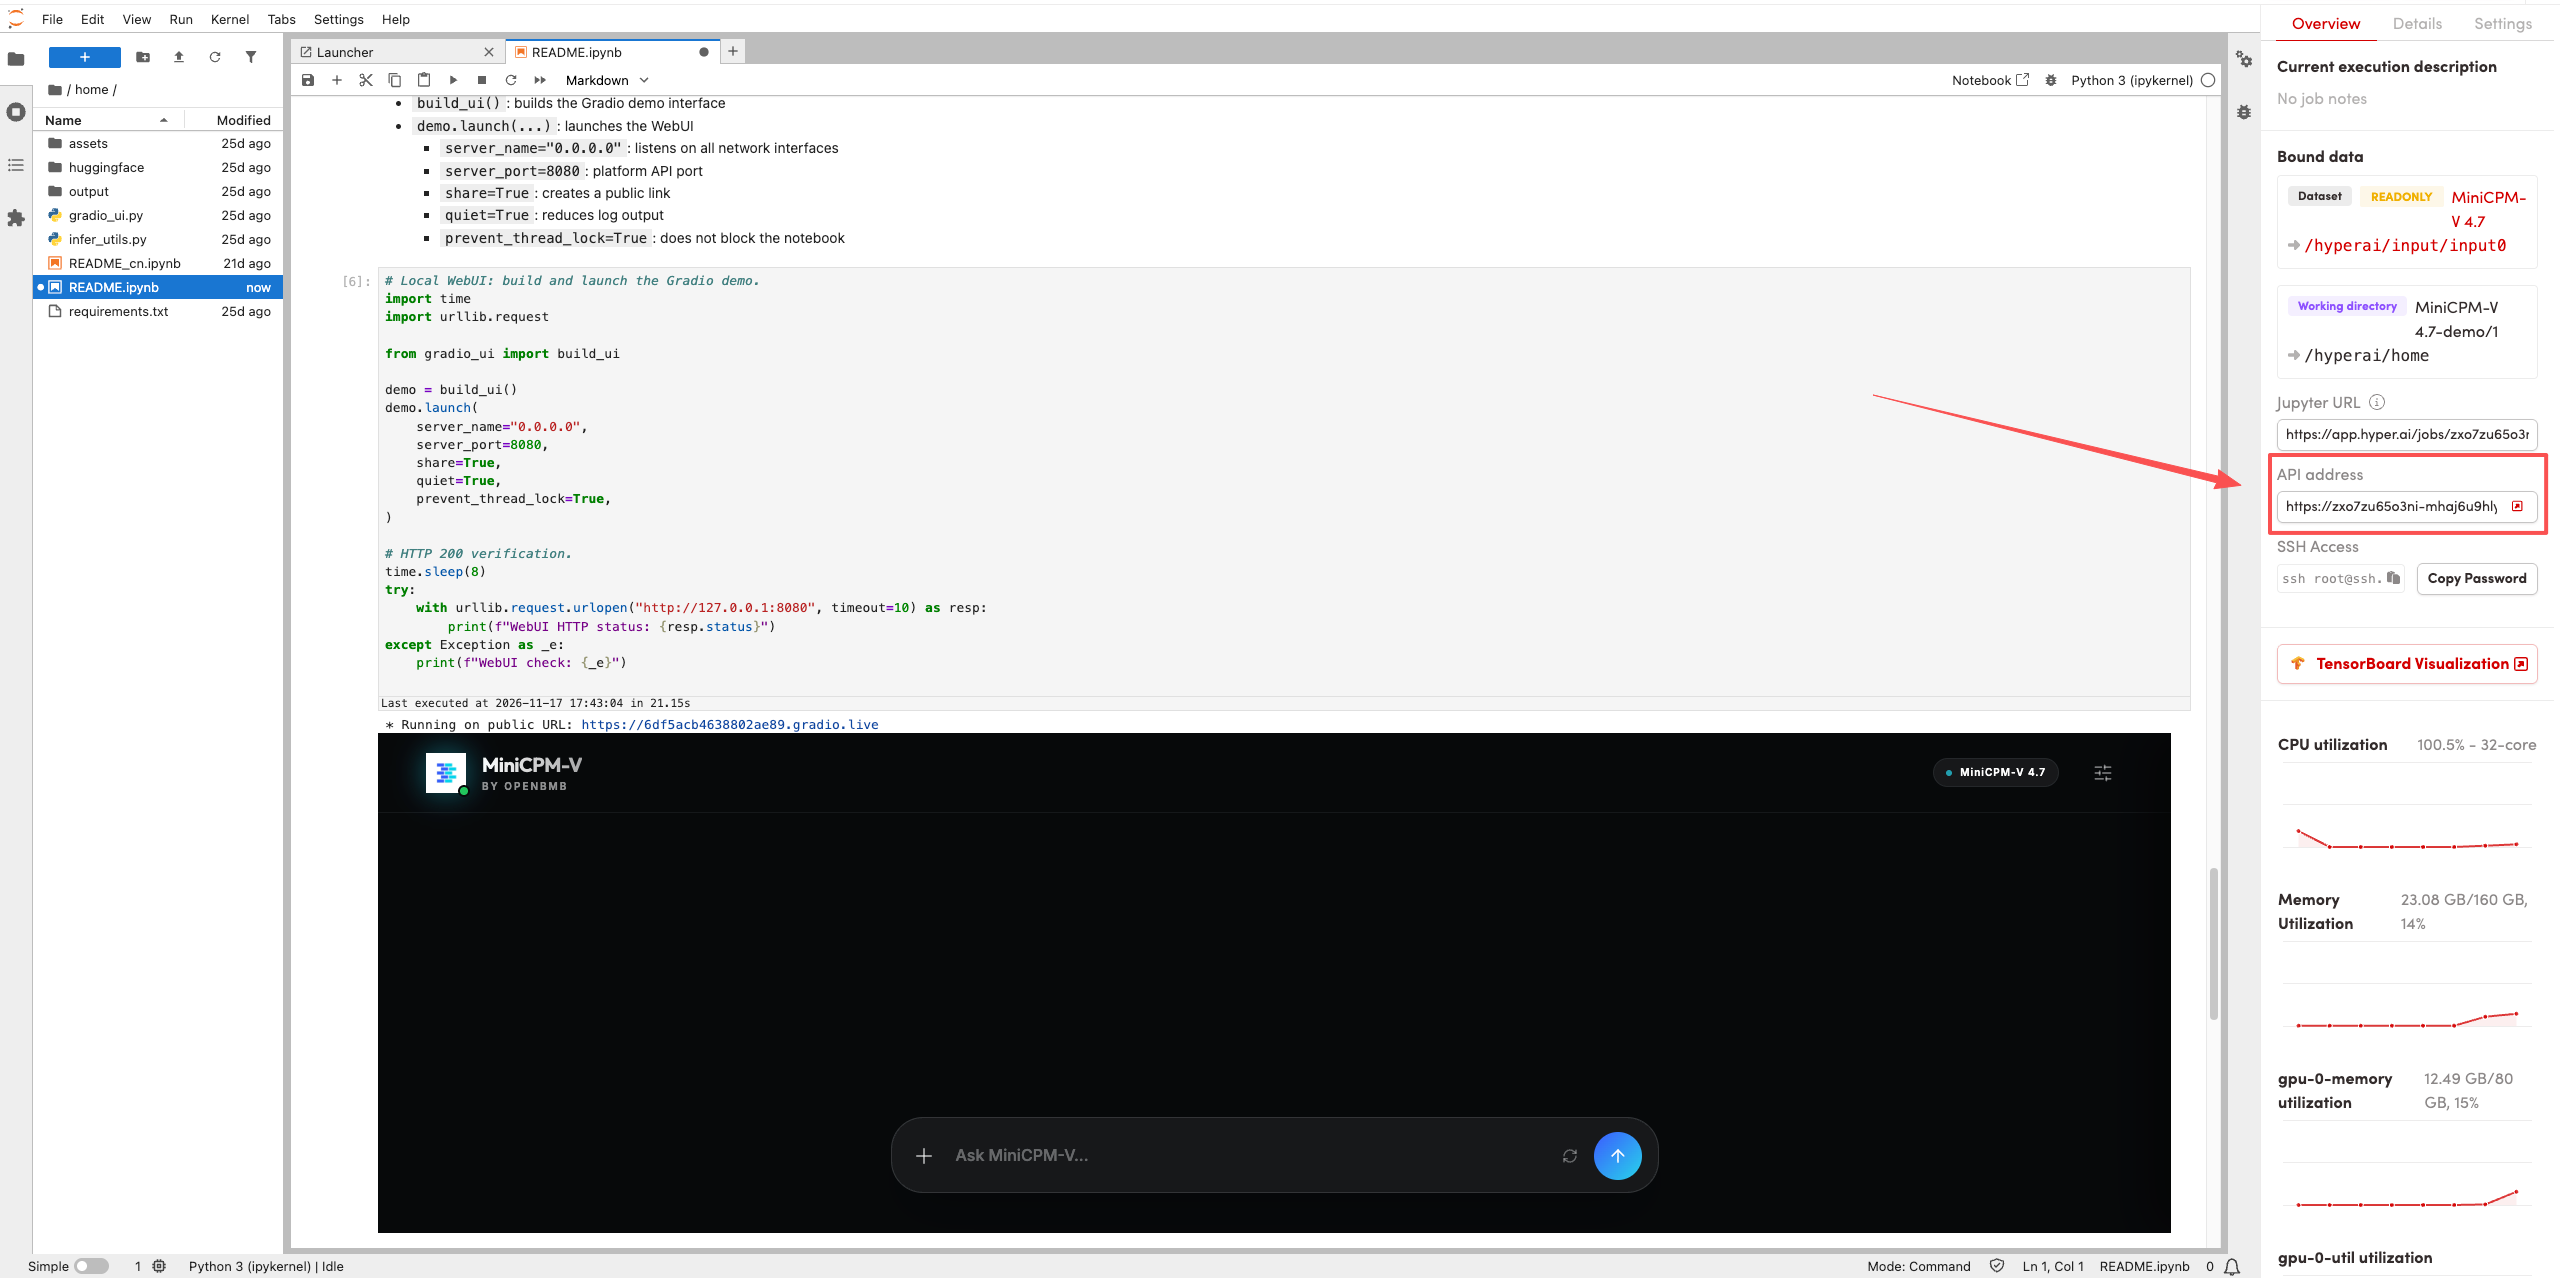
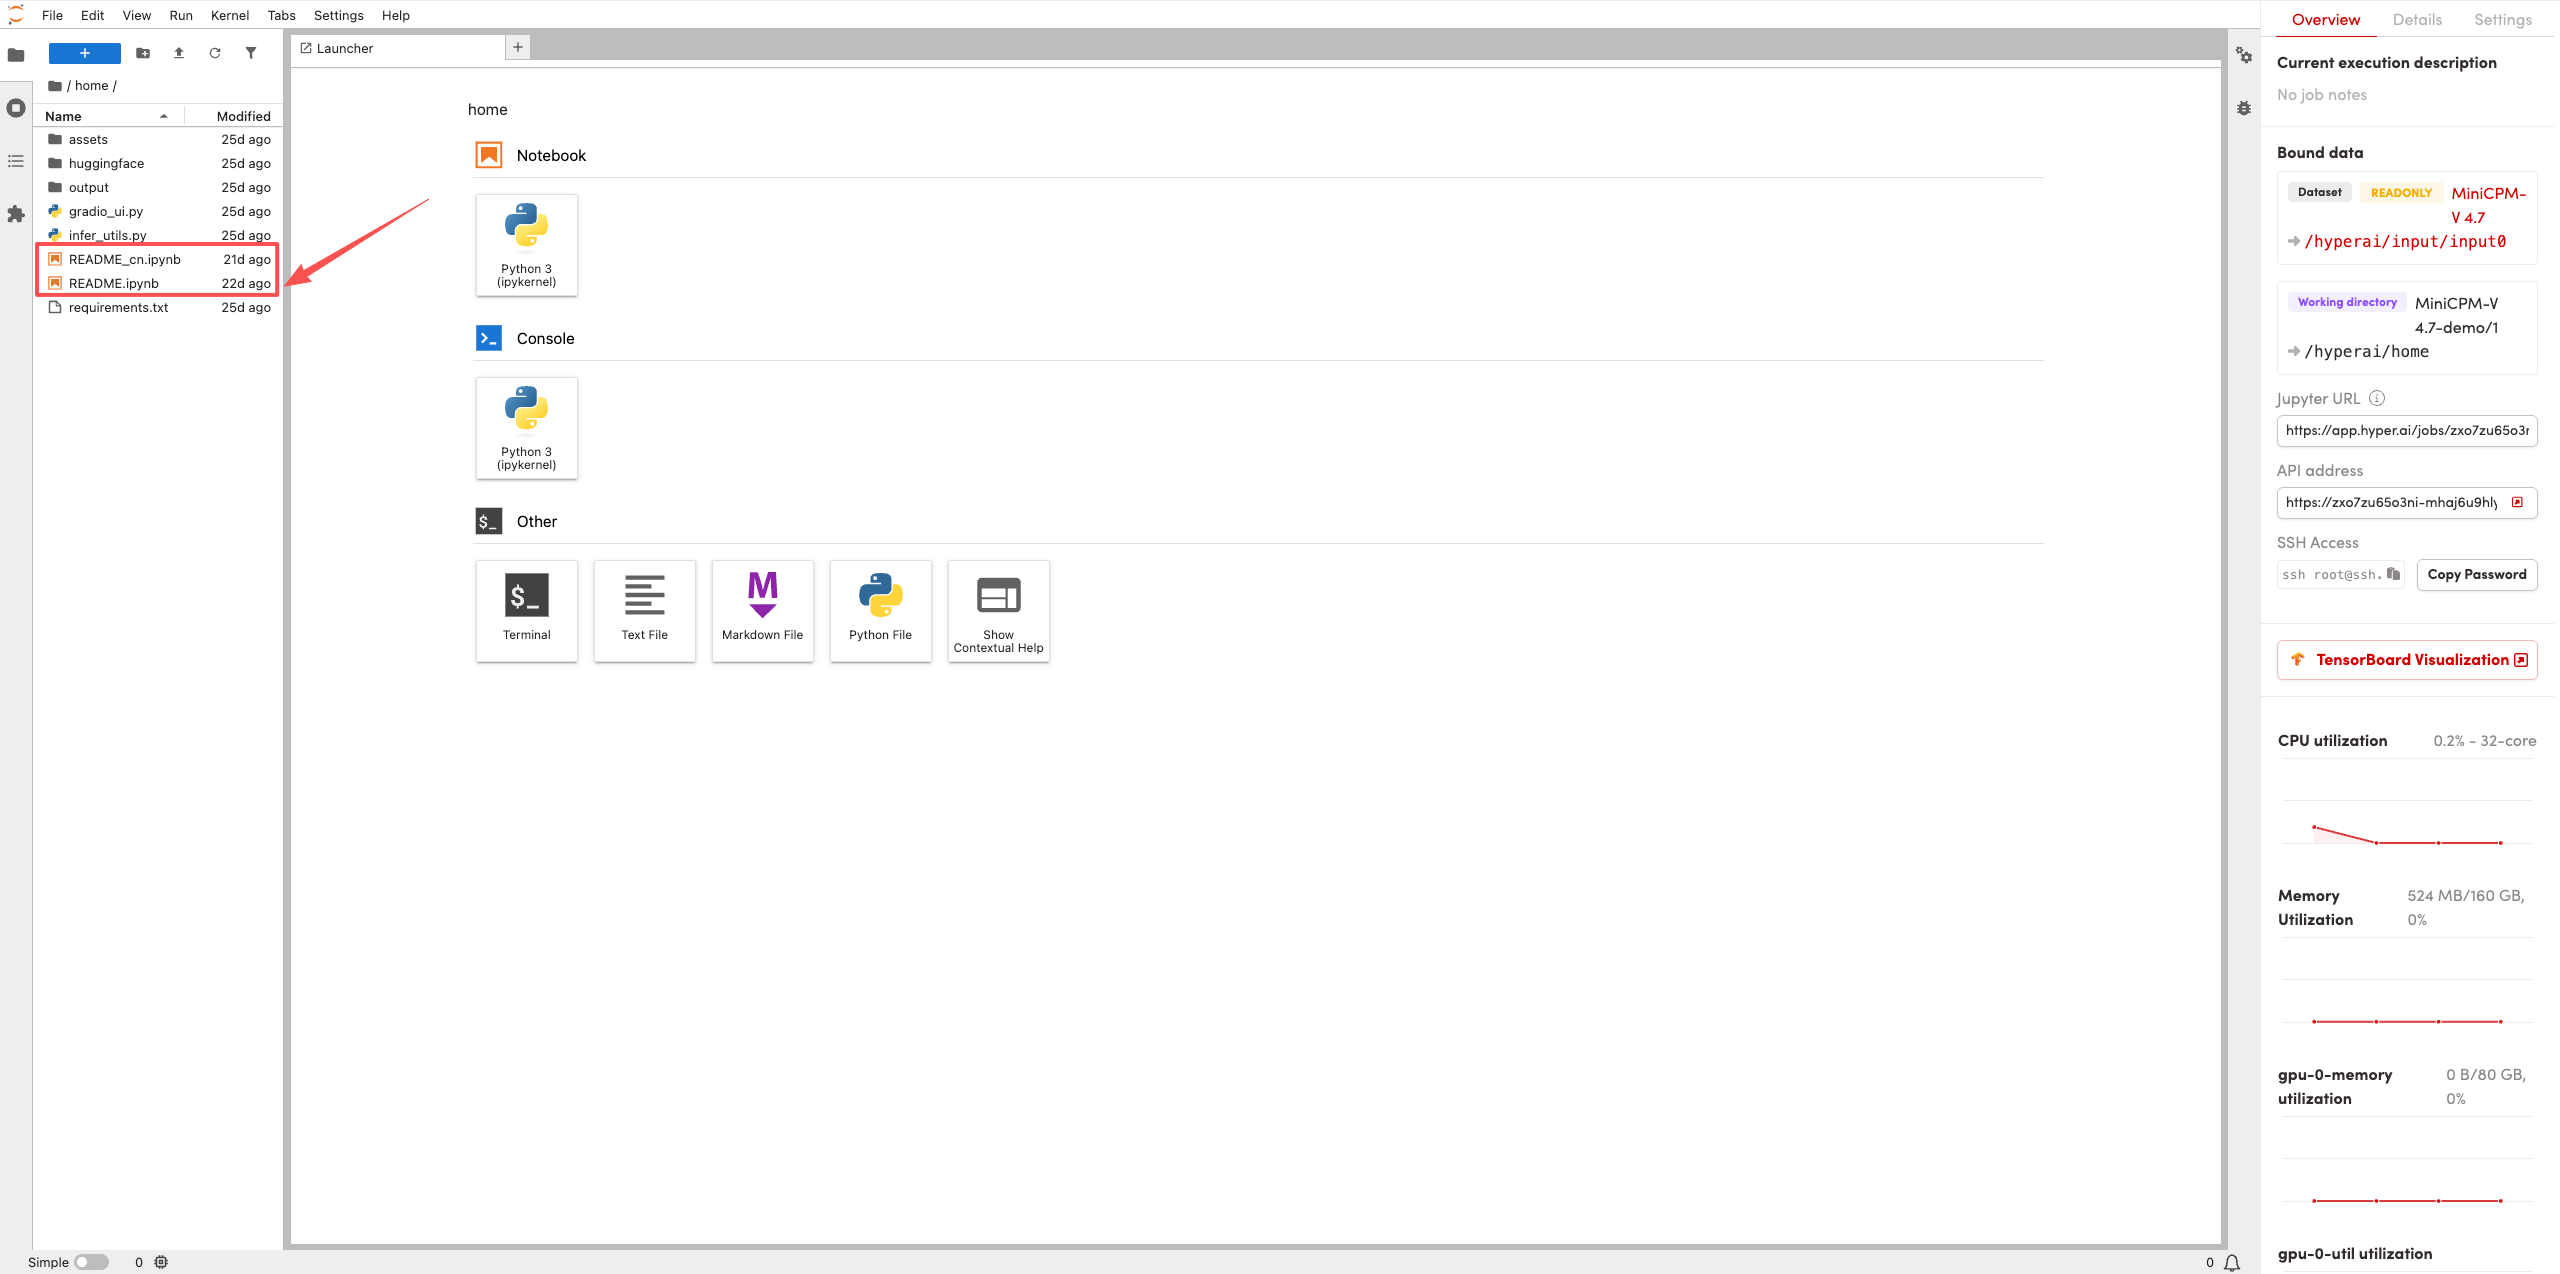
- Nach dem Weiterleiten klicken Sie links auf die README-Datei und anschließend oben auf Run (Ausführen).
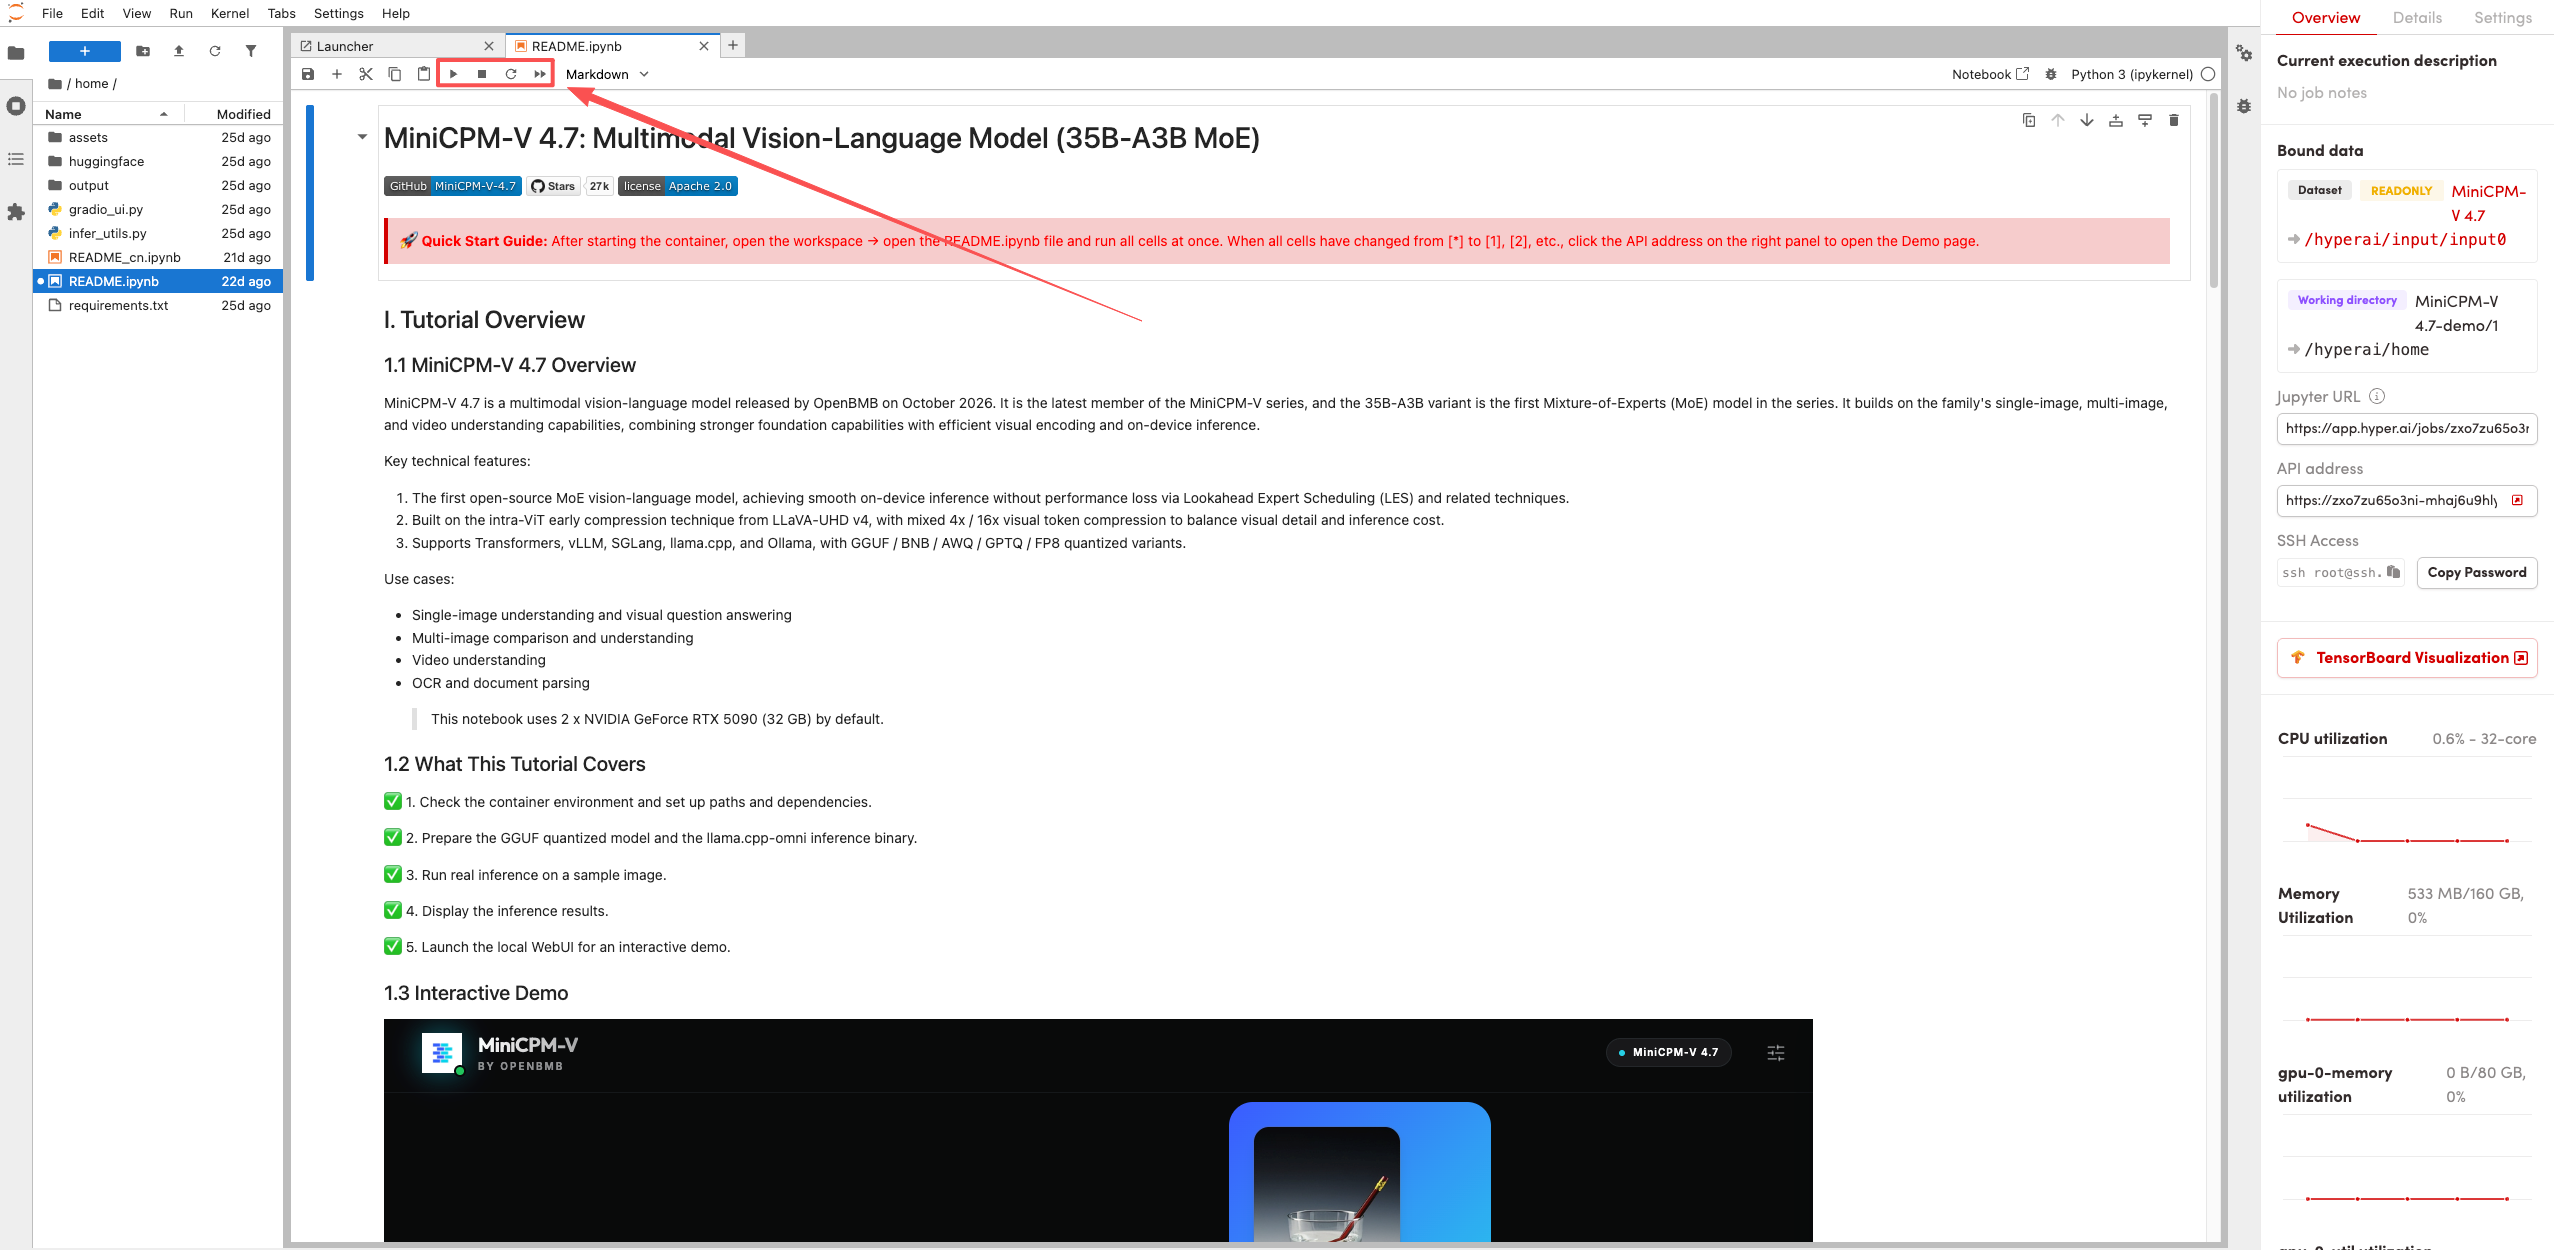
- Nach Abschluss der Ausführung klicken Sie rechts auf die API-Adresse, um auf die Demo zuzugreifen.