Command Palette
Search for a command to run...
دليل تعليمي عبر الإنترنت丨يتم تنشيط حوالي 3B فقط في كل مرة، وتصل سرعة فك التشفير على الجهاز الطرفي لـ MiniCPM-V 4.7 إلى 13+ tokens/s
إذا كانت نماذج اللغة قد علّمت الذكاء الاصطناعي القراءة والتعبير، فإن النماذج متعددة الوسائط توسّع كذلك الطريقة التي يدرك بها العالم. من التعرف على الأجسام في الصور، وقراءة البيانات في المخططات، إلى فهم الأحداث المتتابعة في الفيديو، لم يعد على النموذج التعامل مع النصوص فقط، بل مع مزيج من أشكال معلومات مختلفة، وتحويلها إلى محتوى قابل للاستدلال والإجابة.
MiniCPM-V 4.7، الذي أطلقته ModelBest (面壁智能) ومجتمع OpenBMB، هو نموذج لغوي بصري متعدد الوسائط موجّه لمهام الفهم البصري. يعتمد بنية خبراء مختلط (MoE) من نوع 35B-A3B، بإجمالي عدد معاملات يبلغ 35B، لكنه يفعّل نحو 3B معامل فقط لكل Token، ما يحافظ على قدرات نموذج كبير نسبيًا مع التحكم الفعّال في تكلفة الحساب أثناء الاستدلال.
في مجال الفهم البصري، يدعم MiniCPM-V 4.7 فهم الصورة الواحدة والصور المتعددة والفيديو، ويمكنه معالجة أنواع مختلفة من المدخلات البصرية. يقدّم النموذج ترميز الموضع البصري Canvas M-RoPE وتقنية ضغط بصري عالية الكفاءة، ما يساعد النموذج على التقاط العلاقات المكانية والتفاصيل في الصور بشكل أفضل. أمام المحتوى البصري المعقد، لا يقتصر الأمر على التعرف على الكائنات في المشهد، بل يمكنه أيضًا فهم معلومات الصورة بالاستعانة بالسياق، وإنجاز مهام الأسئلة والأجوبة والتحليل المقابلة.
الأكثر إثارة للاهتمام أن نموذجًا بإجمالي 35B معاملًا كهذا لا يلزم بالضرورة أن يعتمد على خوادم كبيرة للتشغيل. تم تحسين MiniCPM-V 4.7 خصيصًا للاستدلال على الأجهزة الطرفية: عبر تقنيات مثل جدولة الخبراء الاستباقية (Lookahead Expert Scheduling، LES)، يحسّن كفاءة استدعاء الخبراء في نماذج MoE، ويحقق استدلالًا سلسًا على الأجهزة الطرفية دون التضحية بأداء النموذج؛ وبالاقتران بتكميم هرمي دقيق وتقنية أخذ العينات التخمينية DSpark، يخفض تكلفة التشغيل بشكل أكبر. في العرض الرسمي، يستطيع النموذج حتى على iPhone 17 Pro Max تحقيق سرعة فك ترميز تبلغ 13+ tokens/s بذاكرة تبلغ نحو 3GB. أي أن النماذج متعددة الوسائط لا يلزم بالضرورة أن تبقى في السحابة، فبإمكانك تجربة قدرات الفهم البصري عبر الهاتف.
HyperAI أتاح الآن «MiniCPM-V 4.7: نموذج لغوي بصري متعدد الوسائط كبير (35B-A3B MoE)»، لتجربة النموذج بعتبة منخفضة وفهم كيفية معالجته للصور وغيرها من المدخلات البصرية، والتعرف أكثر على كيفية تحقيق بنية الخبراء المختلط توازنًا بين حجم النموذج وتكلفة الحساب وكفاءة التشغيل الفعلية عبر جدولة الخبراء وتحسين الاستدلال.
تشغيل عبر الإنترنت:
المزيد من الدروس عبر الإنترنت:
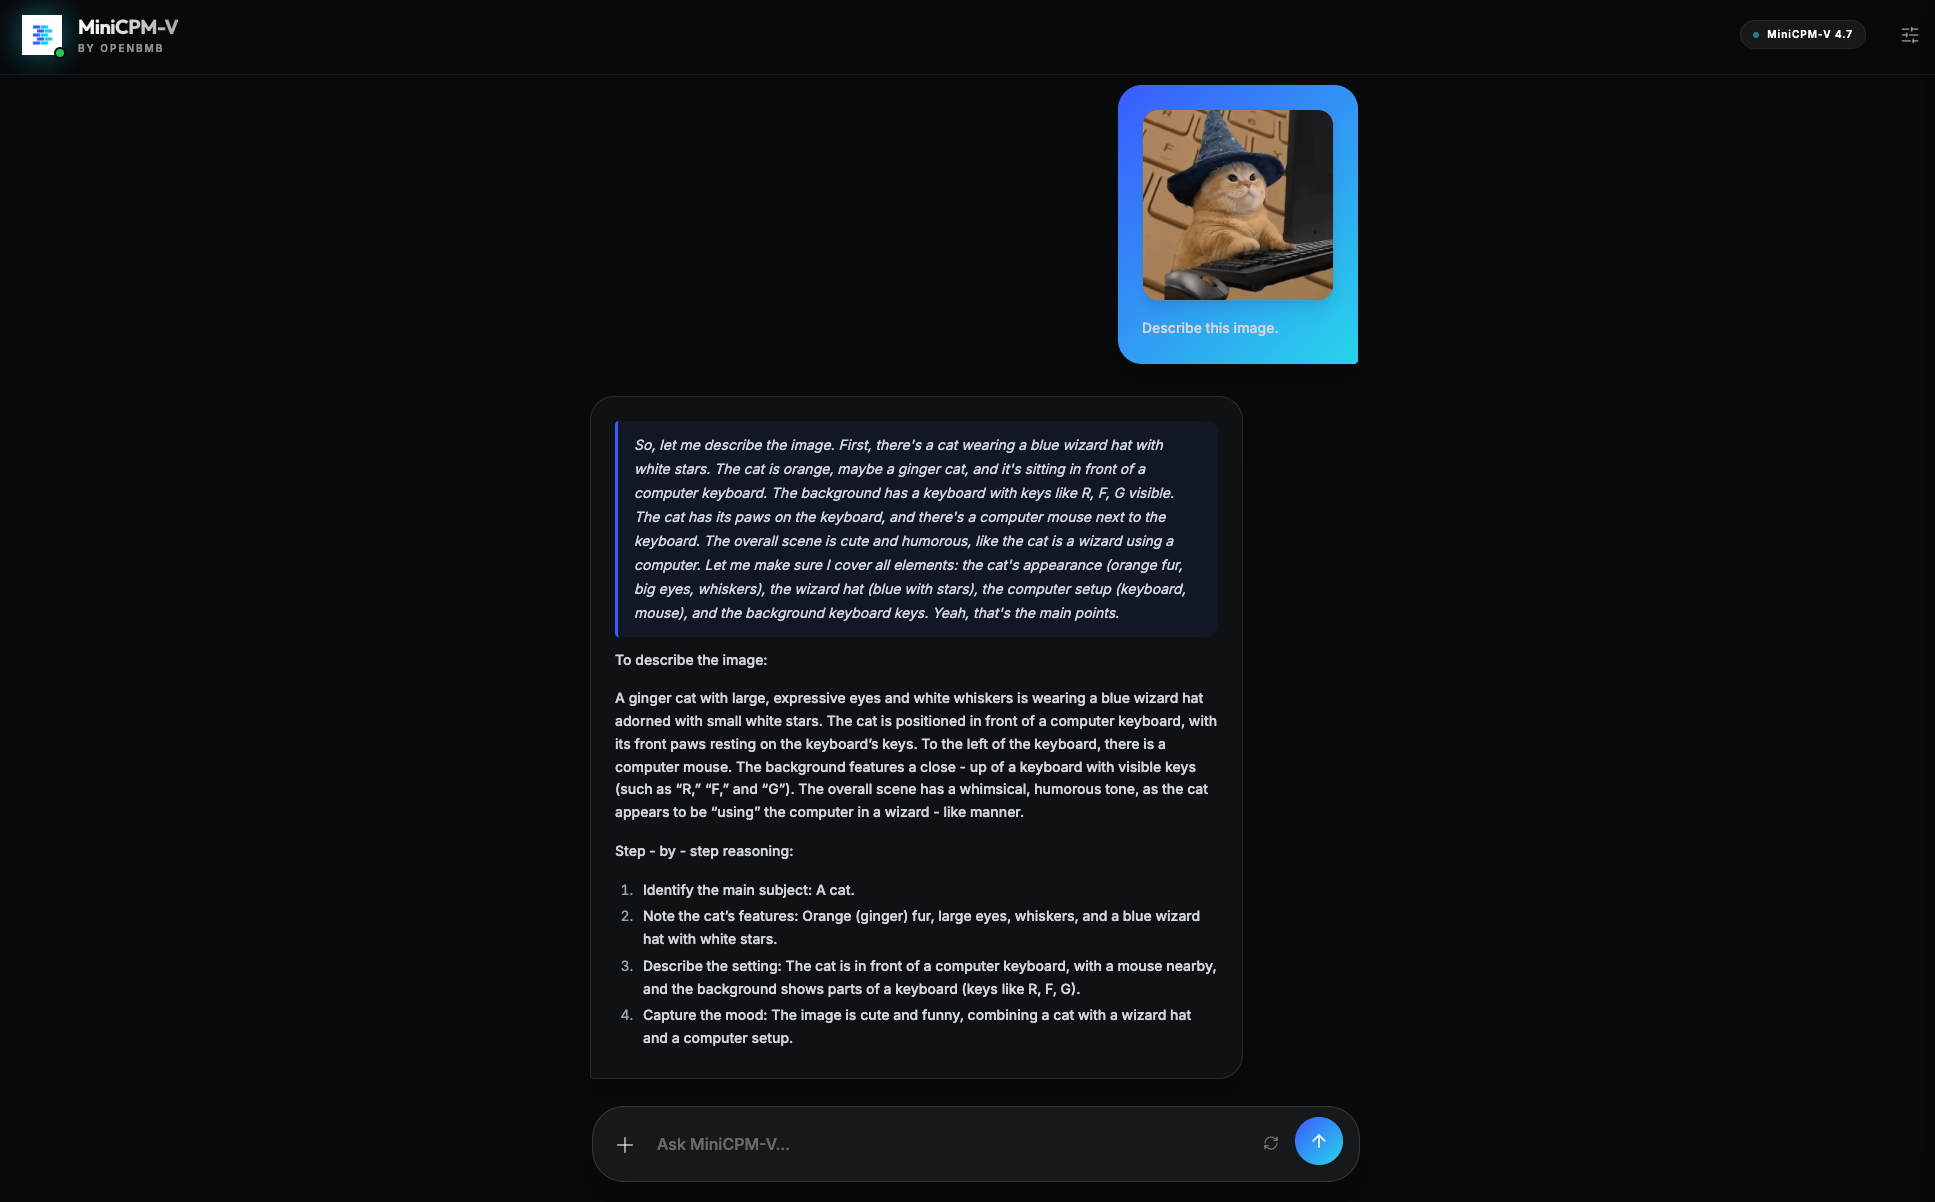
تشغيل العرض التجريبي
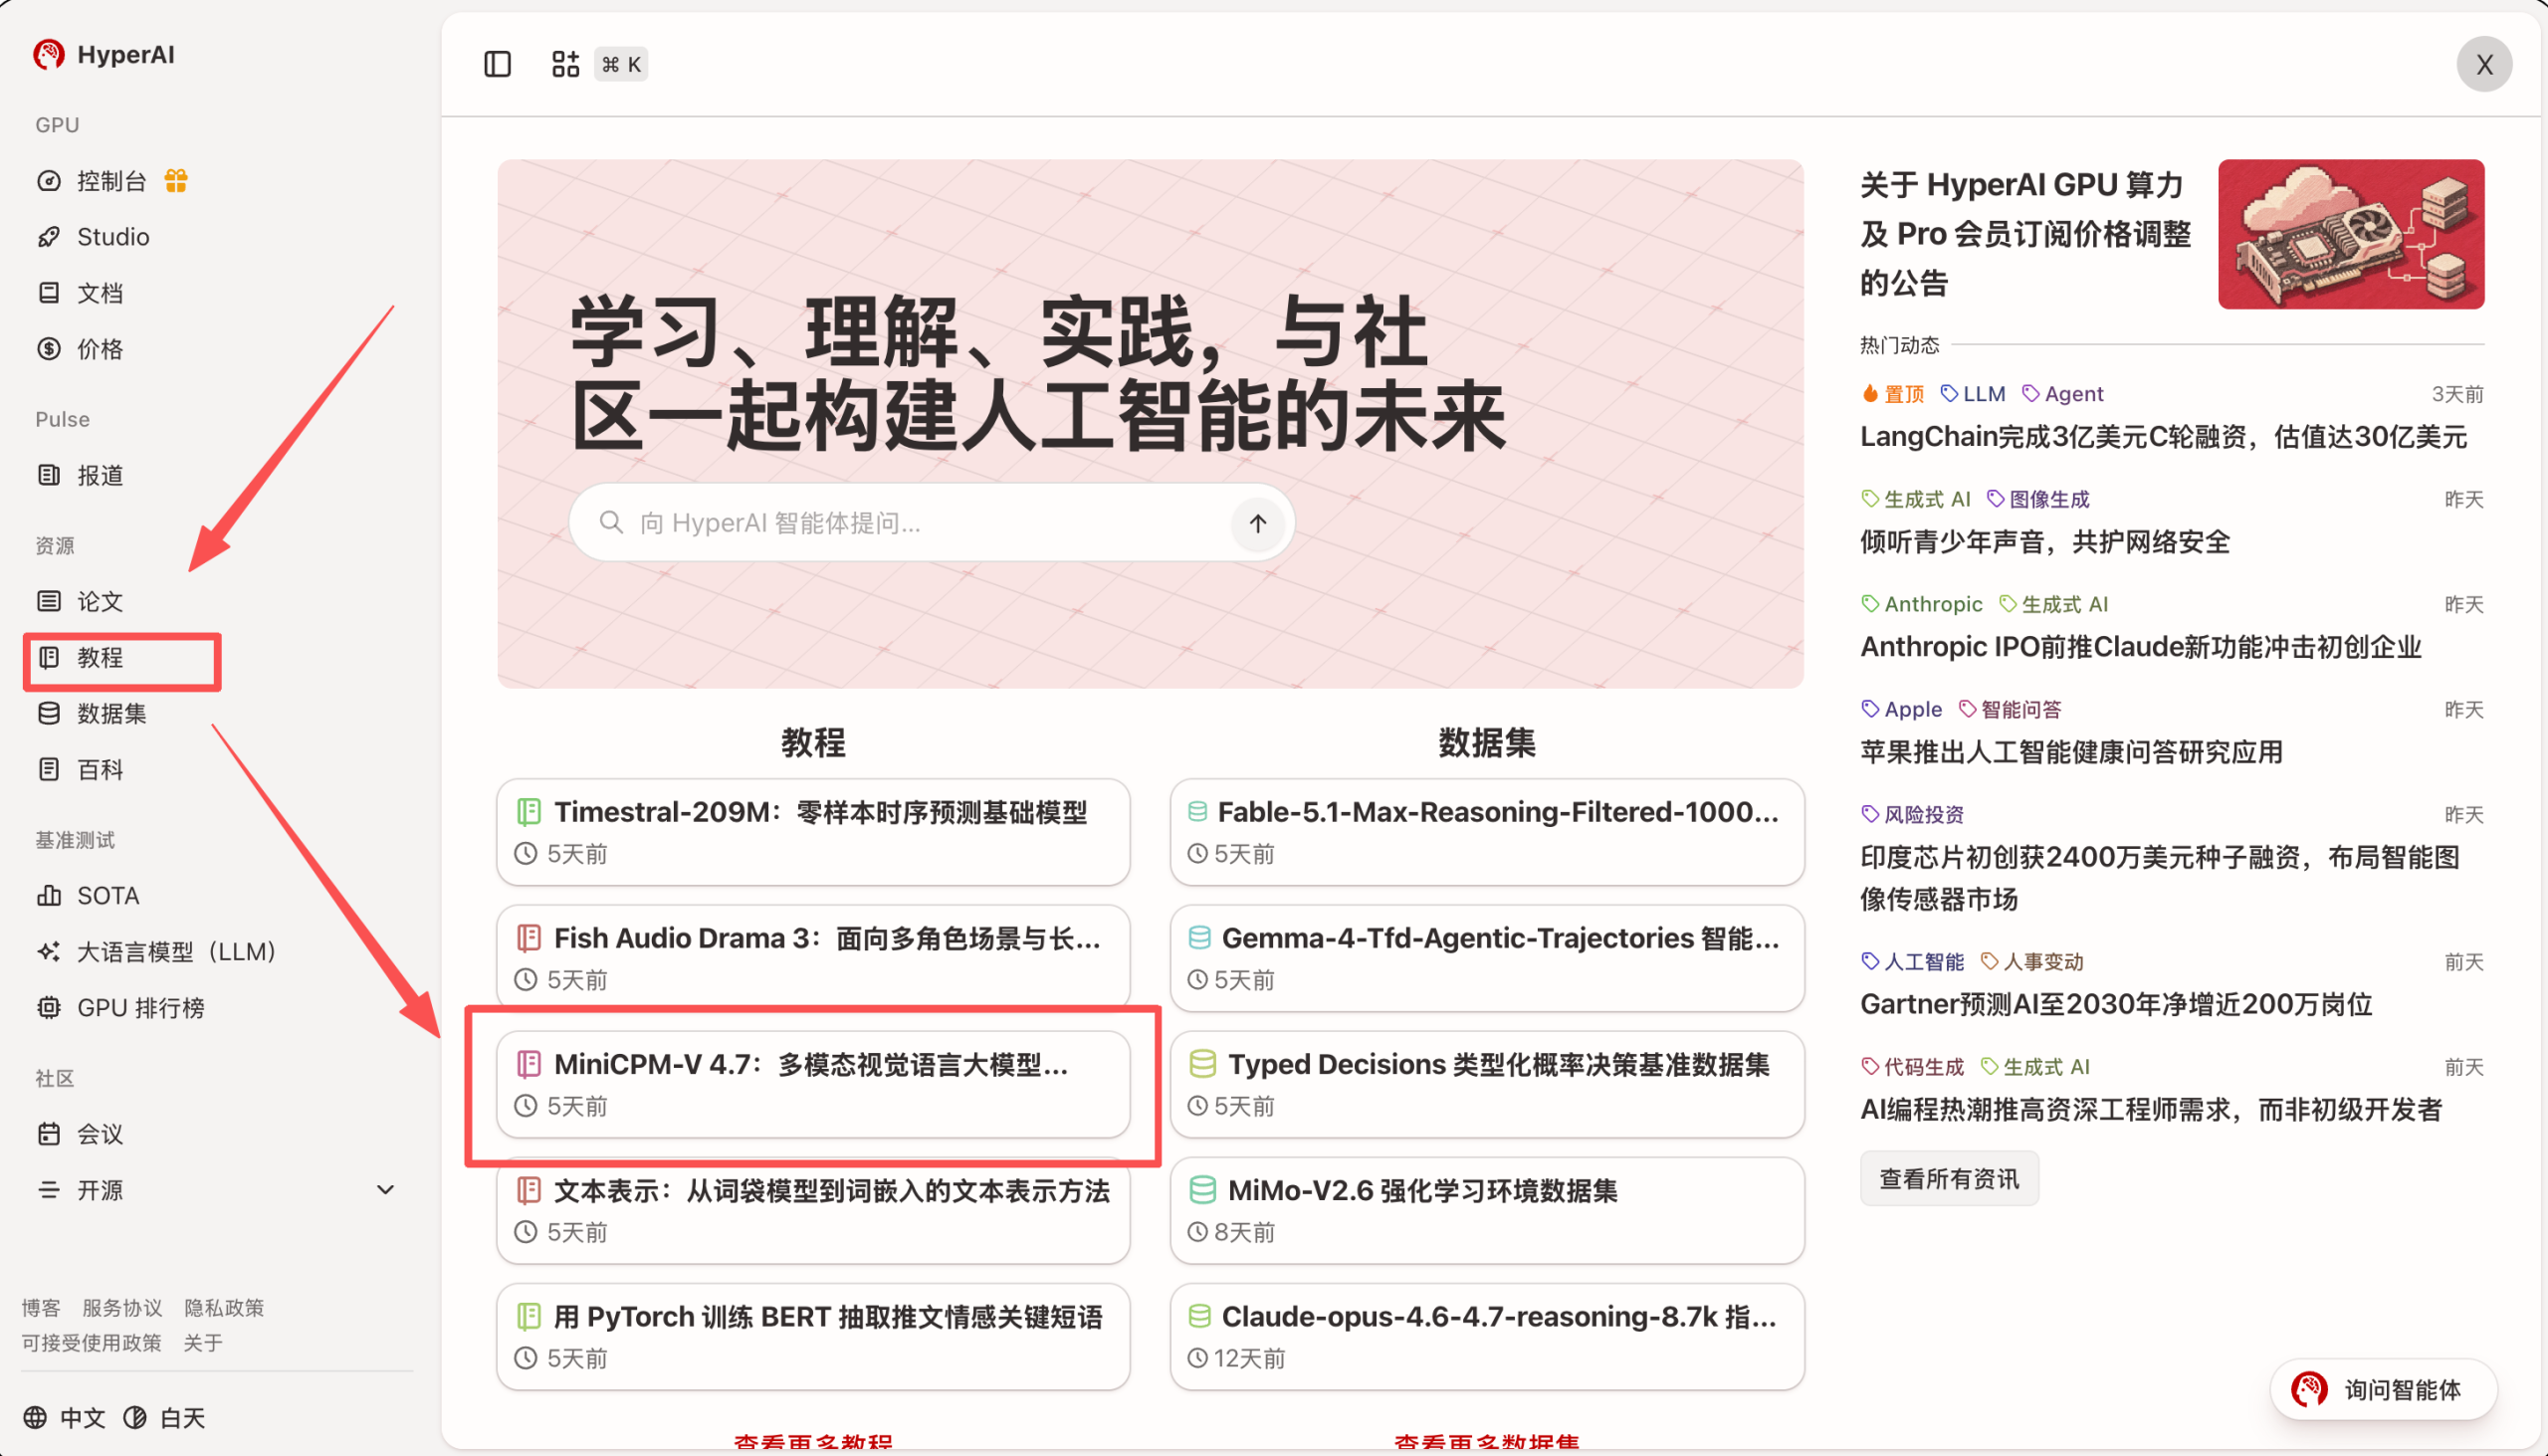
- بعد الدخول إلى الصفحة الرئيسية لـ hyper.ai، اختر صفحة «الدروس»، أو انقر على «عرض المزيد من الدروس»، ثم اختر «MiniCPM-V 4.7: نموذج لغوي بصري متعدد الوسائط كبير (35B-A3B MoE)»، وانقر على «تشغيل هذا الدرس».
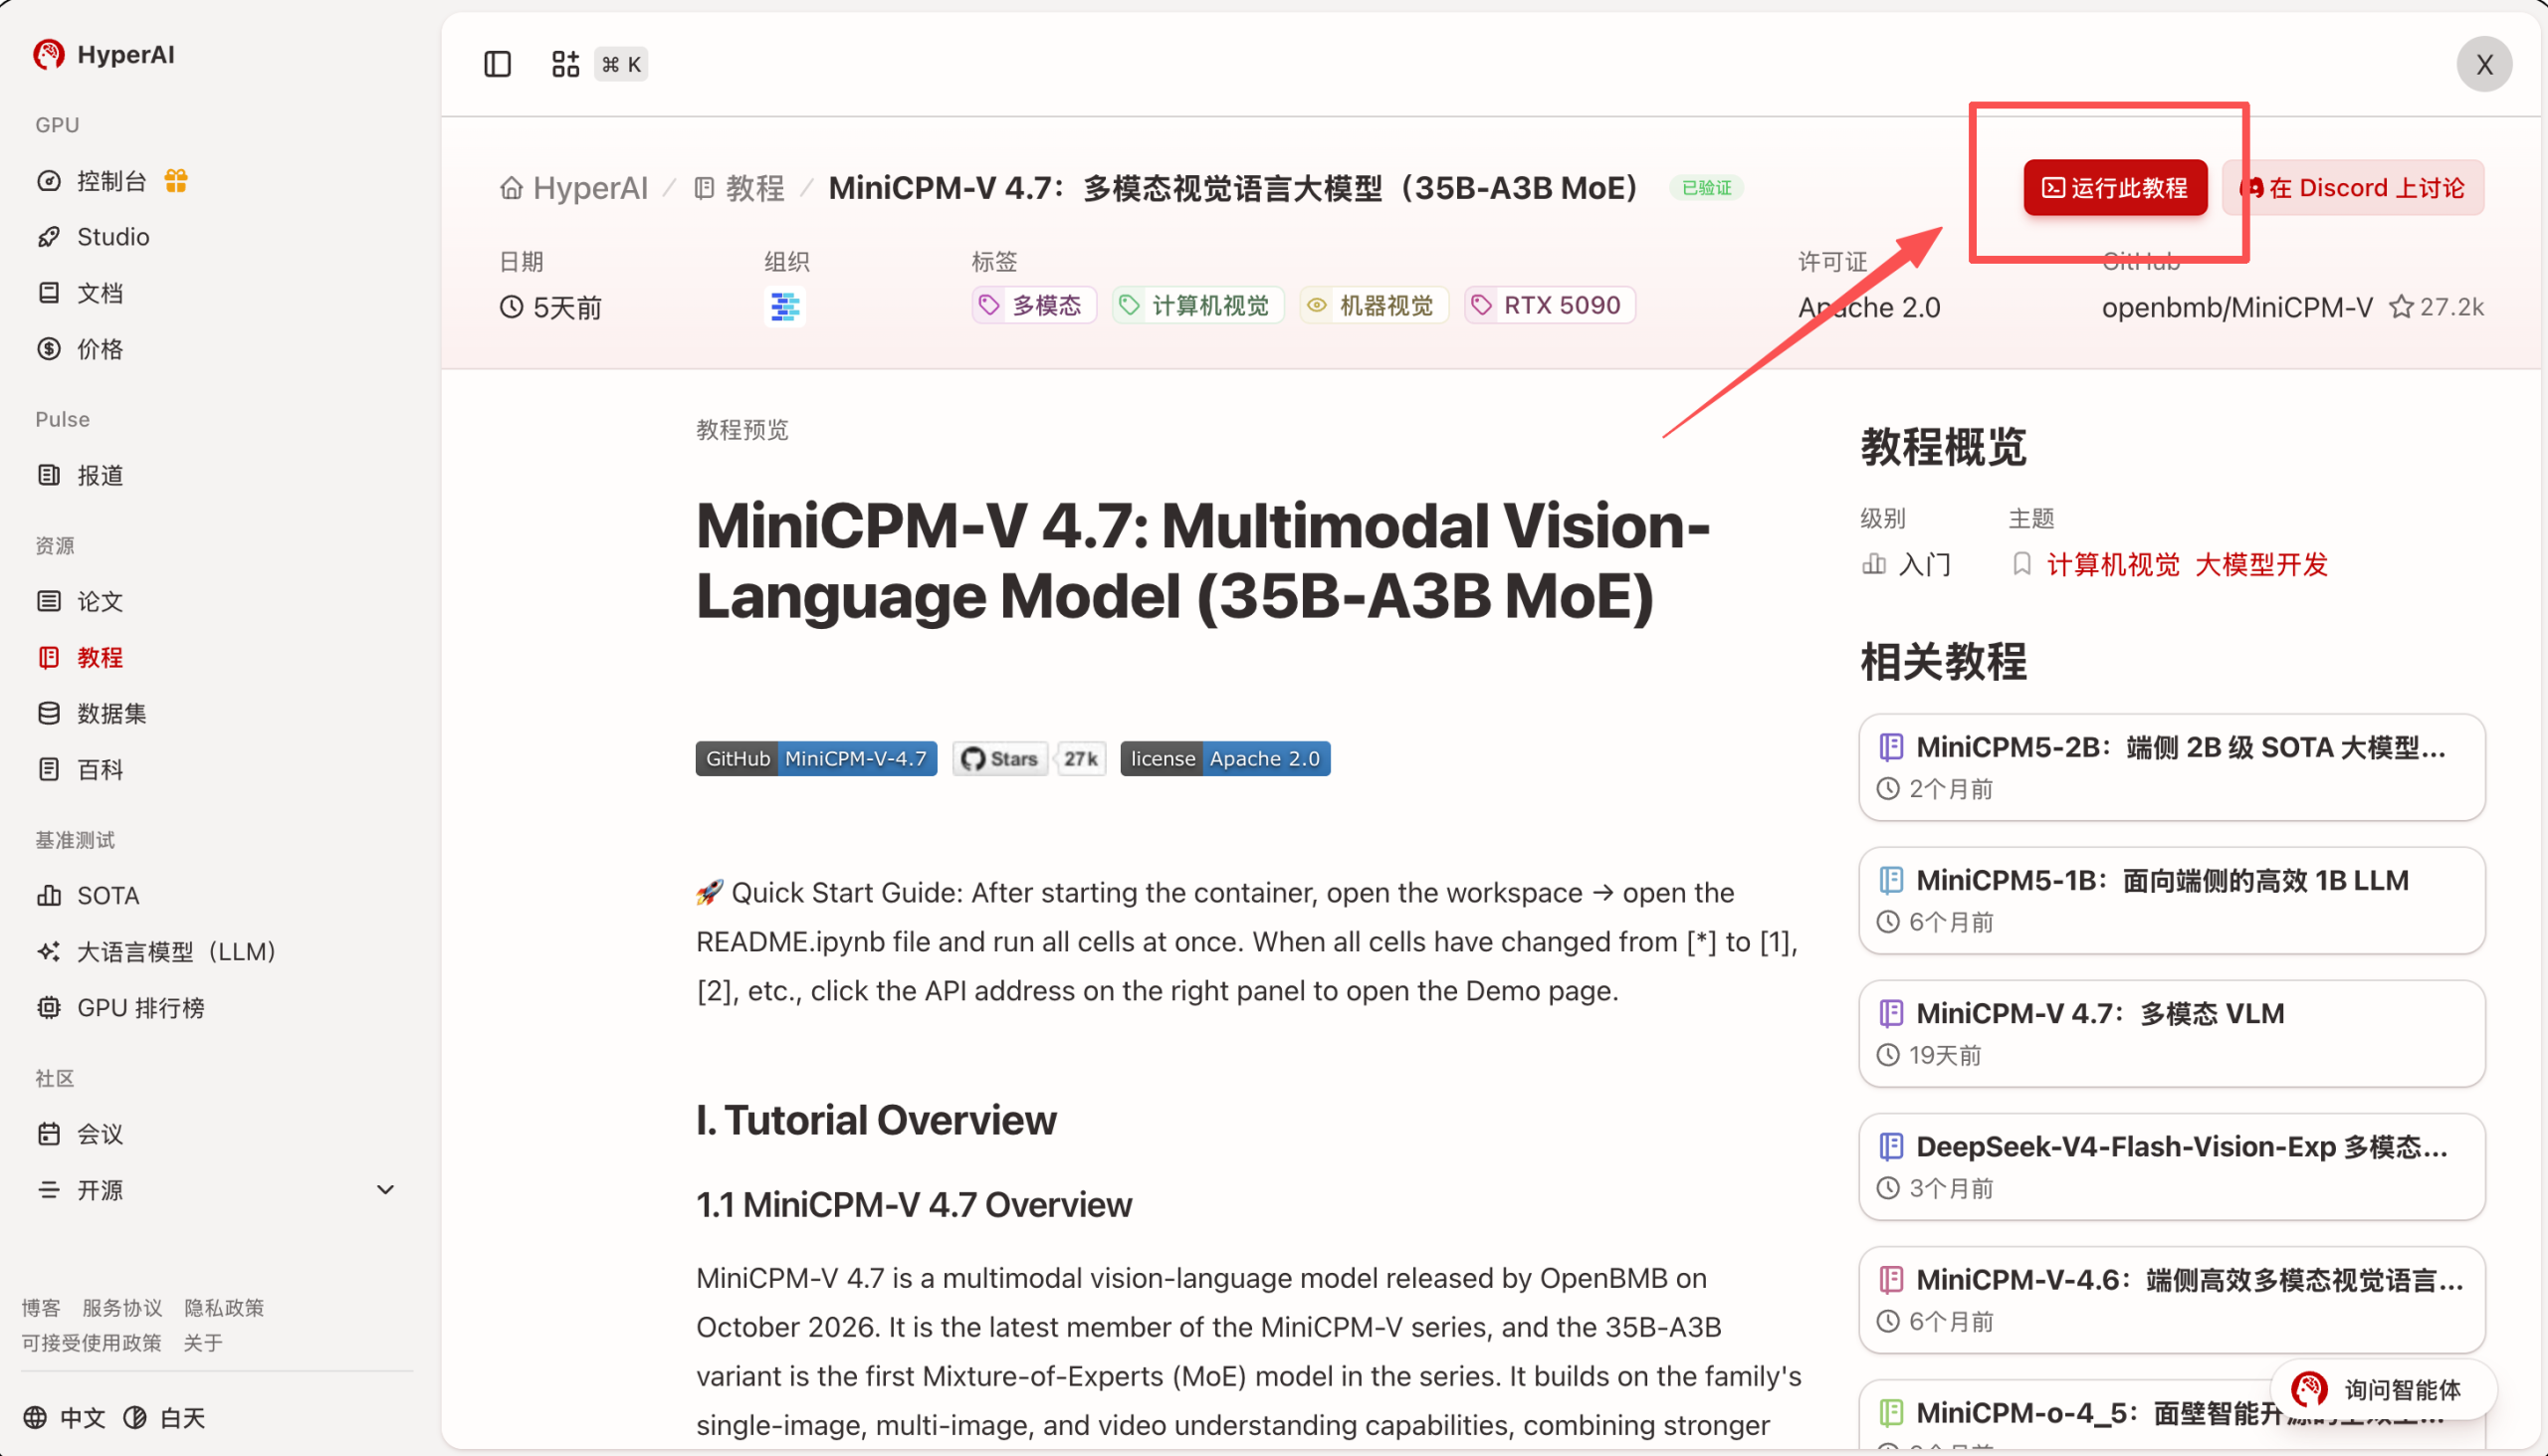
- بعد انتقال الصفحة، انقر على «Clone» في الزاوية العلوية اليمنى لاستنساخ الدرس إلى حاويتك.
ملاحظة: تدعم الزاوية العلوية اليمنى من الصفحة تبديل اللغة، وتتوفر حاليًا اللغتان الصينية والإنجليزية، ويستخدم هذا الدرس الإنجليزية لعرض الخطوات.
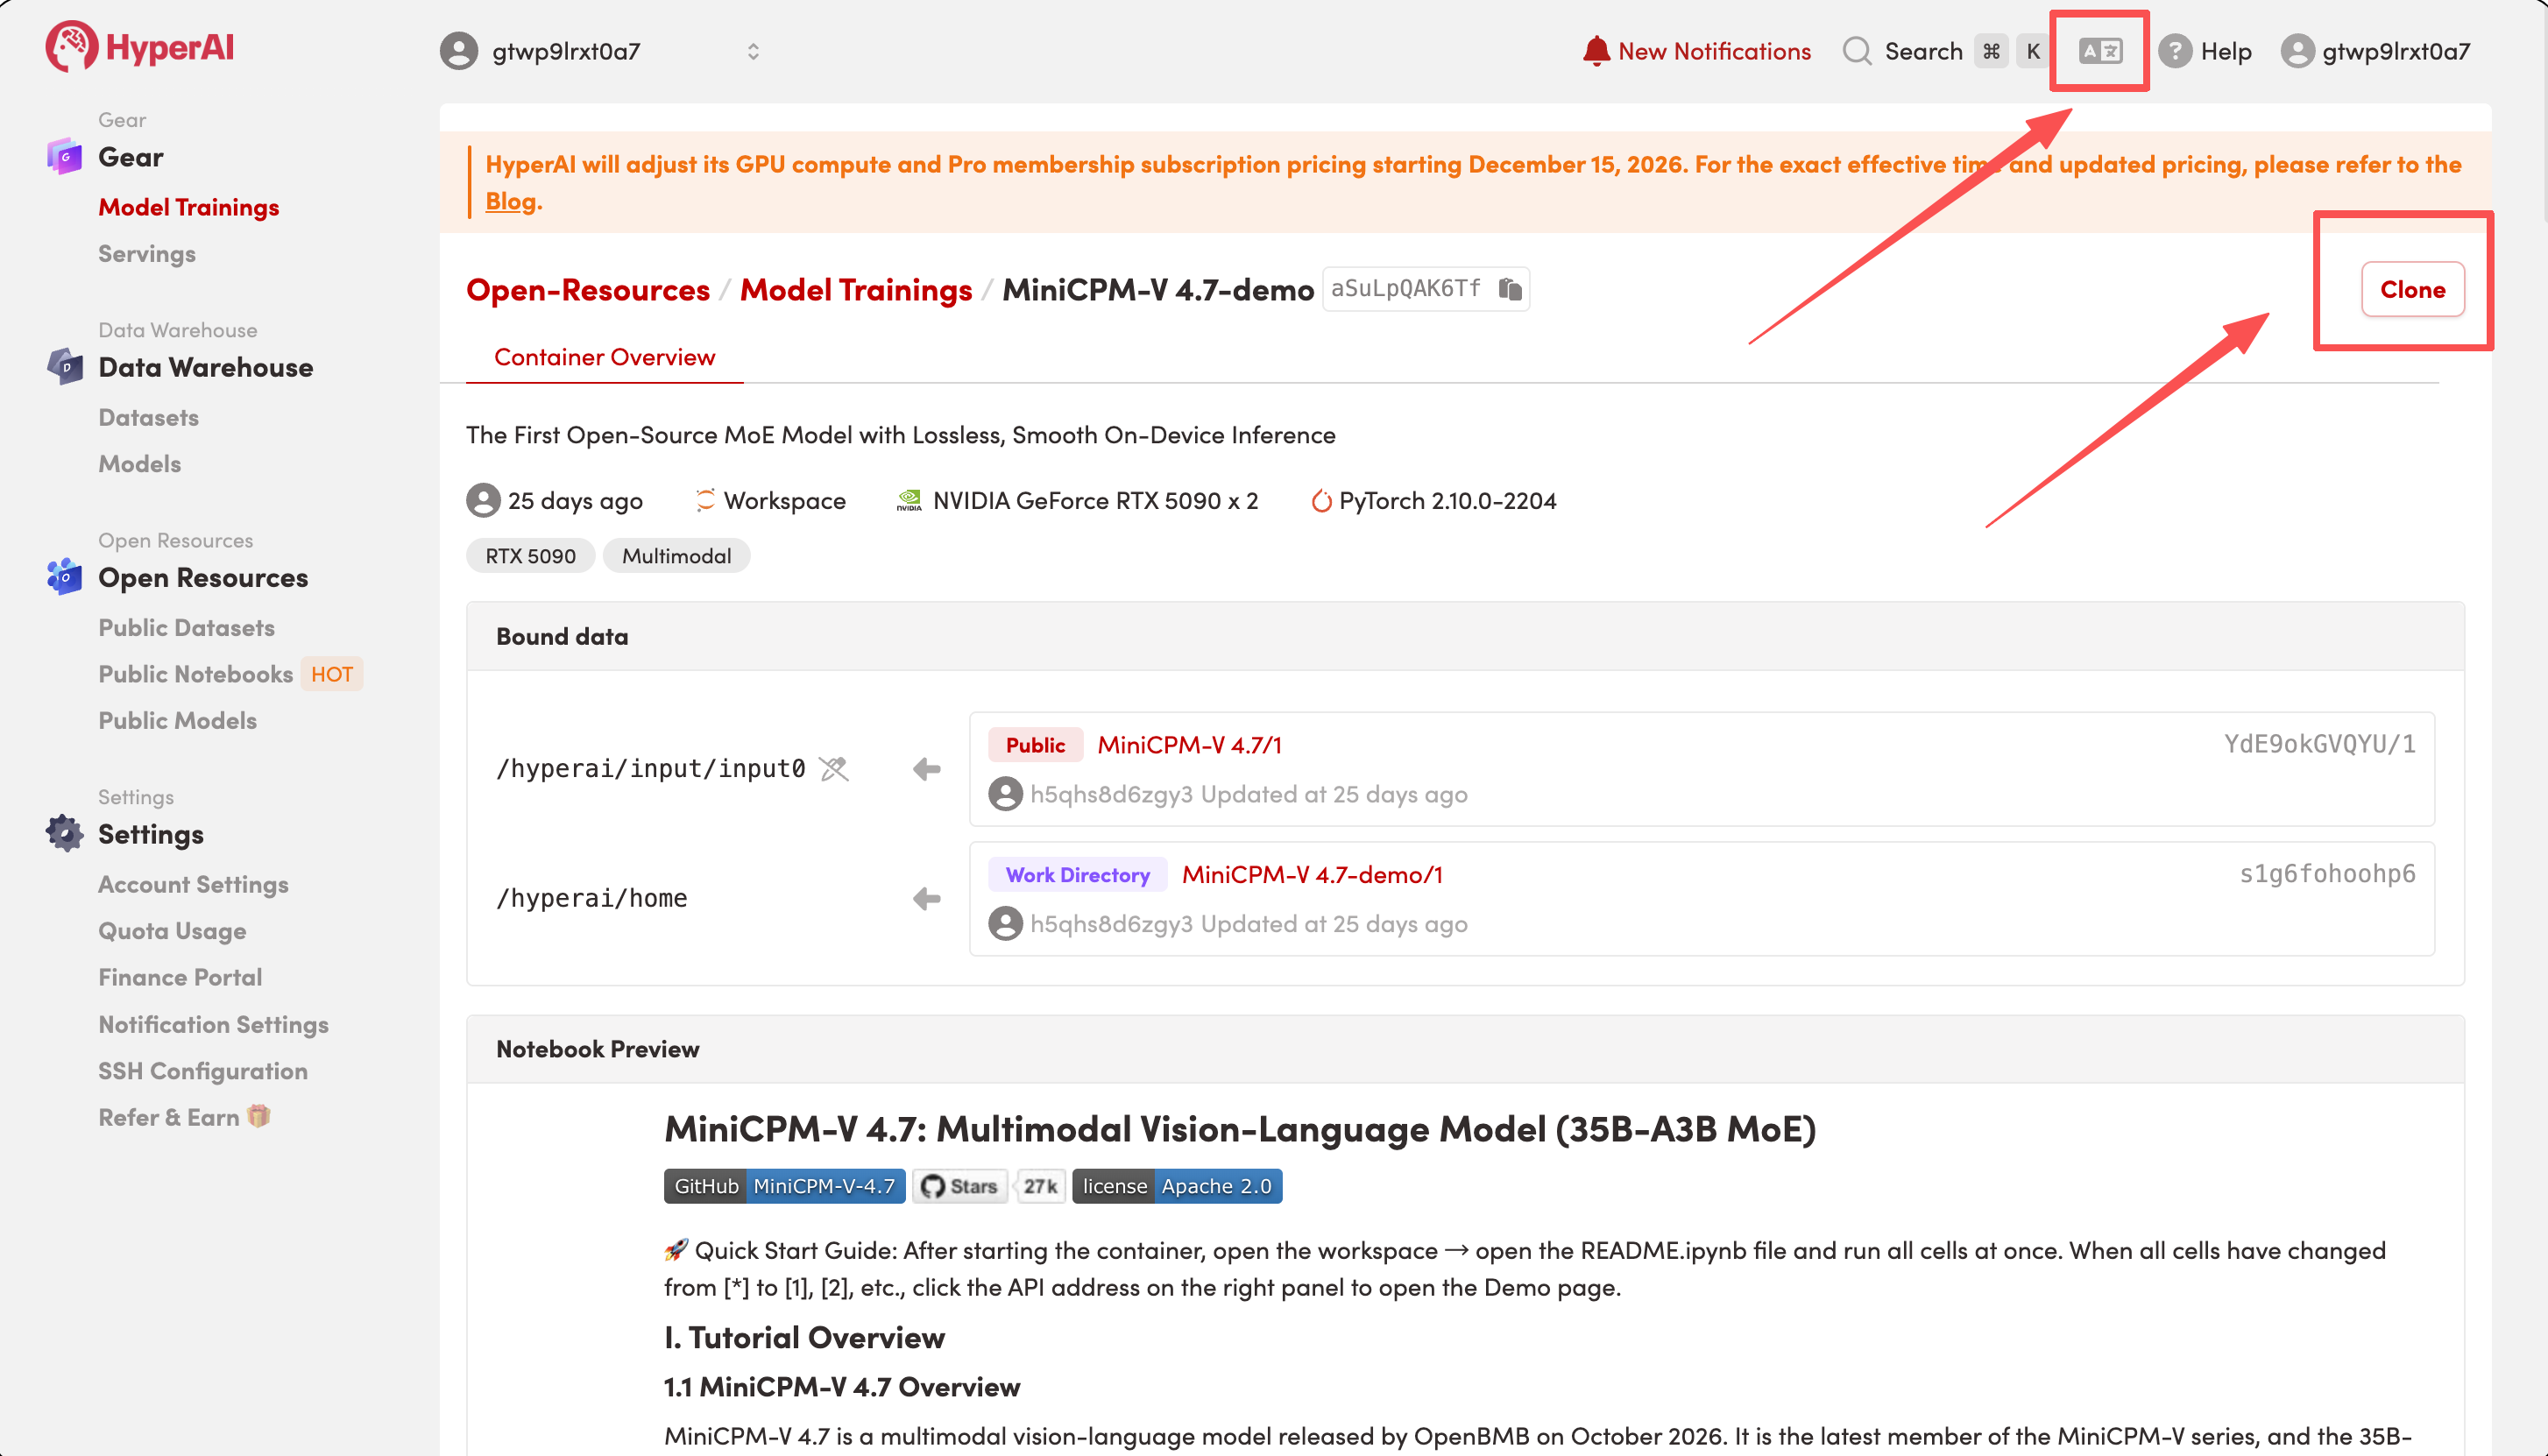
- اختر «2 x NVIDIA GeForce RTX 5090 (32 GB)» والصورة المطابقة، ثم انقر على «Continue job execution (متابعة تنفيذ المهمة)».
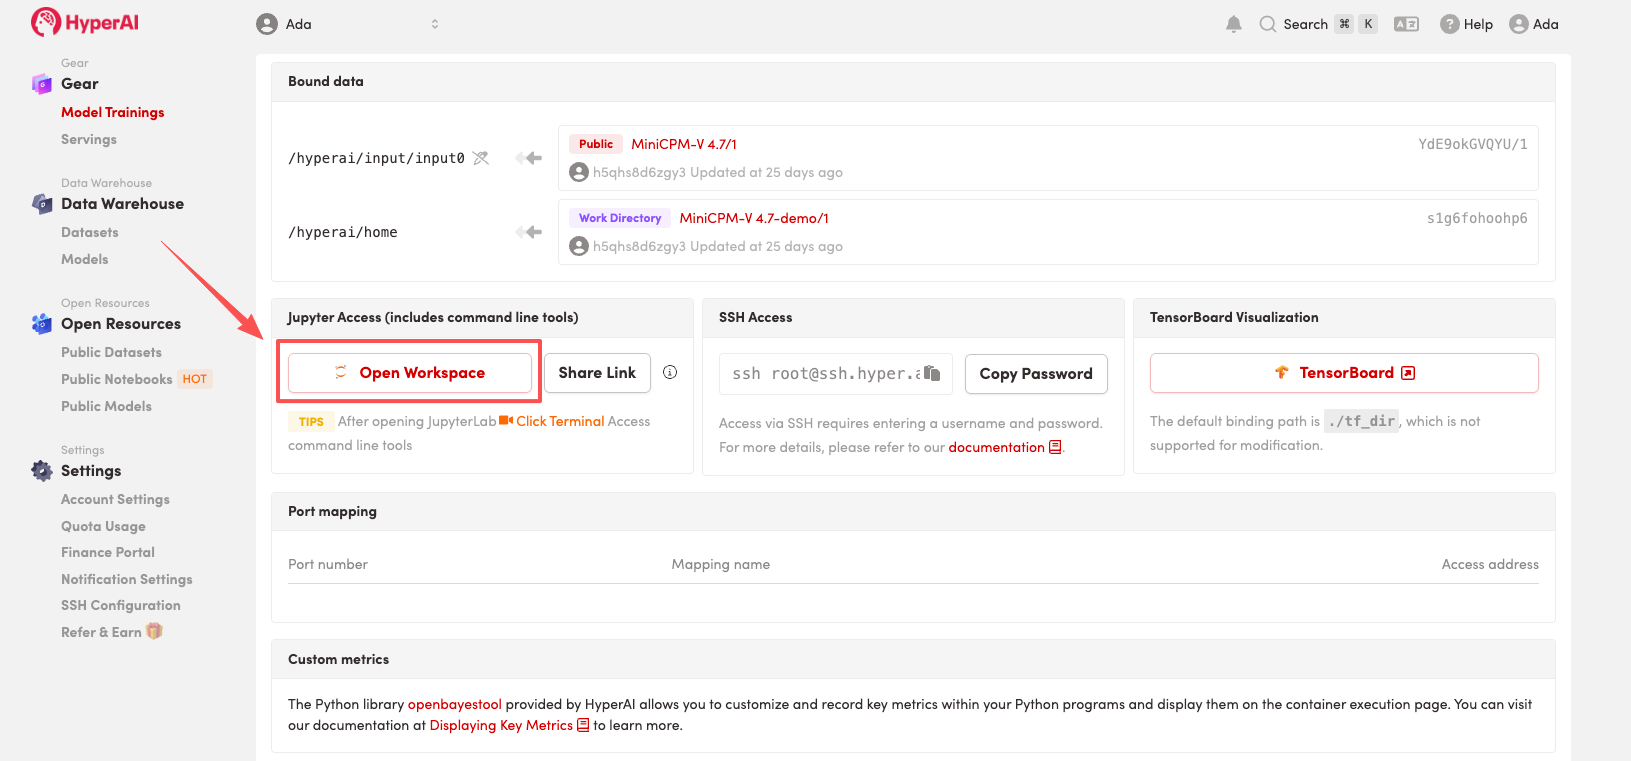
- انتظر تخصيص الموارد، وعندما تتغير الحالة إلى «Running (قيد التشغيل)»، انقر على «Open Workspace» للدخول إلى Jupyter Workspace.
عرض النتائج
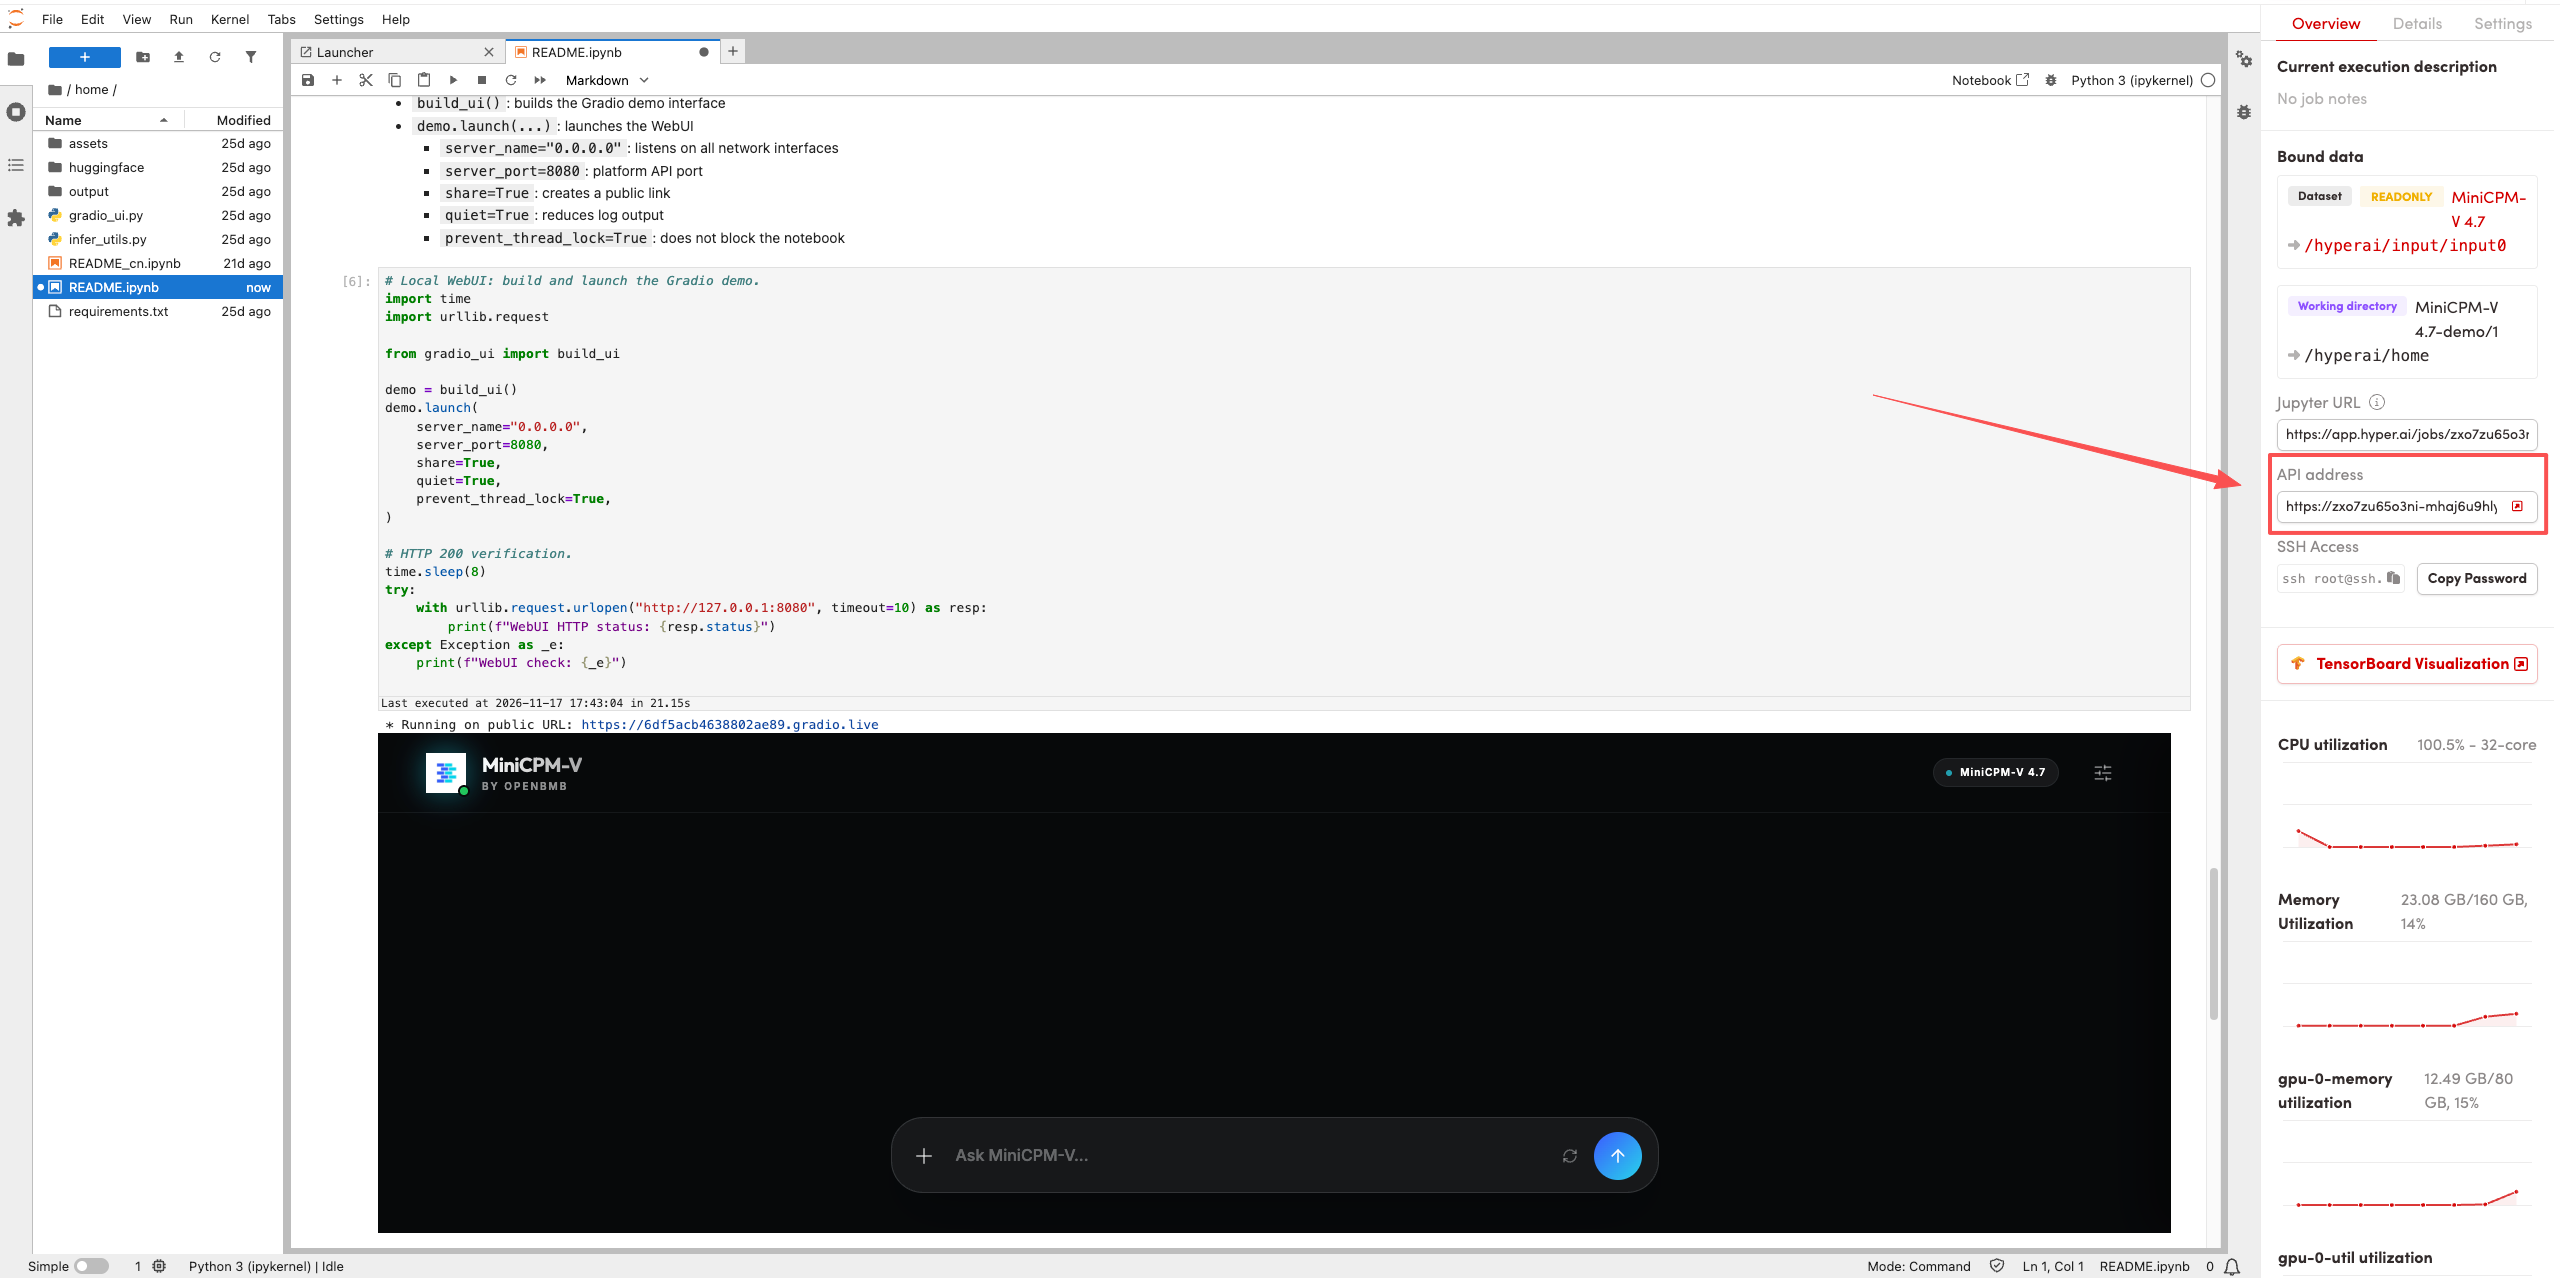
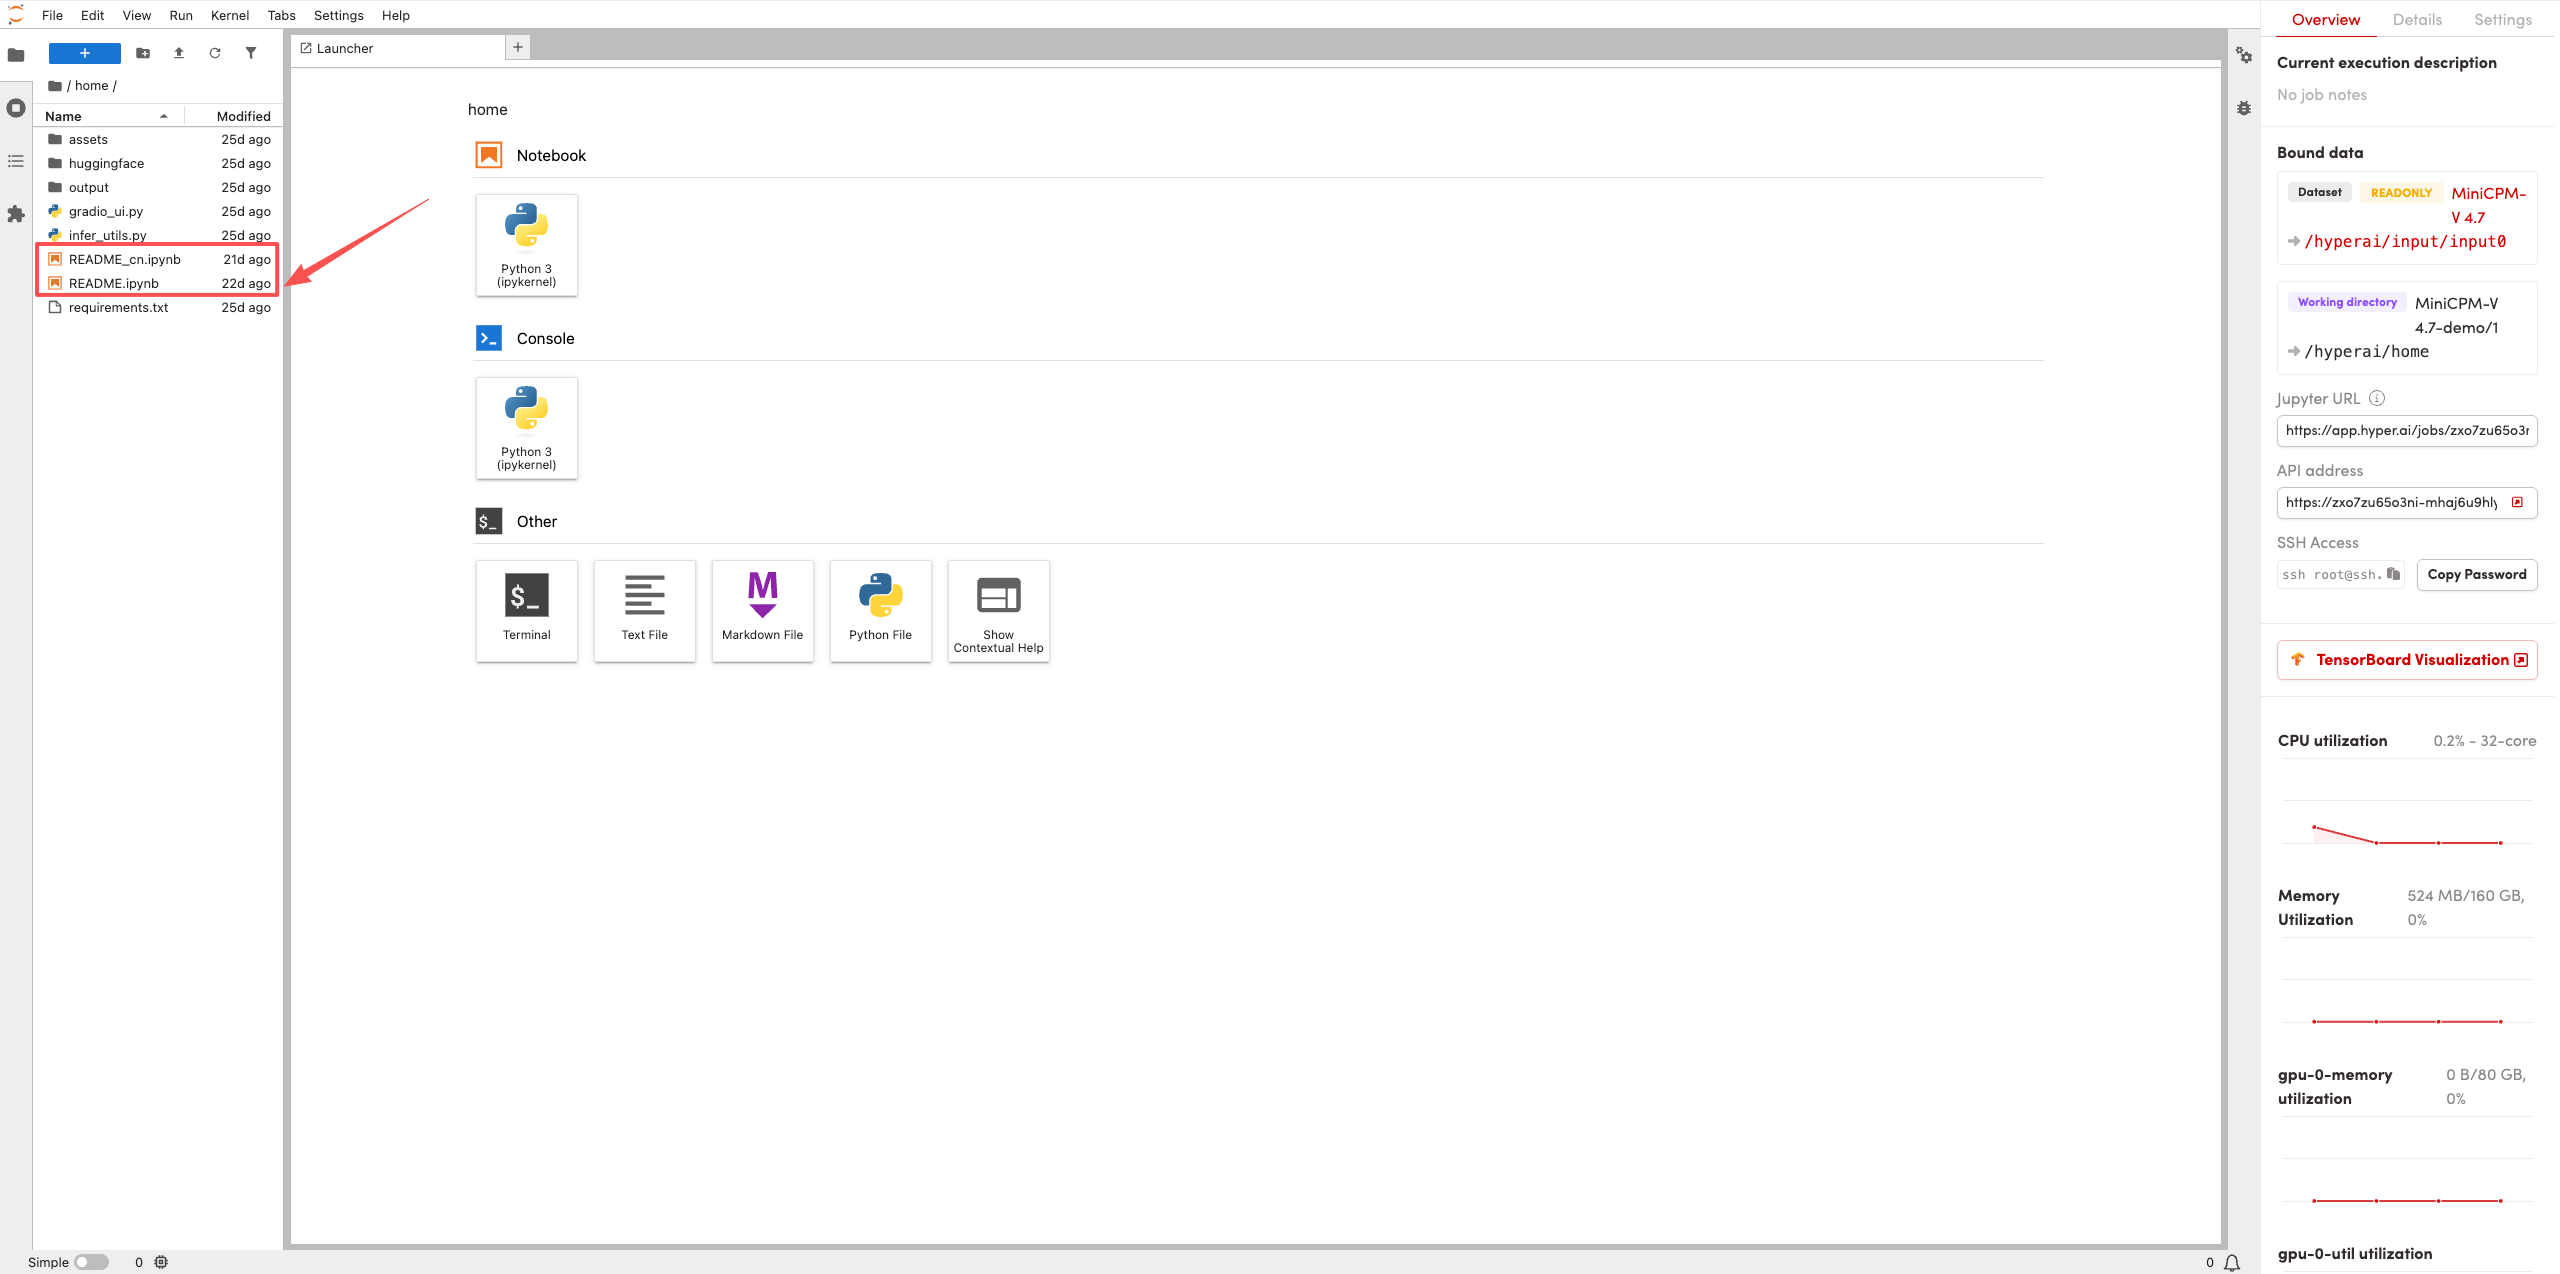
- بعد انتقال الصفحة، انقر على ملف README في الجانب الأيسر، وبعد الدخول انقر على Run (تشغيل) في الأعلى.
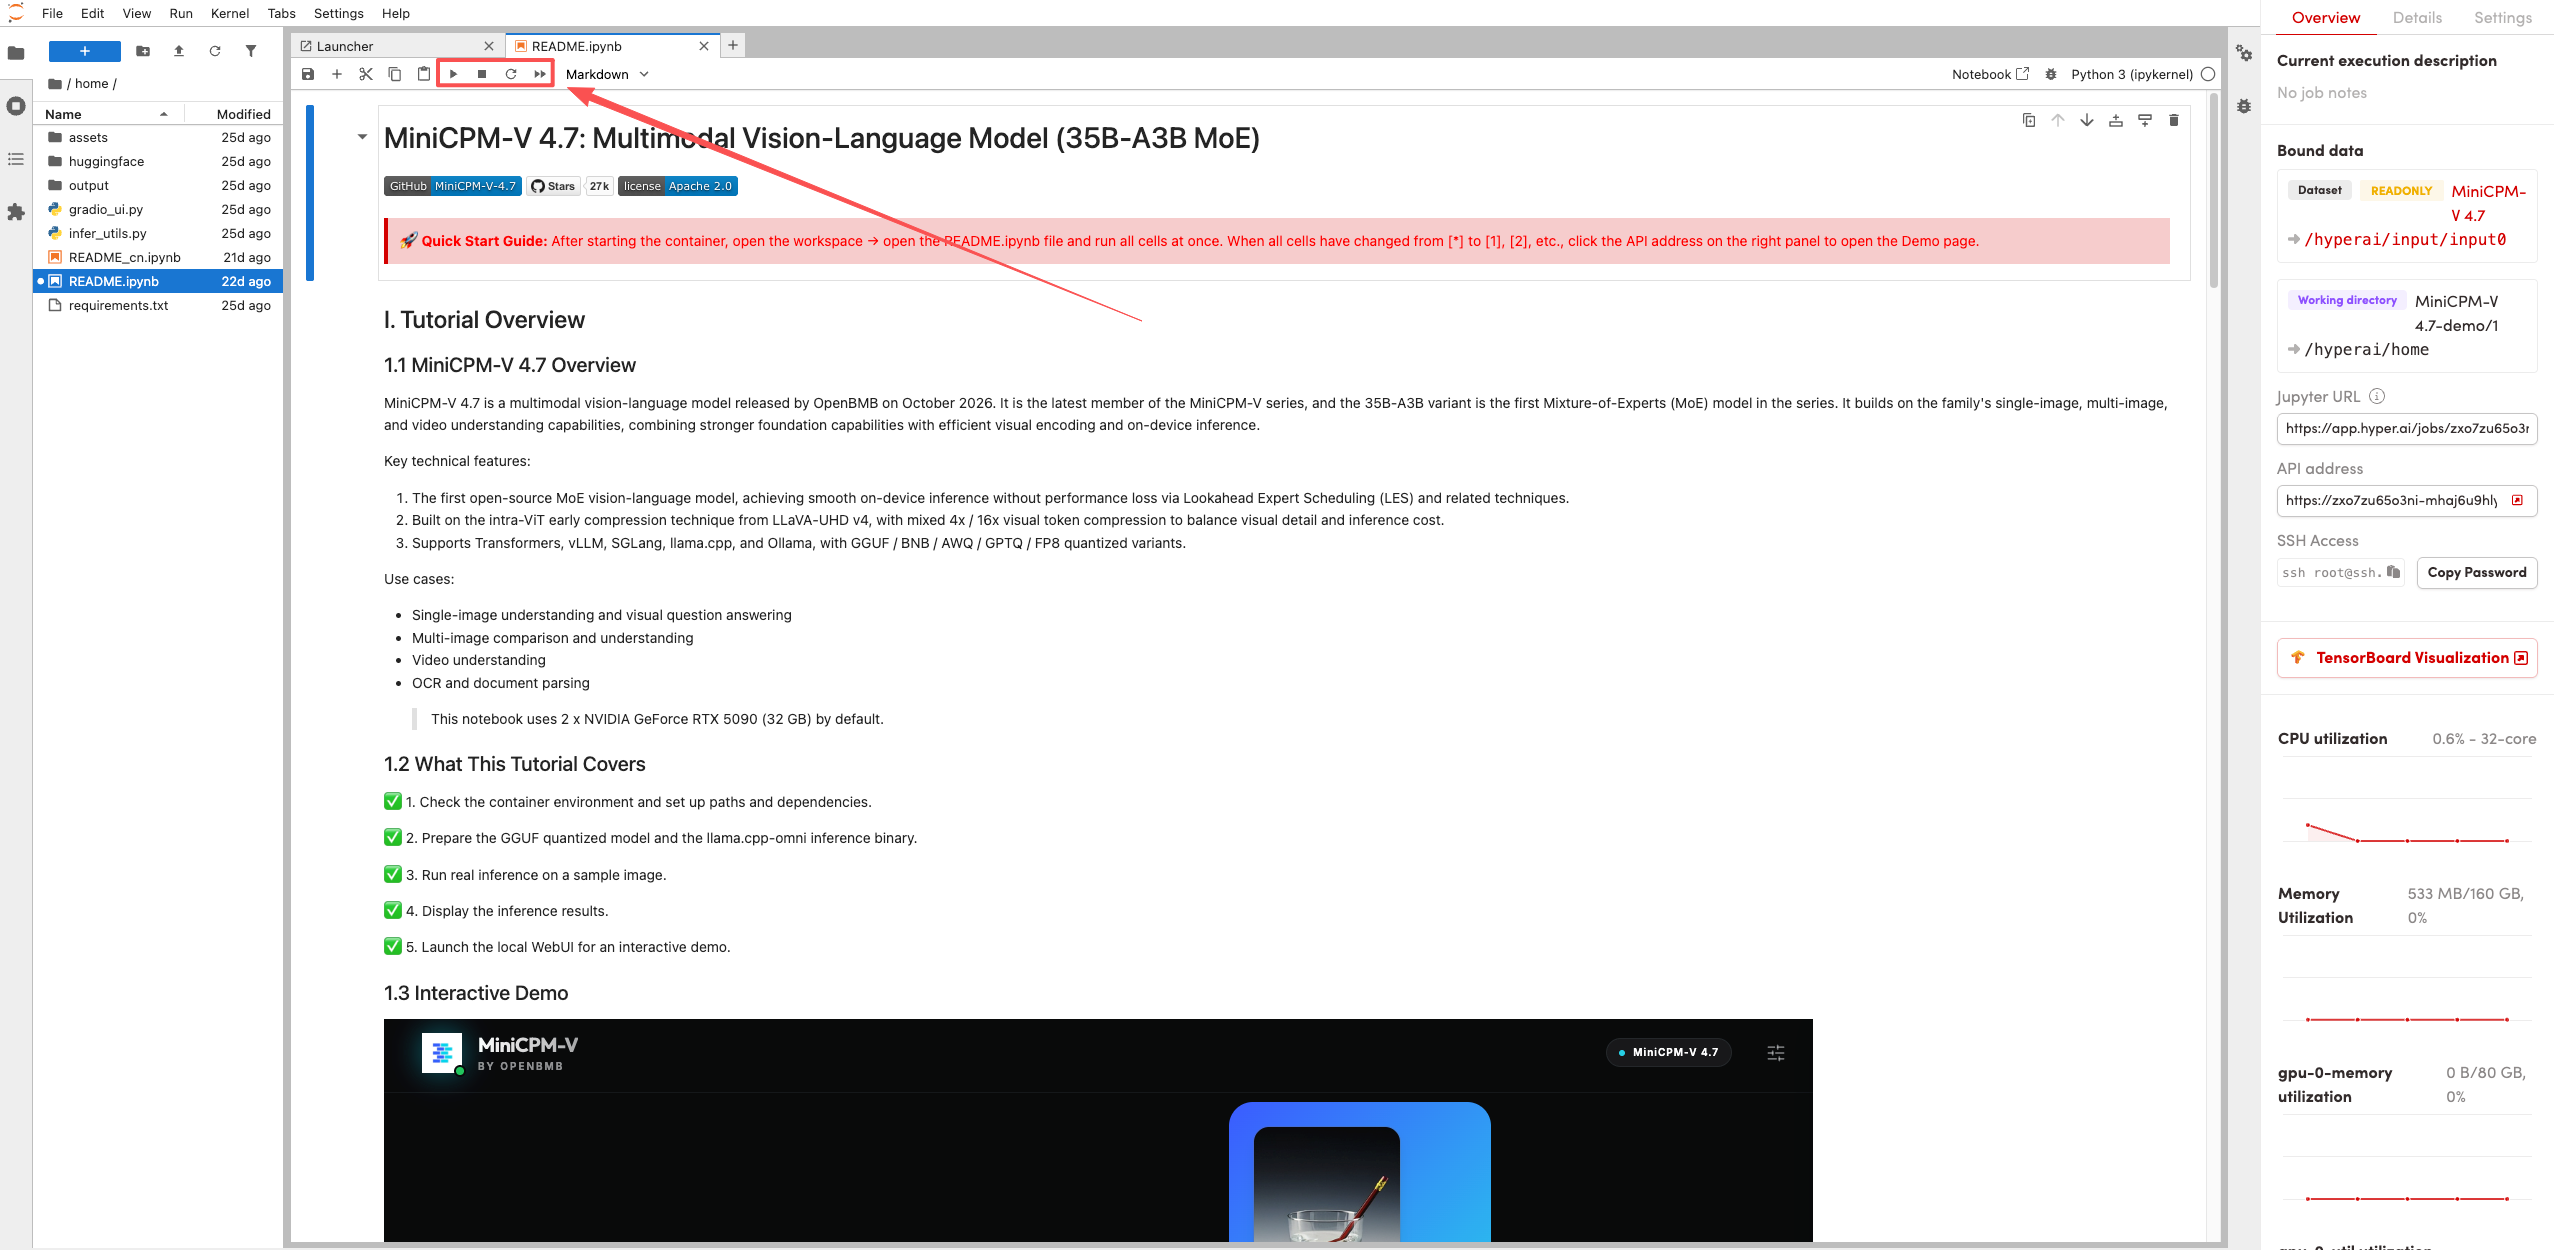
- بعد اكتمال التشغيل، انقر على عنوان API في الجانب الأيمن للوصول إلى العرض التجريبي.