Command Palette
Search for a command to run...
دروس عبر الإنترنت | اتخاذ قرارات سريعة واستدلال حسب الحاجة، نموذج JEV-27B-VL المبني على Qwen3.8-27B، يدعم تقييم الصور والنصوص، الاختيار من متعدد، والتقييم
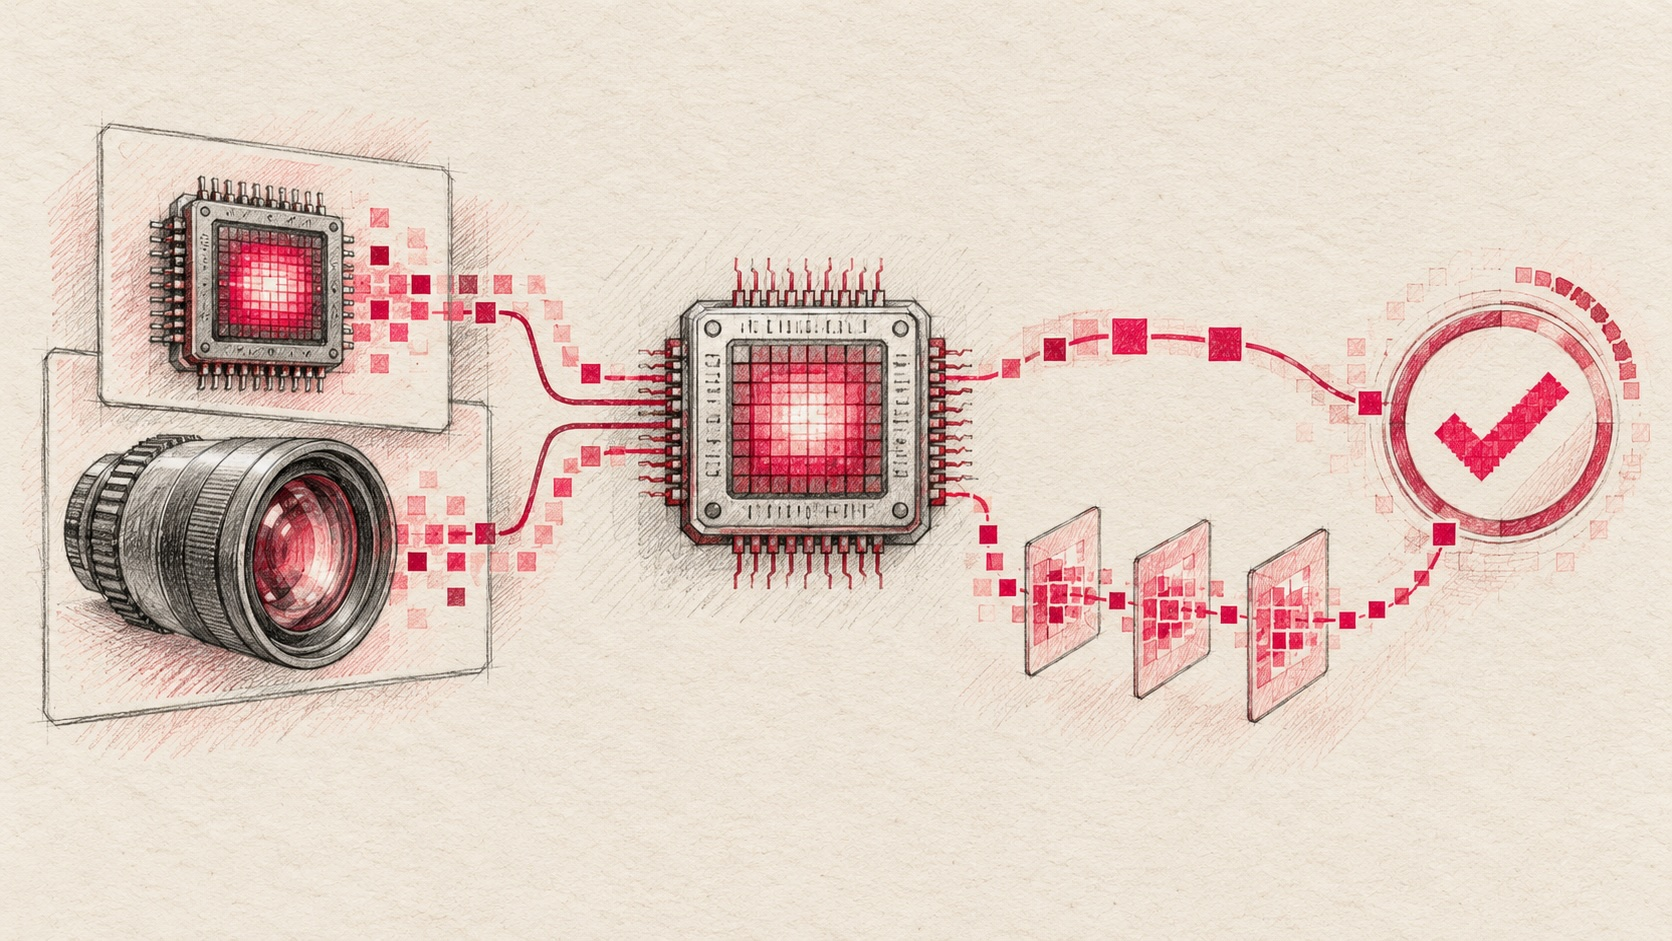
تمكنت نماذج اللغة البصرية من فهم الصور والإجابة عن الأسئلة؛ ومع ذلك، لا يشترط أن تولّد الذكاء الاصطناعي نصاً مطولاً عند تحليل الصور. فعلى سبيل المثال، في مهام مثل تحديد ما إذا كانت الصورة تحتوي على محتوى مخالف، أو اختيار المنتج الأكثر ملاءمة من بين عدة منتجات، أو تقييم ما إذا كان غلاف فيديو قصير يستحق التوصية، غالباً ما يكون المطلوب ليس تحليلاً مفصلاً، بل قراراً واضحاً مع تحديد مستوى الثقة في هذا القرار.
يقوم فريق AutoTrust، من خلال نموذج JEV-27B-VL للقرار البصري الذي أطلقه في عام 2026، باستكشاف نهج مختلف للحل. وقد احتل هذا النموذج المرتبة الأولى في قائمة Vision ضمن مؤشر Jev Decision Index 0.3 المجتمعي. وفقاً لمقدمة المشروع، وعلى عكس نماذج اللغة البصرية التي تركز بشكل أساسي على توليد النص المفتوح، يولي JEV-27B-VL اهتماماً أكبر بـ القرارات المُنمّطة (Typed Decisions): أي تمكين النموذج من تقديم نتائج حكم مباشرة ومطابقة للنوع المحدد، بناءً على مدخلات نصية وبصرية.
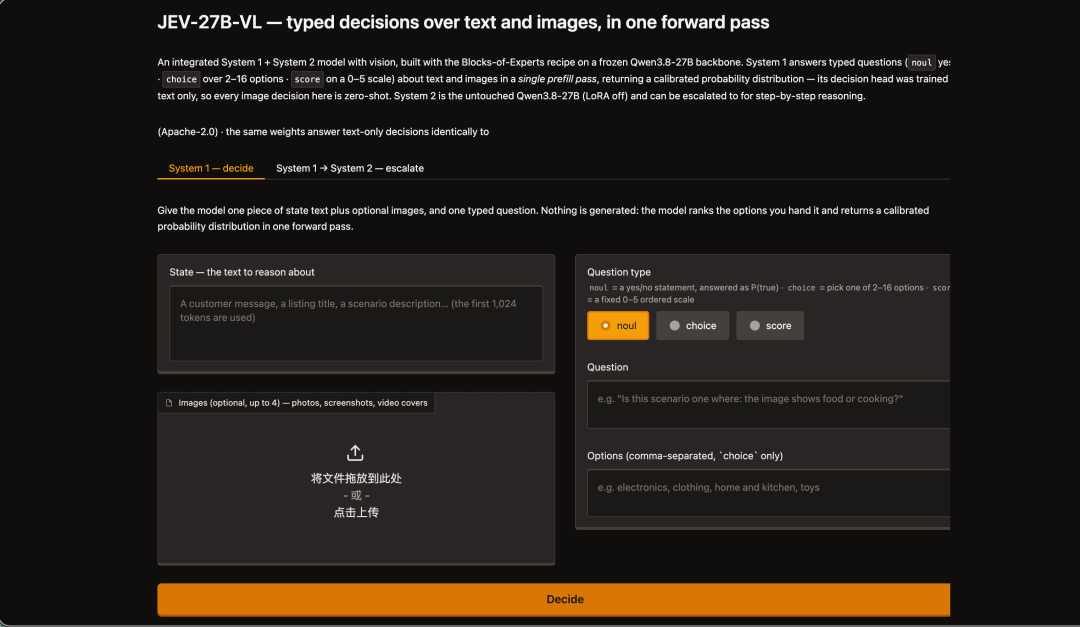
من الناحية التقنية، يعتمد JEV-27B-VL على نموذج Qwen3.8-27B كأساس، ويستخدم خطة Blocks-of-Experts لدمج مسارين مختلفين للمعالجة: يتولى النظام 1 (System 1) اتخاذ القرارات السريعة، بينما يتولى النظام 2 (System 2) الاستدلال العميق. وقد أعاد ترتيب مسارات الحساب للمهام المختلفة، لتجنب تحمل تكلفة التوليد والاستدلال الكاملين في كل عملية حكم، مما يحقق خفة النموذج. يقوم النظام 1، من خلال رأس قرار مخصص، بإخراج احتمالات معايرة للخيارات في تمرير أمامي واحد، مما يدعم أحكام نعم/لا، والأسئلة متعددة الخيارات (من 2 إلى 16 خياراً)، والتقييم على مقياس من 0 إلى 5، دون الحاجة إلى توليد الإجابة توليداً ذاتياً رجعيًا لكل رمز (Token) على حدة. وفي حال انخفاض ثقة القرار، يتم استدعاء النظام 2 لمزيد من الاستدلال خطوة بخطوة باستخدام نموذج Qwen3.8-27B الأصلي. وبالمقارنة مع تنفيذ جميع المهام عبر مسار التوليد الكامل، فإن هذا النهج لتخصيص الحساب حسب الحاجة أكثر ملاءمة للتطبيقات الحساسة لتأخير الاستجابة وتكلفة الاستدلال.
عندما يتطلب الأمر مجرد قرار، فلا داعي لإجبار النموذج على توليد إجابة كاملة. حالياً، يتوفر في قسم الدروس على موقع HyperAI الرسمي (hyper.ai) درس بعنوان «JEV-27B-VL: نموذج القرار المُنمط للنصوص والصور»، لمساعدة المطورين على استخدام قدرات النموذج بسرعة.
تشغيل عبر الإنترنت:
المزيد من الدروس عبر الإنترنت:
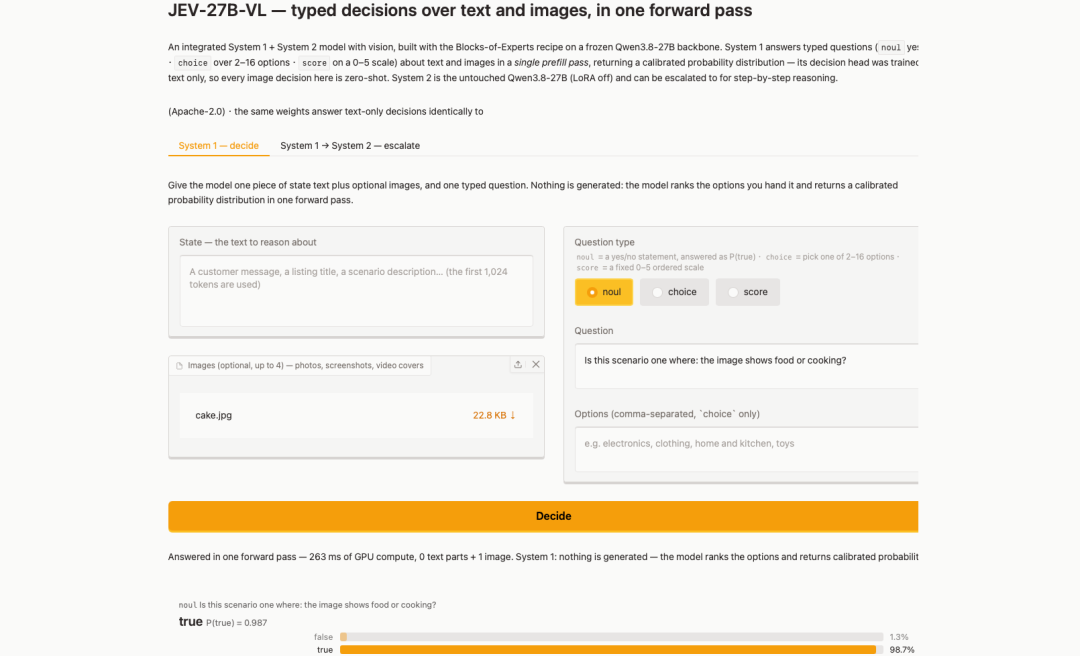
تشغيل العرض التوضيحي
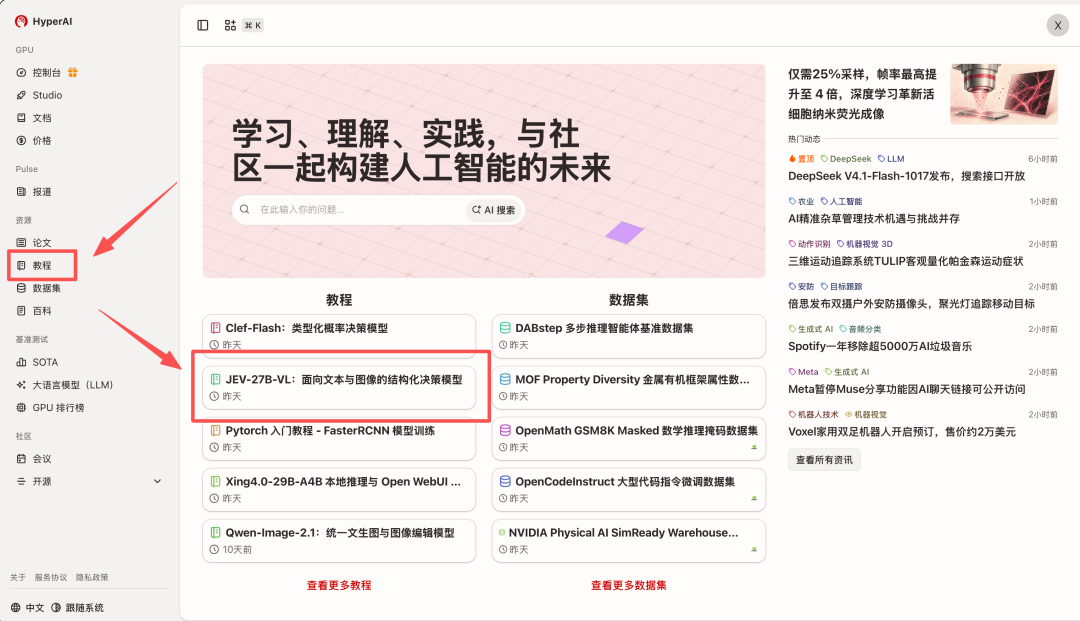
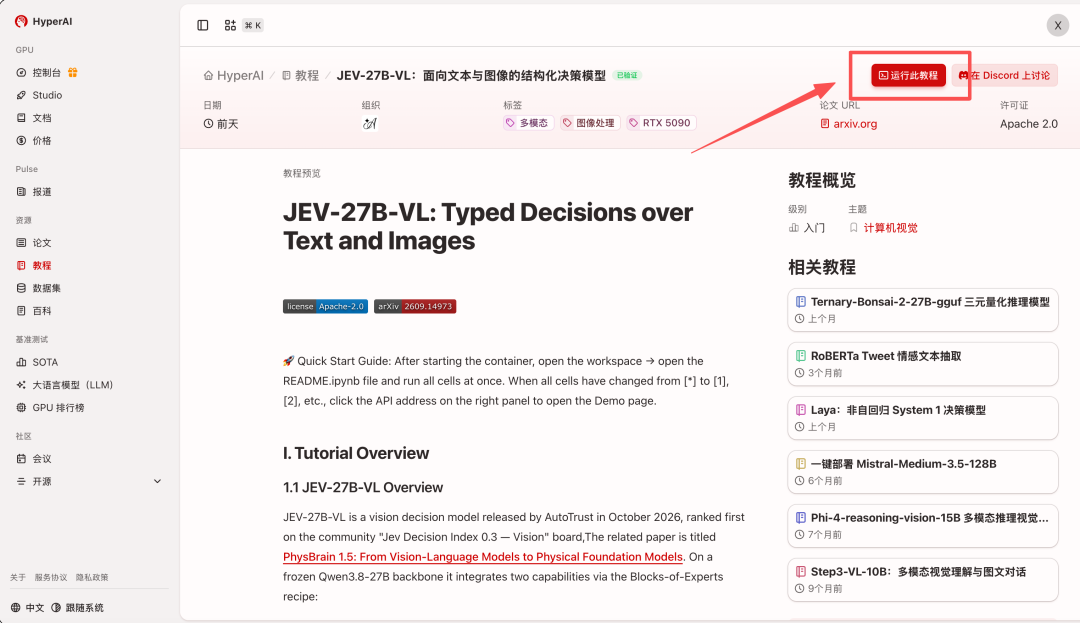
- بعد الدخول إلى الصفحة الرئيسية لـ hyper.ai، اختر صفحة «الدروس»، أو انقر على «عرض المزيد من الدروس»، ثم اختر «JEV-27B-VL: نموذج القرار المُنمط للنصوص والصور»، وانقر على «تشغيل هذا الدرس».
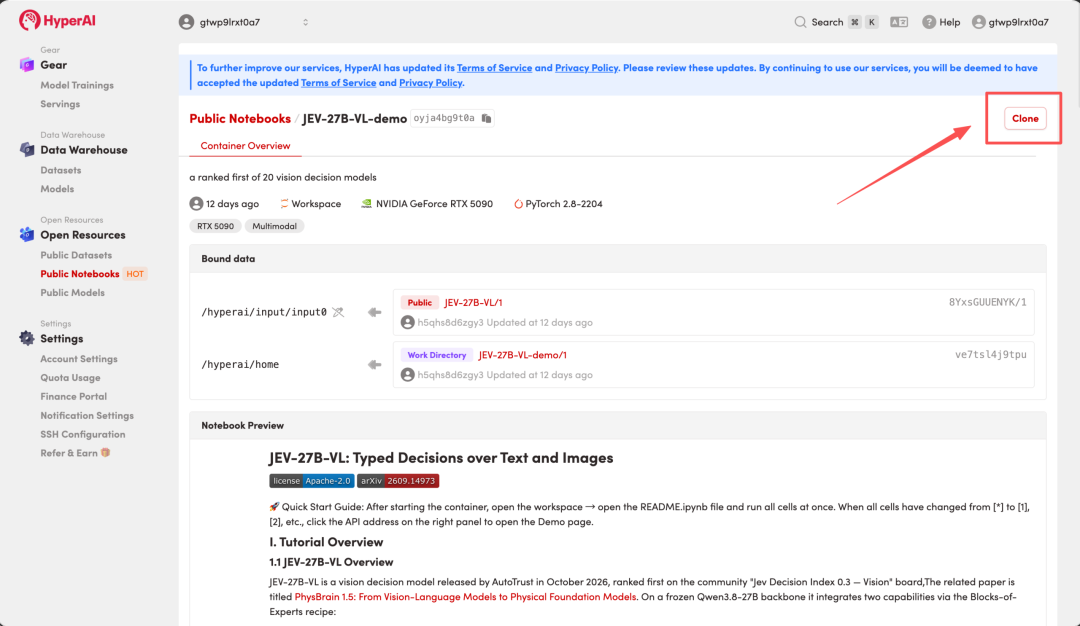
- بعد تحويل الصفحة، انقر على «Clone» في الزاوية العلوية اليمنى لنسخ هذا الدرس إلى حاويتك الخاصة.
ملاحظة: تدعم الزاوية العلوية اليمنى من الصفحة تبديل اللغة، حيث تتوفر حالياً اللغتان الصينية والإنجليزية. تستخدم هذه المقالة الإنجليزية كمثال لعرض الخطوات.
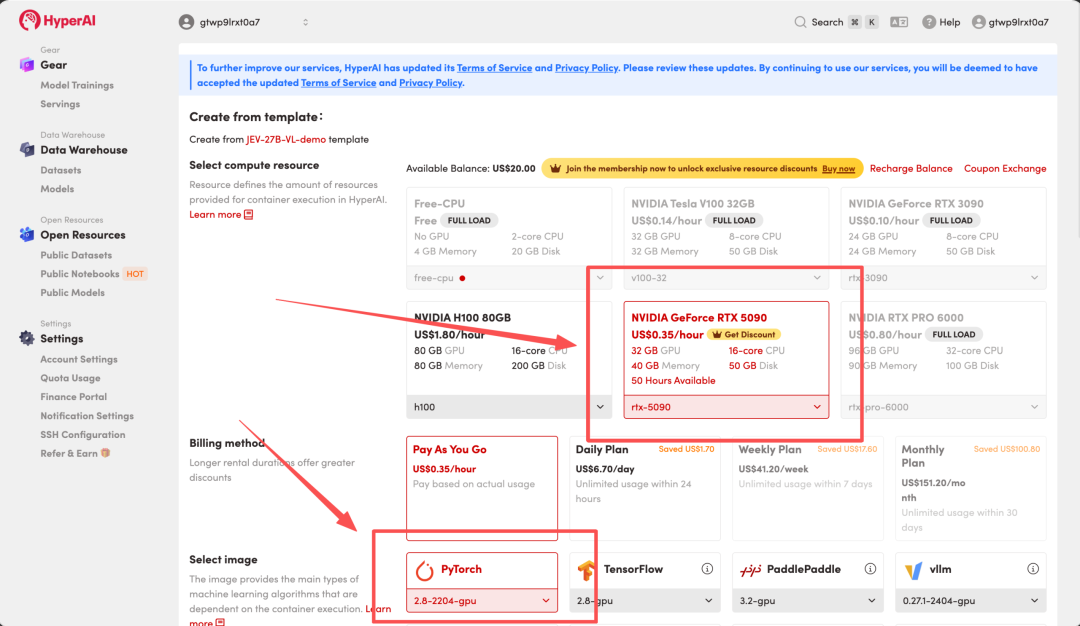
- اختر «NVIDIA RTX 5090» والصورة المقابلة، ثم انقر على «Continue job execution (متابعة التنفيذ)». يستخدم هذا الدرس افتراضياً موارد NVIDIA GeForce RTX 5090 (بذاكرة فيديو 32 جيجابايت).
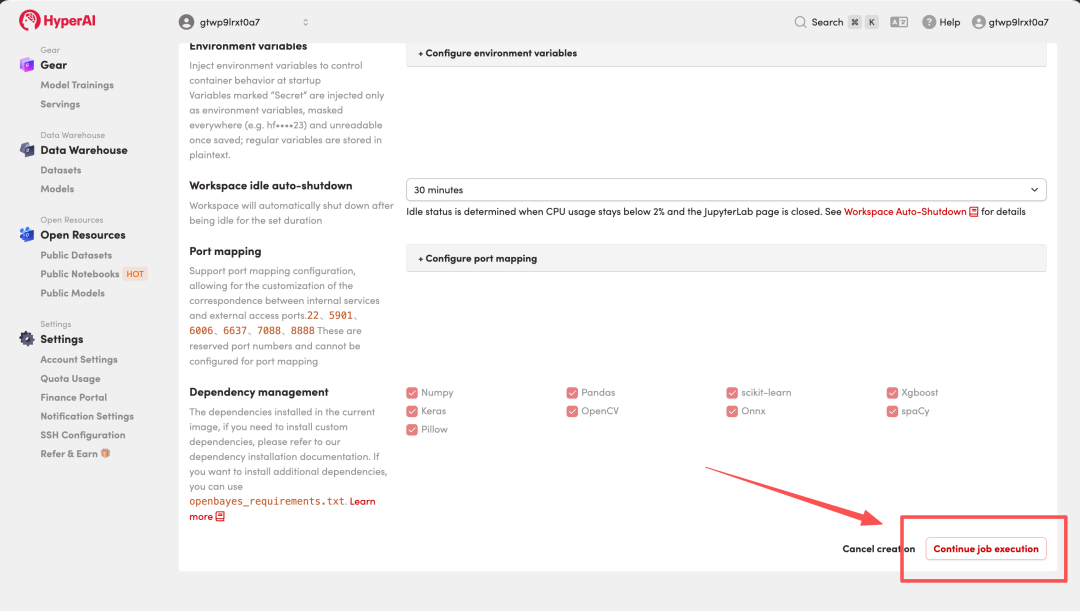
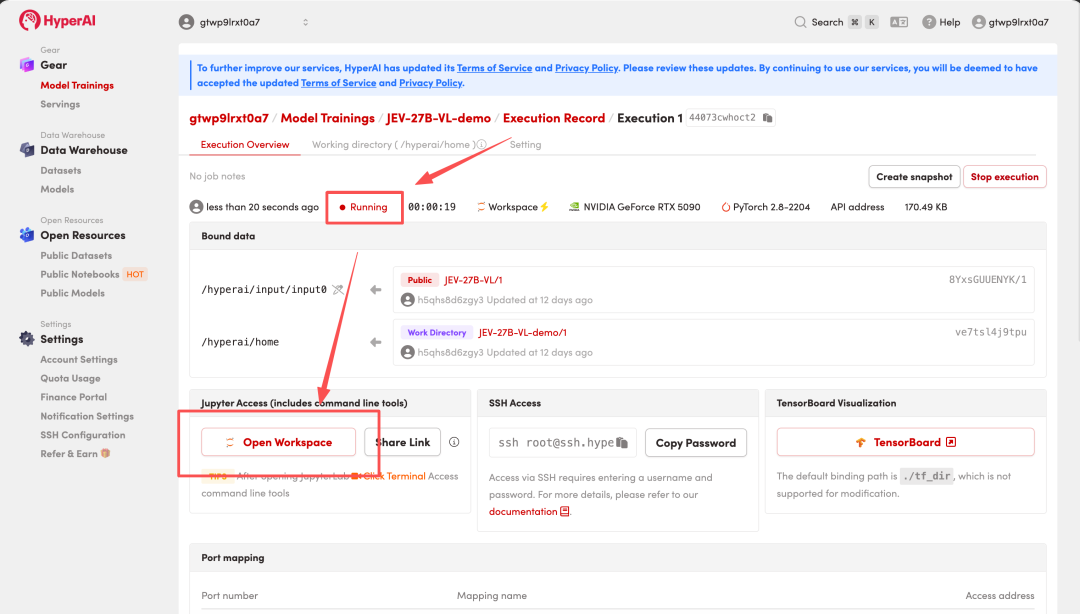
- انتظر تخصيص الموارد، وعند تحول الحالة إلى «Running (قيد التشغيل)»، انقر على «Open Workspace» للدخول إلى مساحة عمل Jupyter.
عرض النتائج
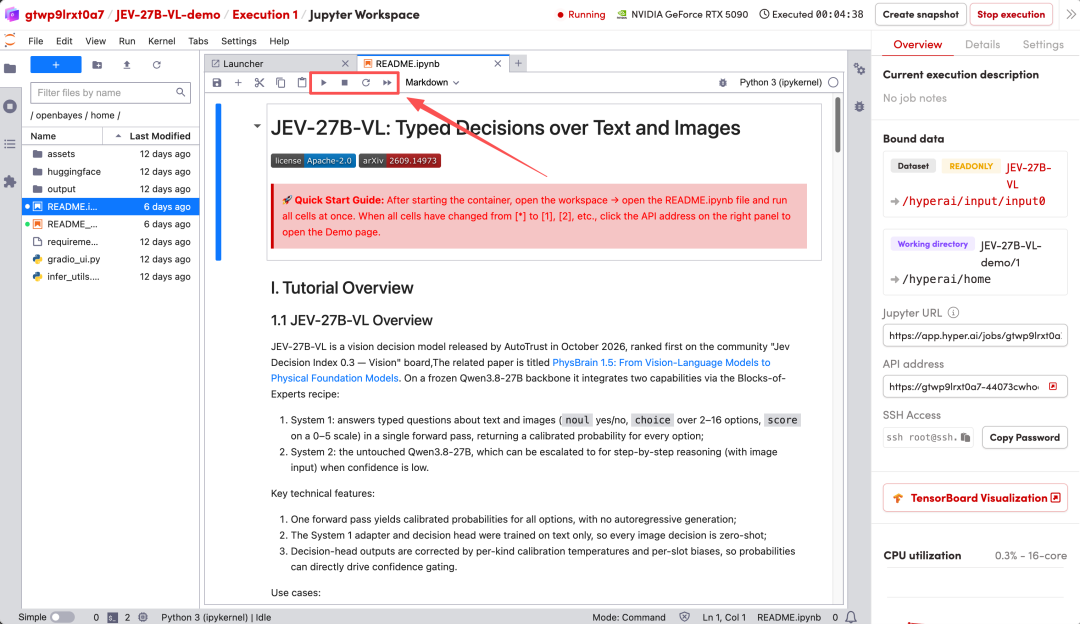
- بعد تحويل الصفحة، انقر على ملف README على اليسار، ثم انقر على «Run (تشغيل)» في الأعلى.
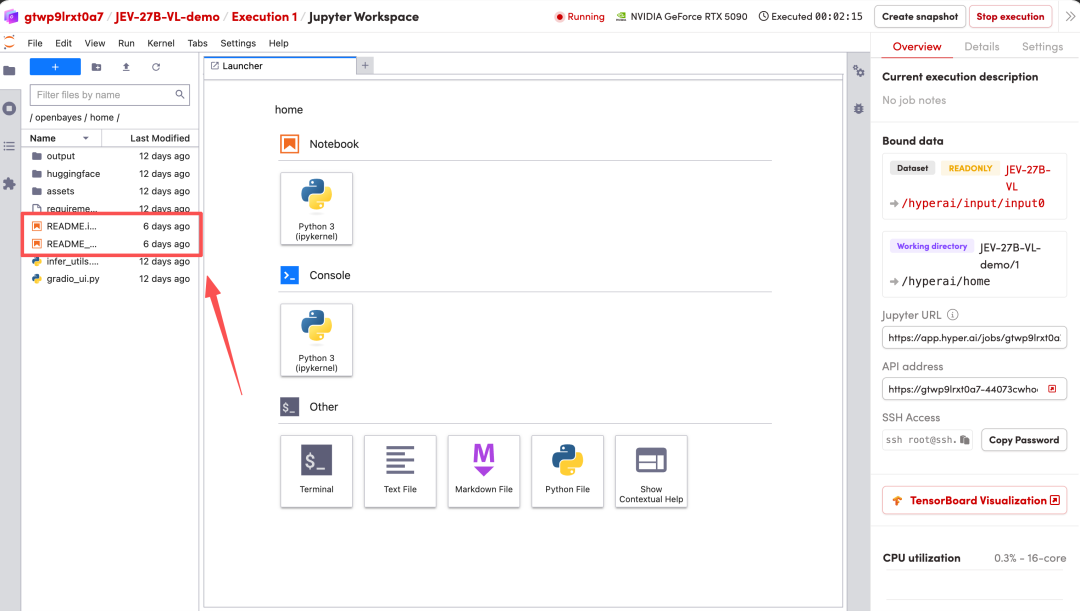
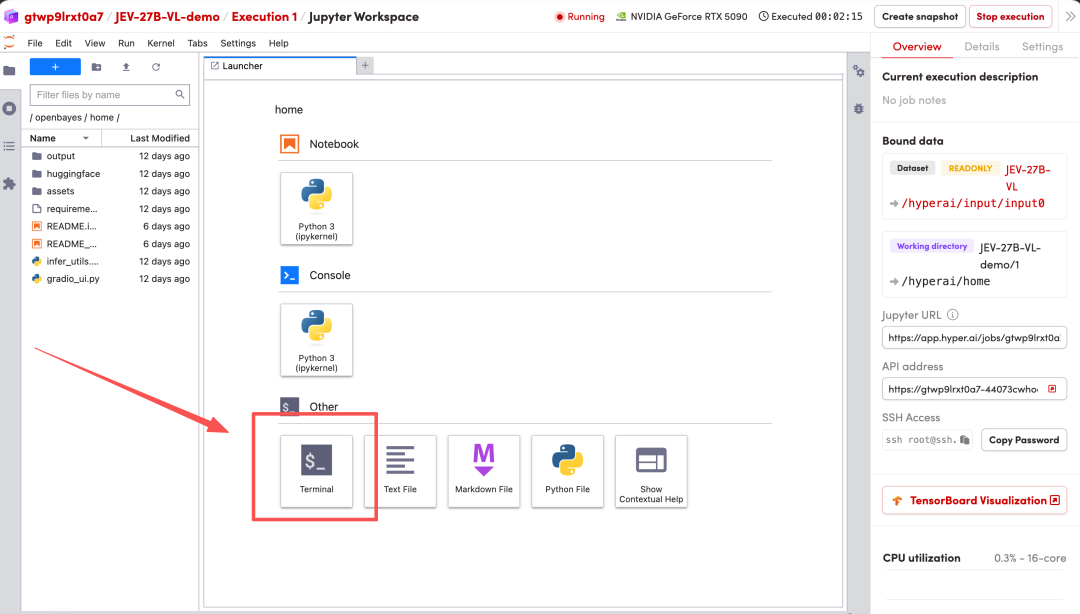
- بعد اكتمال التشغيل، افتح طرفية جديدة ونفذ الأوامر التالية لتشغيل Open WebUI.
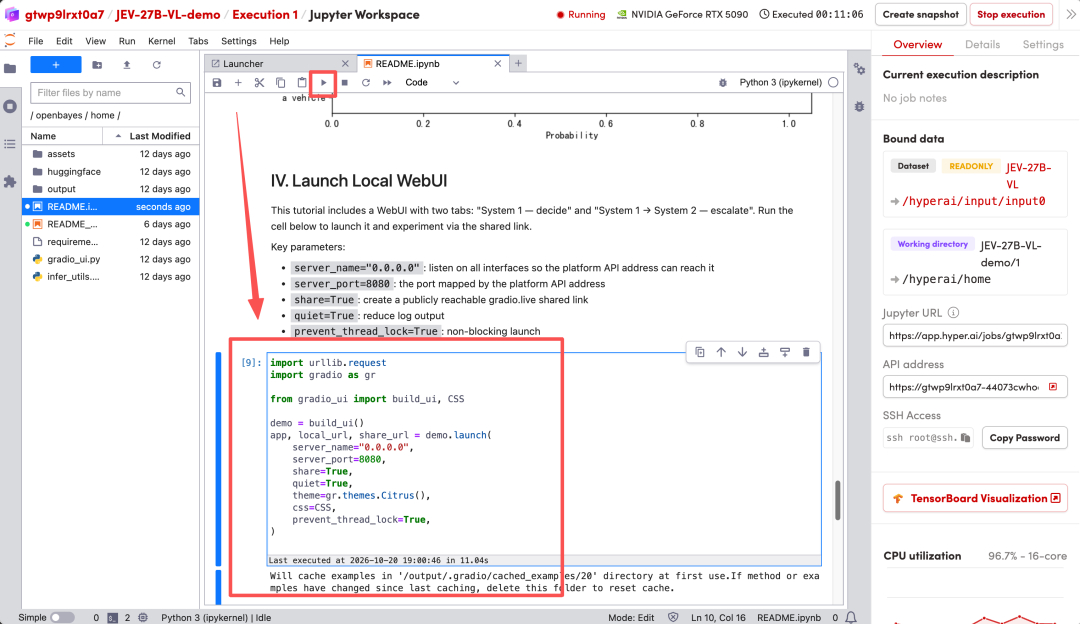
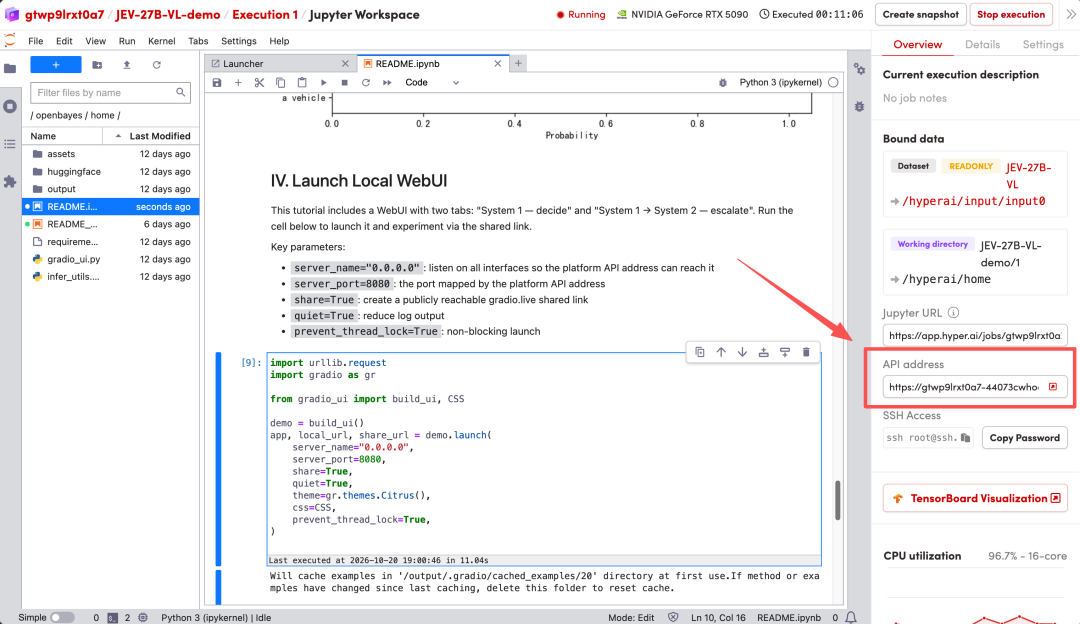
- بعد التشغيل، انقر على عنوان API على اليمين للوصول إلى واجهة Open WebUI عبر المتصفح.