Command Palette
Search for a command to run...
TimesFM 3.0 يتنبأ بالسلاسل الزمنية بدون عينات، ويغطي احتياجات التحليل متعدد السيناريوهات؛ VLX-Seek يدمج تحديد المواقع المستهدفة مع الفهم الدقيق، ويوسع قدرات الإدراك البصري التجسيدي
VLX-Seek هو نموذج لغوي بصري ذو إدراك دقيق أطلقته OmAI Lab في يوليو 2026، موجه للتطبيقات البصرية المجسدة على الأجهزة الطرفية مثل الروبوتات والطائرات بدون طيار. لمعالجة مشكلة صعوبة تحديد الكائن الذي يشير إليه الأمر في المهام الفعلية، يجمع هذا النموذج بين فهم اللغة والإدراك البصري على مستوى المنطقة، ويدعم البحث بناءً على خصائص الهدف وعلاقات الإحالة، ويقوم بالتعرف على النصوص ووصف المحتوى والعدّ حول المنطقة المحددة. بالإضافة إلى ذلك، يقدم النموذج آلية رفض عند غياب الهدف، مما يوفر أساسًا للبحث اللاحق وتعديل المهام. يوسع VLX-Seek نطاق تطبيق النماذج البصرية ليشمل التعرف على الكائنات المحددة والتفاعل معها، مما يوفر دعمًا للقدرات الأساسية لربط الإدراك البيئي واتخاذ القرارات الحركية في الأنظمة الذكية المجسدة.
حاليًا، تم إطلاق «VLX-Seek: نموذج لغوي بصري ذو إدراك دقيق» على الموقع الرسمي لـ HyperAI، جربوه الآن~
الاستخدام عبر الإنترنت: https://go.hyper.ai/oeM9
من 18 سبتمبر إلى 24 سبتمبر، ملخص تحديثات الموقع الرسمي hyper.ai:
-
مجموعات بيانات عامة عالية الجودة: 5
-
دروس تعليمية مميزة: 8
-
مصطلحات موسوعية شائعة: 5
-
مؤتمرات كبرى تنتهي مواعيد التقديم في أكتوبر: 5
زيارة الموقع الرسمي: hyper.ai
مجموعات البيانات العامة المختارة
1. مجموعة بيانات GooseReason-0.7M للاستدلال والتحقق في التعلم المعزز
GooseReason-0.7M هي مجموعة بيانات واسعة النطاق للاستدلال والتحقق في التعلم المعزز (RLVR) أصدرتها NVIDIA في عام 2026، وتهدف إلى حل عنق الزجاجة المتمثل في ندرة بيانات التدريب القابلة للتحقق، من خلال خط إنتاج Golden Goose لتوليد مهام RLVR غير محدودة من النصوص الإنترنتية الغنية بالاستدلال. تحتوي مجموعة البيانات على أكثر من 700 ألف مهمة، تغطي مجالات الرياضيات والبرمجة والعلوم العامة، بحجم بيانات يصل إلى مستوى 0.7M، وتستخدم بشكل أساسي لتدريب نموذج GooseReason-4B-Instruct، الذي حقق نتائج حديثة على مستوى نماذج 4B في 15 معيارًا تشمل الرياضيات والبرمجة واستدلال STEM واتباع التعليمات والألغاز المنطقية.
الاستخدام عبر الإنترنت: https://go.hyper.ai/eQ6X7
2. مجموعة بيانات GR1-100 لتوضيحات عمليات الروبوتات
GR1-100 هي مجموعة بيانات لعمليات الروبوتات أصدرتها NVIDIA في عام 2025، وتحتوي على 92 مقطع فيديو، وتهدف إلى توفير بيانات فيديو عالية الجودة لتدريب الروبوتات. البيانات بتنسيق MP4، بحجم إجمالي يبلغ حوالي 142.3 ميجابايت، ومناسبة للبحث في مجالات الرؤية الحاسوبية وتعلم الروبوتات. تسجل مجموعة البيانات بشكل أساسي مقاطع فيديو من منظور الشخص الثالث لروبوت Fourier يُدعى GR1-T2 وهو ينفذ مهامًا مختلفة في بيئة المختبر.
الاستخدام عبر الإنترنت: https://go.hyper.ai/BulTI
3. مجموعة بيانات GraspGen: Scaling Sim2Real Grasping لتوليد الإمساك
GraspGen: Scaling Sim2Real Grasping هي مجموعة بيانات واسعة النطاق للإمساك بالمحاكاة أصدرتها NVIDIA في عام 2025، وتحتوي على أكثر من 57 مليون عملية إمساك، تم توليدها بناءً على 8,515 كائنًا من مجموعة بيانات Objaverse XL (LVIS)، ومصممة خصيصًا لـ Franka Panda وRobotiq-2f-140 وملاقط الشفط أحادية نقطة التلامس (نصف قطر 30 مم). تهدف إلى تعزيز قدرة نقل مهارات الإمساك للروبوتات من المحاكاة إلى الواقع من خلال بيانات المحاكاة واسعة النطاق. تستخدم مجموعة البيانات تنسيق WebDataset، وتحتوي إجمالاً على أكثر من 57 مليون عملية إمساك بالمحاكاة، وتغطي ثلاثة أنواع مختلفة من ملاقط الروبوتات، ومناسبة للبحث في مجالات إمساك الروبوتات والنقل من المحاكاة إلى الواقع (Sim2Real) وتعلم الروبوتات.
الاستخدام عبر الإنترنت: https://go.hyper.ai/81LdN
4. مجموعة بيانات LiveCodeBench-CPP لتقييم توليد الأكواد
LiveCodeBench-CPP هي مجموعة بيانات لتقييم توليد أكواد C++ أصدرتها NVIDIA في عام 2025، وتهدف إلى توفير معيار تقييم لقدرات توليد الأكواد وتصحيح الأخطاء للنماذج اللغوية الكبيرة بناءً على أحدث المسائل البرمجية. تحتوي مجموعة البيانات على 454 مسألة برمجية، مصدرها الرئيسي AtCoder (287 مسألة) وLeetCode (167 مسألة)، وتغطي المسابقات والمسائل من أكتوبر 2024 إلى مايو 2025. تتضمن البيانات وصف المسائل ومصدر المنصة والدرجة وحالات الاختبار والبيانات الوصفية ذات الصلة، وتستخدم بشكل أساسي لتقييم قدرة النماذج على توليد الأكواد وحل المشكلات في مهام البرمجة الحقيقية.
الاستخدام عبر الإنترنت: https://go.hyper.ai/YdSXz
5. مجموعة بيانات HelpSteer لمواءمة المساعدة
HelpSteer هي مجموعة بيانات أصدرتها NVIDIA في عام 2023 لمواءمة النماذج اللغوية الكبيرة، وتهدف إلى تحسين مساعدة الإجابات وصحتها وتماسكها، ودعم تعديل درجة التعقيد والتفاصيل في الردود. تحتوي مجموعة البيانات على 37,120 عينة، تغطي أنواع مهام متعددة مثل إعادة الكتابة والتلخيص والتصنيف والاستخراج والأسئلة والأجوبة. تتضمن كل عينة موجه النص واستجابة النموذج وتقييمات من خمس سمات تم وضع علامات عليها يدويًا: المساعدة والصحة والتماسك والتعقيد ودرجة التفاصيل، بنطاق تقييم من 0 إلى 4. تم وضع العلامات على البيانات بواسطة منظمة Scale AI، وتستخدم بشكل أساسي لتدريب النماذج اللغوية الكبيرة وتقييمها وأبحاث مواءمة النماذج.
الاستخدام عبر الإنترنت: https://go.hyper.ai/B5OPS>>
دروس عامة مختارة
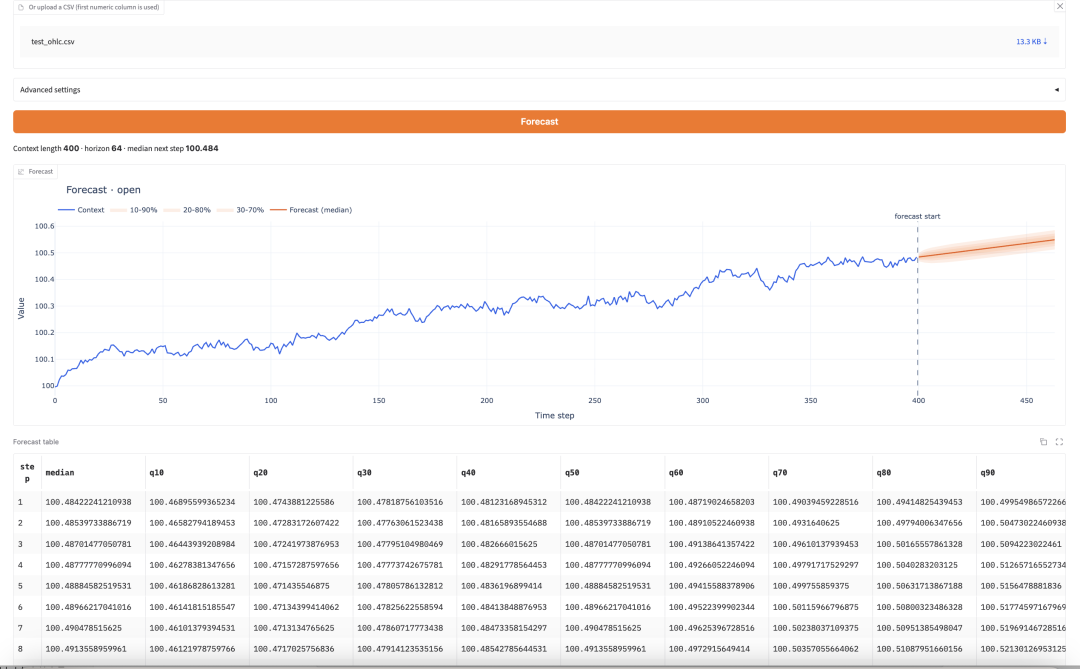
1. TimesFM 3.0: التنبؤ بالسلاسل الزمنية بدون عينات
TimesFM 3.0 هو نموذج أساسي للسلاسل الزمنية أطلقته Google Research في أغسطس 2026، ويعتمد على أسلوب التنبؤ المسبق بدون عينات، حيث يمكنه التنبؤ بسلاسل زمنية جديدة دون الحاجة إلى ضبط دقيق لمهمة محددة. يدعم النموذج بشكل أصلي الإدخال أحادي المتغير ومتعدد المتغيرات وإدخال المتغيرات المصاحبة، ويعزز قدرة التعميم بدون عينات، ويمكن استخدامه في سيناريوهات تحليل السلاسل الزمنية مثل مبيعات التجزئة والتحليل المالي والطقس والطلب على الطاقة والتنبؤ بسلسلة التوريد.
تشغيل عبر الإنترنت: https://go.hyper.ai/DRk3i
صفحة العرض التجريبي
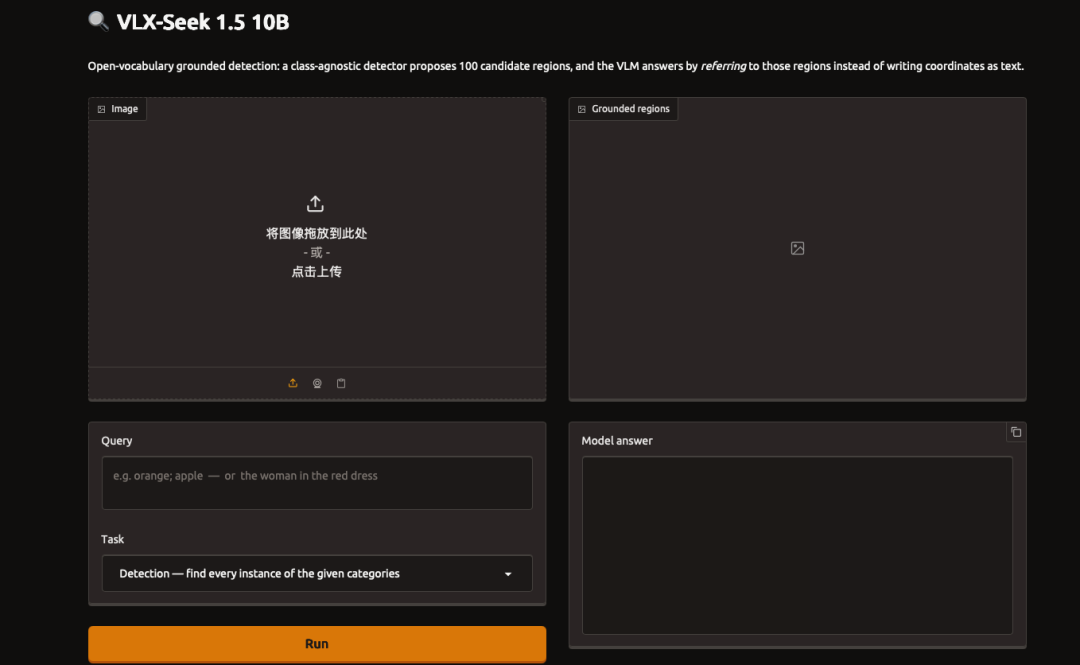
2. VLX-Seek: نموذج لغوي بصري ذو إدراك دقيق الحبيبات
VLX-Seek هو نموذج لغوي بصري (VLM) دقيق الحبيبات أطلقته OmAI Lab في يوليو 2026، ويستهدف سيناريوهات الرؤية التجسيدية على الأجهزة الطرفية، حيث يمكنه فهم محتوى الصورة مع إتمام تحديد المواقع المستهدفة والتمييز بين الحالات والإدراك البصري دقيق الحبيبات. يدعم النموذج اكتشاف الأهداف وفهم التعبيرات المرجعية ووصف المناطق والتعرف الضوئي على الحروف للمناطق والعد والكشف الاستدلالي، ويستخدم آلية رفض المفردات المفتوحة لإخراج None عندما لا يكون الهدف موجودًا، ويمكن استخدامه في السيناريوهات الذكية التجسيدية مثل الروبوتات والطائرات بدون طيار.
تشغيل عبر الإنترنت: https://go.hyper.ai/oeM92
صفحة العرض التجريبي
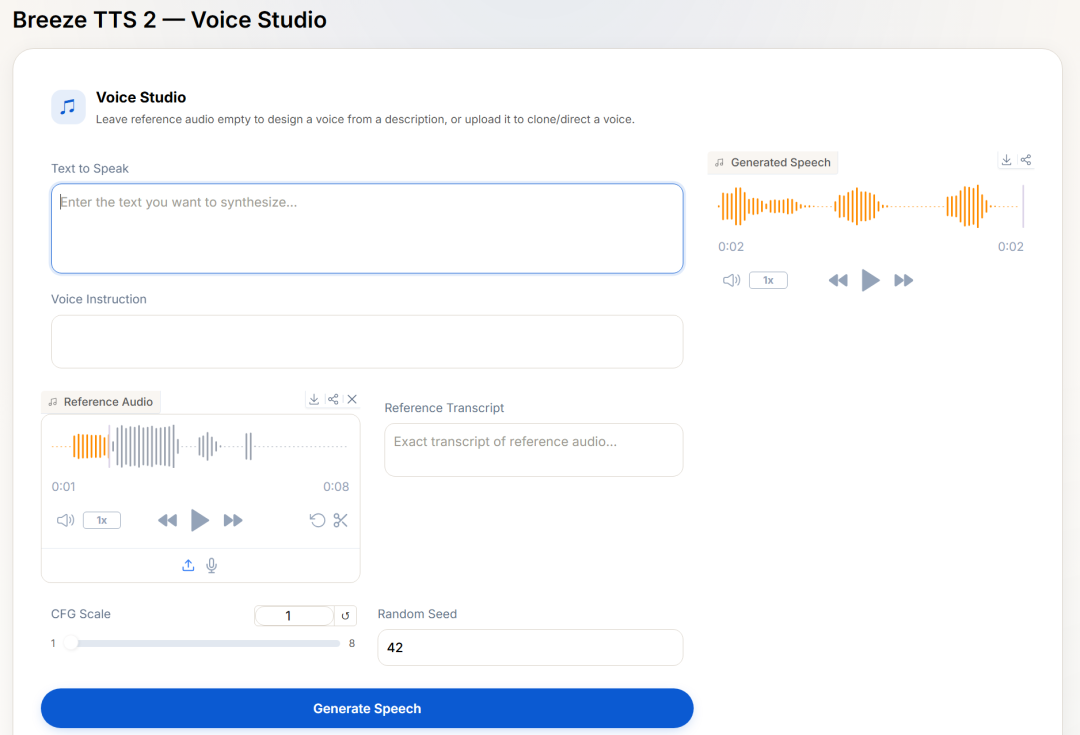
3. Breeze TTS 2 — نموذج تحويل نص إلى كلام مفتوح المصدر في الوقت الفعلي
Breeze TTS 2 هو نموذج تحويل نص إلى كلام بأوزان مفتوحة أطلقته فريق BreezeBlue في أغسطس 2026، ويستهدف سيناريوهات التفاعل الصوتي في الوقت الفعلي، ويدعم تصميم الصوت واستنساخ الصوت والتحكم في المشاعر عبر اللغة الطبيعية. يدعم النموذج اللغتين الصينية والإنجليزية، ويمكنه ضبط النبرة وسرعة الكلام والمشاعر عبر تعليمات نصية، ويدعم الأحداث الصوتية مثل الضحك والتنهد بالإضافة إلى التوليد المتدفق فائق الانخفاض في زمن الاستجابة، ويمكن استخدامه في سيناريوهات مثل المساعدين الصوتيين في الوقت الفعلي والمحتوى الصوتي والترجمة الصوتية المحلية وخدمات الوصول.
تشغيل عبر الإنترنت: https://go.hyper.ai/JStch
صفحة العرض التجريبي
4. دروس تمهيدية في التعلم الإحصائي
تم نشر هذا الدرس بواسطة مستخدم Kaggle DATAI في عام 2018، ويستخدم مجموعة بيانات تشخيص سرطان الثدي في ويسكونسن كمثال، ويشرح من الصفر أساسيات التعلم الإحصائي وطرق التحليل الشائعة. يغطي الدرس استكشاف البيانات والتصور، والإحصاءات الوصفية مثل المتوسط والتباين، ودوال التوزيع التراكمي، وحجم التأثير والارتباط، واختبار الفرضيات وقيمة p، بالإضافة إلى التوزيع الطبيعي وحساب درجة Z، وهو مناسب للمبتدئين في التعلم الإحصائي.
تشغيل عبر الإنترنت: https://go.hyper.ai/fVzMx
5. درس تدريب EfficientDet: اكتشاف أهداف سنابل القمح
يعتمد هذا الدرس على خط التدريب الذي بناه Alex Shonenkov لمسابقة Kaggle Global Wheat Detection، ويطبق من الصفر نموذج اكتشاف الأهداف EfficientDet. يغطي الدرس إعداد البيئة وفحص وحدة معالجة الرسومات، وتحميل مجموعة بيانات المسابقة، وتعزيز البيانات باستخدام Albumentations، وبناء نموذج EfficientDet-D5 وخط التدريب الكامل، وهو مناسب للمطورين الذين يرغبون في تعلم تدريب نماذج اكتشاف الأهداف وتطبيقها العملي.
تشغيل عبر الإنترنت: https://go.hyper.ai/AtDMM
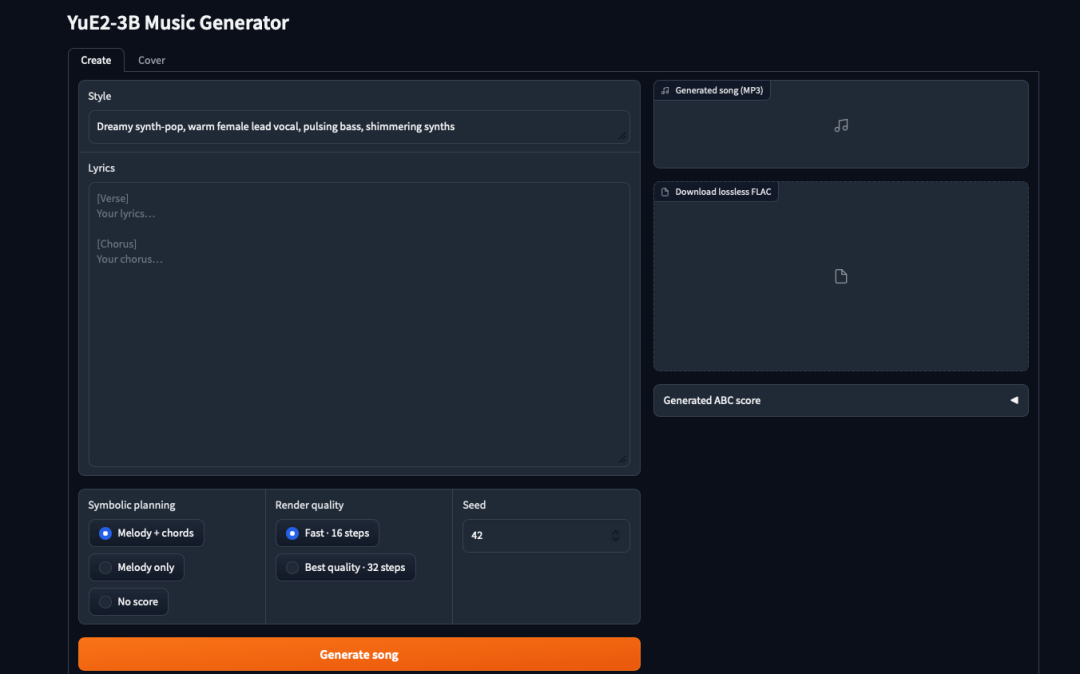
6. YuE2-3B: نموذج توليد موسيقى مفتوح المصدر متقدم
YuE2-3B هو نموذج توليد موسيقى مفتوح المصدر أطلقته فريق Multimodal Art Projection (m-a-p) في عام 2026، ويمكنه توليد أغانٍ كاملة تتضمن الغناء والمرافقة بناءً على كلمات الأغاني وتلميحات الأسلوب. يعتمد النموذج على بنية AR–NAR Mixture-of-Transformers، ويدعم ثلاثة أوضاع: اللحن مع الأوتار، واللحن فقط، والتوليد المباشر، ويدعم إخراج استريو 48 كيلوهرتز، ويمكن استخدامه في سيناريوهات مثل توليد الموسيقى من النصوص وإعادة غناء الأغاني والتحرير الموسيقي الذكي.
تشغيل عبر الإنترنت: https://go.hyper.ai/t4G7M
صفحة العرض التجريبي
7. درس تطوير مشغل فيديو FFmpeg: من التقاط الإطارات إلى القفز
تم اقتباس هذه السلسلة من الدروس من الدرس الكلاسيكي "An ffmpeg and SDL Tutorial" الذي نشره Stephen Dranger في عام 2015، ويتم إعادة تنفيذ المحتوى الأساسي باستخدام Python وأدوات سطر الأوامر FFmpeg، مع شرح مبدأ عمل الصوت والفيديو الرقمي من الصفر. يغطي الدرس المفاهيم الأساسية مثل الحاويات والتدفقات والترميزات وحزم البيانات والإطارات والطوابع الزمنية، ويقوم بتطبيق مزامنة الفيديو ومزامنة الصوت ومعالجة الوسائط خطوة بخطوة من خلال تجارب قابلة للتشغيل، وهو مناسب لتعلم التقنيات المتعلقة بالمشغلات والتحويل والبث المباشر ورؤية الكمبيوتر.
تشغيل عبر الإنترنت: https://go.hyper.ai/rtrW4
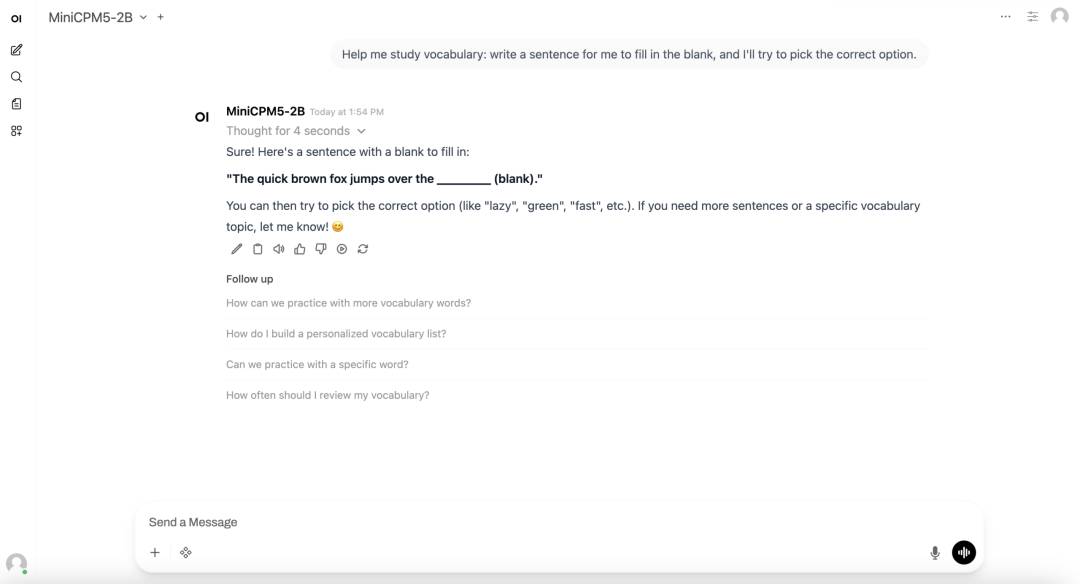
8. MiniCPM5-2B: استدلال نموذج لغوي كبير متطور بمستوى 2B على الأجهزة الطرفية
MiniCPM5-2B هو نموذج لغوي كبير مفتوح المصدر بمستوى 2B أطلقته OpenBMB في سبتمبر 2026، وهو النموذج الثاني في سلسلة MiniCPM5، ويعتمد بنية LlamaForCausalLM القياسية، وهو مصمم للنشر على الأجهزة الطرفية والاستدلال المحلي وسيناريوهات الموارد المحدودة. يدعم النموذج سياقًا يصل إلى 131K، ويتمتع بقدرات الاستدلال البرمجي والرياضي واستدعاء الأدوات والوكيل، ويمكن استخدامه في المساعد الذكي المحلي والمساعدة البرمجية والإجابة عن الأسئلة المعرفية وتطبيقات الوكيل الذكي وغيرها من السيناريوهات.
التشغيل عبر الإنترنت: https://go.hyper.ai/D8jnq
صفحة العرض التجريبي
مختارات من المقالات الشائعة في الموسوعة
1. التعرف الضوئي على الحروف OCR
2. نموذج العمل العالمي WAM
3. الاستشعار عن بعد Remote Sensing
4. الرمز المعطل Glitch Token
5. نموذج المحول التوليدي المُدرَّب مسبقًا GPT
تم هنا تجميع مئات المقالات المتعلقة بالذكاء الاصطناعي، لتتمكن من فهم "الذكاء الاصطناعي" من خلالها:
المؤتمرات المهمة ذات الموعد النهائي في أكتوبر
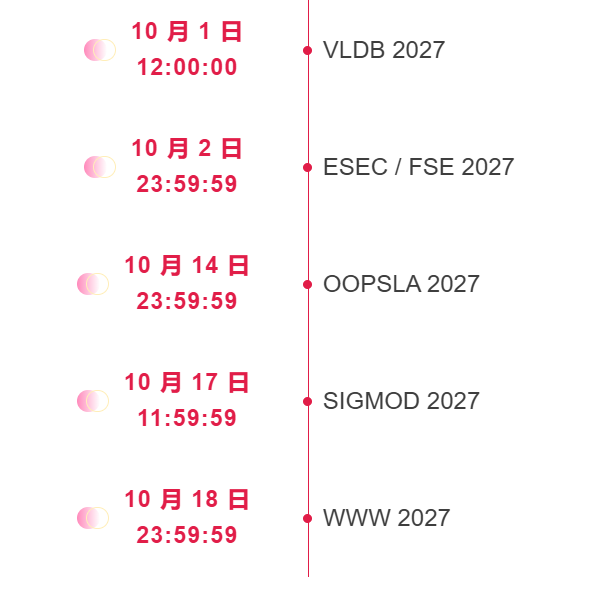
*الموعد النهائي للاستلام بتوقيت AoE
تتبع المؤتمرات الأكاديمية الرائدة في الذكاء الاصطناعي من مكان واحد: https://go.hyper.ai/event
هذا كل ما تضمنته مختارات تحرير هذا الأسبوع، إذا كان لديك موارد ترغب في إدراجها على الموقع الرسمي لـ hyper.ai، فلا تتردد في ترك تعليق أو إرسال مساهمة لنا!
نراكم الأسبوع القادم!