Command Palette
Search for a command to run...
オンラインチュートリアル丨毎回約3Bのみをアクティブ化、MiniCPM-V 4.7の端末側デコード速度は13+ tokens/sに到達
言語モデルが AI に読解と表現を学ばせたのだとすれば、マルチモーダルモデルはさらに、AI が世界を知覚する方法を拡張しました。画像内の物体の認識、グラフ内のデータの読み取りから、動画内で連続して起こる出来事の理解に至るまで、モデルが処理する必要があるのはもはや文字だけではなく、異なる情報形式の組み合わせであり、それらを推論や回答が可能な内容へ変換することが求められます。
面壁智能と OpenBMB コミュニティが提供する MiniCPM-V 4.7 は、視覚理解タスク向けのマルチモーダル視覚言語モデルです。 35B-A3B の混合エキスパート(MoE)アーキテクチャを採用し、総パラメータ数は 35B に達しますが、各 Token では約 3B のパラメータのみが活性化され、比較的大きなモデルの能力を維持しながら、推論時の計算コストを効果的に抑えます。
視覚理解の面では、MiniCPM-V 4.7 は単一画像、複数画像、動画の理解をサポートし、さまざまな種類の視覚入力を処理できます。モデルは Canvas M-RoPE 視覚位置エンコーディングと高効率視覚圧縮技術を導入し、モデルが画像内の空間関係や詳細情報をよりよく捉えるのに役立てています。複雑な視覚コンテンツに対しては、画面内の対象を認識するだけでなく、文脈を踏まえて画像情報を理解し、対応する質問応答や分析タスクを完了できます。
さらに興味深いのは、35B の総パラメータ数を持つこのようなモデルが、必ずしも大型サーバーに依存しなくても動作できるということです。 MiniCPM-V 4.7 は端末側推論向けに特別に最適化されています。Lookahead Expert Scheduling(LES)などの技術により、MoE モデルのエキスパート呼び出し効率を改善し、モデル性能を犠牲にすることなく、スムーズな端末側推論を実現します。細粒度階層量子化、DSpark 投機的サンプリングなどの技術を組み合わせることで、実行コストをさらに低減します。公式デモでは、モデルは iPhone 17 Pro Max 上で約 3GB のメモリで 13+ tokens/s のデコード速度を実現できるとのことです。つまり、マルチモーダルモデルは必ずしもクラウド上に存在する必要はなく、スマートフォンを手に取れば視覚理解能力を体験できるということです。
HyperAI では現在、「MiniCPM-V 4.7:マルチモーダル視覚言語大規模モデル(35B-A3B MoE)」を公開しています。低いハードルで、モデルが画像などの視覚入力をどのように理解するかを体験し、さらに、混合エキスパートアーキテクチャがエキスパートスケジューリングと推論最適化を通じて、モデル規模、計算コスト、実際の実行効率の間でどのようにバランスを取るかを理解できます。
オンライン実行:
その他のオンラインチュートリアル:
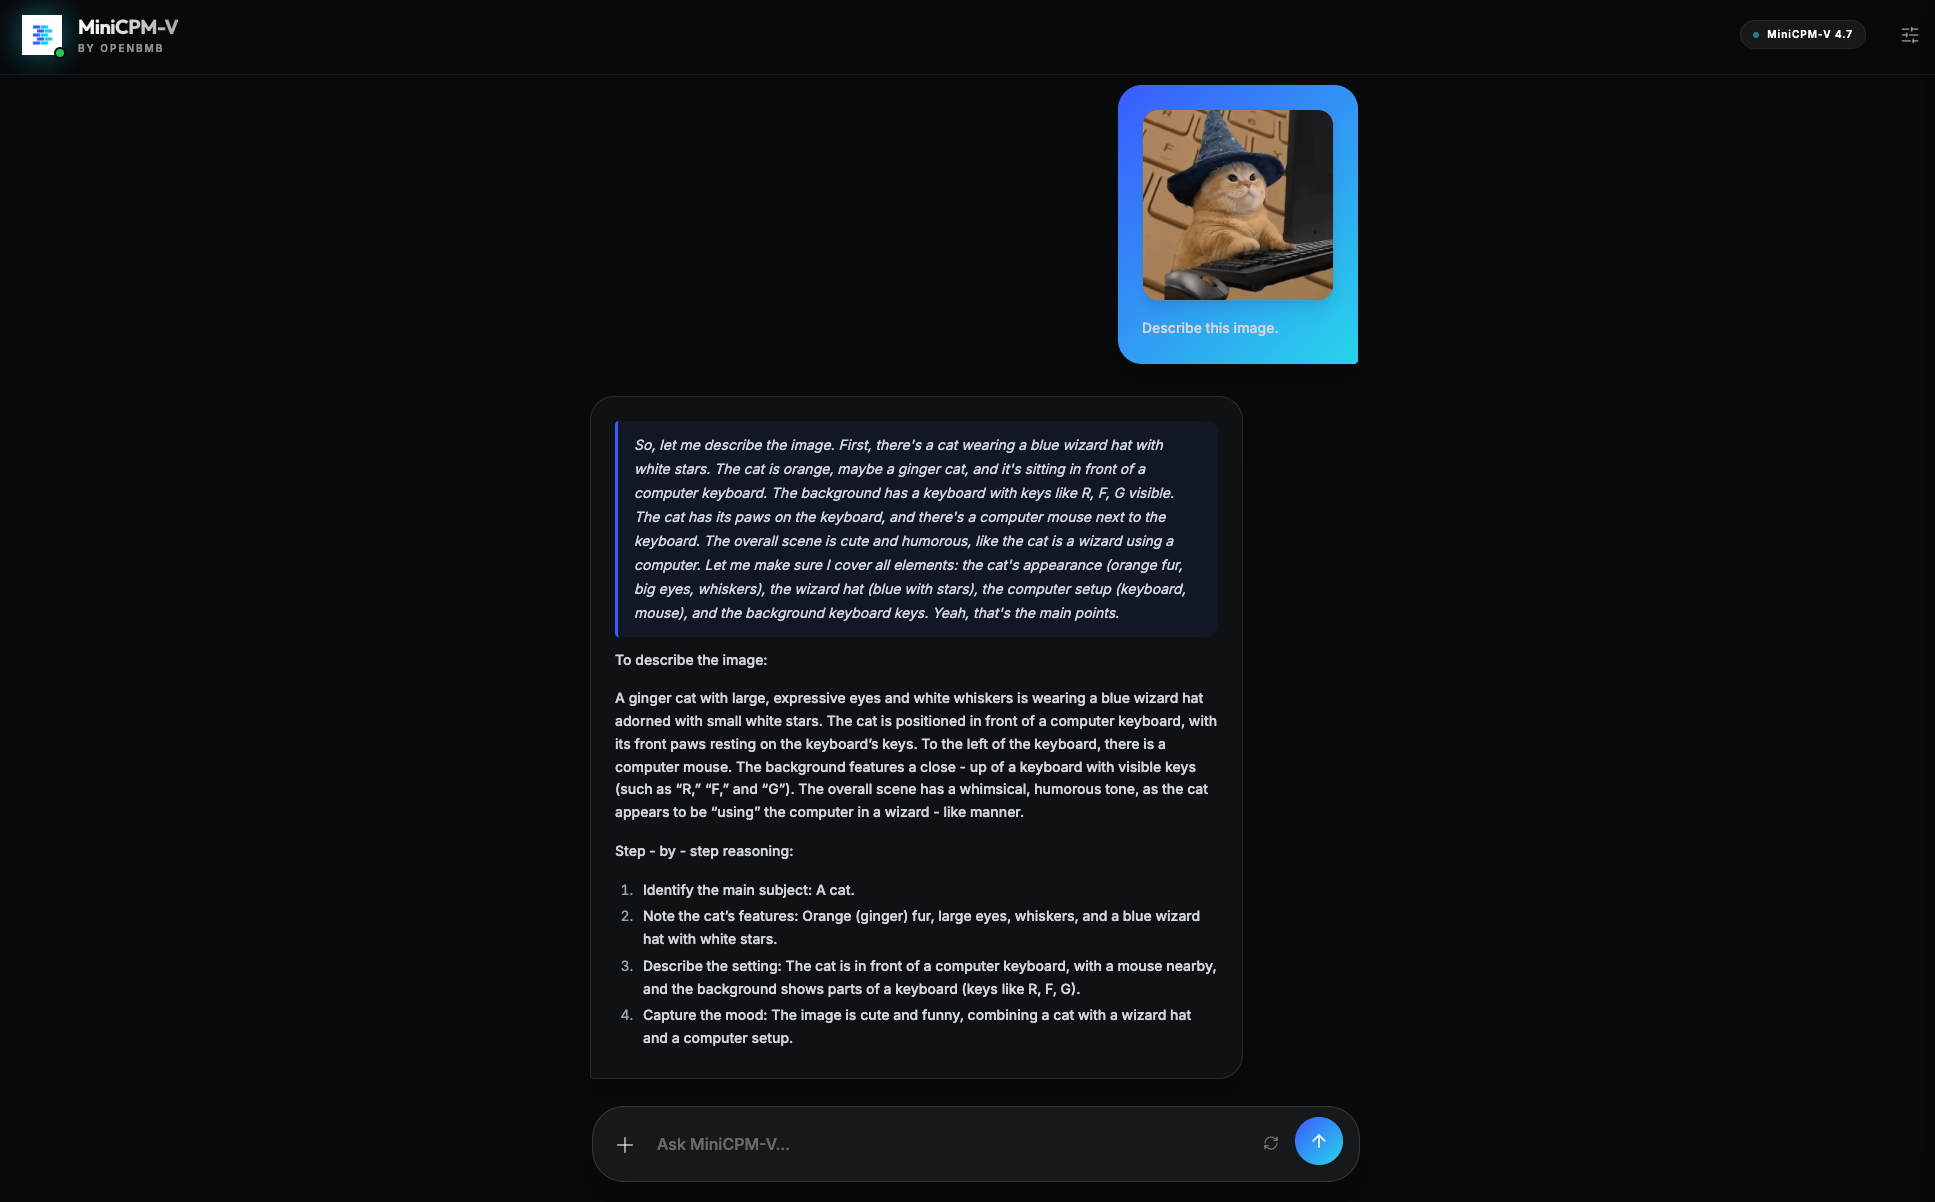
Demo の実行
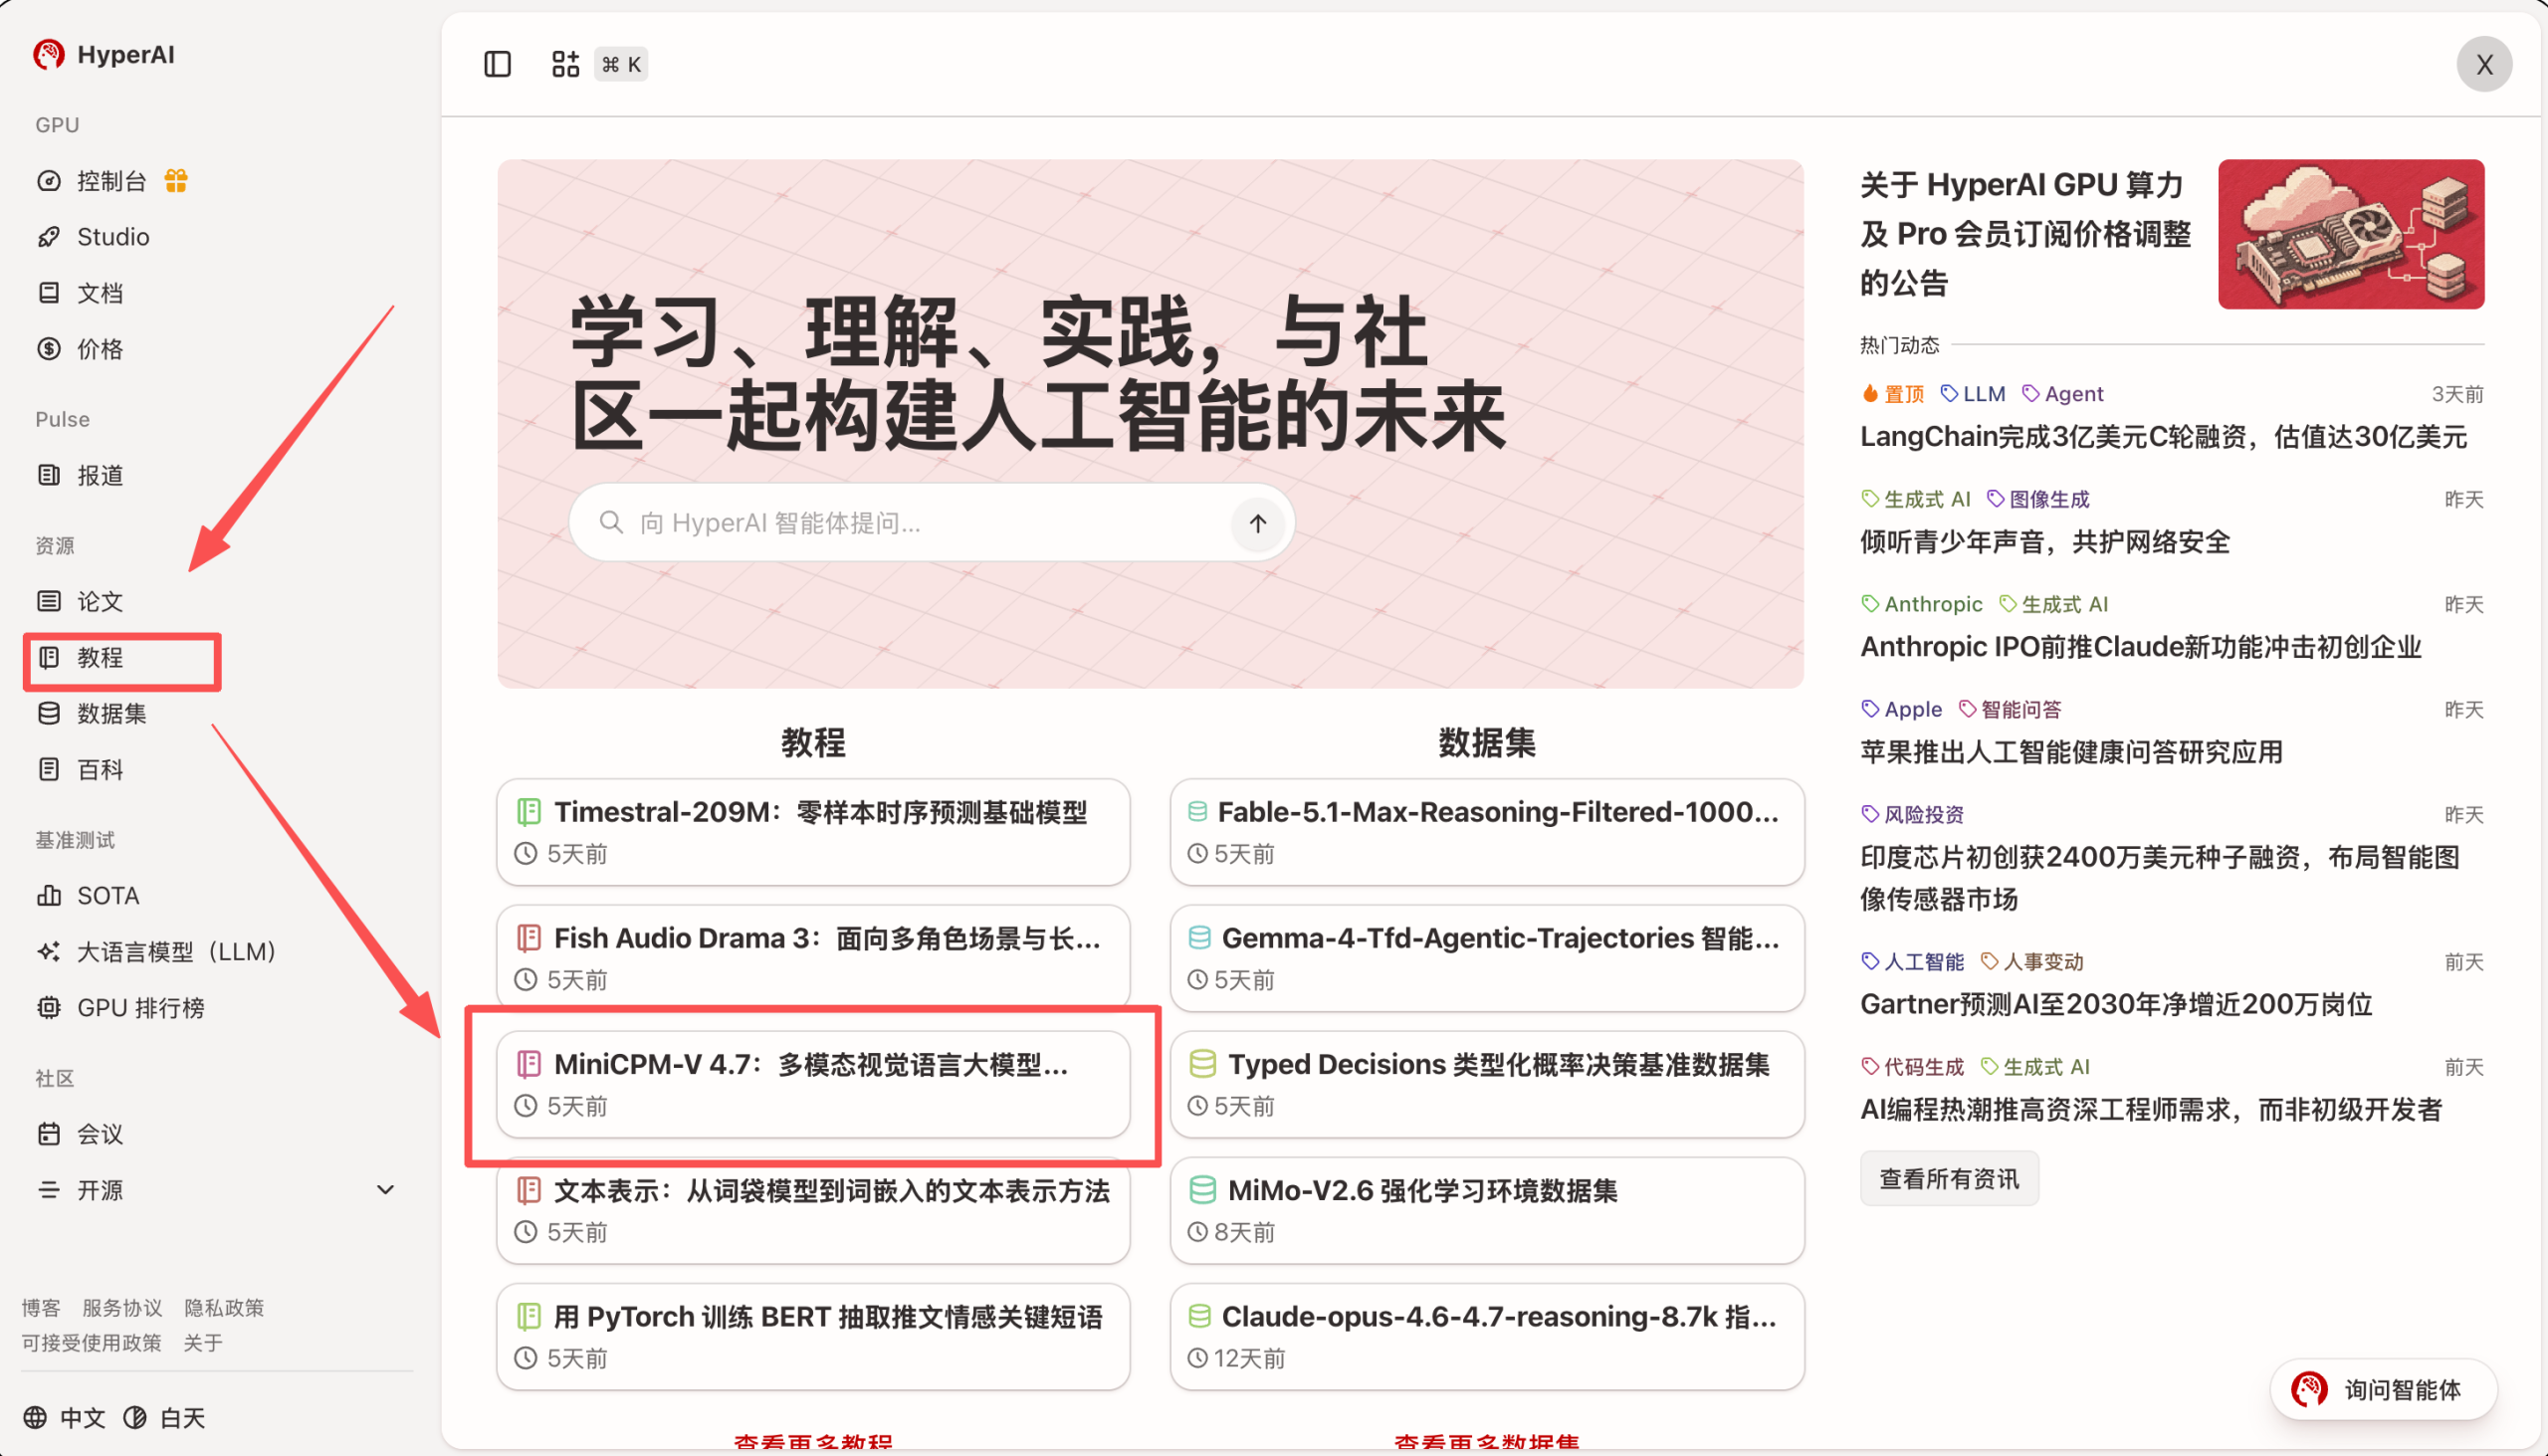
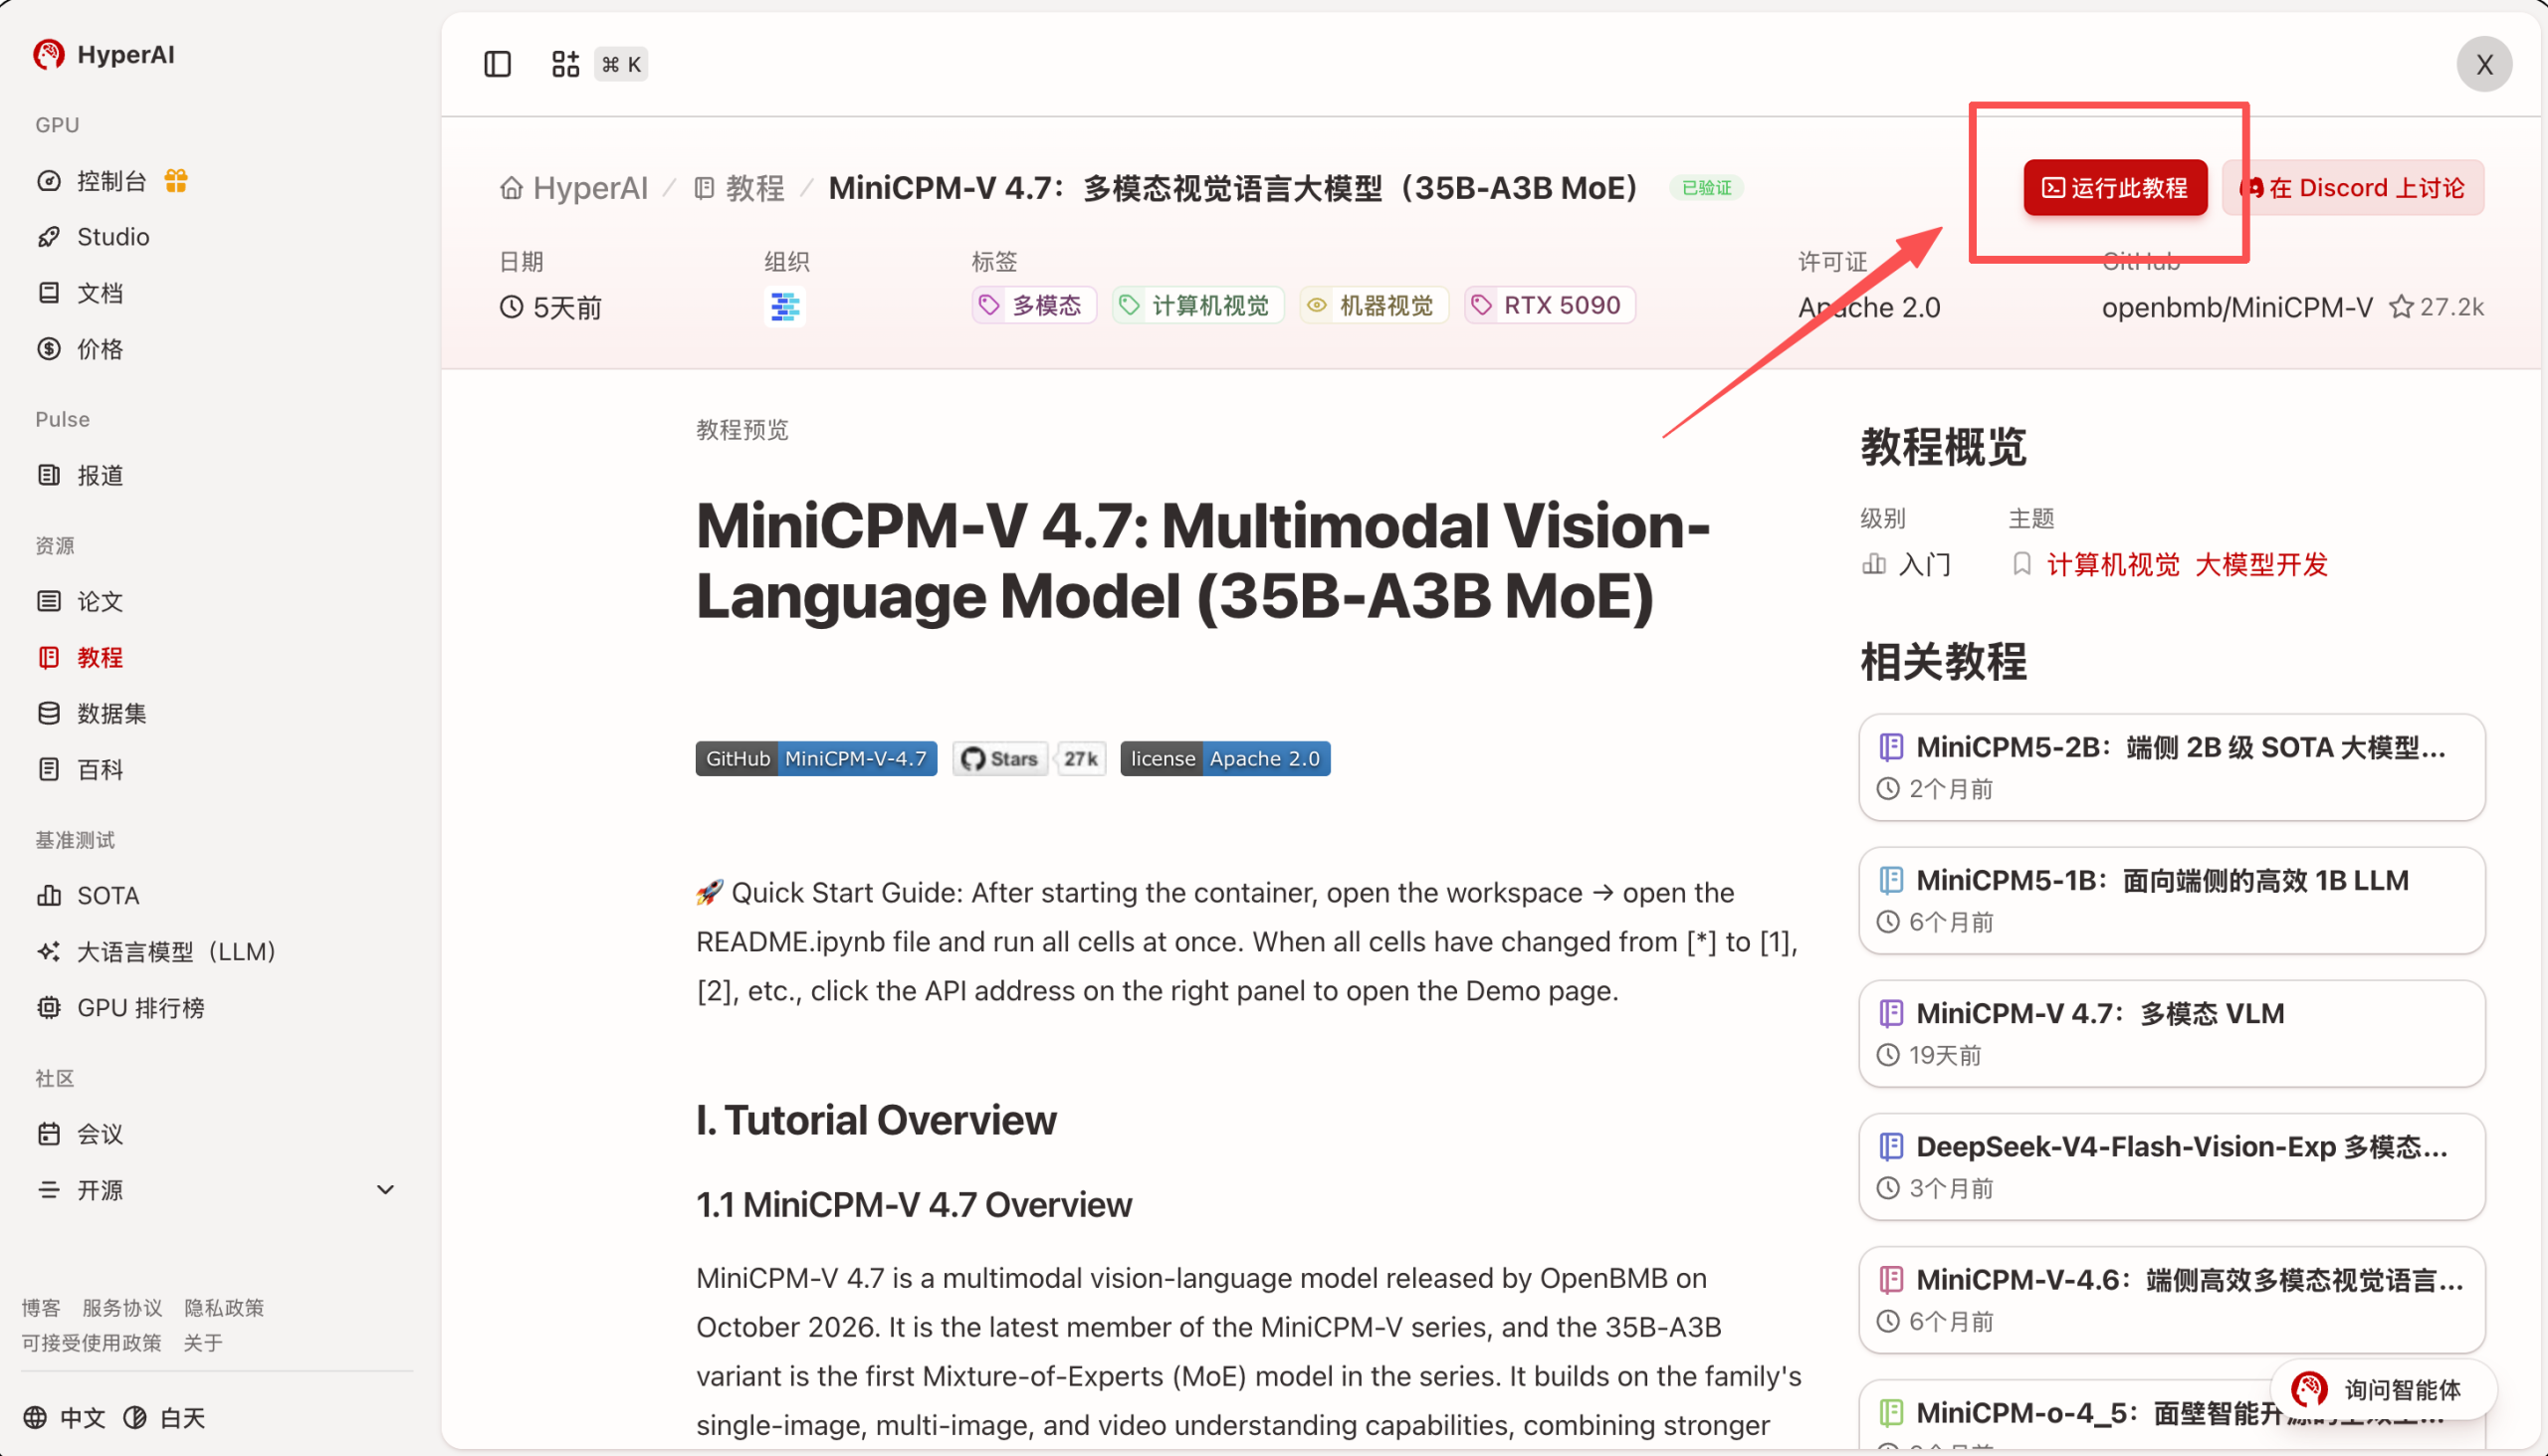
- hyper.ai のトップページに入ったら、「チュートリアル」ページを選択するか、「その他のチュートリアルを見る」をクリックし、「MiniCPM-V 4.7:マルチモーダル視覚言語大規模モデル(35B-A3B MoE)」を選択して、「このチュートリアルを実行」をクリックします。
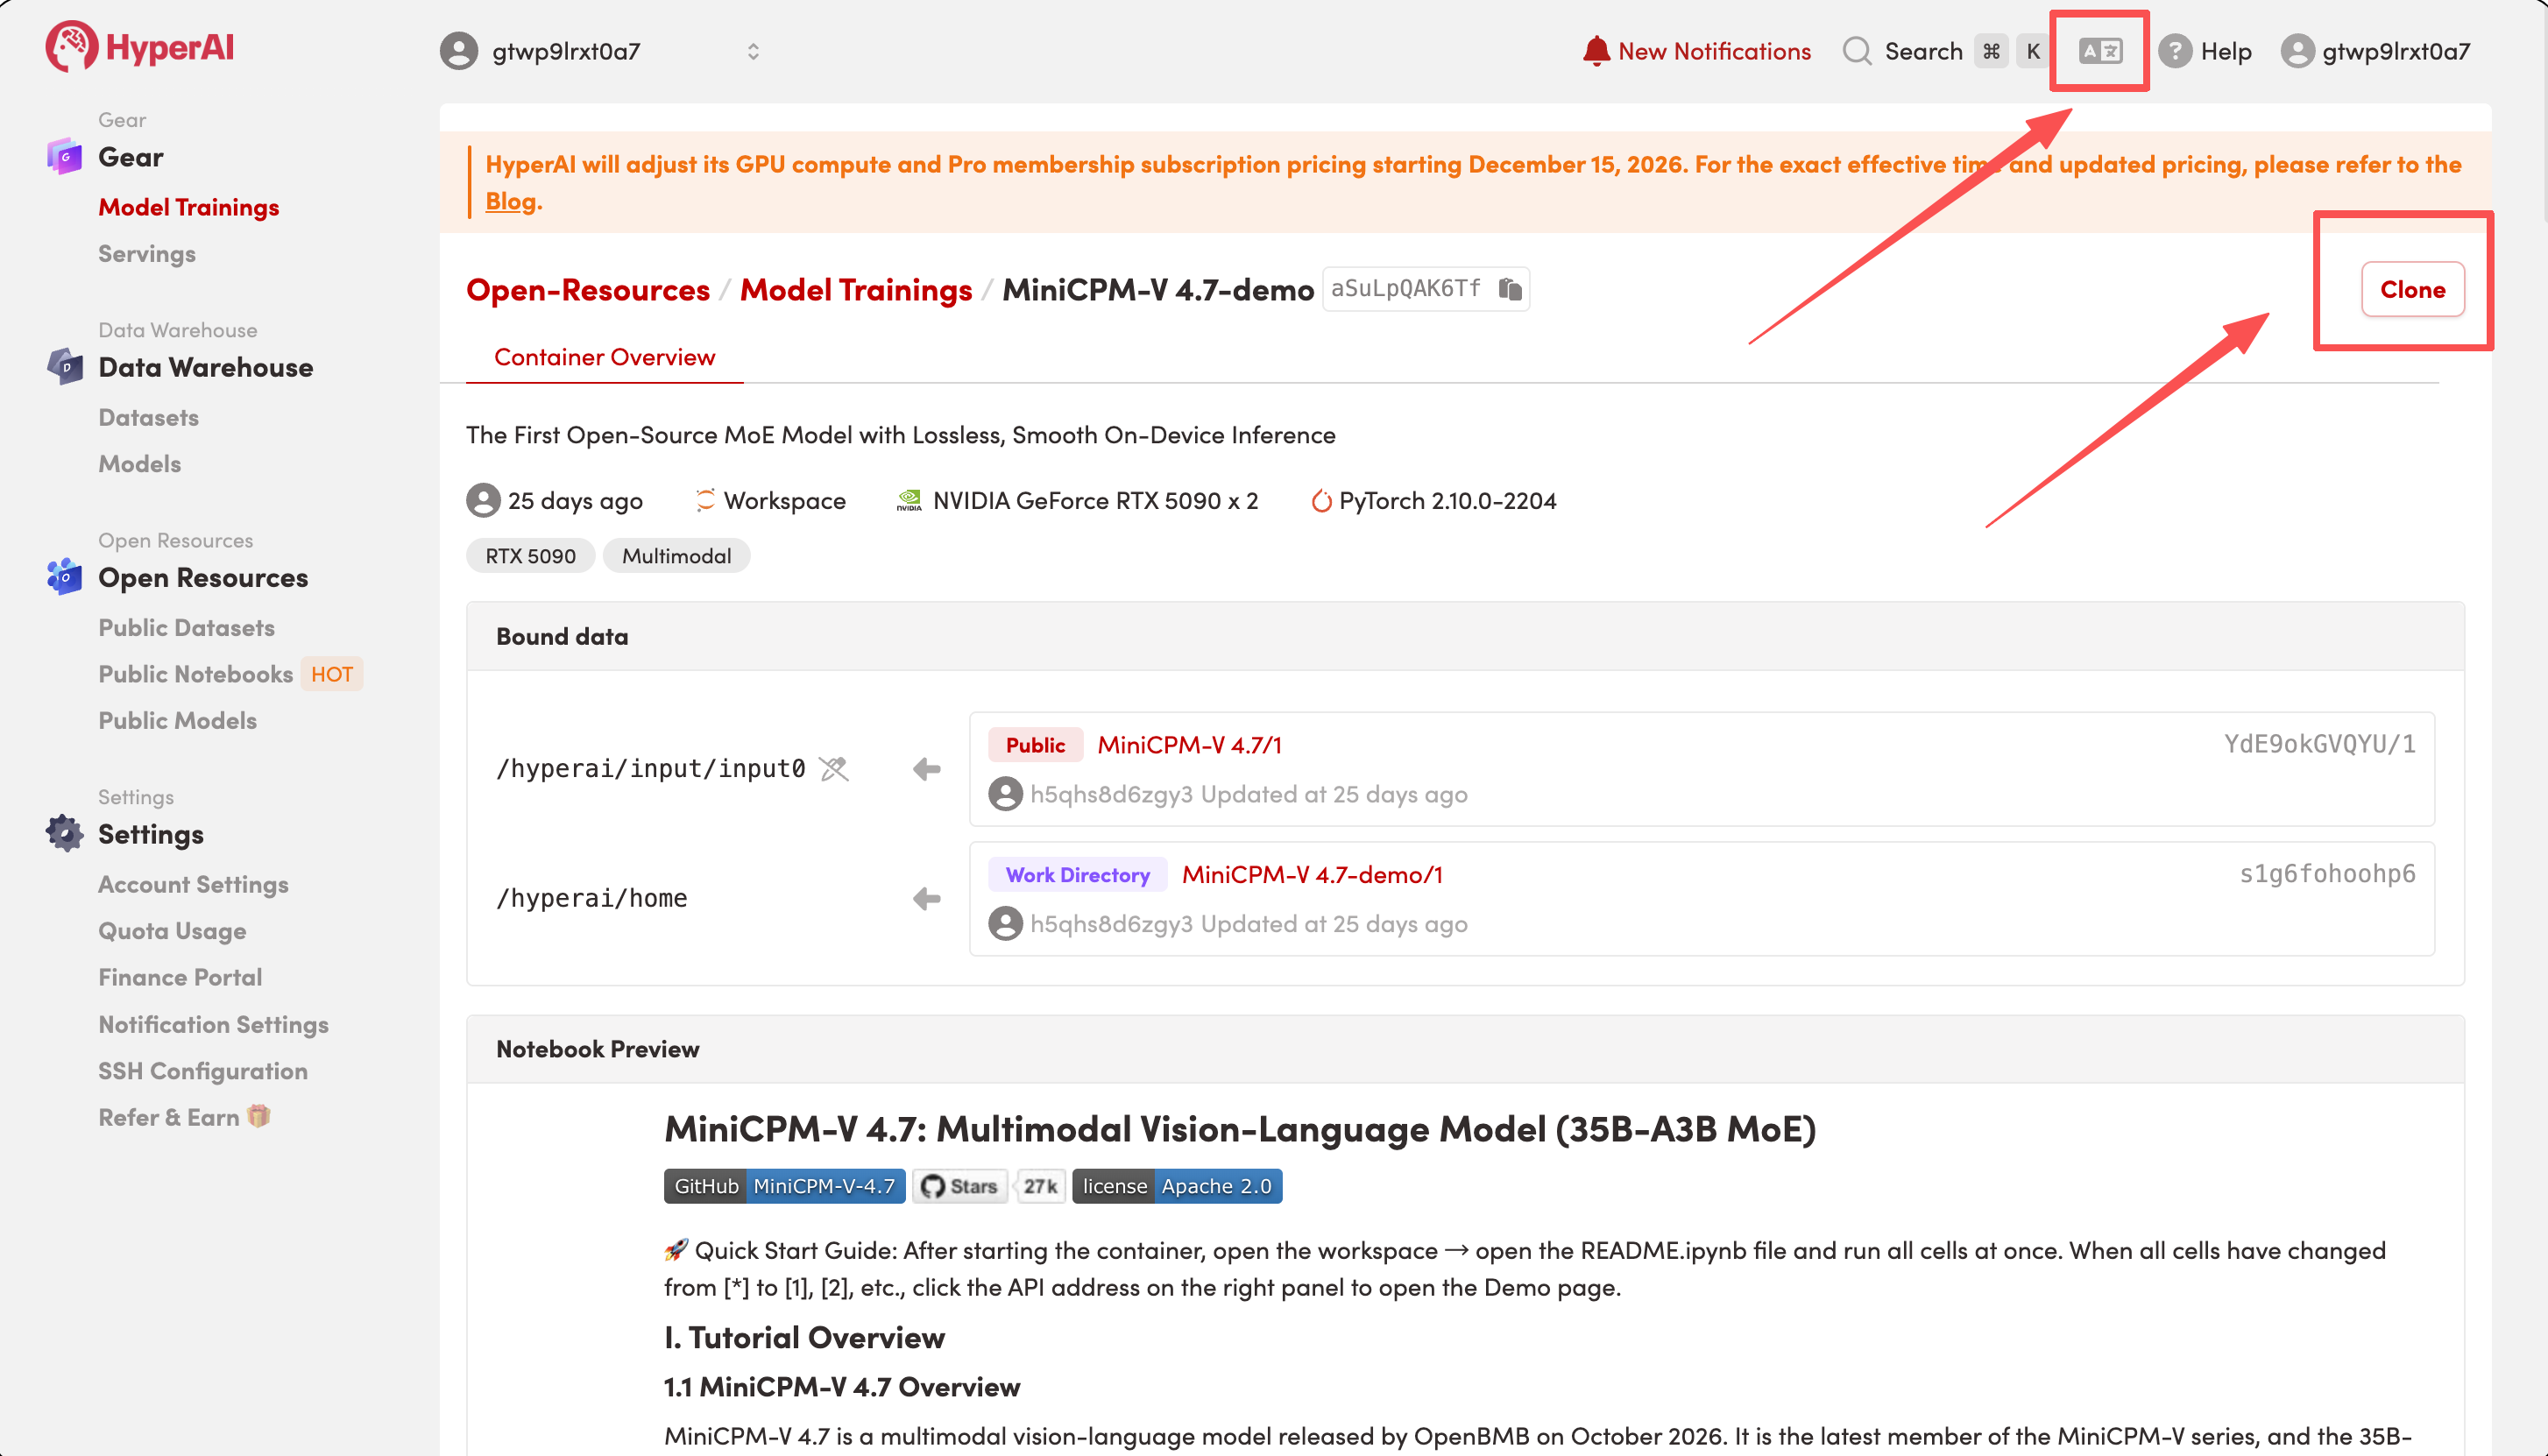
- ページが遷移したら、右上の「Clone」をクリックし、このチュートリアルを自分のコンテナにクローンします。
注:ページ右上では言語の切り替えが可能で、現在は中国語と英語の2言語を提供しています。このチュートリアル記事では英語を例に手順を説明します。
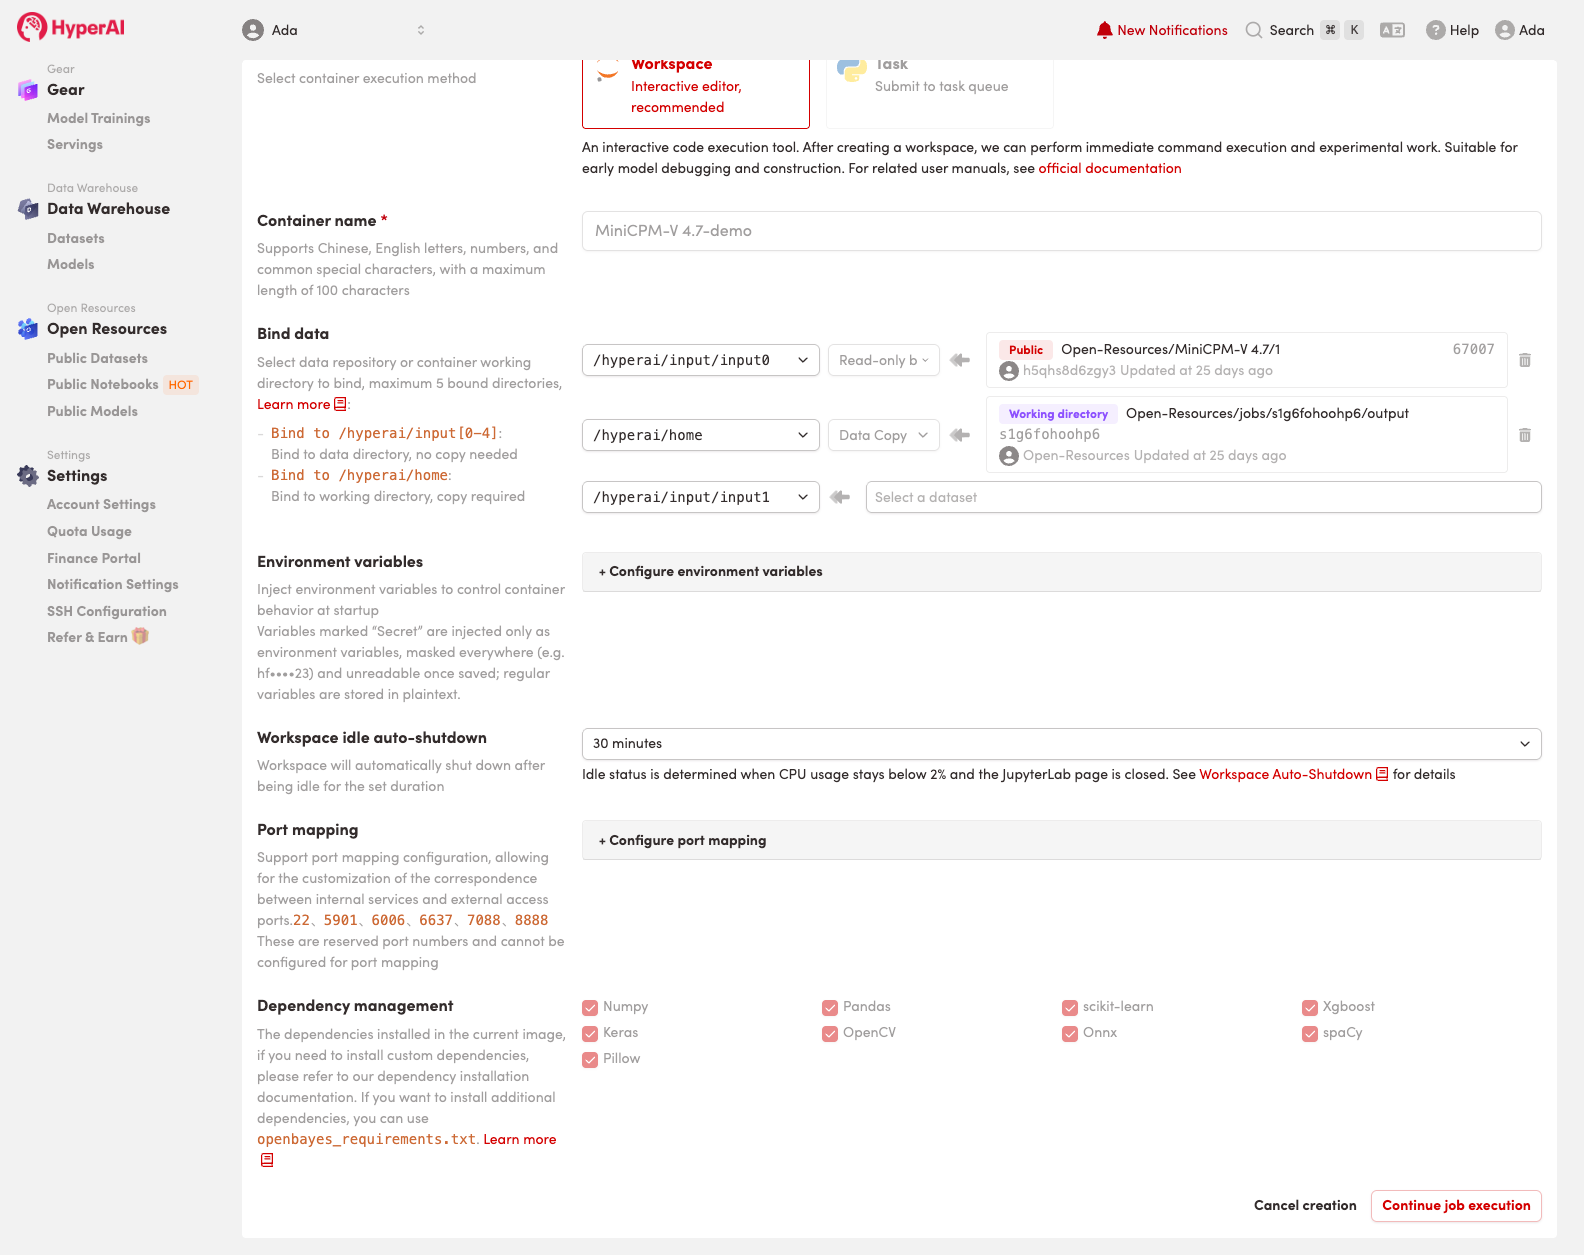
- 「2 x NVIDIA GeForce RTX 5090 (32 GB)」と対応するイメージを選択し、「Continue job execution(実行を継続)」をクリックします。
- リソースの割り当てを待ち、ステータスが「Running(実行中)」になったら、「Open Workspace」をクリックして Jupyter Workspace に入ります。
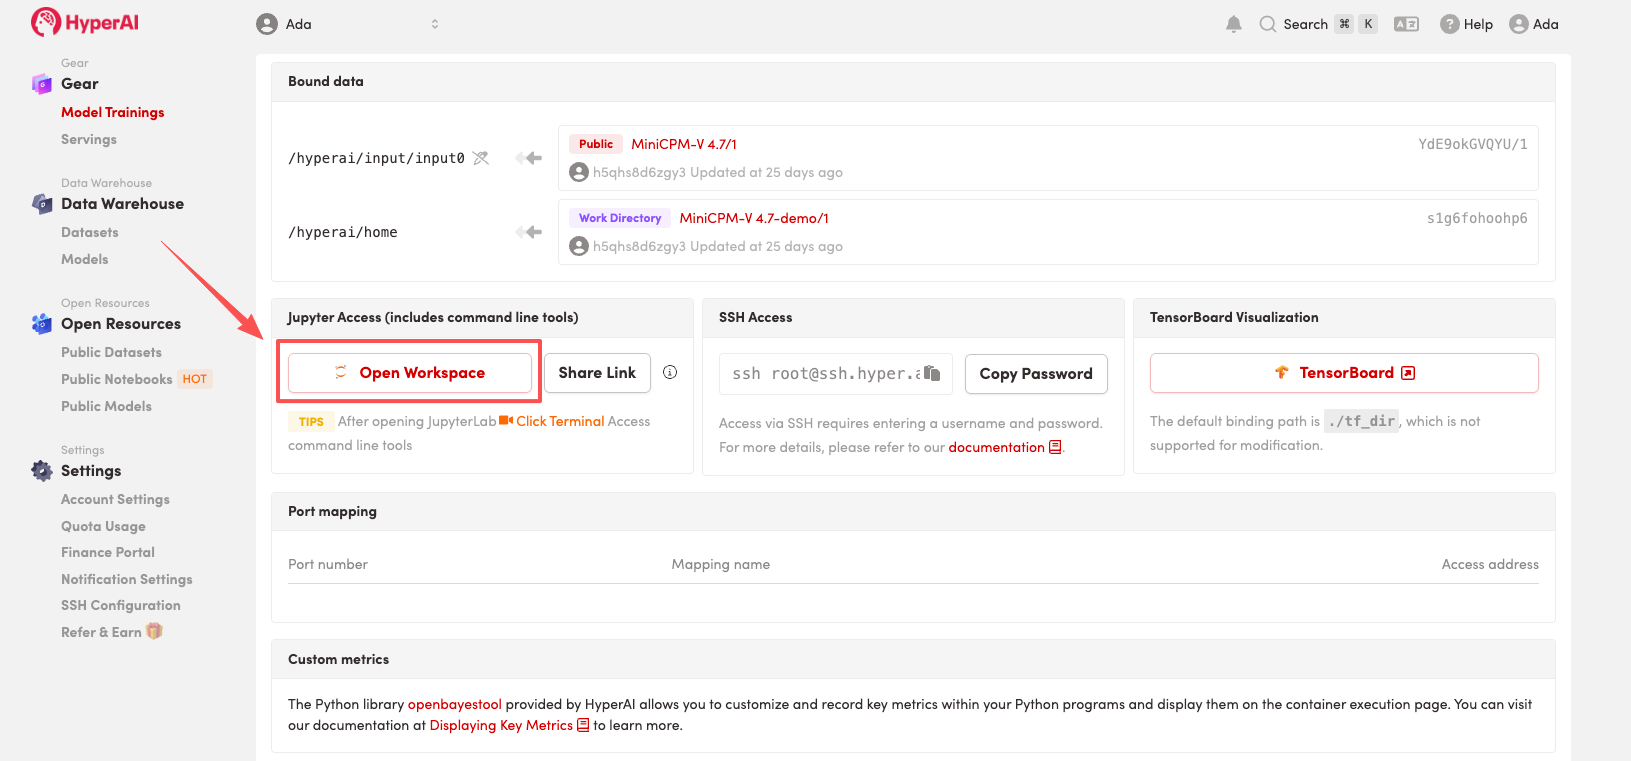
実行結果の表示
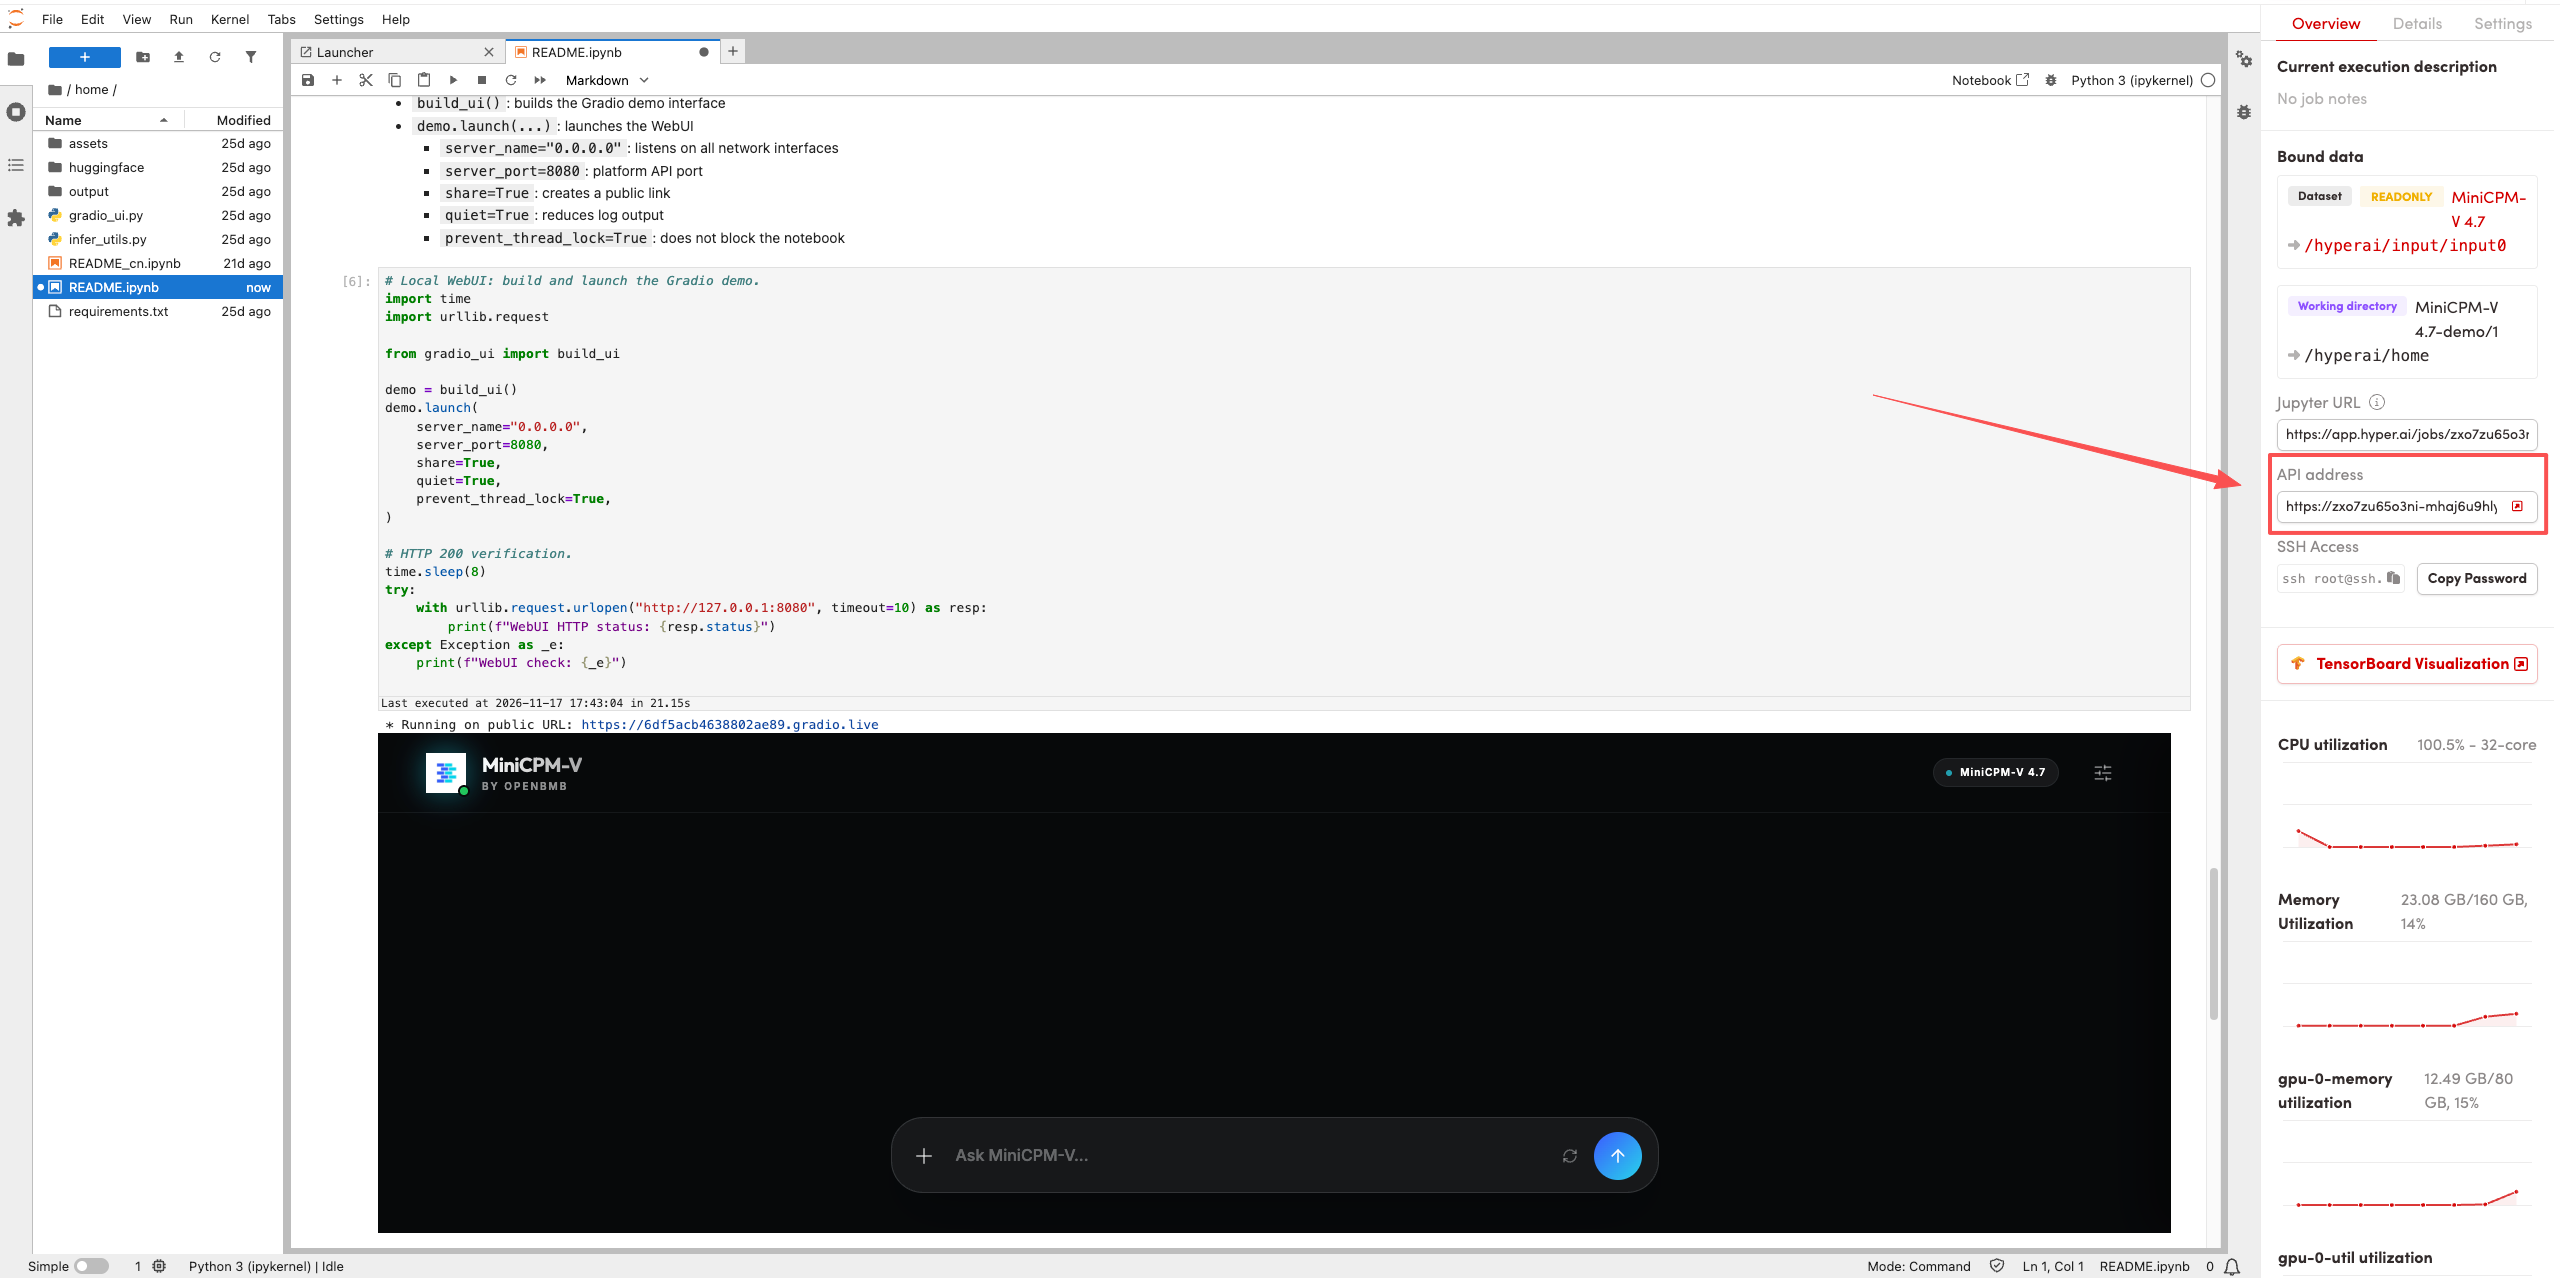
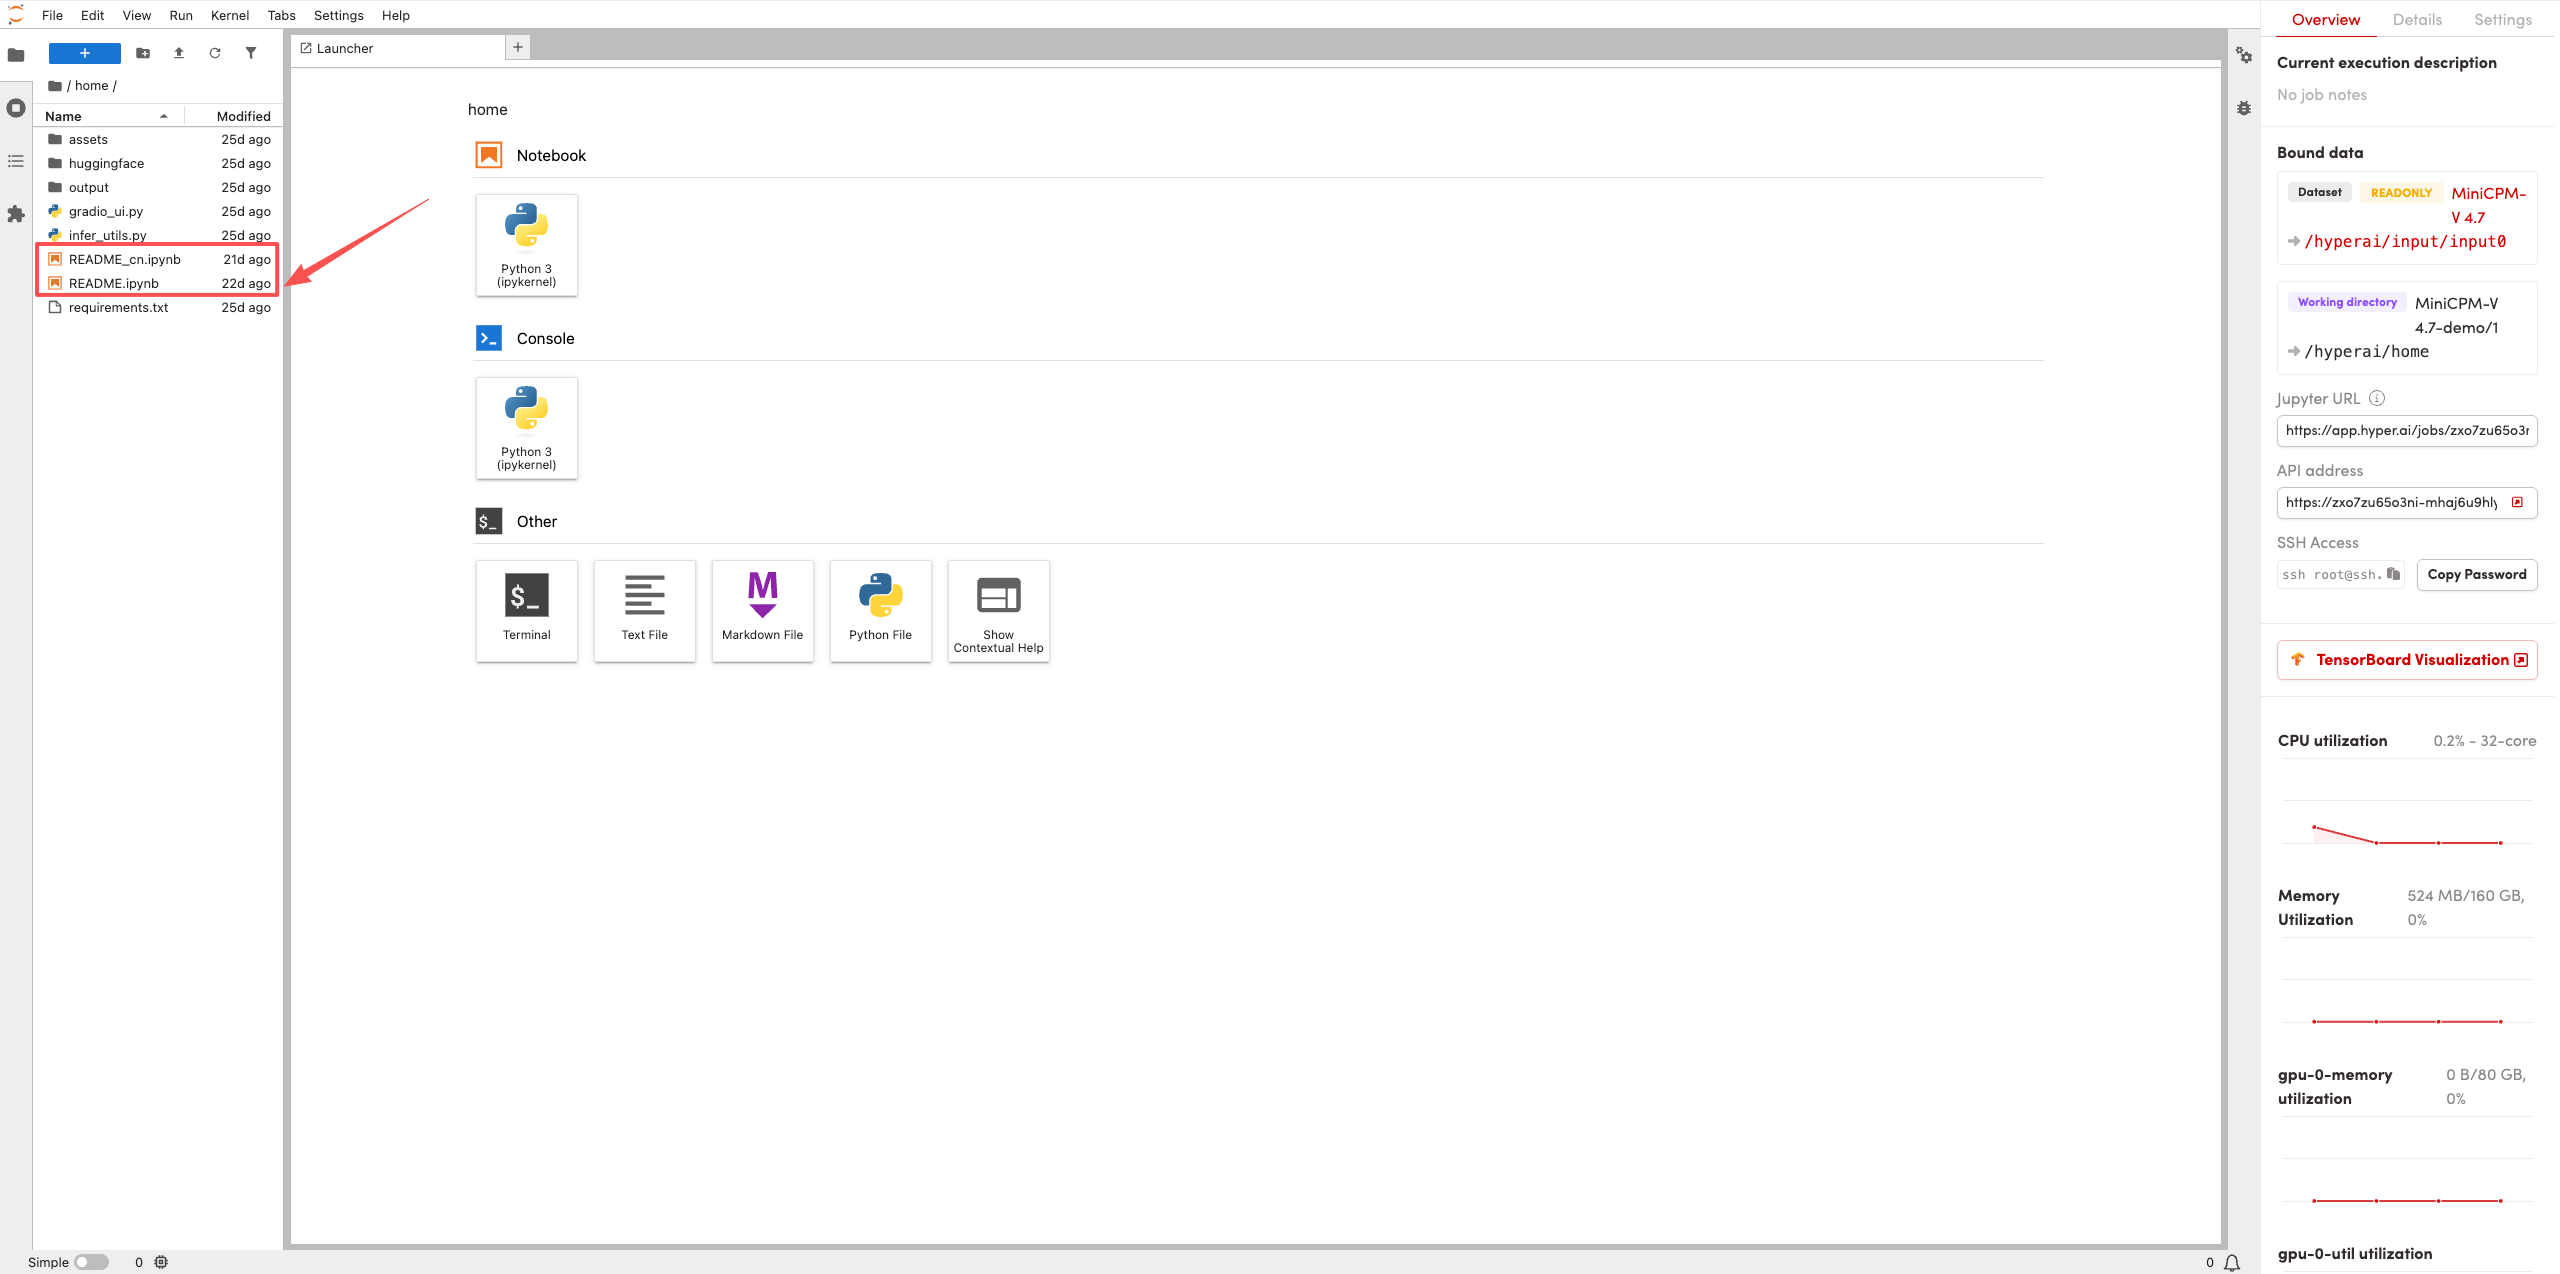
- ページが遷移したら、左側の README ファイルをクリックし、開いたら上部の Run(実行)をクリックします。
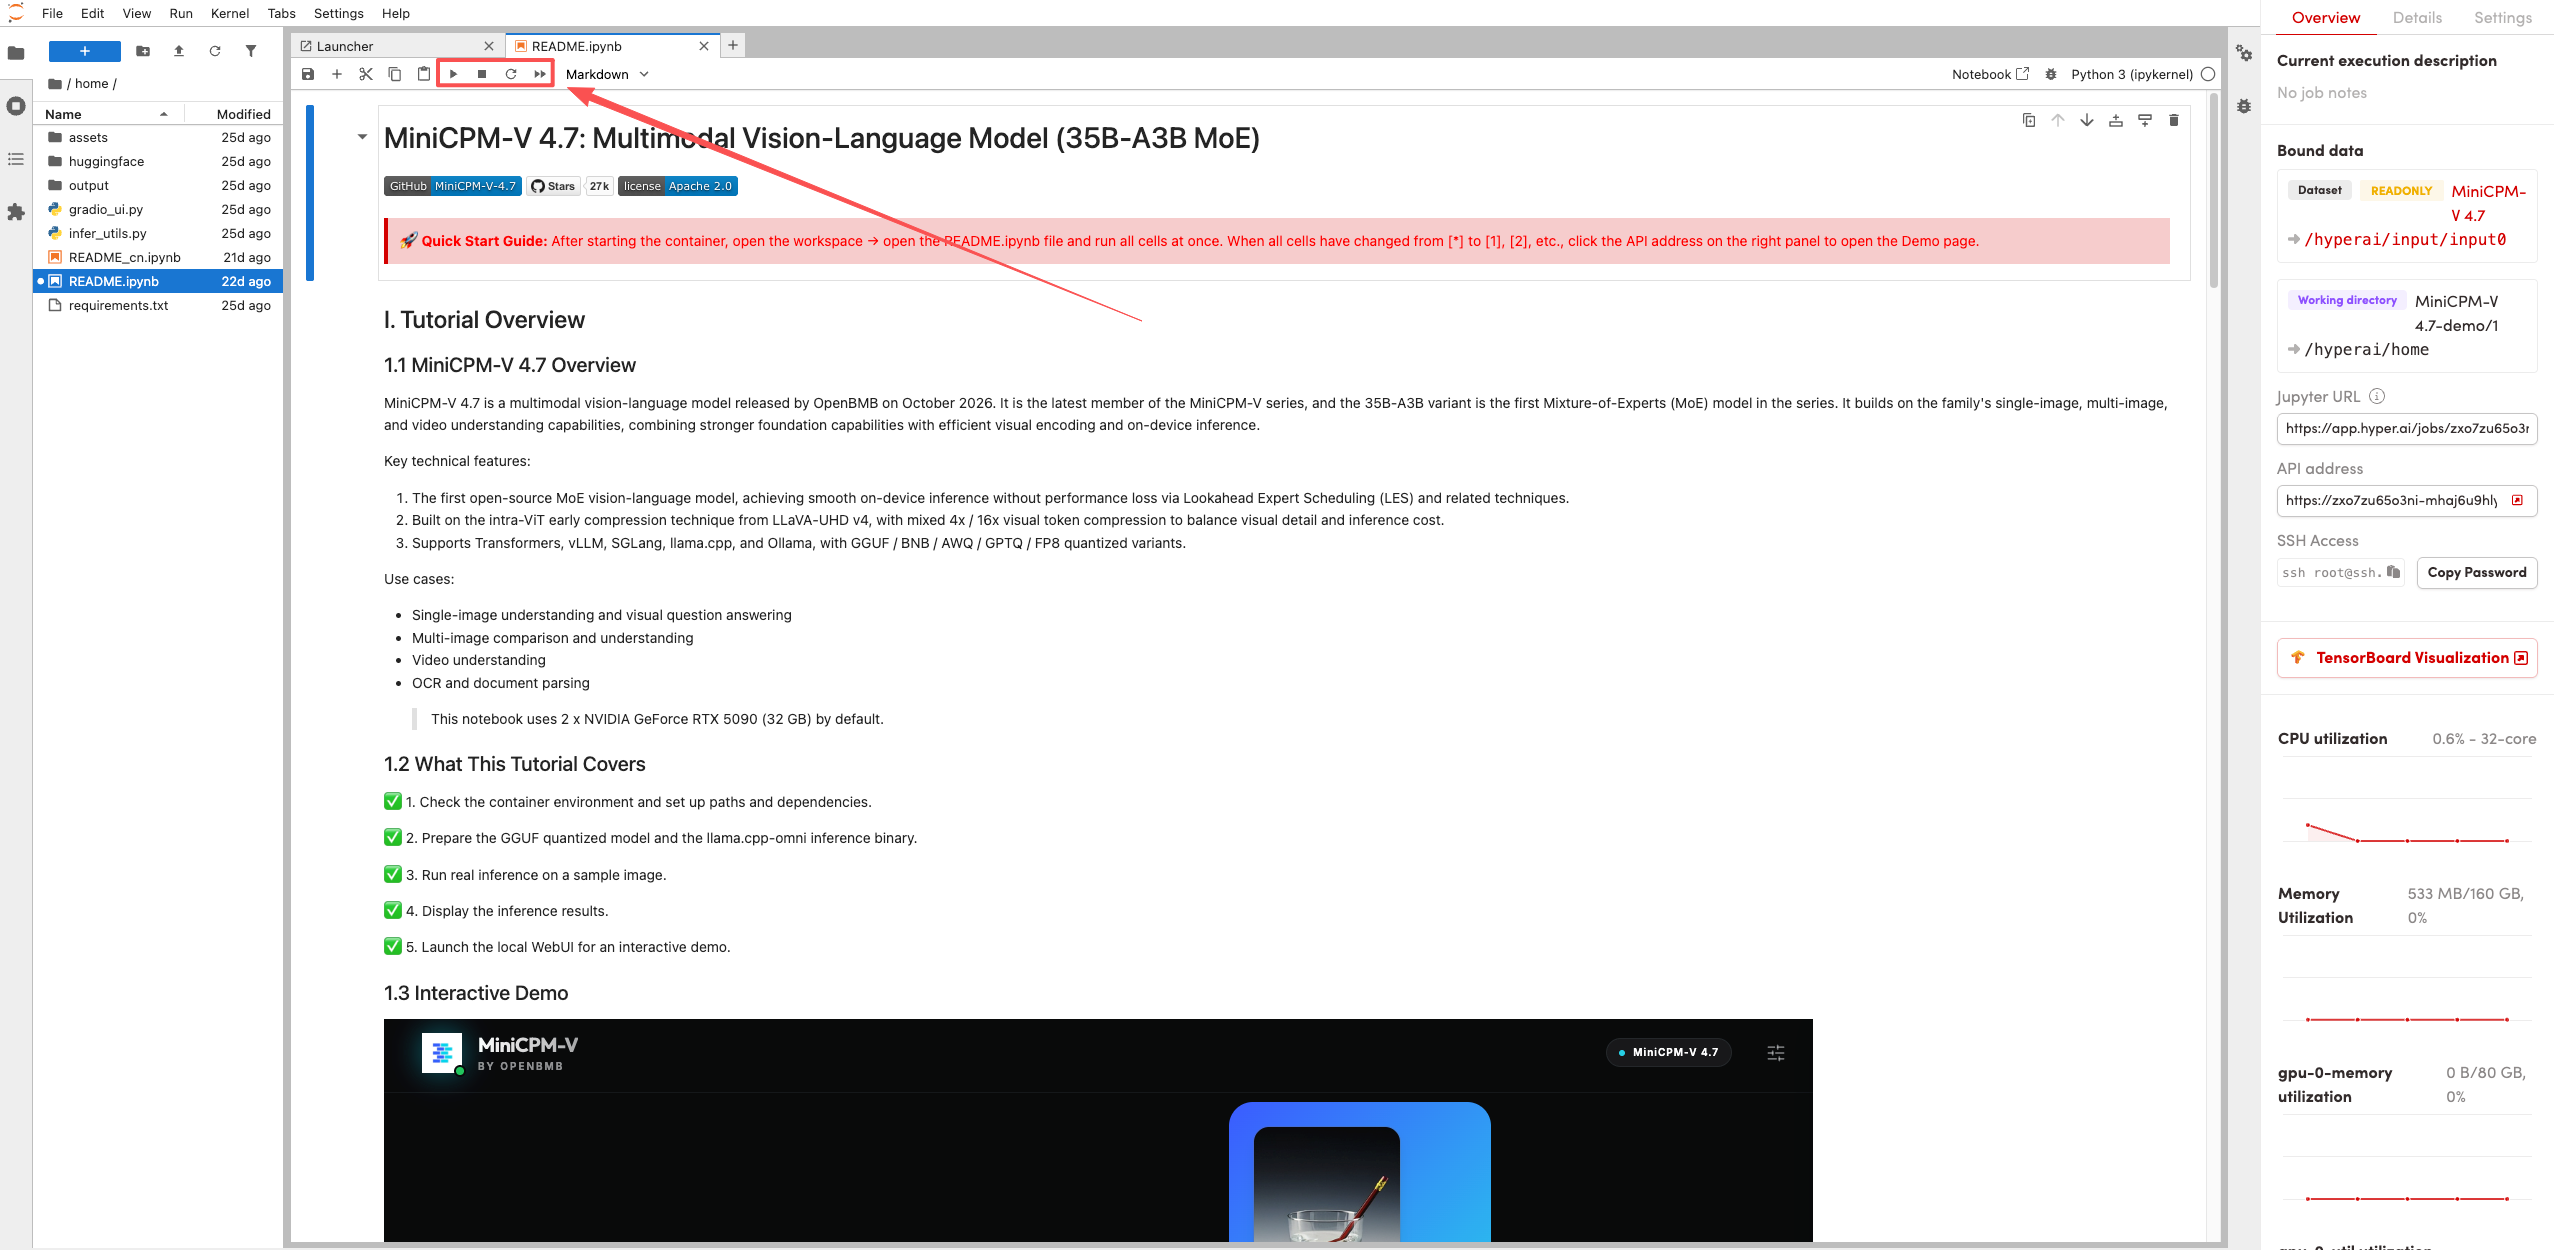
- 実行が完了したら、右側の API アドレスをクリックすると demo にアクセスできます。