Command Palette
Search for a command to run...
オンラインチュートリアル丨迅速な判断とニーズに応じた推論、JEV-27B-VLはQwen3.8-27Bをベースに、画像とテキストの判定、多肢選択、評価に対応
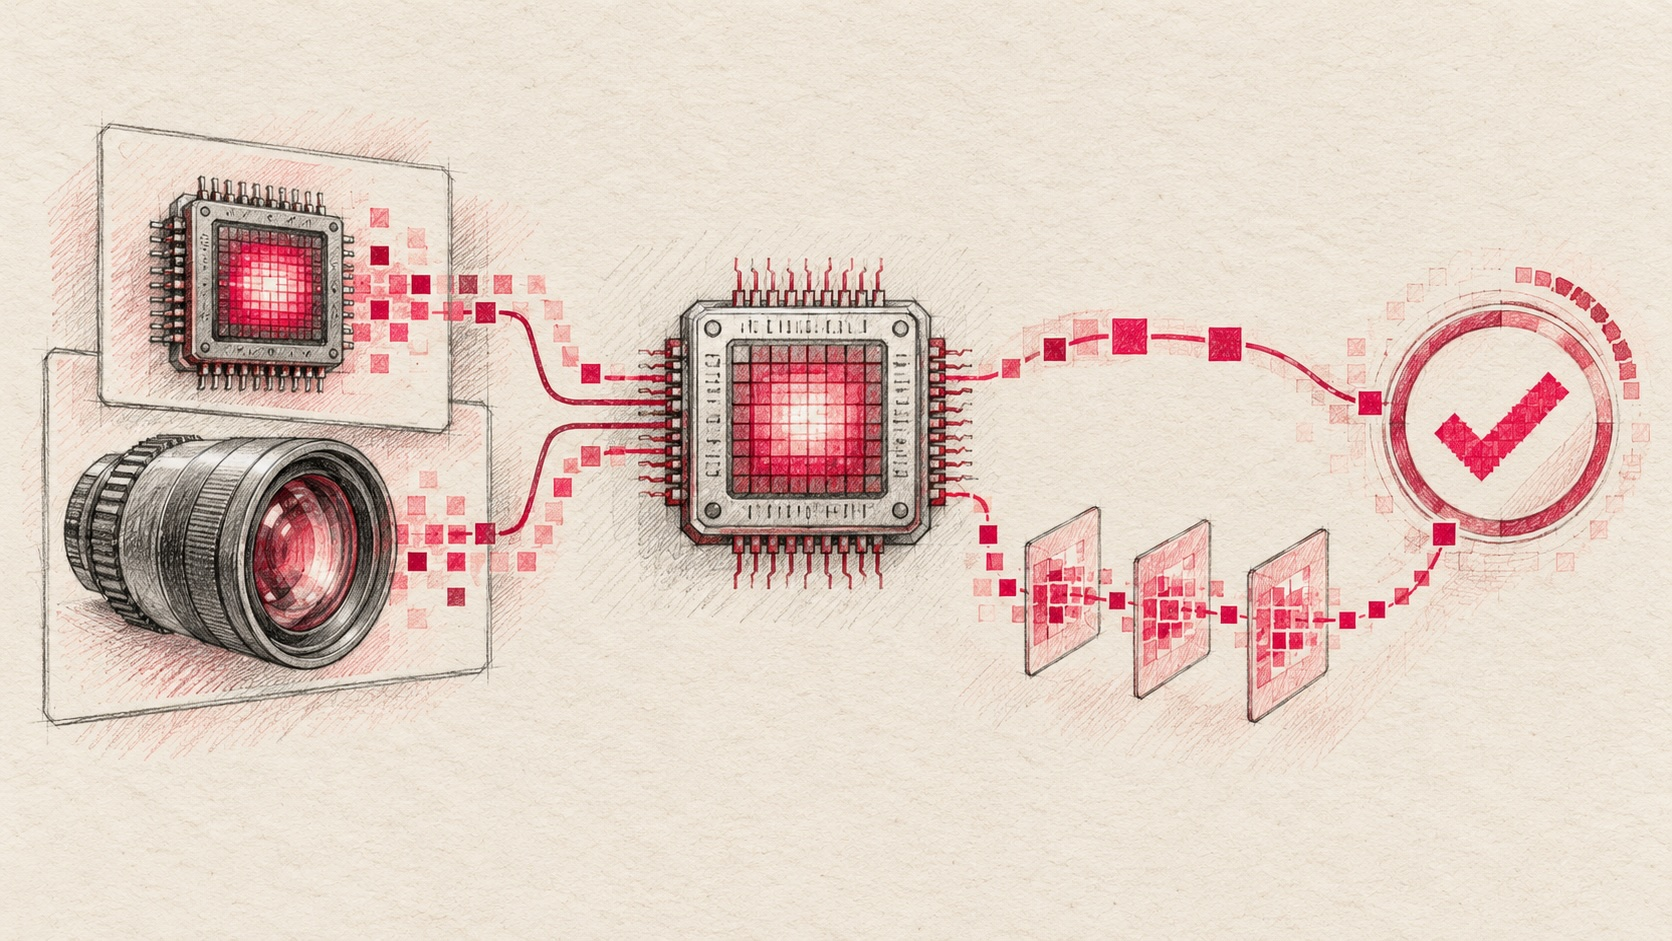
視覚言語モデルはすでに画像を理解し、質問に回答できるようになっています。しかし、AIが画像を見る際、必ずしも長い回答を生成する必要はありません。例えば、画像に違反コンテンツが含まれているかどうかの判定、複数の商品から最も要件に合うものを選ぶ、あるいはショート動画のカバー画像を推薦すべきかの判断など、これらのタスクで本当に必要なのは、詳細な分析ではなく、明確な決定と、その決定に対する確信度であることが多いです。
2026年にAutoTrustチームが発表した視覚決定モデル「JEV-27B-VL」は、異なるアプローチを模索しています。 同モデルは、コミュニティの「Jev Decision Index 0.3」におけるVisionランキングで第1位を獲得しています。プロジェクトの紹介によると、主にオープンエンドなテキスト生成を目的とする視覚言語モデルとは異なり、JEV-27B-VLは「Typed Decisions(型付き決定)」により重点を置いています。すなわち、モデルにテキストおよび画像入力に対し、指定された型に準拠した判定結果を直接出力させるものです。
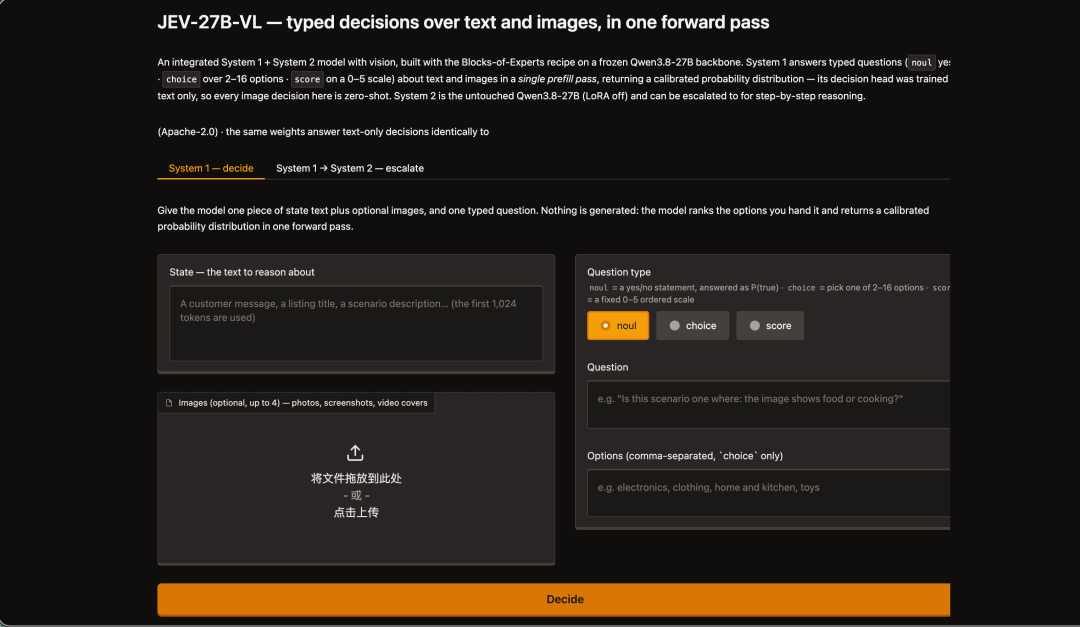
技術的には、JEV-27B-VLはQwen3.8-27Bをベースとし、Blocks-of-Expertsスキームを通じて2つの異なる処理パスを統合しています。System 1は迅速な決定を担当し、System 2は深い推論を担当します。タスクごとに計算パスを再構成することで、すべての判断に対して完全な生成および推論のコストを負うことを避け、モデルの軽量化を実現しています。 System 1は専用の決定ヘッドを介して、単一のフォワードパスで各選択肢の校正済み確率を出力し、Yes/No判定、多肢選択問題(2~16個の選択肢)、0~5点の採点に対応しており、トークン単位での自己回帰生成は不要です。決定の信頼度が低い場合のみ、さらにSystem 2を呼び出し、元のQwen3.8-27Bを用いて段階的な推論を行います。すべてのタスクで完全な生成プロセスを実行する方式と比較して、このオンデマンドな計算リソース配分は、遅延や推論コストに敏感なアプリケーションにより適しています。
タスクに決定のみが求められている場合、モデルに回答文を生成させる必要はありません。現在、HyperAI公式サイト(hyper.ai)のチュートリアルセクションでは、「JEV-27B-VL:テキストと画像のための構造化決定モデル」が公開されており、開発者がモデル機能を迅速に呼び出せるよう支援しています。
オンライン実行:
その他のオンラインチュートリアル:
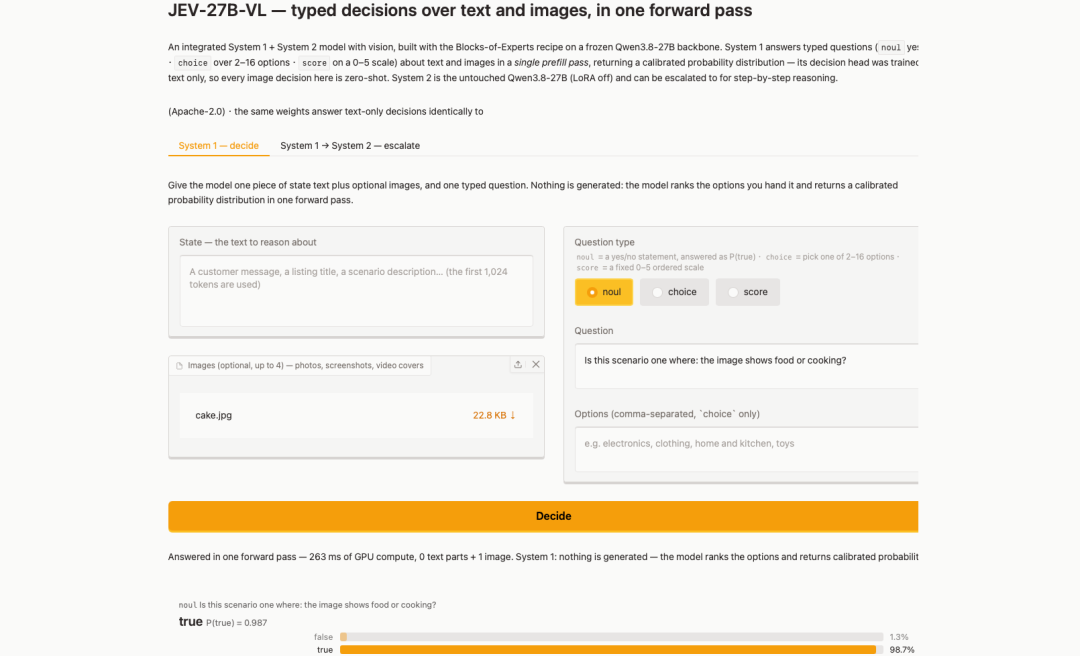
デモの実行
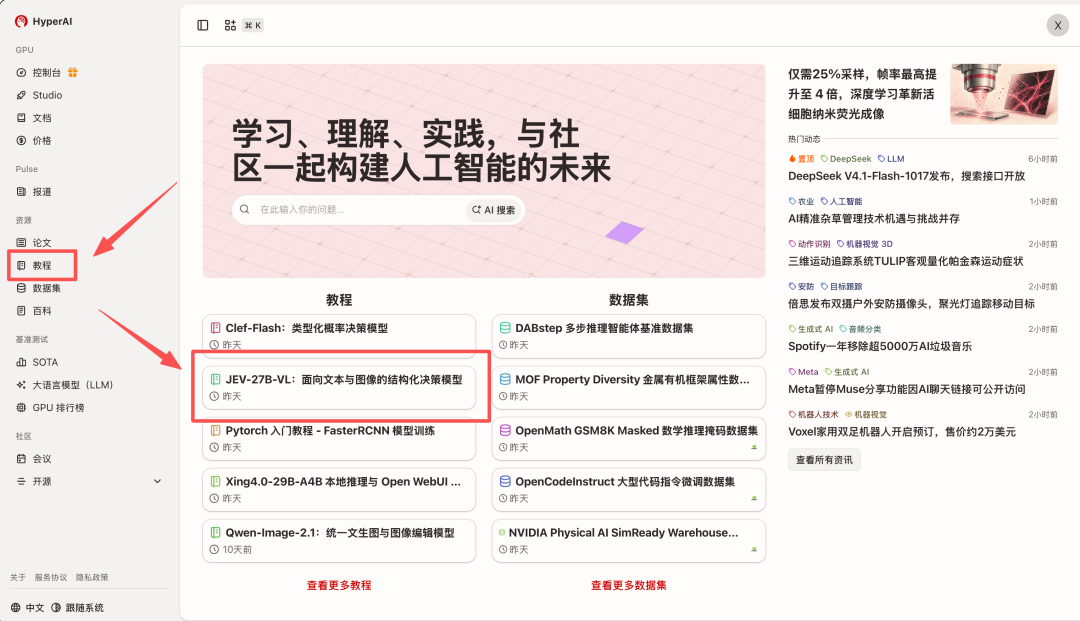
- hyper.aiのトップページにアクセスし、「チュートリアル」ページを選択するか、「その他のチュートリアルを見る」をクリックして「JEV-27B-VL:テキストと画像のための構造化決定モデル」を選択し、「このチュートリアルを実行」をクリックします。
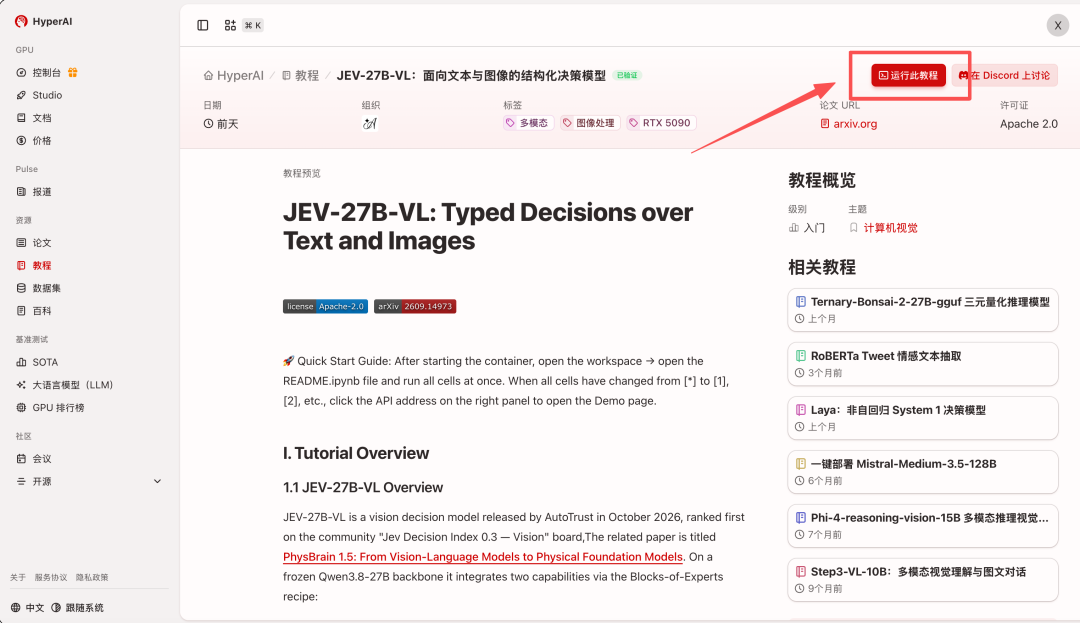
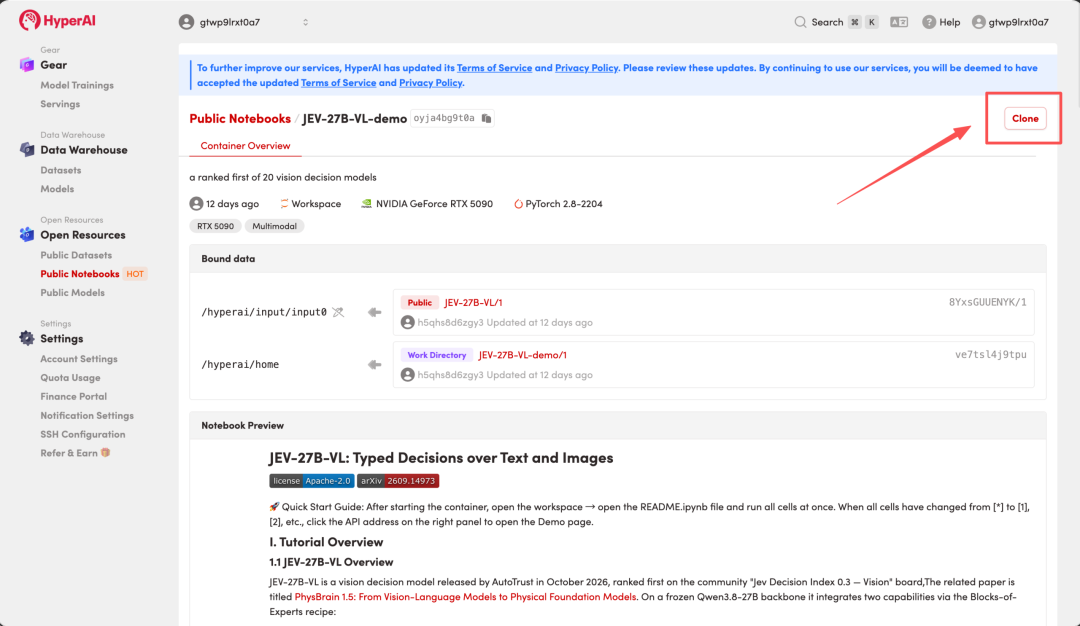
- ページが遷移したら、右上の「Clone」をクリックし、このチュートリアルを自分のコンテナにクローンします。
注:ページ右上では言語の切り替えが可能で、現在中国語および英語の2言語を提供しています。本チュートリアル記事では、英語を例として手順を示します。
- 「NVIDIA RTX 5090」および対応するイメージを選択し、「Continue job execution(ジョブ実行の継続)」をクリックします。本チュートリアルでは、デフォルトでNVIDIA GeForce RTX 5090(32 GB VRAM)リソースを使用します。
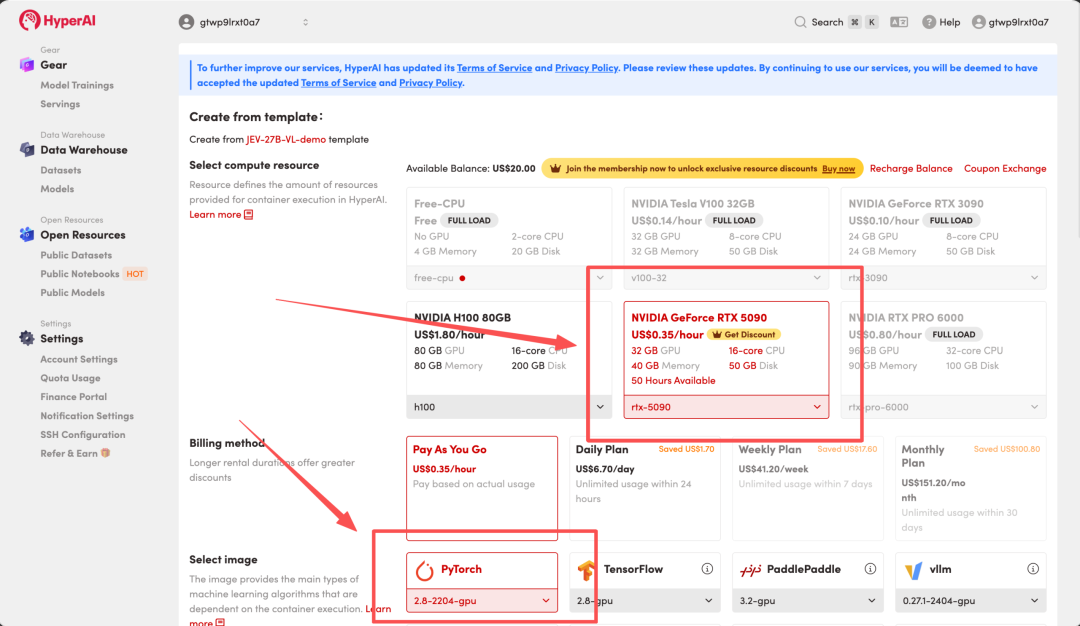
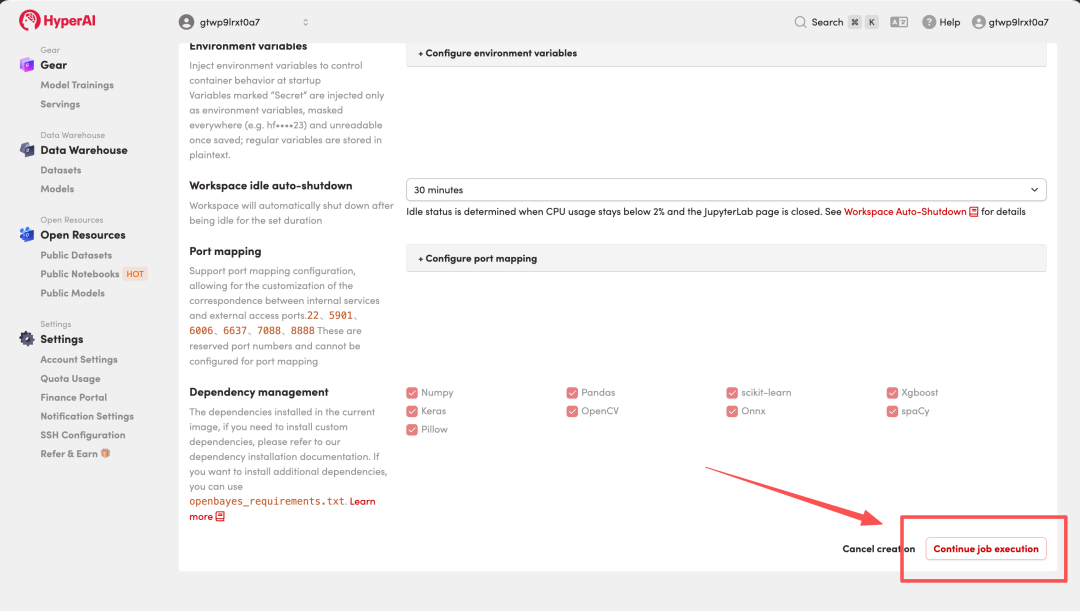
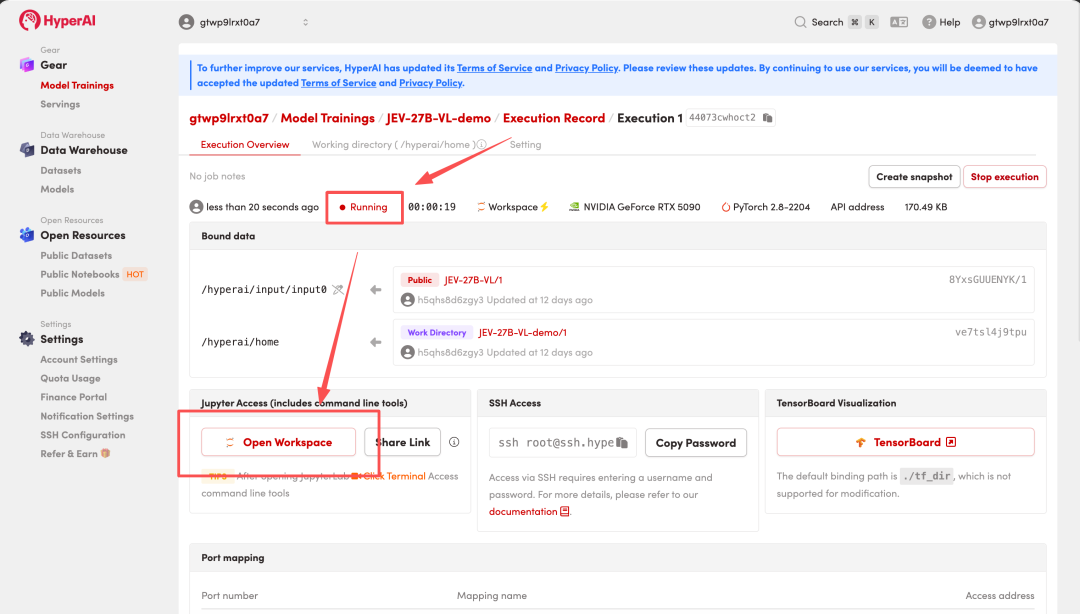
- リソースの割り当てを待ち、ステータスが「Running(実行中)」になったら、「Open Workspace」をクリックしてJupyter Workspaceに入ります。
効果の表示
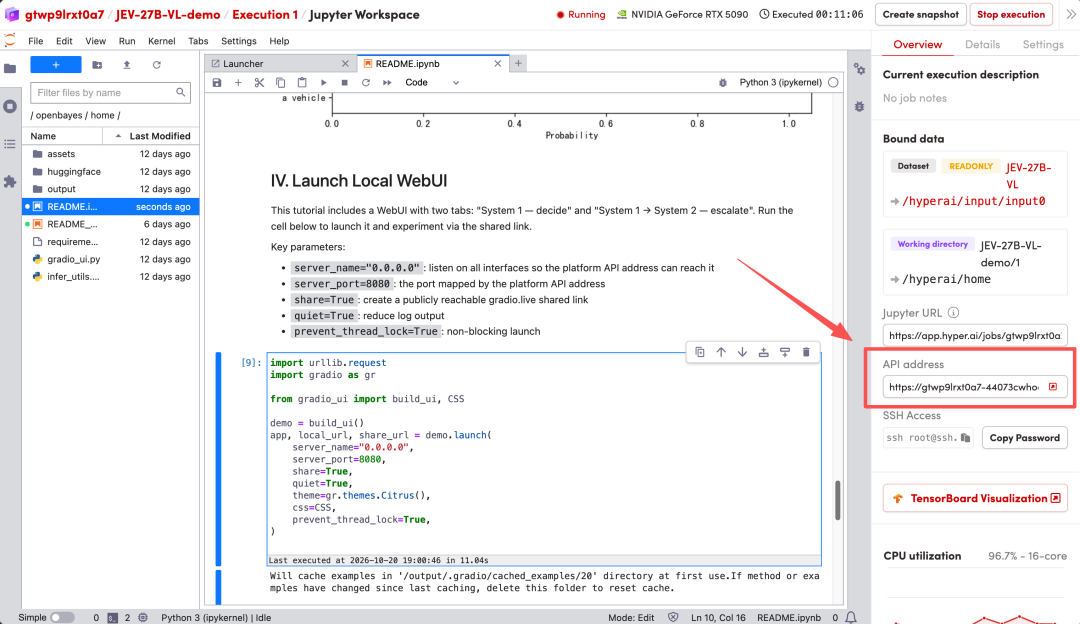
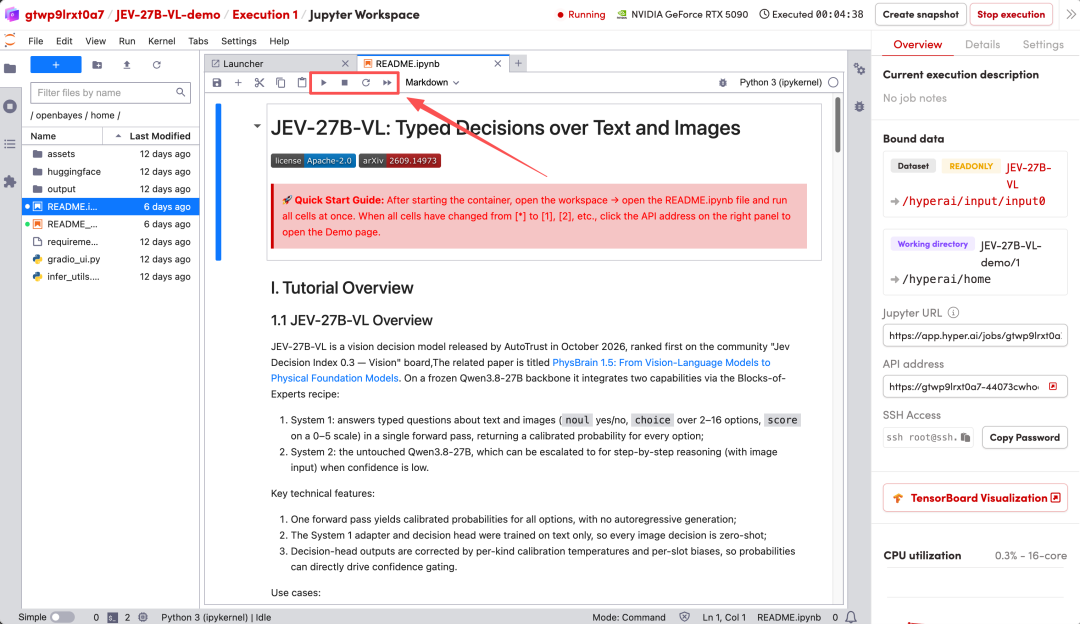
- ページ遷移後、左側のREADMEファイルをクリックし、上部にある「Run(実行)」をクリックします。
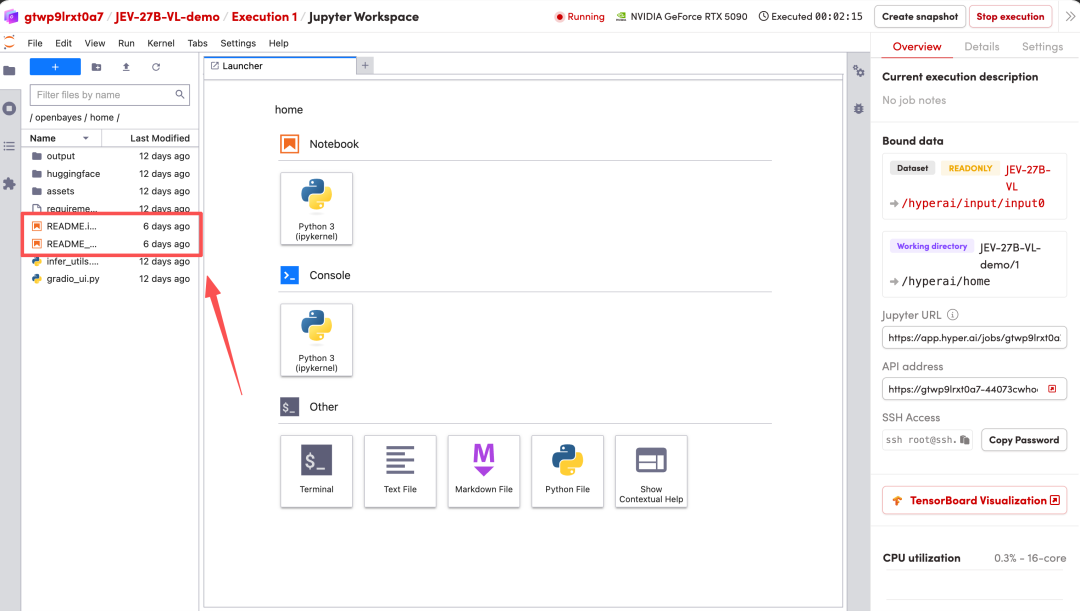
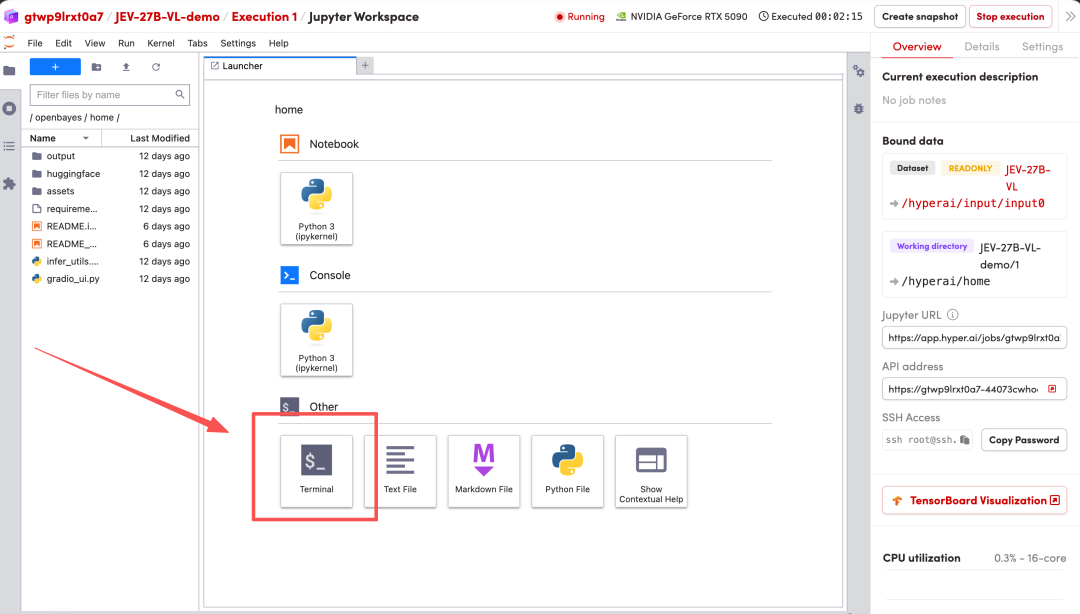
- 実行が完了したら、新しいターミナルを開き、以下のコマンドを実行してOpen WebUIを起動します。
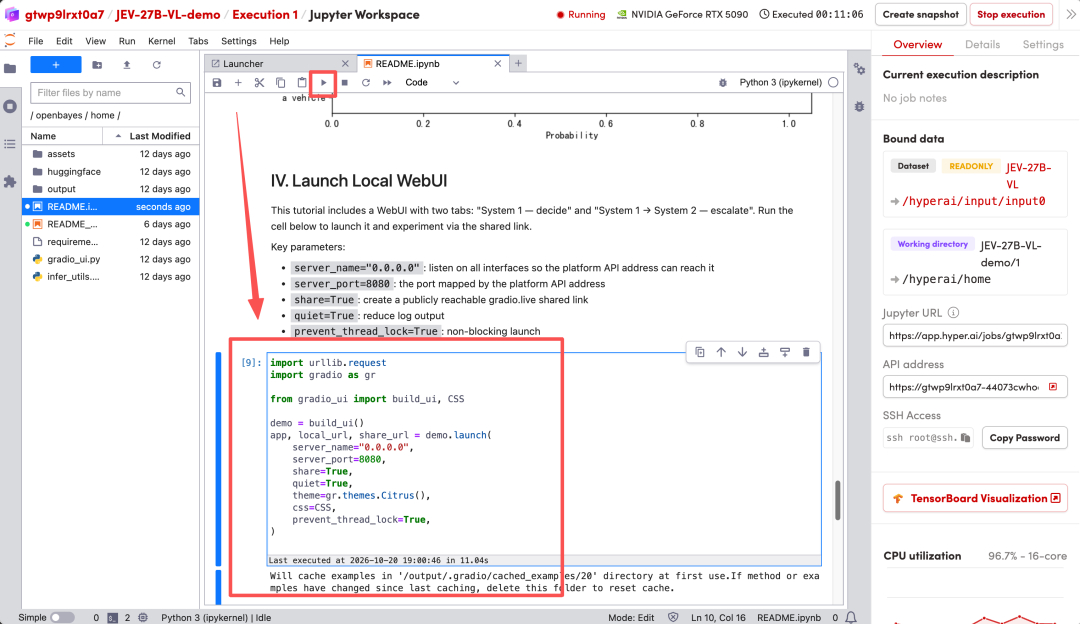
- 起動後、右側のAPIアドレスをクリックすると、ブラウザでOpen WebUIインターフェースにアクセスできます。