Command Palette
Search for a command to run...
IJCAI 2019論文: 38%の中国チームアカウント、北京大学と南京大学がリストに掲載
AIのトップカンファレンス「IJCAI 2019」が8月16日に無事閉幕した。 7日間にわたる技術イベントでは、参加者はワークショップでさまざまな分野におけるAI技術の応用シナリオを学び、AI業界の先輩による基調講演を聞き、AIの発展の歴史やAIの歴史について学ぶ機会を持ちました。ラウンドテーブルの最新の進捗状況とトレンド。さらに、カンファレンスに含まれる論文は間違いなく最も関心のある内容であり、分野別にいくつかの論文を編集して皆様にご紹介します。
人工知能トップカンファレンスIJCAI 20198月10日から8月16日まで中国・マカオで開催され、無事終了しました。
8月13日の開会式では、会議主催者らが今回の会議の論文集を整理した。カンファレンス会長のトーマス・アイター氏は次の情報を発表した。今年のIJCAIには合計4,752件の論文投稿があり、最終的に掲載された論文数は過去最高に達した。850記事、合格率は17.9%です。
次に、会議のプログラム委員長であるサリット・クラウス氏が、昨年収集された論文数 3,470 件と比較して、今年の増加率は 850 件であり、中国からの記事は 327 件あり、38% を占めています。
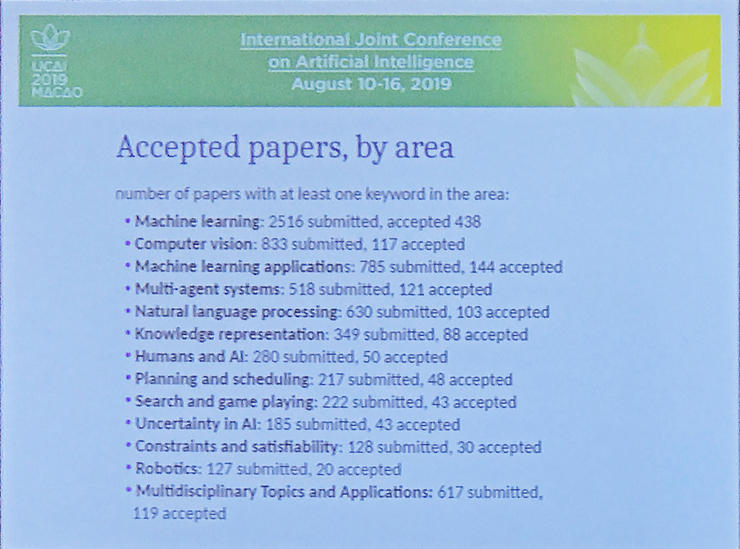
論文のテーマに関しては、機械学習は依然として最も注目されている分野です。収録記事数は438件と半数以上、また、論文数が最も多い分野は、****順に、コンピューター ビジョン、機械学習アプリケーション、自然言語処理です。
受賞歴のある論文の中心
IJCAI 2019 850論文の中から1論文を選出特別な紙(優秀論文):
そういう方法もありますよ2 つの利点:まず、この方法はさまざまな行列空間に適用でき、さらに、多くの分野で受動的にのみ取得できる、またはノイズの多い三重情報を解決できます。論文の中で、研究者らはこの方法の実現可能性を理論的に検証し、取得する必要があるトリプルの数の下限を提案しました。実験の結果、この方法は既存の方法よりも優れており、ノイズに強いという。
 IJCAI-JAIRを入手最高の紙(最優秀論文) は次のとおりです。
注:この賞は、過去5年以内にJAIRに掲載された論文に授与されます。
要約: この論文では、最も典型的な NP 完全問題であるブール充足性 (SAT) と、その PSPACE 完全な一般化バージョンである量的ブール充足性 (QAT) が宣言型プログラミング パラダイムの中核であると述べています。さまざまな計算上複雑な問題の実世界の例を効率的に解決できます。この分野での成功は次のような方法で達成されます。SAT と QSAT意思決定手順の実際の実装は、SAT および QSAT ソルバーの画期的な進歩によって実現されます。この論文では、研究者は前処理と後処理のための条項削除手順を開発および分析します。文節削除プロセスは、一連の (P)CNF 形式的単純化手法を形成し、それにより、式の充足可能性を維持しながら、多項式時間で特定の冗長な特性を持つ文節を削除します。
 これらの受賞論文に加えて、IJCAIは人工知能分野で最も人気のあるトップカンファレンスの一つとして、長年にわたる論文投稿数と受理数においてトップカンファレンスにランクされており、優れた論文が数多くあります。生産された。
したがって、この IJCAI カンファレンスからのスーパーニューラル最もホットな 3 つのエリア (ホット 3)その中から、IJCAIの全体像が垣間見えるよう、厳選した1~2論文を抜粋して簡単に紹介します。
ホット 1: 機械学習
機械学習の厳選論文 1

現在、既存の方法では、マルチモーダルなリカレント エンコーダ/デコーダ ネットワークが使用されることがよくありますが、長期的な依存関係モデリングが不足しているため、長いビデオの質問応答に効果的に適用できません。
この問題を解決するために、著者は次のことを提案しました。高速階層畳み込みセルフアテンション エンコーダ-デック ネットワーク (HCSA)。セルフアテンションエンコーダと階層的畳み込みを使用し、長い形式のビデオ コンテンツを効果的にモデル化します。
HCSA はビデオ シーケンスの階層構造を構築し、ビデオ コンテキストから問題を認識して長期的な依存関係をキャプチャします。さらに、マルチスケール アテンション デコーダは、多層表現を融合して応答を生成し、最上位のコーディング層での情報損失を回避するように設計されています。
実験結果は、この方法が複数のデータセットで良好に実行されることを示しています。
 機械学習の厳選論文 2

この記事では、シンプルで効果的な半教師あり学習アルゴリズムを提案します—補間一貫性トレーニング(補間一貫性トレーニング、ICT)。
ICT は、ラベルのないポイントの内挿予測をそれらのポイントの内挿予測と調整します。分類問題では、ICT は決定境界をデータ分布の低密度領域に移動します。追加の計算をほとんど使用せず、大規模なハイパーパラメータ調整を行わなくても生成モデルのトレーニングを必要とせず、CIFAR-10 および SVHN ベンチマーク データセットの標準ニューラル ネットワーク アーキテクチャに適用すると良好なパフォーマンスを発揮します。最先端のパフォーマンスを実現しました。

ホット 2: コンピューター ビジョン
コンピュータ ビジョンの厳選論文 1

この作品が提案するのは、斬新な動的機能融合戦略、異なる入力画像と位置に異なるフュージョン ウェイトを適応的に割り当てます。これは、特徴マップの各位置でマルチレベル特徴を備えた特定の入力に対して適切な融合重みを推論する、提案された重み学習器によって実現されます。
このようにして、特徴マップと入力画像のさまざまな位置によってもたらされる寄与の不均一性をより適切に考慮できるため、より正確かつ明確なエッジ予測。
 コンピュータ ビジョンの厳選論文 2

この記事が提案するのは、深さの正確な予測のためにマルチスケール構造を活用した構造認識型残差ピラミッド ネットワーク(SARPN) では、Residual Pyramid Decoder (RPD) も提案されています。これは、上位層でグローバル シーン構造を表してレイアウトを表し、下位層でローカル構造を表して各層の形状の詳細と予測を表します。残差マッピングは、上位層によって予測された大まかな構造に徐々に細かい構造を追加する残差リファインメント モジュール (RRM) が提案され、マルチスケール画像の特性を最大限に活用するために、適応型高密度特徴融合 (ADFF) モジュールが提案されます。これは各スケールの効果的な特徴を融合するように自動的に適応し、それを使用して各スケールの構造を推論します。 NYU-Depth v2 データセットの実験結果は、この論文で提案された方法が定性的評価と定量的評価の両方で最先端のパフォーマンスを達成することを示しています。適合率は 0.749、再現率は 0.554、F1 スコアは 0.630 に達します。

ホット 3: 自然言語処理 (NLP)
NLP 厳選論文 1

Leap-LSTMはテキストを読むことができます単語間を動的にジャンプします。各ステップで、Leap-LSTM はいくつかの特徴エンコーダを使用して前のテキスト、次のテキスト、および現在の単語から情報を抽出し、現在の単語をスキップするかどうかを決定します。合計 5 つのベンチマーク データ セット: AGNews、DBPedia、Yelp F. Yelp P.、Yahoo、Leap-LSTMの予測効果は標準LSTMよりも高く、読み取り速度も高速です。
 NLP 厳選論文 2

ただし、多数のエンティティ フィーチャがまだ同等にまとめて処理されていないため、埋め込みベースのエンティティ アライメントの精度と堅牢性が損なわれます。
この論文は新しいフレームワークを提案します。エンティティの複数のビューを統合して、エンティティに合わせた埋め込みを学習します。具体的には、この論文では、エンティティ名、関係、および属性のビューに基づいてエンティティを埋め込むために、いくつかの構成戦略を使用しています。
さらに、この論文では、2 つのナレッジ グラフ間の整合性を高めるために、いくつかのクロスナレッジ グラフ推論手法を設計しています。実際のデータ セットでの実験では、このフレームワークのパフォーマンスが現在の最先端のものよりも大幅に優れていることが示されています。埋め込みベースのエンティティの位置合わせ方法。選択されたビュー、クロスナレッジ グラフ推論、および構成戦略はすべて、パフォーマンスの向上に貢献します。
 - 以上 -