Command Palette
Search for a command to run...
Tutoriel En Ligne | L'équipe De Tian Yuandong Ouvre Le Code Du Modèle De Programmation Flint : 39,8 Milliards De Paramètres, Seulement 2,5 Milliards Activés Par Token
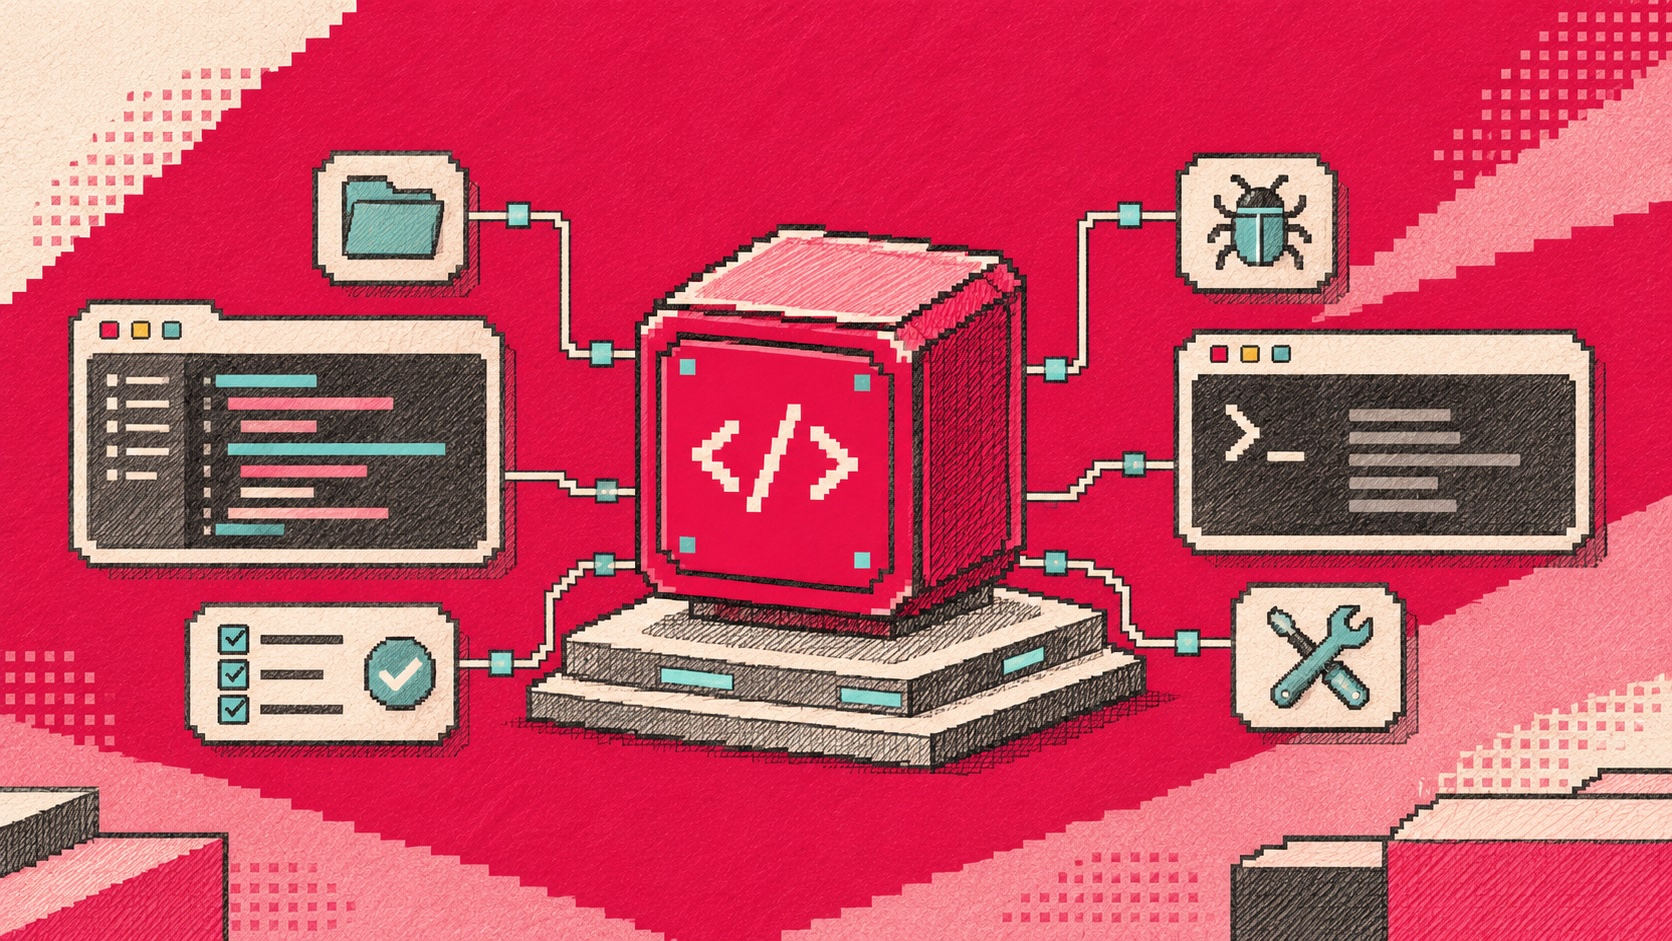
Du simple remplissage d'une fonction à la génération de projets complets à partir de langage naturel, les modèles de code abaissent continuellement la barrière à l'entrée dans le développement logiciel. Mais le véritable développement logiciel ne se limite pas à écrire un bout de code fonctionnel. Comprendre la structure d'un projet existant, localiser des bugs, modifier plusieurs fichiers, exécuter des tests, puis ajuster le code en fonction des messages d'erreur sont autant d'étapes qui nécessitent des capacités plus complètes de compréhension du code et d'exécution de tâches. On peut dire que la génération de code n'est que la première étape ; la partie la plus difficile consiste à permettre à l'IA de s'impliquer réellement dans le processus de développement.
Flint, lancé par Recursive, est précisément un modèle linguistique open source conçu pour les scénarios d'agents de codage (Coding Agent). Il est capable de comprendre les bases de code, de corriger des bugs, d'implémenter de nouvelles fonctionnalités, d'écrire des tests, et prend en charge le raisonnement multi-tours et les appels d'outils. Flint adopte une architecture Mixture-of-Experts (MoE) à base de décodeurs uniquement (Decoder-only). Le nombre total de paramètres atteint 39,8 milliards, mais environ 2,5 milliards de paramètres sont effectivement activés par token. Dans ses couches MoE, chaque token sélectionne 6 experts parmi 256 experts routés, tout en utilisant 1 expert partagé toujours activé. Cette conception permet au modèle de conserver une grande taille totale de paramètres, tout en réduisant le nombre de paramètres à appeler lors de l'inférence pour chaque token.
C'est également l'idée centrale de l'architecture MoE en matière d'efficacité de calcul : grâce au mécanisme de routage, les experts appropriés sont sélectionnés en fonction de l'entrée actuelle pour participer au calcul, réduisant ainsi le nombre de paramètres à activer par token tout en préservant la capacité du modèle. Pour les tâches d'agent nécessitant une analyse de code, un raisonnement et des appels d'outils continus, cette conception aide à contrôler les coûts de calcul lors de la phase d'inférence.
En termes de capacités concrètes, Flint prend en charge les conversations multi-tours, le raisonnement et les appels d'outils. Selon les résultats d'évaluation publiés par Recursive, le modèle obtient 89,7 % sur SWE-bench Pro v2, 74,2 % sur SWE-bench Verified et 54,9 % sur Terminal-Bench 2.1, démontrant ses performances dans les tâches d'ingénierie logicielle et les scénarios d'opérations de terminal. Cela signifie que le positionnement de Flint n'est pas simplement de vous aider à compléter la ligne de code suivante, mais plutôt de tenter de devenir le modèle de base d'un Coding Agent capable de comprendre les tâches de développement, d'appeler des outils et de faire avancer la résolution des problèmes de manière continue.
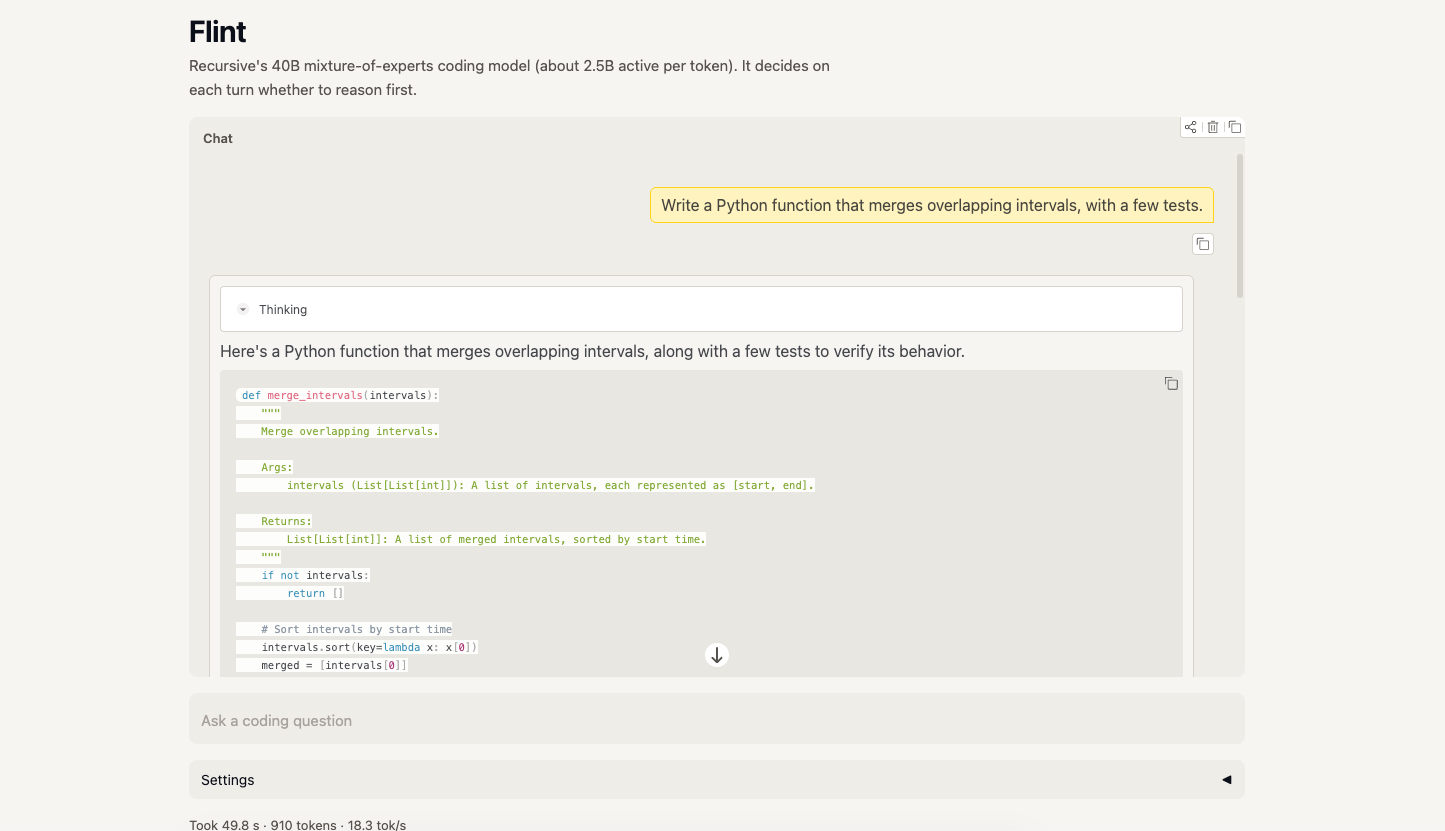
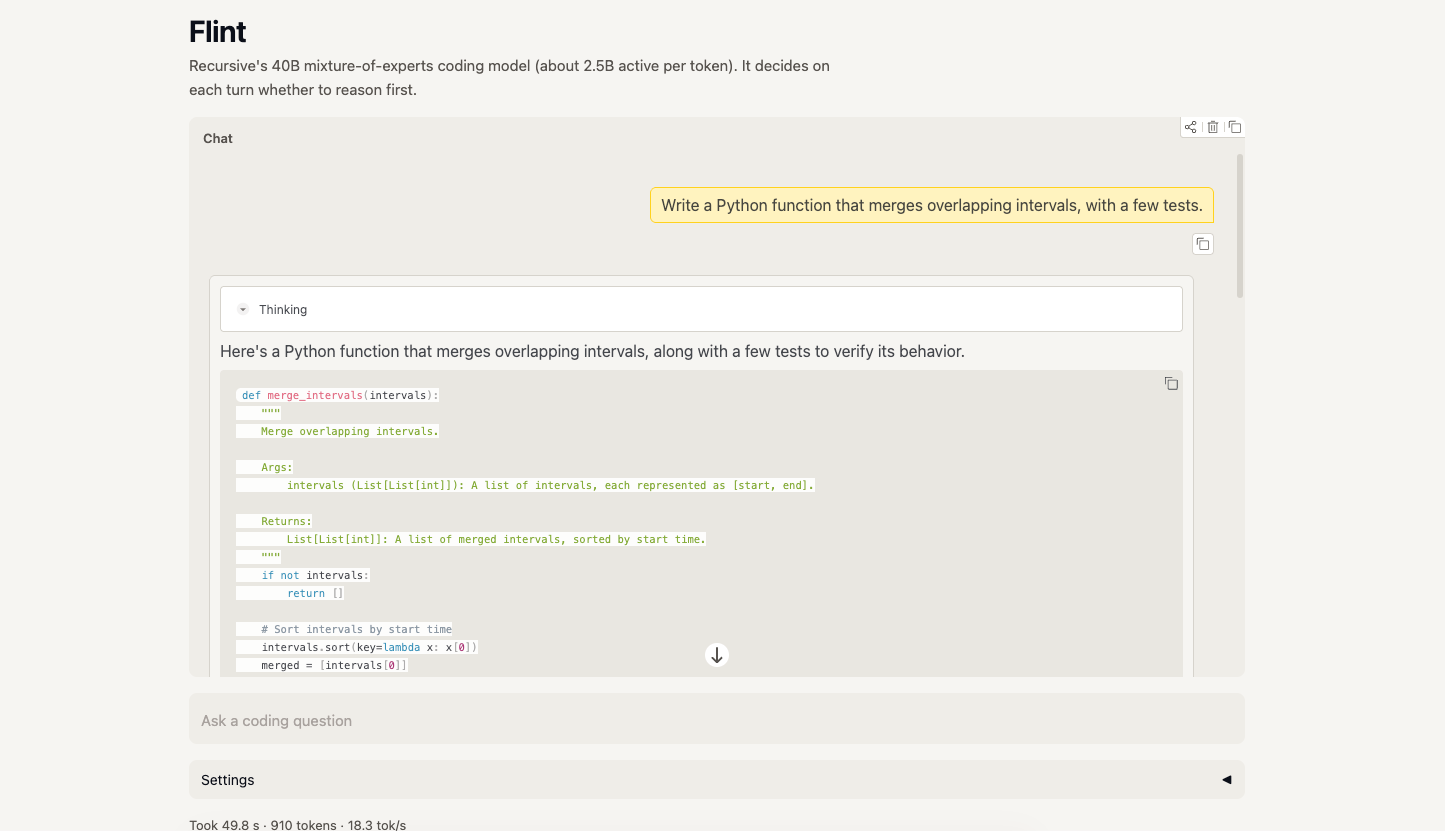
La section Tutoriels de HyperAI propose désormais « Flint : un grand modèle de langage à mélange d'experts pour les Coding Agents ». Les utilisateurs peuvent découvrir via le tutoriel les processus de chargement et d'inférence du modèle, et expérimenter ses capacités de génération de code, de raisonnement et d'appels d'outils.
De la génération d'un bout de code à la participation à la résolution d'une tâche de développement complète, les Coding Agents font évoluer le rôle de l'IA d'un simple assistant de code vers celui de collaborateur de développement.
Exécution en ligne :
Plus de tutoriels en ligne :
Exécution de la démo
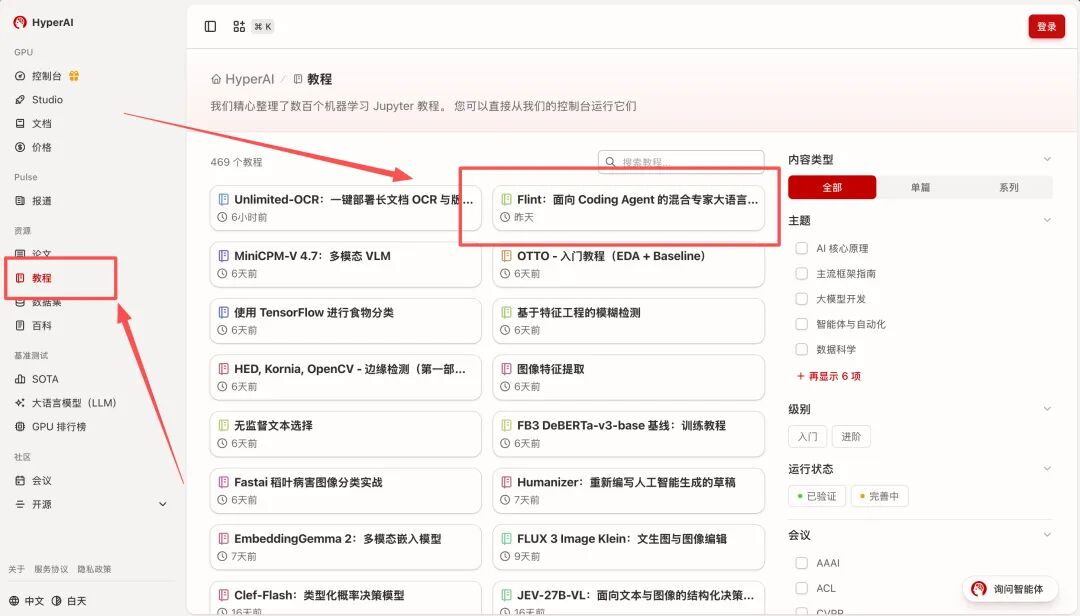
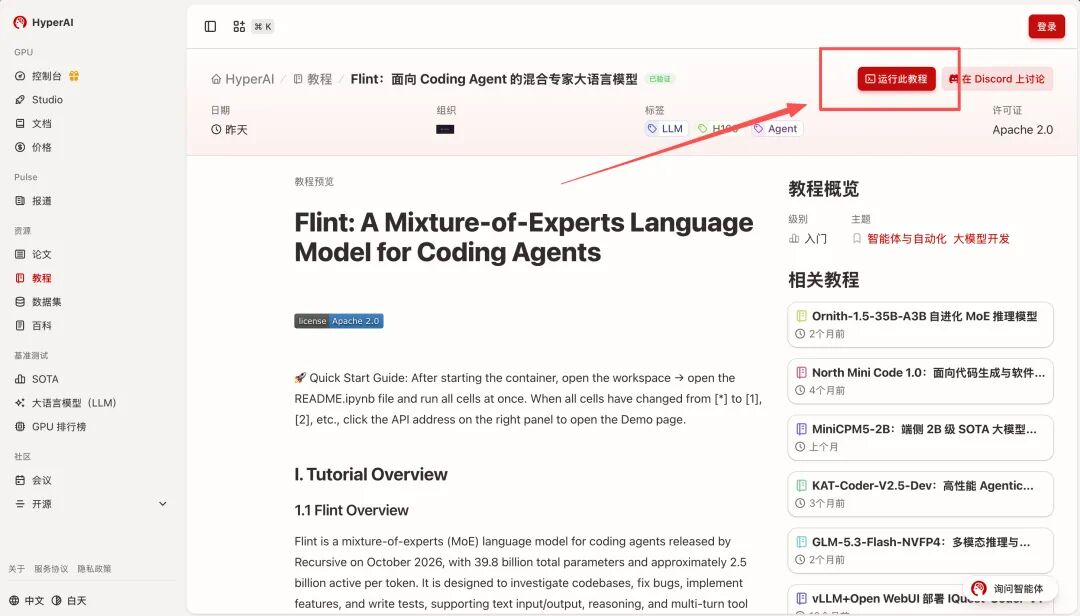
- Après être entré sur la page d'accueil de hyper.ai, sélectionnez la page « Tutoriels » ou cliquez sur « Voir plus de tutoriels », choisissez « Flint : un grand modèle de langage à mélange d'experts pour les Coding Agents », puis cliquez sur « Exécuter ce tutoriel ».
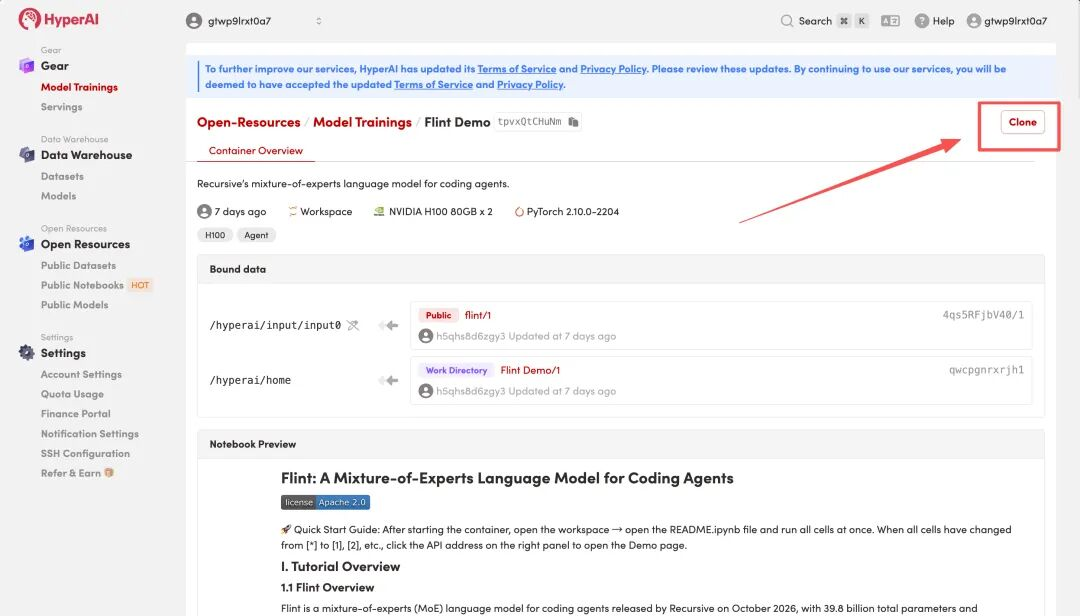
- Après la redirection de la page, cliquez sur « Clone » en haut à droite pour cloner ce tutoriel dans votre propre conteneur.
Note : la langue peut être changée en haut à droite de la page. Actuellement, le chinois et l'anglais sont proposés. Les étapes de ce tutoriel sont illustrées à titre d'exemple en anglais.
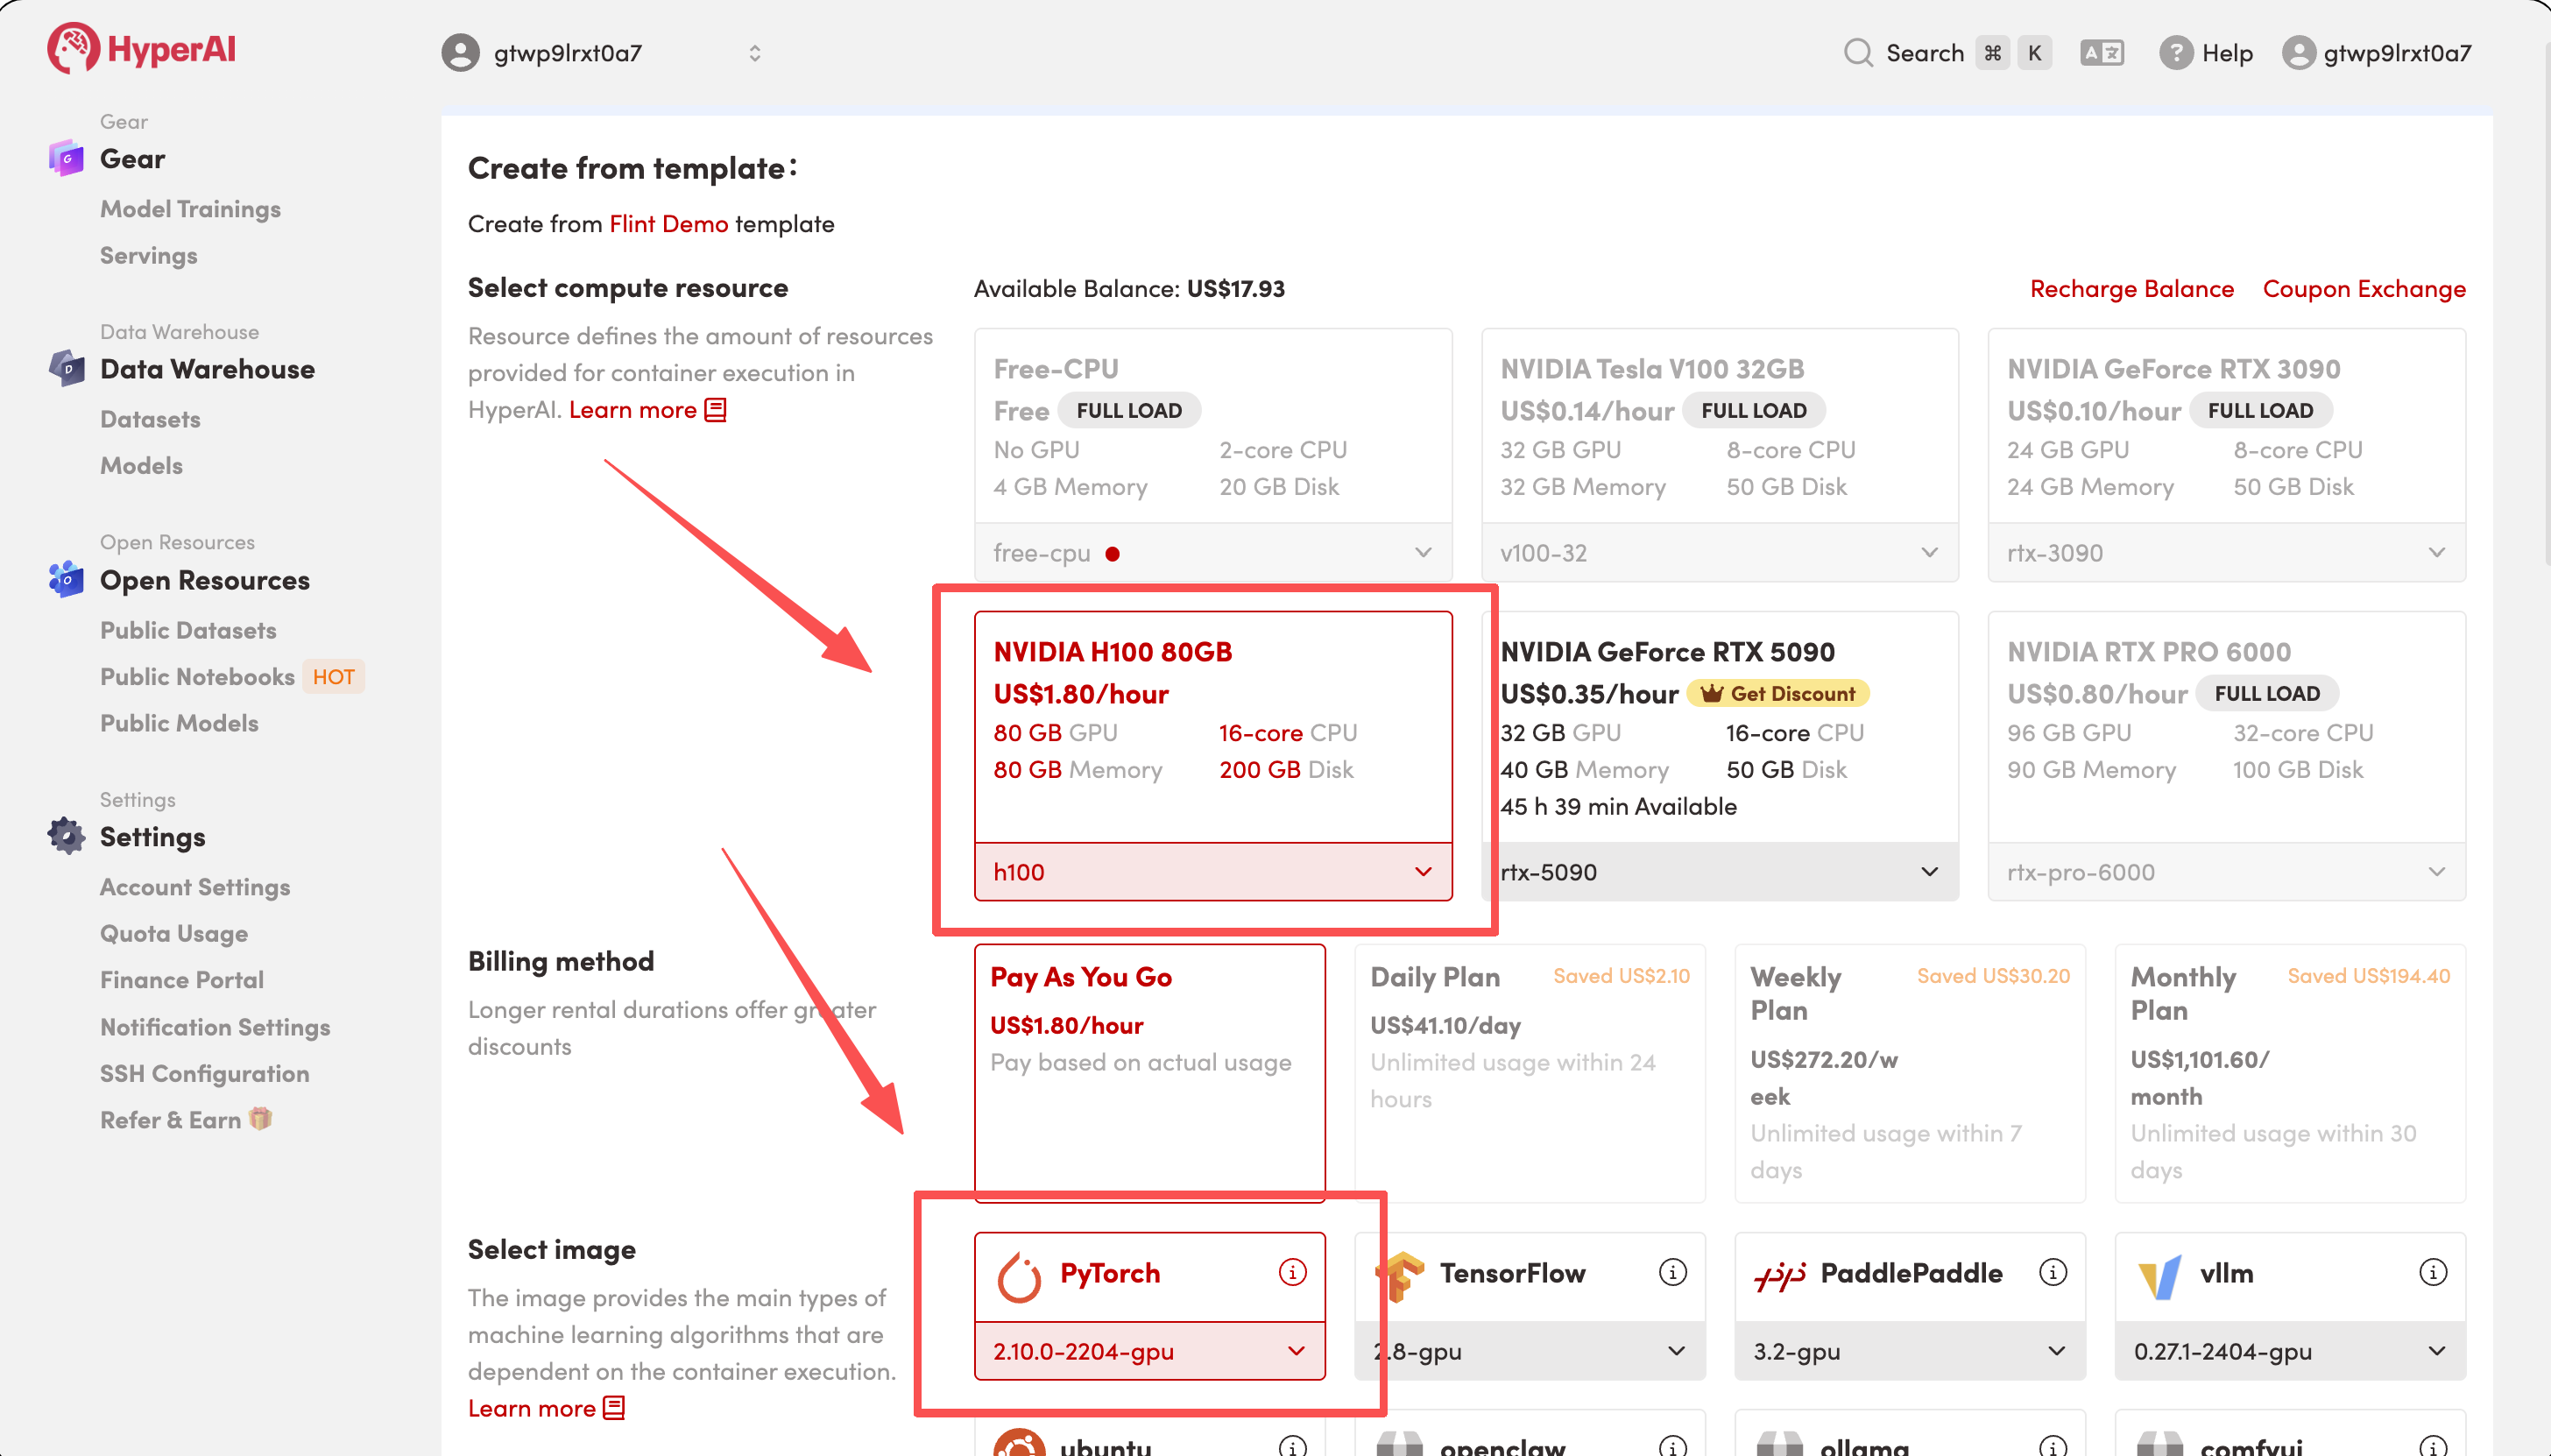
- Sélectionnez « NVIDIA H100 x2 » ainsi que l'image correspondante, puis cliquez sur « Continue job execution (Continuer l'exécution) ».
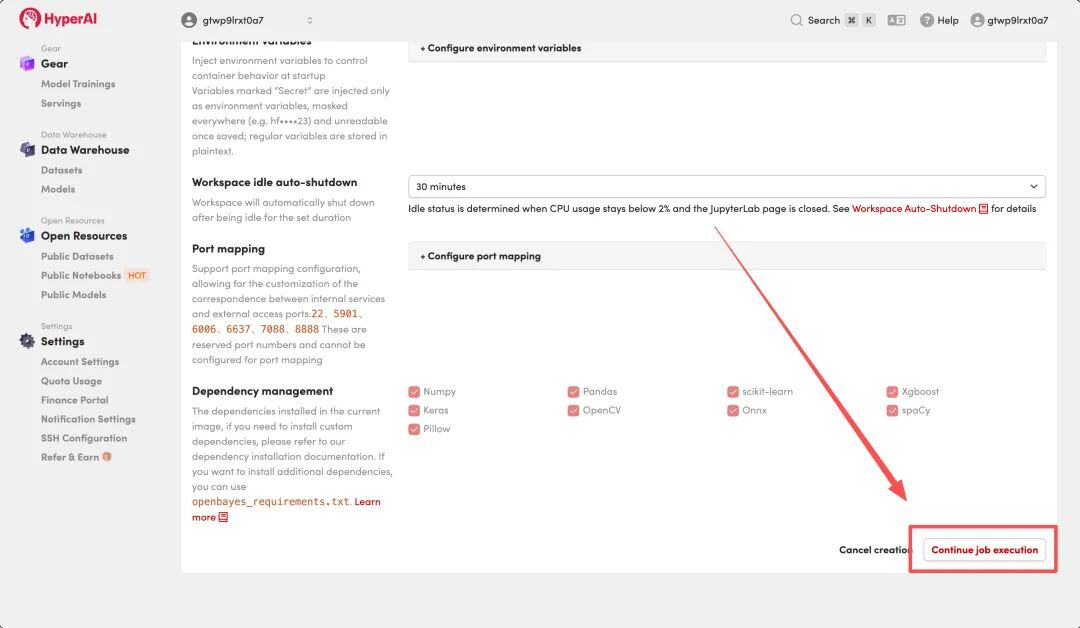
- Attendez l'allocation des ressources. Une fois le statut passé à « Running (En cours d'exécution) », cliquez sur « Open Workspace » pour entrer dans l'espace de travail Jupyter.
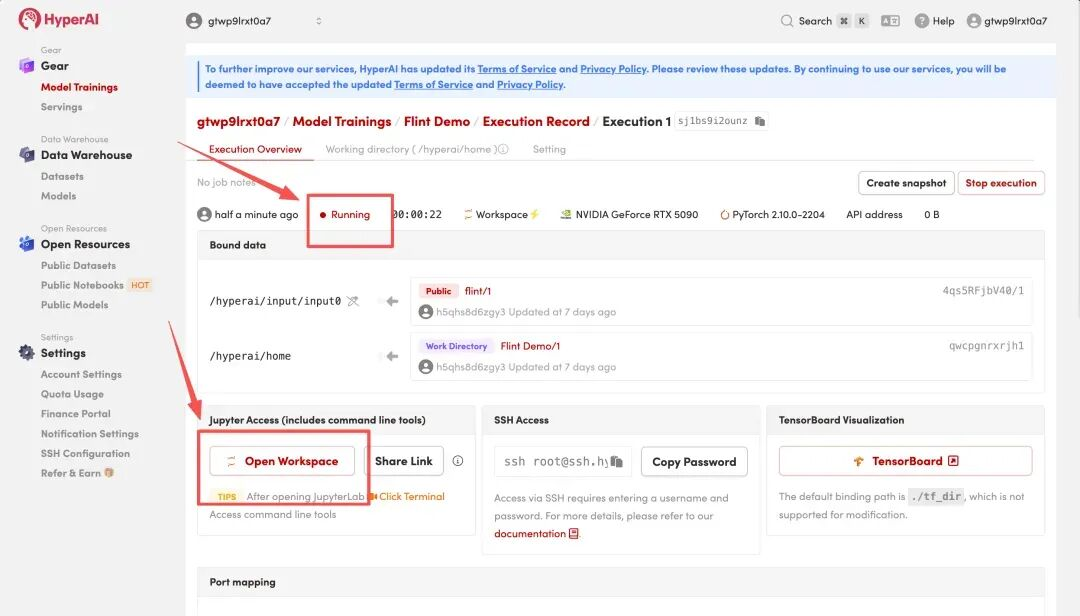
Démonstration des résultats
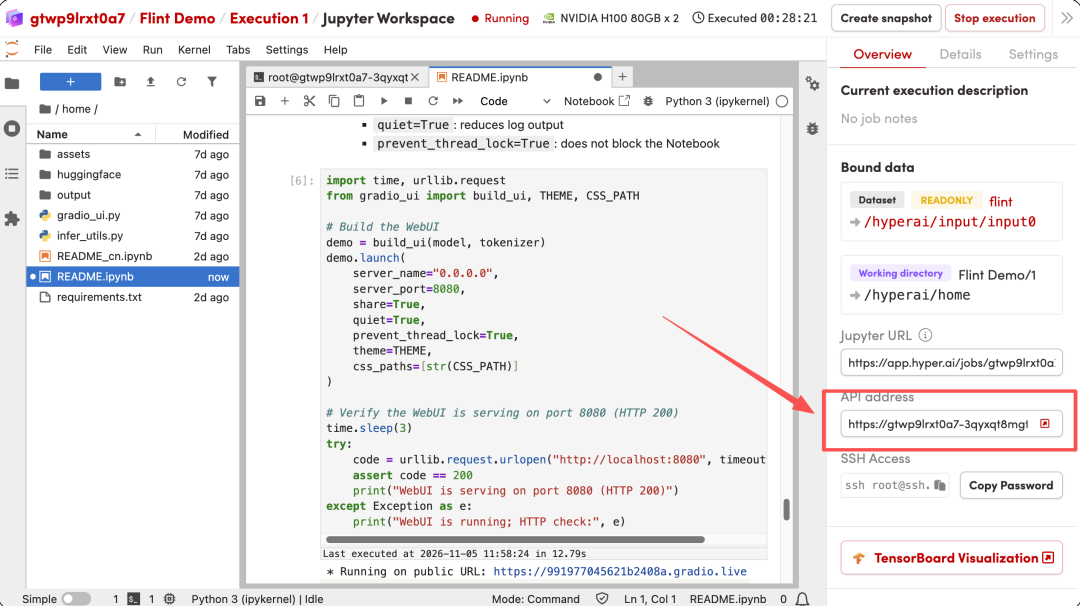
- Après la redirection de la page, cliquez sur le fichier README à gauche, puis cliquez sur « Run (Exécuter) » en haut.
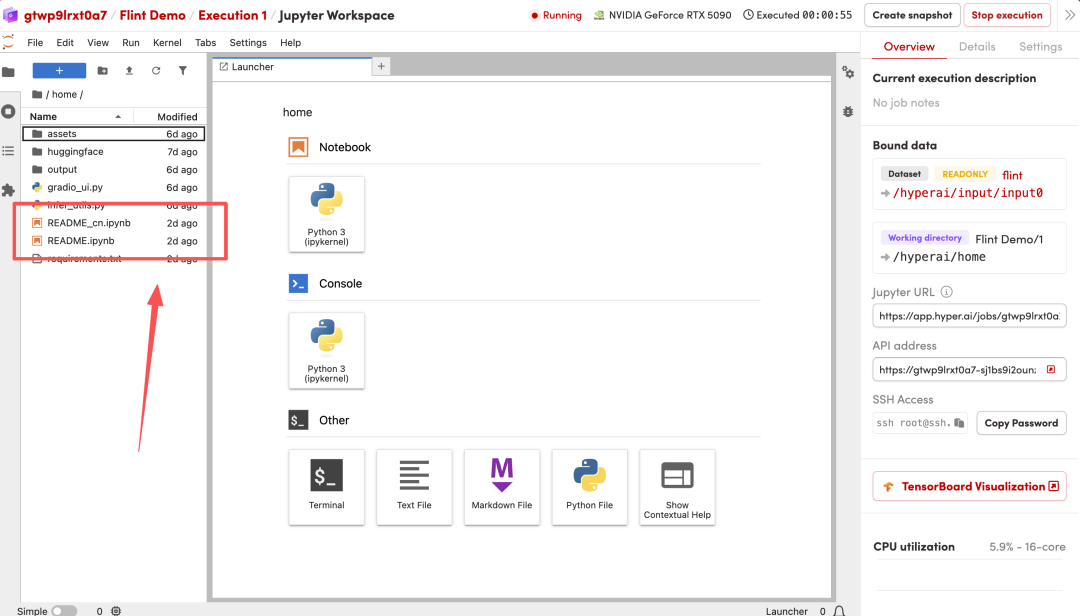
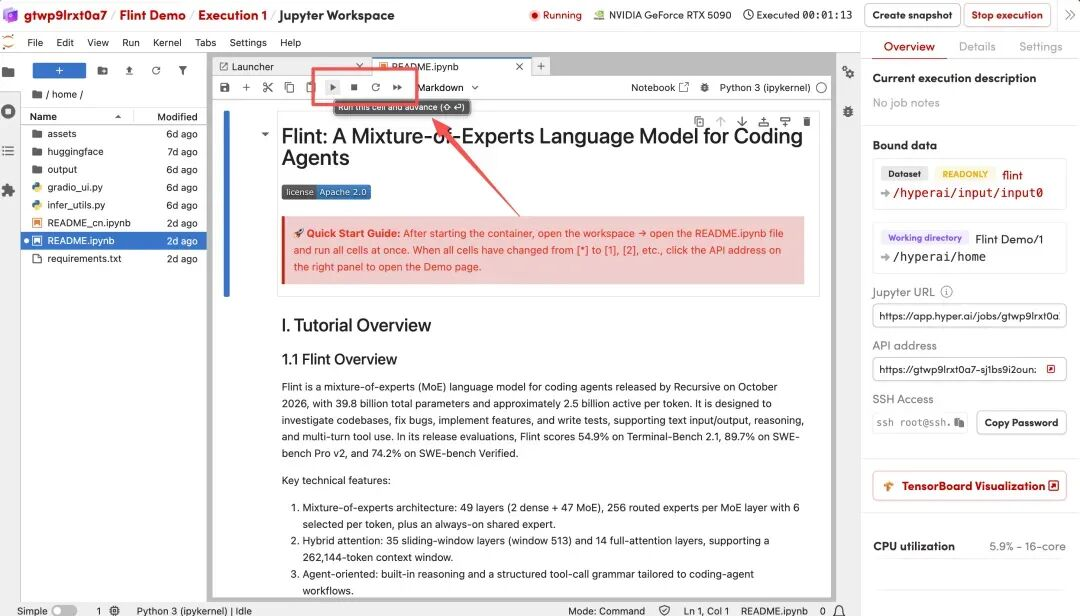
- Une fois l'exécution terminée, ouvrez un nouveau terminal et exécutez la commande suivante pour démarrer Open WebUI.
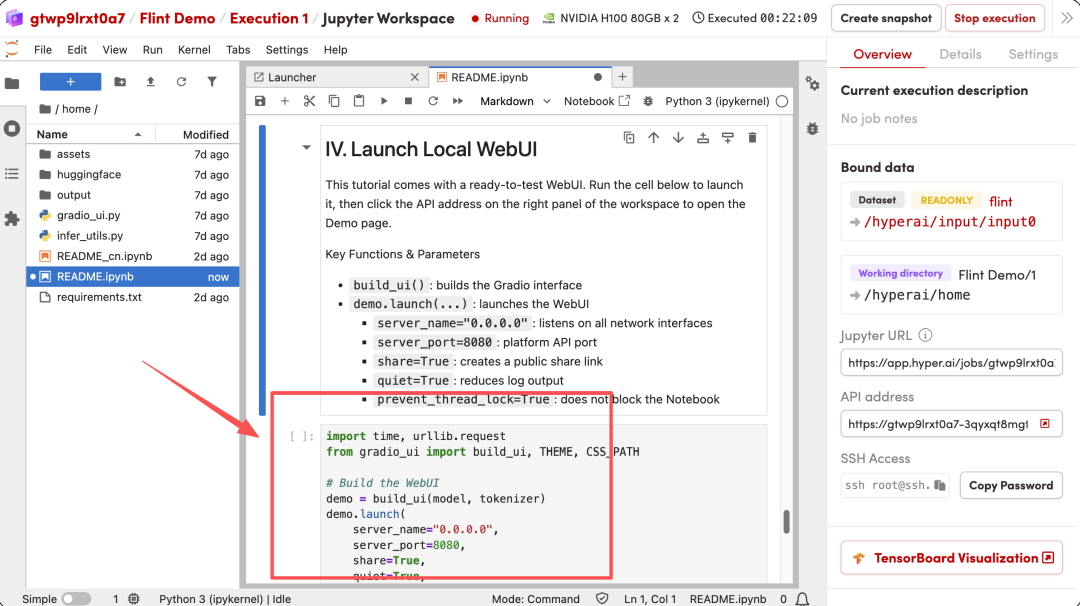
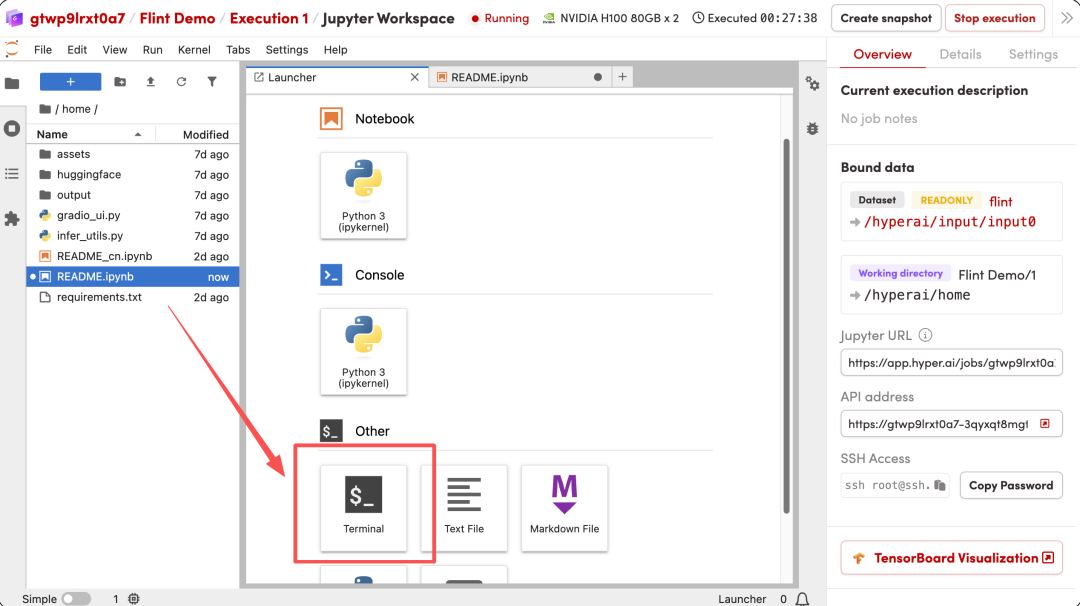
- Une fois démarré, cliquez sur l'adresse API à droite pour accéder à l'interface Open WebUI via le navigateur.