Command Palette
Search for a command to run...
TimesFM 3.0 Prévision De Séries Temporelles En Zéro-shot, Couvrant Les Besoins D'analyse Multi-scénarios ; VLX-Seek Fusionne La Localisation D'objets Et La Compréhension Fine, Élargissant Les Capacités De Perception Visuelle Incarnée
VLX-Seek est un modèle de langage visuel à perception fine lancé par OmAI Lab en juillet 2026, destiné aux applications de vision incarnée sur les appareils de périphérie tels que les robots et les drones. Face au problème pratique où il est difficile de déterminer à quel objet précis l'instruction se réfère, ce modèle combine la compréhension du langage avec la perception visuelle au niveau régional, prend en charge la recherche en fonction des caractéristiques de la cible et des relations de référence, et effectue la reconnaissance de texte, la description de contenu et le comptage autour de la région sélectionnée. De plus, le modèle introduit un mécanisme de rejet en cas d'absence de la cible, fournissant une base pour les recherches ultérieures et les ajustements de tâches. VLX-Seek étend davantage le centre d'application des modèles visuels vers l'identification et l'interaction avec des objets spécifiques, offrant un support de base pour la connexion entre la perception de l'environnement et la prise de décision d'action dans les systèmes d'intelligence incarnée.
Actuellement, le site officiel de HyperAI a mis en ligne « VLX-Seek : Modèle de langage visuel à perception fine », venez vite l'essayer~
Utilisation en ligne : https://go.hyper.ai/oeM9
Du 18 septembre au 24 septembre, aperçu des mises à jour du site officiel hyper.ai :
-
Ensembles de données publics de haute qualité : 5
-
Sélection de tutoriels de qualité : 8
-
Entrées d'encyclopédie populaires : 5
-
Conférences de premier plan avec date limite en octobre : 5
Visitez le site officiel : hyper.ai
Sélection d'ensembles de données publics
1. GooseReason-0.7M Ensemble de données de raisonnement par validation pour l'apprentissage par renforcement
GooseReason-0.7M est un ensemble de données de raisonnement par validation pour l'apprentissage par renforcement (RLVR) à grande échelle publié par NVIDIA en 2026, visant à résoudre le goulot d'étranglement de la rareté des données d'entraînement vérifiables. Il synthétise une quantité illimitée de tâches RLVR à partir de textes Internet riches en raisonnement via le pipeline Golden Goose. L'ensemble de données contient plus de 700 000 tâches couvrant les domaines des mathématiques, de la programmation et des sciences générales, avec une échelle de données de niveau 0,7 M. Il est principalement utilisé pour entraîner le modèle GooseReason-4B-Instruct, qui a obtenu de nouveaux résultats de pointe au niveau des modèles 4B sur 15 benchmarks couvrant les mathématiques, la programmation, le raisonnement STEM, le suivi d'instructions et les énigmes logiques.
Utilisation en ligne : https://go.hyper.ai/eQ6X7
2. GR1-100 Ensemble de données de démonstration de manipulation robotique
GR1-100 est un ensemble de données de manipulation robotique publié par NVIDIA en 2025, contenant 92 clips vidéo, visant à fournir des données vidéo de haute qualité pour l'entraînement des robots. Les données sont au format MP4, avec une taille totale d'environ 142,3 Mo, adaptées à la recherche dans les domaines de la vision par ordinateur et de l'apprentissage robotique. Cet ensemble de données enregistre principalement des vidéos en vue à la troisième personne d'un robot Fourier nommé GR1-T2 effectuant diverses tâches dans un environnement de laboratoire.
Utilisation en ligne : https://go.hyper.ai/BulTI
3. GraspGen : Scaling Sim2Real Grasping Ensemble de données de génération de saisie
GraspGen : Scaling Sim2Real Grasping est un ensemble de données de saisie simulée à grande échelle publié par NVIDIA en 2025. Il contient plus de 57 millions de données de saisie, générées à partir de 8 515 objets de l'ensemble de données Objaverse XL (LVIS), et est conçu pour Franka Panda, la pince industrielle Robotiq-2f-140 et la ventouse à contact ponctuel (rayon de 30 mm). Il vise à améliorer la capacité de transfert des compétences de saisie robotique de la simulation à la réalité grâce à des données de simulation à grande échelle. L'ensemble de données utilise le format WebDataset, avec plus de 57 millions de données de saisie simulée au total, couvrant trois types différents de pinces robotiques, adapté à la recherche dans les domaines de la saisie robotique, du transfert simulation-réalité (Sim2Real) et de l'apprentissage robotique.
Utilisation en ligne : https://go.hyper.ai/81LdN
4. LiveCodeBench-CPP Ensemble de données d'évaluation de génération de code
LiveCodeBench-CPP est un ensemble de données d'évaluation de génération de code C++ publié par NVIDIA en 2025, visant à fournir un benchmark d'évaluation des capacités de génération et de débogage de code basé sur les derniers problèmes de programmation pour les grands modèles de langage. L'ensemble de données contient 454 problèmes de programmation, provenant principalement d'AtCoder (287 problèmes) et de LeetCode (167 problèmes), couvrant les concours et problèmes d'octobre 2024 à mai 2025. Les données comprennent les descriptions des problèmes, les sources des plateformes, les difficultés, les cas de test et les métadonnées associées, principalement utilisées pour évaluer les capacités de génération de code et de résolution de problèmes des modèles dans des tâches de programmation réelles.
Utilisation en ligne : https://go.hyper.ai/YdSXz
5. HelpSteer Ensemble de données d'alignement d'utilité
HelpSteer est un ensemble de données publié par NVIDIA en 2023 pour l'alignement des grands modèles de langage, visant à améliorer l'utilité, la correction et la cohérence des réponses du modèle, tout en permettant d'ajuster la complexité et le niveau de détail des réponses. L'ensemble de données contient 37 120 échantillons, couvrant divers types de tâches telles que la réécriture, le résumé, la classification, l'extraction et la question-réponse. Chaque échantillon comprend un prompt, une réponse du modèle et cinq attributs annotés manuellement : l'utilité, la correction, la cohérence, la complexité et le niveau de détail, avec des scores allant de 0 à 4. Les données sont annotées par l'organisation Scale AI, principalement utilisées pour l'entraînement, l'évaluation et la recherche sur l'alignement des grands modèles de langage.
Utilisation en ligne : https://go.hyper.ai/B5OPS
Sélection de tutoriels publics
1. TimesFM 3.0 : Prévision de séries temporelles zero-shot
TimesFM 3.0 est un modèle de fondation pour séries temporelles lancé par Google Research en août 2026. Il utilise une méthode de prévision pré-entraînée zero-shot, capable de prédire de nouvelles séries temporelles sans nécessiter de fine-tuning spécifique à une tâche. Le modèle prend nativement en charge les entrées univariées, multivariées et les covariables, et renforce la capacité de généralisation zero-shot. Il peut être utilisé pour l'analyse de séries temporelles dans des scénarios tels que les ventes au détail, l'analyse financière, la météo, la demande énergétique et la prévision de la chaîne d'approvisionnement.
Exécution en ligne : https://go.hyper.ai/DRk3i
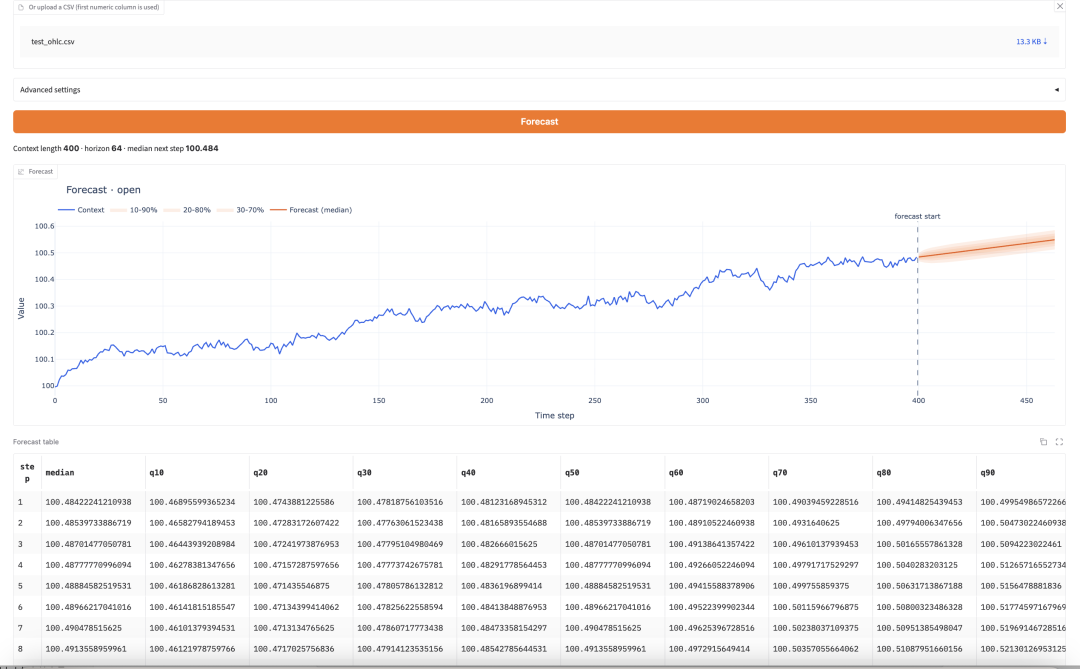
Page de démonstration
2. VLX-Seek : Modèle de langage visuel à perception fine
VLX-Seek est un modèle de langage visuel (VLM) à perception fine lancé par OmAI Lab en juillet 2026. Conçu pour les scénarios de vision embarquée, il permet, tout en comprenant le contenu des images, d'effectuer la localisation d'objets, la distinction d'instances et la perception visuelle fine. Le modèle prend en charge la détection d'objets, la compréhension d'expressions référentielles, la description de régions, l'OCR régional, le comptage et la détection par inférence. Grâce à un mécanisme de rejet à vocabulaire ouvert, il renvoie None lorsque l'objectif n'existe pas. Il peut être utilisé pour des scénarios d'intelligence embarquée tels que les robots et les drones.
Exécution en ligne : https://go.hyper.ai/oeM92
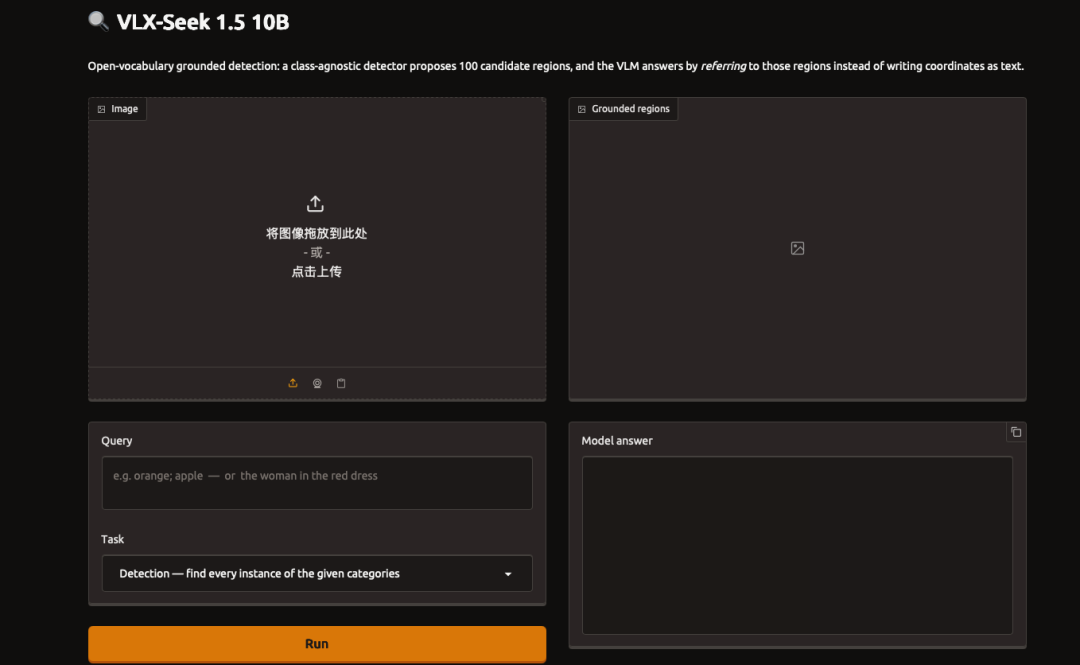
Page de démonstration
3. Breeze TTS 2 — Modèle open source de synthèse vocale en temps réel
Breeze TTS 2 est un modèle de synthèse vocale à poids ouverts lancé par l'équipe BreezeBlue en août 2026. Destiné aux scénarios d'interaction vocale en temps réel, il prend en charge la conception vocale, le clonage vocal et le contrôle des émotions via le langage naturel. Le modèle prend en charge le bilinguisme chinois-anglais, permet d'ajuster le ton, le débit et l'émotion par des instructions textuelles, et prend en charge les événements sonores tels que les rires et les soupirs, ainsi que la génération en streaming à très faible latence. Il peut être utilisé pour les assistants vocaux en temps réel, le contenu audio, la localisation de doublage et les services d'accessibilité.
Exécution en ligne : https://go.hyper.ai/JStch
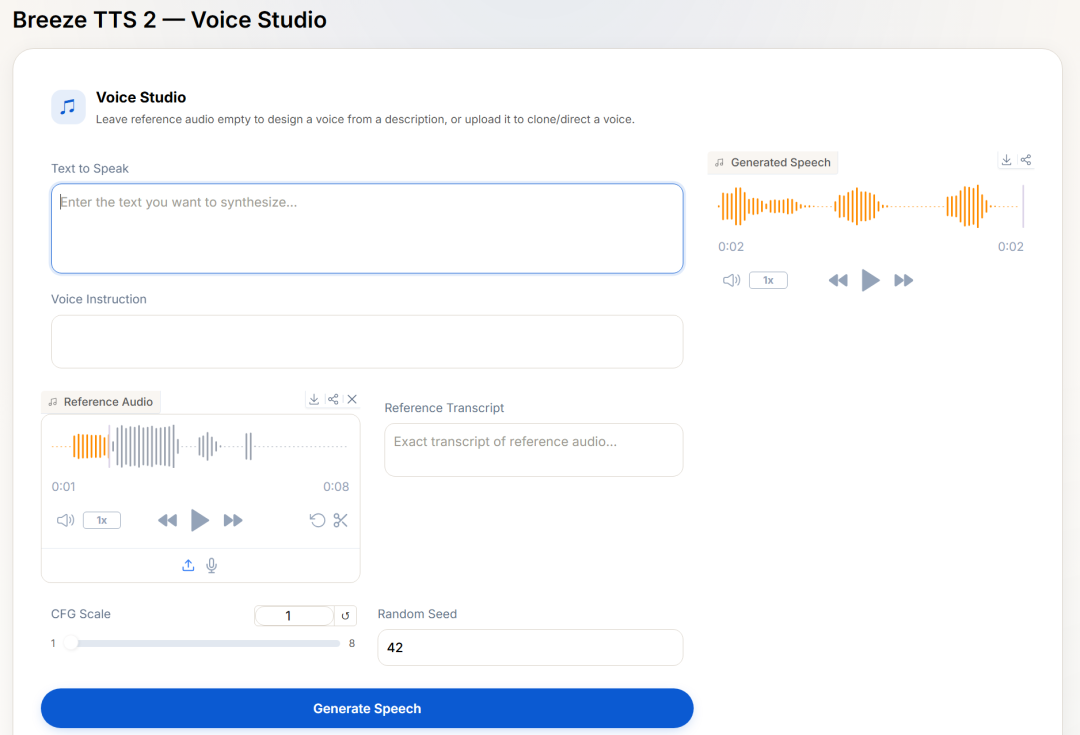
Page de démonstration
4. Tutoriel d'introduction à l'apprentissage statistique
Ce tutoriel a été publié en 2018 par l'utilisateur Kaggle DATAI. Il utilise le Breast Cancer Wisconsin Diagnostic Dataset comme exemple pour expliquer, à partir de zéro, les bases de l'apprentissage statistique et les méthodes d'analyse courantes. Le tutoriel couvre l'exploration et la visualisation des données, les statistiques descriptives telles que la moyenne et la variance, la fonction de distribution cumulative, la taille d'effet et la corrélation, les tests d'hypothèses et les valeurs p, ainsi que la distribution normale et le calcul du score Z. Il convient aux débutants en apprentissage statistique.
Exécution en ligne : https://go.hyper.ai/fVzMx
5. Tutoriel d'entraînement EfficientDet : Détection d'objets pour les épis de blé
Ce tutoriel est basé sur le pipeline d'entraînement construit par Alex Shonenkov pour le concours Kaggle Global Wheat Detection. Il met en pratique, à partir de zéro, le modèle de détection d'objets EfficientDet. Le tutoriel couvre la configuration de l'environnement et la vérification du GPU, le chargement du jeu de données du concours, l'augmentation de données avec Albumentations, la construction du modèle EfficientDet-D5 et le processus d'entraînement complet. Il convient aux développeurs souhaitant apprendre l'entraînement et la mise en pratique des modèles de détection d'objets.
Exécution en ligne : https://go.hyper.ai/AtDMM
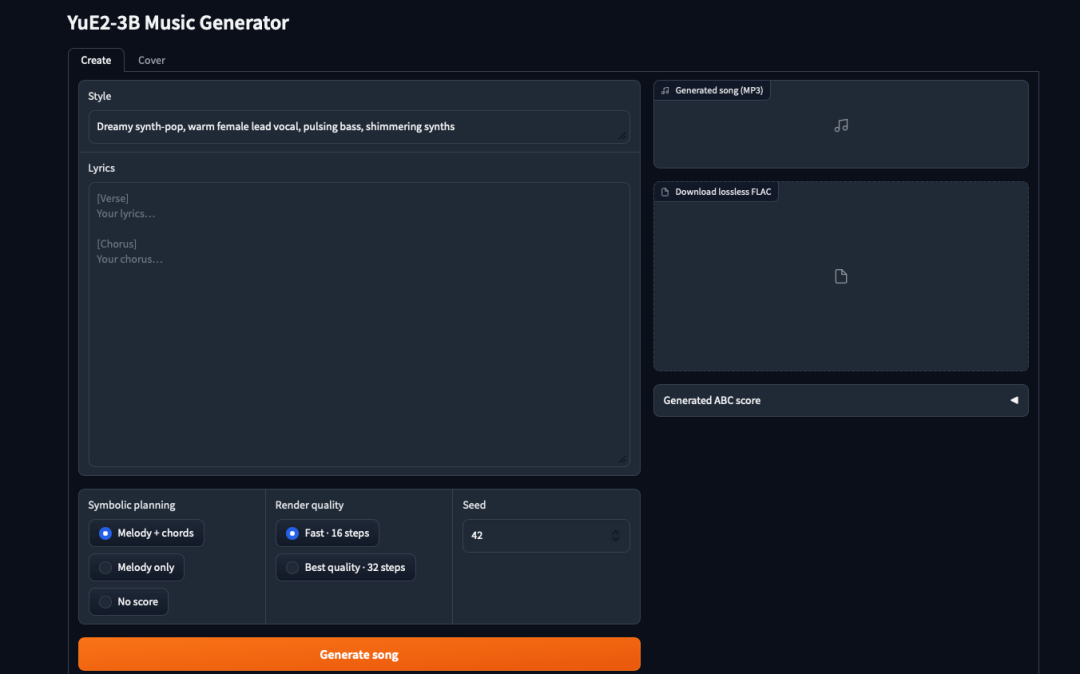
6. YuE2-3B : Modèle open source de pointe pour la génération musicale
YuE2-3B est un modèle open source de génération musicale lancé en 2026 par l'équipe Multimodal Art Projection (m-a-p). Il peut générer des chansons complètes avec voix et accompagnement à partir de paroles et d'indications de style. Le modèle utilise une architecture Mixture-of-Transformers AR–NAR, prend en charge trois modes : mélodie avec accords, mélodie seule et génération directe, et prend en charge la sortie stéréo 48 kHz. Il peut être utilisé pour la génération de musique à partir de texte, les reprises de chansons et l'édition musicale intelligente.
Exécution en ligne : https://go.hyper.ai/t4G7M
Page de démonstration
7. Tutoriel de développement de lecteur vidéo FFmpeg : De la capture d'images à la navigation
Cette série de tutoriels est adaptée du tutoriel classique « An ffmpeg and SDL Tutorial » publié par Stephen Dranger en 2015. Elle réimplémente le contenu principal avec Python et les outils en ligne de commande FFmpeg, en expliquant à partir de zéro le fonctionnement de l'audio et de la vidéo numériques. Le tutoriel couvre les concepts de base tels que les conteneurs, les flux, les codecs, les paquets, les trames et les horodatages, et met en pratique progressivement la synchronisation vidéo, la synchronisation audio et l'adressage multimédia à travers des expériences exécutables. Il convient à l'apprentissage des technologies liées aux lecteurs, au transcodage, au streaming multimédia et à la vision par ordinateur.
Exécution en ligne : https://go.hyper.ai/rtrW4
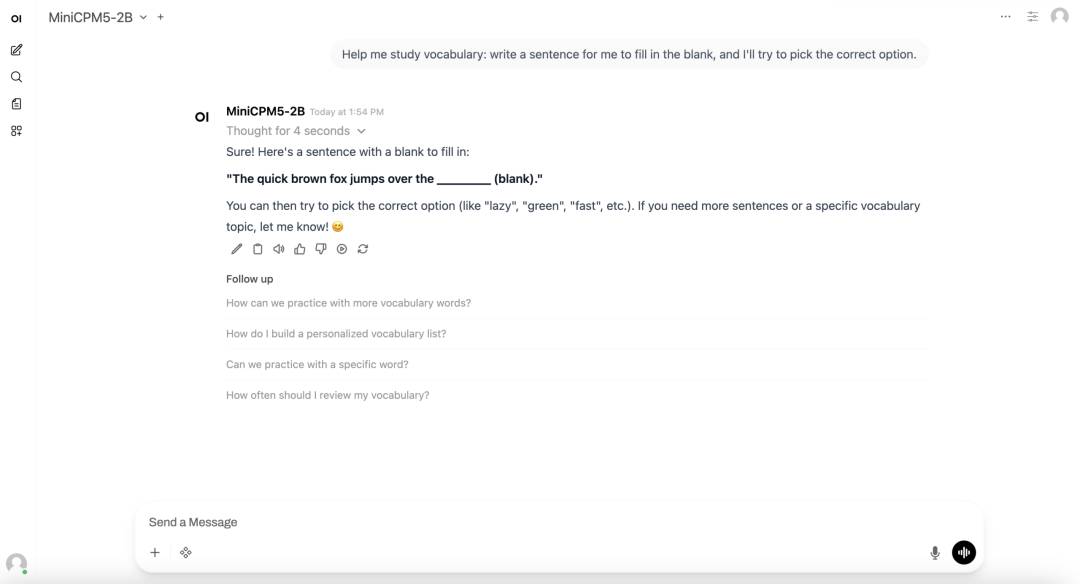
8. MiniCPM5-2B : Inférence de modèle de pointe SOTA 2B embarqué
MiniCPM5-2B est un modèle de langage open source de niveau 2B lancé par OpenBMB en septembre 2026, et le deuxième modèle de la série MiniCPM5. Il adopte une architecture standard LlamaForCausalLM, conçue pour le déploiement en périphérie, l'inférence locale et les scénarios à ressources limitées. Le modèle prend en charge jusqu'à 131K de contexte et dispose de capacités de raisonnement en code et en mathématiques, d'appel d'outils et d'agent, pouvant être utilisé pour des assistants IA locaux, l'aide à la programmation, les réponses aux questions de connaissances et les applications d'agents intelligents.
Exécution en ligne : https://go.hyper.ai/D8jnq
page de démo
Sélection d'articles encyclopédiques populaires
1. Reconnaissance optique de caractères OCR
2. Modèle d'action mondial WAM
3. Télédétection Remote Sensing
4. Jeton défectueux Glitch Token
5. Modèle de transformateur pré-entraîné génératif GPT
Une compilation de centaines d'articles liés à l'IA est disponible ici pour t'aider à comprendre « l'intelligence artificielle » :
Conférences de haut niveau avec date limite en octobre
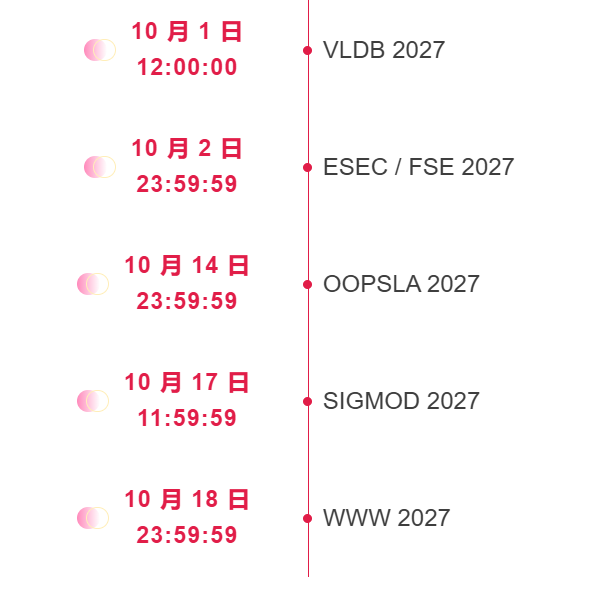
*La date limite est en heure AoE
Suivi en un seul endroit des conférences académiques de haut niveau en IA : https://go.hyper.ai/event
Voilà tout le contenu sélectionné par la rédaction cette semaine. Si tu as des ressources à inclure sur le site officiel de hyper.ai, n'hésite pas à laisser un message ou à nous les soumettre !
À la semaine prochaine !