Command Palette
Search for a command to run...
Online-Tutorial | Deckt 40 Sprachen Ab / Verarbeitet 1 Stunde Aufnahme: NVIDIA Veröffentlicht Nemotron 3.5 Transcribe Als Open Source, Ermöglicht Anweisungssteuerbare Spracherkennung, Übersetzung Und Audio-Frage-Antwort

Nach der Transkription einer Besprechungsaufnahme in Text können weiterhin einige Probleme bestehen: Wie lassen sich mehrere Sprecher unterscheiden? Wurden Fachbegriffe möglicherweise falsch erkannt? Wenn zusätzlich Untertitel oder Übersetzungen erstellt werden sollen, können die gewünschten Ergebnisse direkt aus der Aufnahme erzielt werden?
NVIDIAs Nemotron 3.5 Transcribe versucht, diese unterschiedlichen Anforderungen über Anweisungen zu bearbeiten. Nutzer können das Modell anweisen, mündliche Füllwörter und Wiederholungen beizubehalten und ein wörtliches Transkript zu erzeugen; oder es bitten, die Ausdrucksweise zu bereinigen und besser lesbaren Text auszugeben. Das Modell unterstützt außerdem Sprecherkennzeichnung, Übersetzung gesprochener Sprache, Sprachidentifikation und Audio-Frage-Antwort. Laut offizieller Modellkarte deckt es 40 Sprachen ab und kann Aufnahmen von bis zu etwa einer Stunde Länge verarbeiten; der Unterstützungsgrad variiert je nach Sprache und Aufgabe.
Nemotron 3.5 Transcribe verwendet eine hybride Mamba-2- und Transformer-MoE-Architektur mit insgesamt etwa 34B Parametern; bei der Verarbeitung jedes Tokens werden etwa 4,3B Parameter aktiviert. Es enthält einen Audio-Encoder. Von NVIDIA veröffentlichte Benchmarks zeigen, dass das Modell bei englischen, Langaudio- und mehrsprachigen Spracherkennungs-Benchmarks wettbewerbsfähige Ergebnisse erzielt. Es ist für die Offline-Audioverarbeitung konzipiert und darf aufgrund seines internen Chunking-Mechanismus nicht als Echtzeit-Streaming-Transkriptionsmodell betrachtet werden.
Derzeit hat HyperAI „NVIDIA-Nemotron-3.5-Transcribe-30B-A4B: Anweisungssteuerbare Spracherkennung, Übersetzung und Audio-Frage-Antwort“ veröffentlicht, die Umgebung eingerichtet und die Einstiegshürde für die Bereitstellung erheblich gesenkt ⬇️
Online ausführen:
Weitere Online-Tutorials:
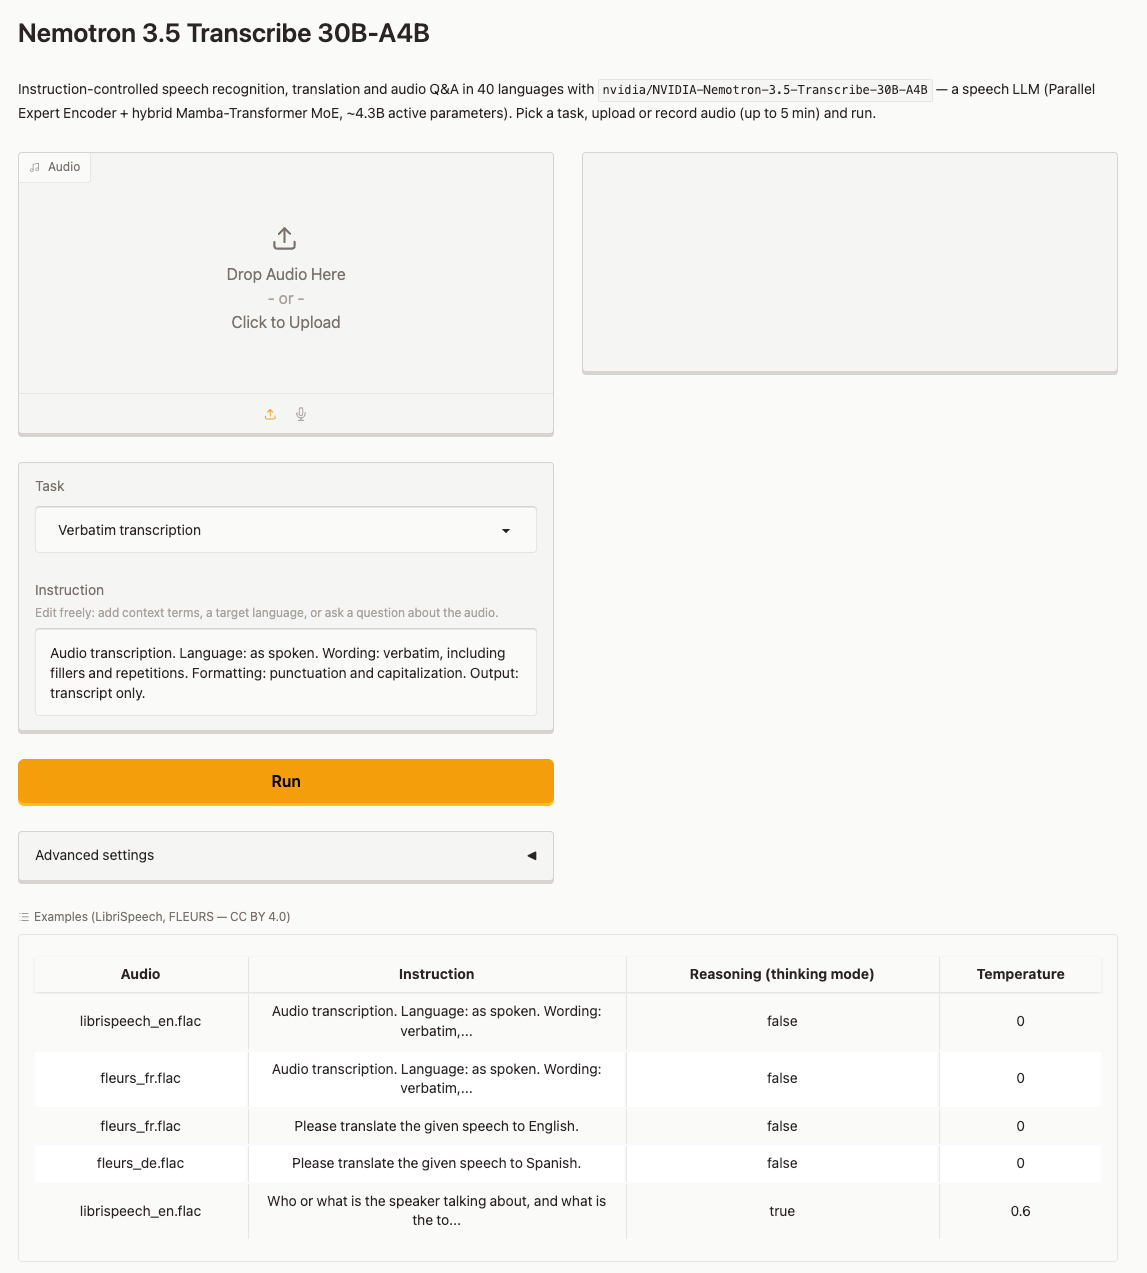
Demo ausführen
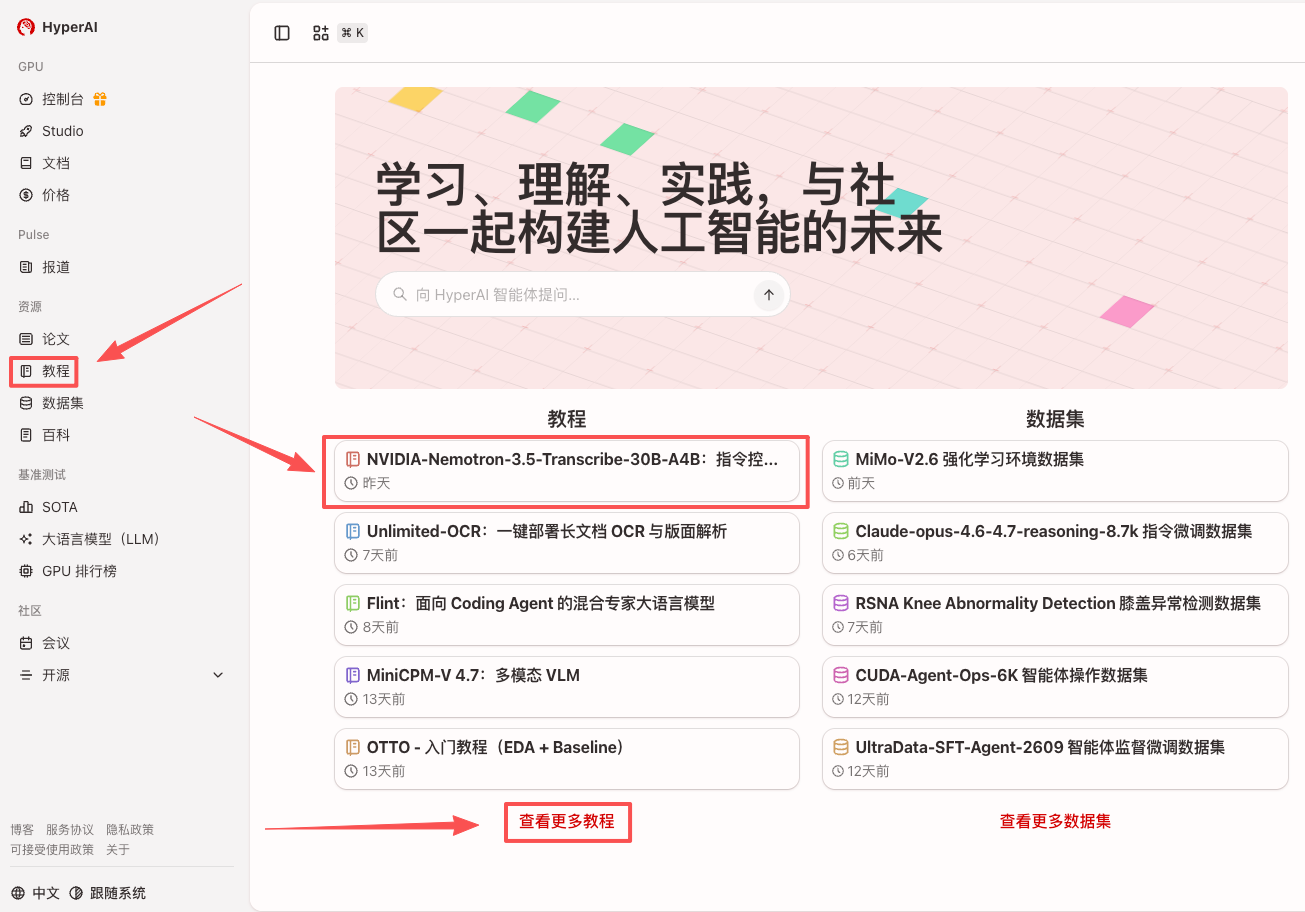
- Gehen Sie auf die Startseite von hyper.ai, wählen Sie die Seite „Tutorials“ oder klicken Sie auf „Weitere Tutorials anzeigen“, wählen Sie „NVIDIA-Nemotron-3.5-Transcribe-30B-A4B: Anweisungssteuerbare Spracherkennung, Übersetzung und Audio-Frage-Antwort“ und klicken Sie auf „Dieses Tutorial ausführen“.
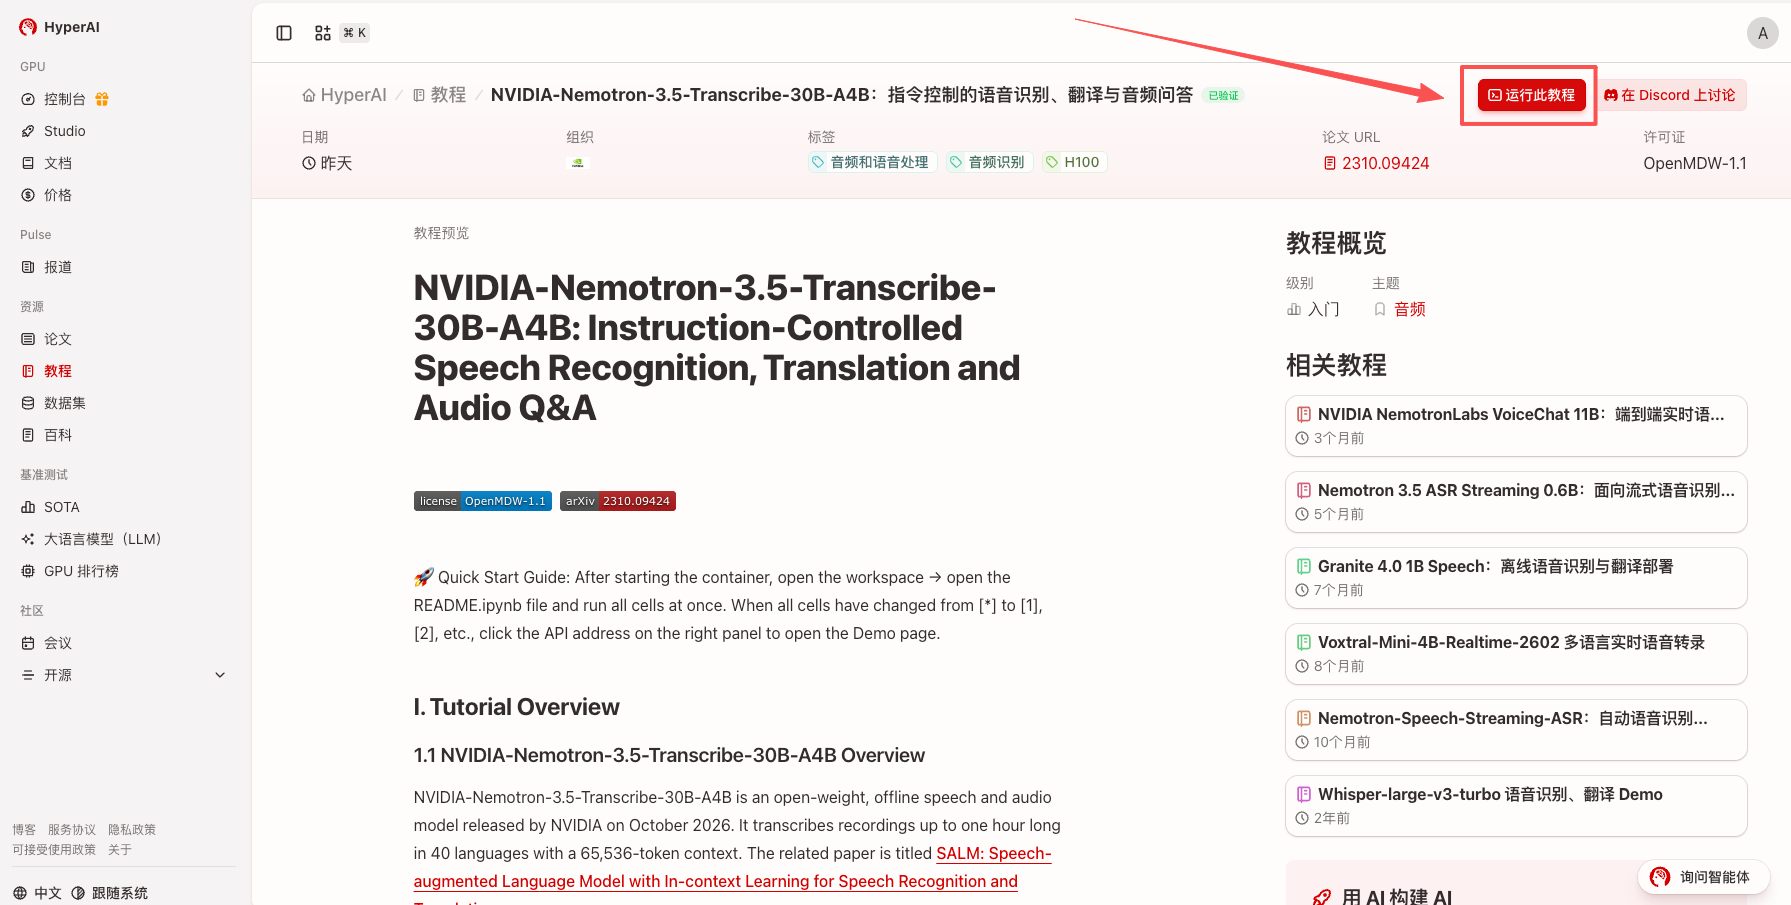
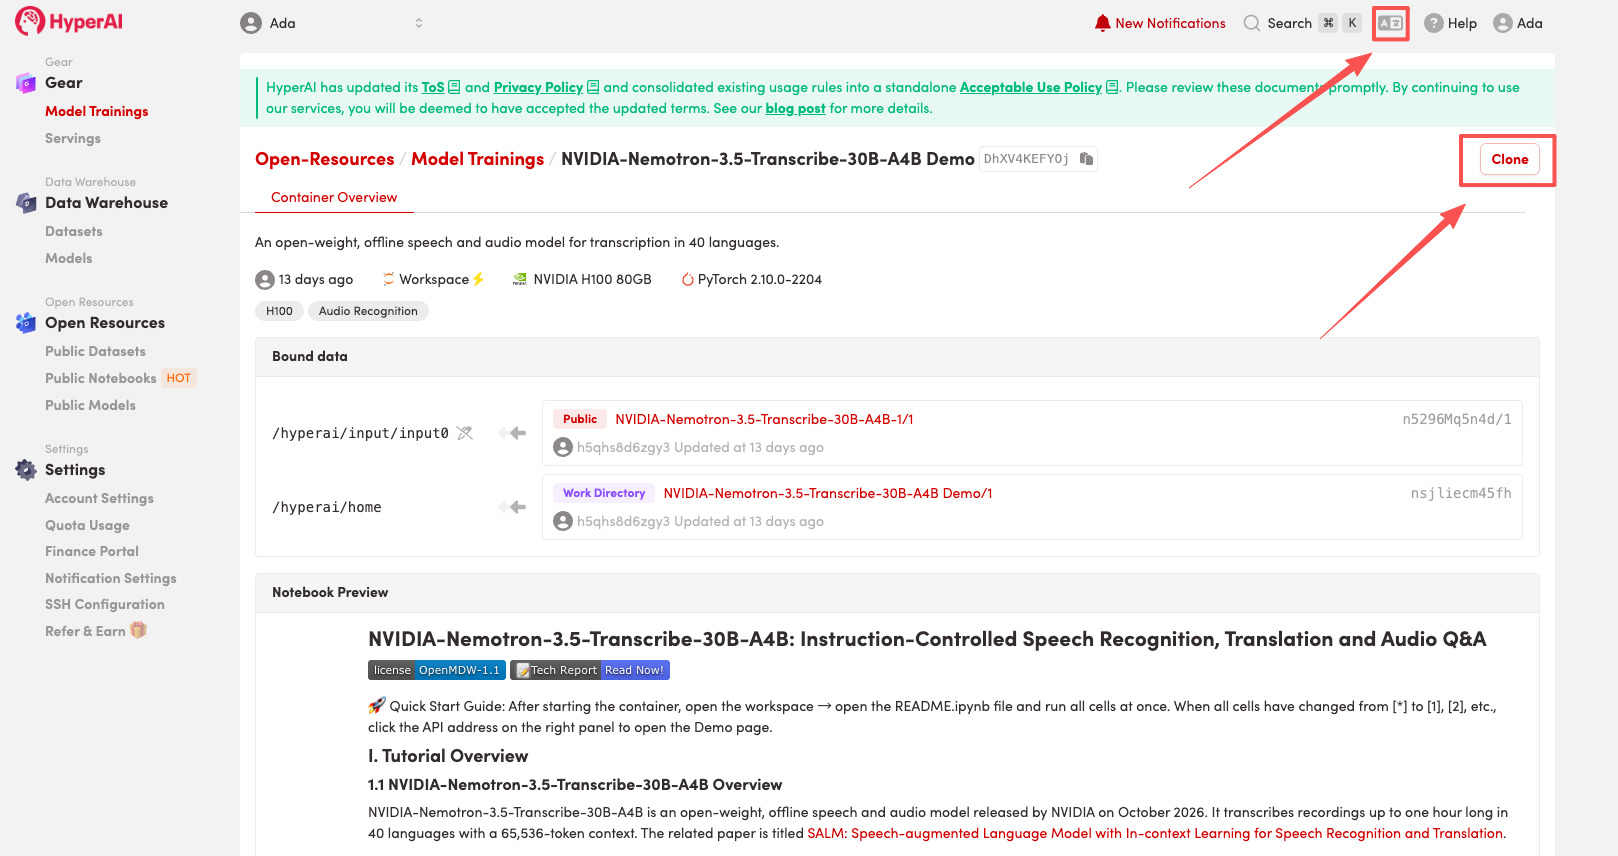
- Nach der Seitenweiterleitung klicken Sie oben rechts auf „Clone“, um dieses Tutorial in Ihren eigenen Container zu klonen.
Hinweis: Oben rechts auf der Seite kann die Sprache umgeschaltet werden. Derzeit sind Chinesisch und Englisch verfügbar; in diesem Tutorial werden die Schritte anhand der englischen Version gezeigt.
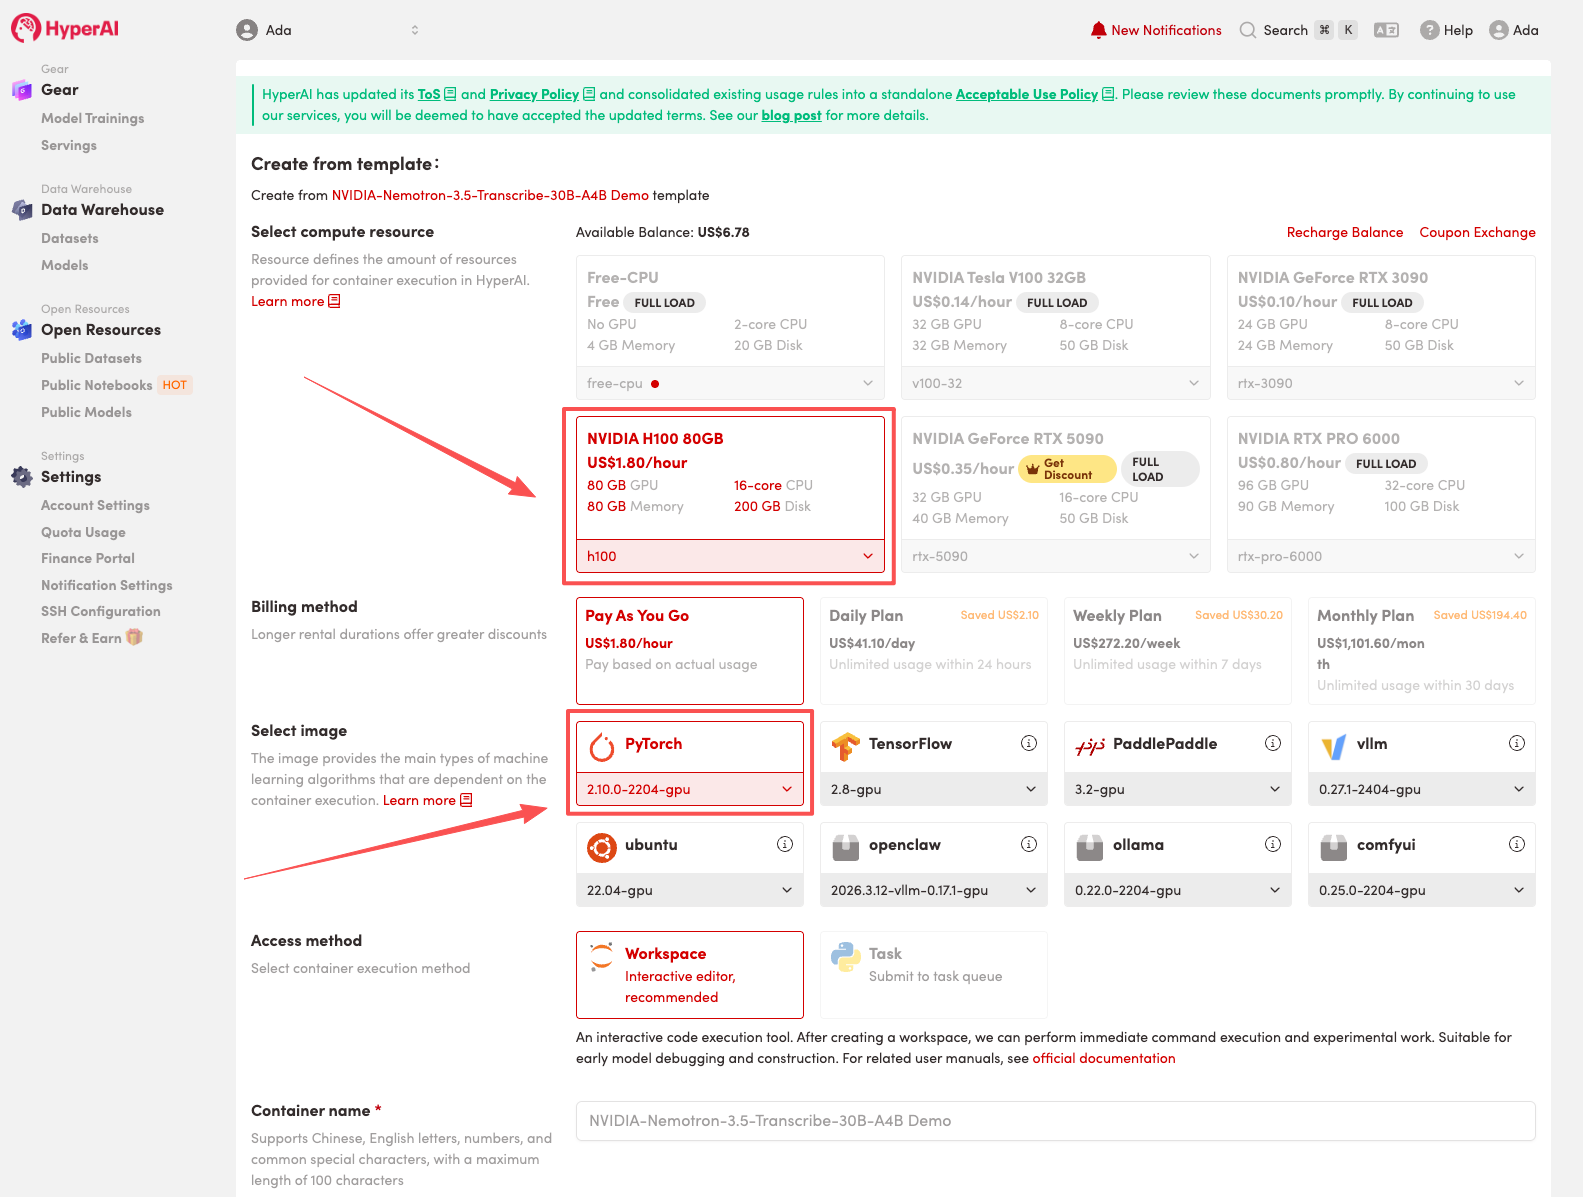
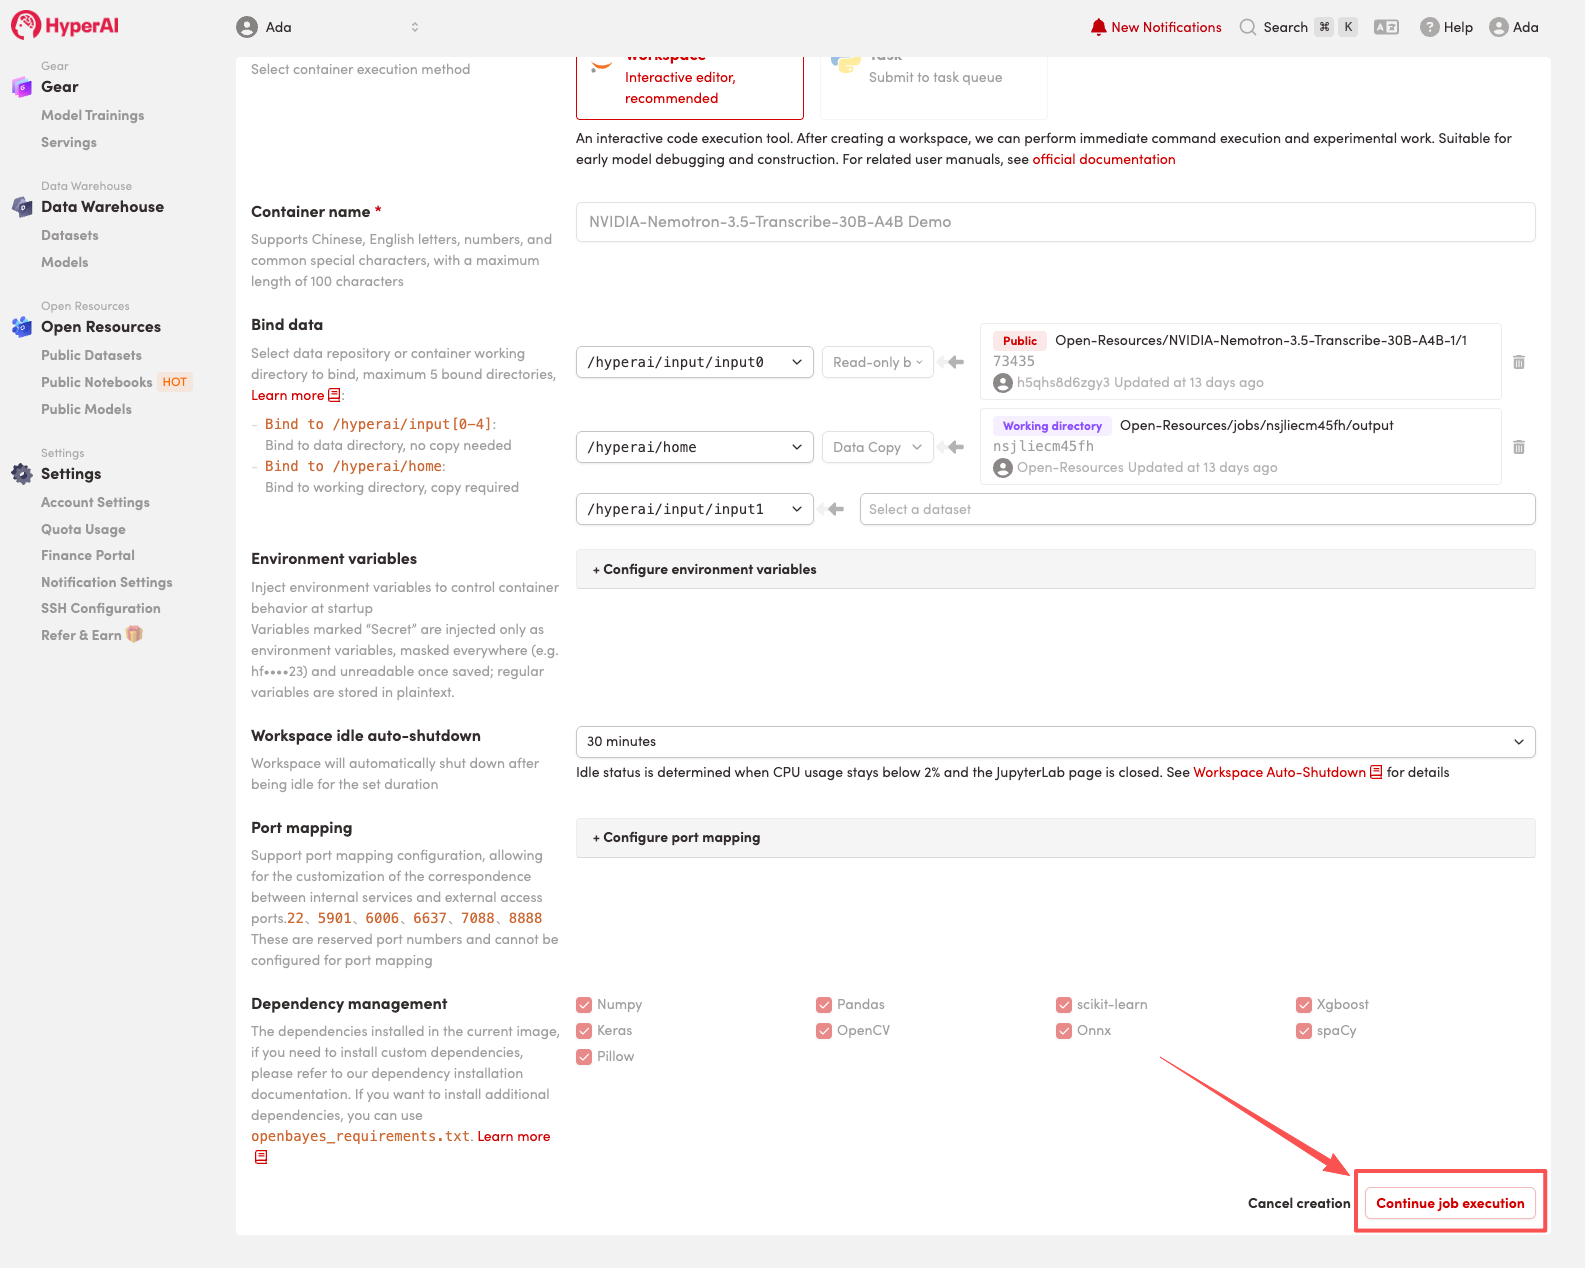
- Wählen Sie „NVIDIA H100“ und das entsprechende Image und klicken Sie auf „Continue job execution (Fortfahren)“.
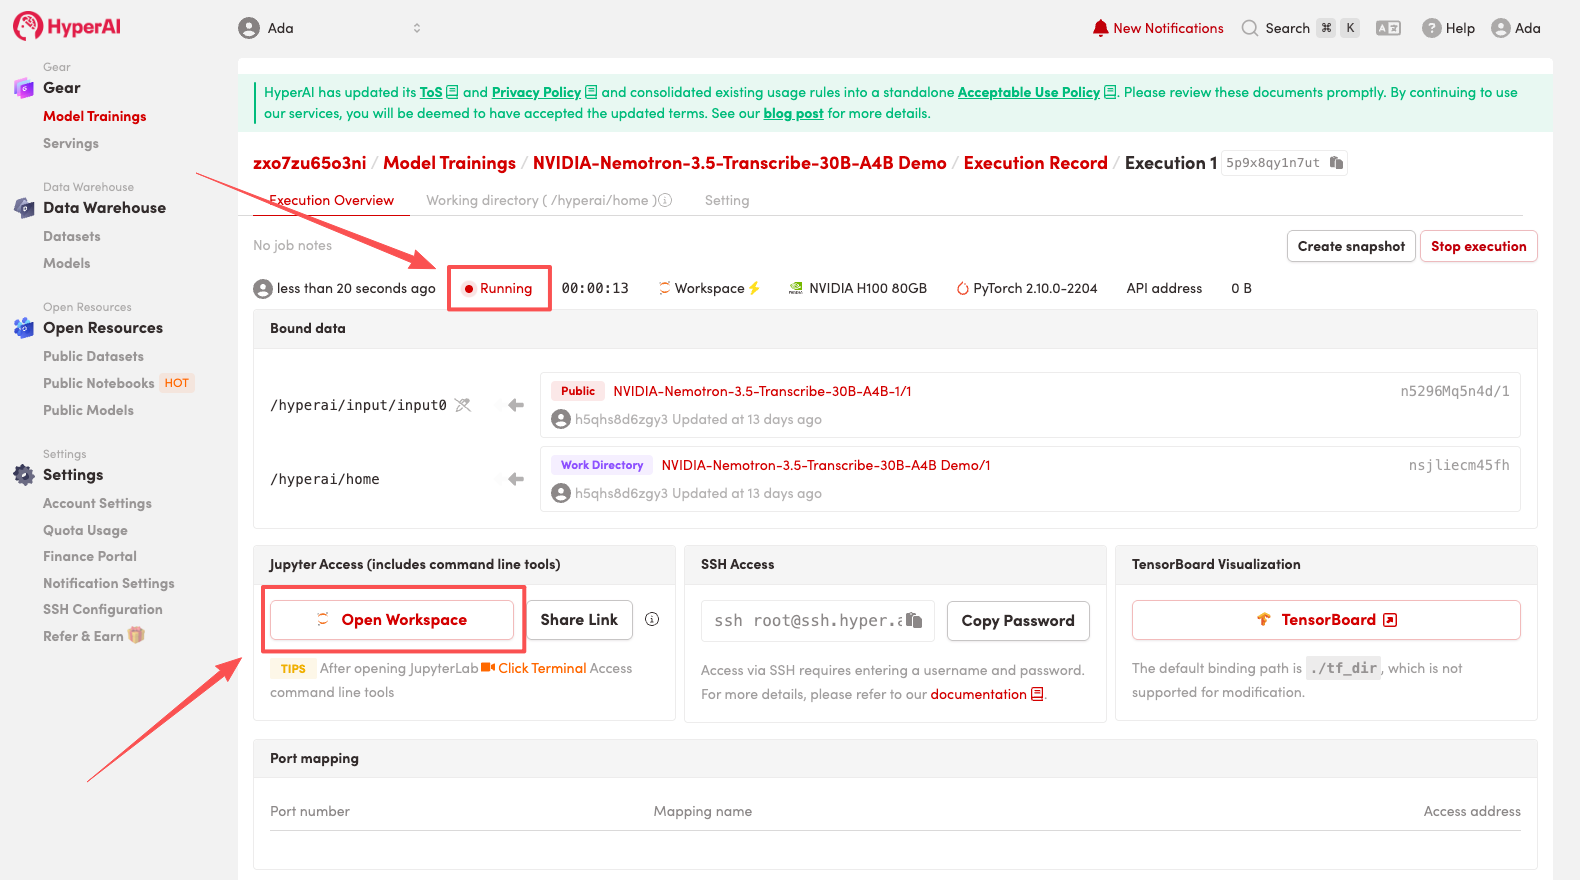
- Warten Sie auf die Zuteilung der Ressourcen. Sobald der Status auf „Running (In Ausführung)“ wechselt, klicken Sie auf „Open Workspace“, um den Jupyter-Workspace zu öffnen.
Ergebnisanzeige
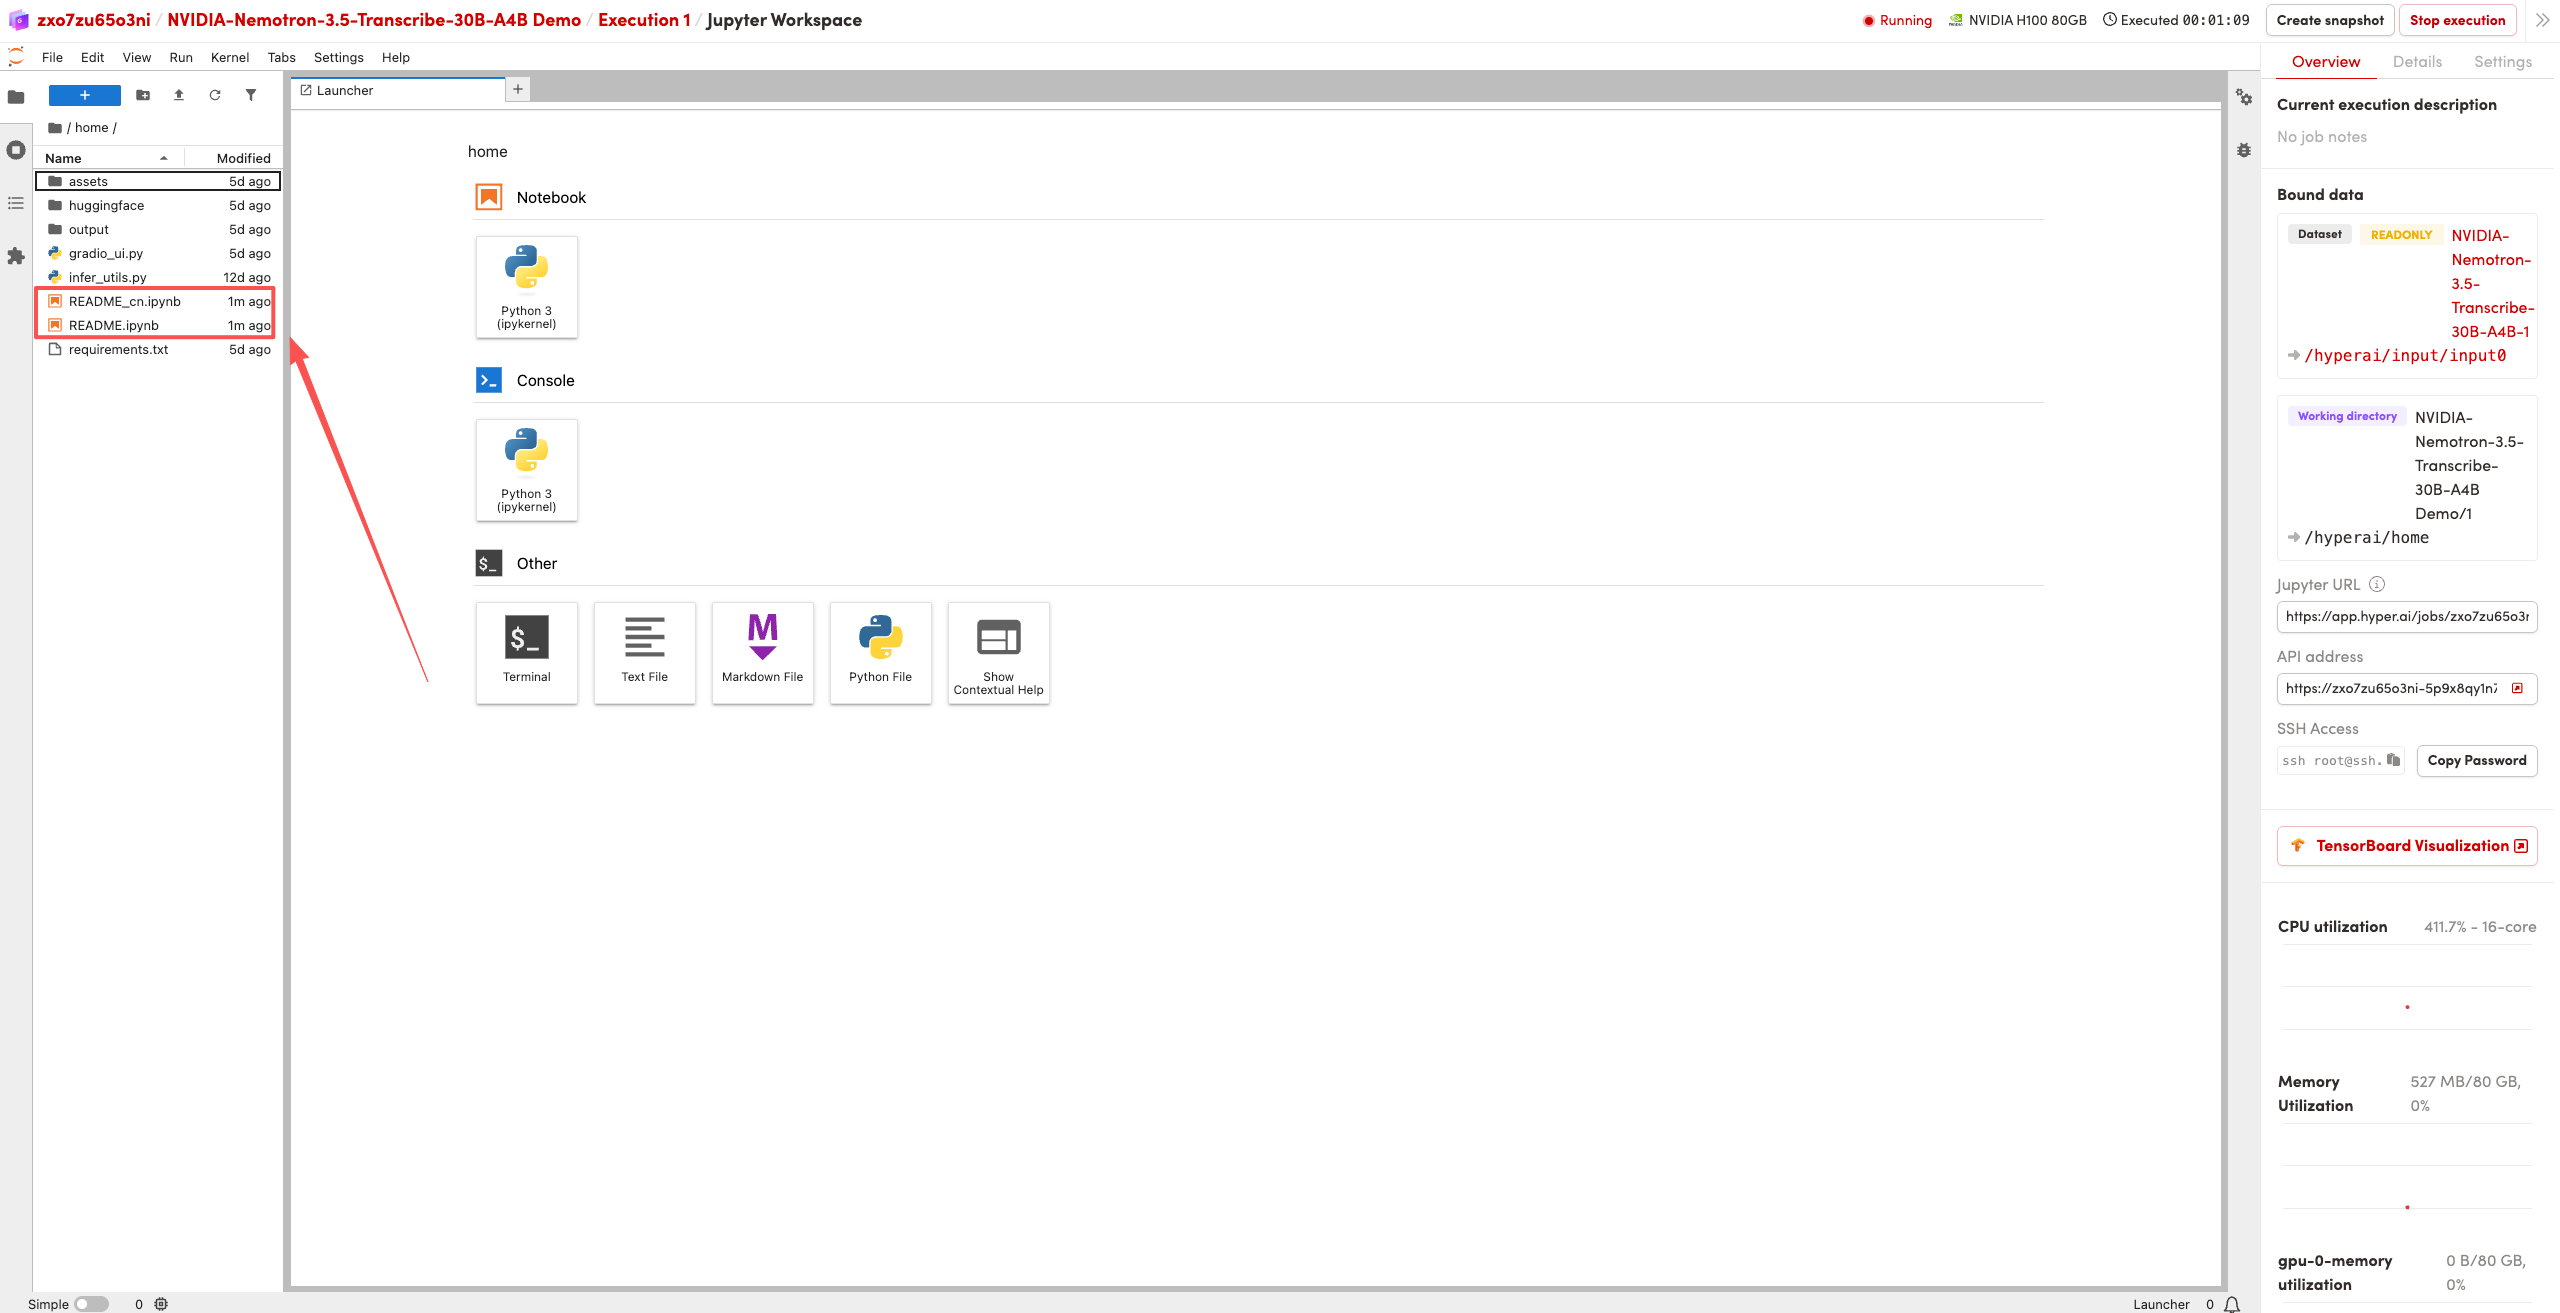
- Nach der Seitenweiterleitung klicken Sie links auf die README-Datei. Klicken Sie nach dem Öffnen oben auf „Run (Ausführen)“.
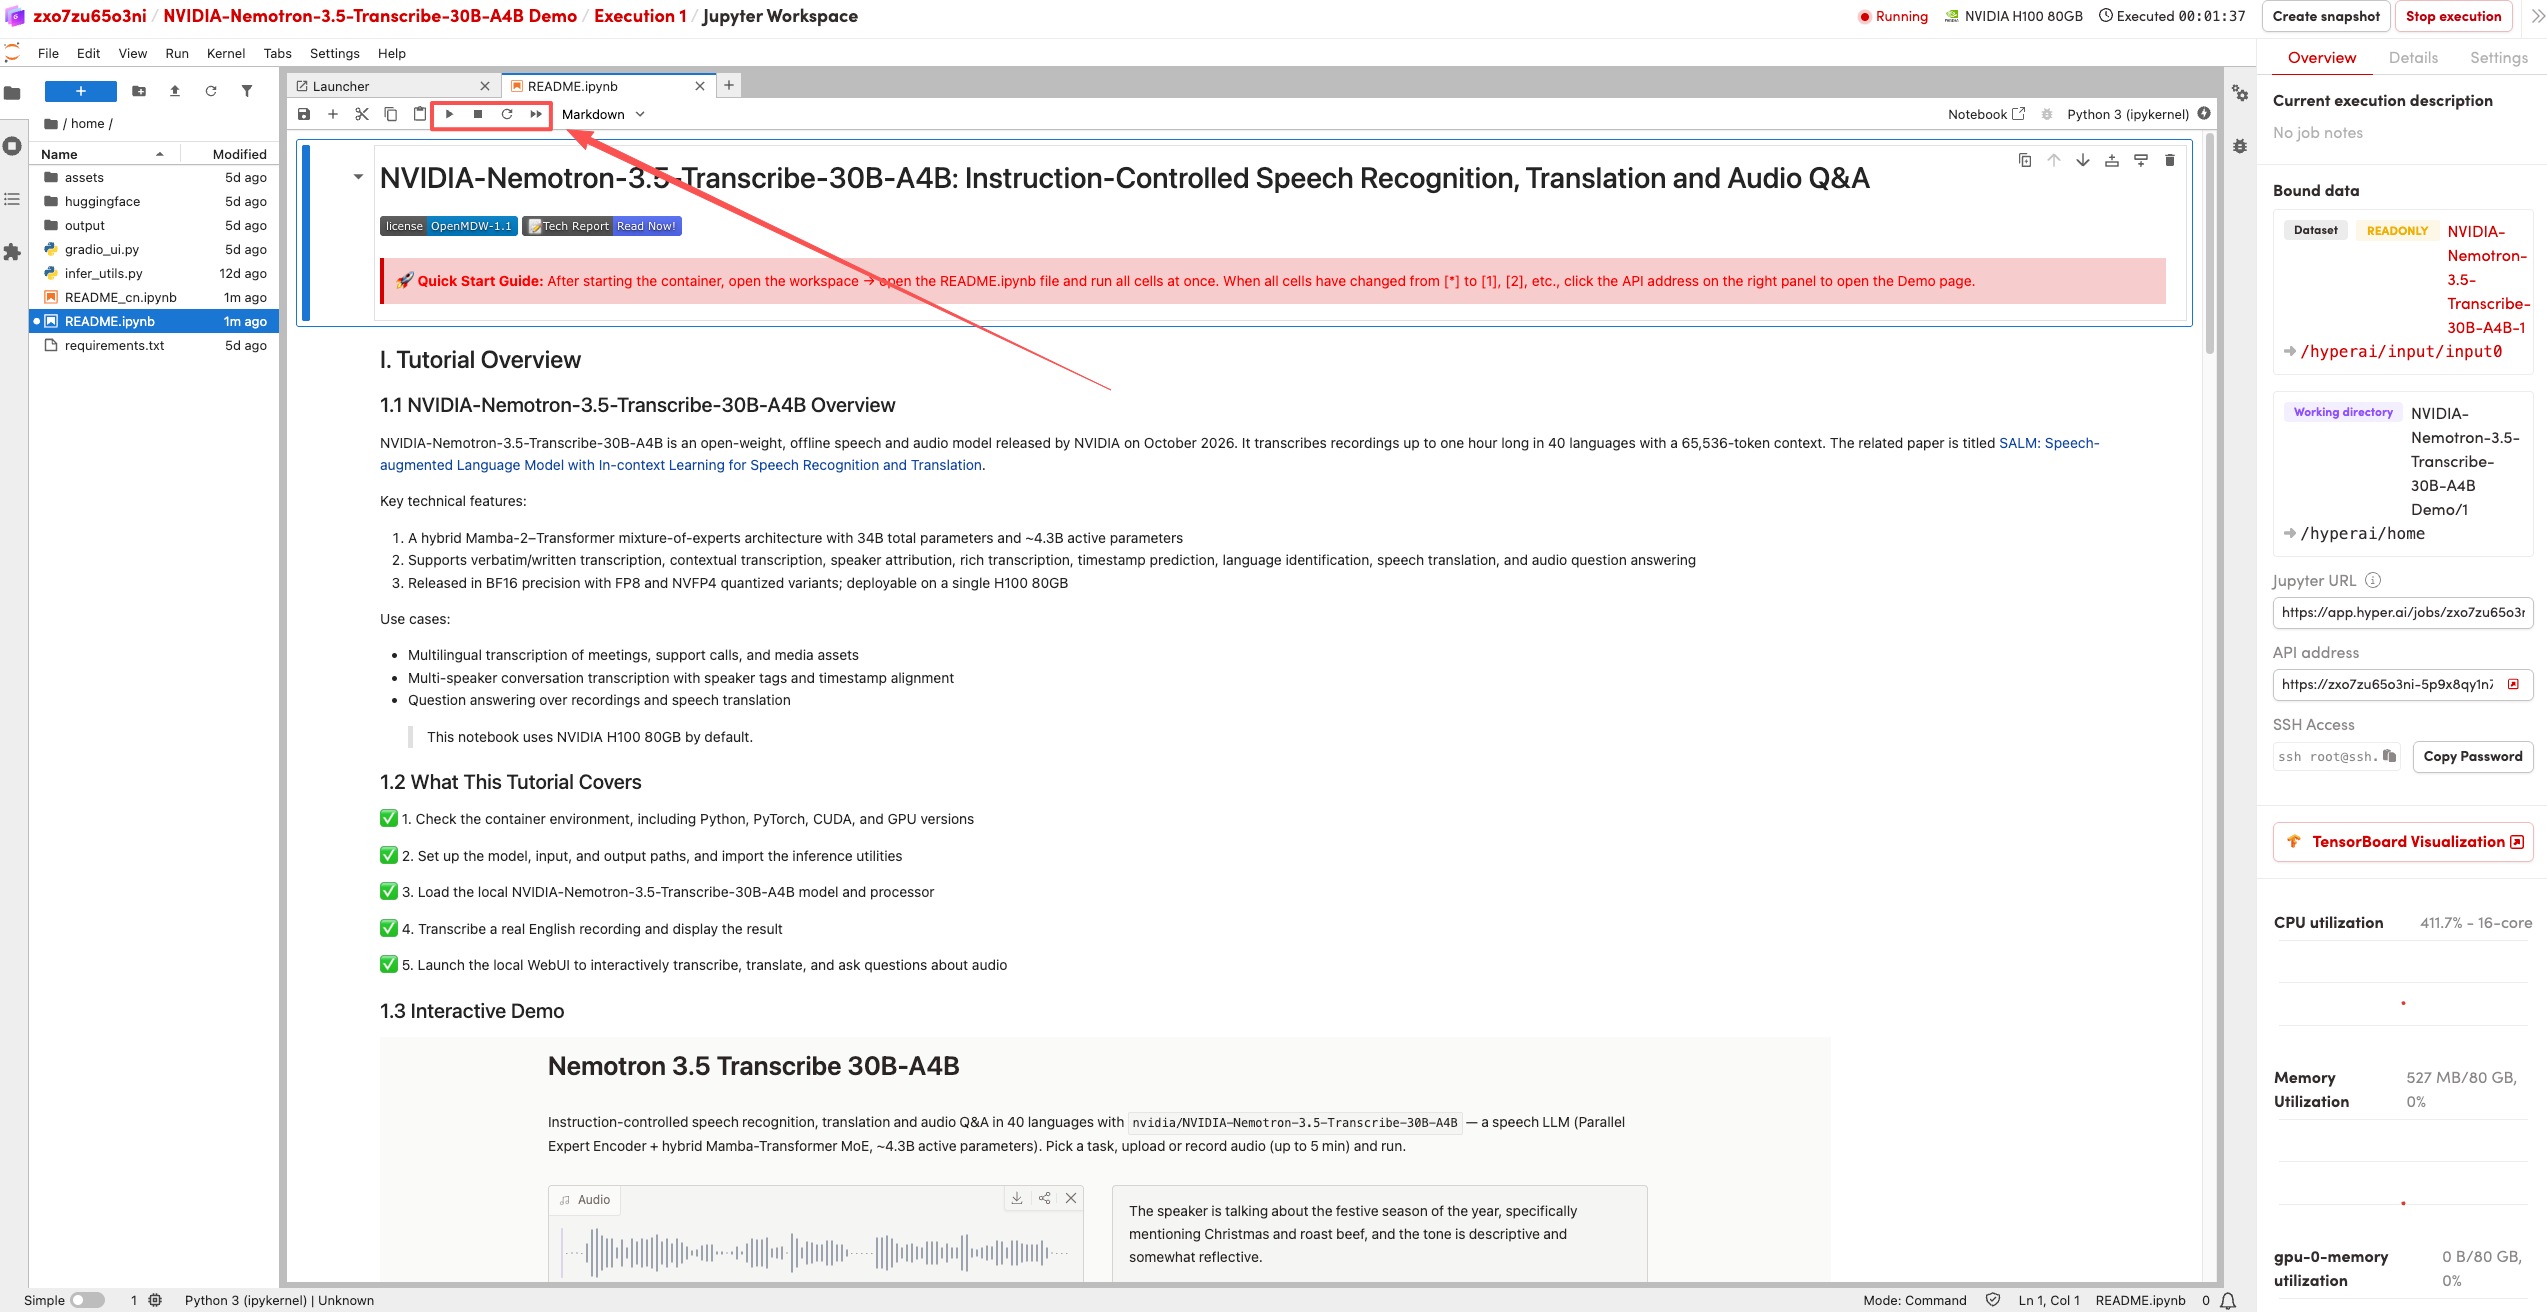
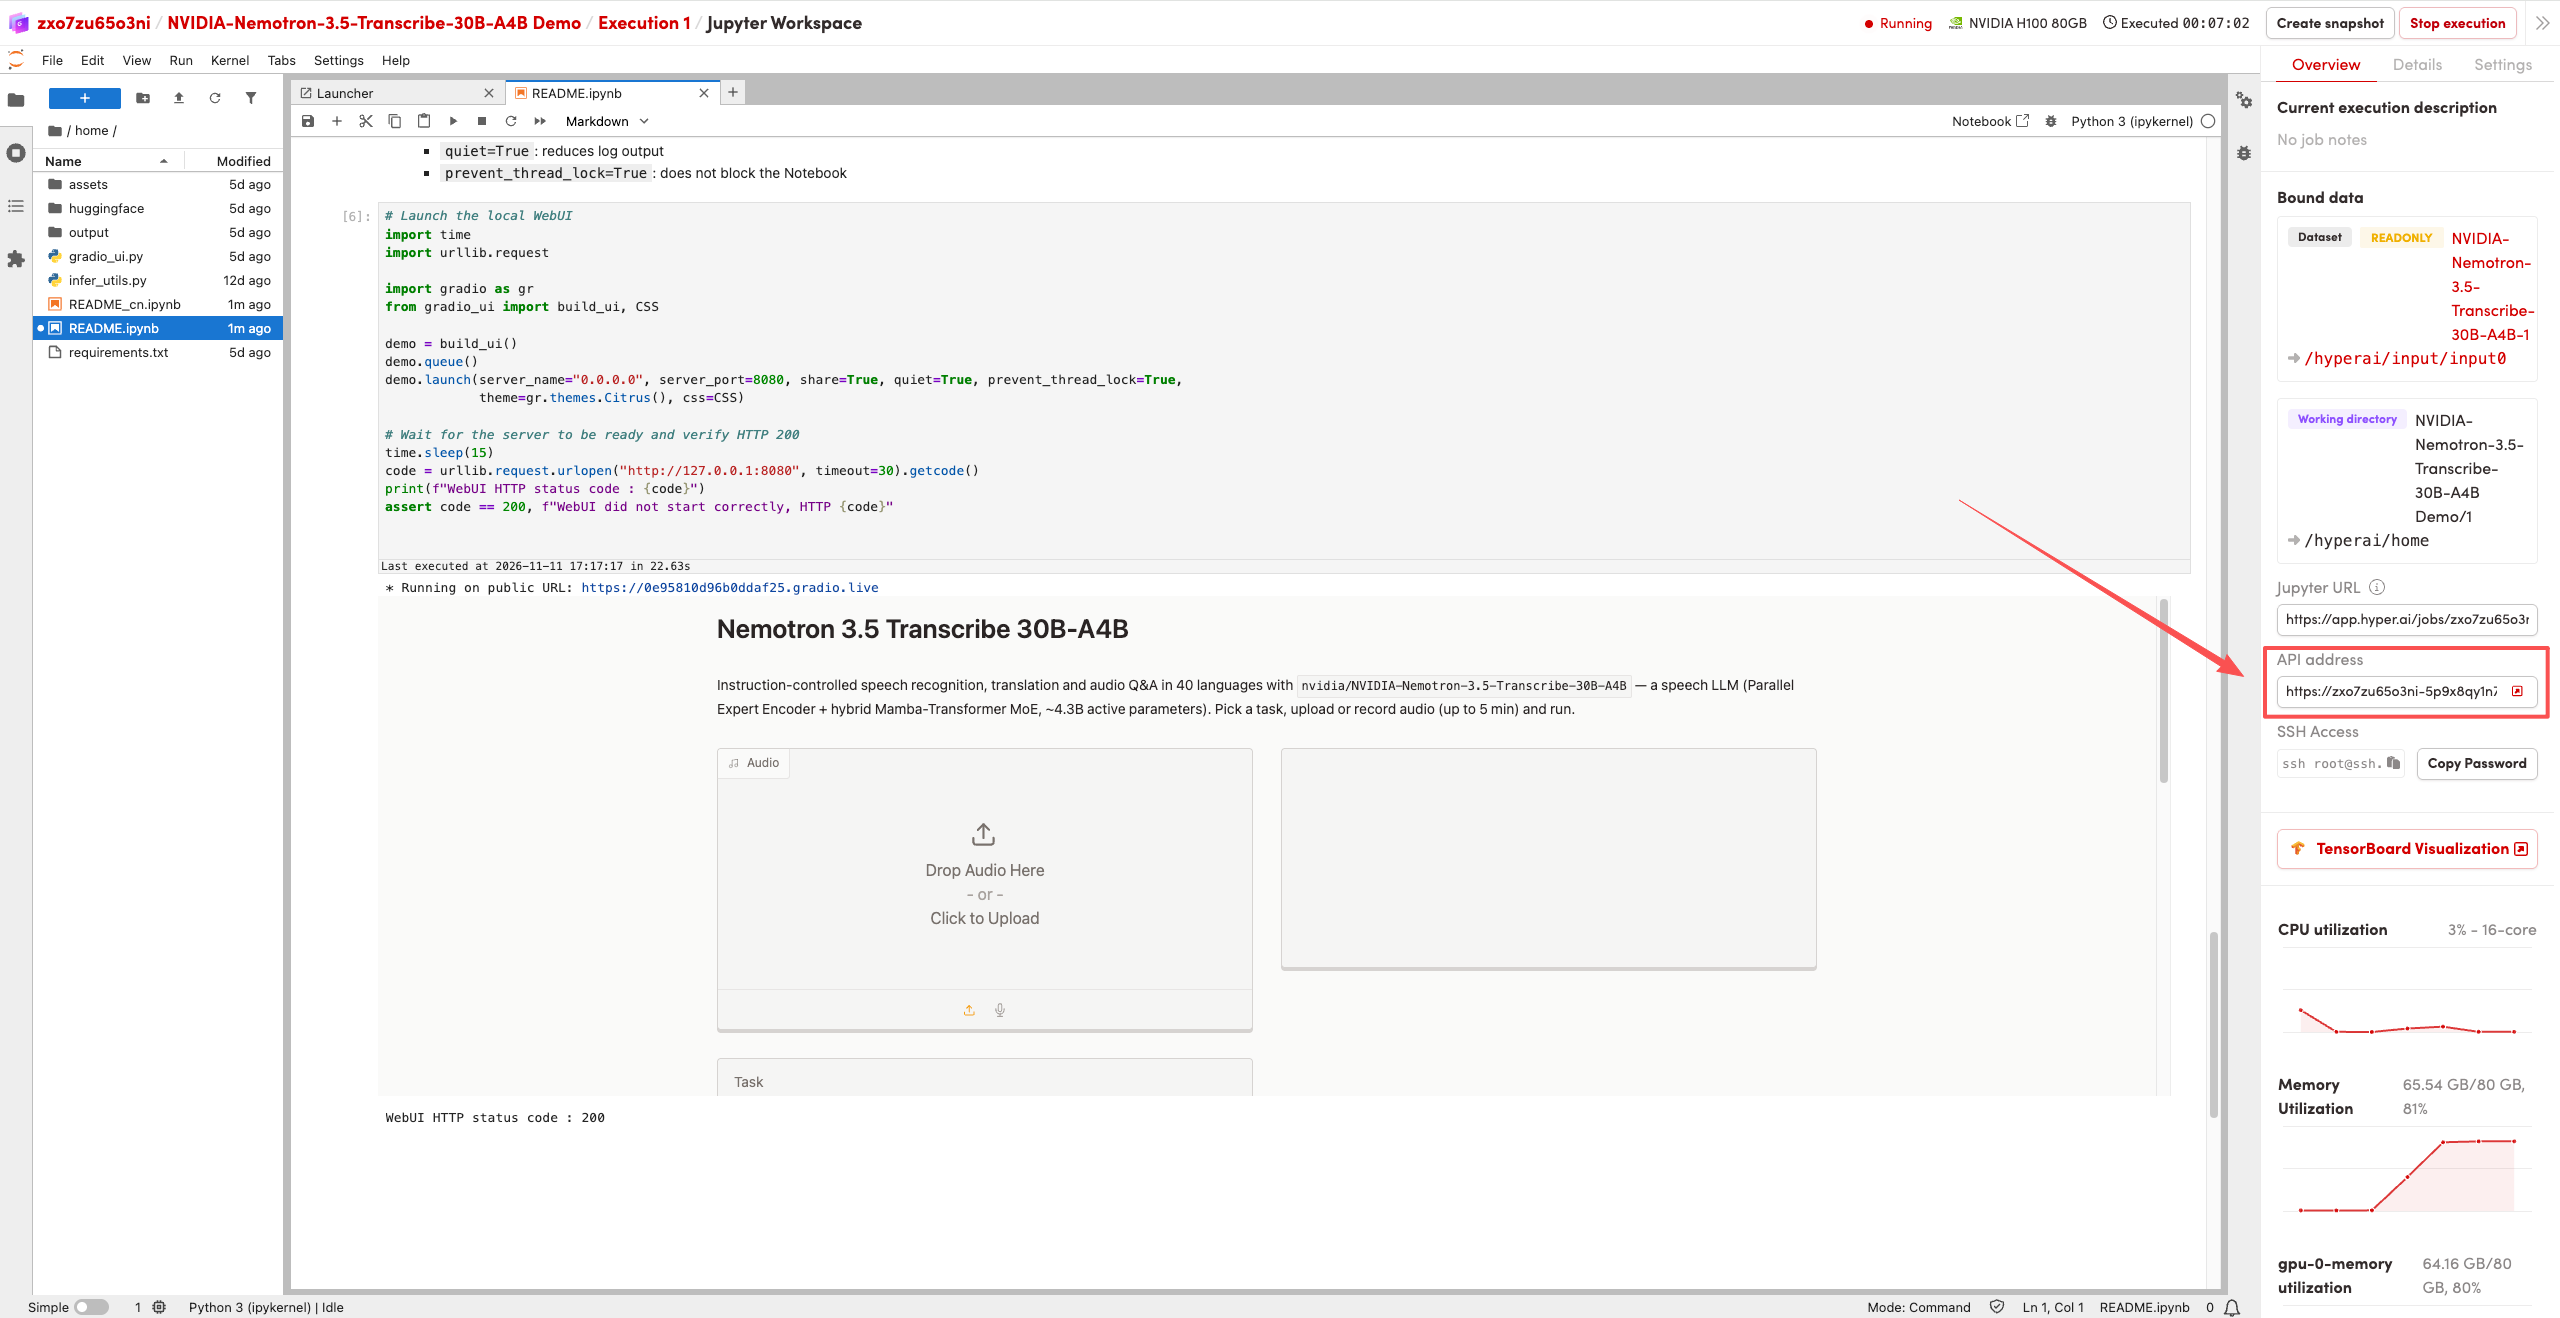
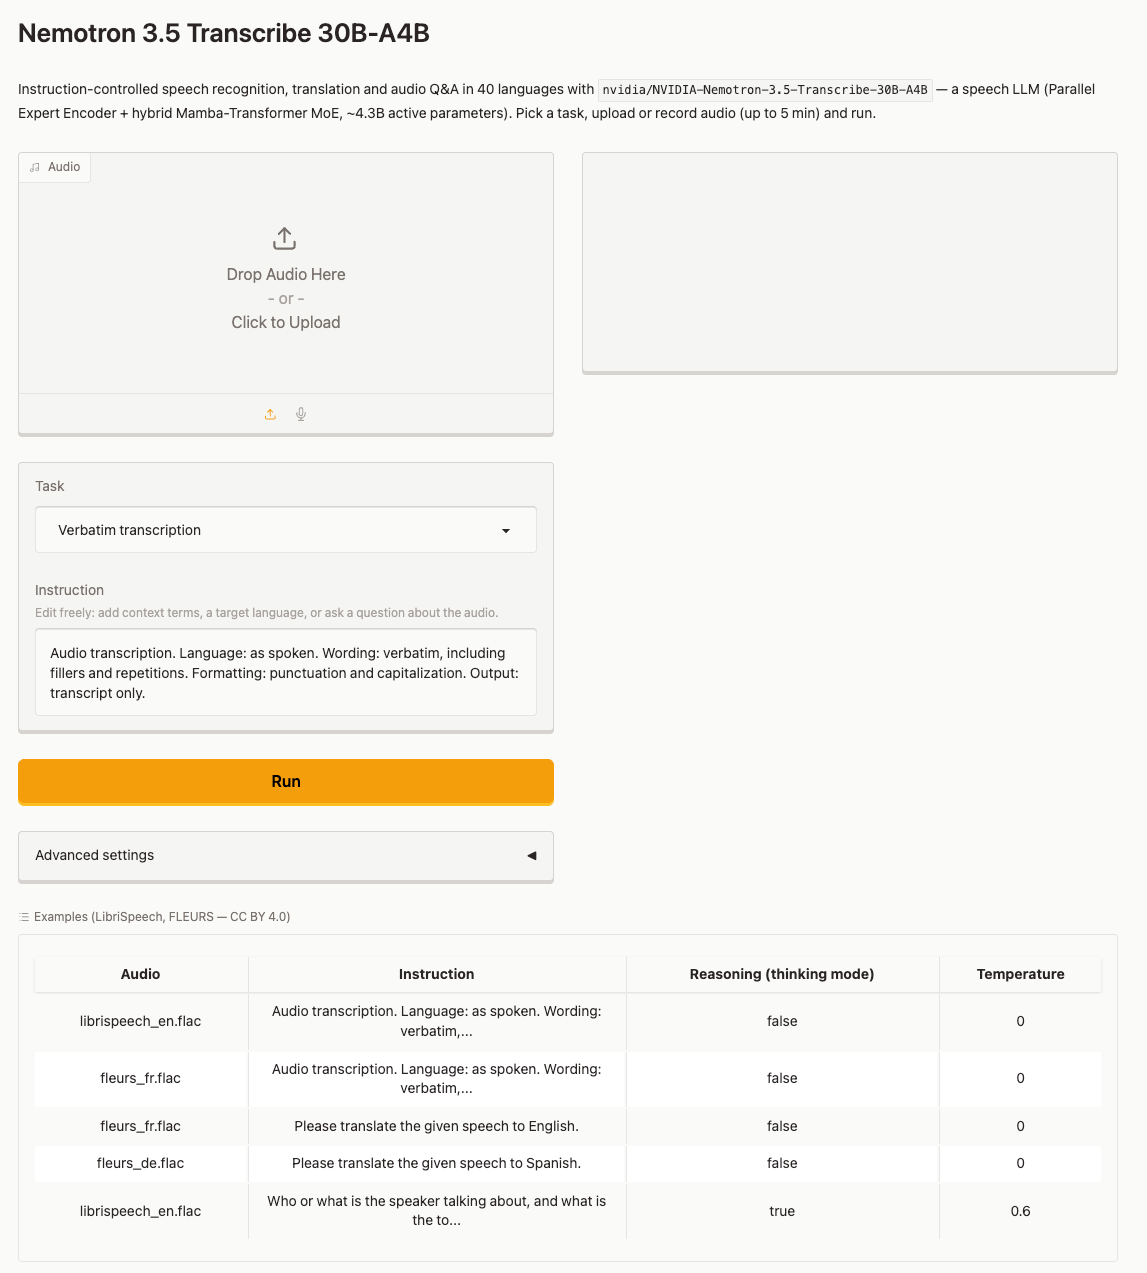
- Nach Abschluss des Laufs klicken Sie auf die rechts angezeigte API-Adresse, um die Demo-Seite aufzurufen.