HyperAI
Command Palette
Search for a command to run...
论文
每日更新的前沿人工智能研究论文,帮助您紧跟最新的人工智能趋势
篇论文
REWARDVERSE:面向视频奖励建模的评分准则引导策略优化
SPEAKERMEM-R1:面向多方对话的以说话人为中心的双轨记忆
过去框定未来:自回归视频生成中的记忆——综述
Spatial-Interactor:通过与可观测物理世界交互学习空间推理
HappyWorld-Bench
用于量子增强扩散语言模型的电路超网络
贝尔曼策略优化
基于文种感知混合专家的一体化多语言场景文本识别
GAE:学习面向 3D 一致世界生成的几何原生潜在空间
RULER:面向 SVG 生成的实例感知评分量规奖励
有品位的智能体:在长时程任务中度量与提升品味
OmniEdu:面向学习与教学的开放基础模型
文档检索感知分块(D-RAC):通过 PDF 归一化与多模态 Markdown 转换实现企业文档的通用检索感知摄取
GameHorizon Suite:游戏玩法中的多时间尺度数据与评估
将 VLM 的智能迁移到机器人控制
WorldCrafter:具有隐式 3D 感知记忆的一致性视频世界模型
RRSI:智能体框架的正则化递归自我改进
OmniVChat:面向原生音视频对话的合成、基准构建与训练
RECREATIONWORLD:面向混合计算机使用智能体的可扩展、可验证环境
EvoOntology:面向数据智能体的自进化本体层
CodeMidas:从代码本身扩展智能体编程强化学习环境
面向智能体智能的基于代码的大规模有依据技能合成
IntBMoE:将块级条件化融入专家组合以实现全参与混合专家模型
JEPA-Anything:学习跨越不同世界的预测模型
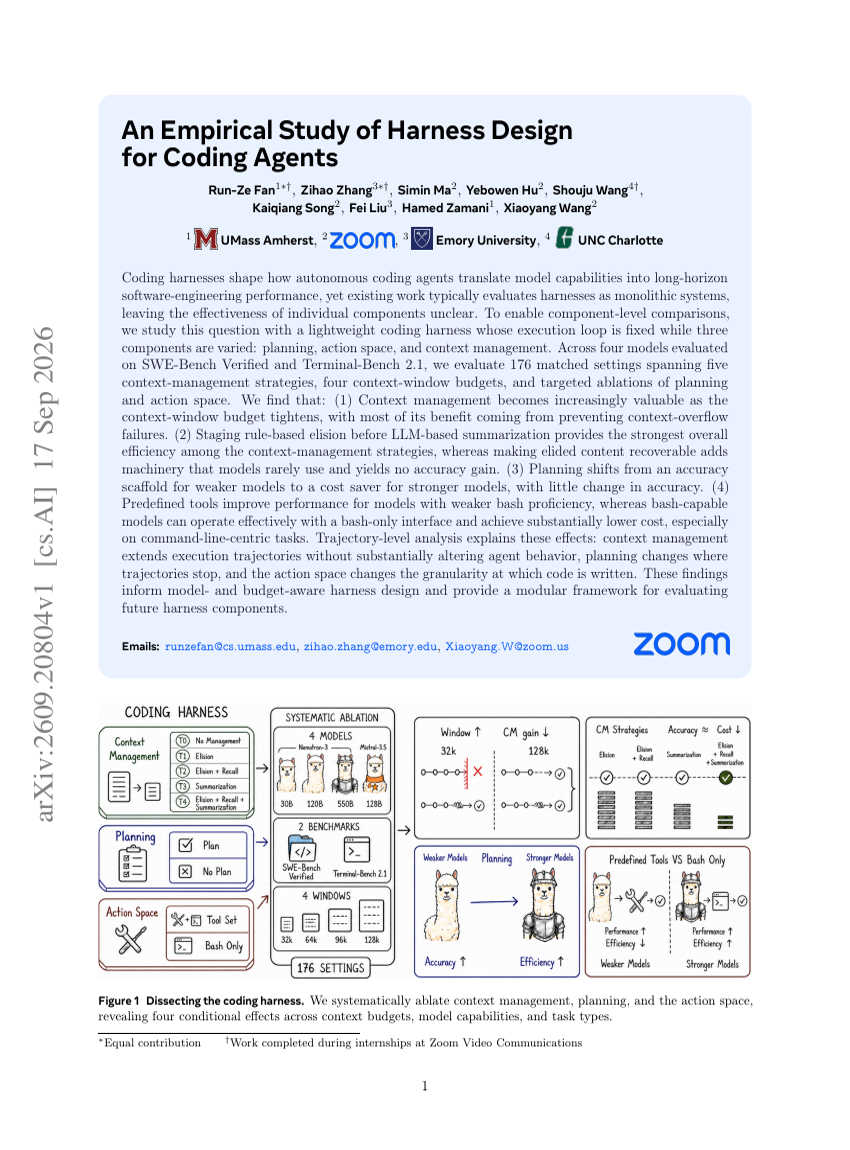
编码智能体 Harness 设计的实证研究
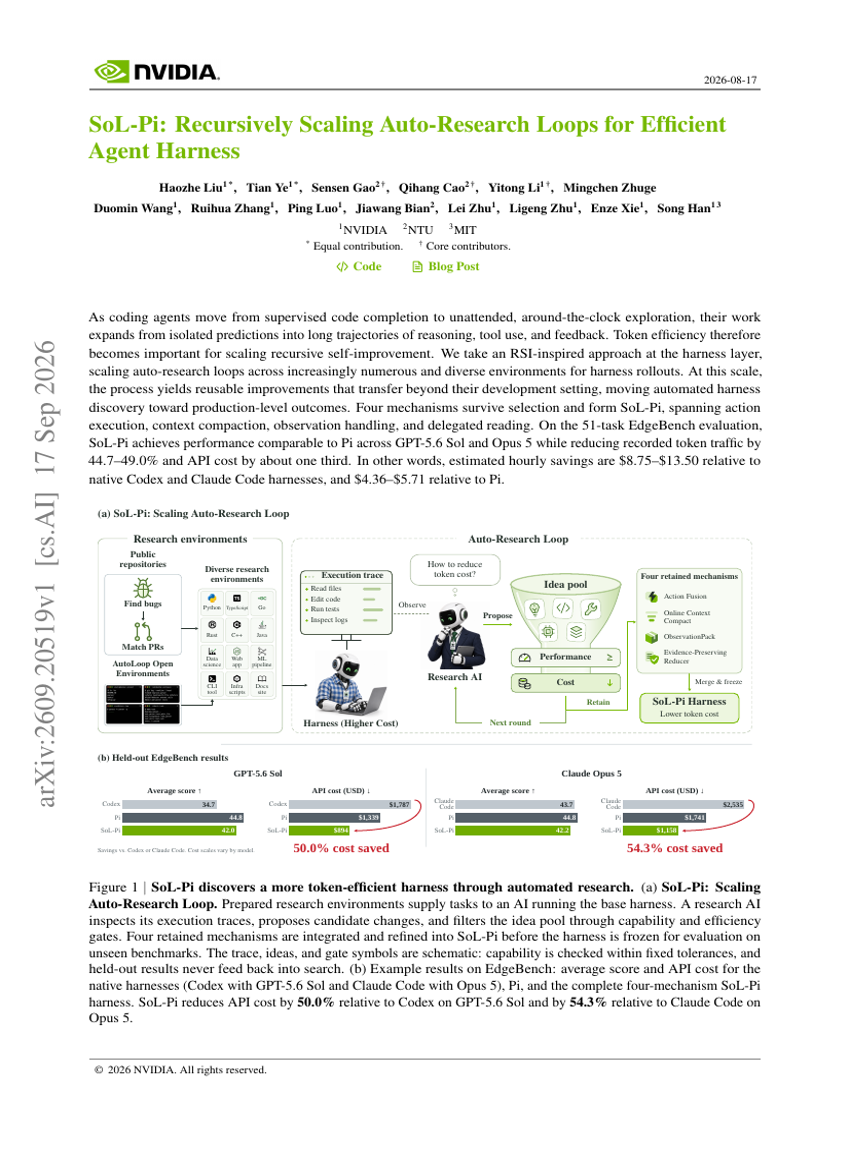
SoL-Pi:递归扩展自动研究循环以实现高效 Agent 执行框架
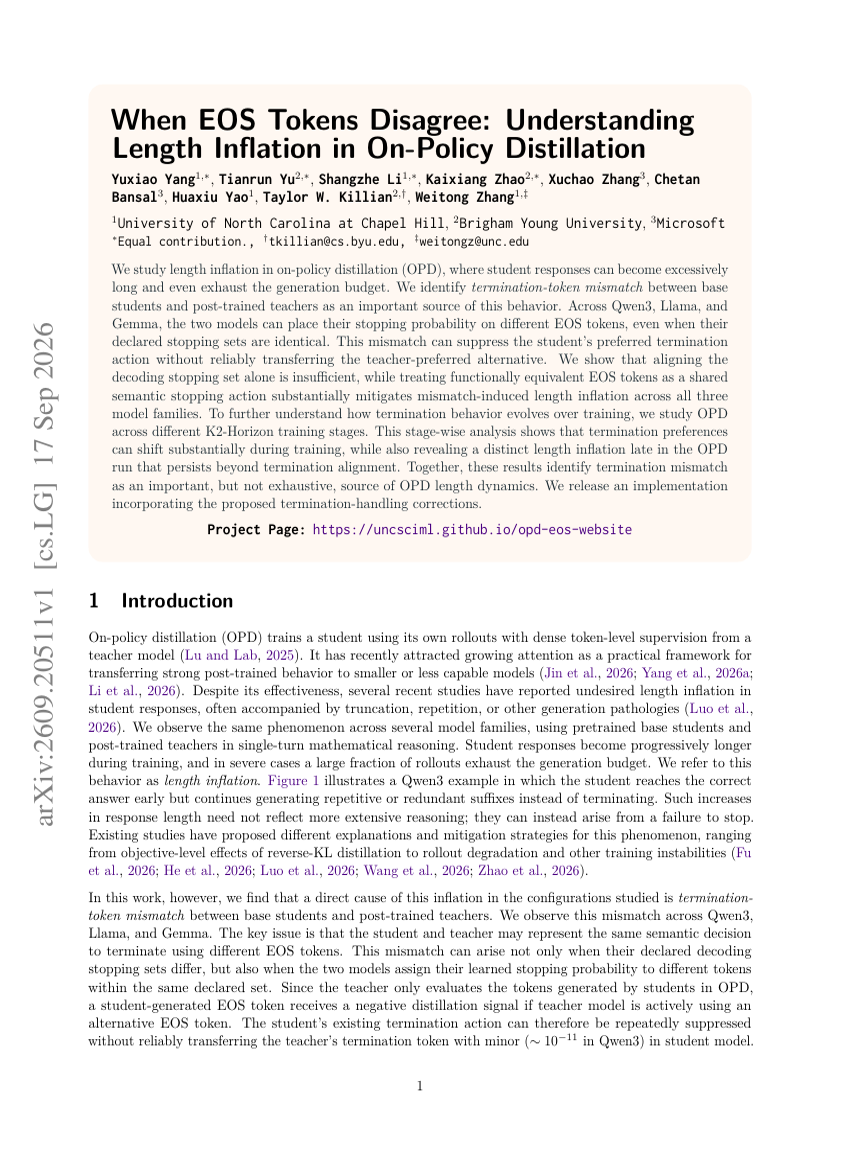
当 EOS token 不一致时:理解同策略蒸馏中的长度膨胀
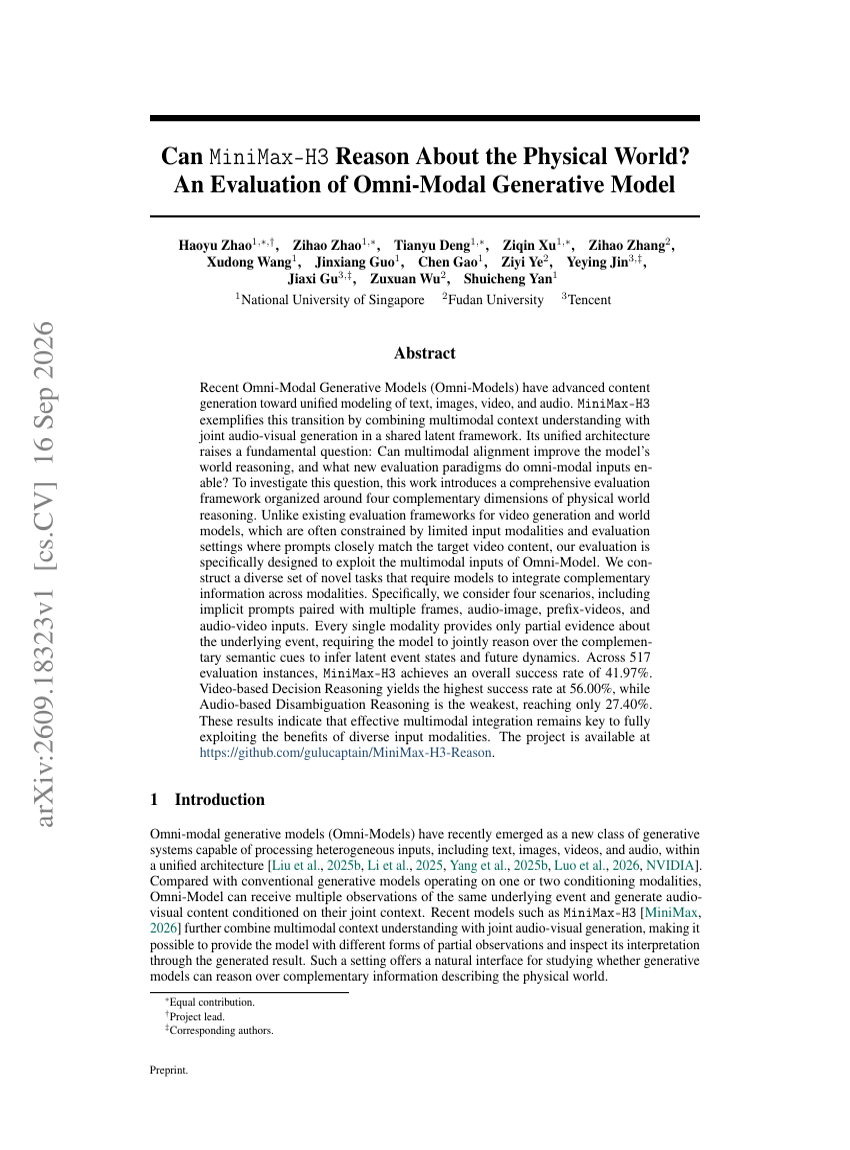
MiniMax-H3 能否对物理世界进行推理?一项全模态生成模型评估
ScienceIDE:将全球科学代码库转化为智能体可学习环境
ProgramDistill:从交互式 Web 应用到可验证的参考引导型软件工程任务
重新思考 PPO 中的评论家学习:理解并缓解价值扁平化
Agora:将 Git 作为集体自动研究的共享内存