Command Palette
Search for a command to run...
단 38.8밀리초! Clef-Flash, 토큰별 출력 없이 멀티모달 의사결정 완료; 백만급 컨텍스트, DABstep 벤치마크로 에이전트의 다단계 추론 능력 평가
에이전트 및 자동화 애플리케이션의 도입이 가속화되는 시점에서, 기업들은 이제 긴 텍스트처럼 재해석이 필요한 결과물이 아닌, 모델이 직접 실행 가능한 판단을 제시하기를 점점 더 강하게 요구하고 있습니다. 그러나 토큰 단위로 자유 생성하는 전통적인 대규모 언어 모델(LLM)의 패러다임은 구조화된 의사결정 시나리오에서 출력 형식의 불안정성, 복잡한 파싱, 높은 지연 시간이라는 고질적인 문제에 직면해 왔습니다.
이러한 한계를 극복하기 위해 Cloudflare는 2026년 10월, 9B 파라미터를 가진 멀티모달 의사결정 모델인 Clef-Flash를 오픈소스로 공개했습니다. Clef-Flash는 Qwen3.5-9B를 기반으로 후속 학습을 진행했으며, 의사결정 과정을 텍스트 생성에서 단일 순전파(forward pass)를 통한 확률 점수 매기기(probablistic scoring) 방식으로 재구성하여, LLM 시대의 구조화된 의사결정을 위한 보다 직접적인 기술적 경로를 제시합니다.
전통적인 생성형 경로는 출력 토큰을 단계별로 디코딩해야 하며, 생성 길이가 길어질수록 대기 시간도 길어집니다. 반면 의사결정 작업에는 단순히 하나의 선택지와 그 확률만 필요합니다. Clef-Flash은 전체 자기회귀(autoregressive) 생성 체인을 생략하며, 공식 보고된 중위 의사결정 지연 시간은 38.8밀리초로, 눈 깜짝할 속도보다 빠릅니다. 동시에 9B 파라미터의 이해 능력은 완전히 보존하되, 연산을 '답변 작성'에서 '판단 수행'으로 재배치했습니다. 또한 Jev System One API와 네이티브 호환되므로, 해당 인터페이스를 사용 중인 비즈니스는 거의 원활하게 통합할 수 있습니다. 고객 서비스 티켓 및 지원 메시지의 자동 분류 및 라우팅, 이미지 및 콘텐츠 심사, 인보이스 상태, 긴급도, 감정 경향의 구조적 추출 등 기업 워크플로우에서 가장 흔한 요구 사항인 '빠르고, 안정적이며, 정량화된 의사결정'에 대해 Clef-Flash은 즉시 활용 가능한 해결책을 제공합니다.
현재 HyperAI 공식 웹사이트에는 'Clef-Flash: 타입화 확률 의사결정 모델'이 오픈되었습니다. 직접 체험해 보세요~
온라인 사용:
10월 19일 - 10월 23일, hyper.ai 공식 웹사이트 업데이트 속보:
- 양질의 공개 데이터셋: 6개
- 양질의 튜토리얼 추천: 4개
- 인기 백과사전 항목: 5개
- 11월 마감 주요 컨퍼런스: 6개
공식 웹사이트 방문: hyper.ai
공개 데이터셋 추천
1. DABstep 다단계 추론 에이전트 벤치마크 데이터셋
DABstep(Data Agent Benchmark for Multi-step Reasoning)은 Adyen이 2025년 공개한 데이터 에이전트 다단계 추론 벤치마크 데이터셋으로, AI 에이전트가 복잡한 데이터 질문 응답 및 다단계 논리 추론을 수행하는 능력을 평가하기 위해 설계되었습니다. 데이터셋은 세 가지 하위 세트로 구성되며, tasks 하위 세트는 460개의 실제 비즈니스 작업을 포함하고, 전체적으로 100만 개 이상의 컨텍스트 샘플을 포함하며 JSON 형식을 채택했습니다.
온라인 실행: https://go.hyper.ai/E4hf8
2. Last Translation Benchmark 극한 번역 벤치마크 데이터셋
Last Translation Benchmark는 Vilém Zouhar 등의 연구자가 2026년 공개한 기계 번역 모델 평가를 위한 벤치마크 데이터셋으로, 관련 논문은 'Last Translation Benchmark'입니다. 이 데이터셋은 현재 기계 번역 모델이 복잡한 번역 작업에서 수행하는 능력을 테스트하고, 실제 시나리오에서 모델의 구체적인 실패 사례를 발견하기 위해 설계되었습니다. 데이터셋은 3,456개의 고난도 번역 샘플을 포함하며, 다양한 언어 및 언어 조합을 커버하고, 수작업 작성 및 동료 심사를 거친 번역 예시를 데이터 소스로 사용합니다. 샘플에는 텍스트, 이미지, 오디오, 비디오 등 멀티모달 입력이 포함되며, 각 샘플마다 수작업으로 제정된 검증 규칙이 제공됩니다.
온라인 실행: https://go.hyper.ai/yxBAk
3. Knee-Raptor-Corpus 무릎 MRI 전처리 스택 데이터셋
Knee-Raptor-Corpus는 fastMRI 원본 무릎 핵자기 공명(MRI) 데이터를 전처리하여 파생된 전처리 데이터셋으로, 무릎 MRI 영상 딥러닝 작업을 위한 표준화된 전처리 샘플을 제공하기 위해 설계되었습니다. 전체 데이터셋은 Part 1과 Part 2 두 부분으로 나뉘며, 총 4,407개의 무릎 MRI 연구를 포함합니다. 본 데이터셋은 Part 1으로, 첫 3,200개 연구를 포함하며, 각 연구는 44장의 336 × 336 uint8 이미지 스택으로 처리되고, 고정된 순서대로 시상면, 관상면, 축면 시퀀스 슬라이스를 채워 넣습니다.
온라인 실행: https://go.hyper.ai/roWu1
4. Knee-Raptor-Corpus-Ext 무릎 MRI 슬라이스 데이터셋
본 데이터셋은 Knee-Raptor-Corpus의 Part 2로, 나머지 1,207개 연구 샘플을 포함합니다. 데이터는 원본 DICOM 의료 영상을 고정 크기의 축면 슬라이스 스택으로 재샘플링하며, 각 샘플은 44장의 336 × 336 uint8 이미지로 통일되어 의료 영상 모델 학습에 직접 사용할 수 있습니다.
온라인 실행: https://go.hyper.ai/rlTgA
5. MOF Property Diversity 금속 유기 골격체 속성 데이터셋
MOF Property Diversity는 2026년 공개된 금속 유기 골격체(Metal-Organic Frameworks, MOF) 속성 데이터셋으로, 재료 정보학 연구에 대표적인 MOF 데이터를 제공하고 재료 속성 분석, 클러스터링 및 기계 학습 등의 작업을 지원하기 위해 설계되었습니다.
온라인 실행: https://go.hyper.ai/BIMLz
6. prompts.chat AI 프롬프트 데이터셋
prompts.chat은 오픈소스 프롬프트 공유 커뮤니티로, 본 데이터셋은 해당 플랫폼의 프롬프트 라이브러리 내보내기 스냅샷이며, 원본 자료는 오픈소스 프로젝트인 Awesome‑ChatGPT‑Prompts에서 가져왔습니다. 데이터셋은 ChatGPT, Claude, Gemini, Llama, Mistral 등 주요 대규모 모델에 적합한 프롬프트 예제를 수집하여 프롬프트 엔지니어링 연구 및 대규모 모델 대화 효과 테스트에 사용할 수 있습니다.
온라인 사용: https://go.hyper.ai/iDmot
공개 튜토리얼 추천
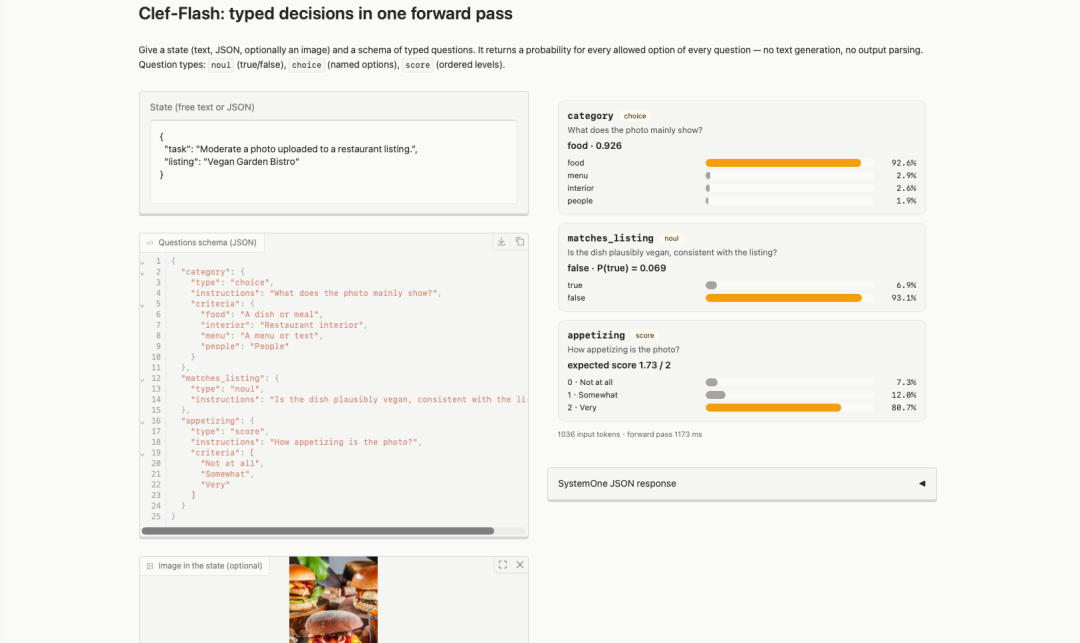
1. Clef-Flash: 타입화 확률 의사결정 모델
Clef-Flash는 Cloudflare가 2026년 10월 공개한 9B 멀티모달 의사결정 모델로, 공식 보고된 중위 의사결정 지연 시간은 38.8밀리초에 불과하며, Jev System One API와 호환됩니다. 고객 서비스 티켓 자동 분류 및 라우팅, 이미지 및 콘텐츠 심사, 인보이스 상태 및 긴급도 판단 등 구조화된 의사결정 시나리오에 적합합니다.
온라인 실행: https://go.hyper.ai/U6YW0
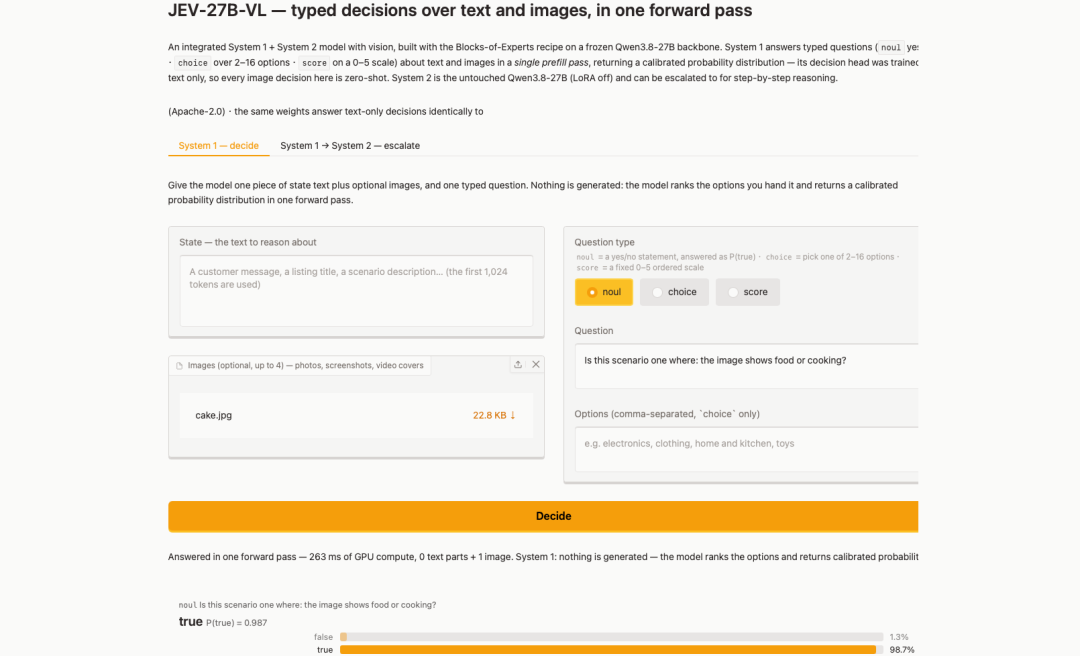
2. JEV-27B-VL: 텍스트 및 이미지를 위한 구조화 의사결정 모델
JEV-27B-VL은 AutoTrust AI가 2026년 10월 공개한 비전 의사결정 모델로, 동결된 Qwen3.8-27B 백본(Backbone) 위에 Blocks-of-Experts 방식을 통해 이중 채널 기능을 통합했습니다. 공개 측 기준, 해당 모델은 Jev Decision Index 0.3 비전 랭킹의 20개 비전 의사결정 모델 중 1위를 차지했습니다.
온라인 실행: https://go.hyper.ai/3wow2
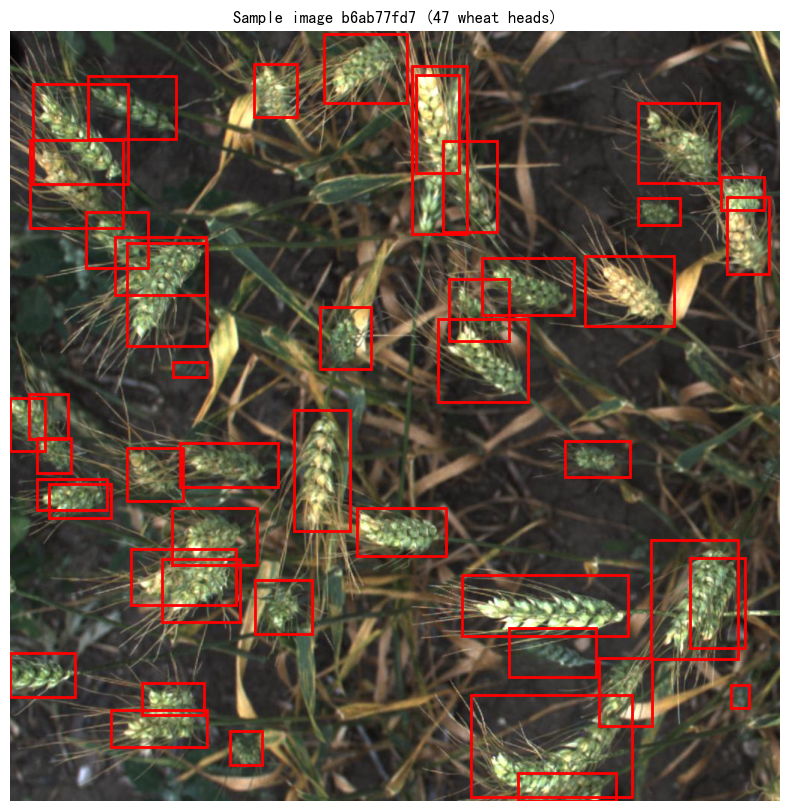
3. Pytorch 입문 튜토리얼 - FasterRCNN 모델 학습
본 튜토리얼은 Kaggle 사용자 pestipeti의 공개 Notebook을 기반으로, PyTorch와 torchvision을 사용하여 Faster R-CNN 객체 탐지 모델을 학습하고 밭 이미지에서 밀 이삭을 탐지하는 방법을 시연합니다. 튜토리얼은 데이터 로딩, 데이터 탐색, 모델 구축, 단일 에폭 학습 및 테스트 이미지 추론의 전체 프로세스를 순서대로 다루며, 객체 탐지 및 전이 학습 입문자에게 적합하고 밀 이삭 카운팅, 농업 원격 감지 및 식물 표현형 분석 등의 시나리오에도 사용할 수 있습니다.
온라인 실행: https://go.hyper.ai/Ozwaq
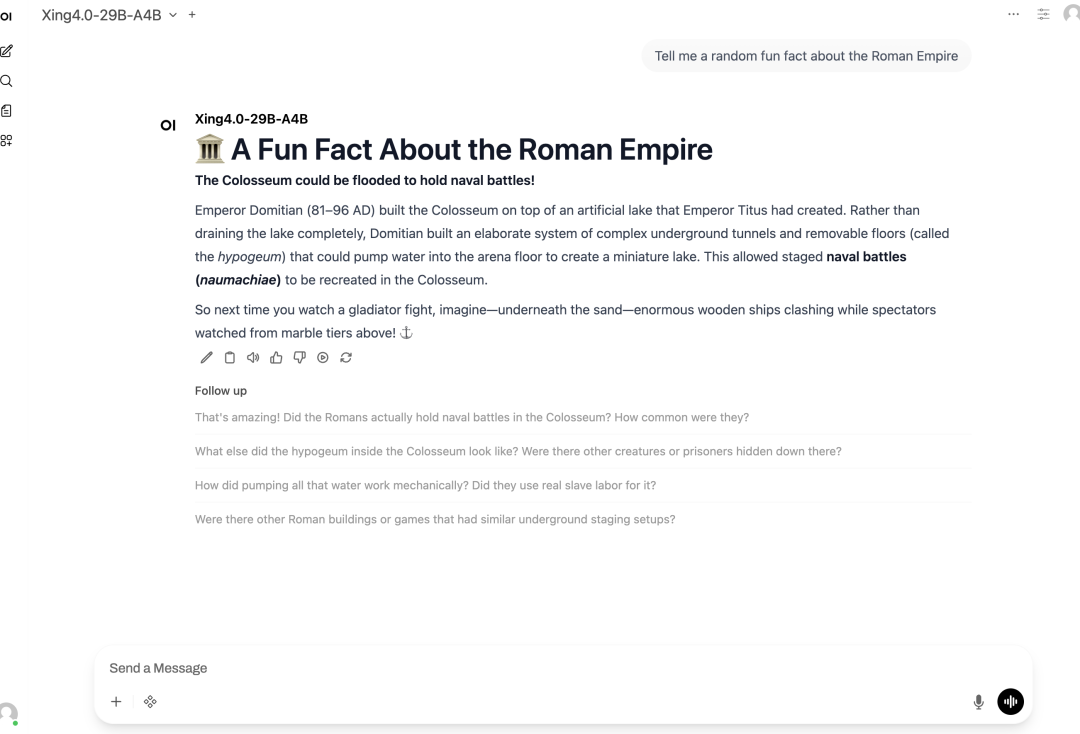
4. Xing4.0-29B-A4B 로컬 추론 및 Open WebUI 배포
본 튜토리얼은 Xing4.0-29B-A4B 대규모 모델의 로컬 추론 및 Open WebUI 배포를 시연합니다. Xing4.0-29B-A4B는 China Telecom 인공지능 과학기술 유한회사가 2026년 9월 공개한 Xing 시리즈(전신은 TeleChat)의 최신 대규모 언어 모델로, 복잡한 추론, 코드 생성, 도구 호출 및 긴 컨텍스트 질문 응답 등의 시나리오에 적합합니다.
온라인 실행: https://go.hyper.ai/PDmlT
인기 백과사전 항목 추천
1. 세계 동작 모델 WAM
2. 강건성/견고성 Robustness
3. 생성적 사전 학습 트랜스포머 GPT
4. 비디오 생성 Video Generation
5. 임베딩 모델 Embedding Models
여기에는 수백 개의 AI 관련 항목이 편집되어 있어, 이곳에서 '인공지능'을 이해할 수 있습니다: https://go.hyper.ai/wiki
11월 마감 주요 컨퍼런스
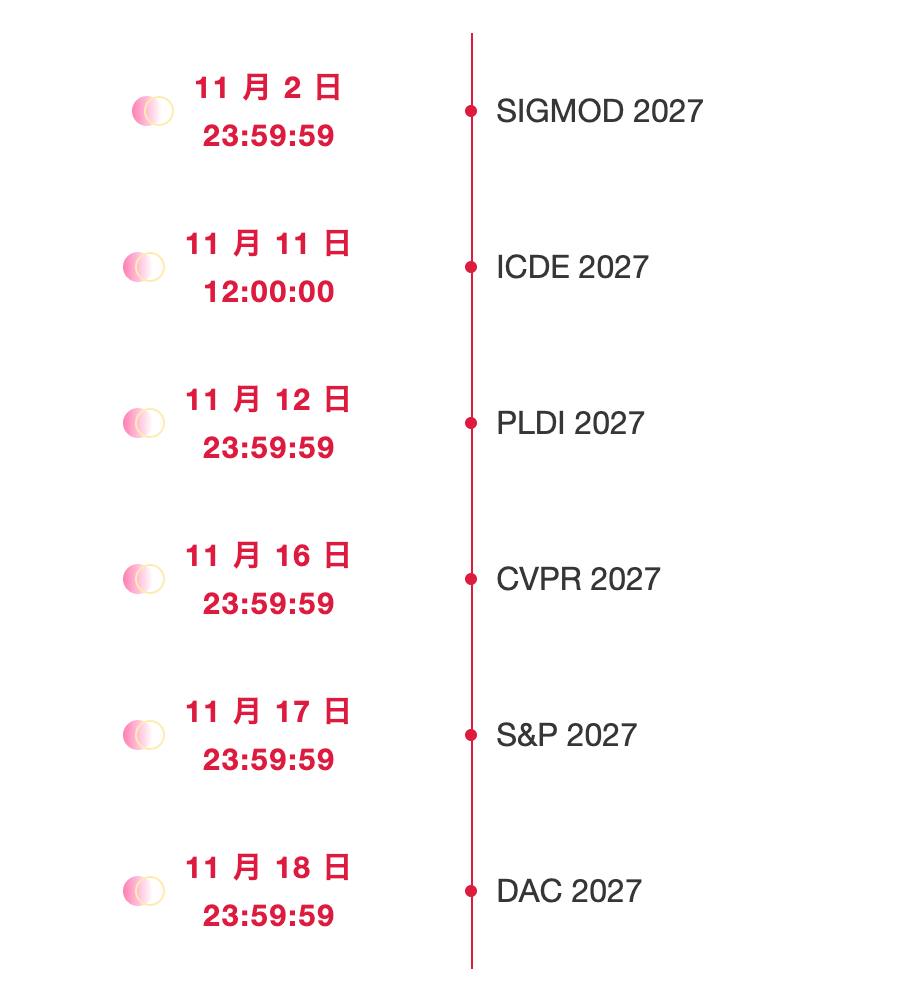
- 마감 시간은 AoE 시간 기준
인공지능 학술 주요 컨퍼런스 원스톱 추적: https://go.hyper.ai/event
이상이 이번 주 편집부 추천의 전체 내용입니다. hyper.ai 공식 웹사이트에 수록하고 싶은 자원이 있다면, 댓글이나 기고를 통해 알려주세요!
다음 주에 또 만나요!