Command Palette
Search for a command to run...
단 25%의 샘플링으로 최대 4배까지 프레임 속도를 향상시키는, 딥러닝 기반의 혁신적인 살아있는 세포 나노 형광 이미징
주지하다시피, 세포는 생명체의 구조와 기능의 기본 단위이며, 다양한 정교한 세포 소기관, 세포골격, 단백질 복합체 등의 나노미터 크기의 구조가 그 안에서 각자의 역할을 수행하여 복잡하고 다채로운 생명 활동을 구동한다. 그러나 오늘날까지 과학계는 이러한 정교한 나노 스케일 구조들이 어떻게 역동적으로 상호작용하는지에 대해 여전히 아는 바가 적다. 그 주된 이유는 전통적인 광학 현미경이 아베 회절 한계의 제약으로 인해, 세포 내부의 수많은 나노미터 크기의 미세 구조와 그 동적 변화가 마치 '선명하게 볼 수 없는' 안개 속에 갇혀 있는 것처럼 보이며, 이는 세포 아미세 구조 연구의 진전을 크게 방해해 왔기 때문이다.
형광 나노현미경(Fluorescence nanoscopy) 기술의 등장은 이 장벽을 허물었다. 광학 회절 한계를 돌파하는 원거리(field) 형광 현미경 기술의 일종으로서, 이 기술은 물리적 수단을 통해 형광 분자의 발광 상태를 제어하여 관측 해상도를 효과적으로 나노 스케일 수준으로 향상시킴으로써, 연구자들이 세포 내부 미세 구조의 정교한 형태와 동적 변화를 직접 관찰할 수 있게 되었으며, 이는 세포 생리 법칙 탐구, 질병 병리 기전 규명, 생명 활동의 신비 해독을 위한 중요한 도구가 되었다.
수많은 형광 나노현미경 기술 경로 중, 가역적 포화 광학 형광 전환(RESOLFT) 나노현미경은 매우 대표적인 방안이다. 이 기술은 가역적 광 스위치 형광 단백질(rsFPs)을 활용하여, 공간적으로 구조화된 광장을 통해 형광 단백질이 켜진 상태(ON)와 꺼진 상태 간에 가역적으로 전환되도록 제어함으로써 분자 발광의 희소성을 만들어낸다. 이러한 교묘한 '선택적 점등' 스캐닝을 통해 최종적으로 회절 한계를 초월한 고해상도 세포 이미지를 재구성한다.
그러나 RESOLFT 나노현미경은 현재 완전무결하지 않으며, 광범위한 적용 과정에서 주요 장애물은 두 가지이다: 첫째, rsFPs 자체에는 광 스위치 피로 효과가 존재하여, 반복적인 상태 전환은 점차 가역적 전환 능력을 상실하게 할 수 있으며, 이는 살아있는 세포의 장시간 시계열 이미징 총 시간을 직접적으로 제한한다; 둘째, RESOLFT 이미징 시간은 형광 분자의 전환, 여기(excitation) 소요 시간 및 공간 스캐닝 샘플링 포인트 수의 제약을 받으며, 샘플링 포인트가 많을수록 이미징 소요 시간이 길어지고, 시간 해상도가 부족하면 운동 아티팩트가 쉽게 발생한다.
상기 난제에 대응하기 위해, 스웨덴 스톡홀름 왕립공과대학교(KTH), 독일 드레스덴 공과대학교(TU Dresden), 이탈리아 밀라노 인간 기술 성 재단(Fondazione Human Technopole)의 기관 간 연구팀은 딥러닝과 RESOLFT 이미징을 결합하여 두 가지 상보적인 계산 이미징 전략을 개발하였다: 저신호대잡음비(SNR) 또는 언더샘플링된 이미지를 복원하여 RESOLFT 이미징의 실험적 한계를 크게 확장한 Hierarchical DivNoising(HDN) 계층적 노이즈 제거 네트워크와 Fast‑MoNaLISA 희소 샘플링 재구성 프레임워크이다. HDN 네트워크를 활용하면 단일 프레임 이미지의 광선량(light dose)을 10배 줄일 수 있으며, 타임랩스 이미징의 총 시간은 최대 5배까지 연장할 수 있다. Fast-MoNaLISA 프레임워크를 활용하면, 25% 샘플링 조건에서 이미징 프레임 속도가 최대 4배까지 향상될 수 있다.
관련 연구 성과는 'Time-lapse RESOLFT nanoscopy empowered by deep learning'이라는 제목으로 Nature Communications에 게재되었다.
연구 하이라이트:
- HDN/HDNsup 계층적 노이즈 제거 네트워크를 기반으로, 광선량을 10배 낮춘 조건에서 저신호대잡음비 RESOLFT 이미지를 복원하여, 최대 5배까지 살아있는 세포의 장시간 나노 이미징을 가능하게 함
- Fast-MoNaLISA 시계열 업샘플링 모델을 개발하여 언더샘플링된 이미지를 초해상도로 재구성함으로써, 최대 4배의 이미징 가속을 실현하고 스캐닝 아티팩트를 경감함
- 다양한 유형의 데이터셋을 구축하여 모델을 종합적으로 검증하였으며, 미토콘드리아 소포, 액틴 네트워크 등 세포 소기관의 동적 과정에 대한 살아있는 세포 나노 관찰을 실현함
논문 주소:
https://www.nature.com/articles/s41467-026-78580-z
다중 소스 데이터셋 설계, 학습 및 독립적 평가에 적합
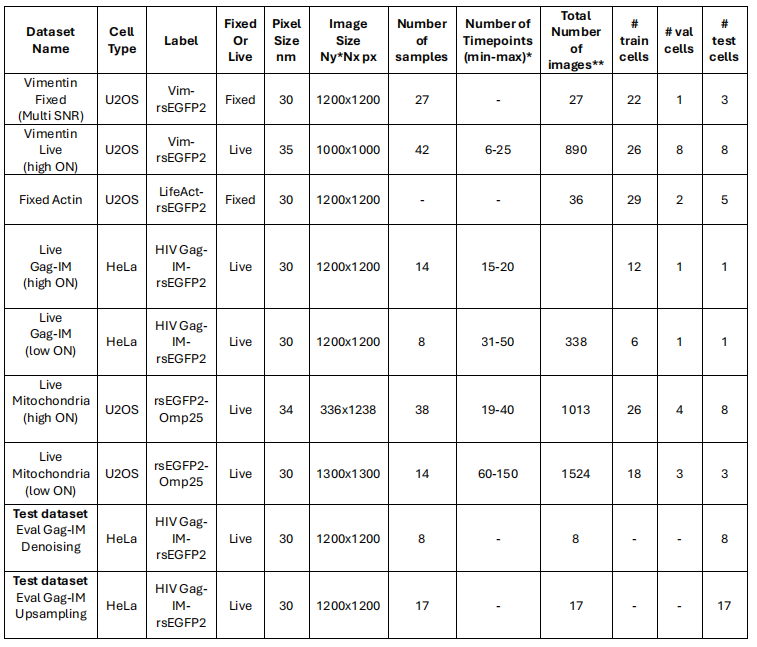
본 연구는 용도가 서로 다른 여러 RESOLFT 데이터셋을 채택하였으며, 이는 페어링된 데이터셋(Paired datasets), 비페어링된 데이터셋(Unpaired datasets), 그리고 독립 데이터셋(Independent datasets)을 포함한다. 구체적으로는 다음과 같다:
페어링된 데이터셋
깨끗한 이미지와 노이즈가 포함된 이미지 간의 페어링된 데이터셋을 확보하기 위해, 연구자들은 이미지 쌍 사이에서 구조적 변위가 발생하지 않도록 세포를 고정 처리하였다. 고정 처리는 rsFP의 사이클링 횟수를 제한하며, 이는 광표백(photobleaching) 속도가 살아있는 세포보다 더 빠름을 의미하지만, 여전히 고품질의 RESOLFT 이미지를 확보할 수 있다.
고정된 비멘틴 데이터셋(Fixed vimentin dataset) U2OS Vim-rsEGFP2의 경우, 연구자들은 먼저 약 10%-20%의 ON-스위칭(약 30 W/cm²)으로 노이즈가 포함된 이미지를 수집한 후, 약 80%-90%의 ON-스위칭(약 300 W/cm²)에서 5장의 이미지를 수집하였다. 이 의사 시계열 신호는 빠르게 감쇠되며, 연구자들은 신호 감쇠 과정을 활용하여 서로 다른 신호대잡음비 수준에서 HDN 및 HDNsup과 업샘플링 예측 결과를 평가하고, 의사 시계열의 첫 3장 이미지의 평균값을 취하여 최적의 실제 기준값(true reference)을 얻었다.
고정된 액틴 메쉬워크 데이터셋(Fixed actin meshwork dataset) U2OS LifeAct-rsEGFP2의 경우에도 동일한 절차를 따랐다. 다만, 첫 번째 이미지는 약 50% ON-스위칭 하에서 수집되었으며; 이후 약 90% ON-스위칭 하에서 5장의 이미지를 수집하고, 평균 처리를 통해 고품질의 실제 기준 이미지를 생성하여 HDNsup 모델의 학습에 사용하였다.
비쌍대 데이터셋
비쌍대 데이터셋은 주로 무감독 학습을 위한 노이즈 제거 및 업샘플링 훈련에 사용됩니다.
미토콘드리아와 HIV Gag-IM 입자의 무감독 HDN 노이즈 제거 처리를 위해 연구진은 낮은 ON-스위칭 시간 시계열을 채택하고, 낮은 신호 대 잡음비(SNR)의 시간 시계열에서 직접 HDN을 훈련했습니다. 단일 시간 시계열에 많은 수의 프레임이 포함되므로, 소수의 세포만으로도 충분한 양의 잡음 이미지를 제공할 수 있습니다.
업샘플링 훈련 데이터셋의 경우, 연구진은 일반적인 RESOLFT 시간 시계열(10-40 프레임 포함)을 수집했으며, 시간 길이는 각 세포와 구조에 맞게 조정되어 전체 시계열 세트의 SNR이 충분하도록 했습니다.
독립 테스트 데이터셋
HIV Gag-IM 입자의 경우, 연구진은 추가로 두 개의 테스트 세트를 수집했습니다. 이는 노이즈 제거 평가 세트(낮은 ON-스위칭, 높은 ON-스위칭, 증강 공초점의 세 가지 조건에서 수집된 이미지 포함)와 업샘플링 평가 세트(높은 ON-스위칭과 증강 공초점의 두 가지 조건에서만 수집된 이미지 포함)입니다. 주목할 점은 이러한 모든 데이터셋이 살아있는 세포에서 수집되었기 때문에 세포 이동의 영향이 존재한다는 것입니다.
각 데이터셋은 무작위로 훈련 세트, 검증 세트 및 테스트 세트로 분할됩니다. 이미지 크기는 64 × 64, 96 × 96, 128 × 128을 포함하며, 정보량이 부족한 블록은 제거됩니다. 구체적인 데이터셋은 아래 그림과 같습니다:
핵심 문제 분할, 이미지 노이즈 제거 및 희소 샘플링 복원 집중
본 연구는 RESOLFT 기술에 초점을 맞추며, 기본 방법은 현재 가장 최신의 병렬화 RESOLFT 영상 기술인 MoNaLISA 구현 방식을 채택합니다. MoNaLISA는 ON-스위칭과 읽기(read-out)를 위한 다초점 모드와 OFF-스위칭을 위한 중첩된 주기적 선형 모드를 통합하여, 약 40 × 40 µm²의 시야(FOV) 내에서 약 0.5 Hz의 프레임 속도로 45-60 나노미터 공간 해상도의 살아있는 세포 영상을 가능하게 합니다.
이를 바탕으로 연구진은 딥러닝을 활용하여 낮은 신호 대 잡음비의 이미지나 샘플링이 부족한 이미지를 복원함으로써 기존 RESOLFT 방법의 한계를 돌파하는 것을 제안했습니다. 그 논리는 매우 단순합니다. 즉, 이미지 노이즈 제거 기술을 통해 영상에 필요한 빛의 선량을 줄여 광표백 현상을 완화하고, 희소 샘플링으로 수집된 데이터를 복원하기 위한 계산 프레임워크를 구축하여 계산적 업샘플링을 통해 시간 해상도를 향상시키는 것입니다.
구체적으로, ON-스위칭 광 강도는 활성화되는 rsFP의 수를 결정하며, 이는 수집 신호 강도를 제어합니다. 기존 방식은 일반적으로 SNR을 극대화하기 위해 rsFP의 80%-90%를 활성화하지만, 본 연구는 반대 전략을 제안하여 rsFP의 10%-20%만 활성화하고 낮은 SNR의 이미지를 획득한 후, 딥러닝 노이즈 제거를 통해 고품질 이미지를 재구성합니다. 이는 광표백을 최소화할 뿐만 아니라, ON-스위칭에 짧은 파장(일반적으로 405 nm)을 사용하여 발생하는 광독성 문제도 완화합니다.
이를 바탕으로 연구진은 무감독 이미지 노이즈 제거 알고리즘인 HDN을 채택할 것을 제안했습니다. 이 방법은 계층적 변분 오토인코더(LVAE) 네트워크 구조를 기반으로 하며, 실험적으로 측정된 잡음 모델을 도입합니다. 또한, 연구진은 동일한 프레임워크를 감독 학습으로 수정한 HDN의 감독 변형 버전인 HDNsup을 제공합니다. 연구 팀이 무감독 및 감독 두 가지 버전의 해결책을 제시한 이유는, 고품질 정답(GT)이 있을 때는 감독 학습을 사용할 수 있고, 정답이 없을 때는 무감독 모드에서도 여전히 안정적으로 사용할 수 있도록 하기 위함입니다. 동시에, 이상적인 전략은 효과적으로 노이즈를 제거하면서도 공간 해상도를 희생하지 않아야 합니다.
여기서 HDN의 백본 네트워크인 LVAE는 생체 이미지 데이터의 계층적 구조 사전 분포를 학습하는 데 사용되며, 큰 윤곽선부터 미세한 질감까지 다단계 특성을 동시에 포착할 수 있습니다. 더 중요한 것은, 이 모델이 다해 사전 분포 모델로서 유일한 확정된 결과를 출력하지 않는다는 점입니다. 실험 잡음 모델은 HDN이 무감독 학습을 달성할 수 있게 하는 핵심 요소로, 잡음이 포함된 관측 이미지 뒤에 있는 실제 깨끗한 신호의 조건부 확률을 설명합니다. 더욱이, 이 프레임워크는 감독 학습에 쉽게 적용될 수 있어 HDN이 알려진 깨끗한 정답 정보를 활용할 수 있게 하며, 동시에 HDN의 다해 표현과 출력 결과의 다양성 조절 가능성이라는 두 가지 특성을 유지합니다.
연구의 두 번째 해결책은 희소 샘플링된 이미지를 복원하기 위한 프레임워크를 구축하는 것으로, 빠른 살아있는 세포 역학의 시각화를 구현하는 것이 목적입니다. 구체적으로, 수집 시간은 스캔 단계 수에 의존하며, 희소 샘플링과 이미지 복원 기술을 결합하면 이미지 품질을 유지하면서 영상 속도를 크게 향상시킬 수 있습니다. 최적의 샘플링 간격은 일반적으로 나이퀴스트-섀논 표본화 정리에 따라 결정되며, 에일리어싱 아티팩트나 정보 중복을 방지하기 위해 간격 크기는 시스템 차단 주파수의 2배, 즉 예상 해상도의 약 절반에 해당합니다. RESOLFT 영상에서는 이 간격이 약 20-30 nm입니다.
이를 바탕으로 연구진은 Fast MoNaLISA를 제안했습니다. 이 방법은 일부 스캔 단계를 건너뛰어 단일 프레임 수집 시간을 단축한 후, 업샘플링 네트워크를 사용하여 언더샘플링된 이미지를 복원합니다. 이 방법의 장점은 빛의 선량을 변경하지 않고도 시간 해상도를 향상시킬 수 있다는 점입니다. 이 개념은 회절 한계의 공초점 현미경에 사용된 적이 있지만, 100 nm 이하의 나노 초해상도 영상에서는 검증된 적이 없습니다. 또한, 본 연구의 핵심 기술적 세부 사항은 샘플링을 줄이는 동시에 OFF-스위칭 광 선량을 일정하게 유지하여 샘플에서 기존 영상 해상도를 유지한다는 점입니다.
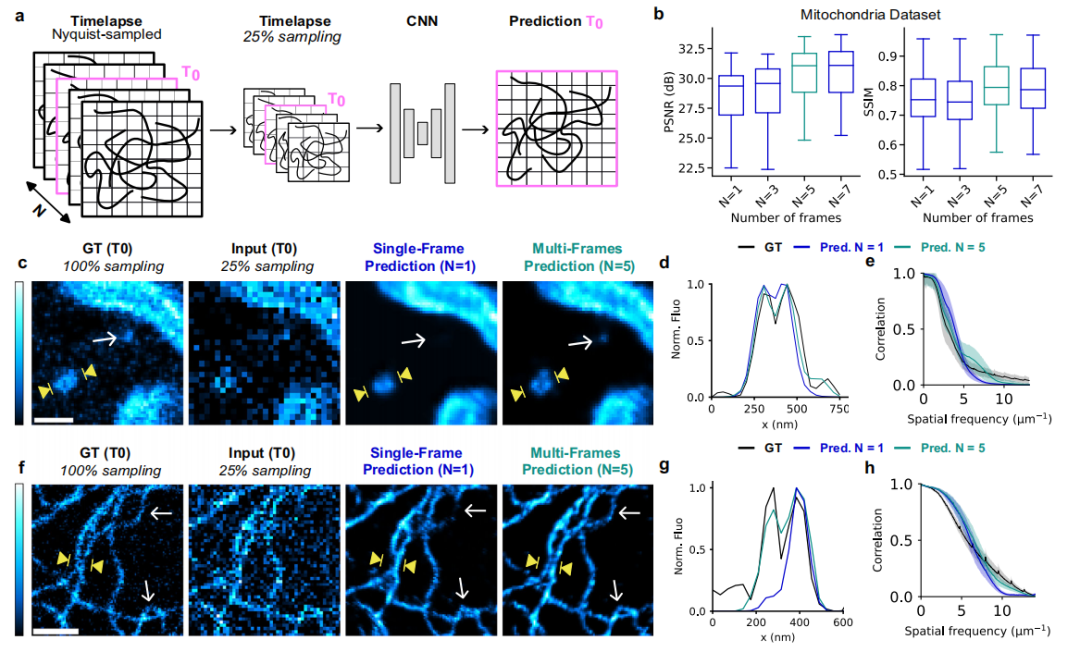
Fast MoNaLISA는 단일 프레임 학습과 다중 프레임 학습 두 가지 학습 패러다임을 구현했습니다. 단일 프레임 학습은 정적 장면에서의 업스케일링 복원을 목표로 하며, 네트워크에 단일 시간점의 데이터를 제공합니다. 다중 프레임 학습은 단일 프레임 학습 방식을 기반으로 개선된 방법으로, 세포 내 분자와 세포 소기관의 빠른 동적 과정을 이미징하는 것을 목표로 합니다. 이 방법에서는 연구자들이 단일 스냅샷 대신 서브 샘플링된 시계열 이미지를 입력으로 사용하며, 각 시간점에 대해 단일 프레임 학습과 동일한 무작위 다운샘플링 단계를 적용하여 서브 샘플링된 이미지를 생성합니다. 이후 네트워크는 시계열의 중간 시간점을 예측하도록 학습되며, 입력 이미지의 새로운 시간적 컨텍스트가 제공하는 추가 정보를 학습하여 재구성 충실도를 향상시킵니다.
네트워크 아키텍처 측면에서, Fast MoNaLISA 업스케일링 재구성의 기본 구조는 UNet-RCAN이며, 원래 RCAN의 마지막 업스케일링 계층은 삭제하지 않고 유지합니다. 이 네트워크를 선택한 이유는 간단합니다. RCAN은 본래 이미지 업스케일링 작업을 위해 설계되어 이번 연구의 저샘플링 이미지 복원에 자연스럽게 적합하기 때문입니다. 또한 구조적 선택 및 배제 측면에서, 모델은 U-Net 백본을 유지하여 모델의 수렴 속도를 높이는 데 도움을 줍니다.
조명 10배 감소, 시계열 5배 연장, 촬영 속도 4배 향상
연구진은 먼저 HDN의 낮은 ON-switching 이미지 복원 능력을 평가했습니다. 실험에서는 무감독 방법인 Noise2Void(N2V), Self-Inspired Noise2Noise(SN2N) 및 감독 방법인 Content-Aware Image Restoration(CARE), UNet-RCAN을 각각 선정하여 HDN과 비교 검증했습니다.
결과에 따르면, Ground Truth(GT)의 평균 반치폭(FWHM)은 58nm였으며, HDN과 HDNsup 모두 공간 해상도를 유지하여 평균 FWHM이 각각 56nm와 54nm였습니다. 반면, 무감독 방법인 SN2N의 평균 FWHM은 120nm, N2V는 93nm였습니다. 감독 방법은 상대적으로 우수하여 CARE은 73nm, UNet-RCAN은 70nm였으나, 여전히 세포 구조를 평활화하는 경향이 있어 세부 정보 손실을 초래했고, 이로 인해 평균 FWHM이 모두 Ground Truth보다 높았으며 푸리에 링 상관(FRC) 곡선이 저주파 대역에서 하락했습니다. 아래 그림과 같습니다:
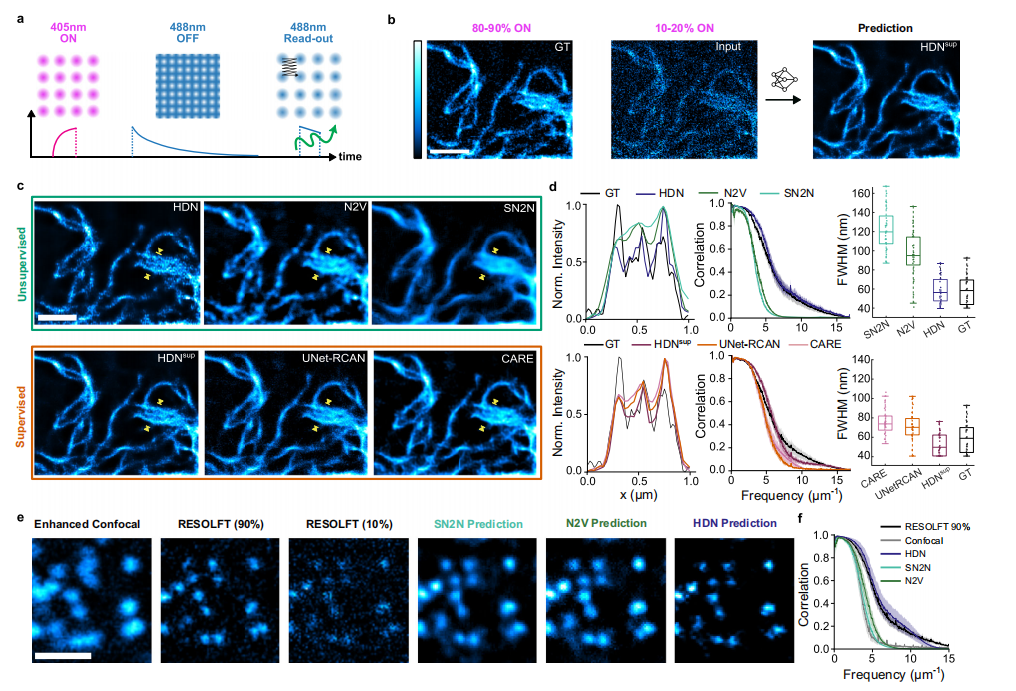
그러나 주목할 점은 감독 노이즈 제거 방법의 성능 한계가 네트워크 아키텍처 자체에서 기인하는 것이 아니라, Ground Truth의 품질 부족에서 비롯된다는 것입니다. 따라서 다른 감독 학습 방법과 마찬가지로 HDNsup은 뛰어난 성능을 보이지만, 그 성능은 여전히 Ground Truth의 품질에 크게 의존합니다.
이어서 연구진은 더 희소한 점상 구조에서 HDN 노이즈 제거 방법의 효과를 검증했습니다. 결과적으로 HDN은 이러한 점상 구조를 정확하게 복원하며, 강화 공초점 이미징에서는 관찰할 수 없는 초분해능 세부 정보를 보존했습니다. 이는 다른 무감독 노이즈 제거 방법으로는 불가능한 것이며, FRC 역시 이 결론을 뒷받침했습니다. 물론 신호 대 잡음비(SNR)가 극히 낮을 경우 예측 정확도가 떨어지므로, 예측의 신뢰성을 확보하기 위해 ON-switching 수준을 신중하게 선택하고 검증해야 합니다. HIV Gag-IM-rsEGFP2의 경우, 5%의 밝은 상태 활성화 비율에서는 명확한 재구성 아티팩트가 발생하며, 10%가 비교적 신뢰할 수 있는 작업 임계값입니다.
살아있는 세포의 장시간 시계열 이미징을 실현하는지 검증하는 과정에서, 이미징에 사용된 자외선-가시광선 에너지가 원래의 약 1/10 수준이 되었기 때문에, 시계열 이미징 시간이 기존의 높은 ON-switching을 사용하는 일반적인 RESOLFT 방법과 비교하여 최대 약 5배 연장되었습니다. 아래 그림과 같습니다. 주목할 점은 해당 실험이 모두 vimentin 분자의 내재적 발현 수준에서 수행되었으며, rsEGFP2 미토콘드리아 외막과 같이 밝기가 더 높은 샘플의 경우 무감독 HDN을 사용하여 100 프레임 이상의 시계열 이미징을 실현할 수 있다는 것입니다.
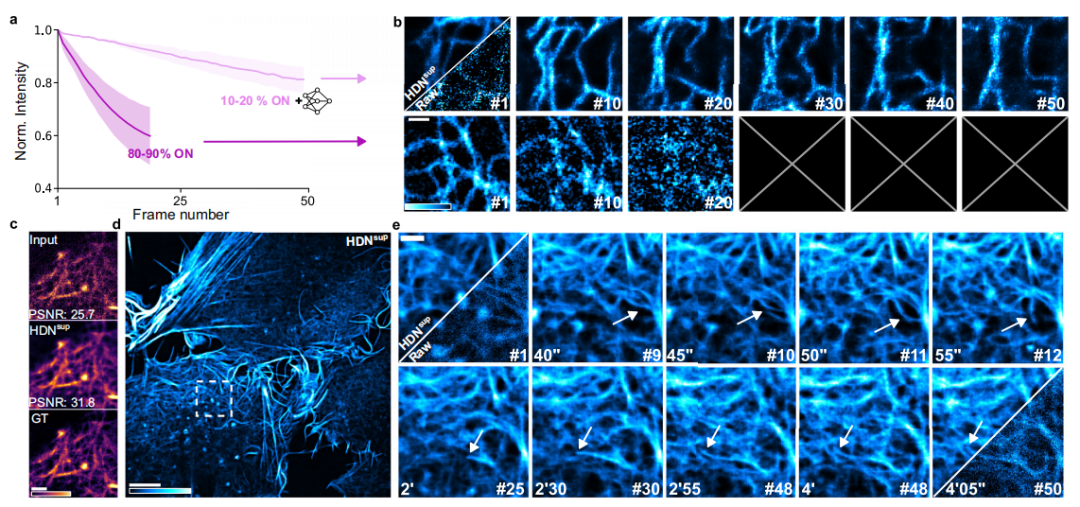
연구진은 HDNsup을 사용하여 액틴 그물망과 같은 복잡하게 얽힌 구조의 이미징 실험을 계속 진행했습니다. LifeAct-rsEGFP2를 발현하는 고정 세포에서 고품질 데이터를 수집하여 액틴 그물망 구조를 정밀하게 재구성할 수 있음을 먼저 검증한 후, 살아있는 세포 이미징으로 전환했습니다. 결과적으로 HDNsup은 최소 50 프레임을 연속적으로 성공적으로 수집하여 액틴 그물망 구조의 동적 과정에 대한 장시간 관측을 실현했습니다.
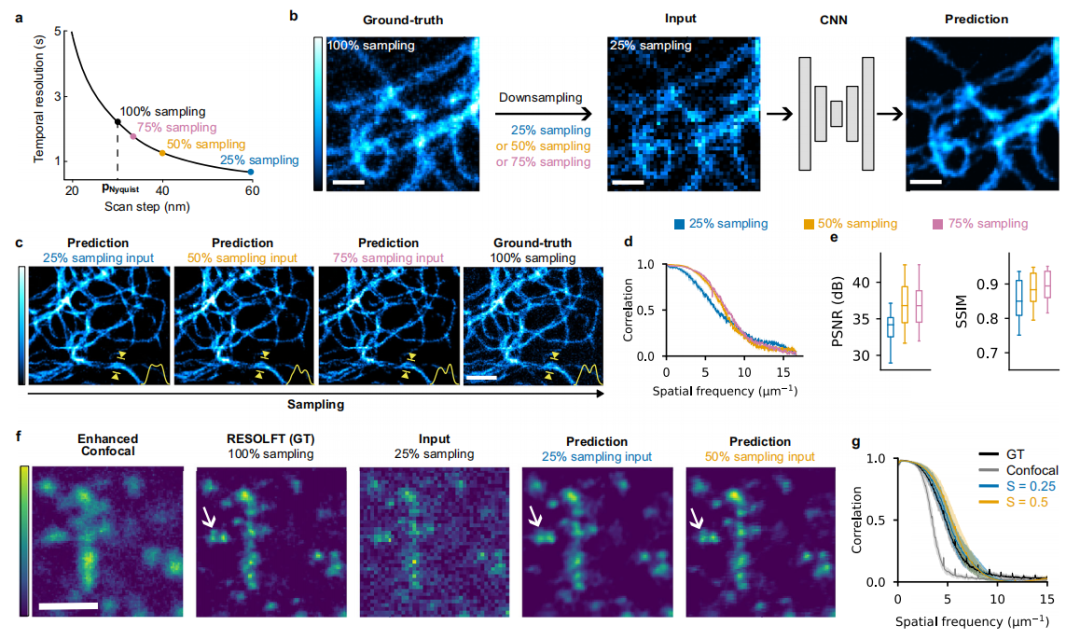
단일 프레임 학습과 다중 프레임 학습 평가에서, 연구진은 75%, 50%, 25%의 세 가지 샘플링률을 탐색했으며, 이는 각각 프레임 속도 1.3배, 2배, 4배 향상에 해당합니다.
단일 프레임 학습 결과에 따르면, Fast MoNaLISA는 신호 대 잡음비가 높은 이미지에서 최상의 성능을 보이므로, 일반적인 ON-switching 수준인 80%-100%를 채택해야 합니다. 이는 광조사 선량 감소라는 전반적인 목표와 일치하는데, 서브 샘플링 자체가 해당 선량을 감소시키기 때문입니다. 또한 샘플링률의 선택은 이미징 속도와 예측 신뢰성 사이의 트레이드오프를 반영하며, 단일 프레임 예측에서 50%의 샘플링률을 사용하는 것은 속도와 충실도 사이의 가장 견고한 절충안입니다. 아래 그림과 같습니다:
다중 프레임 학습 결과, Fast MoNaLISA는 픽셀의 25%만 수집하는 고속 이미징 조건에서도 이미지를 정확하게 복원할 수 있으며, 이는 단일 프레임 학습의 기존 한계를 돌파한 것입니다. 아래 그림과 같습니다:
맺음말
총체적으로, 본 연구는 실험적 이미징과 계산적 복원을 결합한 하이브리드 방식을 구축하여, 병렬 RESOLFT 기술을 기반으로 전체 살아 있는 세포의 장시간 동적 관측을 실현했습니다. 공간 해상도는 약 60나노미터에 달하며, 세포 골격, 미토콘드리아 소포 등 미세 구조를 포착하고, 과거에는 정적인 촬영으로만 관찰 가능했던 약한 신호와 빠른 이동 분자를 추적할 수 있습니다. SIM, SOFI, STED 등 주요 살아 있는 세포 초해상도 기술과 비교할 때, 본 방법은 70나노미터 이하의 해상도, 이미징 속도, 시야 크기 및 광 손상 사이에서 드문 균형점을 달성했습니다.
더욱 가치 있는 점은, 현재 연구팀이 LISAI 소프트웨어 프레임워크를 오픈소스로 공개했으며, 관련 알고리즘은 STED, 디스크 스캐닝 공초점 현미경 등 다른 스캐닝 현미경 시스템으로 이식 가능하다는 것입니다. 물론 딥러닝 복원에는 매개변수 선택의 문제가 있어 샘플의 신호 대 잡음비에 따라 매개변수를 조정해야 합니다. 향후에는 모델을 더욱 최적화하고 통합 프레임워크를 구축하여 이미징 시 광 노출량과 데이터 수집 시간을 동시에 줄이는 방향으로 발전할 수 있습니다.